上一章完成以后,我们已经有了一个:
nnaa_library.mdb
其中保存了 CYC4、AZE2 等自定义非天然氨基酸。
但此时 MOE 只知道:
"这个残基长什么样。"
它还不知道:
"这个残基接到蛋白主链以后,侧链通常可以采用哪些构象。"
这就是 Rotamer Library 要解决的问题。
Rotamer 到底是什么?
氨基酸侧链通常可以围绕 χ1、χ2 等可旋转键发生旋转。
理论上这些二面角可以连续变化,但实际上由于:
-
空间位阻;
-
键角限制;
-
分子内部能量;
-
局部相互作用;
某些侧链构象会比其他构象更稳定。
这些常见、合理的侧链构象,就可以理解为:
Rotamer。
天然氨基酸已经有成熟的 Rotamer 数据。
但对于我们刚刚自己构建的 CYC4、AZE2,MOE 并没有现成的构象信息,因此需要重新建立。
第一步:从 NNAA Database 生成 Rotamer Library
打开前面建立的:
nnaa_library.mdb
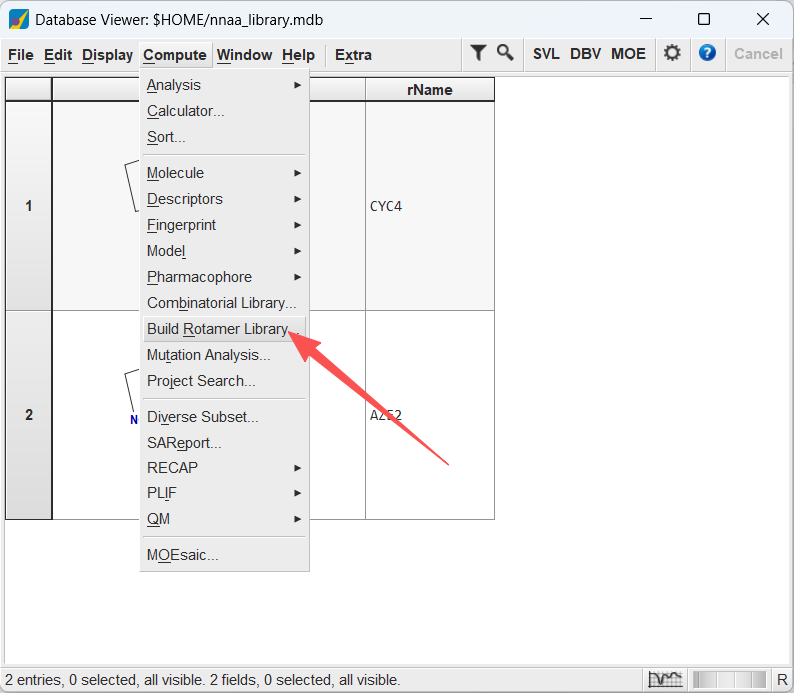
然后在 Database Viewer 中选择:
Compute → Build Rotamer Library...
这一步会根据数据库中的非天然氨基酸结构,对侧链构象进行采样,并生成新的 Rotamer Database。
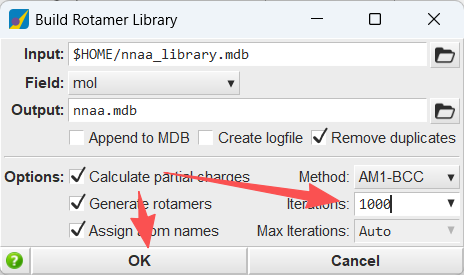
输出数据库可以设置为:
nnaa_rotamers.mdb
示例中为了缩短计算时间,将:
Iterations = 1000
然后开始计算。
这里的 Iterations 可以简单理解为:
在构象空间中进行采样和搜索的次数。
迭代次数越高,通常意味着对侧链构象空间探索得更加充分,但计算时间也会增加。
为什么一个氨基酸会产生四种状态?
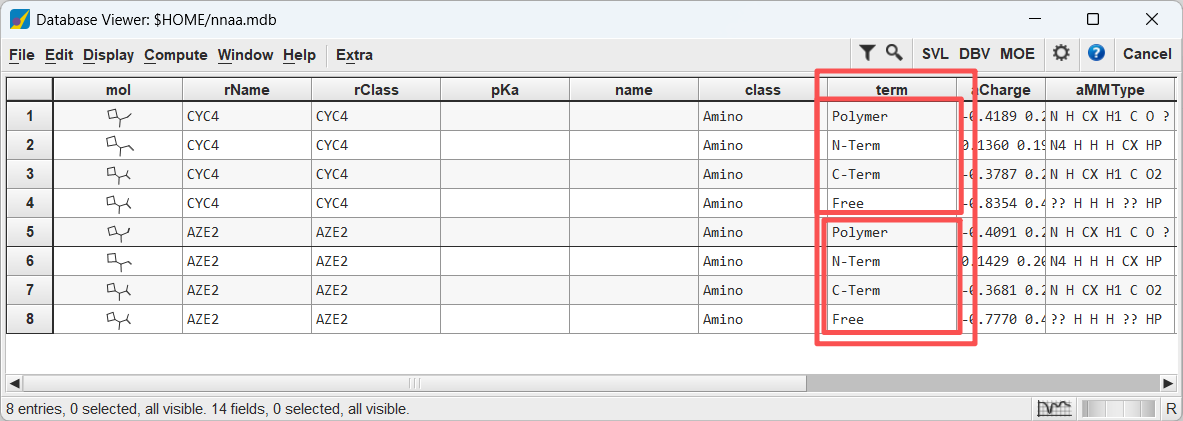
计算完成后,nnaa_rotamers.mdb 会自动打开。
这里会发现一个很有意思的现象:
同一个非天然氨基酸并不是只有一条记录。
而是会生成四种不同环境下的形式:
-
Polymer;
-
N-terminal charged;
-
C-terminal charged;
-
Free zwitterionic amino acid。
为什么要这么做?
因为同一个氨基酸处在蛋白链内部、N 端、C 端和游离状态时,化学环境并不相同。
例如:
Polymer 状态
表示这个残基已经通过肽键连接在蛋白或肽链内部。
而:
Free zwitterion
则对应游离氨基酸状态。
而N-terminal charged 和C-terminal charged分别代表他们N端和C端的氨基酸残基状态。
对于后续肽设计来说,最常使用的通常是 Polymer 状态,因为我们更关心的是:
当 CYC4 被插入肽链中以后,它的侧链有哪些合理构象。
第二步:直接查看 CYC4 的侧链构象
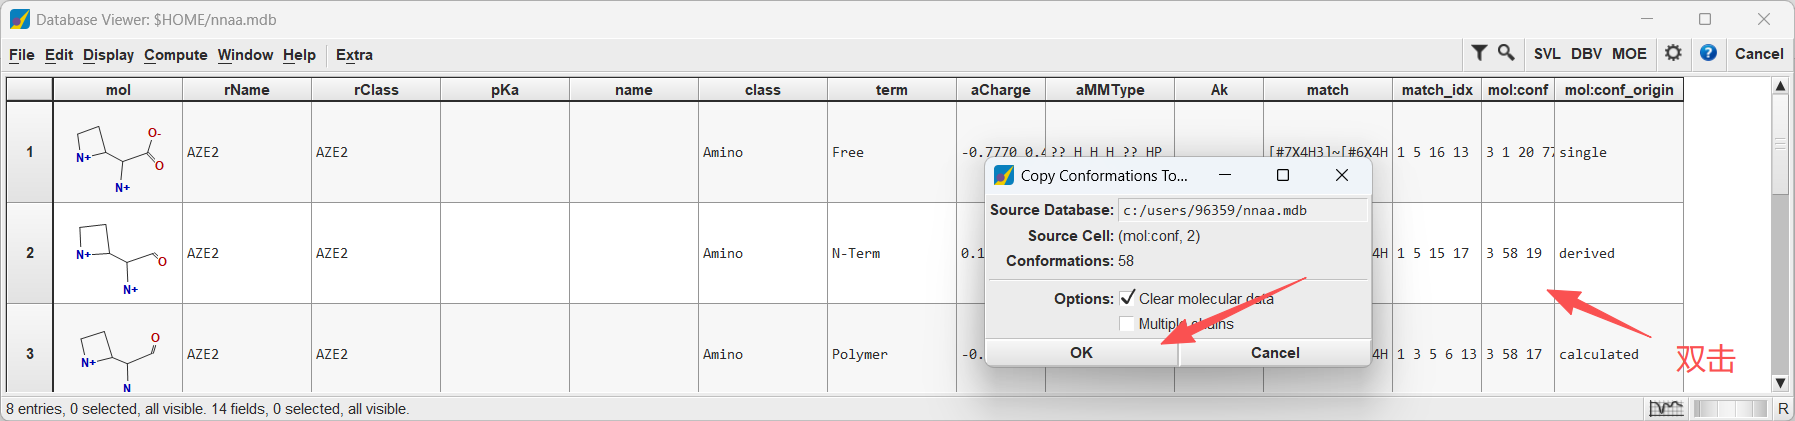
接下来可以双击:
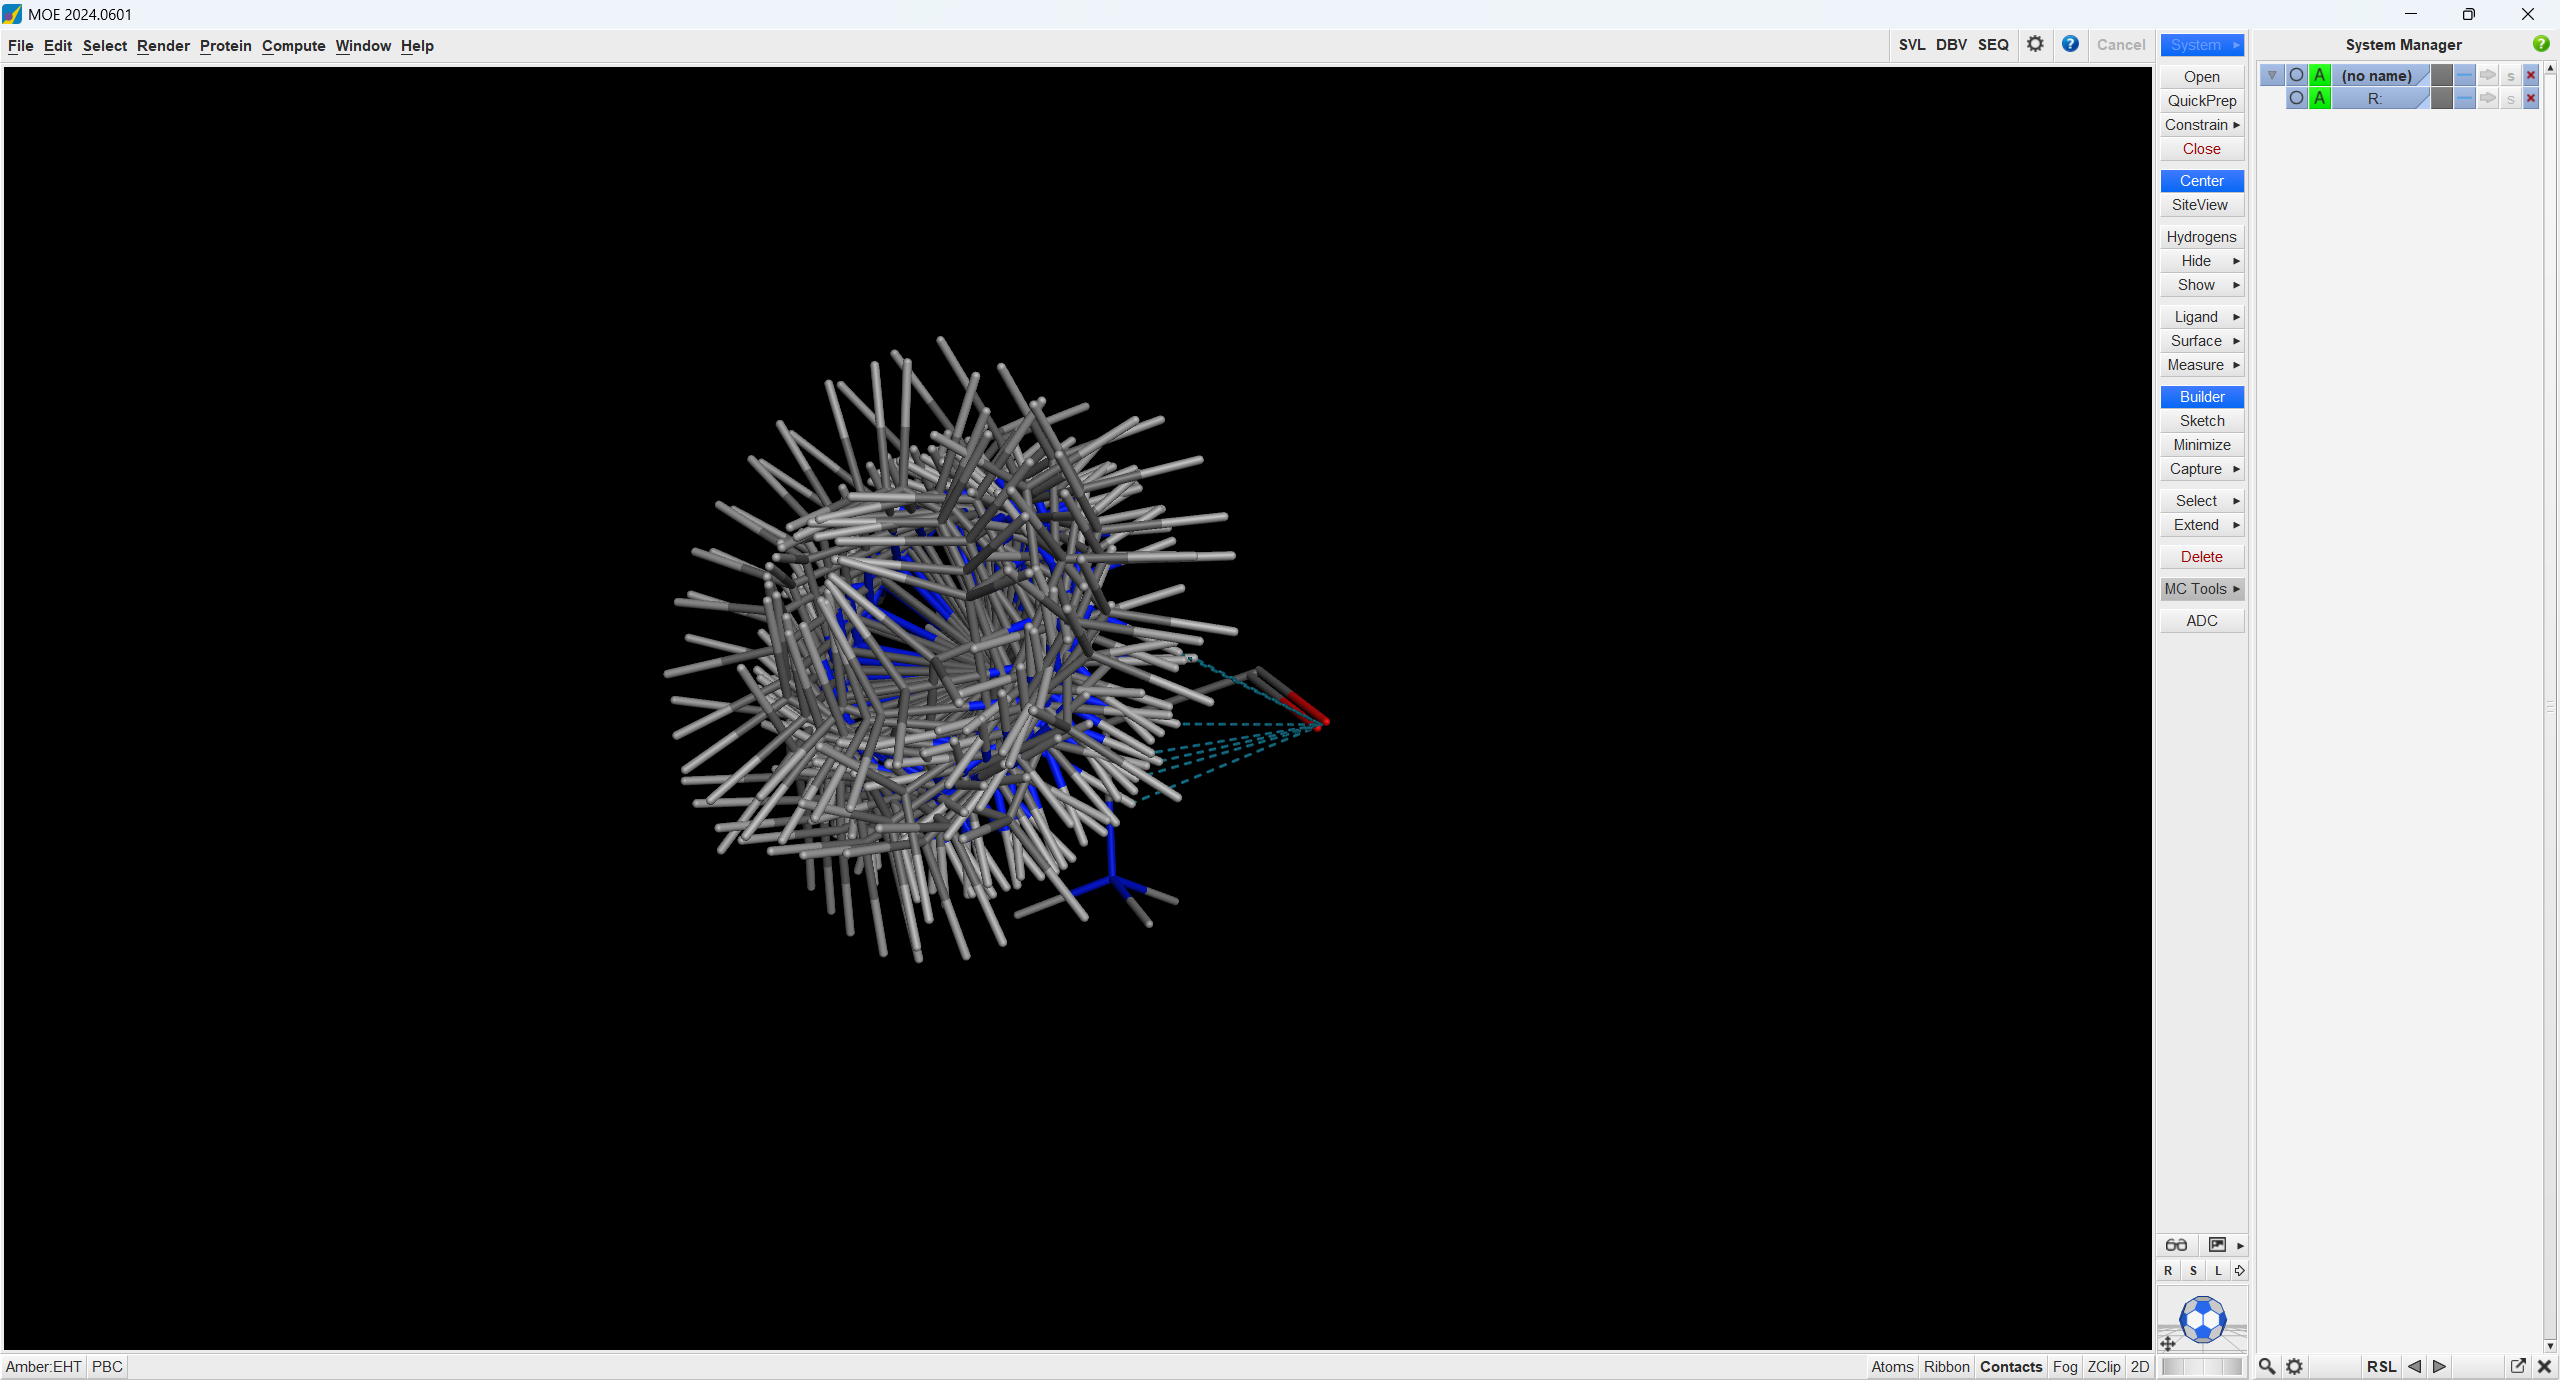
CYC4 Polymer → mol:conf
加载对应的 conformers。
这样,CYC4 的多个候选侧链构象会同时显示在 MOE 三维窗口中。
这一张图其实非常值得仔细看。
因为它直观展示了 Rotamer Library 的真正意义:
不是给残基保存一个固定结构,而是保存一组可能的侧链构象。
以后当 CYC4 被突变到某个肽链位置时,MOE 就可以从这些构象中寻找更适合当前局部环境的 side-chain placement。
第三步:把新的 Rotamer Library 加入 MOE
生成数据库之后还没有结束。
因为此时:
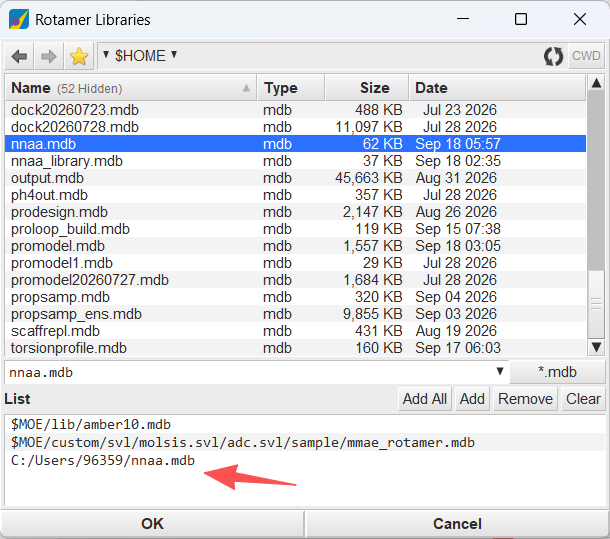
nnaa_rotamers.mdb 虽然存在,但 MOE 的 Protein Builder 并不知道要去读取它。
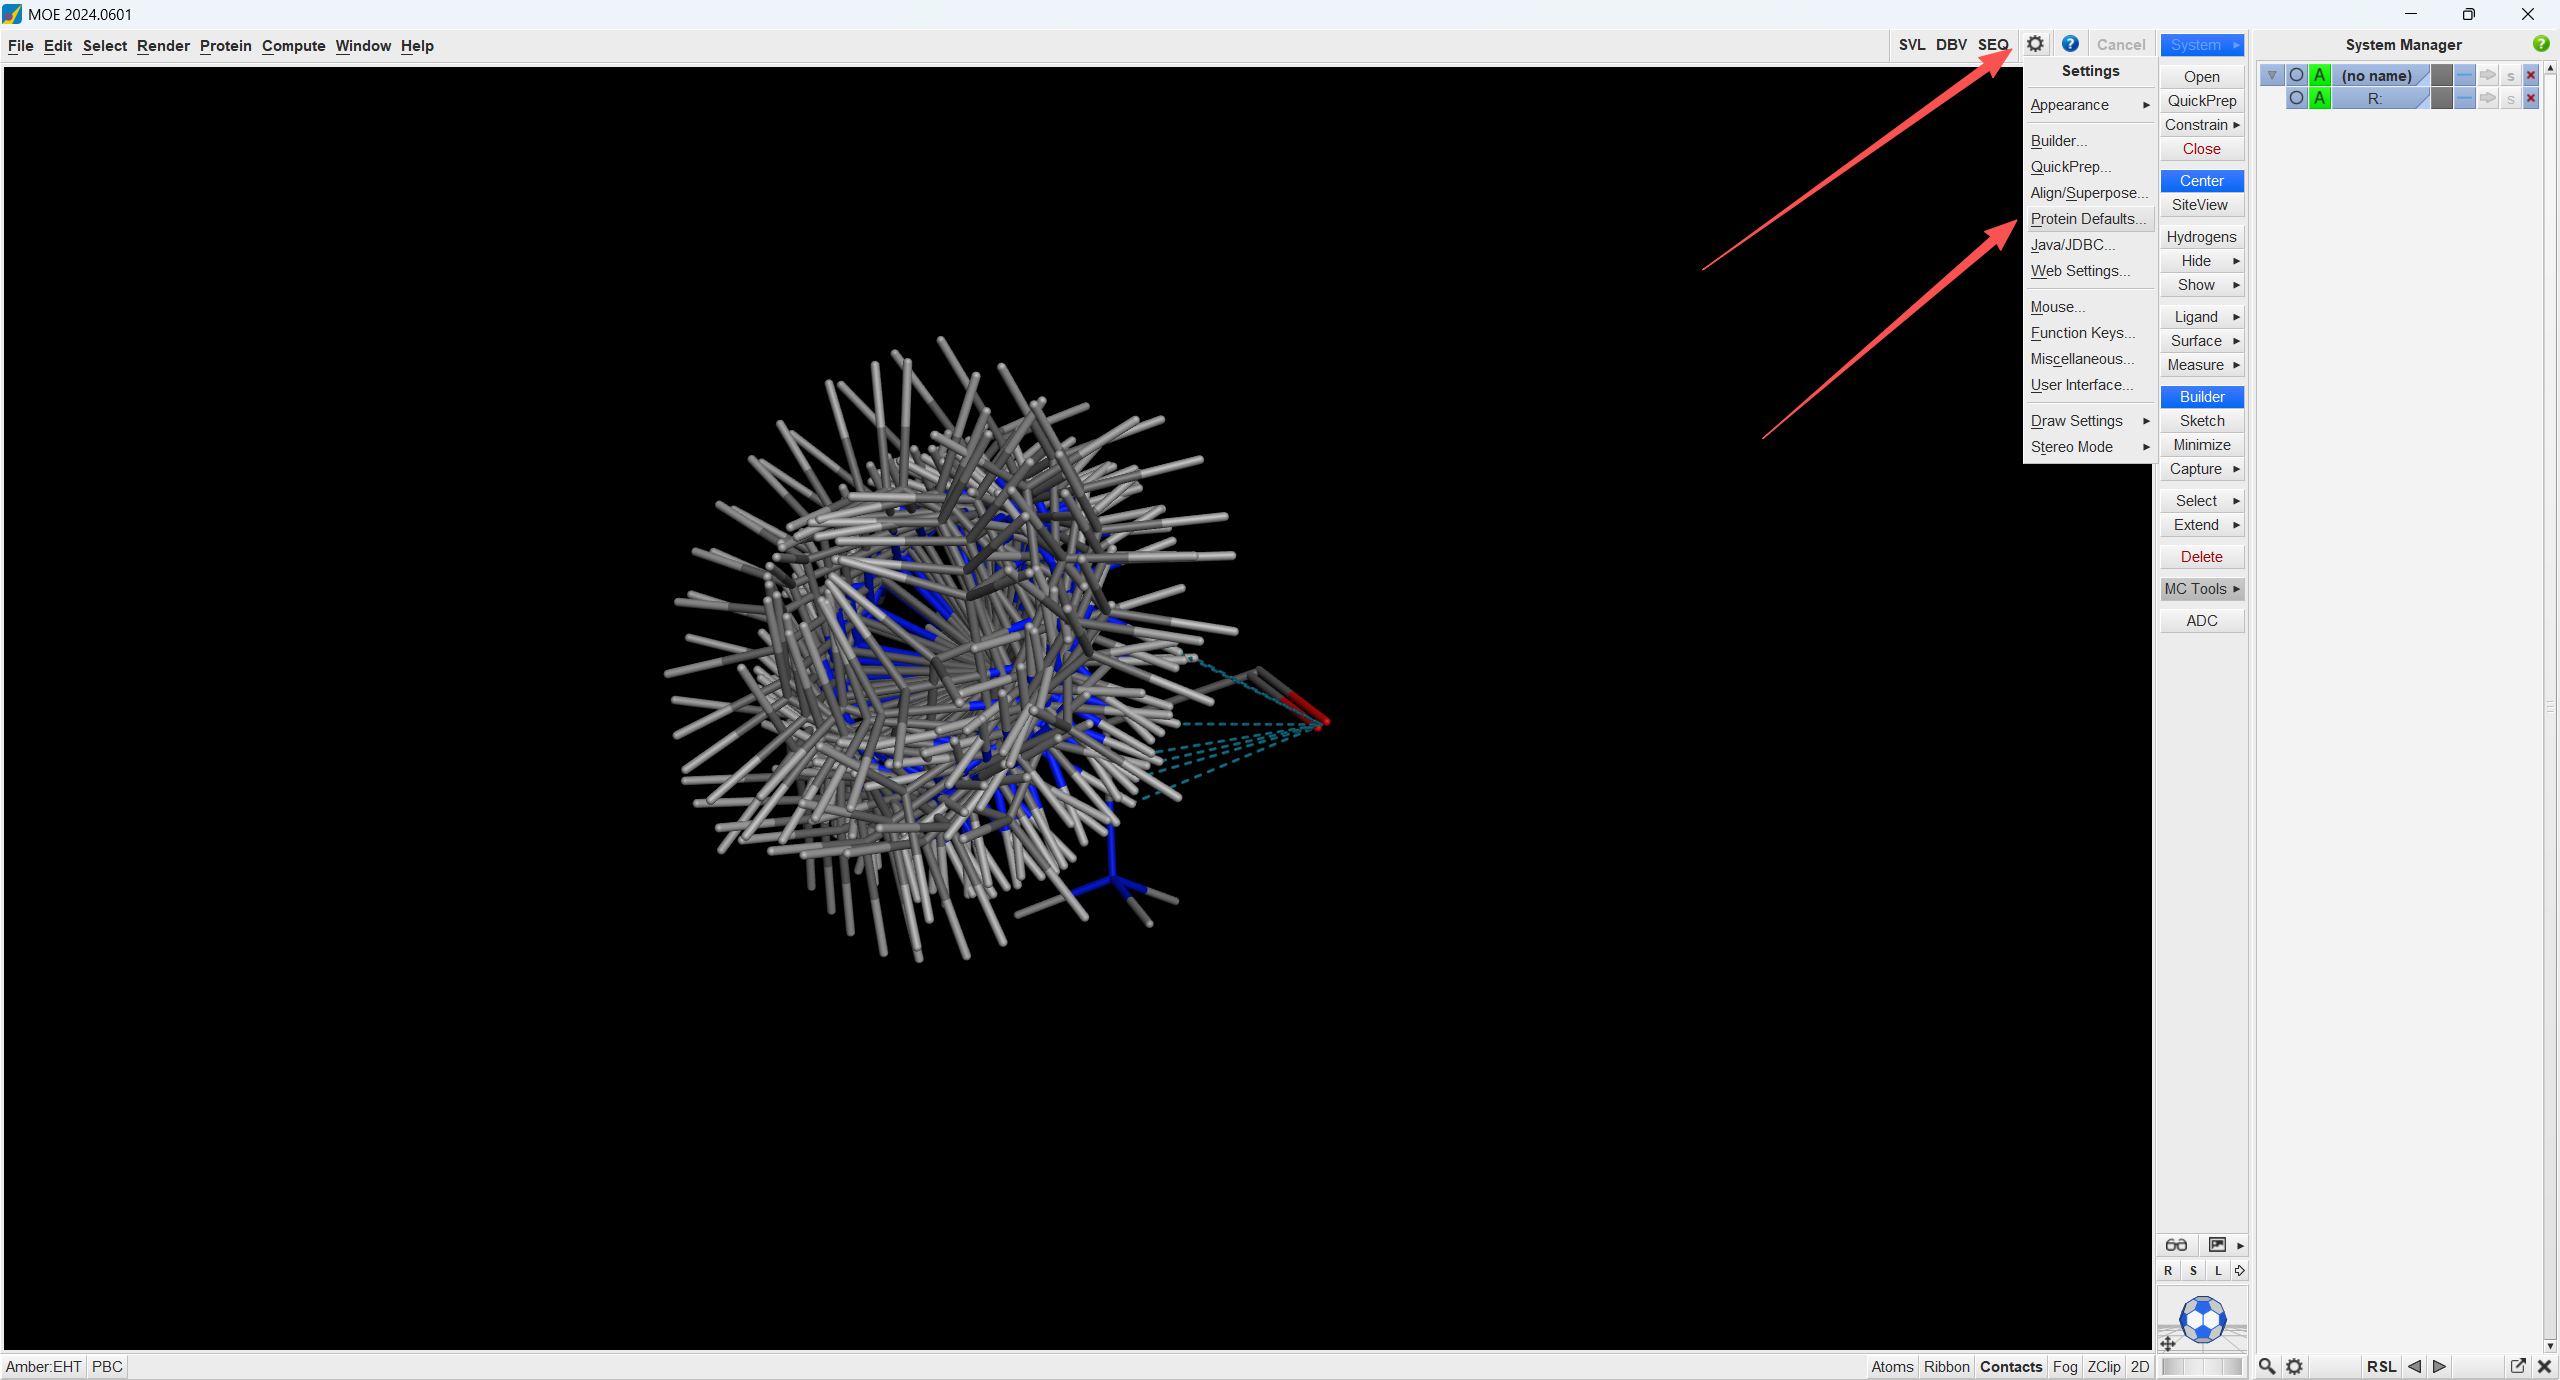
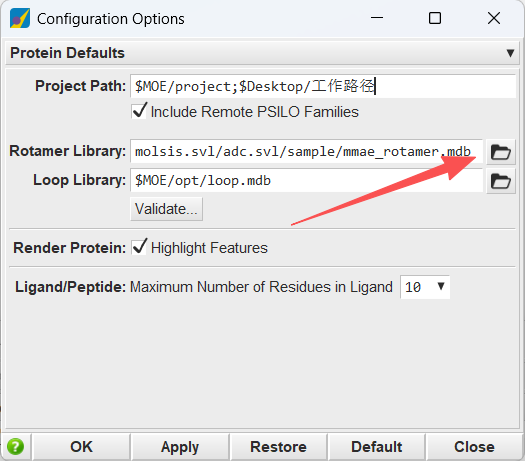
因此还需要进入:
Protein Defaults
把新生成的:
nnaa_rotamers.mdb
加入 Rotamer Libraries 列表。
添加完成以后,可以使用:
Validate...
检查数据库是否能够被正确找到。
如果路径或文件存在问题,这里会出现 warning。
这一操作完成以后,自定义 Rotamer Library 才真正进入 MOE 的蛋白设计环境。
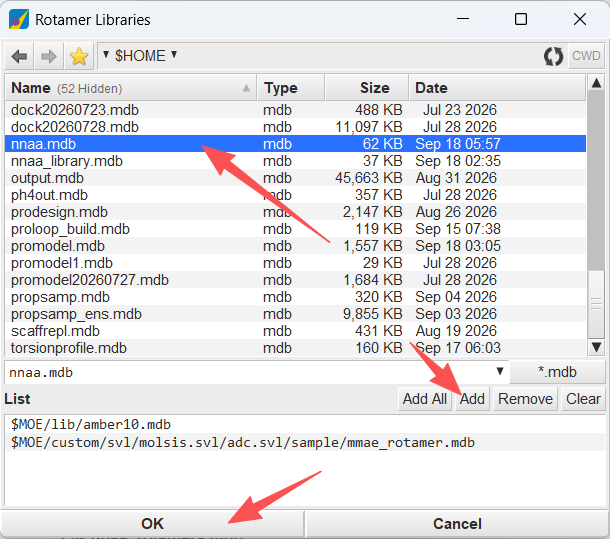
当这里下面出现了,代表添加成功了。
到这里,我们到底完成了什么?
现在可以把整个过程串起来:
设计非天然氨基酸结构
↓
保存到 nnaa_library.mdb
↓
Build Rotamer Library
↓
生成 nnaa_rotamers.mdb
↓
加入 Protein Defaults
↓
Protein Builder / Protein Design 调用
也就是说,我们已经从"画一个新的氨基酸",走到了:
让 MOE 真正知道这个氨基酸在蛋白环境中可能怎么摆放。
这一步非常关键。
因为后面的 Protein Design 并不是简单把一个残基替换进去,而是还需要重新寻找合理的侧链构象。
本篇小结
自定义非天然氨基酸要真正进入肽设计流程,需要两个层次的信息:
第一层:化学结构是什么。
这由 nnaa_library.mdb 保存。
第二层:合理的侧链构象有哪些。
这由 nnaa_rotamers.mdb 保存。
完成 Rotamer Library 并加入 Protein Defaults 后,CYC4、AZE2 才真正具备进入自动化设计流程的条件。
下一篇我们将正式从"手工设计"进入"批量设计":
如何利用 Protein Design 和 Residue Scan,同时测试多个位点、多个天然和非天然氨基酸突变,并自动计算 affinity 和 stability。