上一篇中,我们已经使用 Molecule Builder 对肽上的单个原子进行修改。
如果进一步思考,就会发现一个很自然的问题:
既然侧链可以修改,能不能直接把修改后的结构定义成一种新的氨基酸,以后像 Leu、Asn 一样反复使用?
这就是非天然氨基酸库要解决的问题。
为什么需要非天然氨基酸?
天然氨基酸虽然已经覆盖了疏水、芳香、带电和极性等多种化学性质,但对于肽类药物来说,它们提供的化学空间仍然有限。
例如,我们可能希望:
-
增大某个疏水侧链;
-
引入环状结构;
-
限制侧链构象自由度;
-
改变电荷状态;
-
引入天然氨基酸不存在的官能团。
这时,与其每次都手工修改,不如把这个结构定义成一个新的 residue。
MOE 中可以先利用 Protein Builder 生成一个天然氨基酸作为模板,再切换到 Molecule Builder 对其化学结构进行编辑。
第一步:从一个已有氨基酸开始
打开:
Protein → Protein Builder
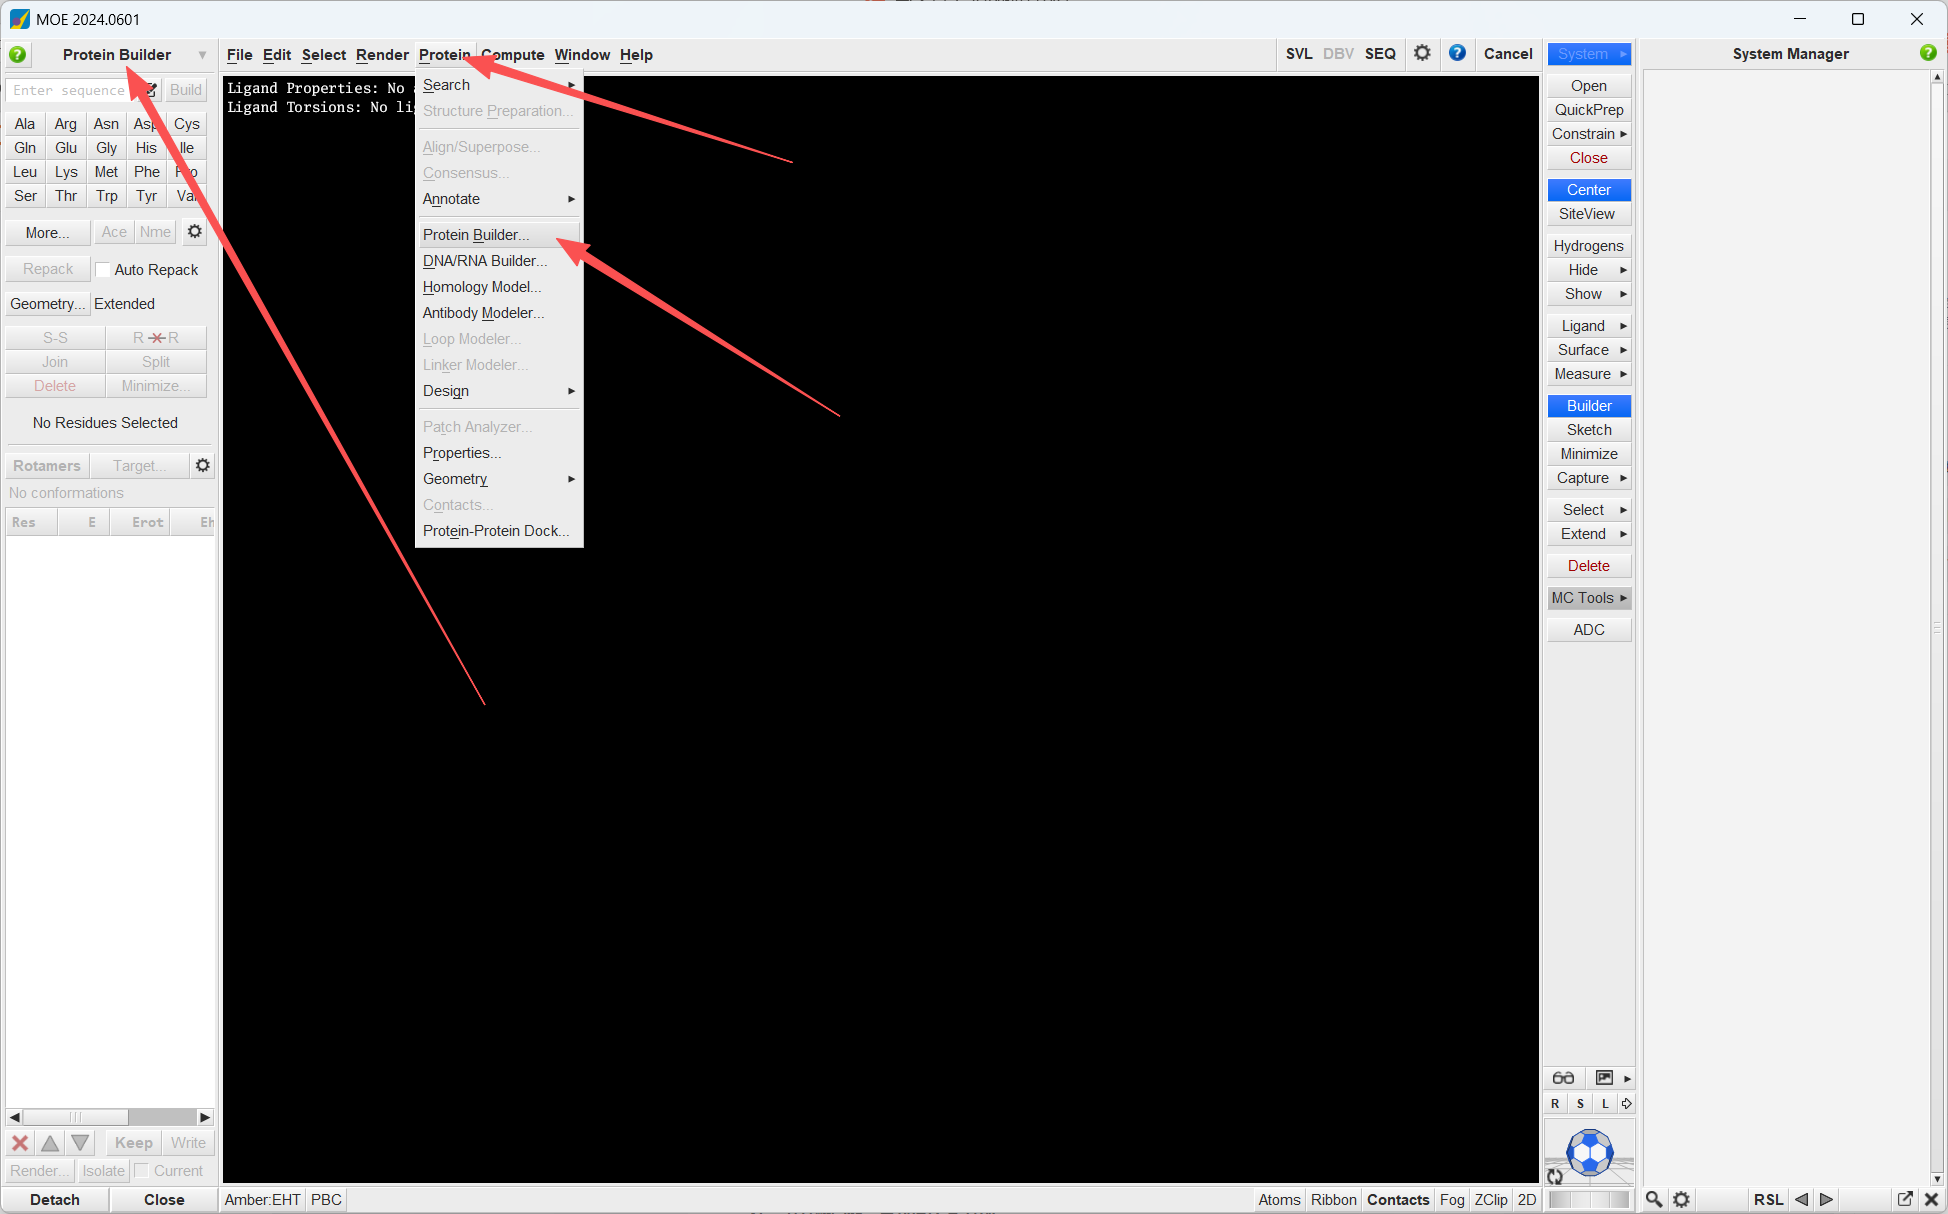
在面板上方可以直接看到 20 种天然氨基酸,同时通过 More... 查看已有的非天然氨基酸。
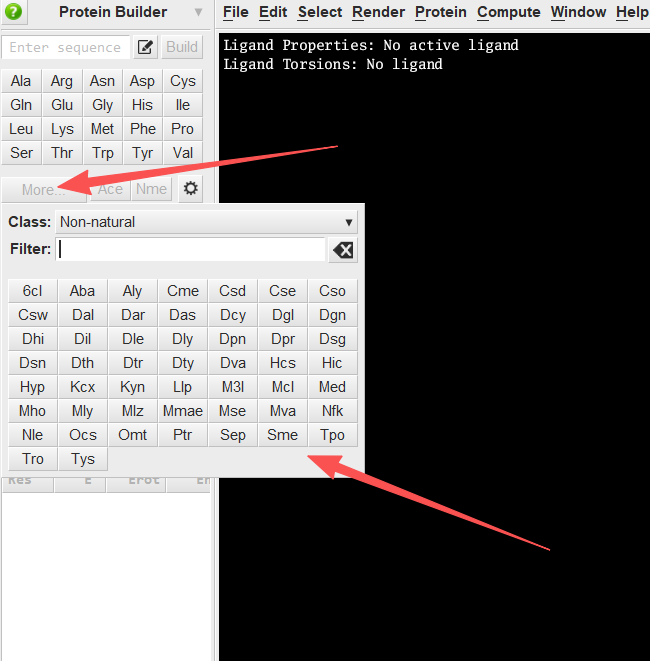
这里我们先选择 Leu。
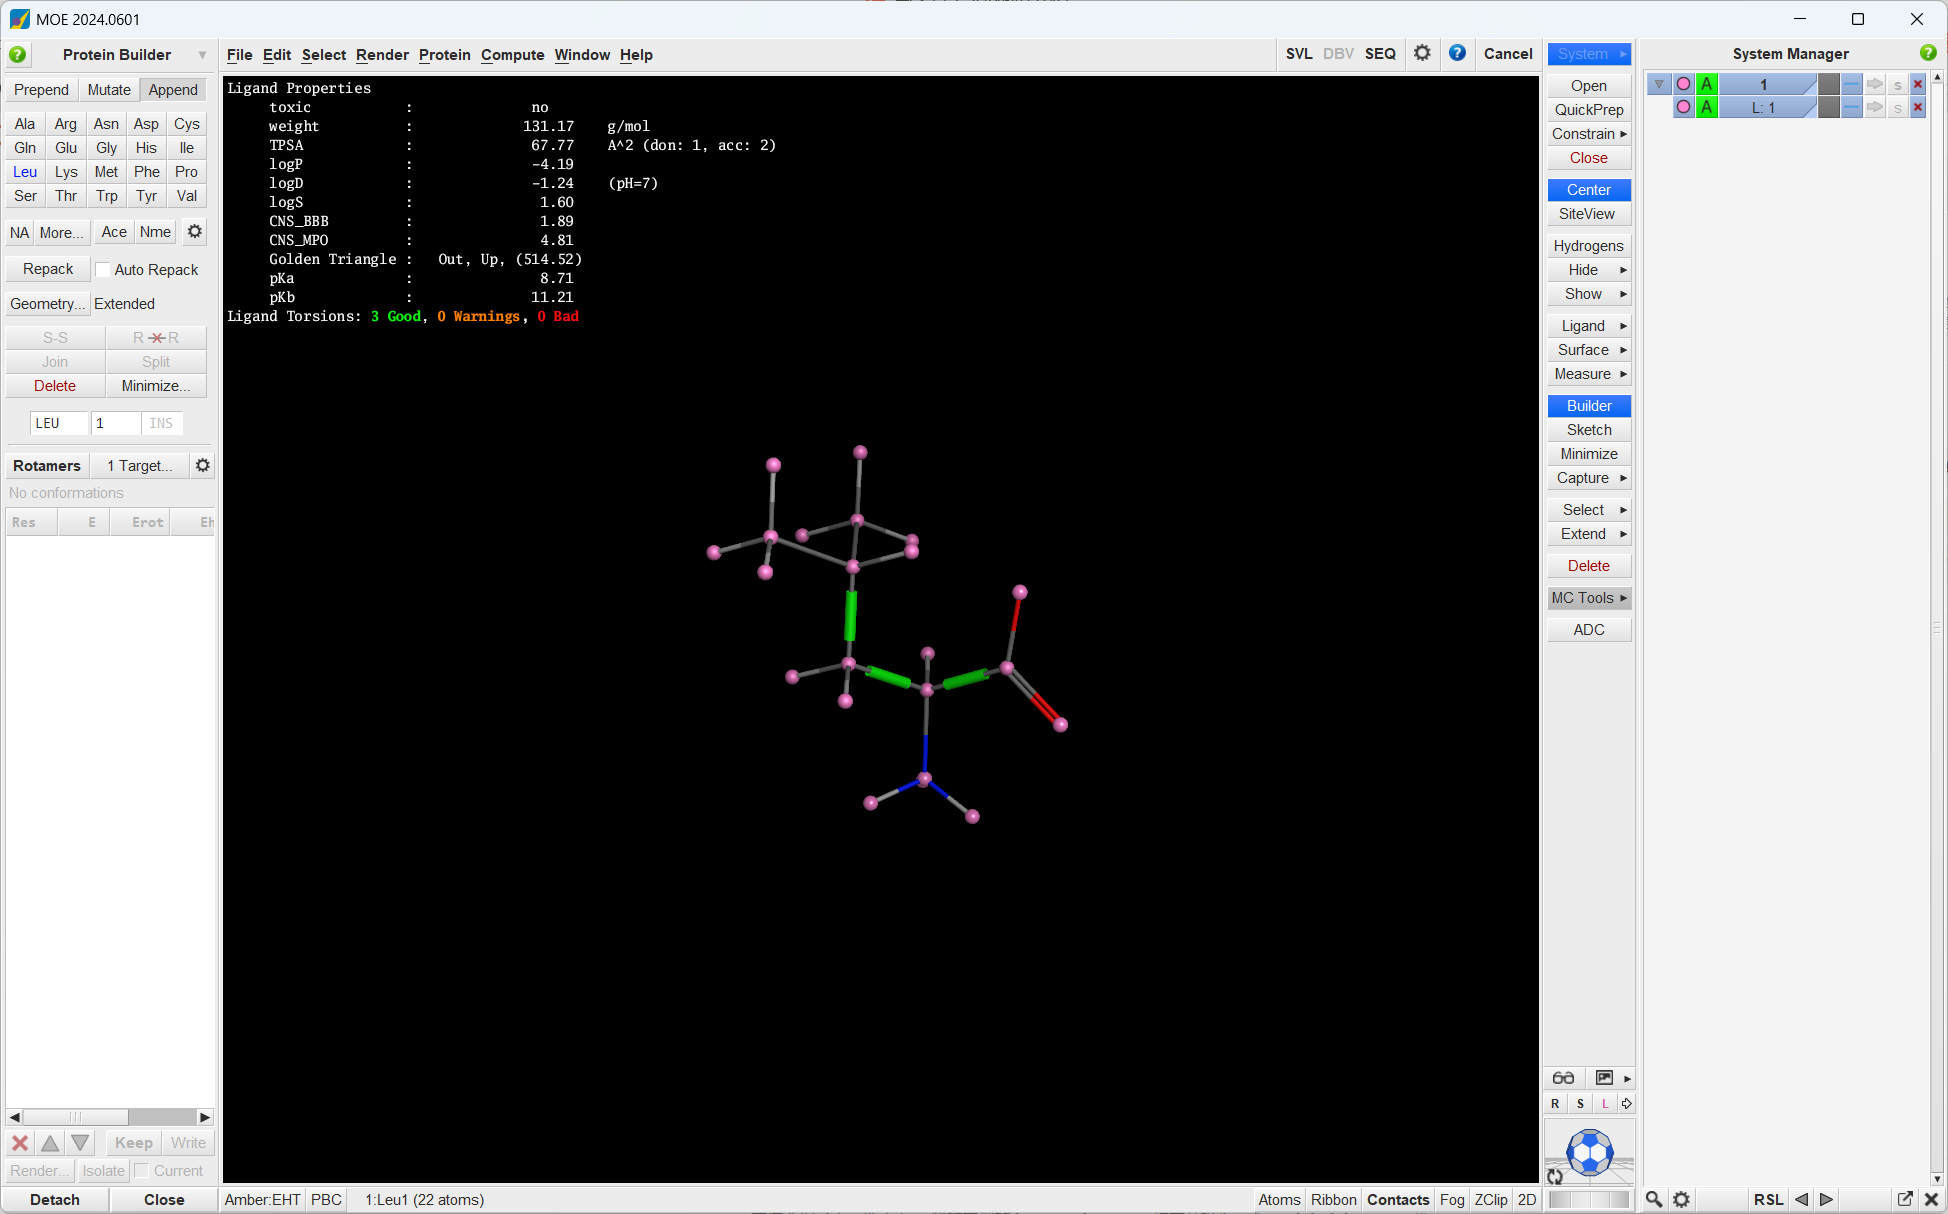
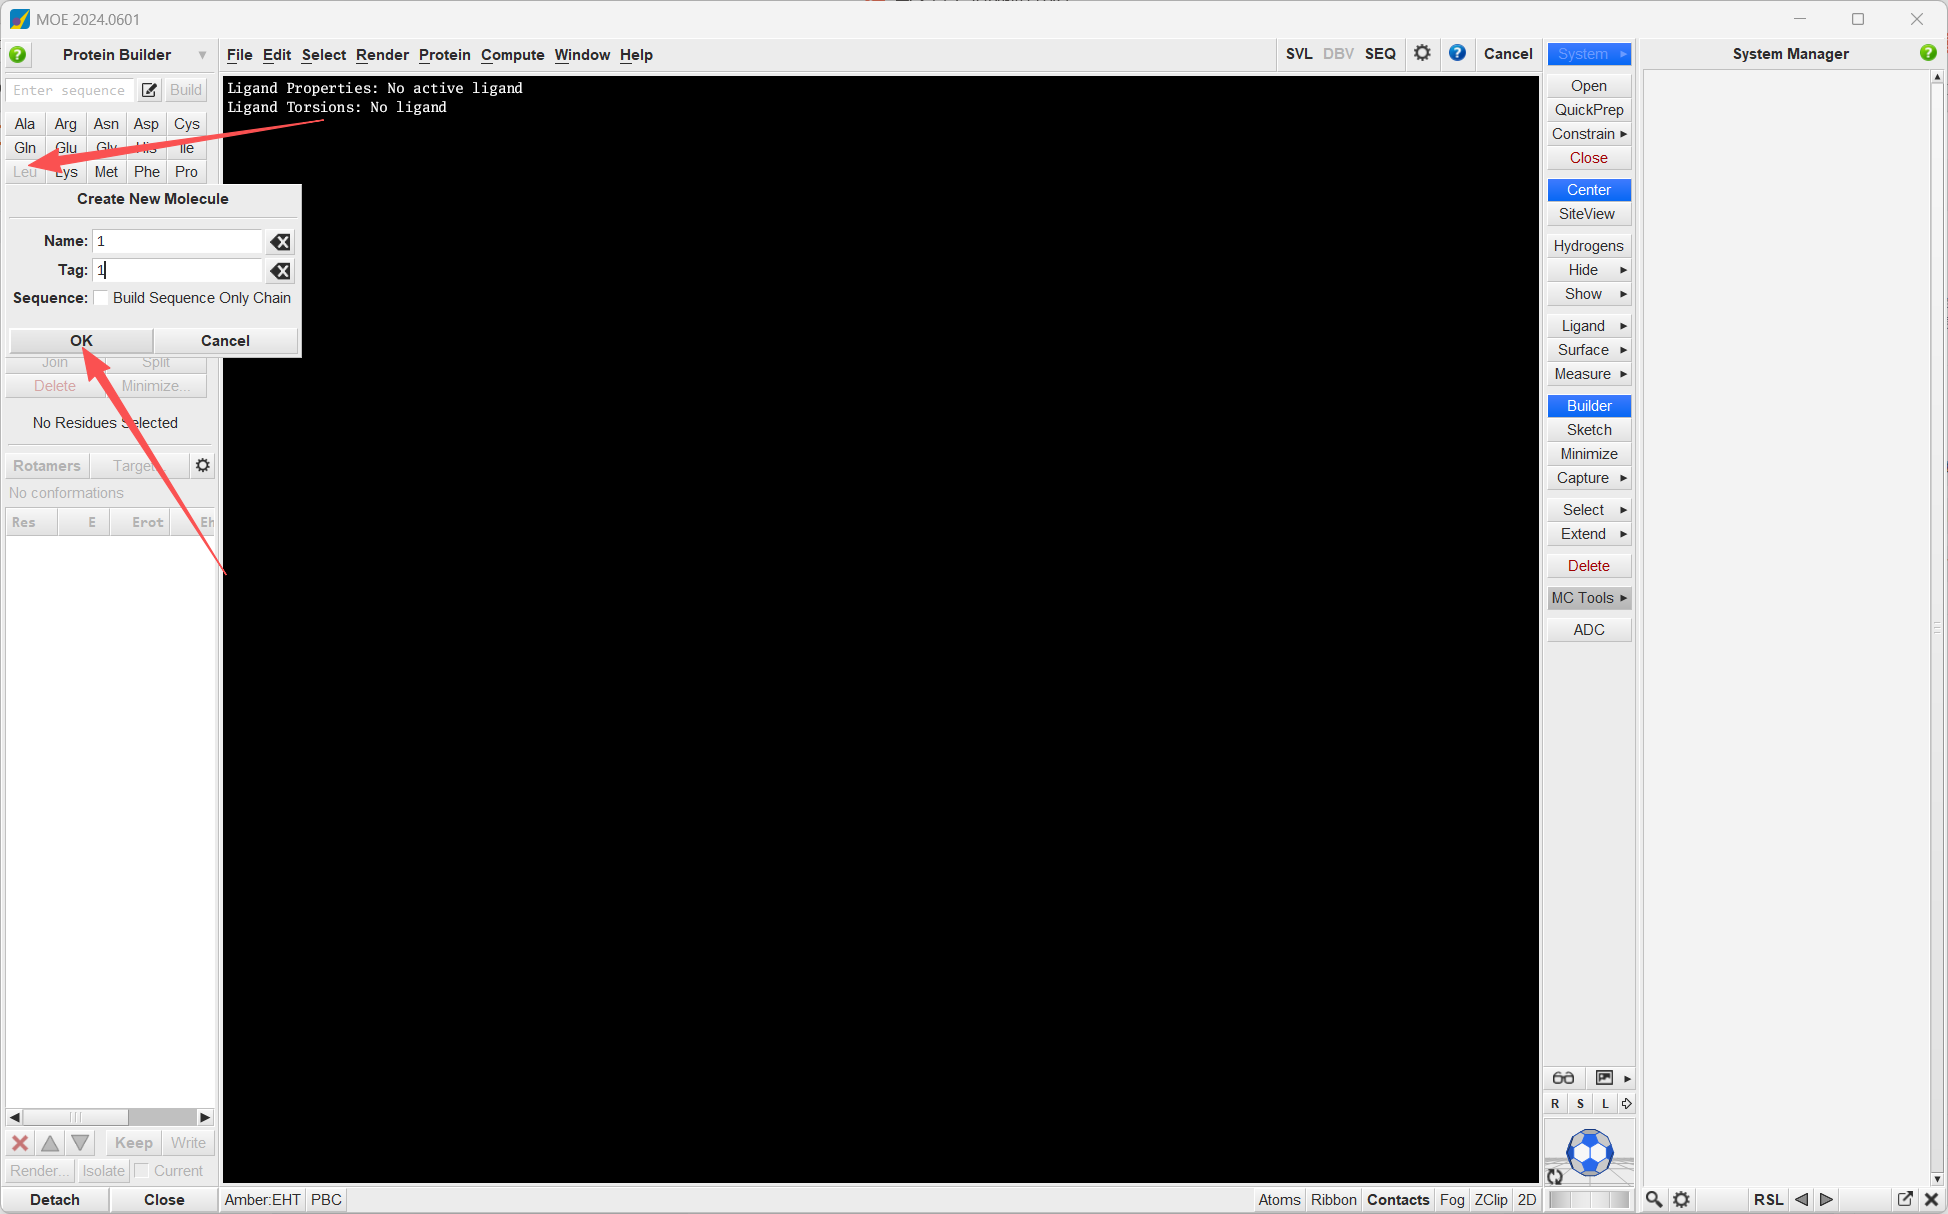 Leu 会作为一个完整的氨基酸结构出现在三维窗口中。
这样做的好处是:
氨基酸主链、手性中心以及基本成键关系已经存在,我们只需要修改侧链。
第二步:从 Leu 构建 CYC4
首先给当前 residue 设置一个新的名称,例如:
CYC4
随后切换:
Protein Builder → Molecule Builder
接下来就不再把它当作"Leu"整体处理,而是直接编辑原子结构。
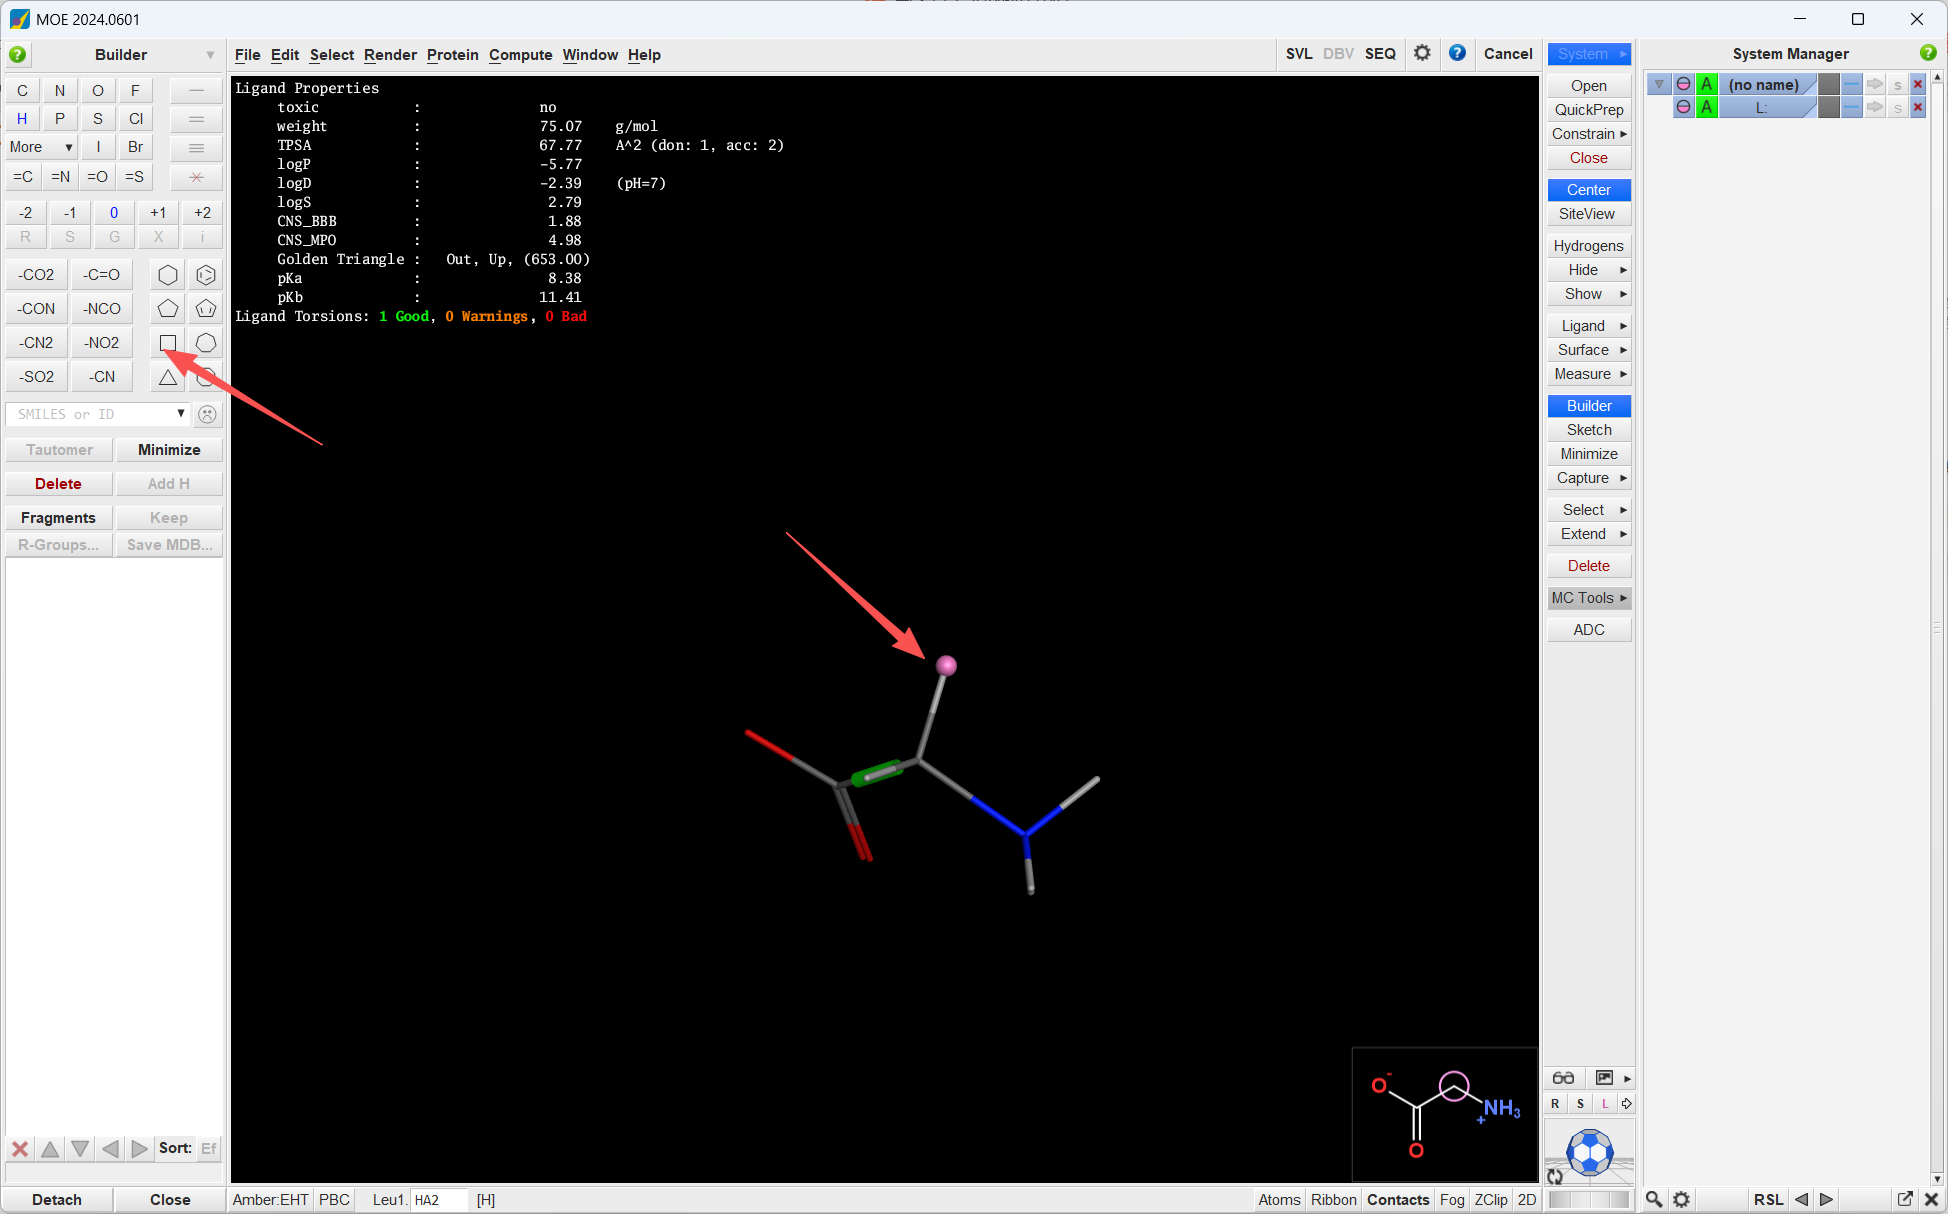
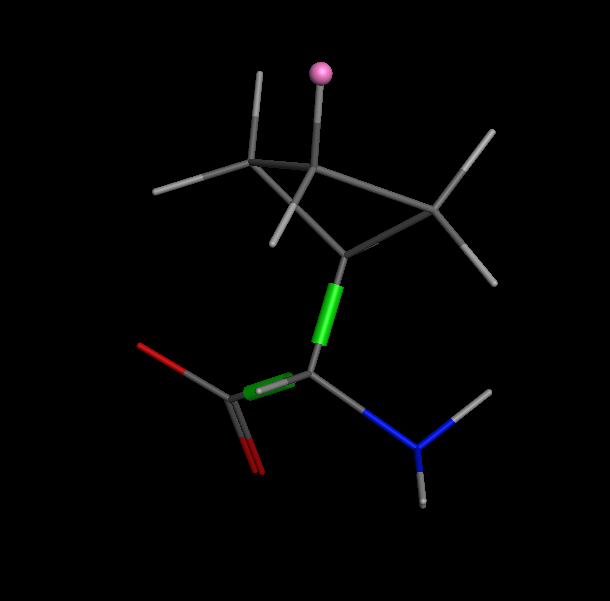
在这个例子中,选中 Leu 侧链末端的 isopropyl group ,将其替换为一个 cyclobutyl group,然后执行一次 Minimize。
于是,原来的天然 Leu 侧链被改造成一个新的环状侧链。
这一步体现了建立非天然氨基酸最核心的思路:
保留氨基酸骨架,重新设计 R 基团。
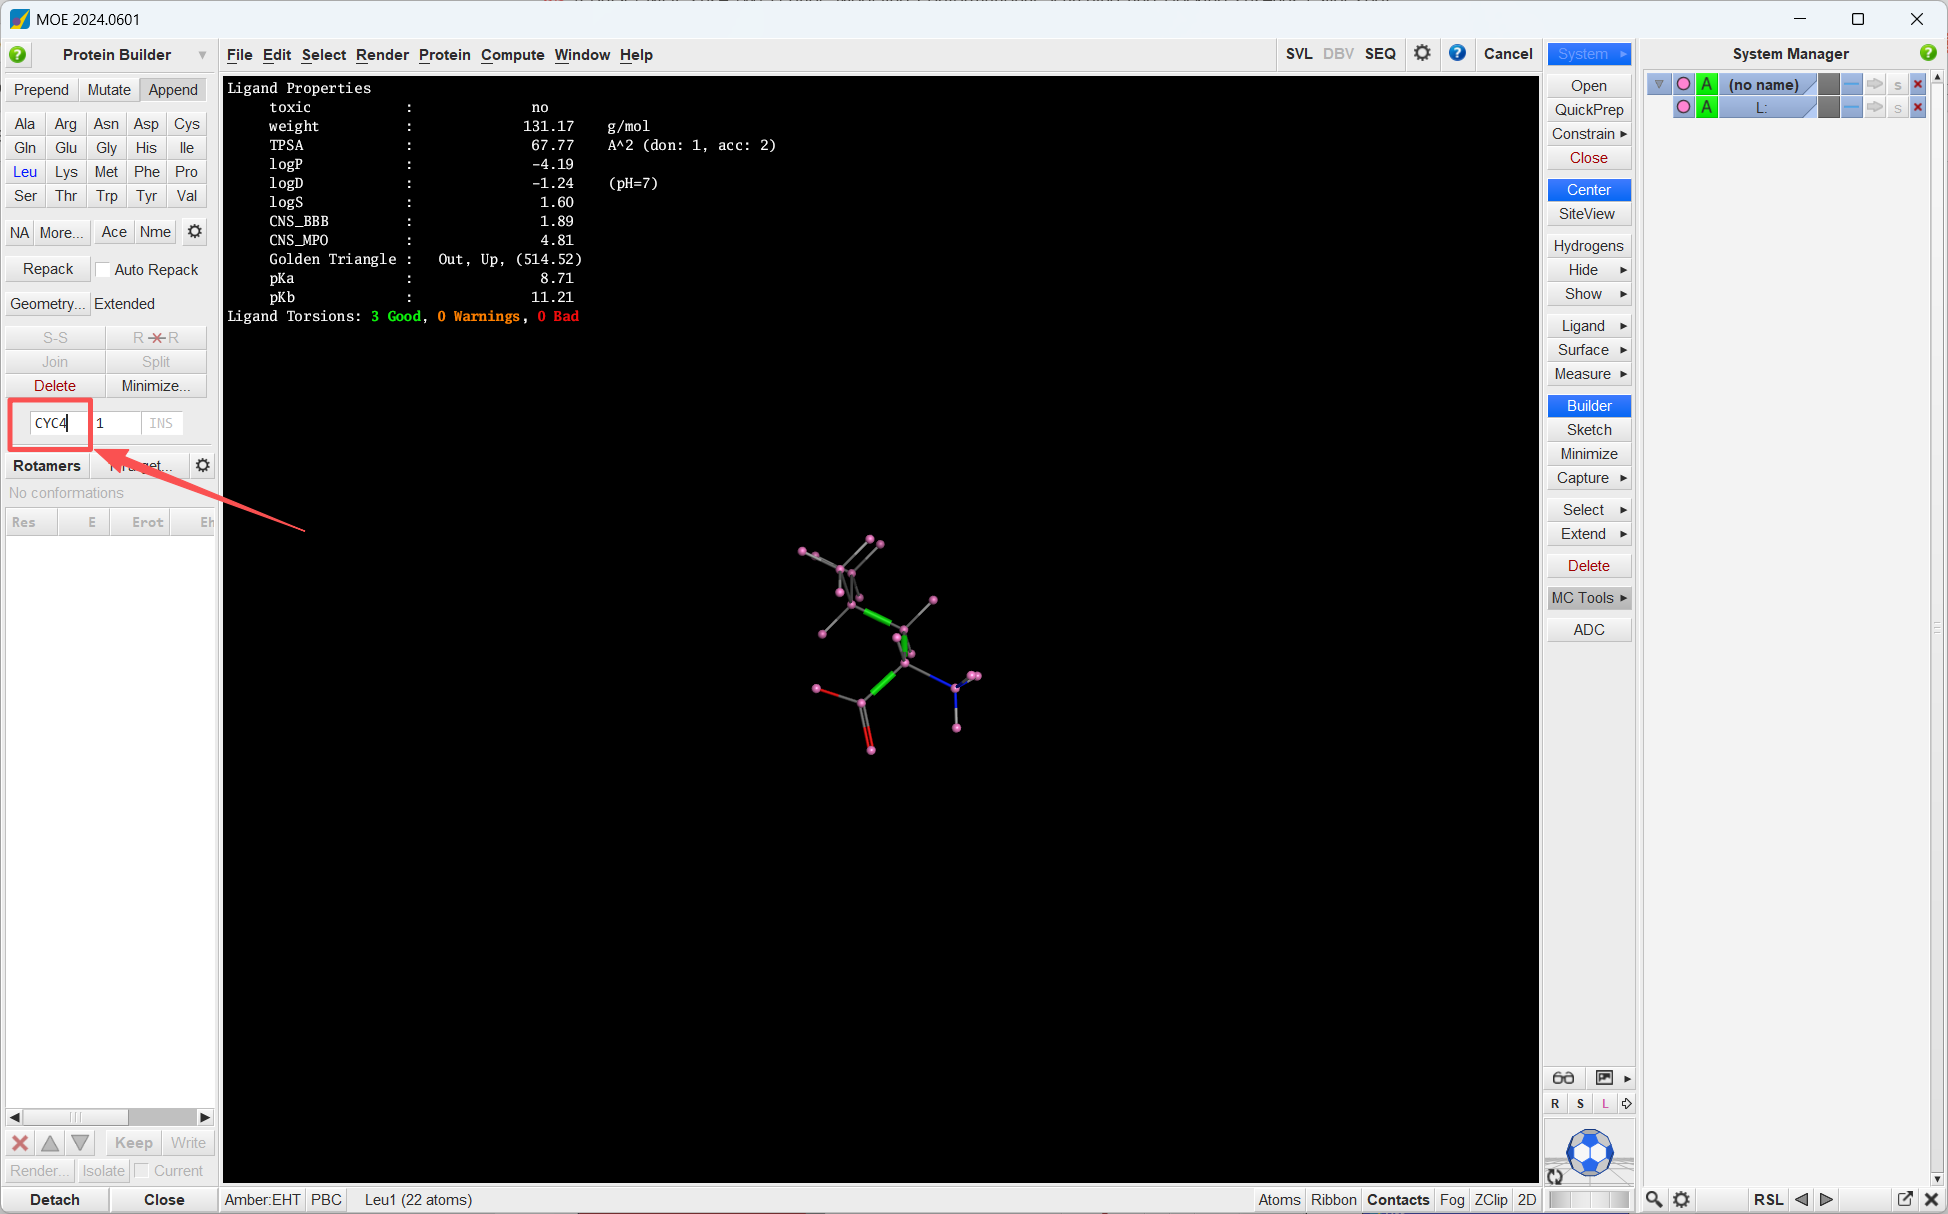
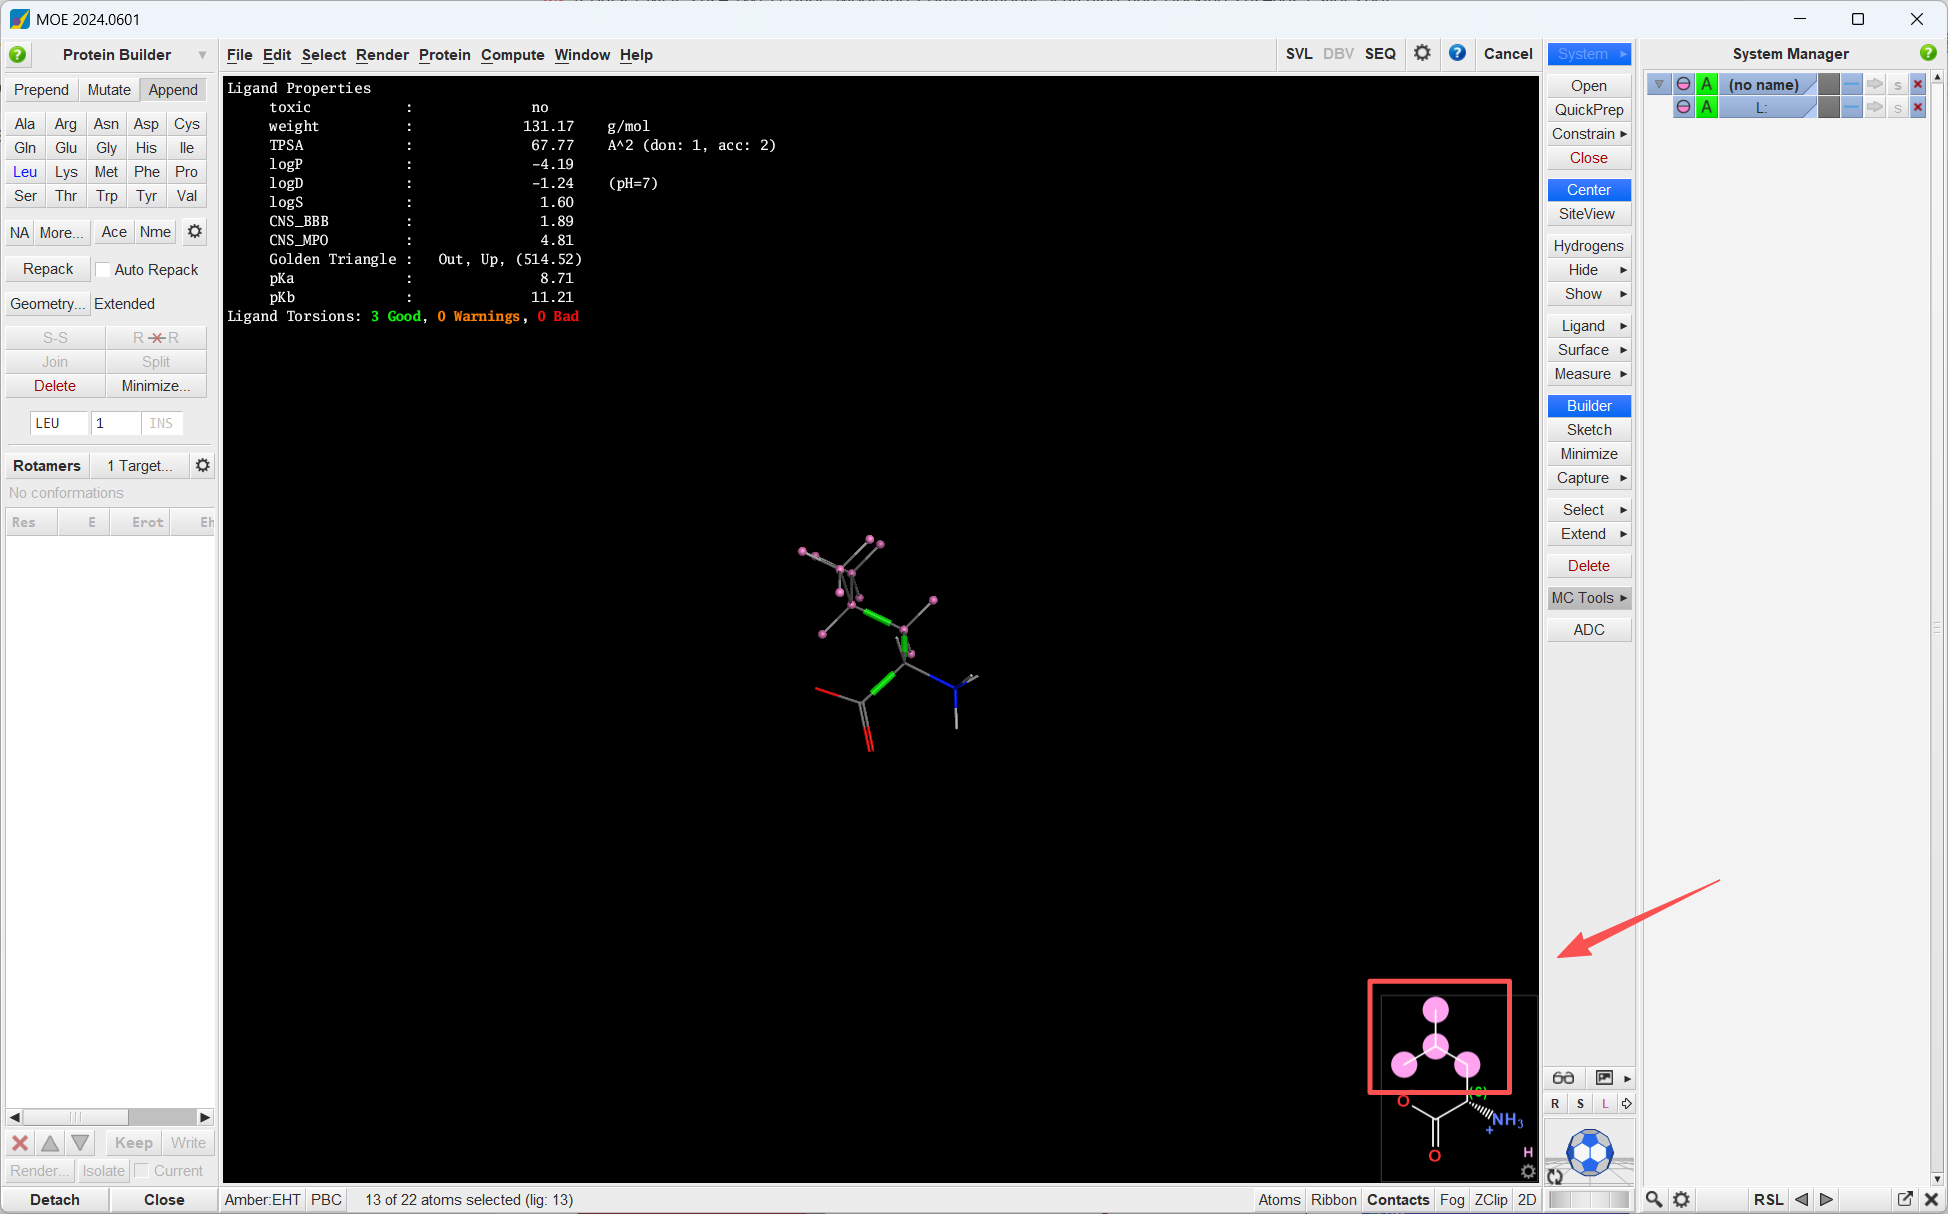
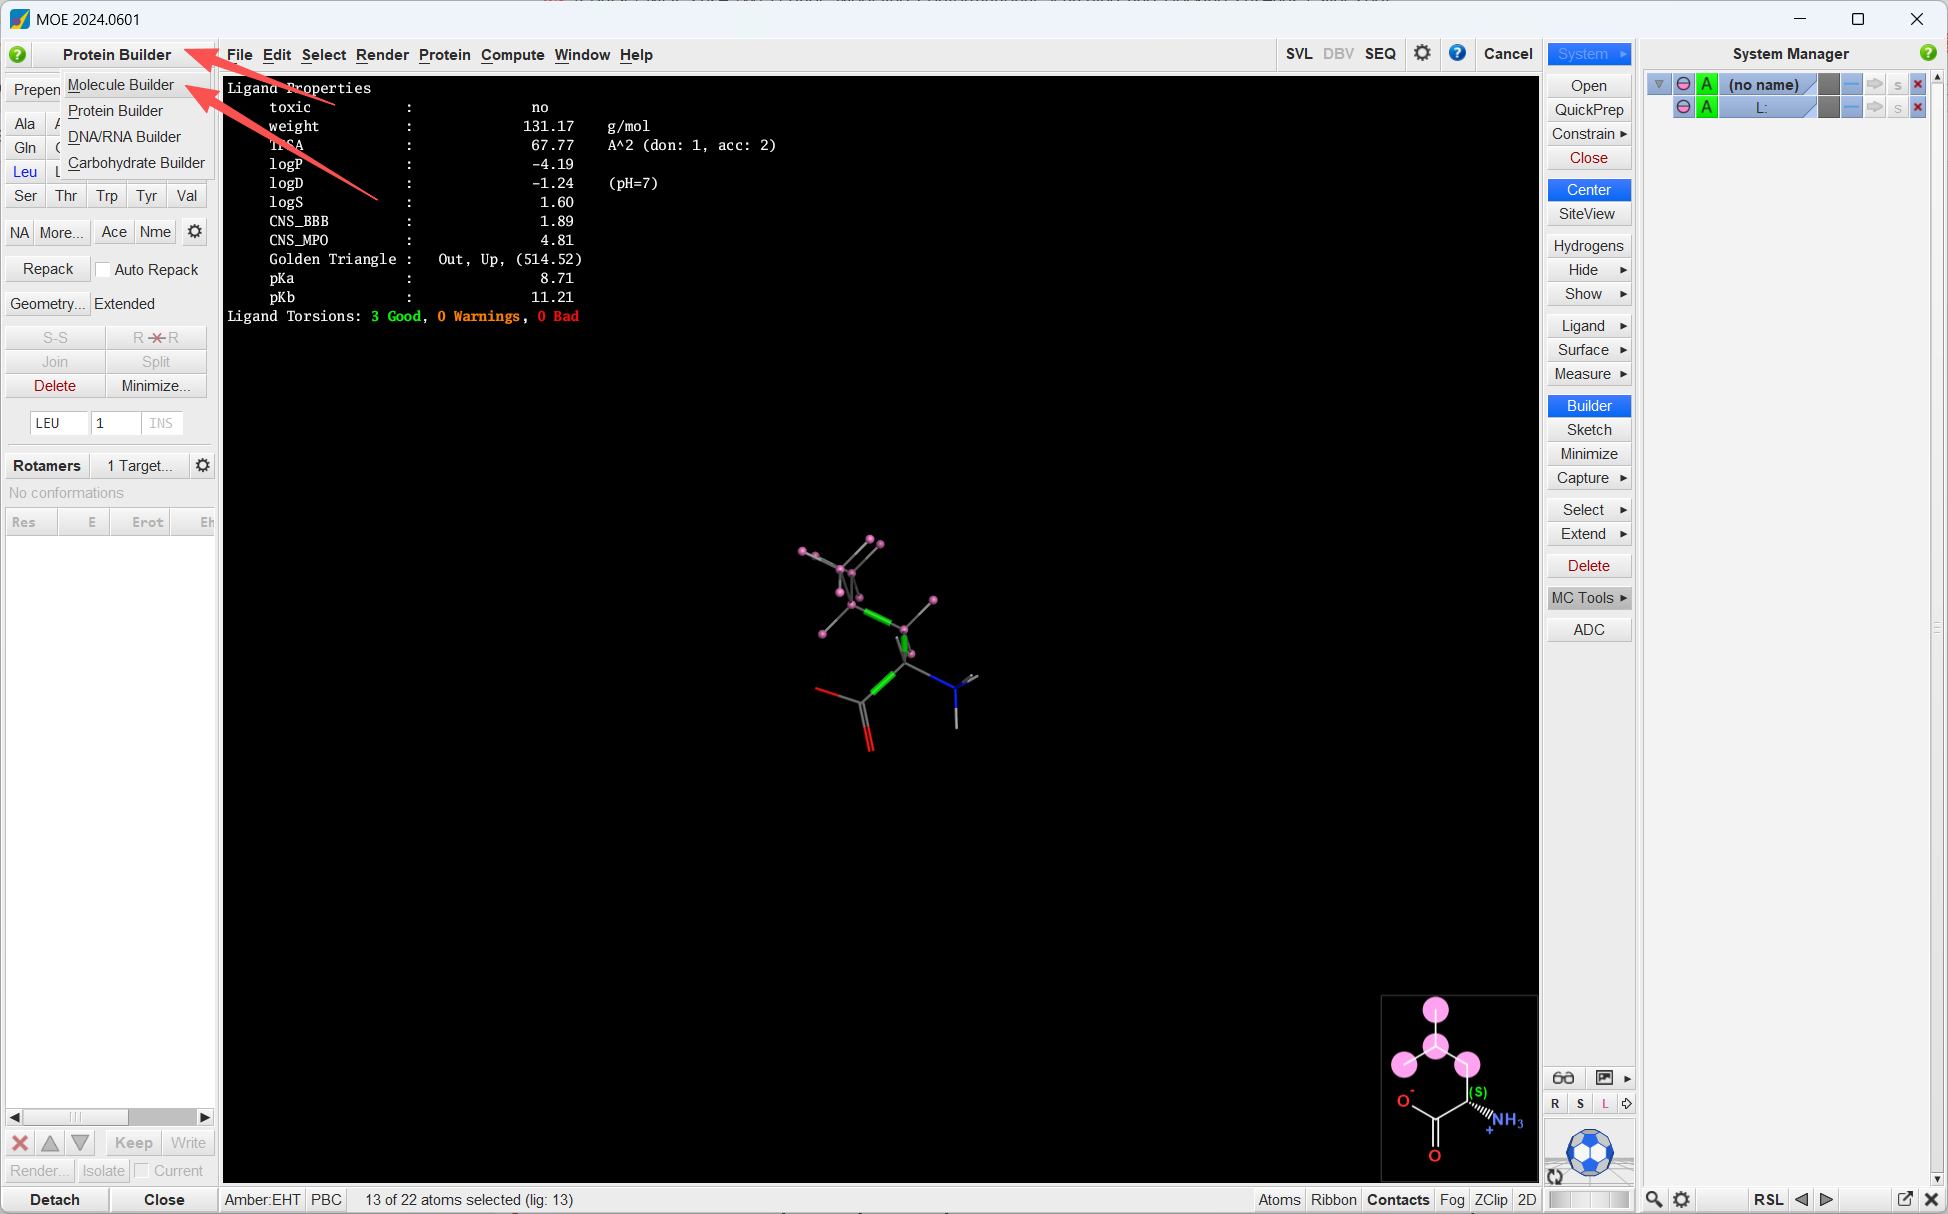
删除基团。点击生成环丁烷。
第三步:把新残基保存到数据库
现在屏幕里虽然已经有了 CYC4 的结构,但它目前只是一个分子。
要想后续反复调用,需要建立一个 MOE database。
通过:
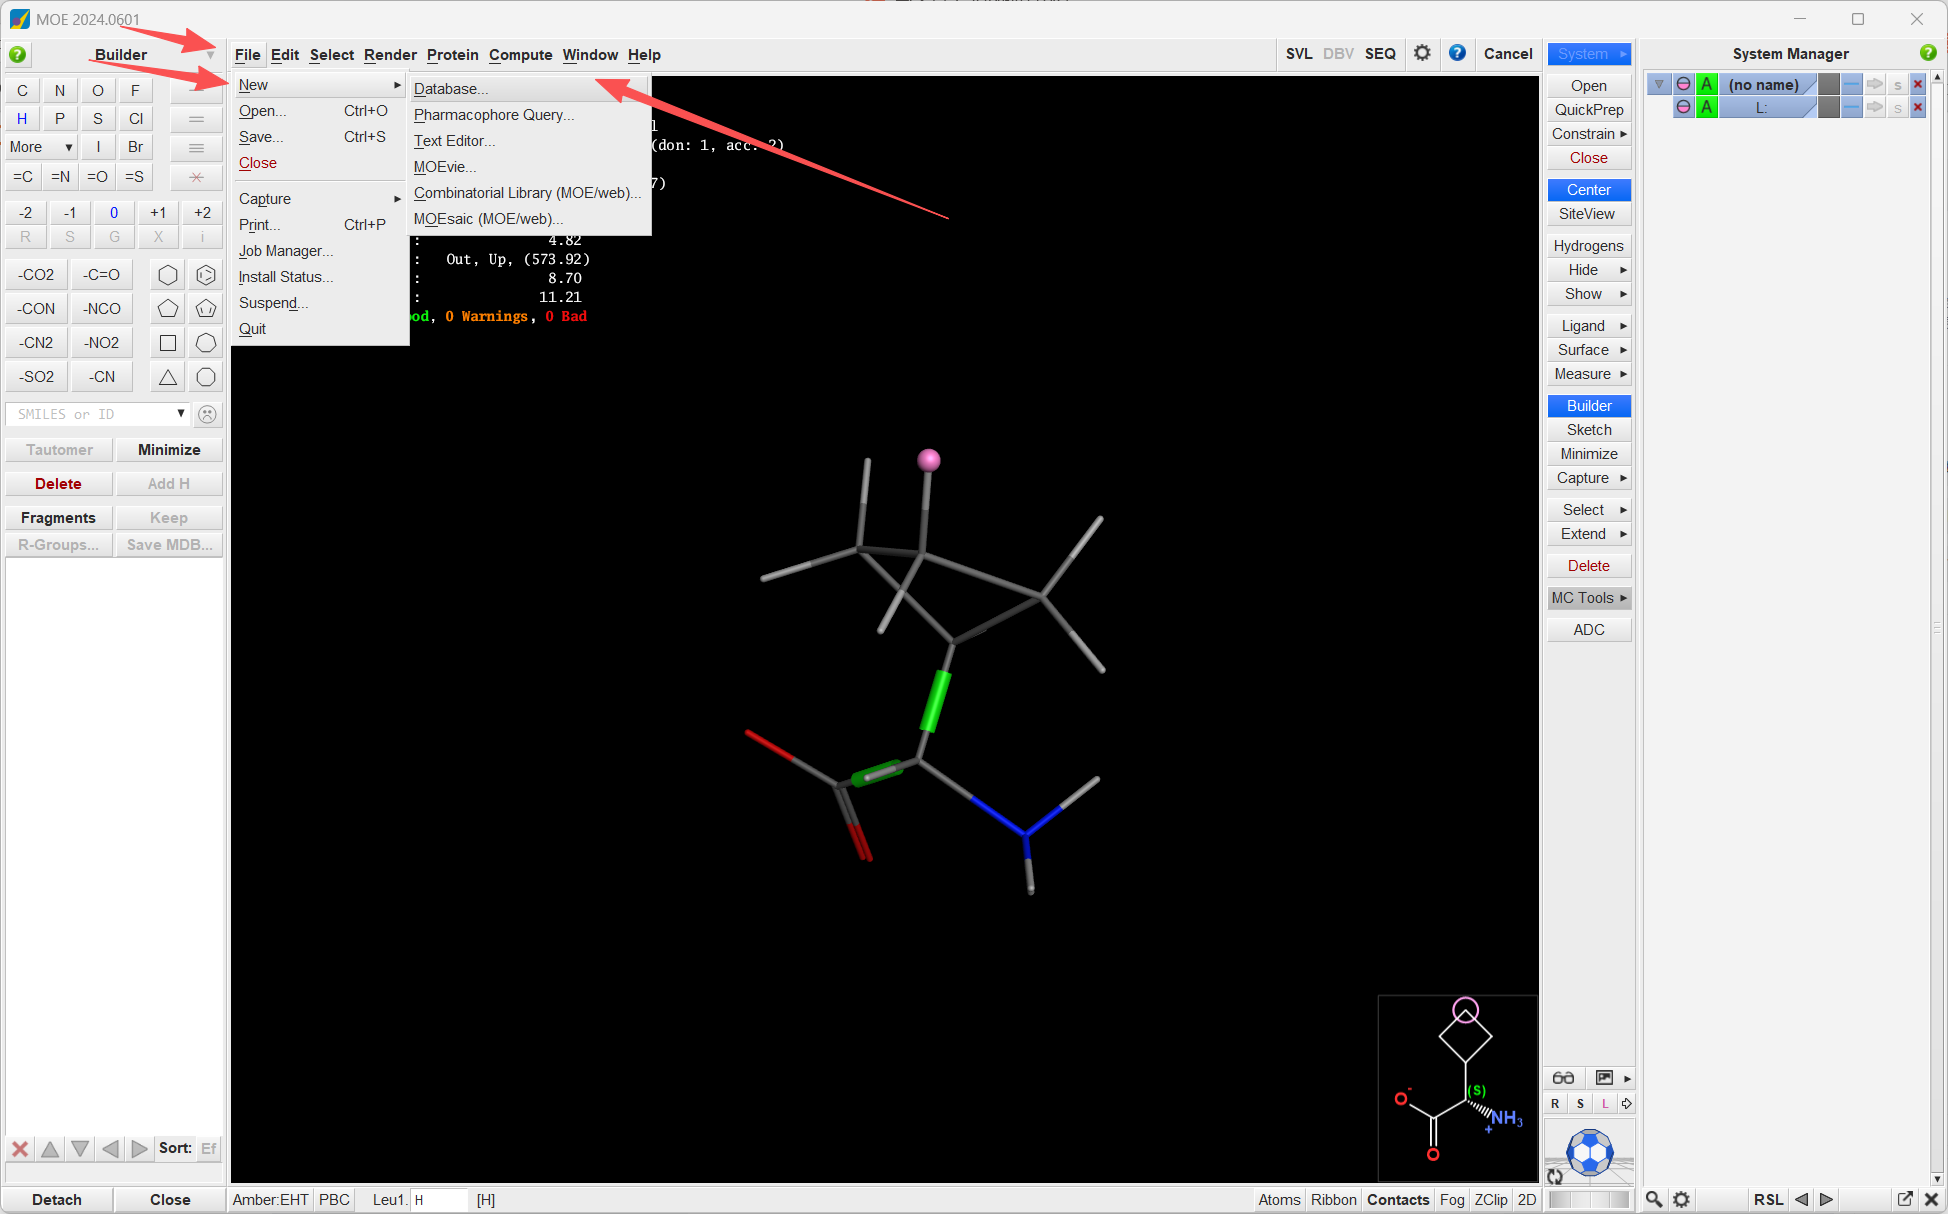
File → New → Database
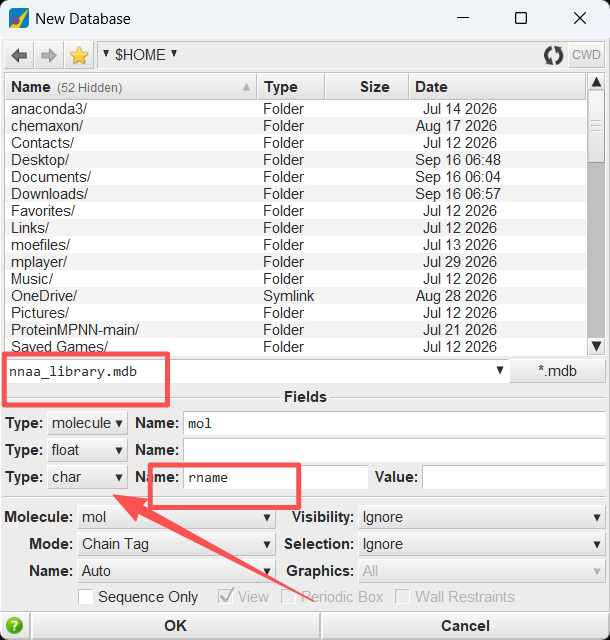
创建新的数据库,例如:
nnaa_library.mdb
并加入一个字符字段:
rName
用于保存 residue name。
数据库中默认会保存当前三维结构。
随后在 rName 中输入:
CYC4
这样,"这个三维分子是谁"就被明确记录下来了。
第四步:可以直接修改原子类型和电荷
非天然氨基酸的设计并不局限于"换一个侧链片段"。
还可以直接改变:
-
原子类型;
-
电荷;
-
手性。
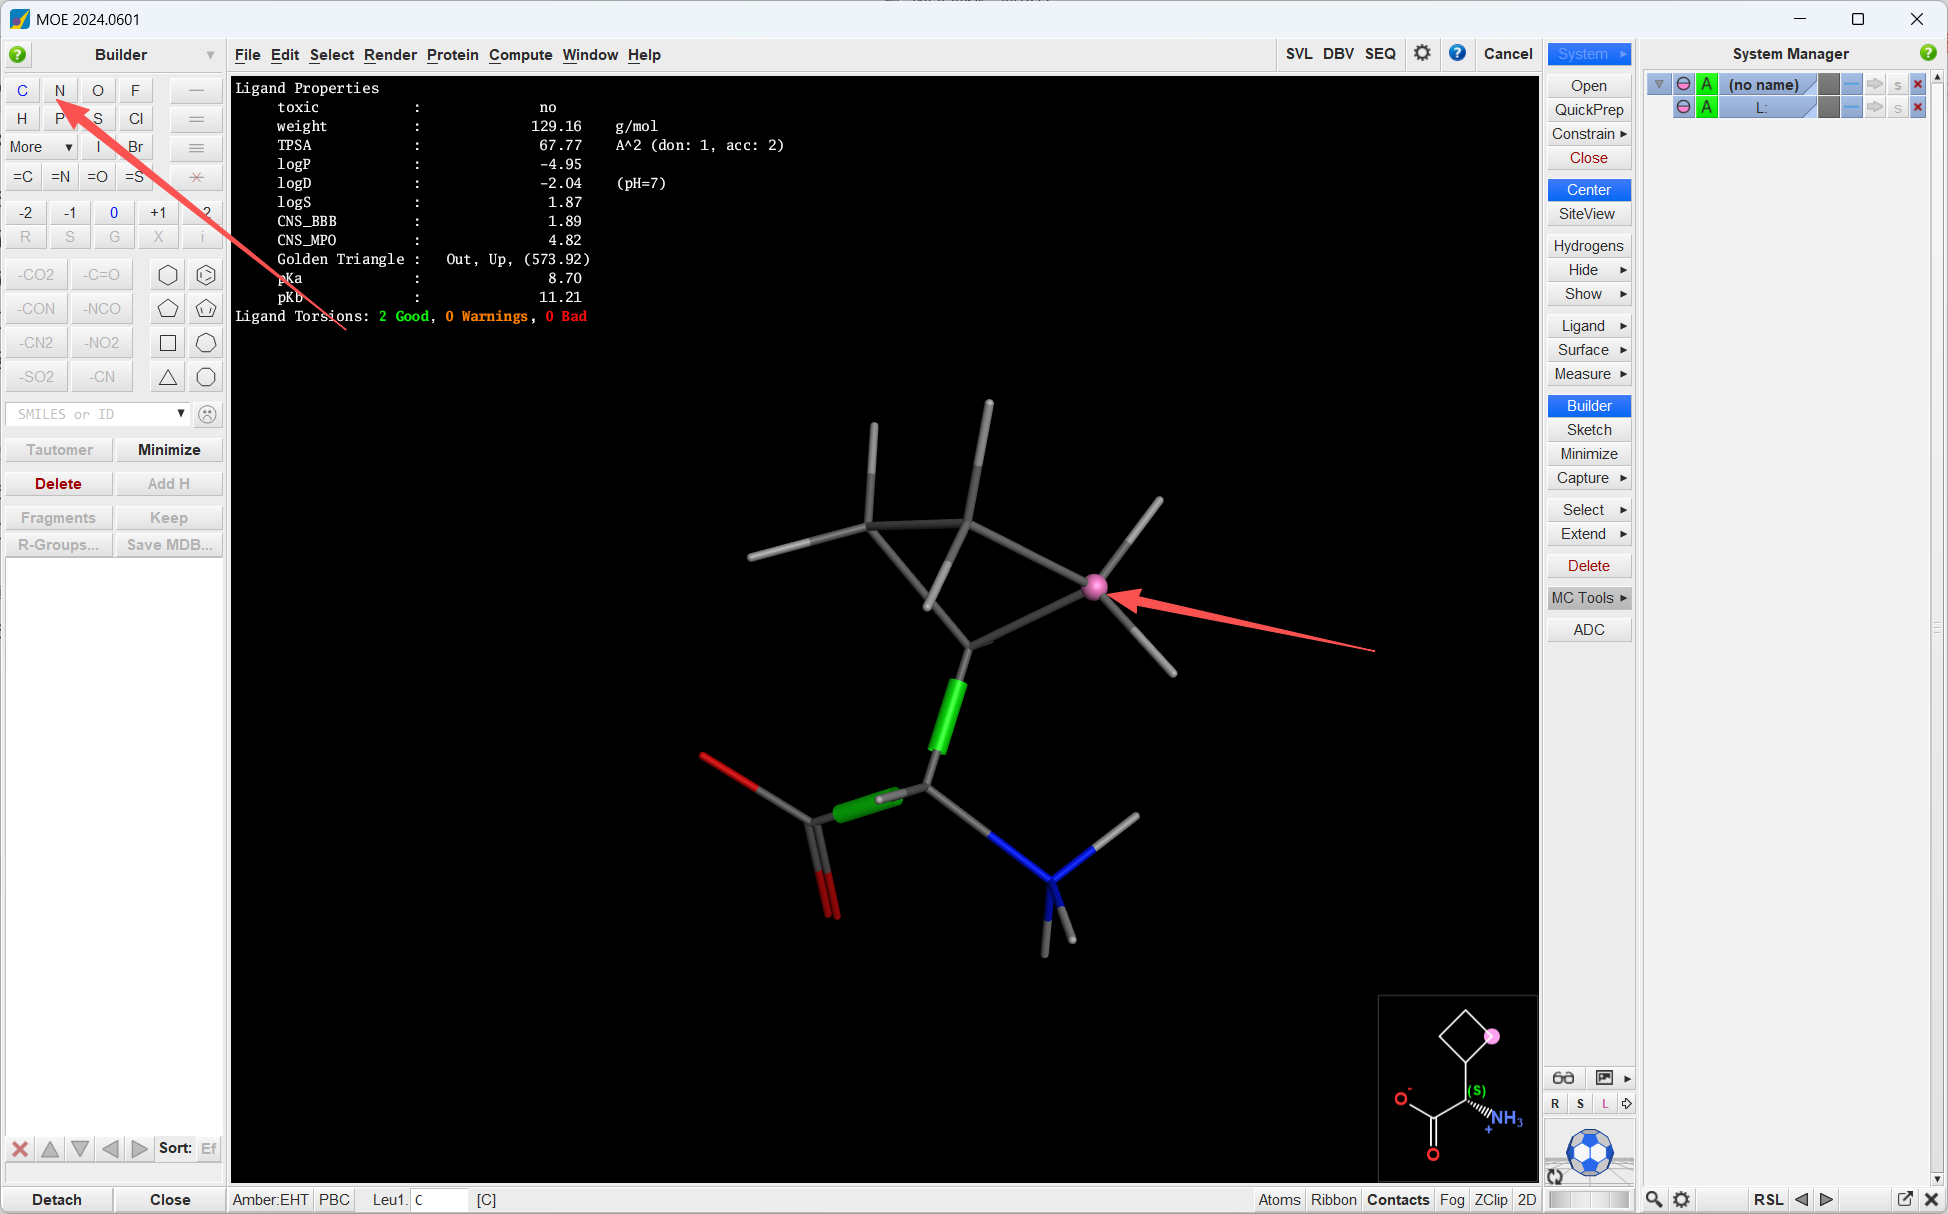
例如构建 AZE2 时,可以选中一个 Carbon,将其修改成 Nitrogen,并进一步设置 +1 charge。
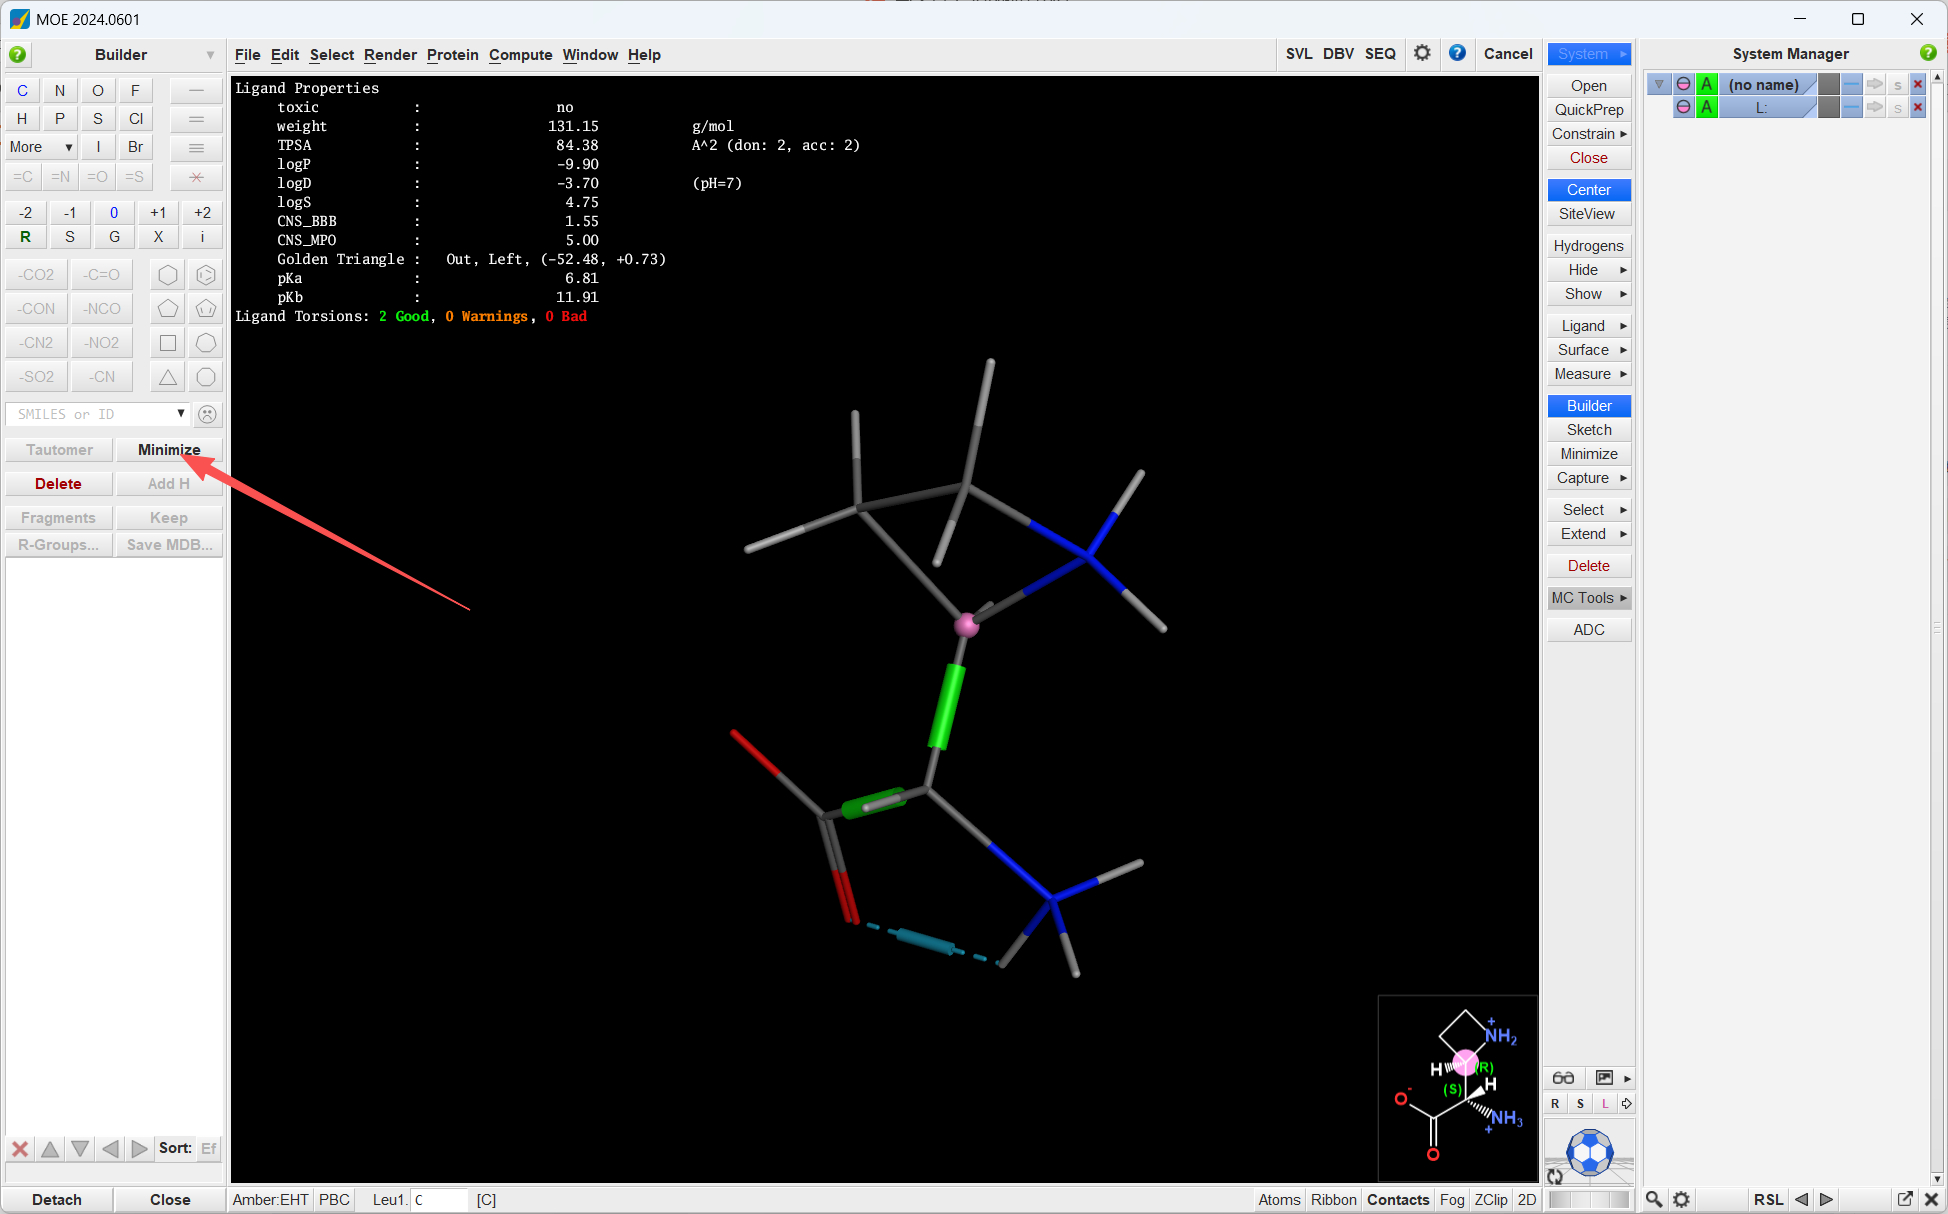
随后还可以检查指定手性中心,将其设置为正确的 R stereochemistry,再进行 Minimize。
这里尤其值得注意:
创建非天然氨基酸不能只关注二维结构是否画对。
立体化学同样是结构定义的一部分。
如果手性中心设置错误,那么后面生成的三维构象、Rotamer 甚至 Protein Design 结果都会发生变化。
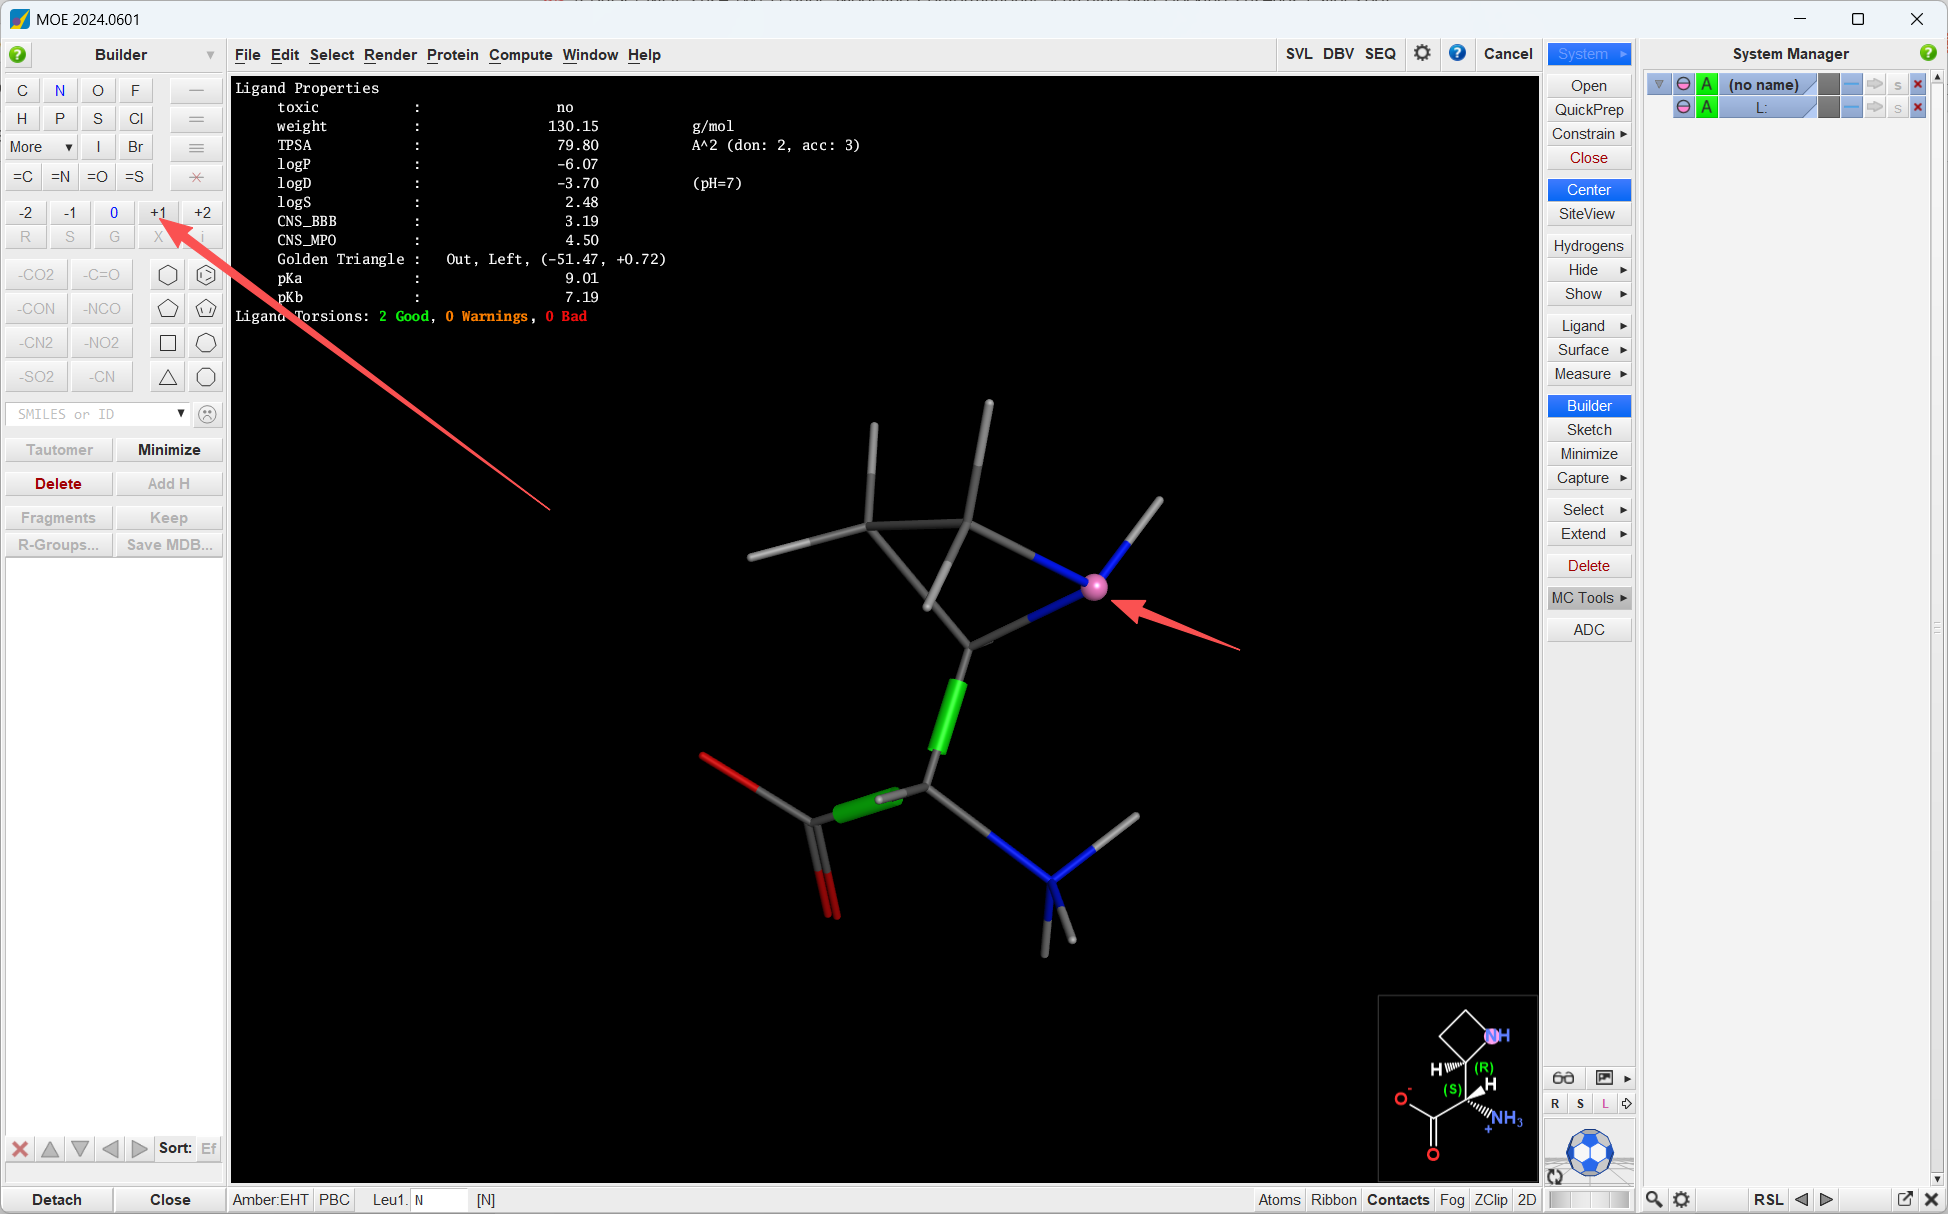
例如构建 AZE2 时,可以选中一个 Carbon,将其修改成 Nitrogen,并进一步设置 +1 charge。
随后还可以检查指定手性中心,将其设置为正确的 R stereochemistry,再进行 Minimize。
这里尤其值得注意:
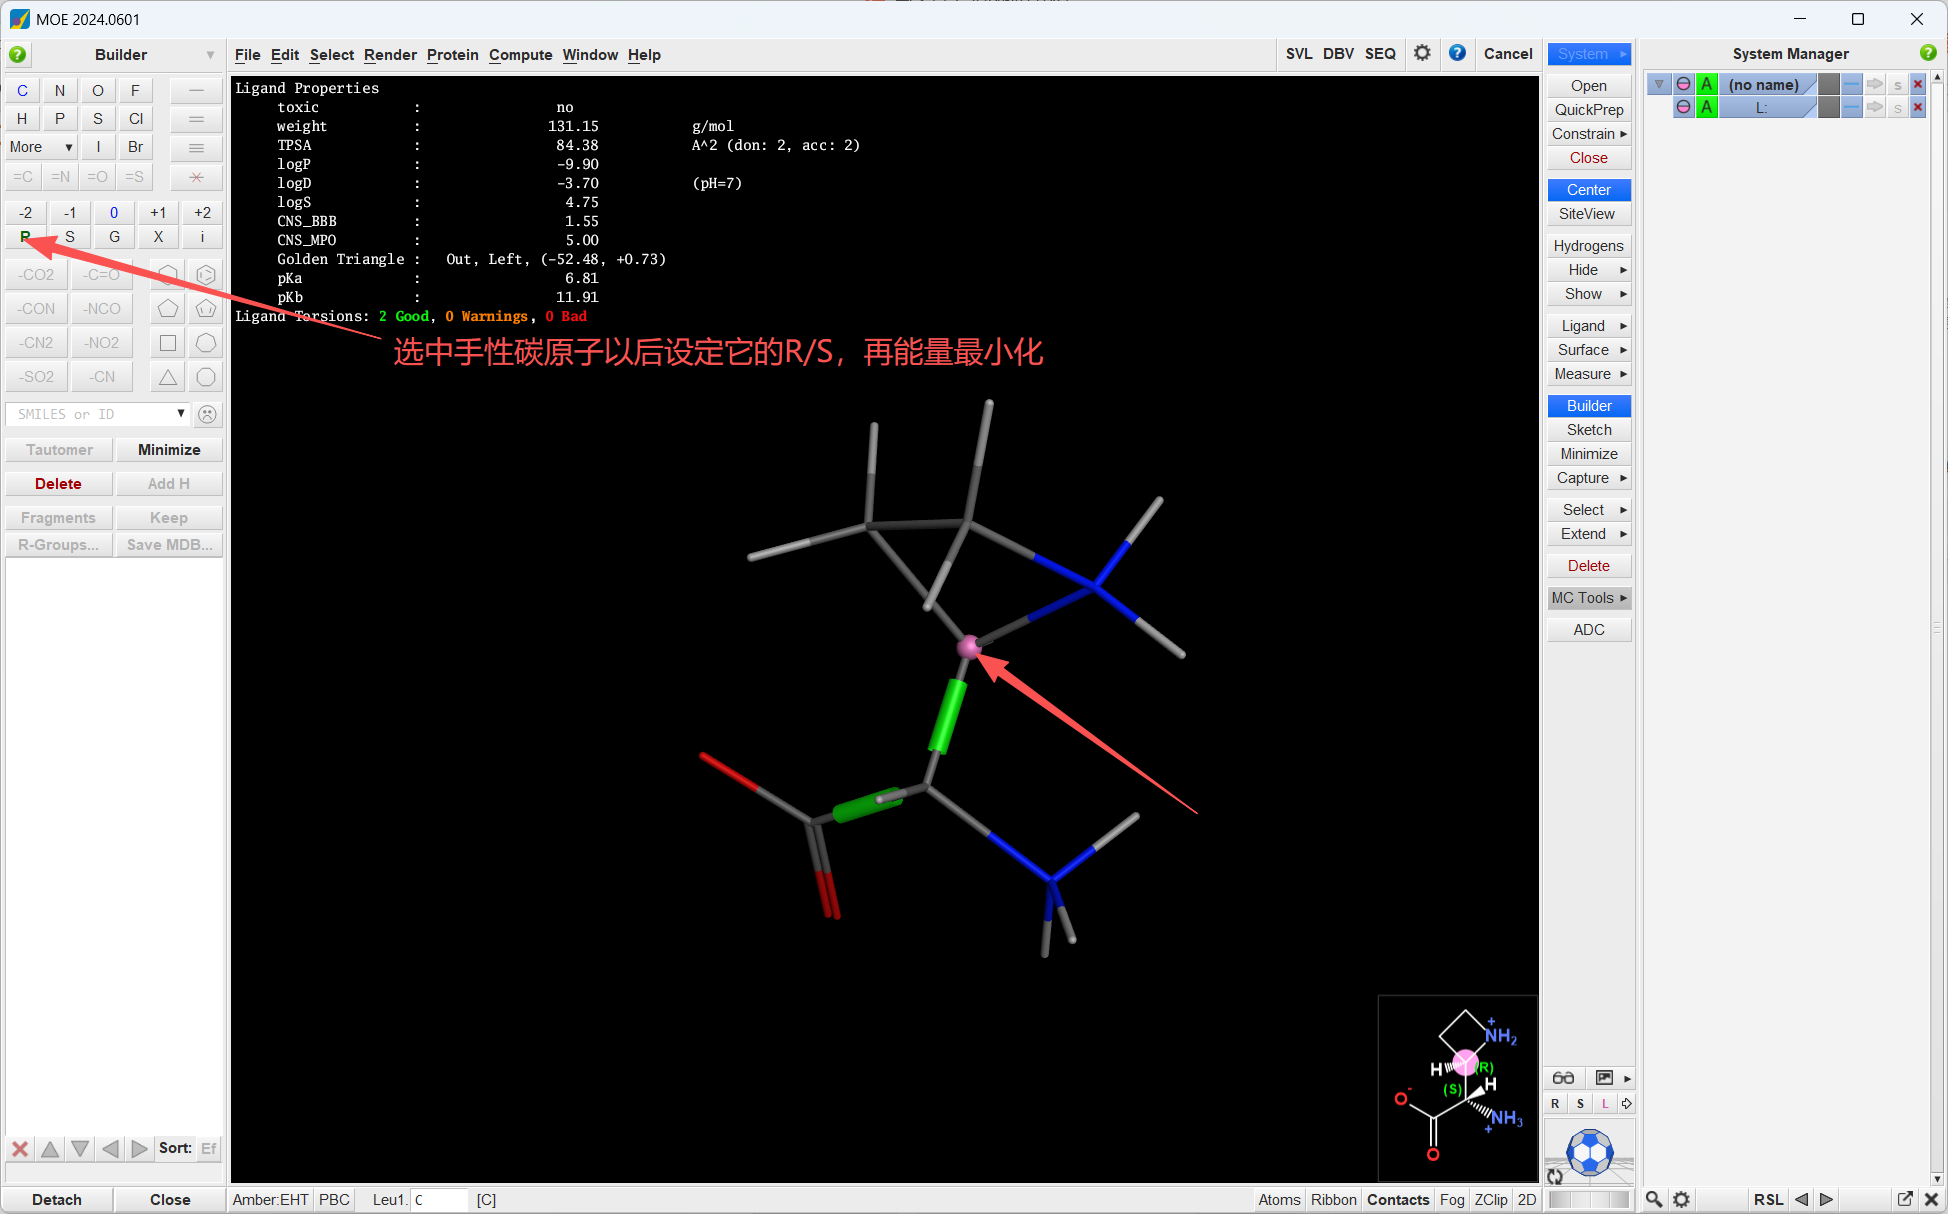
创建非天然氨基酸不能只关注二维结构是否画对。
立体化学同样是结构定义的一部分。
如果手性中心设置错误,那么后面生成的三维构象、Rotamer 甚至 Protein Design 结果都会发生变化。
第五步:把多个非天然残基放进同一个库
完成 AZE2 后,可以重新切换回 Protein Builder,为当前结构设置 residue name:
AZE2
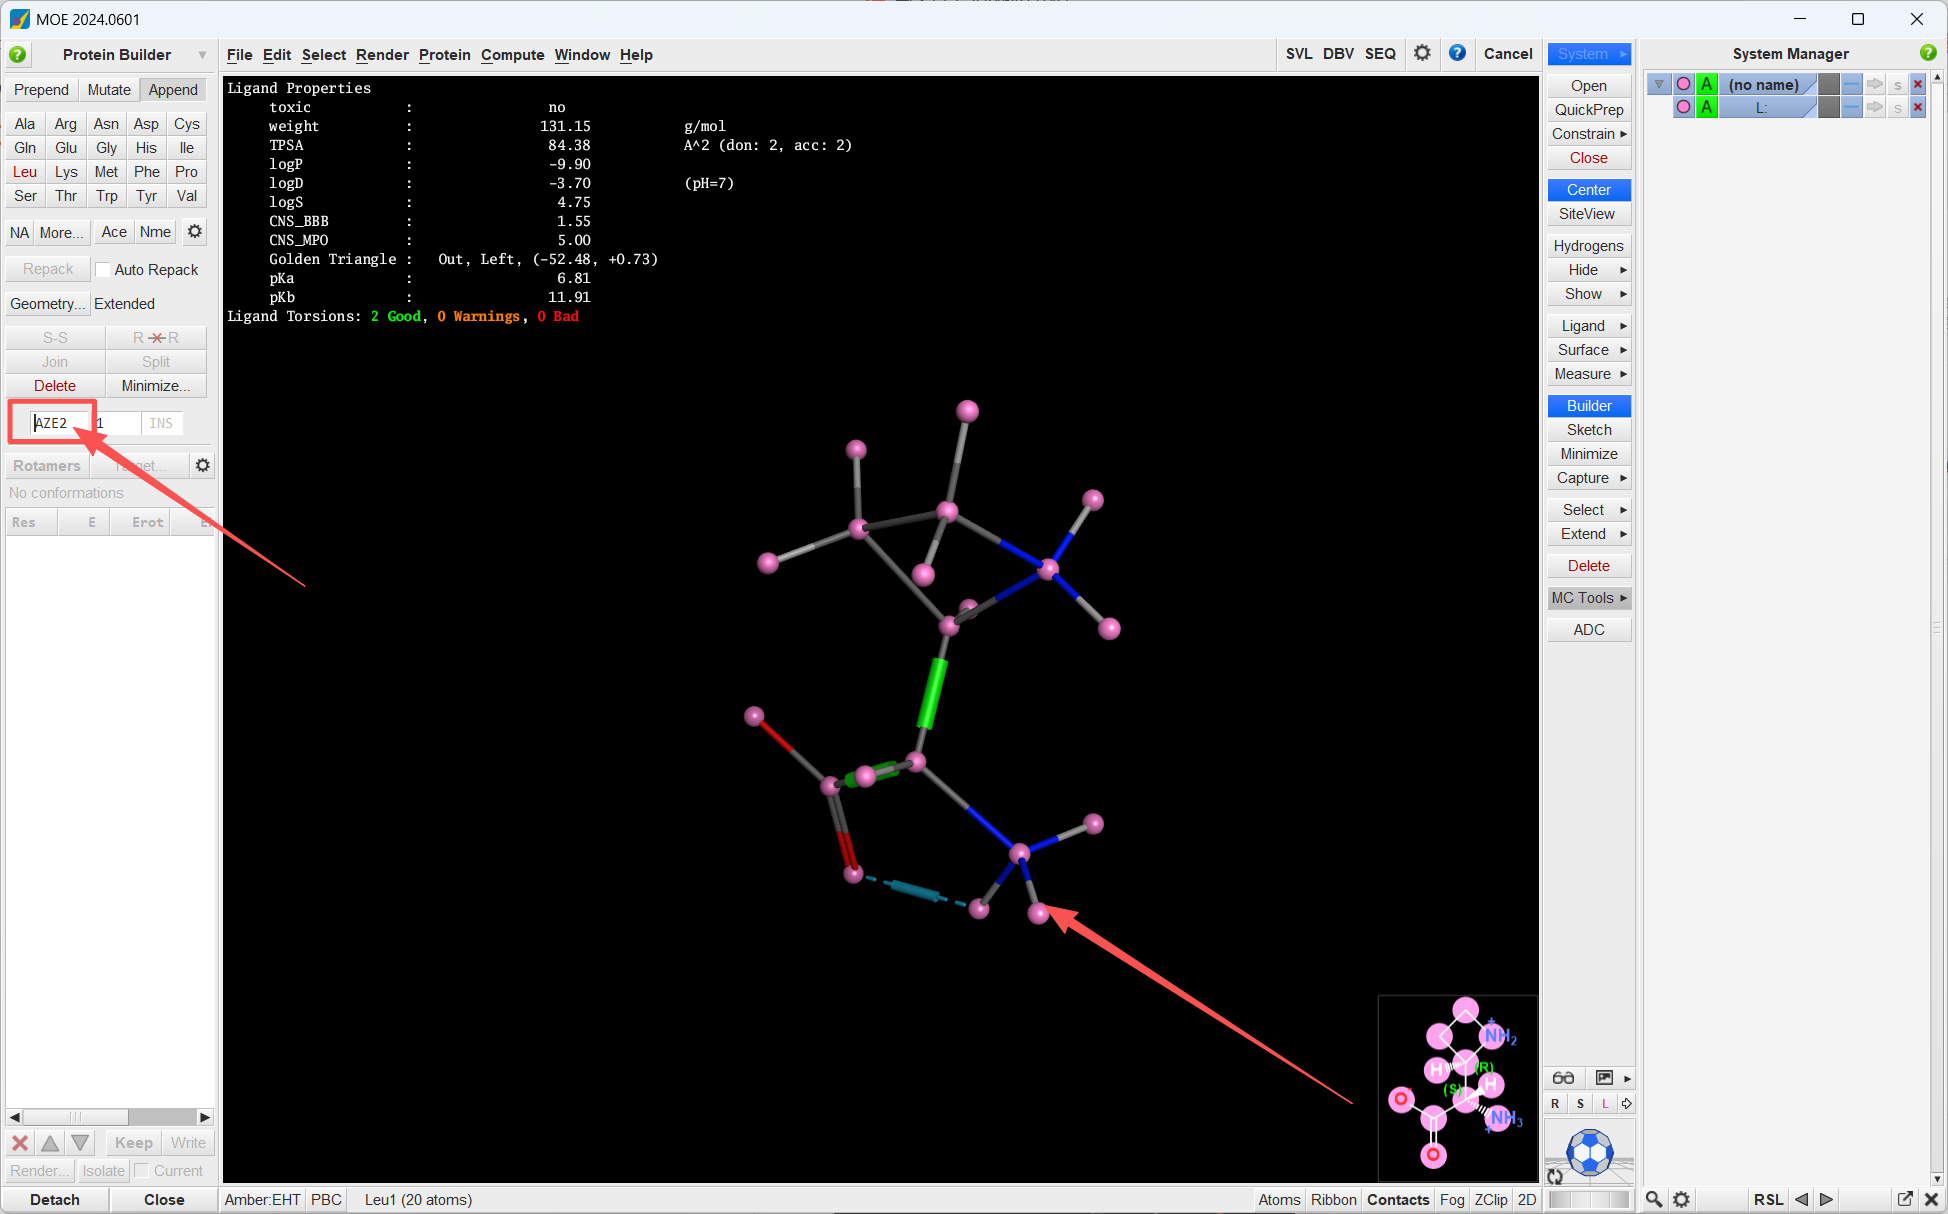
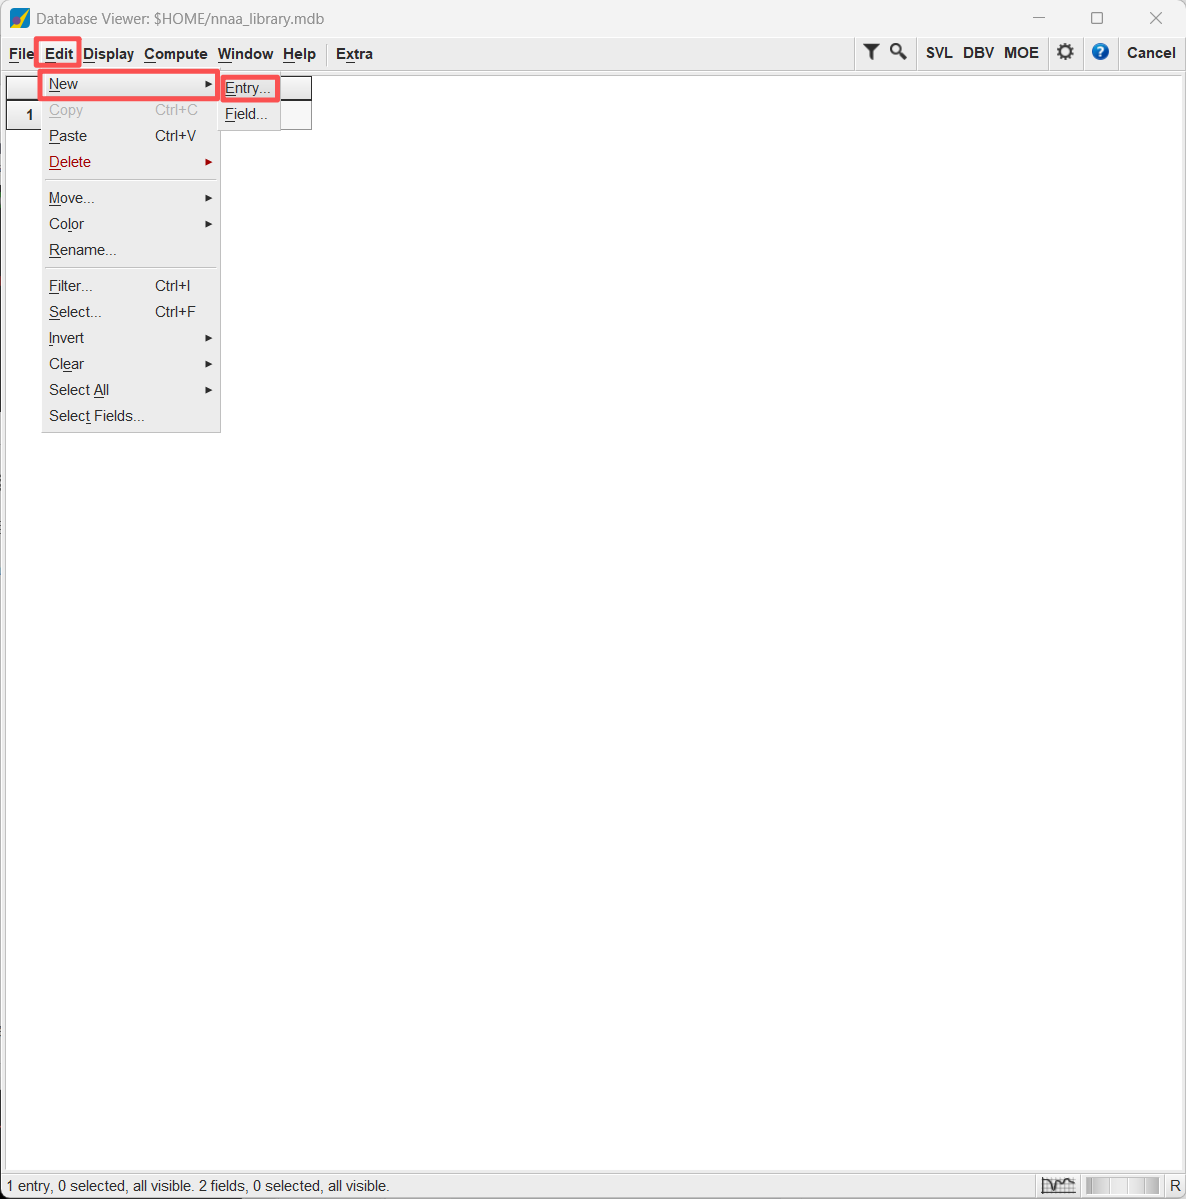
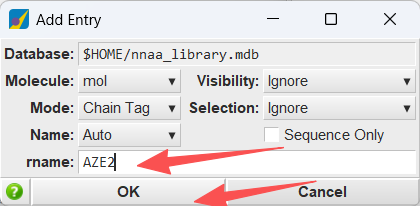
随后在 Database Viewer 中建立新的 entry,并设置:
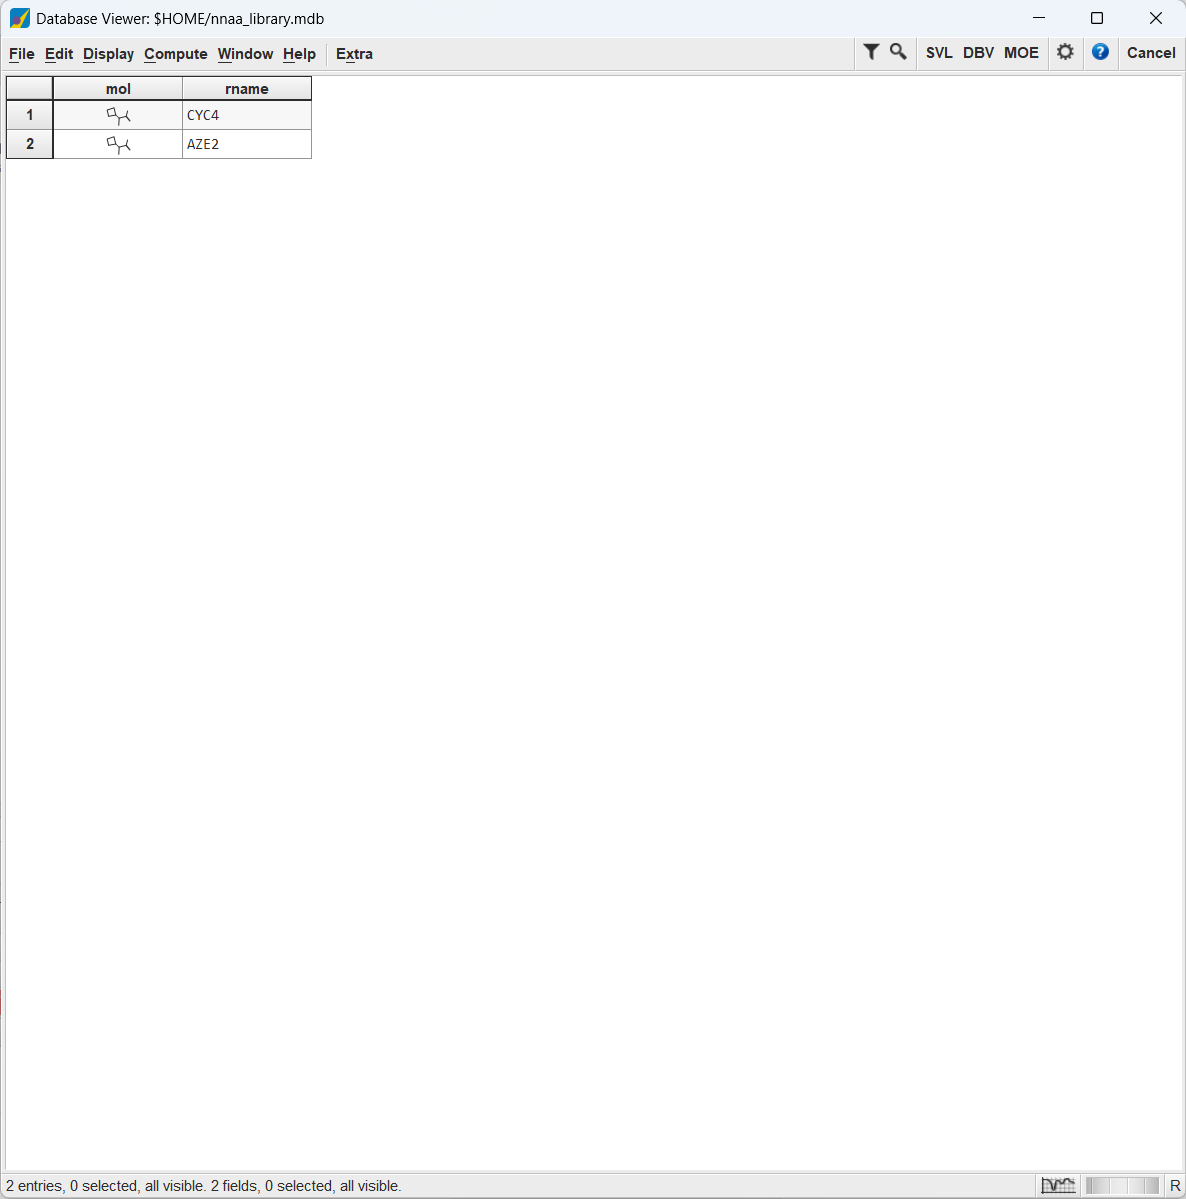
rName = AZE2
于是同一个 nnaa_library.mdb 中就可以同时保存 CYC4、AZE2 等多个自定义残基。
现在它已经能直接用于 Protein Design 了吗?
还差一步。
目前我们已经告诉 MOE:
CYC4 和 AZE2 的化学结构是什么。
但是 Protein Design 不仅需要知道一个氨基酸"长什么样",还需要知道:
它的侧链有哪些合理构象?
天然氨基酸已经有成熟的 Rotamer Library。
而对于我们刚刚创造的 CYC4、AZE2,这些信息还不存在。
所以整个流程实际上是:
设计 NNAA 化学结构
↓
保存 NNAA Database
↓
建立 Rotamer Library
↓
加入 Protein Defaults
↓
用于 Protein Builder / Protein Design
本篇小结
创建非天然氨基酸的核心并不复杂:
选择天然氨基酸作为模板 → 修改 R 基团 → 检查原子、电荷和手性 → 设置新的 residue name → 保存到数据库。
真正值得理解的是:
我们正在把一个临时的化学修改,变成 MOE 可以反复识别和调用的新残基类型。
但结构定义只是第一步。
下一篇我们继续完成最关键的一环:
如何为自己创建的非天然氨基酸生成 Rotamer Library?
这一步完成以后,CYC4 和 AZE2 才真正能够像天然氨基酸一样进入后续的侧链搜索和 Protein Design。
而在之后的ADC药物研发教程中,同一个非天然氨基酸残基的不同的rotamer的构象数据库也将会广泛的运用起来。