上一篇介绍了肽对接的两条路线:Protein--Protein Docking 和 Protein--Ligand Docking。
这一篇我们切换到一个新的案例:stapled peptide--Mdmx。
这里不再直接使用前面的 p53 peptide,而是先对一条 stapled peptide 进行 Conformational Search ,建立肽构象库,再将这些构象作为 Ligand 输入 General Dock,与 Mdmx 进行对接。
整套流程可以概括为:
Stapled Peptide → Conformational Search → Conformational Database → General Dock → Docking Poses
它正好展示了柔性肽进行 Protein--Ligand Docking 时一种非常实用的处理思路。
一、为什么要先做 Conformational Search?
肽与普通小分子相比具有更多可旋转键,尤其是主链本身就具有较大的构象自由度。
如果只拿一个初始构象直接 Dock,那么程序既需要寻找肽在受体上的位置和方向 ,又需要同时处理肽自身的构象变化,搜索空间会迅速扩大。
因此可以把问题拆成两步:
Conformational Search:肽可能有哪些合理构象?
↓
Docking:这些构象中,哪些能够合理结合受体?
这就是本篇 workflow 的核心。
二、准备 stapled peptide
首先载入:
stapled_peptide.moe
然后使用:
RHS → QuickPrep
进行结构准备。
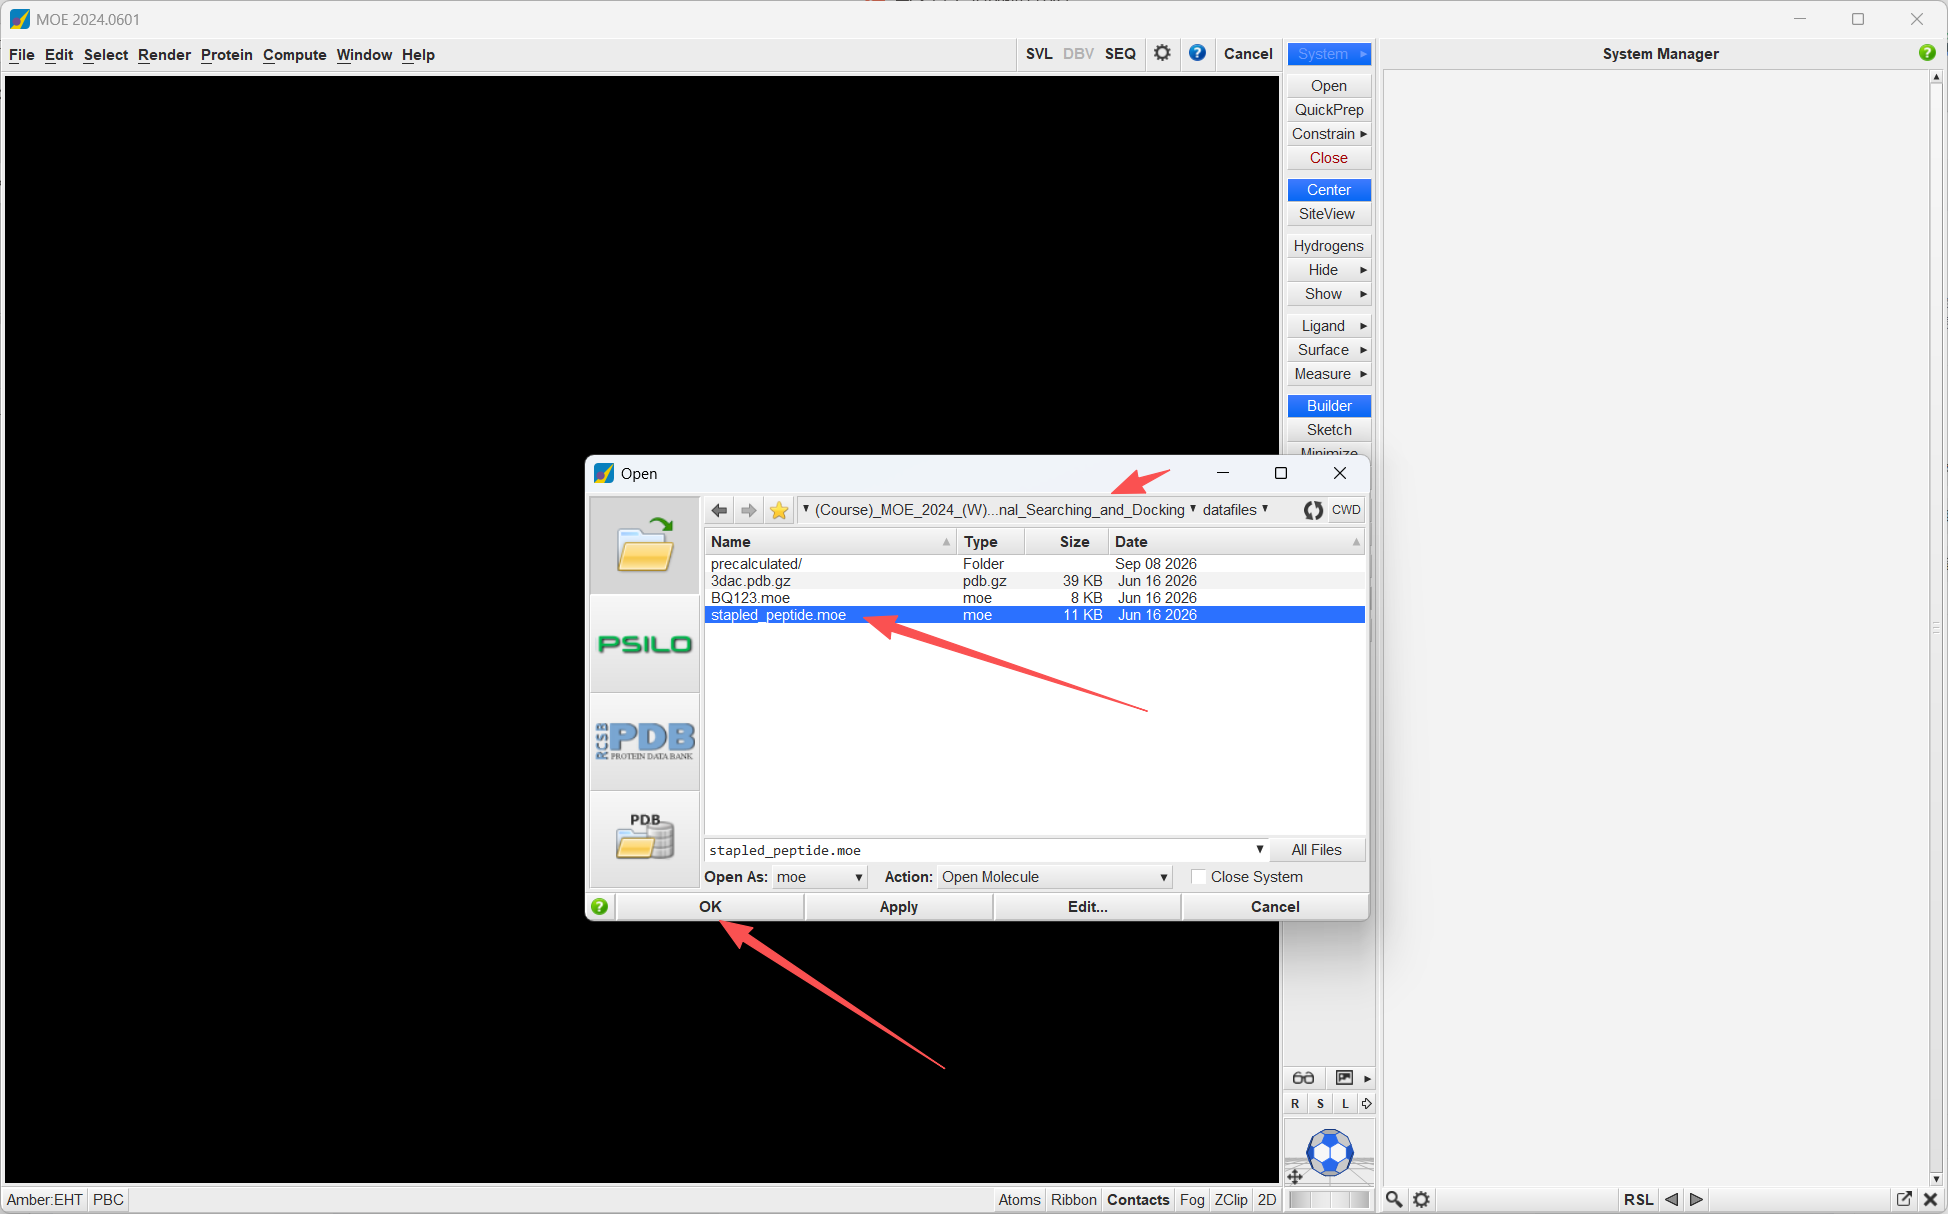
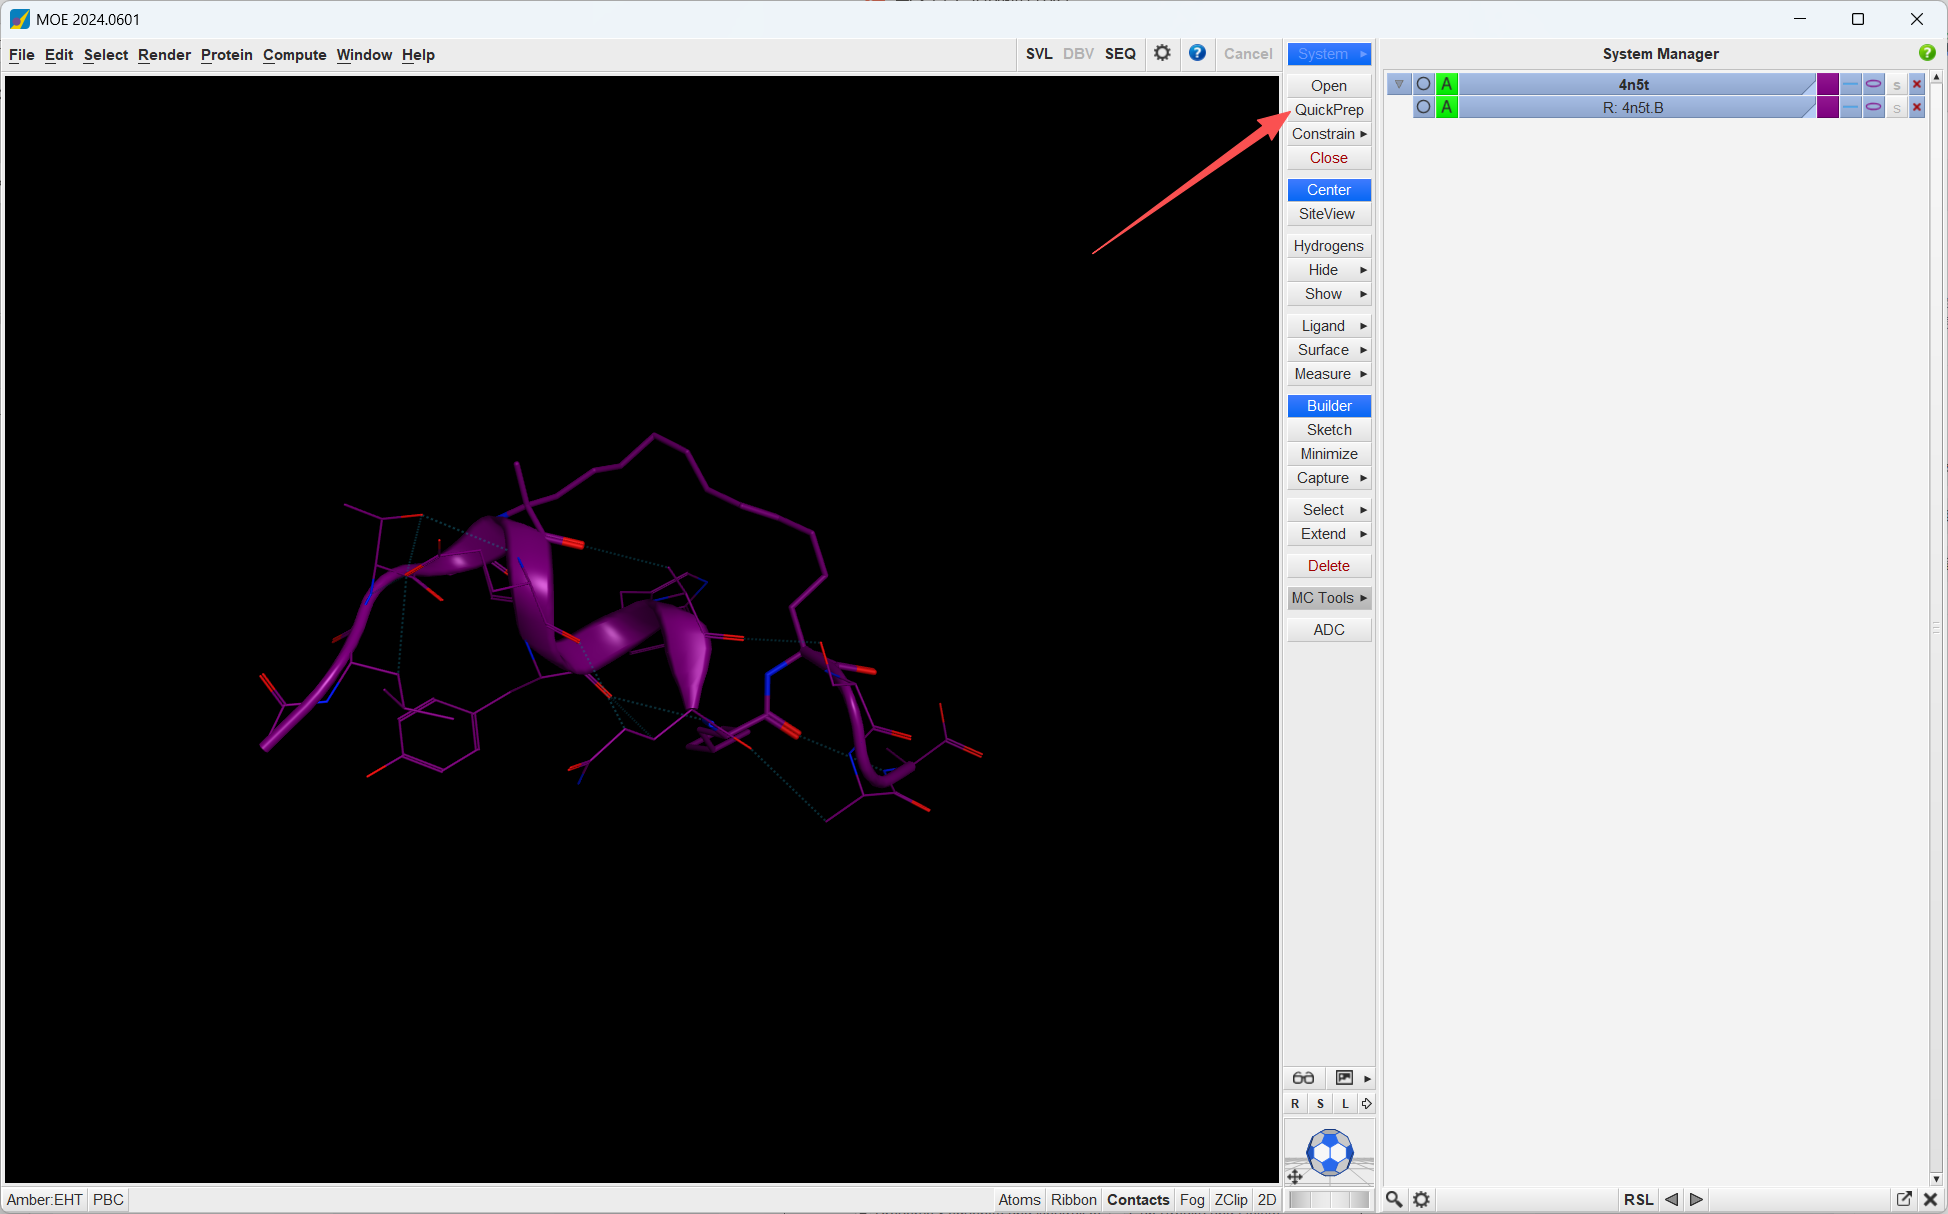
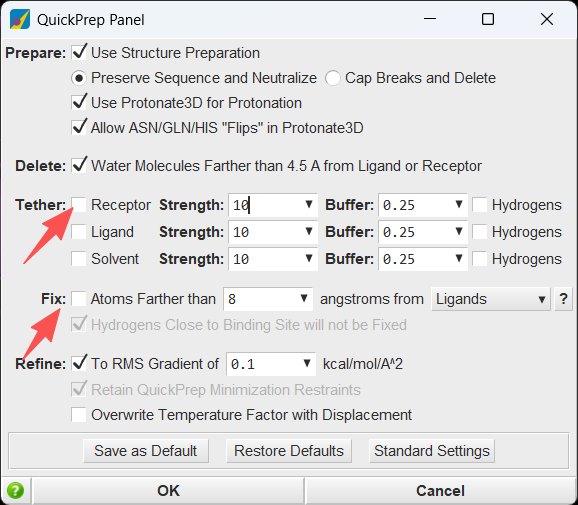
这里Tether Receptor 的部分要取消勾选。是因为接下来希望对这条肽做真正的构象搜索,而不是让它继续受到 QuickPrep 阶段参考坐标的 tether 约束。
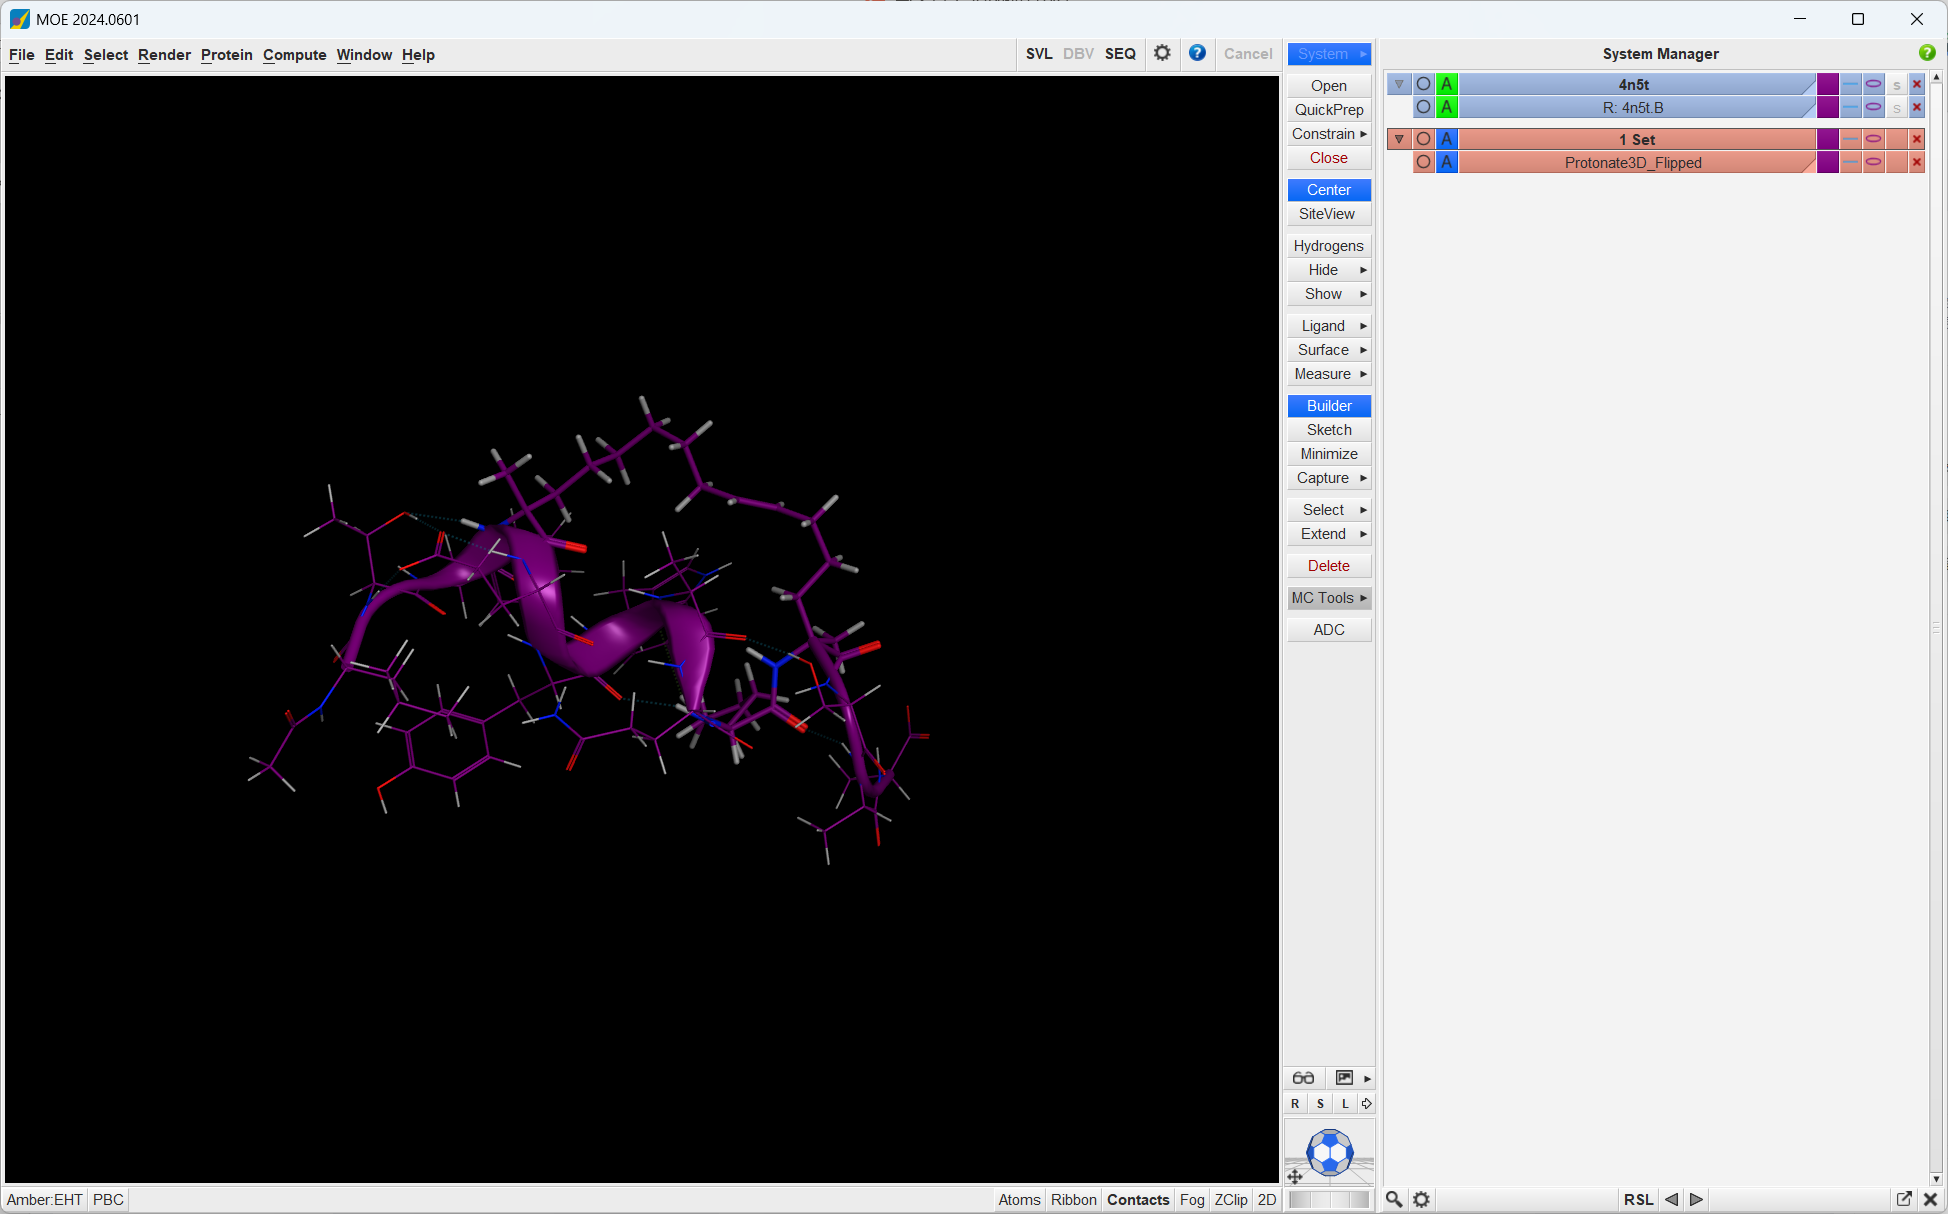
这里使用的是 stapled peptide。Staple 将肽链上的两个位置连接起来,有助于维持局部 α-helix,因此在后面的构象搜索中,我们并不希望这一段已经形成的螺旋结构被完全打散。
三、建立 Helix Rigid Body
Stapled peptide 中的 staple 用于稳定局部 α-helix,因此在后续构象搜索时,我们希望保留这段螺旋主链的整体形状,同时允许侧链和肽的其他区域继续调整。
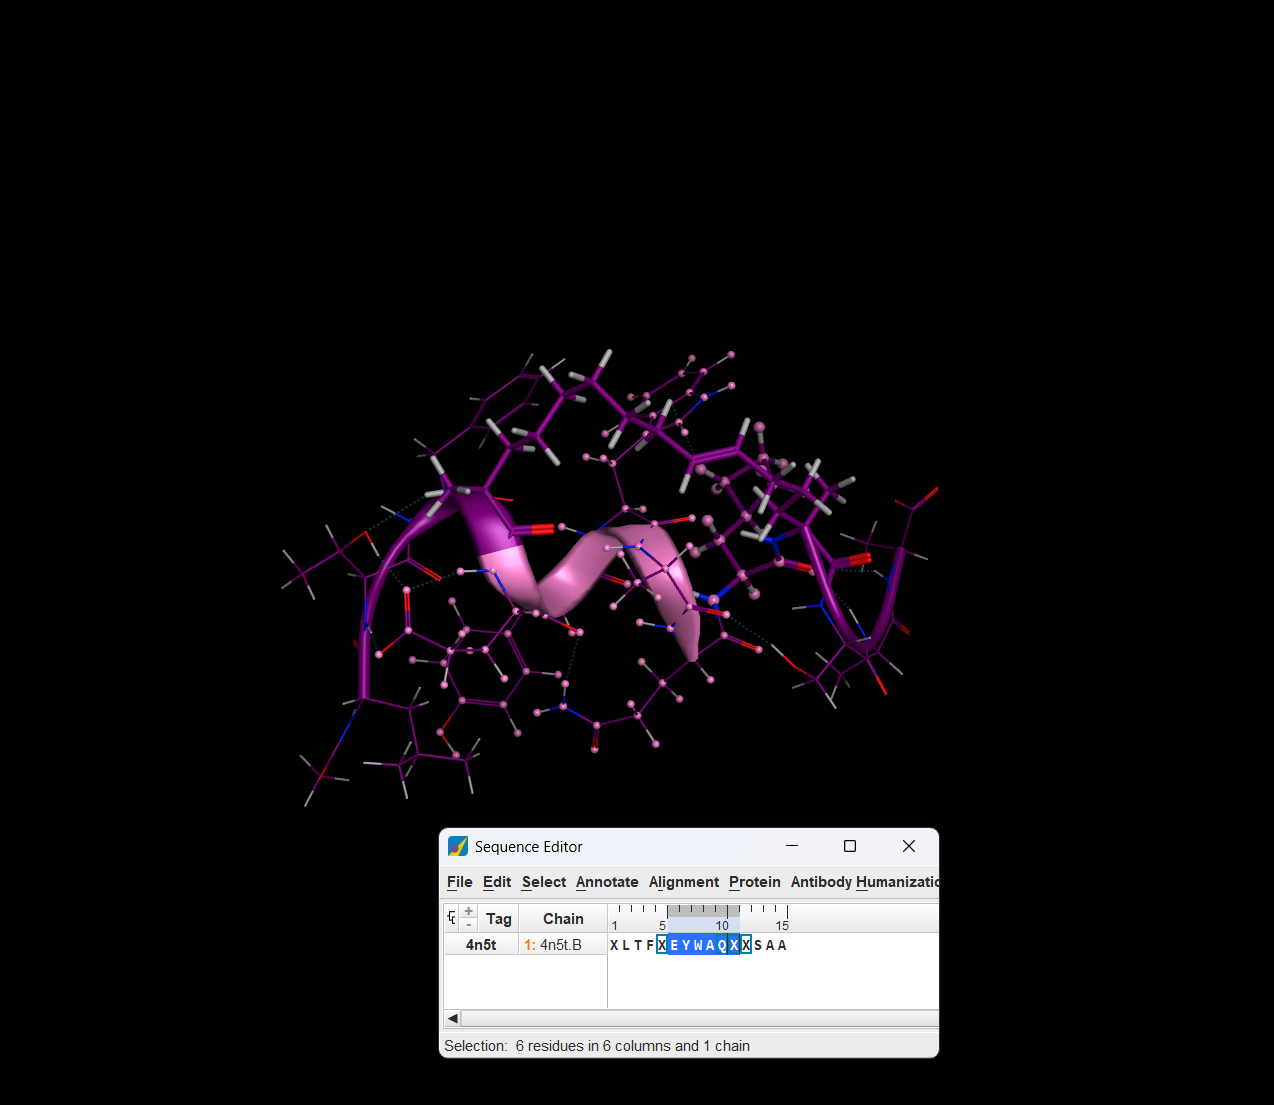
这里并不是直接把 6--11 位残基全部设成 Rigid Body,而是只将它们的 backbone atoms 建立为一个 Set。具体操作分为三步。
首先,在 Sequence Editor 中框选 6--11 位残基。此时这些残基的原子整体处于选中状态。
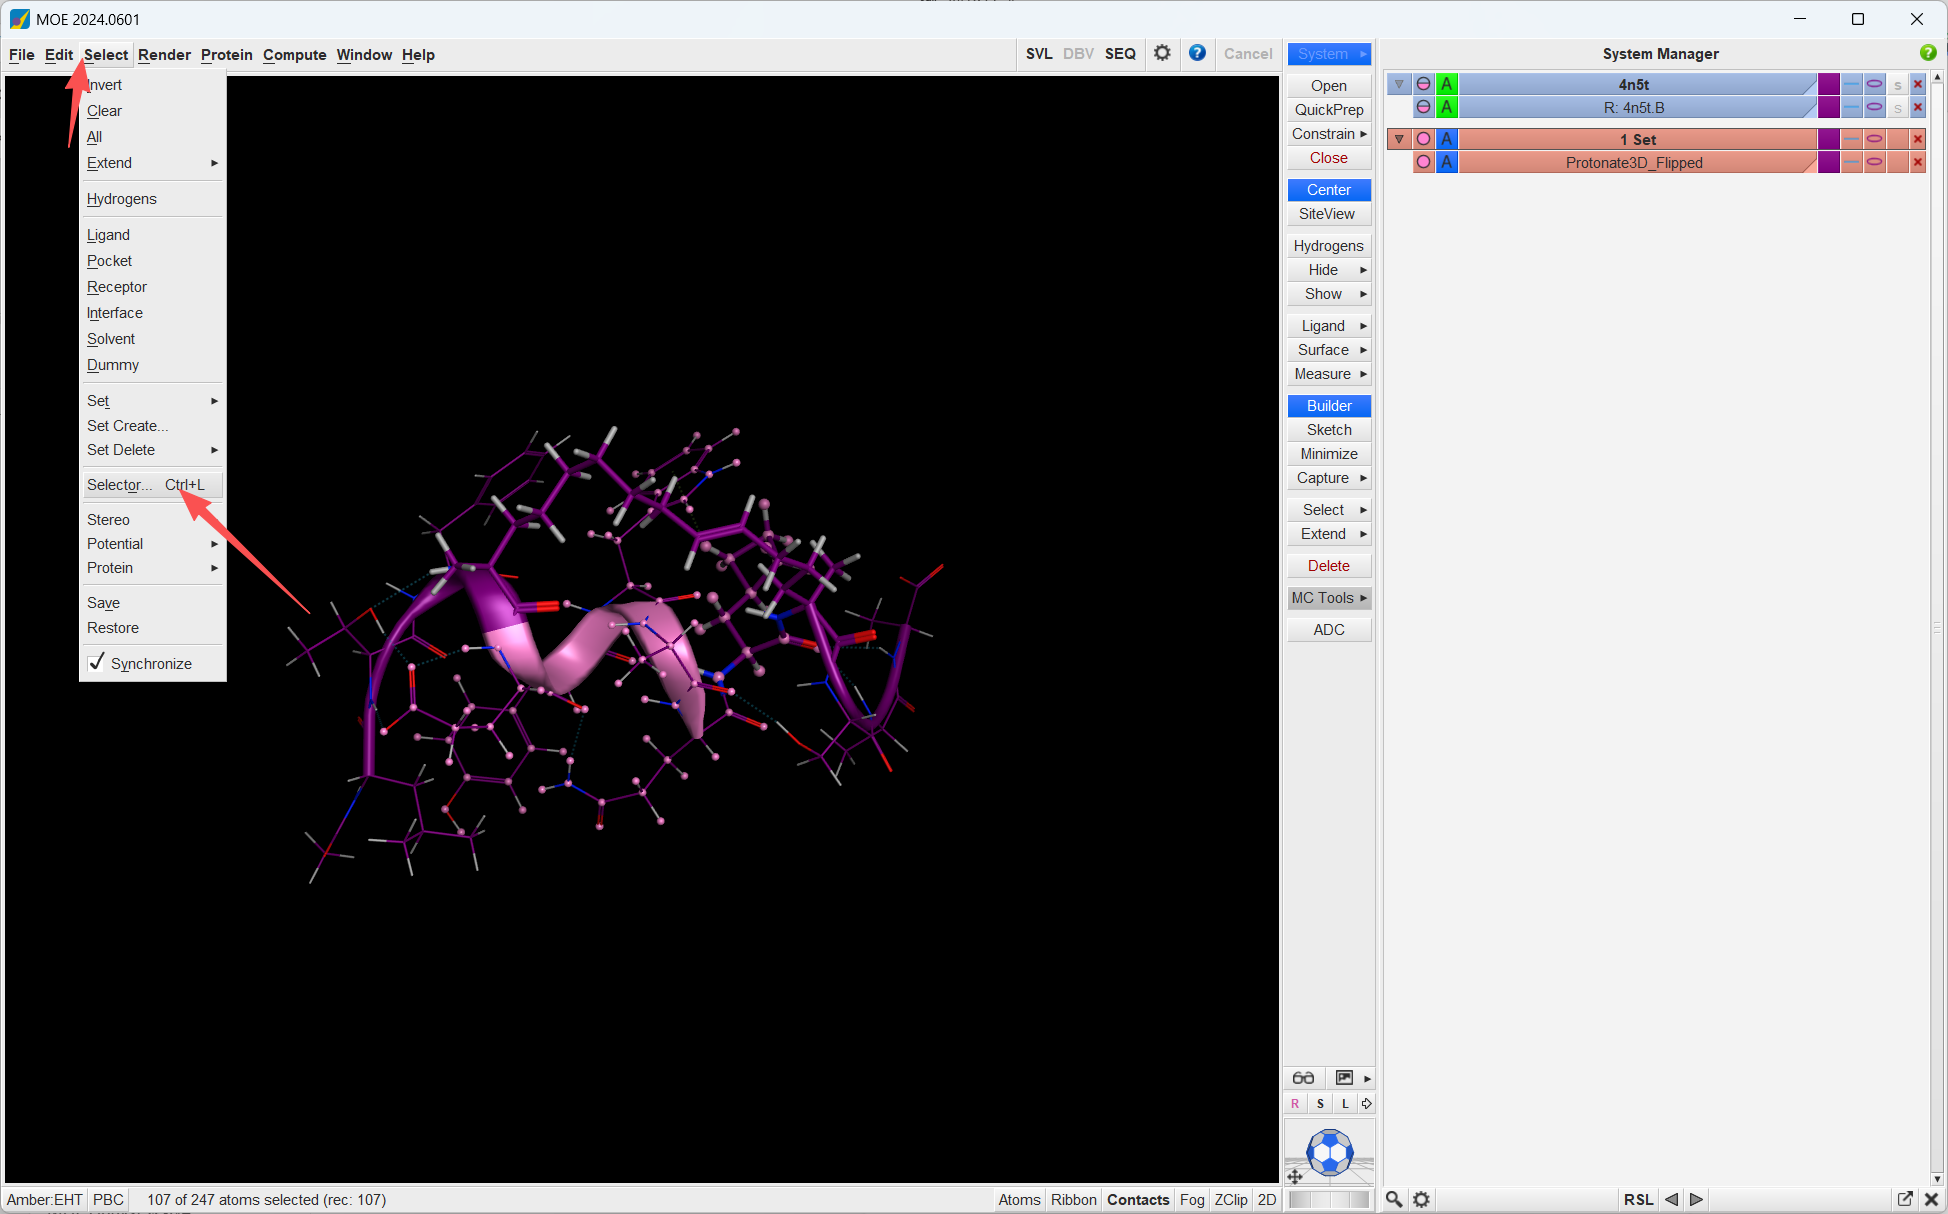
接下来进入:
Select → Selector...
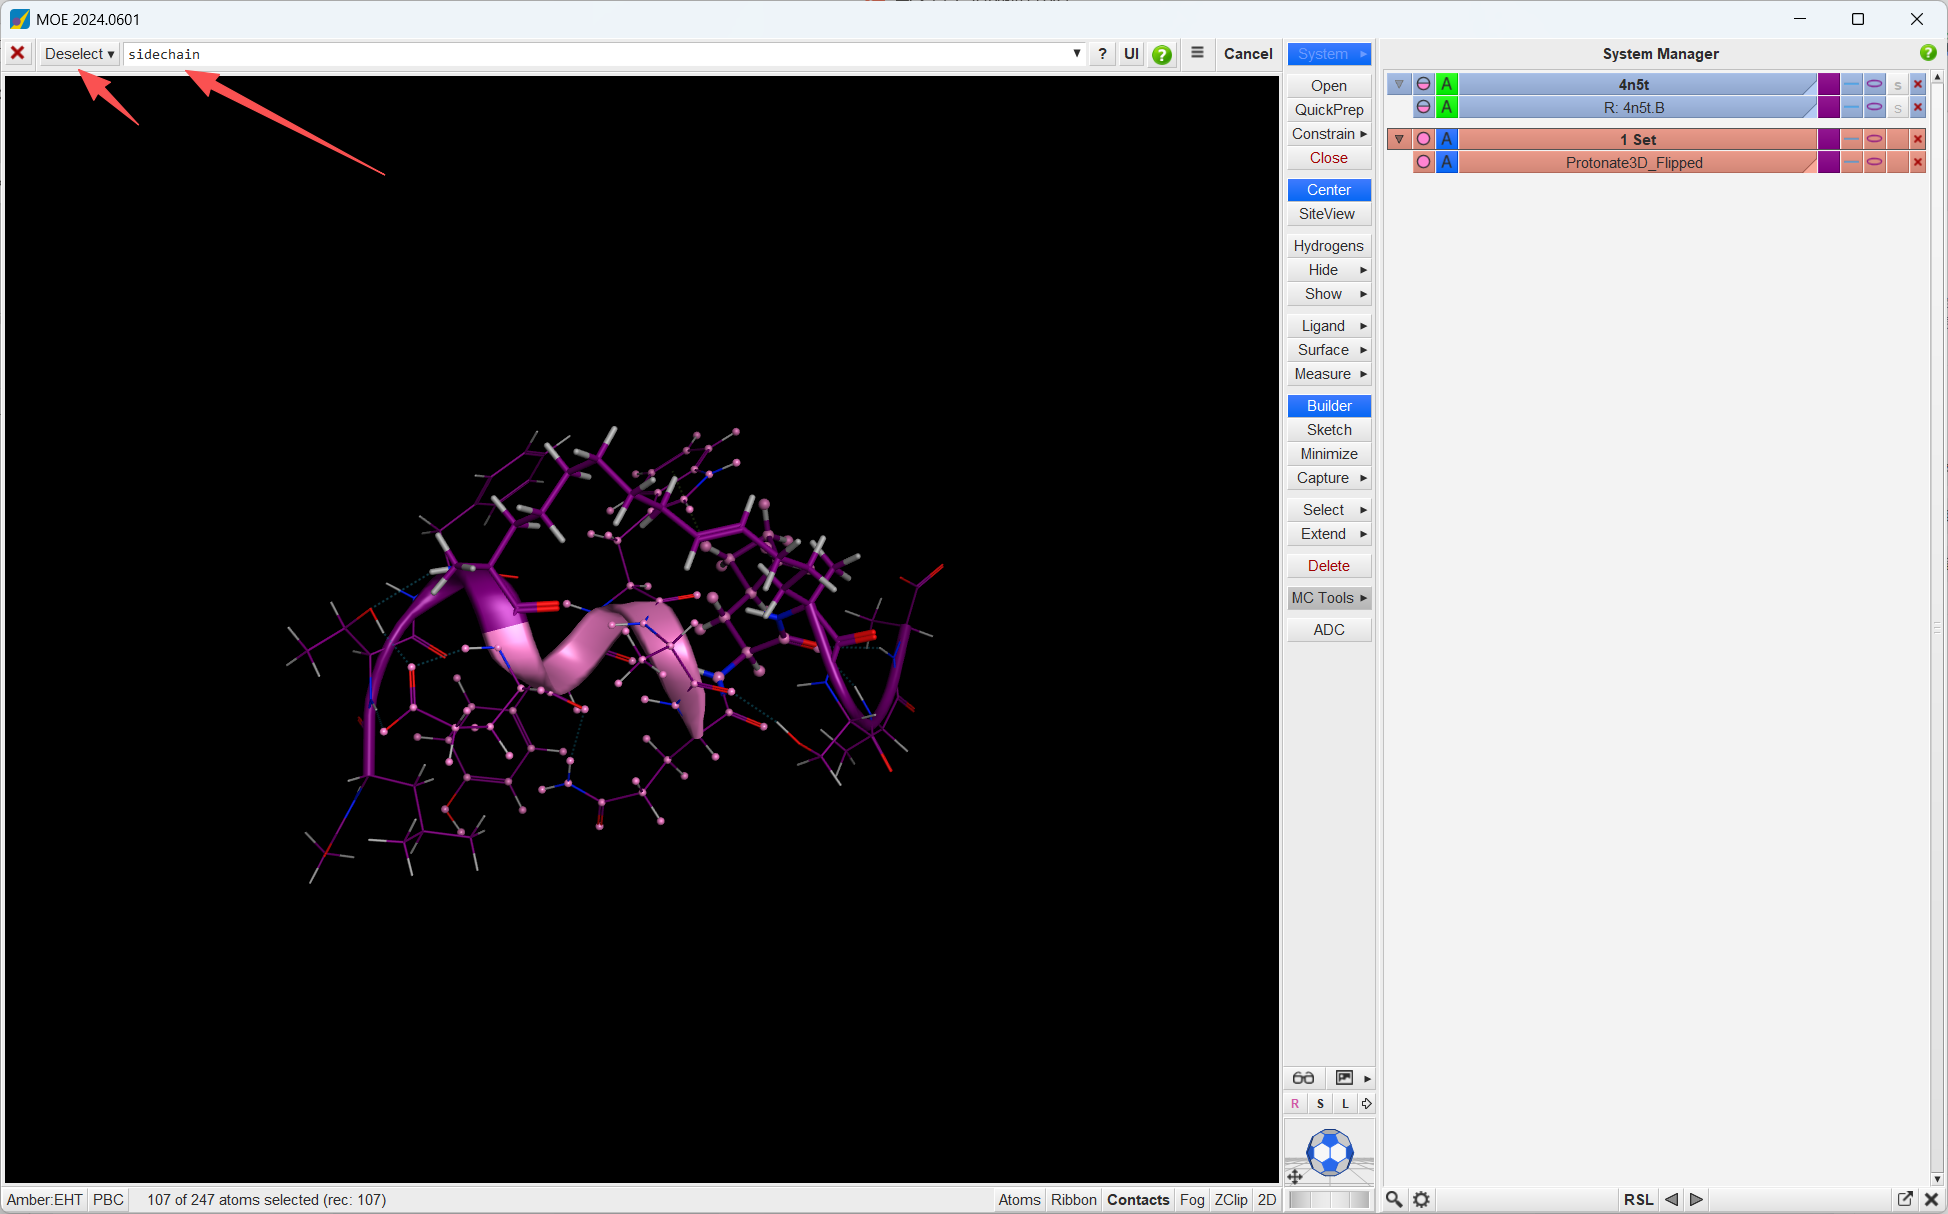
将 Selection Mode 攃为:
Deselect
然后输入:
sidechain
并按 Enter。
这里的 sidechain 很容易理解反了。由于当前模式是 Deselect,这一步的含义实际上是:
6--11 位残基全部原子
↓ Deselect sidechain
只留下 6--11 位残基的 backbone atoms
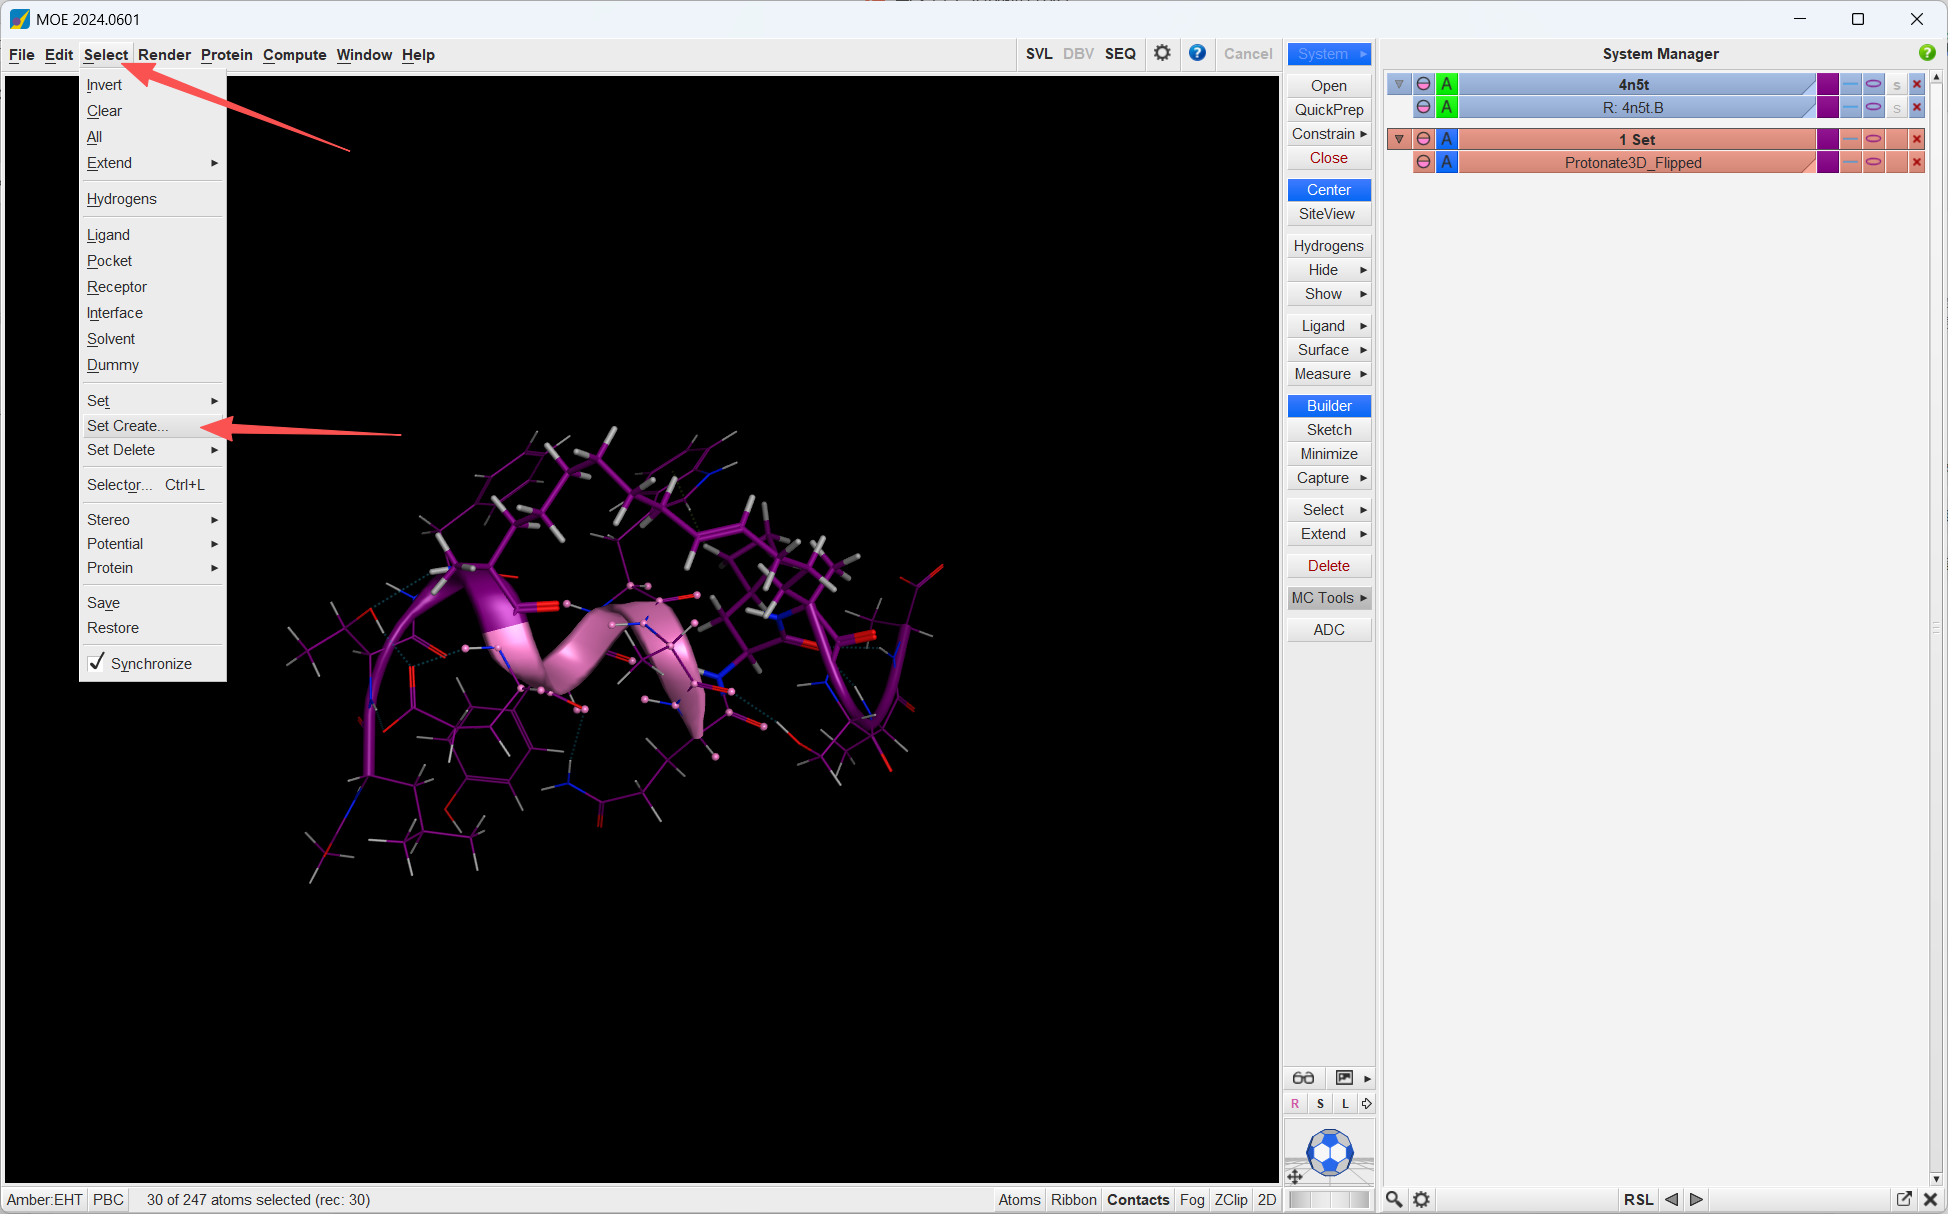
最后进入:
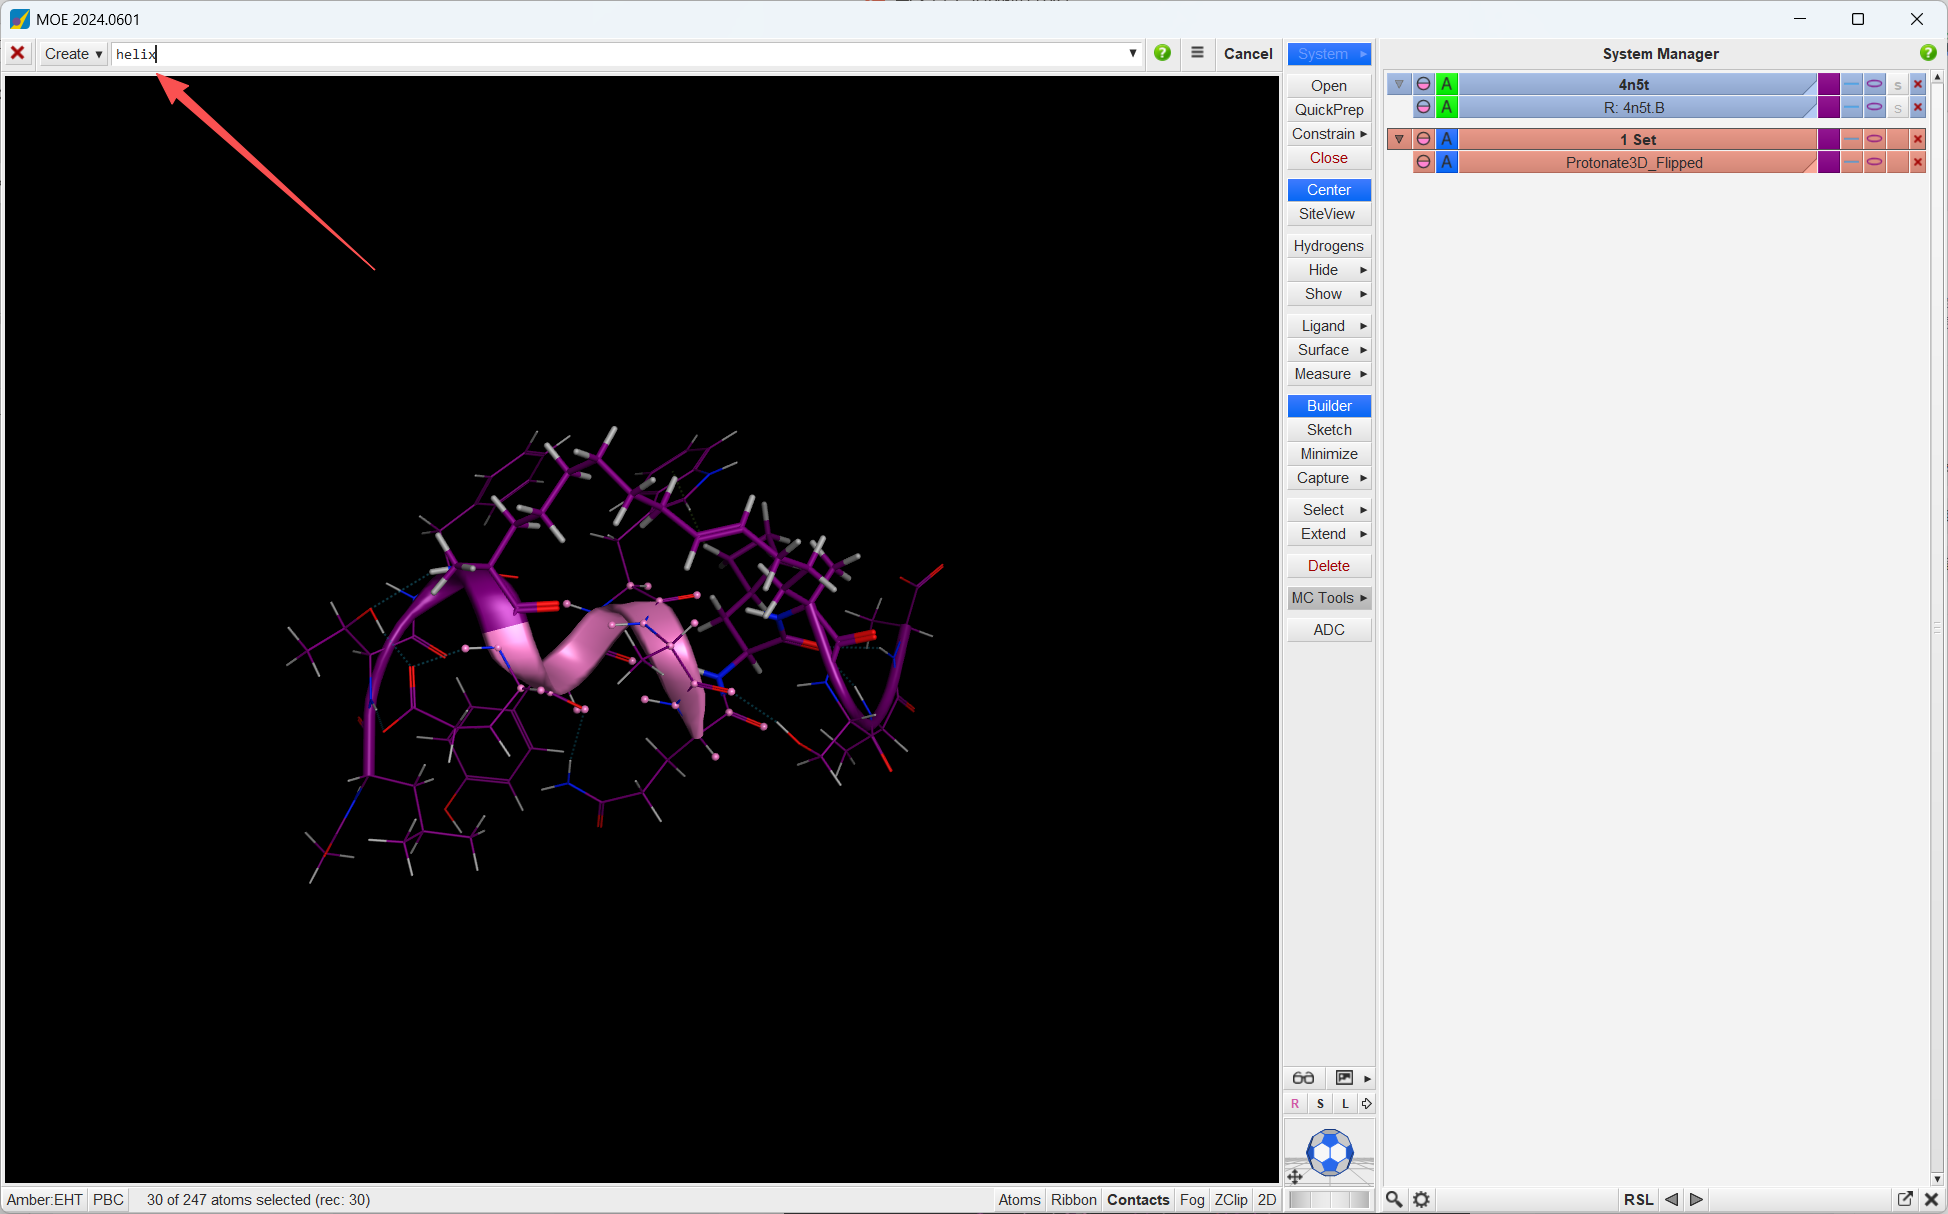
Select → Set Create...
输入:
helix
将当前选中的 backbone atoms 保存为一个名为 helix 的 Set。创建完成后,可以在 System Manager → Sets 中看到它。 (Course)MOE_2024(W)_Peptide_M...
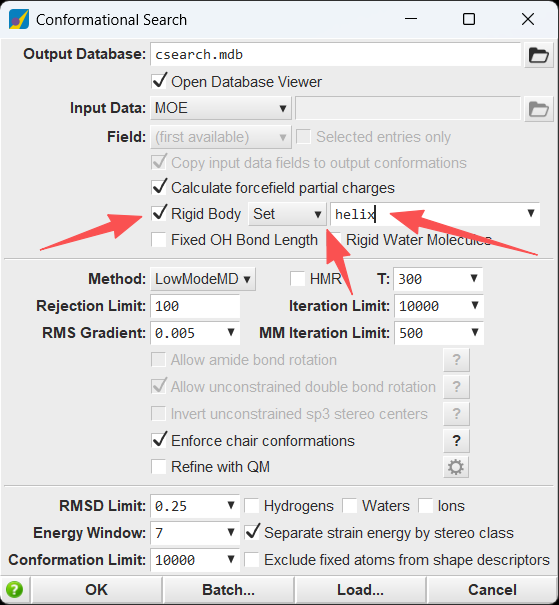
这个 helix Set 会在下一步 Conformational Search 中被指定为 Rigid Body 。因此,真正作为刚体处理的是这段 α-helix 的主链原子,而不是把 6--11 位残基连同侧链一起完全固定。
这样处理后,构象搜索可以在维持局部 α-helix 主链整体结构的同时,继续探索侧链以及肽链其他柔性区域的不同构象
四、运行 Conformational Search
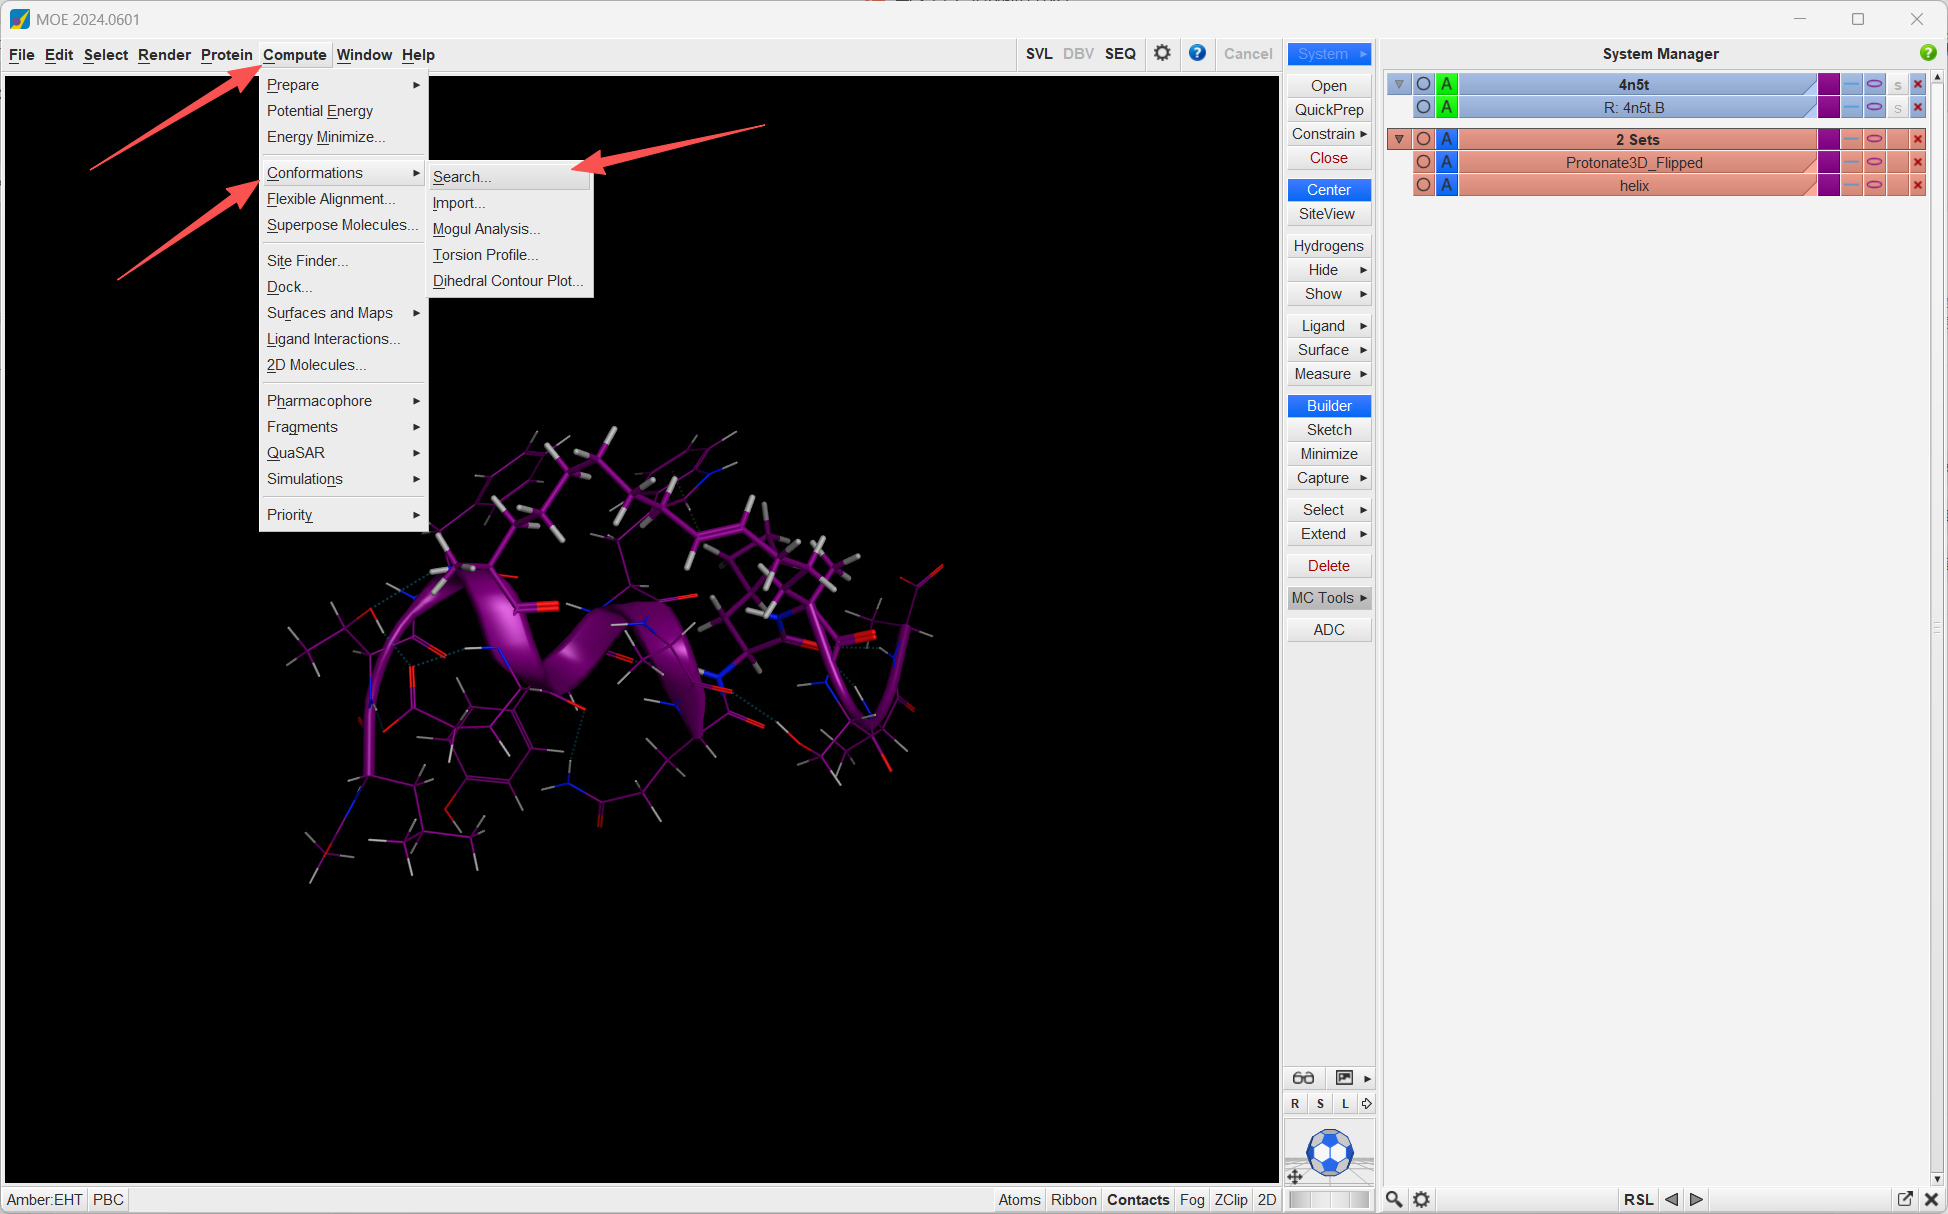
进入:
Compute → Conformations → Search
打开 Conformational Search。
设置:
Rigid Body → Set → helix
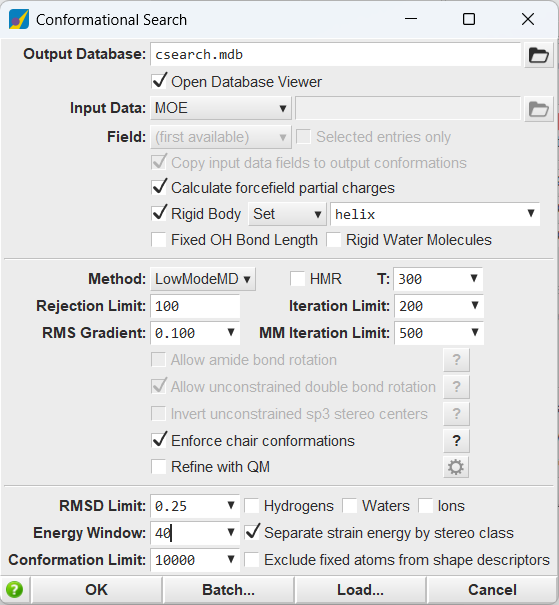
案例中进一步设置:
Iteration Limit = 200
RMS Gradient = 0.1
Energy Window = 40
然后开始计算。
其中需要特别注意 Iteration Limit = 200。
这里使用较少的迭代次数主要是为了缩短演示时间。对于实际柔性肽计算,更充分的构象采样通常需要更多 iterations。
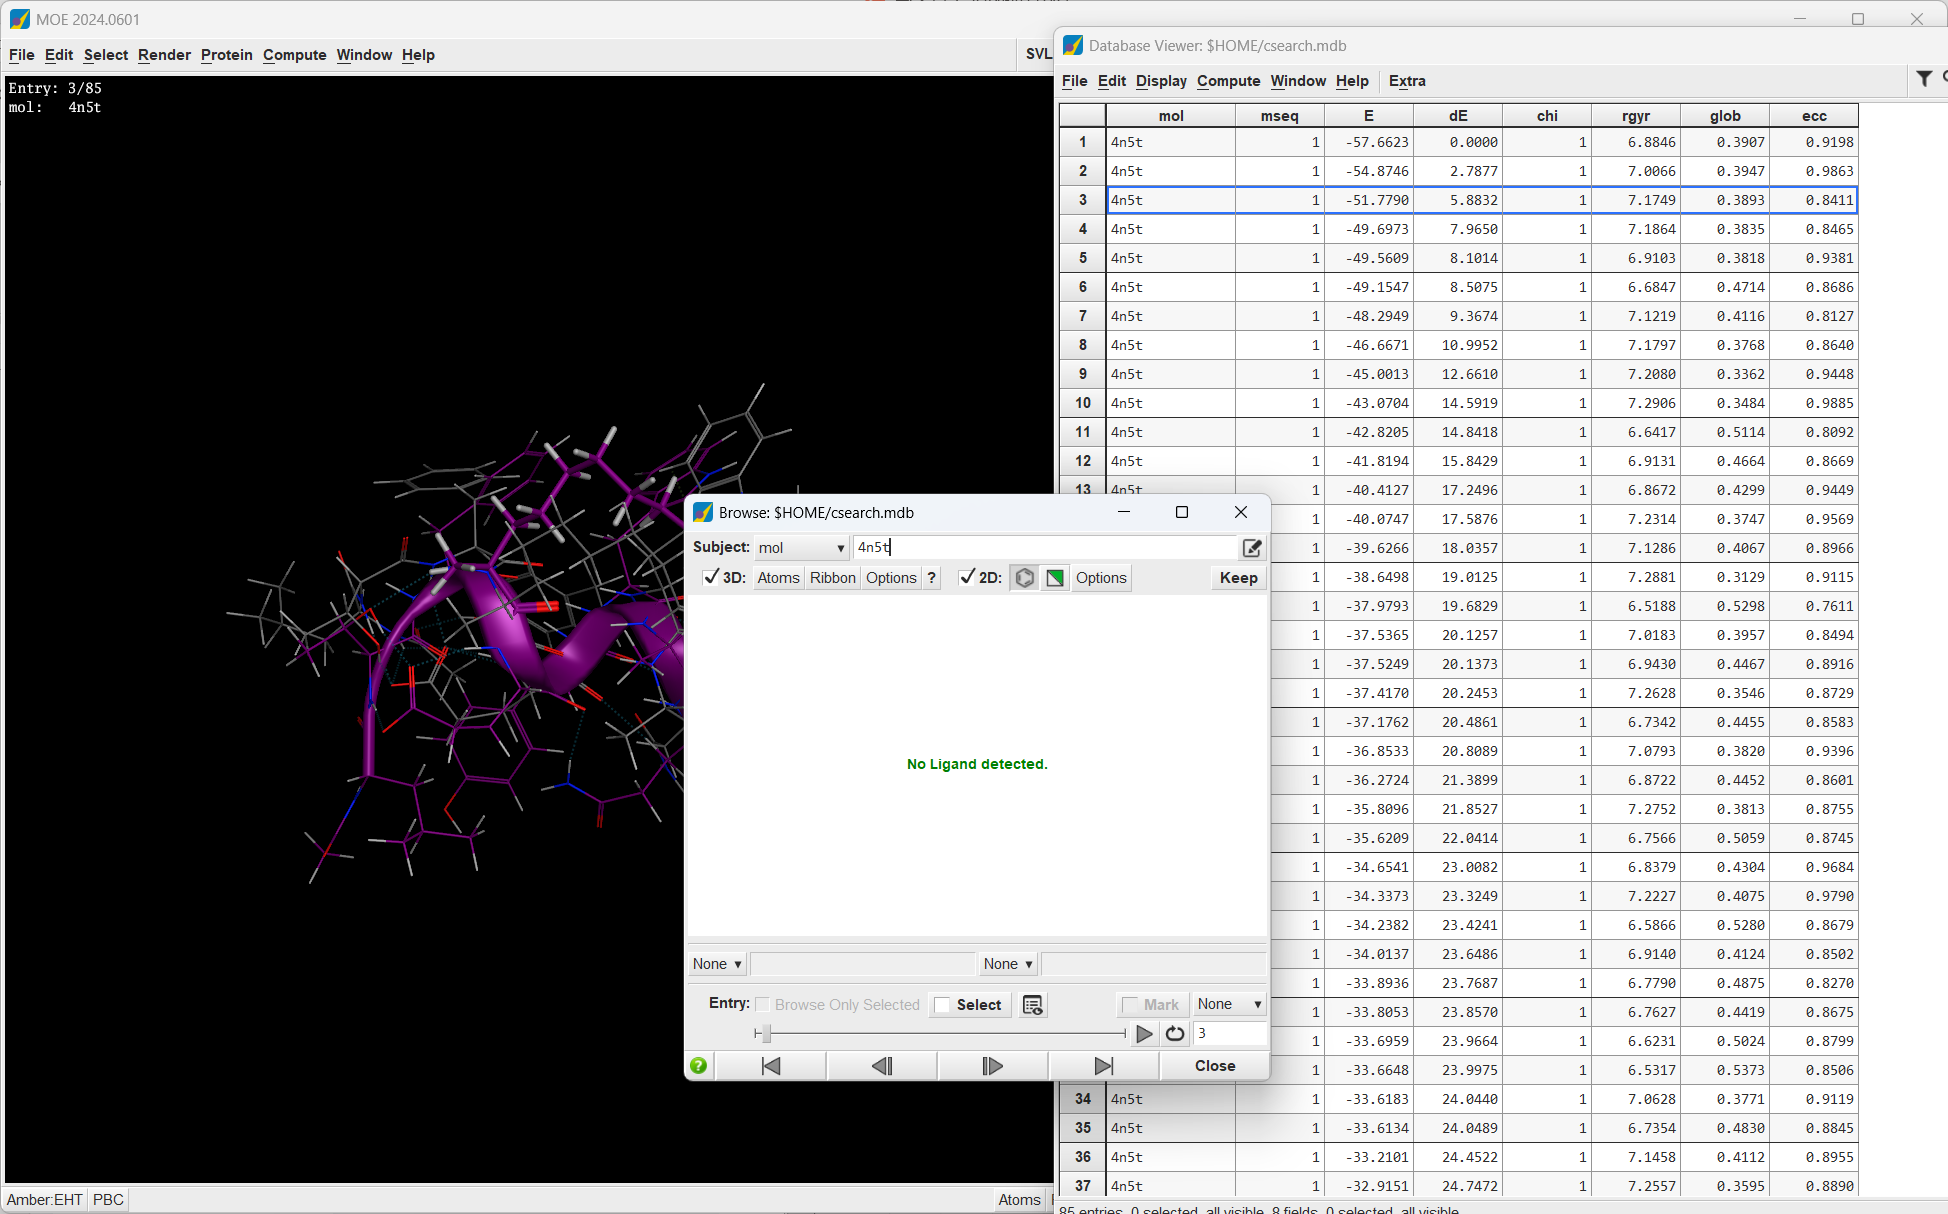
五、得到 Peptide Conformational Database
计算完成后,不同构象会写入输出数据库,并按照能量 E 排序。
这里需要注意,我们的目标并不是:
找到一个能量最低的肽结构,然后只拿它去 Dock。
而是建立:
一批能量合理、结构不同的 peptide conformations。
因为肽自身最低能量的游离构象,并不一定就是最适合与受体结合的构象。
因此后面真正送入 Docking 的,是整个:
Conformational Database
而不是其中某一个结构。
六、将构象库送入 General Dock
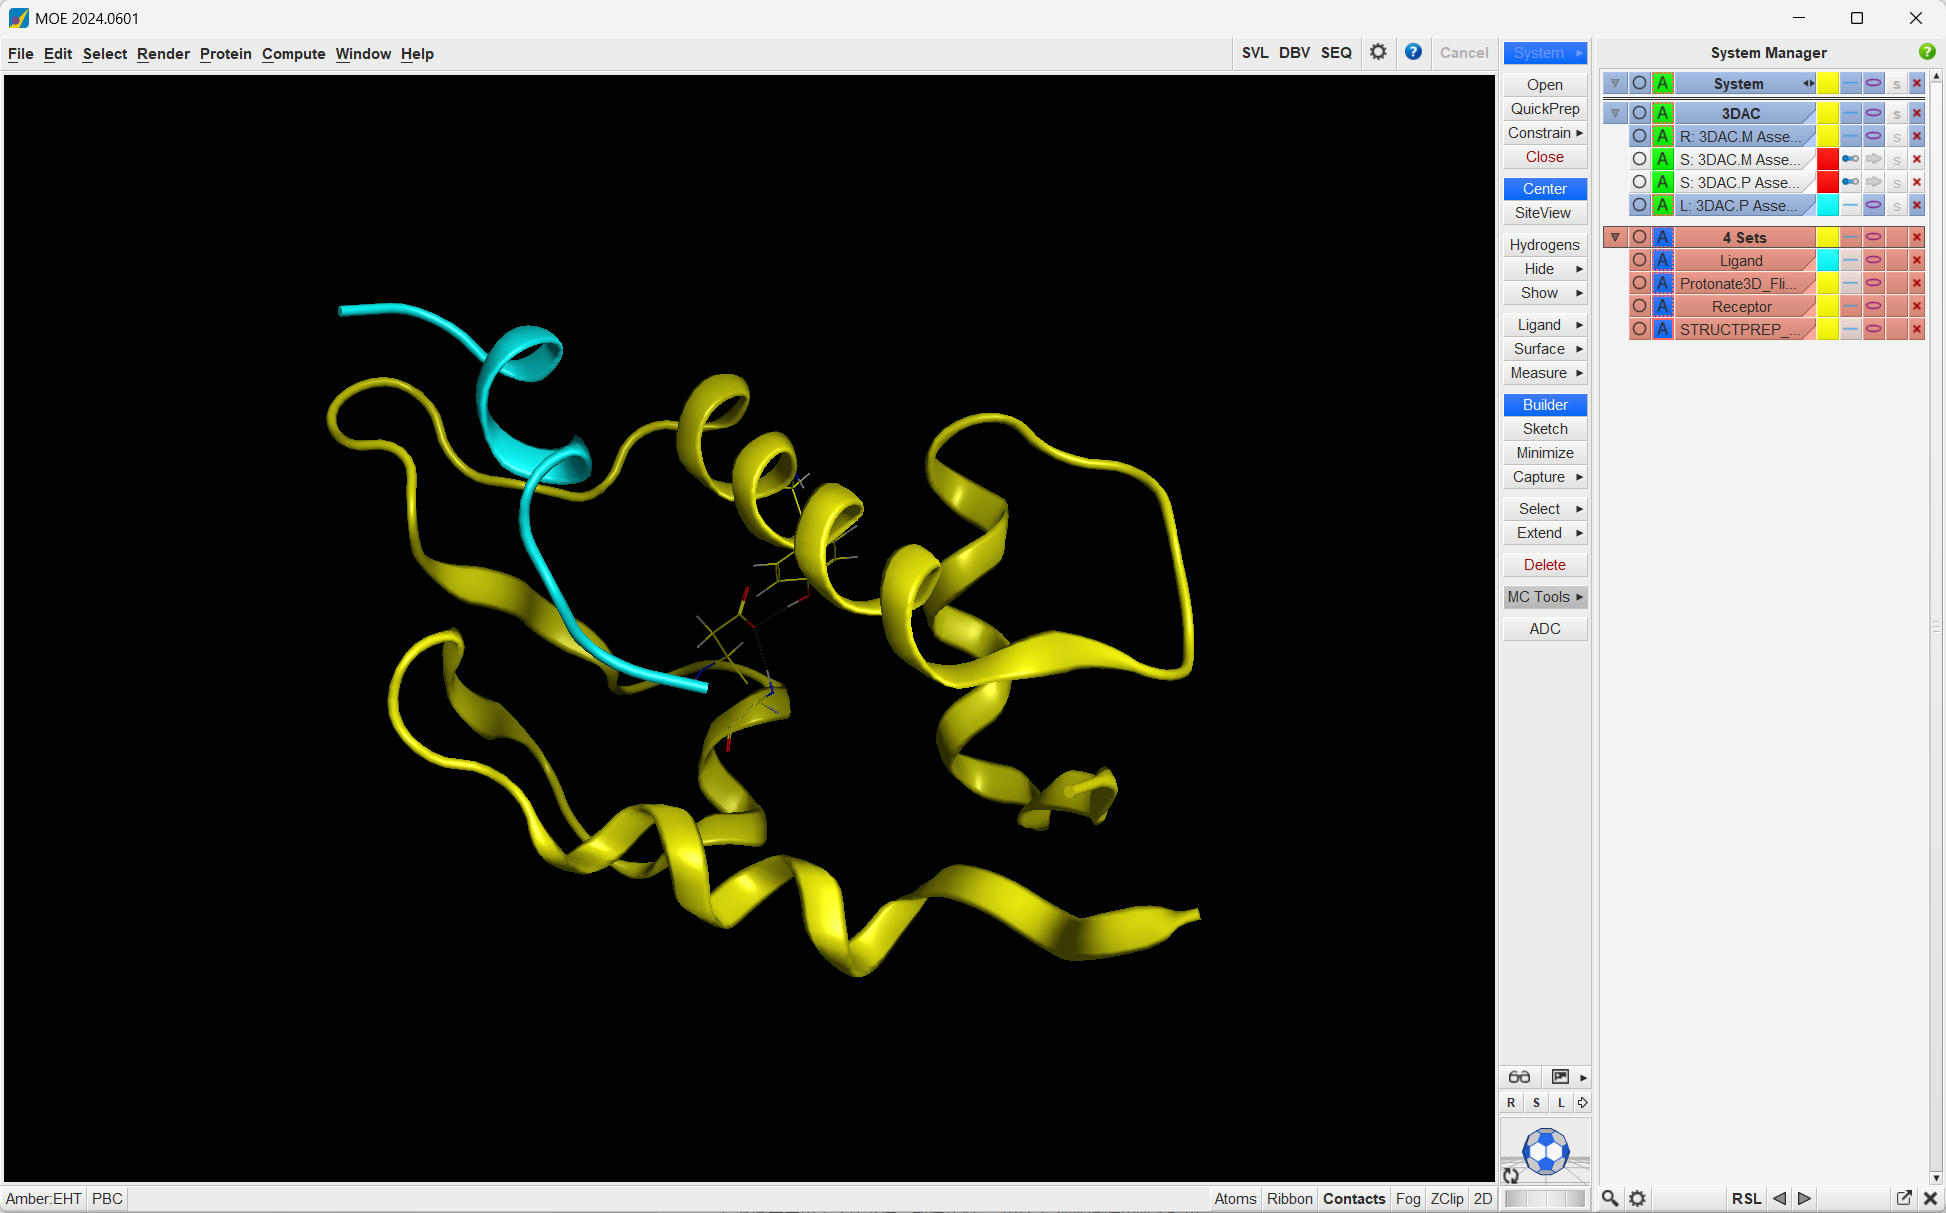
完成构象搜索后,载入受体:
Mdmx.moe
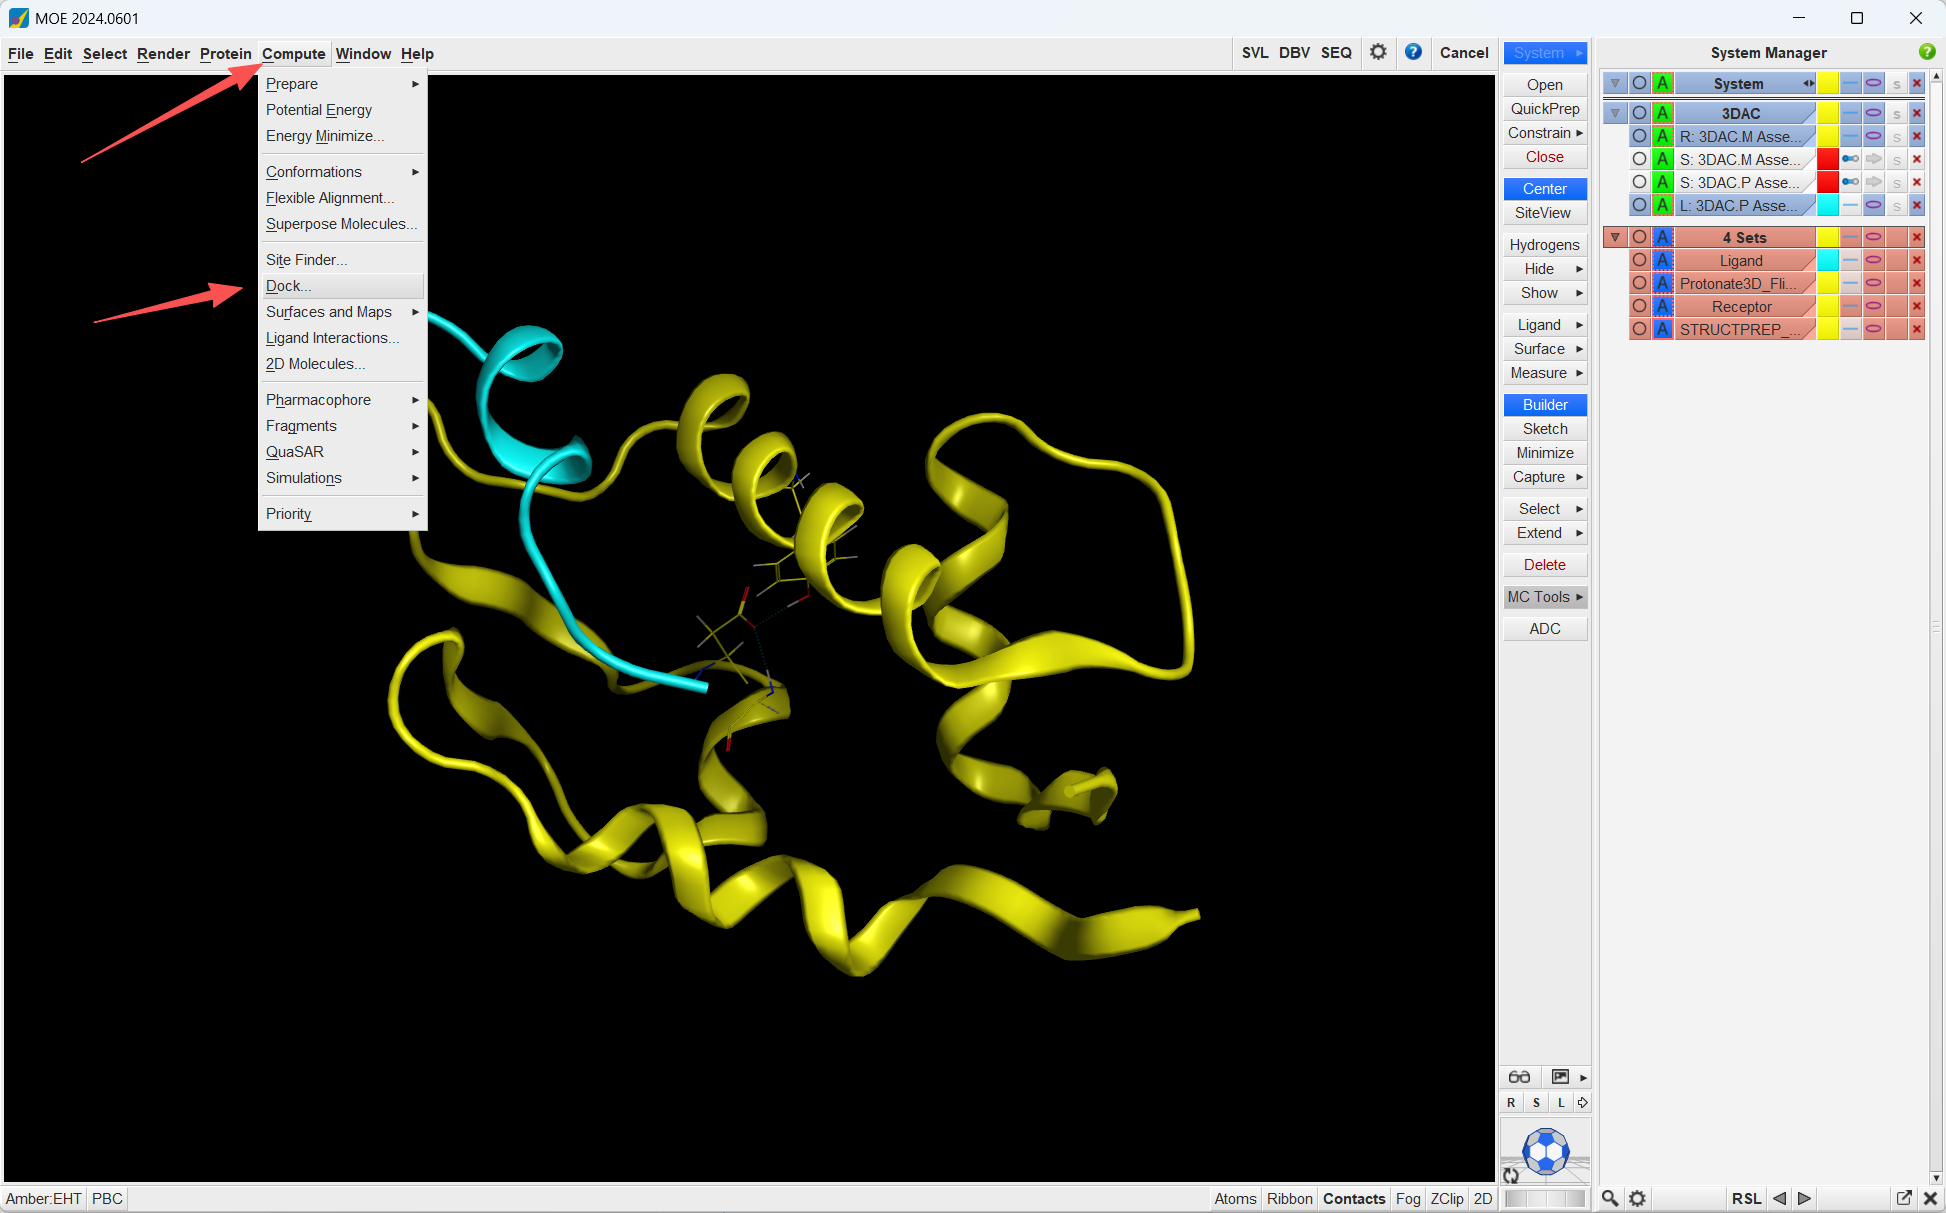
然后进入:
Compute → Dock
此时打开的是 General Dock。
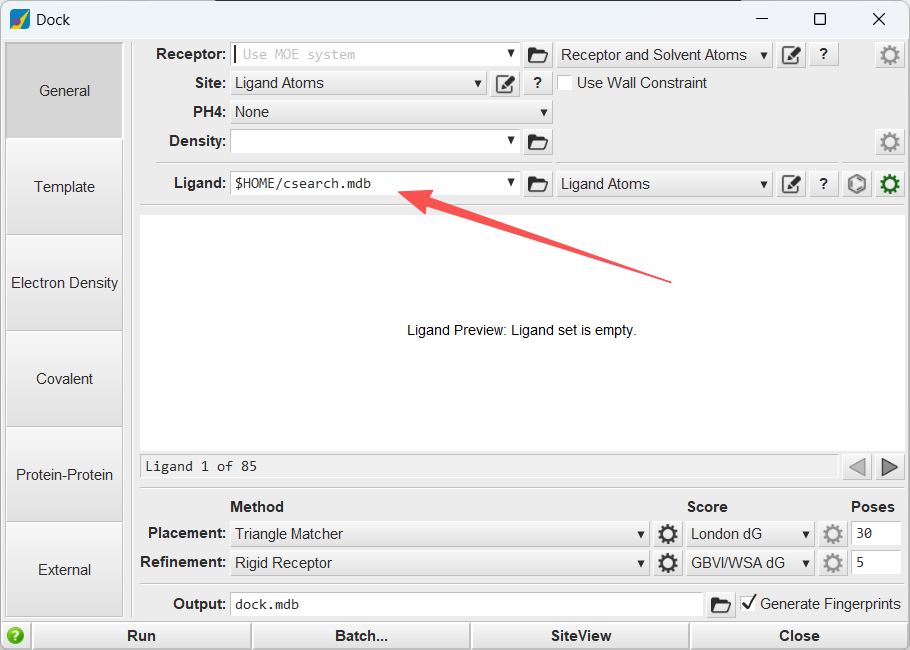
General Dock 可以简单理解为:
Ligand Input
↓
Placement
↓
Scoring
↓
Refinement
↓
Final Scoring
↓
Docking Poses
这里 Ligand 不再是一个单独结构,而是前面生成的 csearch.mdb。
七、关键设置:Conformations → Use Existing
点击 Ligand 数据库选择:
csearch.mdb
然后进入 Ligand Options,将:
Conformations → Use Existing
打开。
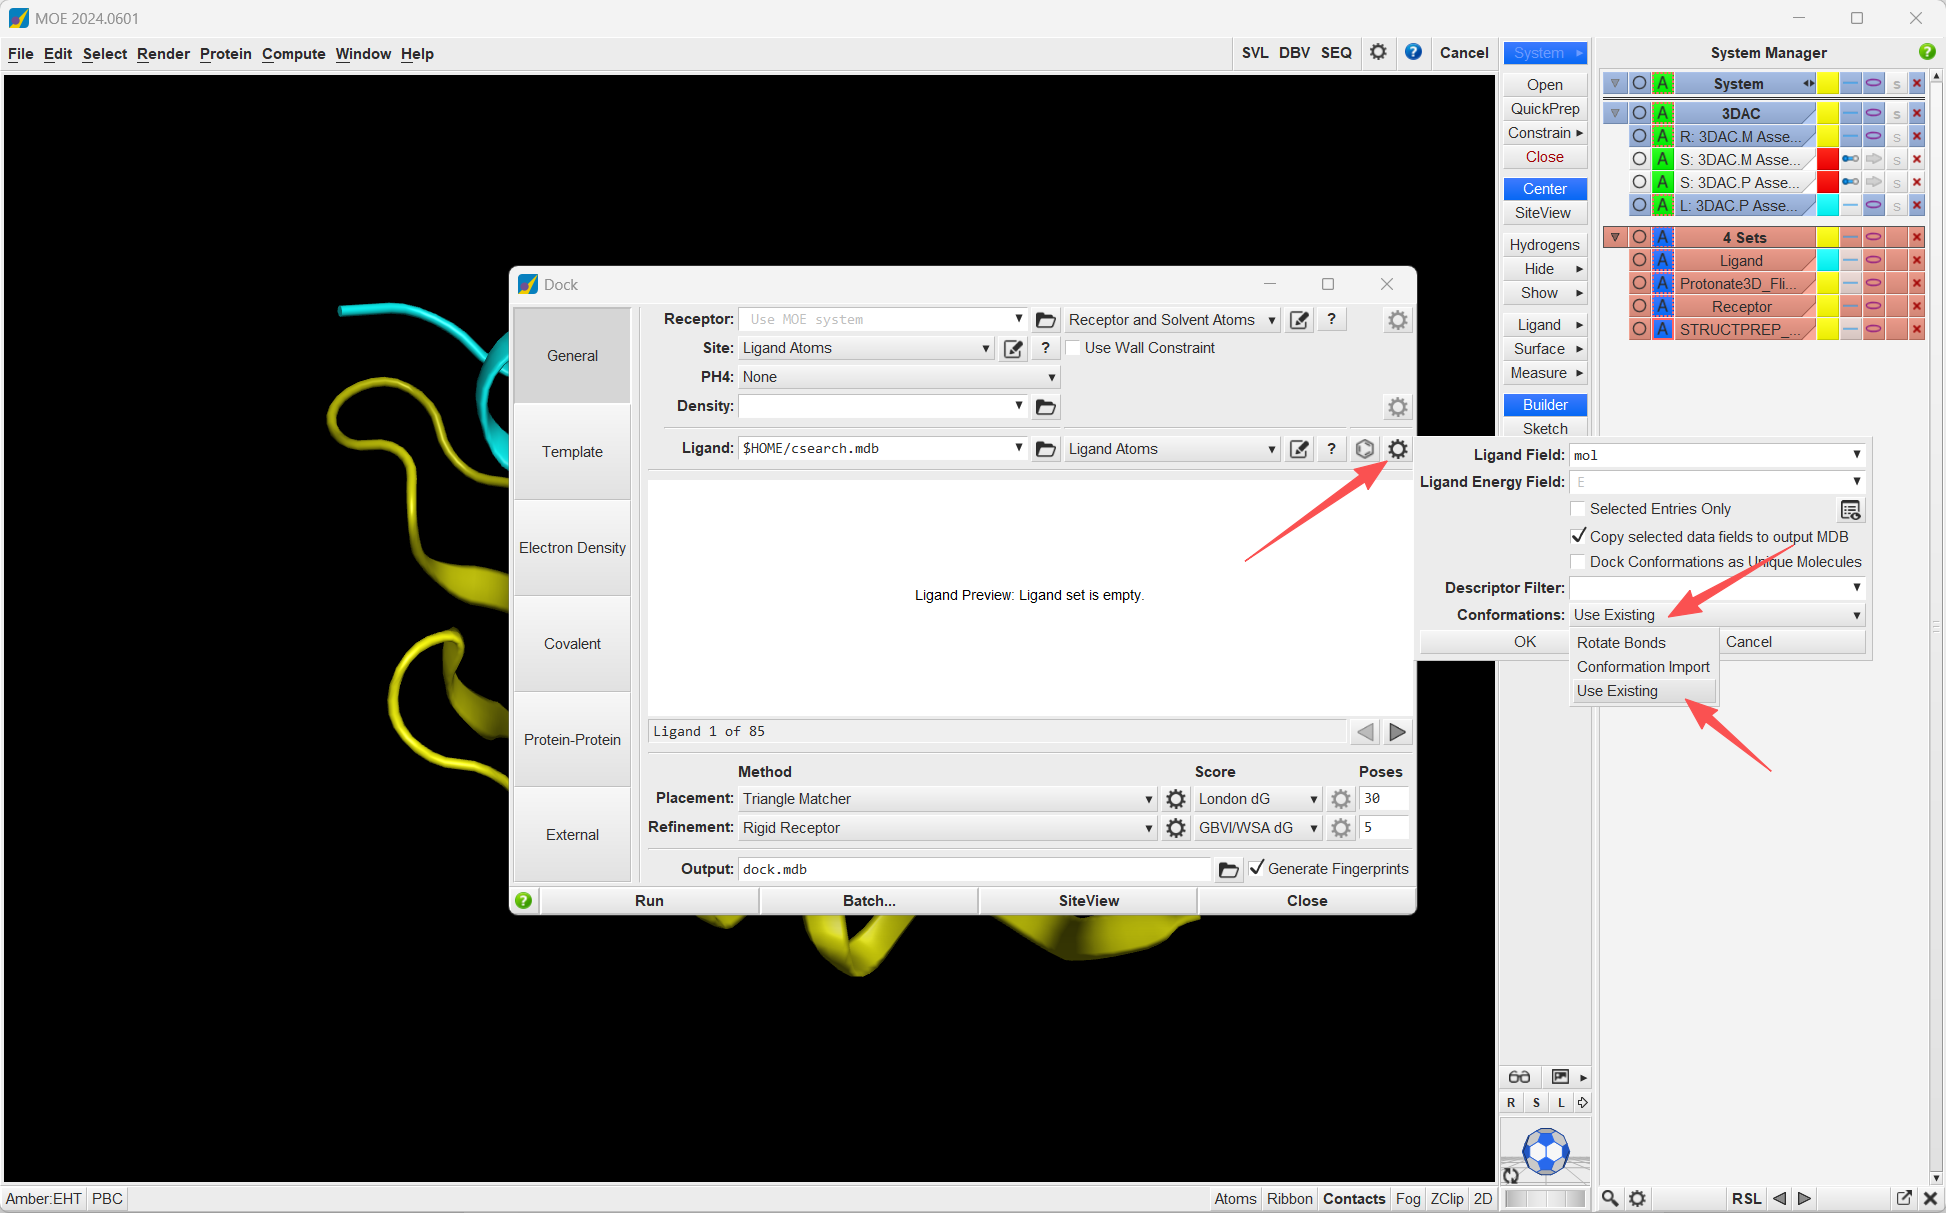
这一步是整个流程中非常关键的连接点。
它表示:
Docking 直接使用前面 Conformational Search 已经生成的肽构象。
因此:
Conformational Search
↓
csearch.mdb
↓
General Dock:Use Existing
三个步骤就真正串联起来了。
八、运行 Docking
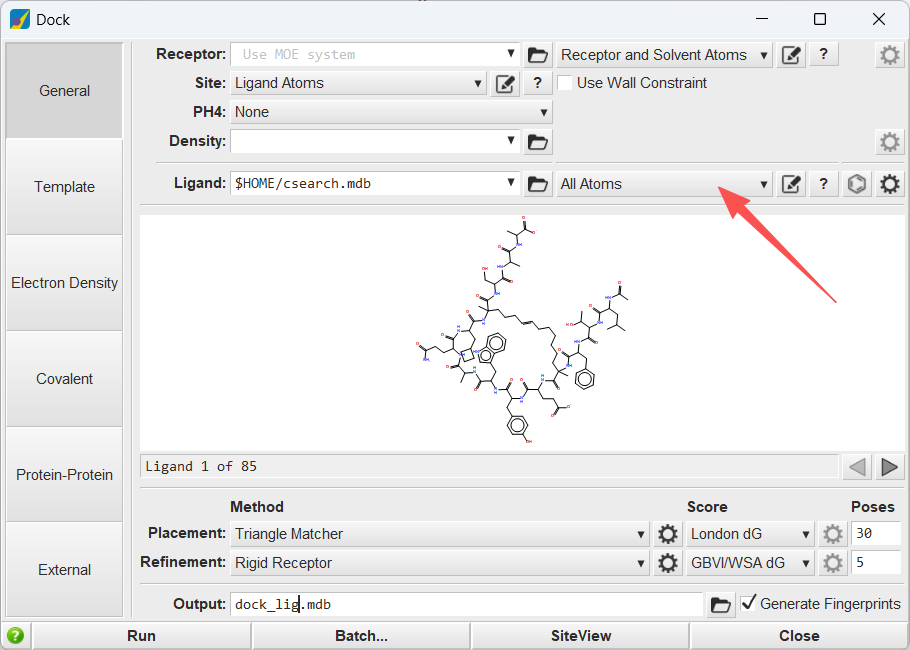
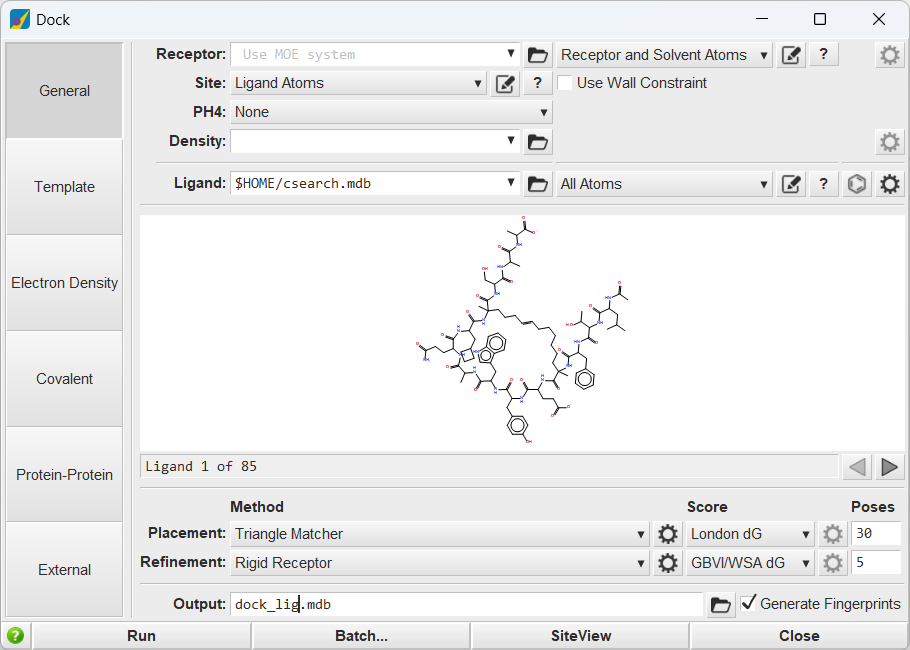
由于构象数据库中的 peptide 在这里被识别为 Receptor,需要在 Ligand 下拉选项中选择:
All Atoms
然后设置输出数据库,例如:
dock_lig.mdb
即可运行 Docking。
默认示例保留 30 个 poses 进入 refinement,但对于 peptide conformational database,建议增加这一数量。
更充分的计算示例中使用了:
Refined poses = 400
并最终返回:
50 poses
同时,前面的构象搜索也使用了更多 iterations,以获得更加充分的 peptide conformational sampling。
因此实际项目中要注意:
前面的构象采样和后面的 Docking pose 搜索是相互关联的。
构象库采样不足,后面的 Docking 很难补救。
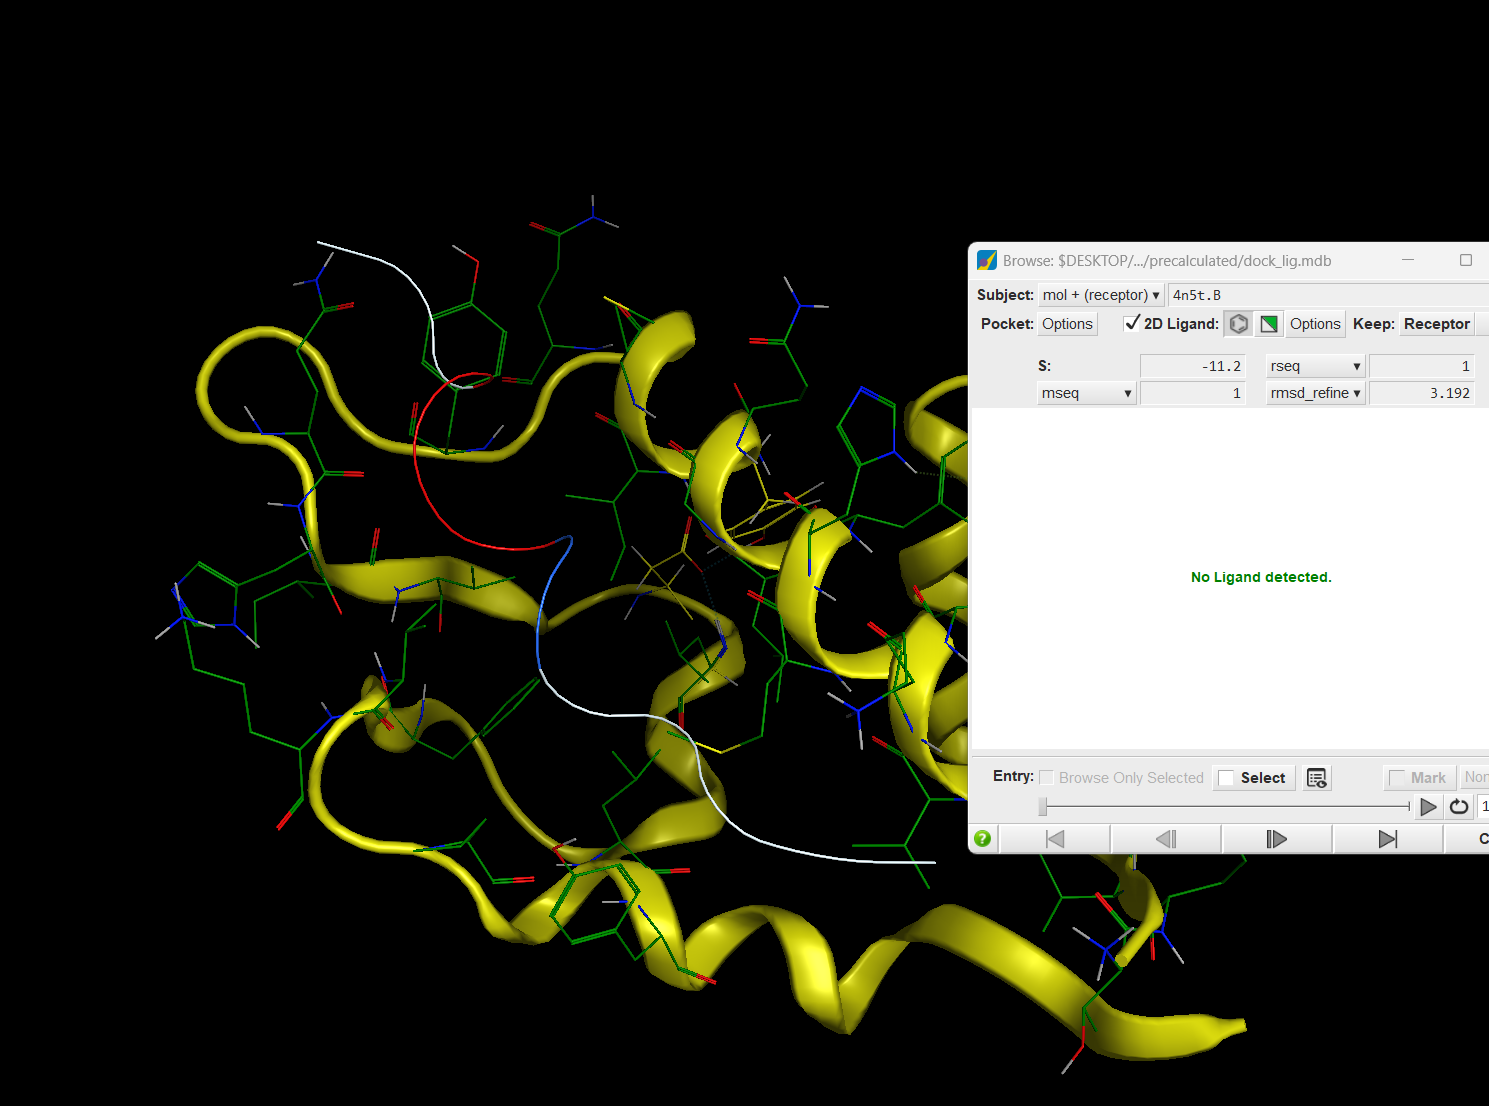
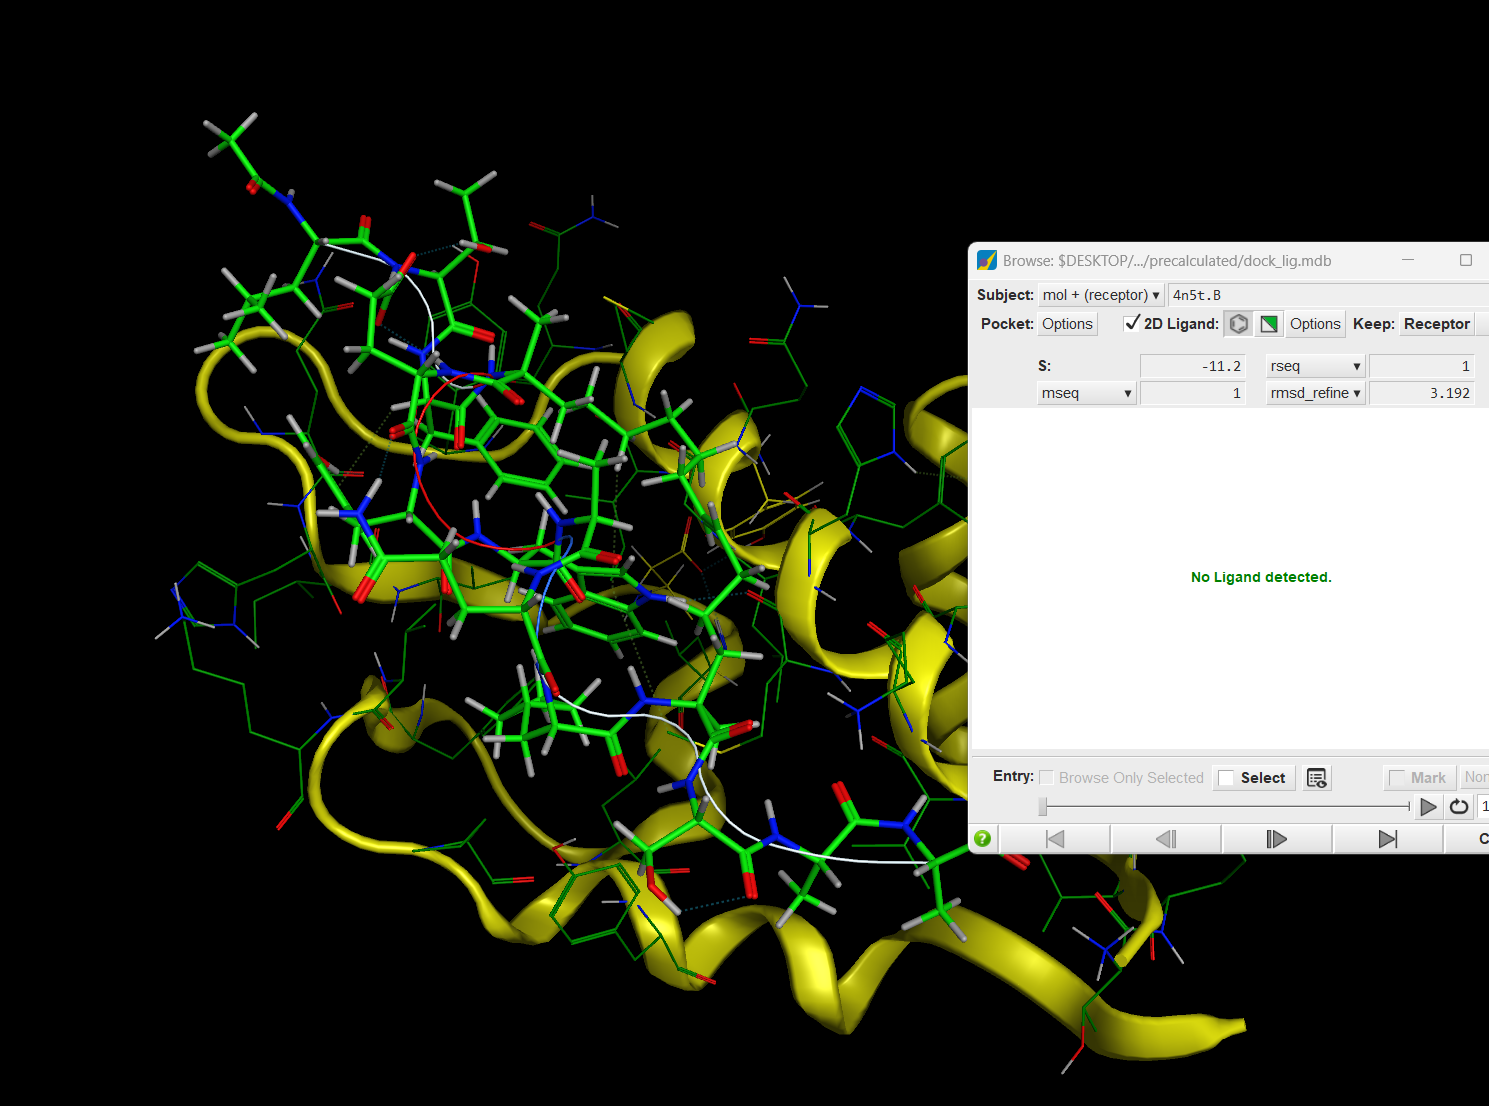
九、浏览最终 Docking Pose
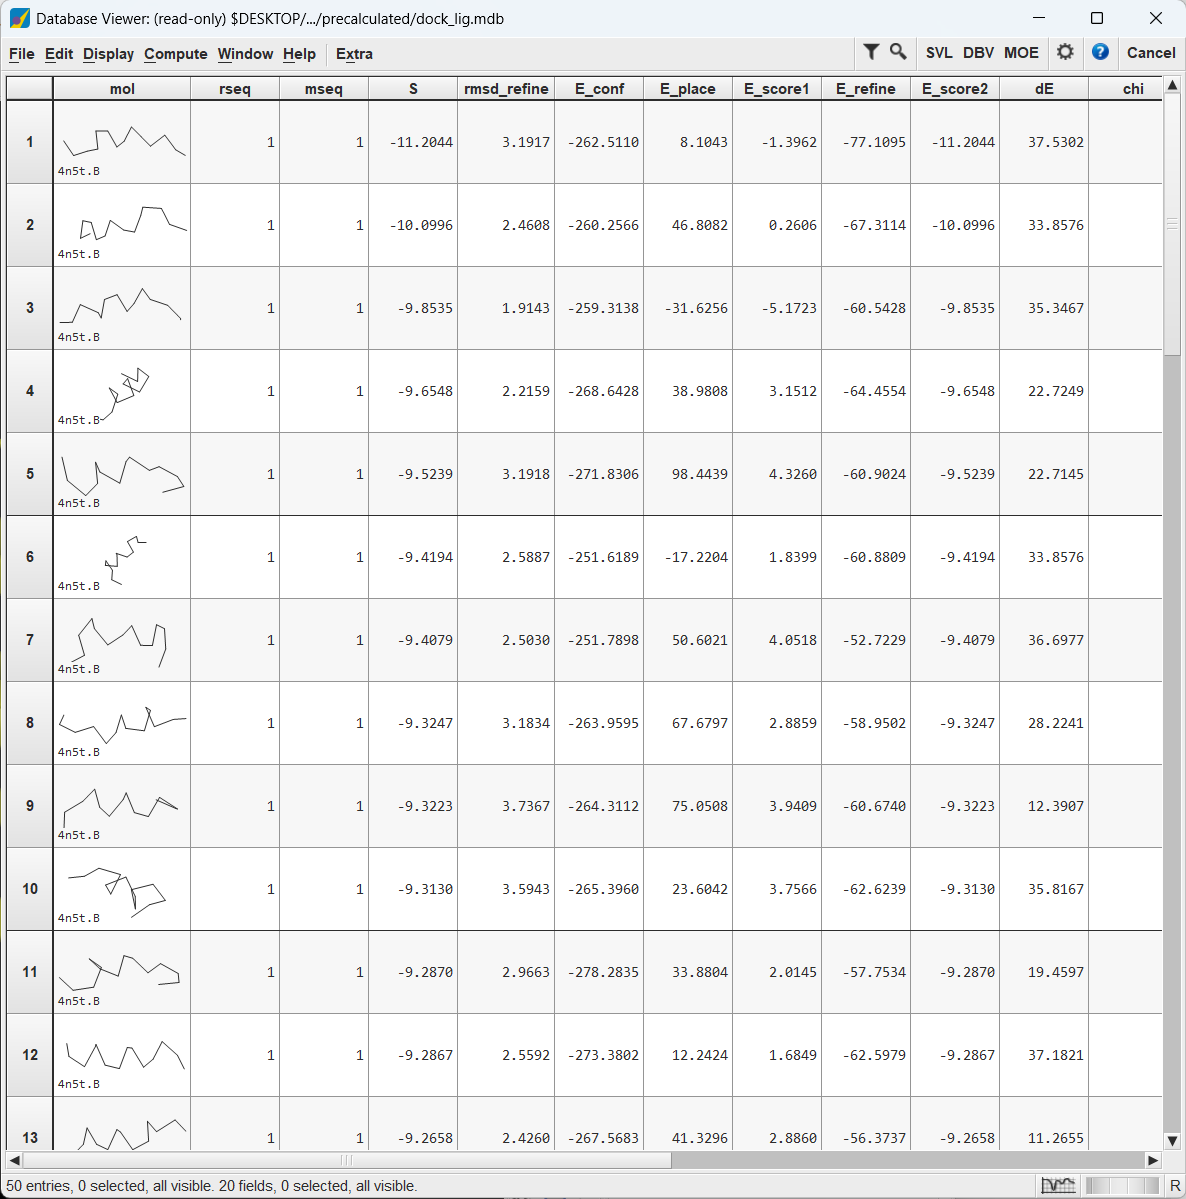
计算完成后,最终 poses 会写入数据库,并按照最终评分 S 排序。
通过:
DBV → File → Browse
可以逐个查看 Docking Pose。
在这个案例中,排名第一的 stapled peptide pose 与 3DAC 晶体结构中 bound p53 peptide 的结合构象具有相似性。
十、不要只看排名第一的 Pose
做到这里,我们已经完成:
Peptide
→ Conformational Search
→ Conformational Database
→ General Dock
→ Docking Poses
但 Docking Score 只是第一层筛选。
对于肽,我们真正关心的还包括:
关键残基有没有进入正确区域?
已知氢键有没有形成?
疏水残基的空间位置是否合理?
不同高排名 Pose 是否具有共同的相互作用模式?
因此下一步不能只是机械地选择 Score 最好的结构。
我们需要从:
"哪个 Pose 分数最好?"
进一步走向:
"哪些 Pose 保留了我们真正关心的蛋白--肽相互作用?"
这就需要使用 PLIF------Protein-Ligand Interaction Fingerprints。
本篇总结
柔性肽进行 Protein--Ligand Docking 时,一个实用策略是先通过 Conformational Search 建立 peptide conformational database,再将构象库输入 General Dock。
对于 stapled peptide,还可以通过 Rigid Body Set 保持需要维持的局部二级结构,同时采样其他柔性区域。
因此整套计算流程可以概括为:
Structure Preparation → Rigid Body Definition → Conformational Search → csearch.mdb → General Dock → Use Existing → Refinement & Scoring → dock_lig.mdb
这实际上是把一个复杂问题拆成了两个相对清晰的问题:
先解决"肽可能长什么样",再解决"这些构象怎么和蛋白结合"。
下一篇
MOE 肽类药物设计(十三):Docking Pose 太多怎么筛?用 PLIF 从"分数"转向"相互作用模式"