大模型擅长写出一段人能读懂的文字,但程序往往需要的是另一种东西:一个可以直接用来分流、排序、拦截或触发下一步的判断。
TypeSafe 的 Jev 瞄准的正是这个缺口。它不以生成长文本为目标,而是让你提交一段 state 和一组定义明确的问题,返回带概率分布的结构化答案。本文从实际接入开始,讲清它适合解决什么问题、怎样调用,以及如何把不确定性真正写进业务流程。
先说结论:Jev 适合什么,不适合什么
Jev 是 TypeSafe 的 System One 模型。它适合在已有输入上做快速、边界清晰的判断,例如:
- 这张工单该分给哪个团队?
- 这条消息是否表达了紧急性?
- 风险落在哪个已定义的等级?
它不替代需要长篇推理、开放式创作或对话回复的生成式模型。一个实用的判断标准是:一位熟悉业务的人拿到同样的上下文后,能否在几秒内对一个单一问题作出判断?能,就很适合拆成 Jev 问题。
System One:把"快思考"变成智能 if 语句
丹尼尔·卡尼曼在《思考,快与慢》中用"系统 1"描述快速、自动、凭直觉完成的判断;"系统 2"则更缓慢、费力,需要有意识推演。TypeSafe 所说的 System One 借用了这一区分,来界定 Jev 的工作边界:给定明确的 state 和一个原子问题,快速返回可由程序消费的结构化判断。
所以 Jev 的价值不是代替所有思考,而是把高频、边界明确的判断做成可靠的"智能 if 语句"。它不适合作为长篇对话、复杂数学推理、棋类规划或跨多步论证的替代品。
这里的 System One 是产品与任务定位的类比,不等同于对人类认知机制的技术复现,也不构成心理学或神经科学主张。
训练路线:RLHF、RLVR、RLCD 分别在优化什么
理解缩写的重点不在于判断谁"更先进",而是分辨它们面向哪种输出与任务目标。
| 缩写 | 含义 | 适合理解的任务取向 |
|---|---|---|
| RLHF | Reinforcement Learning from Human Feedback,基于人类反馈的强化学习 | 让预训练模型更符合人类偏好的回答方式,常见于面向对话与文本生成的模型 |
| RLVR | Reinforcement Learning from Verifiable Rewards,基于可验证奖励的强化学习 | 奖励可由正确性等方式验证,常用于需要严密推演的任务;这类推理取向可能带来更高延迟与成本 |
| RLCD | Reinforcement Learning from Contrast Distillation,来源文档译为"对比蒸馏强化学习" | TypeSafe 将其描述为优化决策过程,以输出经过校准的决策与概率值,而非生成一段文本 |
对开发者而言,更实用的选择原则是:如果代码需要可执行的分类、分数、概率和置信度,优先考虑 Jev;如果需要开放式解释、创作或逐步推理,再考虑生成式或推理模型,并在系统中组合两者。
接入前准备:账号、API Key 与 Agent Skill
先在 TypeSafe 官网点击 Join Waitlist 申请访问。收到邀请邮件后创建账号,再进入 Console → API Keys 创建 API Key。
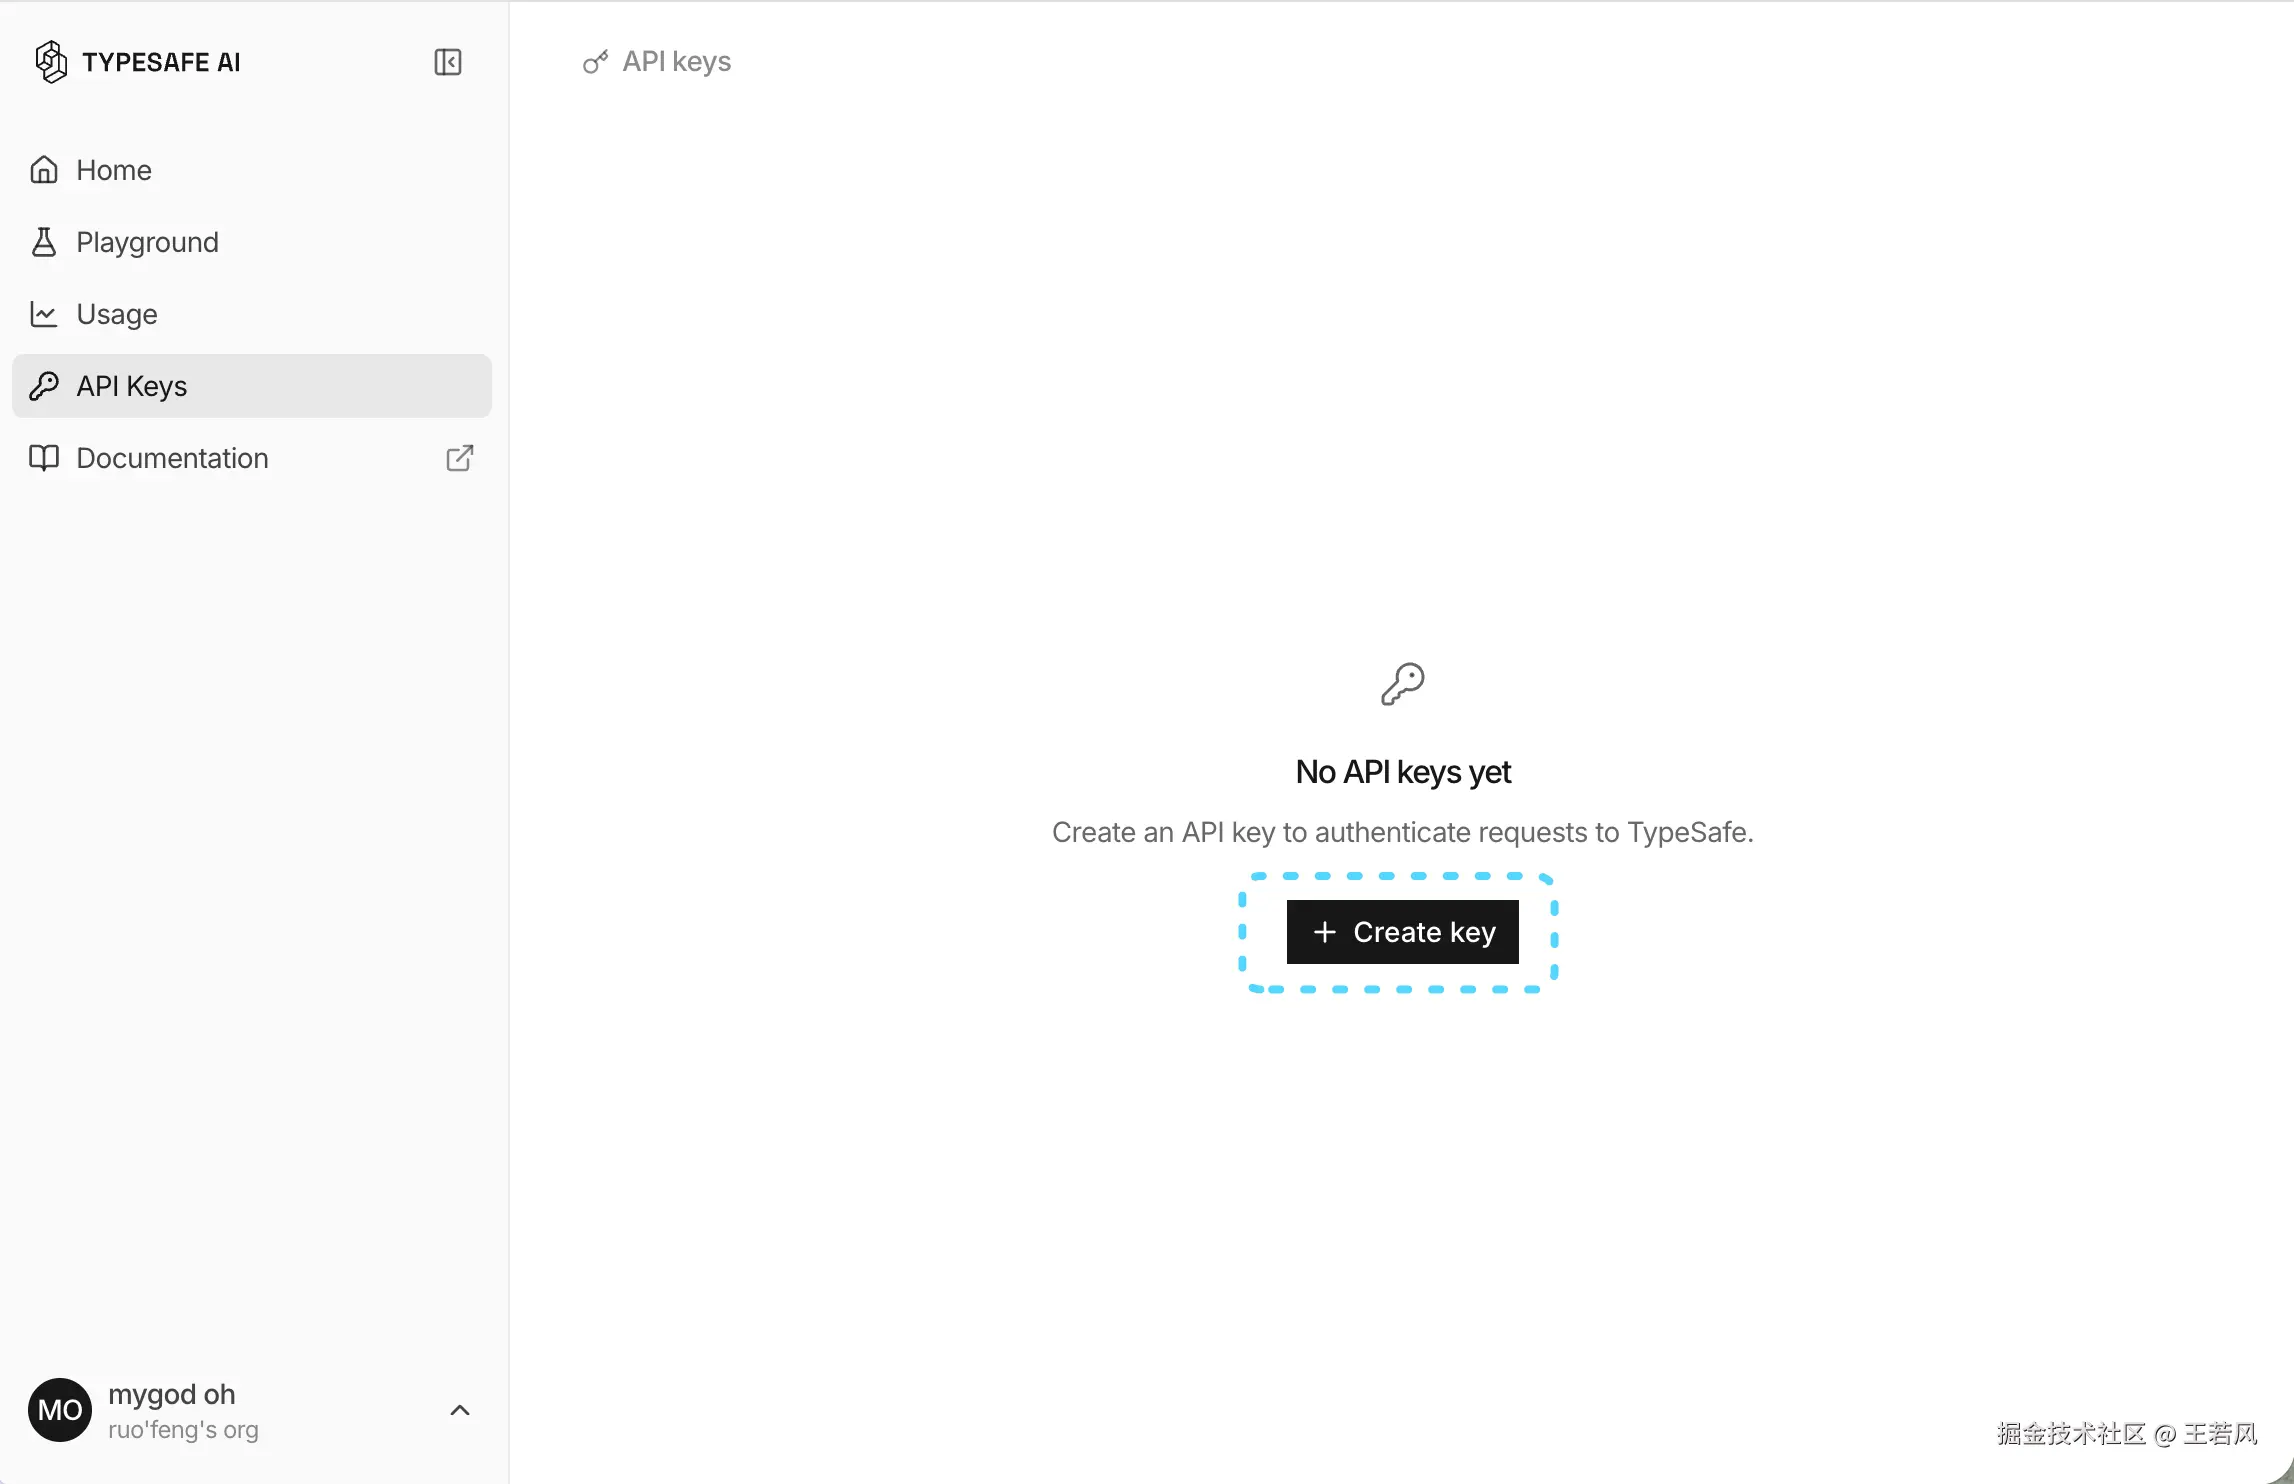
API Key 应只放在服务端环境变量或密钥管理服务中,不能提交到 Git 仓库、出现在前端代码或日志里。怀疑泄露时,应在 Console 中停用并重新创建。
如果希望让 Coding Agent 帮忙接入,可安装 TypeSafe 的官方 Skill:
bash
npx skills add typesafe-ai/skills --skill typesafe-ai然后在任务中明确要求 Agent 使用它:
text
Use the TypeSafe skill to integrate Jev into this project.先在 Playground 验证问题设计
在写业务代码之前,先打开 TypeSafe Playground,用真实但不包含敏感信息的样本验证问题边界、选项描述和评分等级。
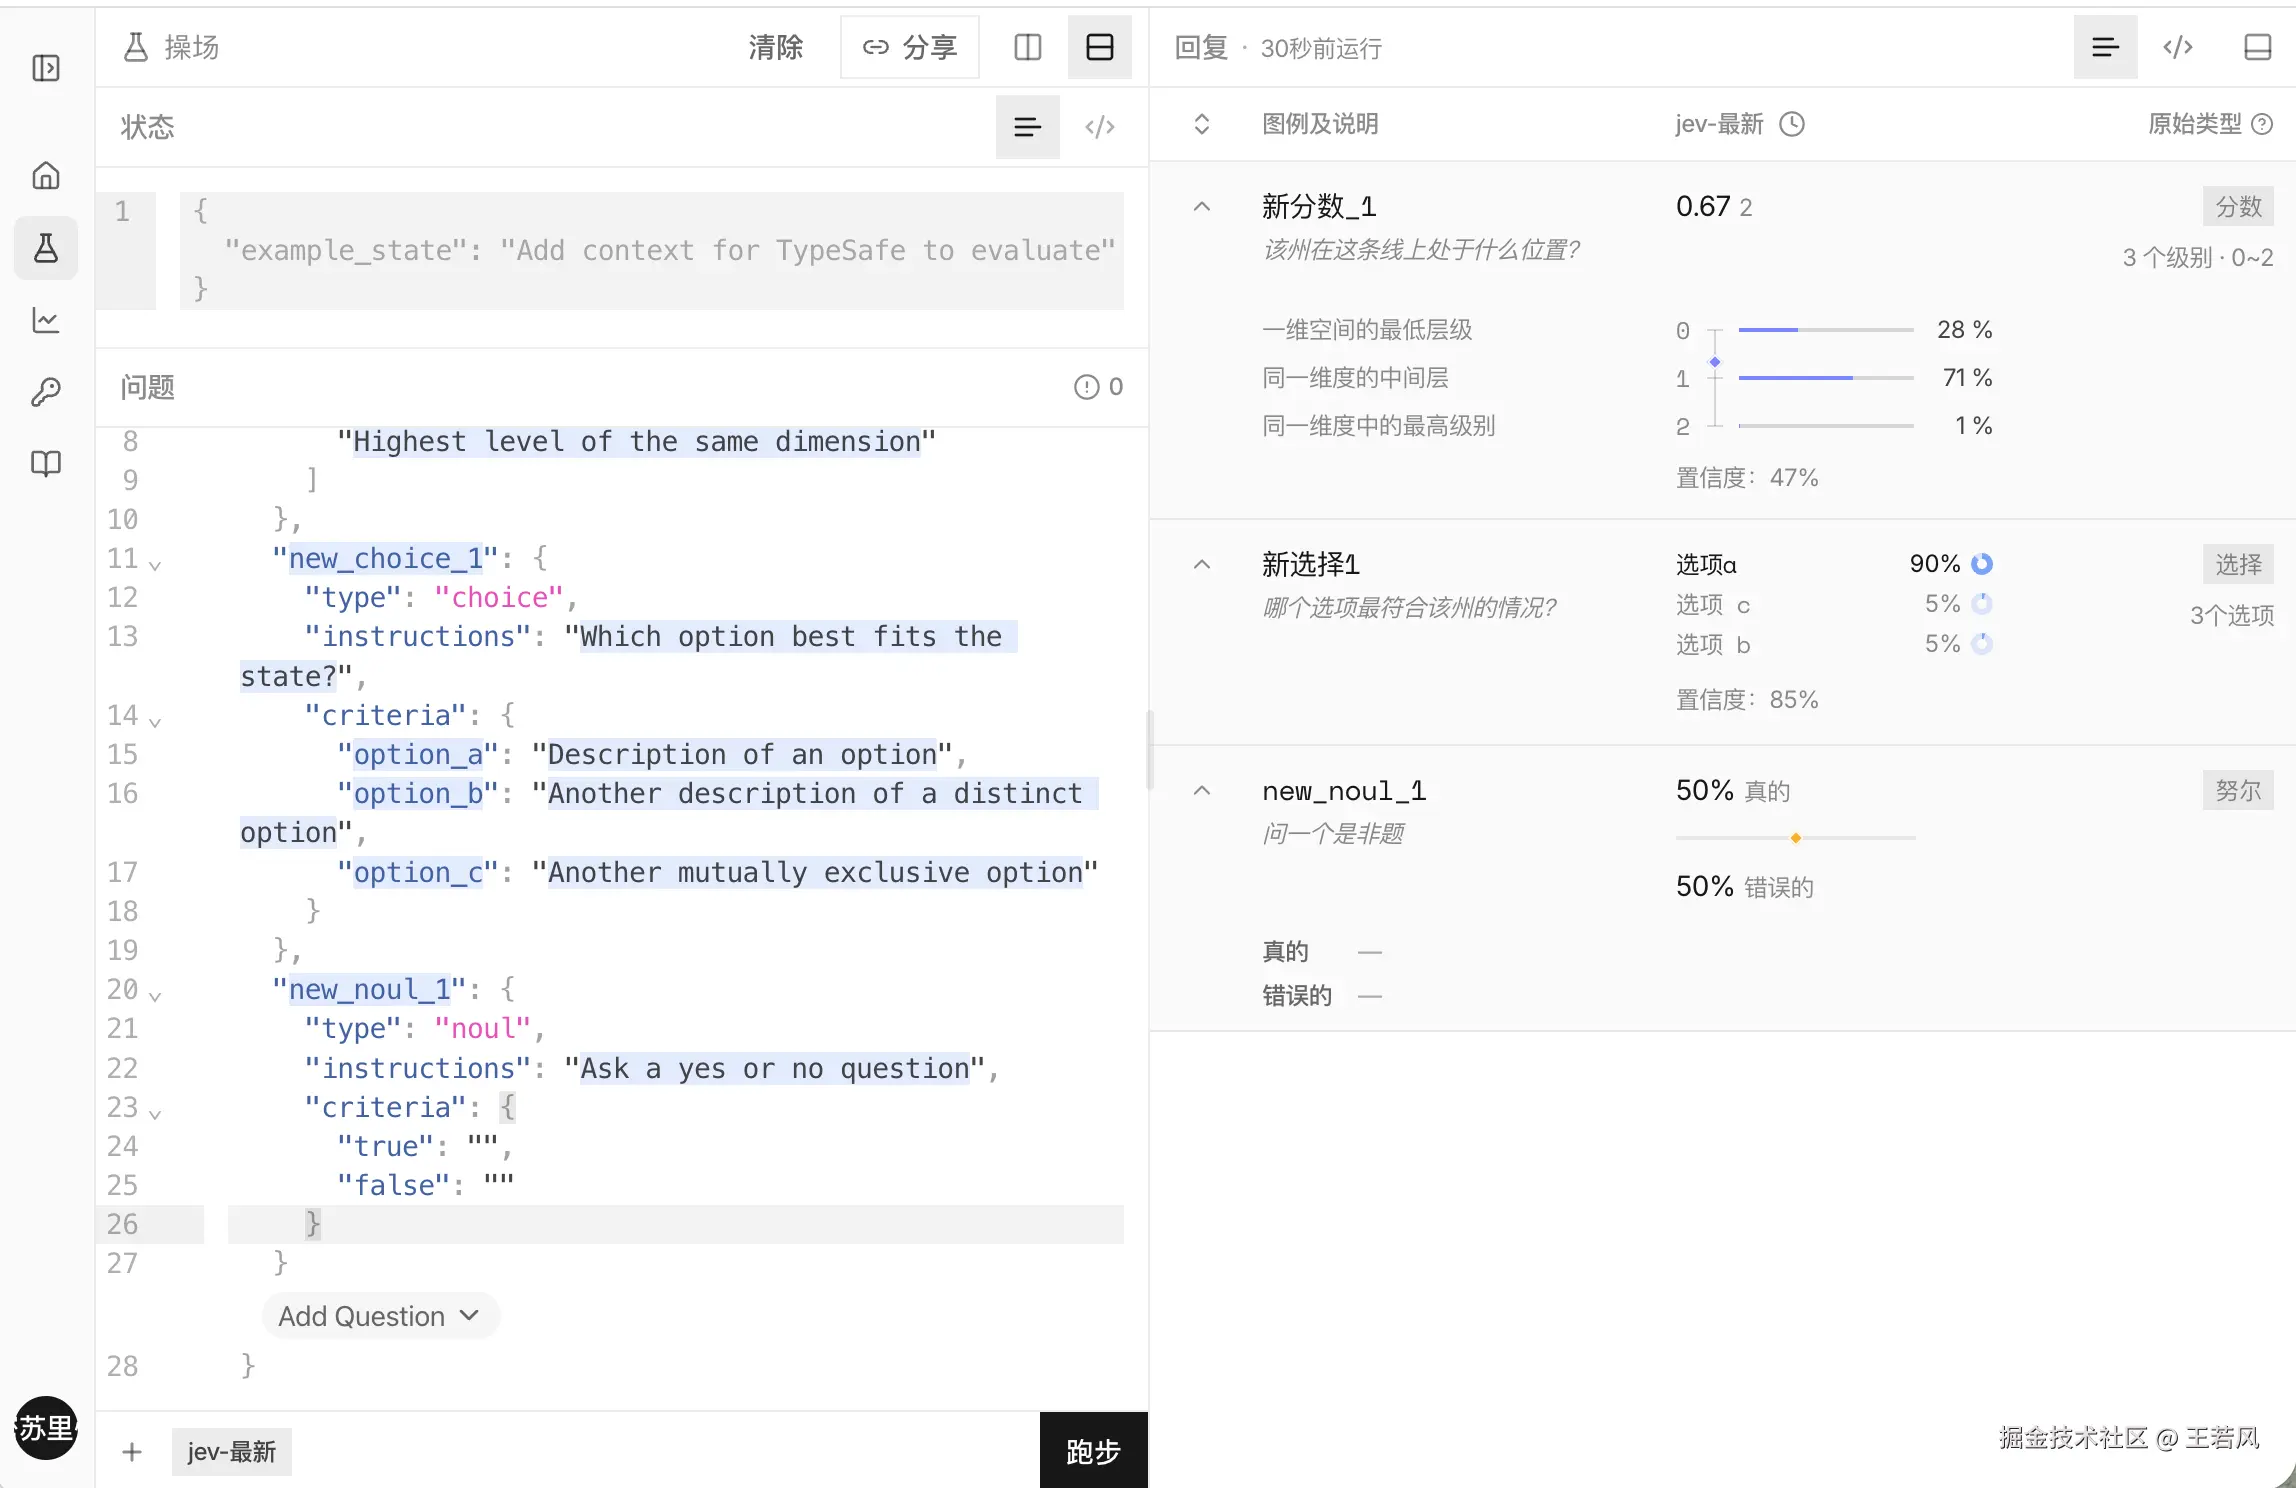
先从一个简单的 Noul 问题开始:
json
{
  "urgency": {
    "type": "noul",
    "instructions": "这条消息是否表达了紧急性?"
  }
}
这一步不是反复调"提示词文案",而是确认问题的边界足够清楚:哪些输入该命中、哪些相邻情况不该命中、置信度低时系统要怎样处理。
第一次 API 调用:一次做三个判断
Jev 的接口是 POST https://api.typesafe.ai/v1/systemone。请求顶层只有三个核心字段:
| 字段 | 作用 |
|---|---|
state |
要被判断的上下文,例如工单、简历、商品信息或事件记录 |
model |
选择模型;快速开始可使用 jev-latest |
questions |
"问题 ID → 问题定义"的映射;答案会按相同 ID 返回,ID 本身不会发给模型 |
下面的例子对同一条客服消息同时做路由、情绪分级和紧急性判断:
bash
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "state": "Stripe 账户连续 3 天无法连接,我正在损失订单,请尽快帮忙。",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "哪支团队应处理此消息?",
      "criteria": {
        "billing": "支付、订阅或账单问题",
        "technical": "产品故障、集成或技术问题",
        "sales": "价格、方案或账户咨询"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "客户表现出多强的挫败感?",
      "criteria": [
        "平静陈述事实",
        "感到挫败但保持礼貌",
        "非常愤怒或使用强烈措辞"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "该消息表达了紧急性或时间敏感性。"
    }
  }
}
EOF
同一请求中的问题会针对同一份 state 并行、彼此独立地评估。优先把当前流程可能需要的问题一起发出,再由代码决定哪些答案应被采用;相较为每个问题单独请求,这种方式通常更快,但额外问题仍会增加 token 成本。
Choice、Score、Noul:三种问题怎么选
| 类型 | 何时使用 | 关键返回值 |
|---|---|---|
| Choice | 答案来自一组没有顺序的固定选项 | choice、各选项 probabilities、confidence |
| Score | 答案位于一个可清楚描述的有序等级谱上 | score、各等级 probabilities、legend、confidence |
| Noul | 只需回答是或否 | noul:回答"是"的概率,范围为 0 到 1;不单独返回 confidence |
Choice:固定分类
用 Choice 处理"属于哪一类"。criteria 是"选项名 → 描述"的映射;选项名和描述都会给模型,因此描述必须明确区分相邻类别。类别可能覆盖不全时,加入 other 或 none_of_the_above。
Score:可解释的连续分级
用 Score 处理"处于什么程度"。criteria 是从低到高的有序数组,至少 2 档、最多 10 档。返回的 score 是等级位置的概率加权平均,因此可以是小数。不要只读一个分数,要连同概率分布和置信度一起解释。
每个等级应描述具体情境,例如"功能受损,但存在可用替代方案",而不是"中等严重"。不要让一个 Score 同时衡量"准时、聪明、有经验"这类多个维度;拆开后再在代码中加权组合。
Noul:明确的二元判断
用 Noul 处理"是否"。noul = 0.999 表示"是"的概率很高,0.001 表示"否"的概率很高,接近 0.5 则说明正反证据接近。尽量把 instructions 写成"高值就是是"的句子;边界微妙时可增加 true 与 false 的 criteria 说明。
实测:返回结构和计算方式都可直接验证
对上述客服消息的实际调用,jev-latest 返回了具体版本 jev-1.13.0,并给出了以下结果:
json
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.66,
      "probabilities": {
        "billing": 0.23,
        "technical": 0.77,
        "sales": 0
      }
    },
    "frustration": {
      "type": "score",
      "score": 0.98,
      "confidence": 0.96,
      "legend": {
        "0": "平静陈述事实",
        "1": "感到挫败但保持礼貌",
        "2": "非常愤怒或使用强烈措辞"
      },
      "probabilities": {
        "0": 0.03,
        "1": 0.97,
        "2": 0
      }
    },
    "is_urgent": {
      "type": "noul",
      "noul": 0.98
    }
  }
}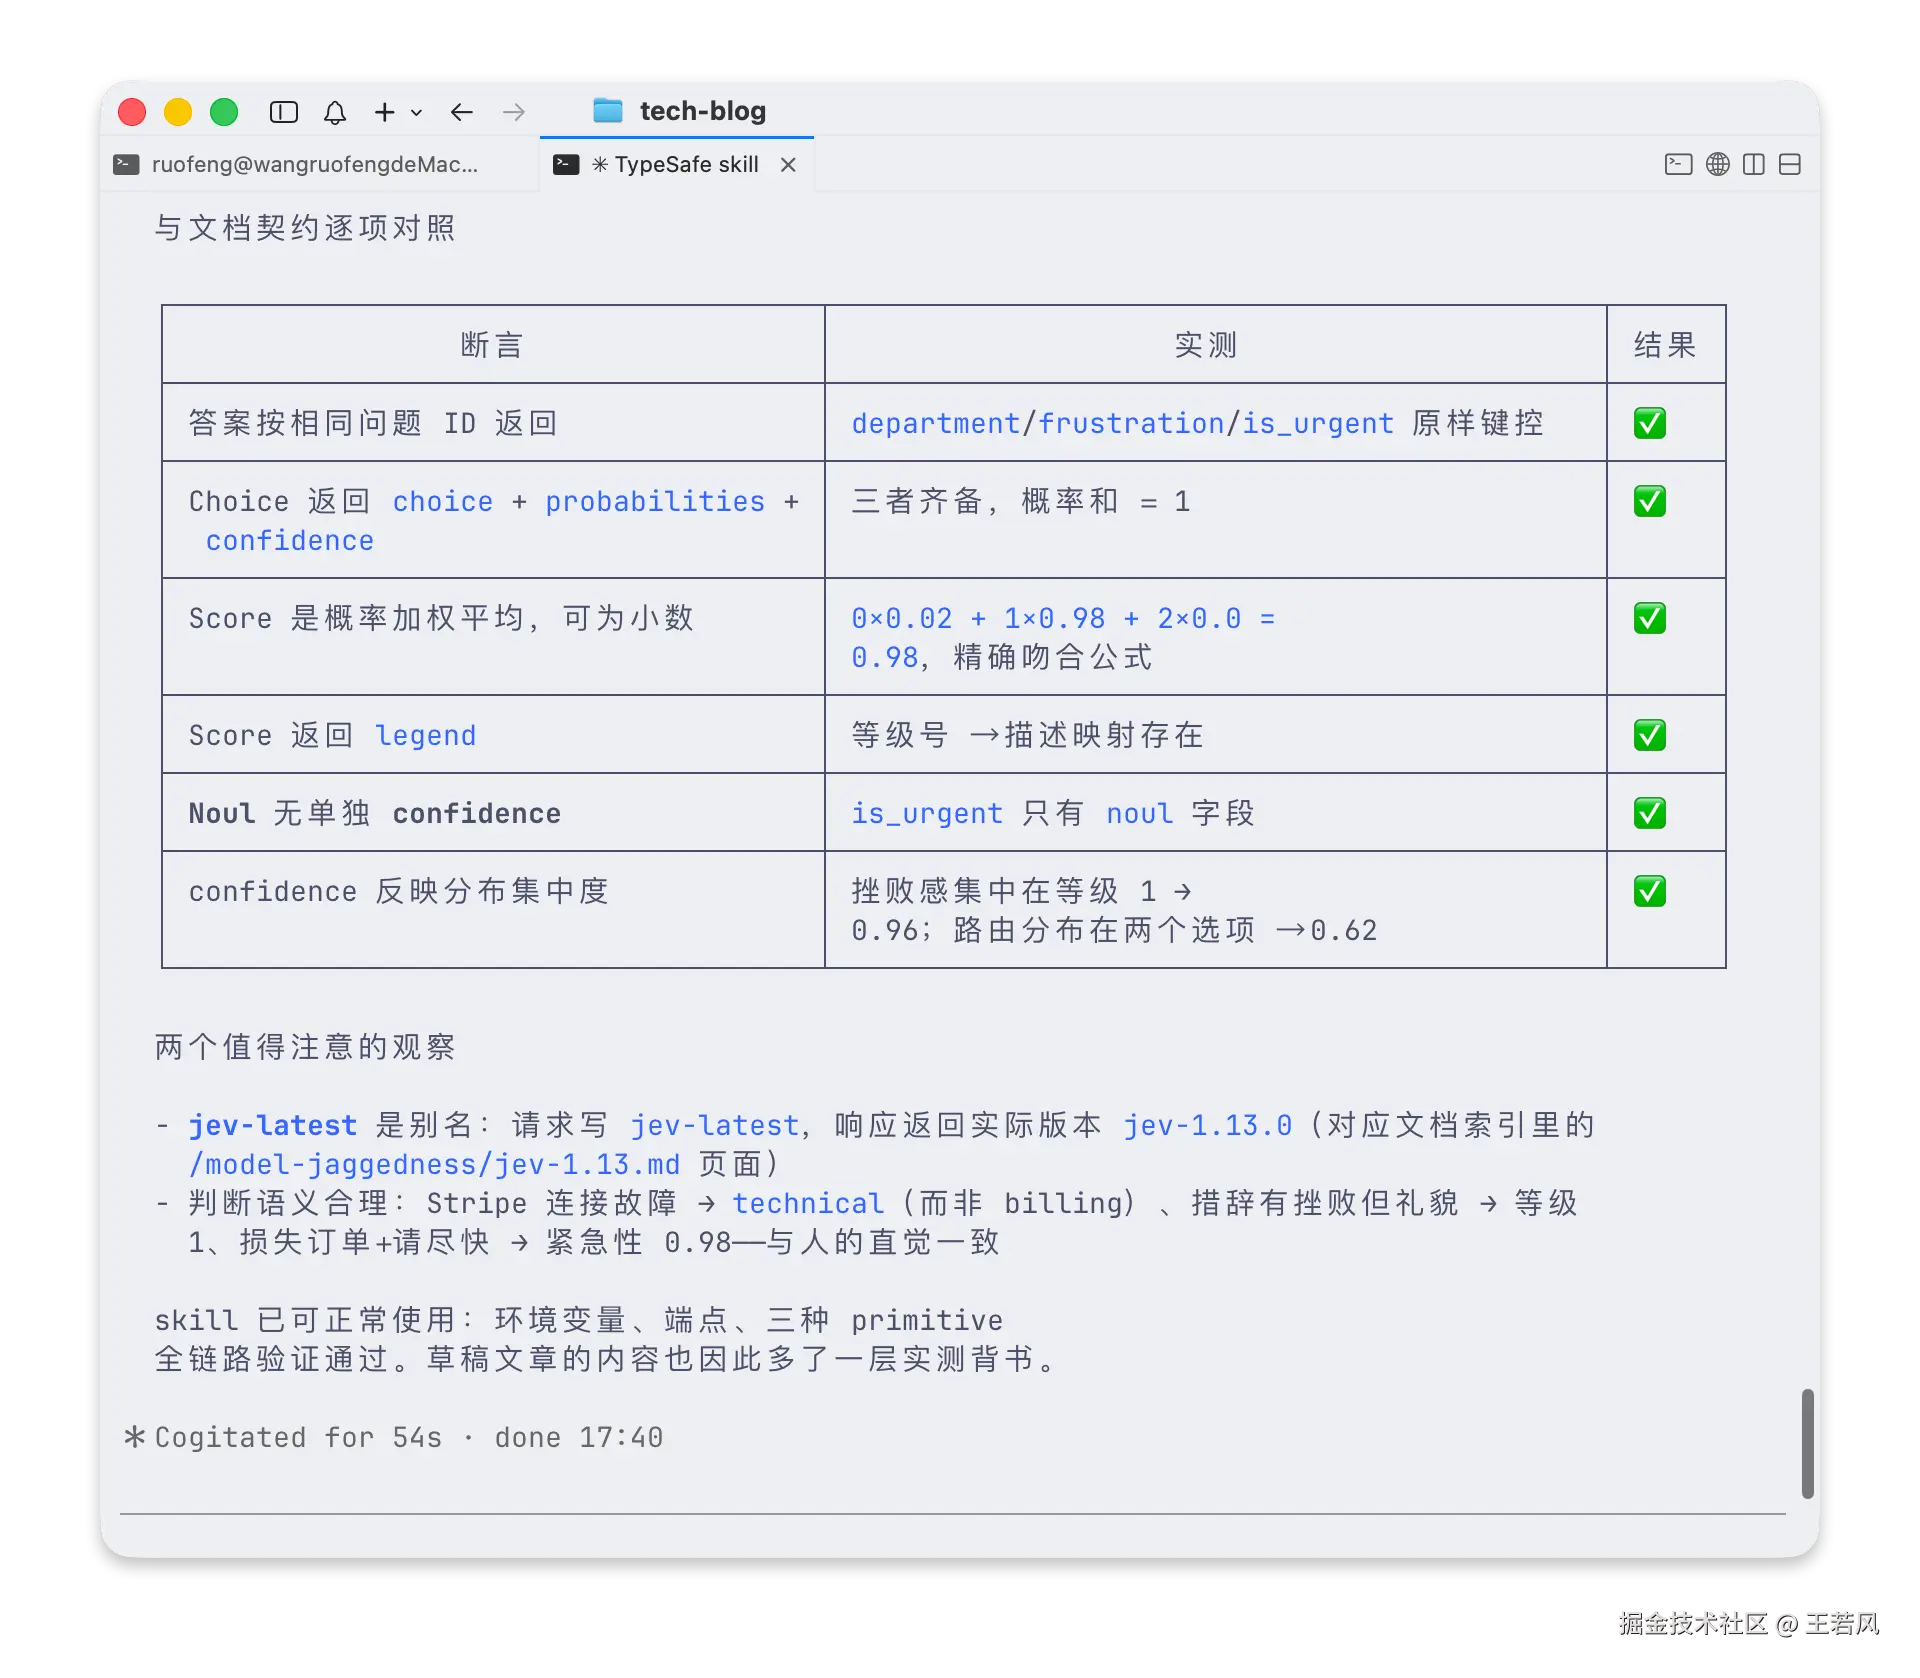
这个结果有几个值得注意的地方:
department按请求中的同名问题 ID 返回,choice、probabilities和confidence都齐全;三项概率之和为 1。frustration.score是等级位置的概率加权平均。响应中展示的概率可能经过四舍五入,因此排查时应以当次完整响应为准,而不是用展示后的有限小数重新计算。- Score 的
legend将等级编号映射回描述;Noul 则只有noul字段,不单独提供confidence。 - 模型别名
jev-latest会在响应中落到实际版本。因此业务系统应使用别名保持升级弹性,同时记录返回的具体版本,方便排查差异。
置信度不是装饰字段,而是路由信号
Choice 和 Score 会返回 confidence,其值来自概率分布的集中程度:结果集中在一个选项或等级,置信度更高;分散在多个结果,置信度更低。它不是"结果绝对正确"的保证,而是模型在表达"这道题是否存在清晰答案"。
| 置信度区间 | 建议的系统行为 |
|---|---|
| 高 | 可自动执行低风险、可逆操作 |
| 中 | 保留建议结果,但要求用户确认、标记复核或补充信息 |
| 低 | 不要自动行动;转人工、请求澄清或回退到其他流程 |
阈值必须随风险变化:读操作可以较宽松;删除、付款、权限变更等高后果动作,应采用更严格的阈值,并保留人工确认。
python
answer = response.answers["department"]

if answer.confidence >= 0.85:
    route_to(answer.choice)          # 自动分派
elif answer.confidence >= 0.50:
    flag_for_review(answer.choice)   # 建议分派,等待确认
else:
    ask_for_clarification()          # 不做自动决定
从 Demo 到可靠系统:四个原则
- 一个问题只问一个原子判断。 "给这个创业项目打分"混合了市场、技术、差异化等多个维度。应拆成多个 Score,再由代码明确权重。
- 把组合逻辑留在代码里。 模型负责单项判断;优先级、阈值、权限和业务规则由普通条件分支或公式控制,便于审计与调整。
- 允许推测性并行提问。 例如先问工单归属,同时询问"退货原因"和"物流问题";最终只消费与路由结果相关的答案。这是 Speculative Fan-Out 模式。
- 用自己的历史样本验证。 为每个问题准备已知期望结果的样本,检查描述改动是否提升实际效果。更高的
confidence不自动等于更正确。
常见误区
- 把开放式生成需求硬塞进 Jev。 需要写邮件、总结报告或多步推理时,优先考虑生成式模型,或只将其中可判定的部分交给 Jev。
- Choice 选项描述互相重叠。 把每个选项"包括什么、不包括什么"写清;必要时提供少量贴近真实输入的示例。
- 只使用 Score 的整数档位。 小数分数承载了多个等级之间的概率权重;应连同
probabilities与confidence解读。 - 低置信度仍自动执行高风险操作。 不确定性本身就是系统输入,不是可以忽略的异常。
- 把问题 ID 当成模型指令。 模型不会看到问题 ID;关键边界必须写在
instructions和criteria中。
下一步
- 用 Playground 为一个真实但低风险的业务场景写出 3 个原子问题。
- 用 cURL 或 SDK 接入服务端,并记录输入、答案、概率和最终人工或程序决策,注意对生产数据脱敏。
- 为每个业务动作定义风险等级与置信度策略。
- 阅读官方 Patterns,按需要采用 Confidence-Gated Routing、Composite Scoring、Intent Routing 或 Speculative Fan-Out。