文章目录
- [1. 是什么?](#1. 是什么?)
- [2. 案例演示](#2. 案例演示)
-
- [2.1 集成 spaCy](#2.1 集成 spaCy)
- [2.2 抽取演示](#2.2 抽取演示)
- [2.3 抽取入库](#2.3 抽取入库)
-
- [2.3.1 模拟语料](#2.3.1 模拟语料)
- [2.3.2 模型抽取 & 写入节点元数据](#2.3.2 模型抽取 & 写入节点元数据)
- [2.4 构建检索器](#2.4 构建检索器)
- [2.5 执行查询](#2.5 执行查询)
- [2.6 使用 NER 标准组件](#2.6 使用 NER 标准组件)
1. 是什么?
命名实体识别 (Named Entity Recognition)用于识别查询语句内特定类型的信息并进行分类,以此实现更精准的检索与筛选策略。
通俗解释 :NER 就是从用户的问题文本里,自动把地点、人名、时间、角色、机构这类专有名词抽取出来并打上标签。在 RAG 检索场景里,抽取出的实体可以作为元数据,过滤向量库,缩小检索范围,让检索结果更贴合用户查询。
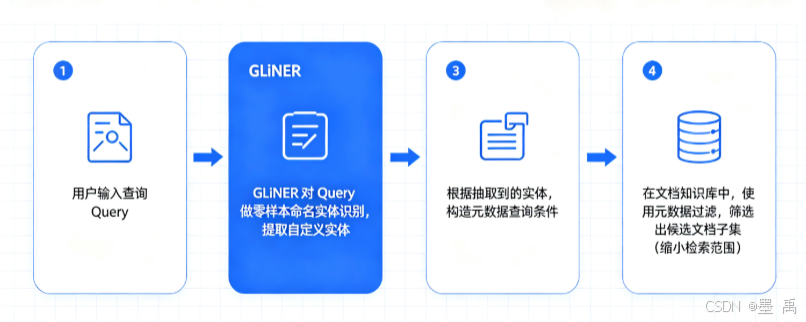
执行流程:
- 用户输入查询
Query GLiNER模型(NER开源模型)对Query做零样本命名实体识别,提取自定义实体- 根据抽取到的实体,构造元数据查询条件
- 在文档知识库中,使用元数据过滤,筛选出候选文档子集(缩小检索范围)
NER本身不是检索器,它的价值是给每个节点打上实体标签。
2. 案例演示
最小实现演示,所以效果一般...
python
from pathlib import Path
import tempfile

from llama_index.core import Settings, SimpleDirectoryReader, VectorStoreIndex
from llama_index.core.node_parser import SentenceSplitter
from llama_index.core.vector_stores.types import (
    FilterCondition, FilterOperator, MetadataFilter, MetadataFilters,
)
from llama_index.embeddings.openai_like import OpenAILikeEmbedding
2.1 集成 spaCy
spaCy 是工业级、面向生产环境的 Python 开源 NLP 库,2015 年发布,主打高性能、开箱即用的一体化 NLP 流水线。
核心能力(内置流水线组件):
- 分词 Tokenization:语言学驱动分词,支持标点、缩写、复杂文本拆分,比基础空格分词更智能
- 词性标注 POS Tagging:标记词语词性(名词、动词、形容词等)
- 词形还原 Lemmatization :把单词还原为词根原形(如
running → run) - 依存句法分析 Dependency Parsing:识别词与词之间语法依赖关系,可可视化句法树
- 命名实体识别 NER:提取实体,如人名、地点、机构、日期、产品,支持自定义实体训练
- 句子分割:自动切分句子边界
- 词向量与文本相似度 :预训练词向量,计算
Token/Span/Doc之间语义相似度 - 文本分类、实体链接 :
v3版本原生支持HuggingFace Transformer(BERT等)接入,支持多任务学习
一次性安装准备:
python
    pip install spacy
    python -m spacy download zh_core_web_sm     # 中文小模型,约 40MB
输出提示:
python
Requirement already satisfied: catalogue<2.1.0,>=2.0.3 in E:\ProgramData\miniconda3\envs\LlamaIndexProject\Lib\site-packages (from srsly<3.0.0,>=2.3.0->spacy-pkuseg<2.0.0,>=1.0.0->zh-core-web-sm==3.8.0) (2.0.10)
Installing collected packages: spacy-pkuseg, zh-core-web-sm
Successfully installed spacy-pkuseg-1.0.1 zh-core-web-sm-3.8.0
✔ Download and installation successful
You can now load the package via spacy.load('zh_core_web_sm')
查看模型装了哪些组件、认识哪些实体类型:
python
import spacy

nlp = spacy.load("zh_core_web_sm")

print("=" * 70)
print("模型流水线组件:", nlp.pipe_names)          # 例如 ['tok2vec','ner',...]

ner = nlp.get_pipe("ner")
print(f"模型认识的实体标签({len(ner.labels)}类): {sorted(ner.labels)}")
输出示例:
python
模型流水线组件: ['tok2vec', 'tagger', 'parser', 'attribute_ruler', 'ner']
模型认识的实体标签(18类): ['CARDINAL', 'DATE', 'EVENT', 'FAC', 'GPE', 'LANGUAGE', 'LAW', 'LOC', 'MONEY', 'NORP', 'ORDINAL', 'ORG', 'PERCENT', 'PERSON', 'PRODUCT', 'QUANTITY', 'TIME', 'WORK_OF_ART']
中文模型常见标签:
python
PERSON=人名 ORG=机构名 GPE=行政区划/地名 LOC=地点 ...2.2 抽取演示
准备文本进行对象抽取:
python
def extract_entities(text: str) -> list:
    """纯模型抽取:跑流水线 → doc.ents 按类型白名单过滤 → 去重排序。"""
    entities = {ent.text for ent in nlp(text).ents if ent.label_ in KEEP_LABELS}
    return sorted(entities)

SAMPLES = [
    "华为在深圳发布了新款昇腾芯片。",
    "明珠手机是华星科技发布的旗舰手机。",
]
for node in nodes:
    ents = extract_entities(node.get_content())
    node.metadata["entities"] = "、".join(ents)
    node.metadata["primary_entity"] = ents[0] if ents else "未知"
    print(f"\n节点 [{node.metadata.get('file_name')}] 入库实体: {ents}")
输出示例(效果一般):
python
文本: 华为在深圳发布了新款昇腾芯片。
    实体: 华为     类型: GPE(地名)
    实体: 深圳     类型: GPE(地名)
    实体: 昇腾     类型: PERSON(人名)
文本: 明珠手机是华星科技发布的旗舰手机。
    实体: 华星     类型: LOC(地点)
2.3 抽取入库
2.3.1 模拟语料
python
PHONE_DOC = (
    "明珠手机是华星科技于2023年发布的旗舰折叠屏手机,搭载自研天璇芯片,"
    "配备6.8英寸柔性折叠屏与5000mAh电池,影像系统由星辰光学调校。"
)
PAD_DOC = (
    "雷克平板是华星科技旗下雷克品牌2024年发布的大屏平板,同样搭载天璇芯片,"
    "配备12.4英寸护眼屏幕与8000mAh电池,主打移动办公与手写笔记。"
)
tmp_dir = Path(tempfile.mkdtemp())
(tmp_dir / "a").mkdir()
(tmp_dir / "a" / "phone.txt").write_text(PHONE_DOC, encoding="utf-8")
(tmp_dir / "b").mkdir()
(tmp_dir / "b" / "pad.txt").write_text(PAD_DOC, encoding="utf-8")
2.3.2 模型抽取 & 写入节点元数据
加载数据,对每个节点进行对象抽取,并添加元数据:
python
documents = SimpleDirectoryReader(
    str(tmp_dir),
    recursive=True,   # 坑:默认只扫顶层目录、不进子目录------语料在 a/ b/ 子目录里,
                      # 不加 recursive=True 会报 "No files found"
).load_data()
nodes = SentenceSplitter(chunk_size=512).get_nodes_from_documents(documents)

for node in nodes:
    # 直接遍历 doc.ents,保留类型标签:kept = [(实体文本, 类型), ...]
    kept = [(ent.text, ent.label_) for ent in nlp(node.get_content()).ents
            if ent.label_ in KEEP_LABELS]
    # metadata 里存两个字段(键名 = 第 5 节过滤器用的字段名,别改):
    #   entities       ------ 全部实体(展示用)
    #   primary_entity ------ 第一个实体(过滤字段,类型信息另在打印里看)
    node.metadata["entities"] = "、".join(t for t, _ in kept)
    node.metadata["primary_entity"] = kept[0][0] if kept else "未知"

    print(f"\n节点 [{node.metadata.get('file_name')}]")
    if kept:
        for t, l in kept:   # 逐个打印 实体 + 类型(和第 2 节同样的格式)
            print(f"    实体: {t:<6} 类型: {l}({LABEL_CN.get(l, '')})")
    else:
        print("    (模型未抽到实体)")
    print(f"    → 入库主实体: {node.metadata['primary_entity']}")
每个节点入库的元数据:
python
节点 [phone.txt]
    实体: 华星     类型: GPE(地名)
    → 入库主实体: 华星

节点 [pad.txt]
    实体: 雷克     类型: LOC(地点)
    实体: 华星科技旗下雷克品牌 类型: ORG(机构名)
    → 入库主实体: 雷克
2.4 构建检索器
从节点创建索引存储,并添加一个元数据过滤器:
python
index = VectorStoreIndex(nodes=nodes)

filters = MetadataFilters(
    filters=[
        MetadataFilter(
            key="primary_entity",
            value="雷克",
            operator=FilterOperator.EQ,   # 精确等于;匹配多个实体时用 IN
        )
    ]
)
retriever = index.as_retriever(similarity_top_k=4, filters=filters)
只在 primary_entity == "雷克" 的块里检索(其他块根本不进候选)
2.5 执行查询
python
QUERY = "雷克平板哪里产的?"
print("\n" + "=" * 70)
print(f"查询:{QUERY}   [过滤条件: primary_entity == 雷克]")
for i, ns in enumerate(retriever.retrieve(QUERY), 1):
    ent = ns.node.metadata.get("primary_entity", "?")
    print(f"  ({i}) 实体={ent} | {ns.node.get_content()[:30]}...")
输出示例:
python
(1) 实体=雷克 | 雷克平板是华星科技旗下雷克品牌2024年发布的大屏平板,同样...2.6 使用 NER 标准组件
LlamaIndex 官方把 spaCy NER 封装成标准组件的版本,可以换成官方组件的写法:
python
# pip install llama-index-extractors-entity spacy
from llama_index.extractors.entity import EntityExtractor
from llama_index.core.ingestion import IngestionPipeline

pipeline = IngestionPipeline(transformations=[
    SentenceSplitter(chunk_size=512),          # 切分
    EntityExtractor(model="zh_core_web_sm",    # 官方 NER 组件(内部就是 spaCy)
                    label_entities=True),      # 实体带类型:"华星科技:ORG"
])
nodes = pipeline.run(documents=documents)      # 切分+抽实体自动串起来,写入 metadata