26年4月来自Nvidia、多伦多大学和悉尼大学的论文"RoboLab: A High-Fidelity Simulation Benchmark for Analysis of Task Generalist Policies"。
一、研究问题与动机
论文针对当前通用机器人策略评估中的关键瓶颈:真实世界评估昂贵且难以规模化;现有仿真基准常出现训练与评估域重叠、任务集静态导致性能快速饱和,并且缺乏对策略失败模式和泛化能力的细粒度分析。为此,作者提出 RoboLab,希望回答两个问题:
1)通过仿真分析能在多大程度上理解真实世界策略的表现?
2)哪些因素最强烈地影响策略行为?
二、方法
如图1 所示RoboLab 概览。RoboLab 提出一种评估框架,旨在实现对现实世界策略的大规模评估。通过引入一套用于生成新场景和任务的精简流程(上图),RoboLab 实现快速扩展,从而能够有效测试策略的泛化能力。配套的基准测试集 RoboLab-120 引入多种评估维度以及一系列指标和分析工具,并展示与现实世界基准测试高度一致的相关性(下图)。
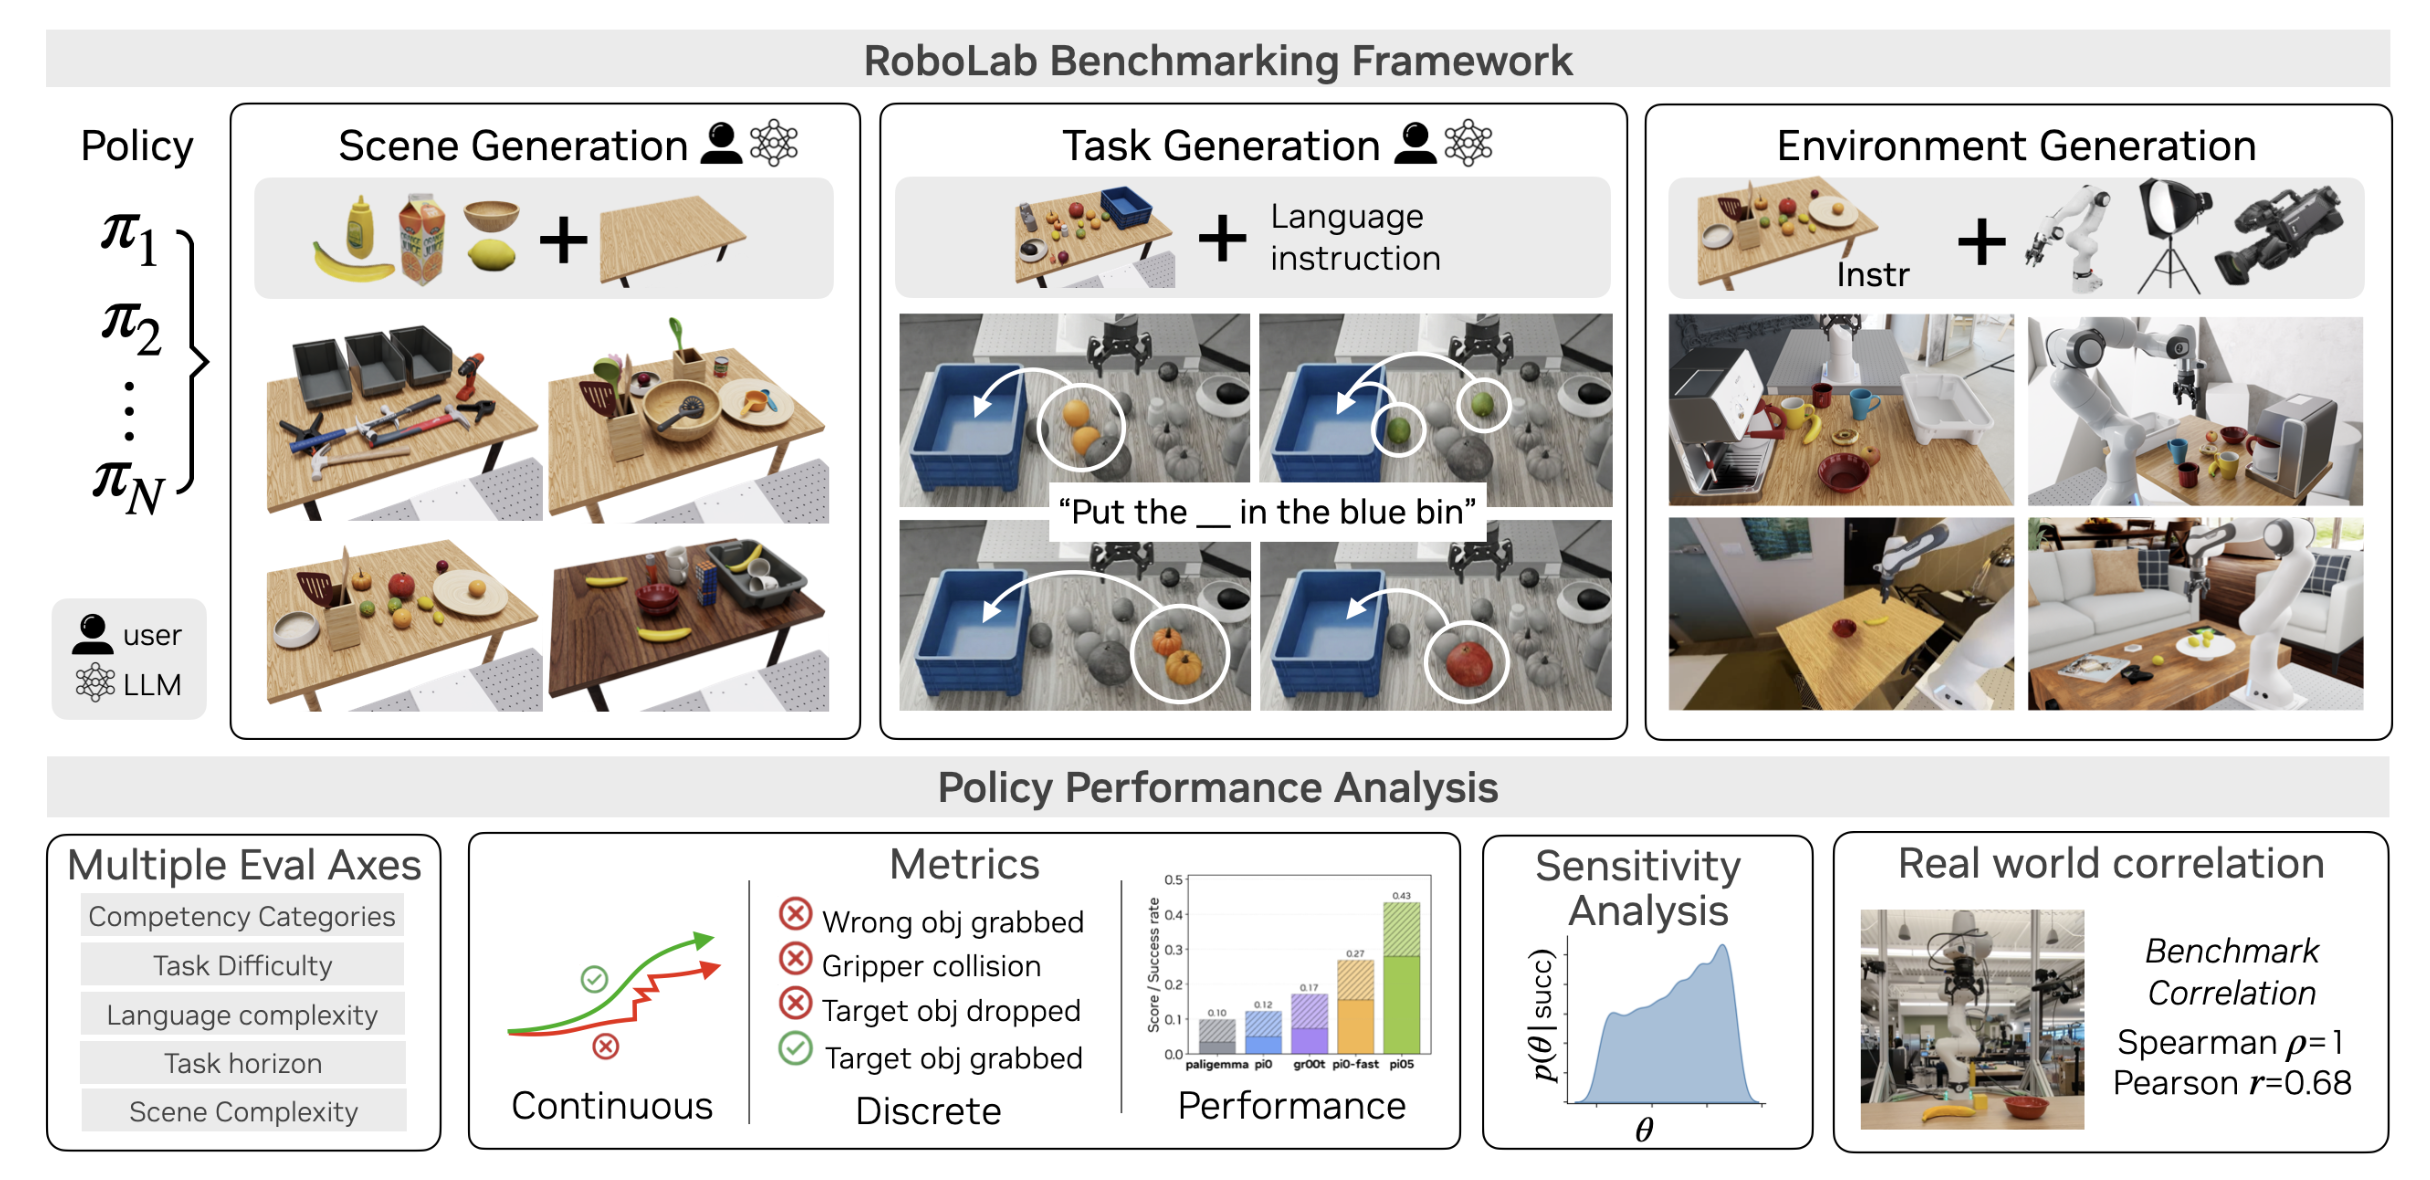
RoboLab 是一个基于高保真仿真的机器人策略评测框架,核心方法包括:
1 可扩展的场景与任务生成
场景由物体、位置、朝向组成;任务由场景和语言指令定义;环境进一步绑定机器人、策略、观测/动作空间以及相机、光照、背景、物体位姿等变化。
场景生成采用 LLM 生成结构化场景计划,再通过几何求解器转换为物体位姿,并在 Isaac Sim 中前向仿真检查稳定性;若失败,将错误反馈给 LLM 迭代修正。
任务生成同样由 LLM 根据场景物体目录、任务示例、谓词库、能力轴模板和难度约束生成任务代码,并经过语法验证、资产验证和失败修复。
2. RoboLab-120 基准
包含 120 个手工设计的抓取-放置类任务,覆盖三类能力轴:
视觉能力:颜色、语义、尺寸识别;
程序能力:可供性、重定向、堆叠等;
关系能力:连词、计数、空间关系。
任务按难度分为简单、中等、复杂,难度由子任务数量和技能权重决定。任务支持多标签,以反映其同时考察多种能力。
3. 多维评估指标与分析工具
除成功率外,引入归一化子任务分数、事件跟踪、语言变体测试、轨迹质量指标(如 SPARC 平滑度、末端速度、路径长度)等。
使用基于 Simulation-Based Inference 的 MNPE 敏感性分析,学习环境参数与任务成功之间的后验分布,从而识别哪些扰动因素最影响策略表现。
实验中对相机位姿、物体位姿、光照、背景和桌面纹理等受控变化进行系统分析。
4. 真实世界相关性验证
将 RoboLab-120 的成功率与真实世界基准 RoboArena 的 Elo 分数进行比较,发现策略排序高度一致,说明 RoboLab 可作为真实世界策略质量的有效代理。
三、主要贡献
RoboLab 平台:一个基于 IsaacLab 的机器人/策略无关评测框架,支持人工和 AI 辅助快速生成大量高保真场景与任务,缓解基准饱和问题。
RoboLab-120 基准:120 个多样化任务,覆盖视觉、程序、关系三类能力轴和多个难度层级,并提供鲁棒性指标。
策略分析工具集:超越二值成功率,提供子任务评分、事件跟踪、轨迹质量、语言变体测试和贝叶斯敏感性分析,能够定位策略失败模式和关键影响因子。
真实世界相关性证据:与 RoboArena 的策略排名保持高度一致,表明仿真评测对真实世界评测具有良好代理价值。
如图 2所示机器人基准测试的三种方法。左图:迄今为止,纯粹基于模拟的基准测试视觉质量较低,导致了巨大的"模拟到现实"(sim2real)迁移鸿沟。中图:"现实到模拟"(Real2sim)基准测试通过将现实世界的视觉纹理引入模拟环境来解决这一问题;然而,构建此类环境的成本极高,据报道,生成单个场景耗时约 1 小时 9。右图:本文方法以低开销实现了高度的真实感。
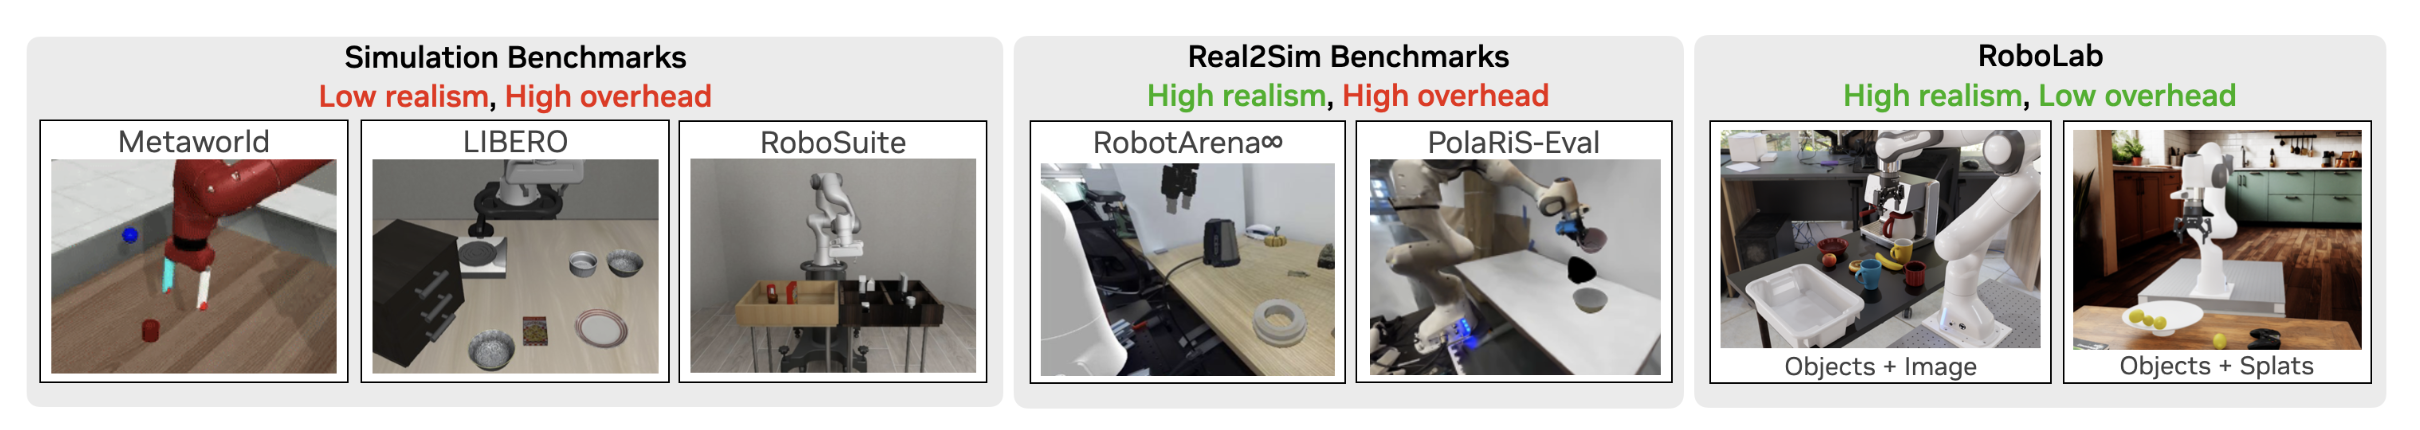
场景生成三阶段的方法细节如下。
A. 阶段 I:用于语义规划的谓词
使用以下谓词:
• PlaceIn(x, y):物体 x 必须包含在 y 内部(例如,碗里的水果)。
• PlaceOn(x, y):物体 x 由 y 支撑(例如,杯垫上的马克杯)。
• ClusterAround(x, {y_i}):物体 x 作为一组物体 {B_i} 的锚点。
• PlaceAnywhere(x):物体 x 自由放置在全局支撑表面(桌面)上。
如果谓词引用的锚点不存在,则将其降级为 PlaceAnywhere 约束,以确保该物体仍保留在场景中。
B. 阶段 II:几何约束求解
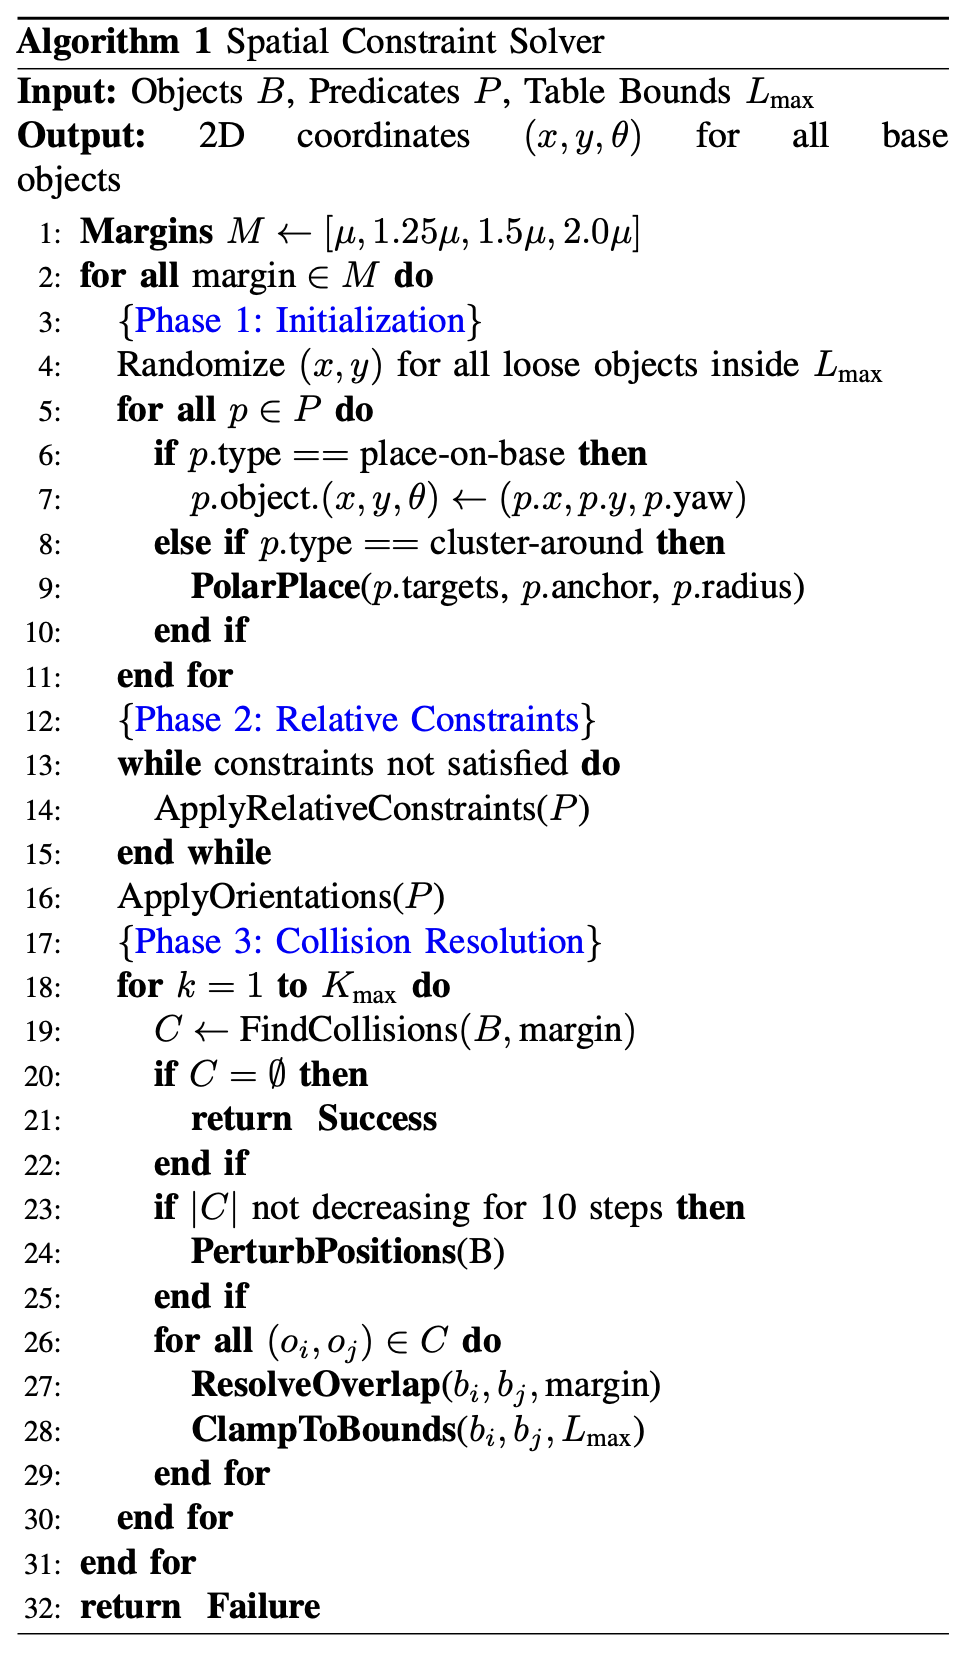
对于全局放置(PlaceAnywhere),在全局桌面表面边界内利用拒绝采样,并使用基于 OBB(有向包围盒)的 SAT(分离轴定理)算法检查与所有已放置物体的碰撞情况。为处理高密度场景,采用两种策略:(1) 自适应松弛循环,若未找到有效布局,则逐步增加碰撞裕度;(2) 随机扰动步骤,当求解器收敛到局部极小值时,随机微调所有物体的位置(算法 1所示)。
对于堆叠(PlaceOn(b_i, b_support)),利用拒绝采样(最多尝试 K = 20 次)在 b_support 的顶面上采样位置,以寻找位置 p_xy,使得对于同一支撑面上所有已放置的物体,均满足 OBB(b_i) ∩ OBB(b_existing) = ∅(算法 2所示)。
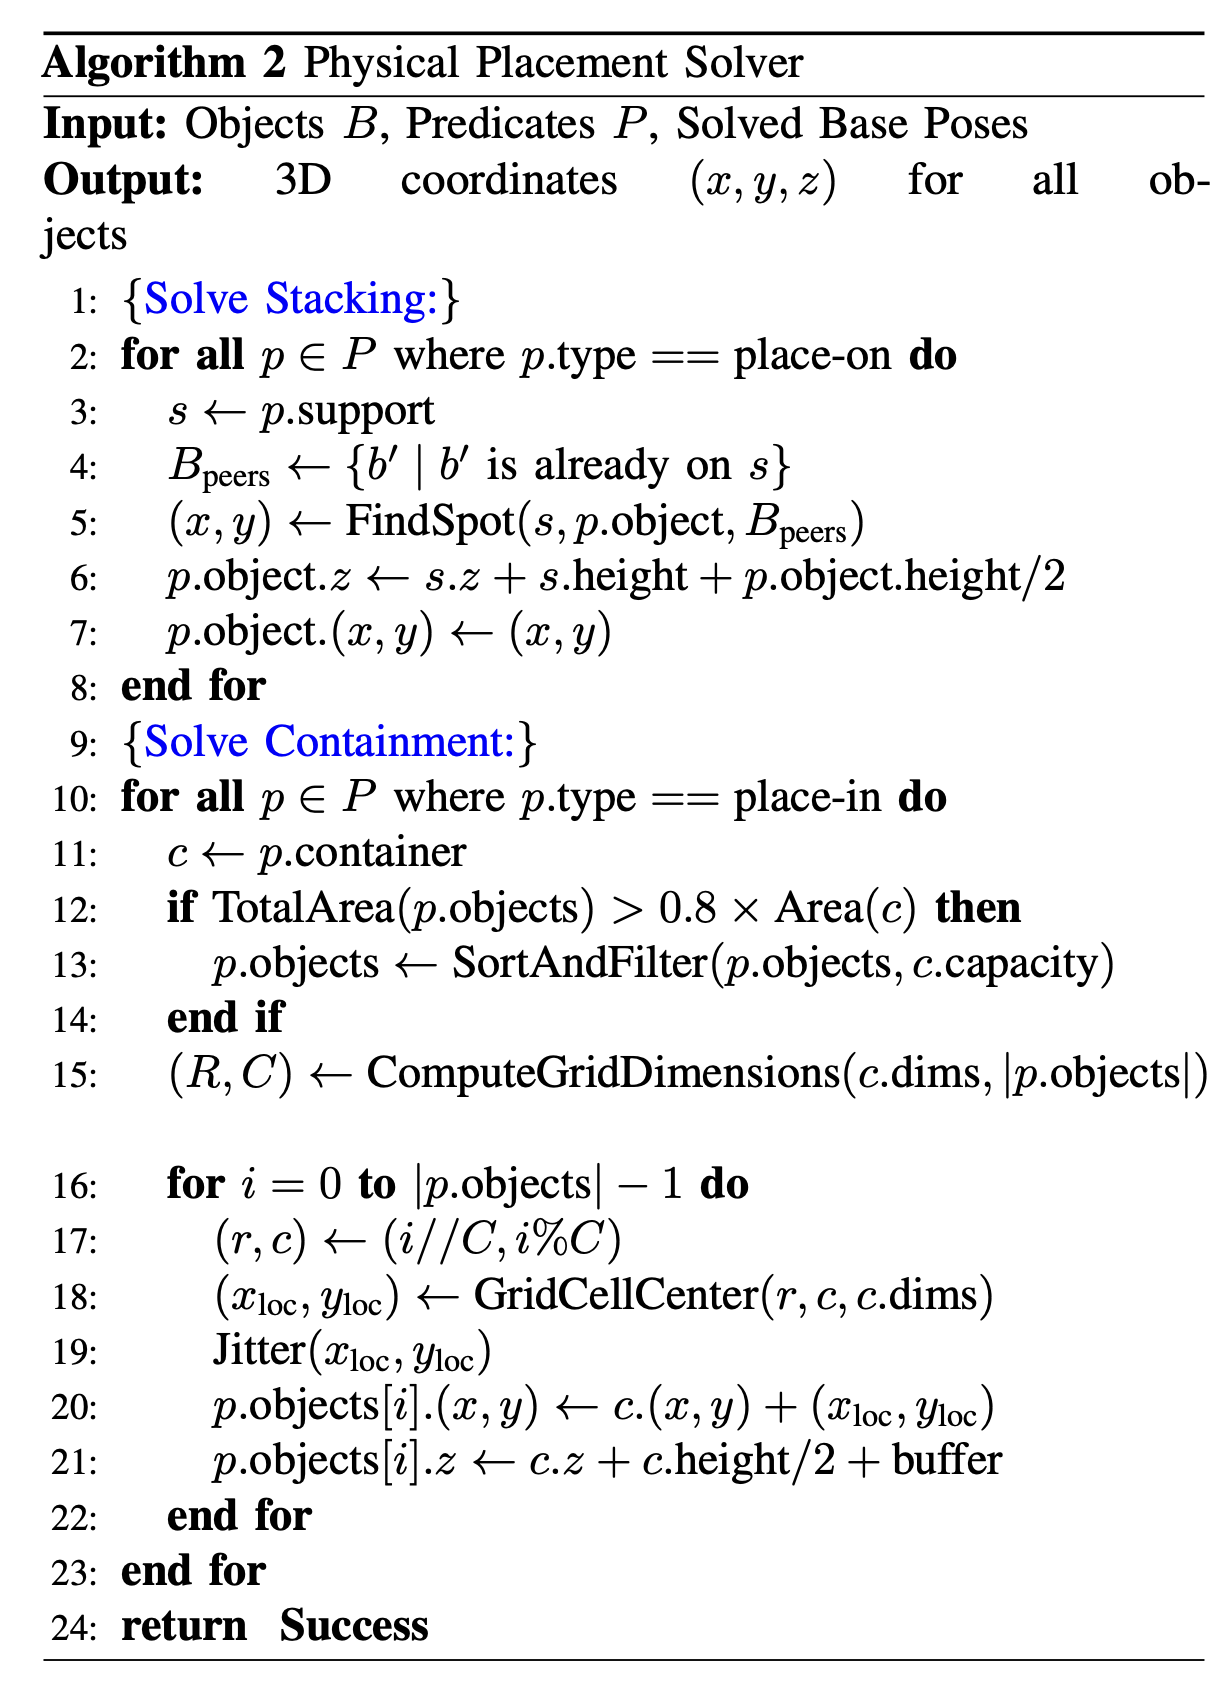
对于包含关系(PlaceIn(b_i, b_container)),利用 b_container 的包围盒尺寸 d_b 计算其可用内部体积。采用一种装箱启发式方法,将容器底部离散化为网格,网格分辨率设为 s = max(dx_i, dy_i) + ε_margin。若网格单元 (u, v) 未被占用,且位于按因子 γ = 0.7 缩放后的容器边界内(以避免边缘碰撞),则视为有效。将 o_i 指定给第一个有效单元格,并设定其高度 z_i = z_container}+ h_container / 2。
四、局限
论文指出的主要局限包括:
当前主要聚焦刚体桌面场景,对可变形物体(布料、线缆、袋子)和复杂接触操作覆盖不足。
需要精确力控、柔顺交互或复杂摩擦动力学的接触丰富技能代表性有限,且受物理仿真保真度制约。
子任务评估体系对开放式、模糊的长时任务(如"清理所有衣物")效果有限,仍需人类判断。
尽管仿真保真度较高,仍存在残余视觉分布偏移,需要进一步分析感知栈鲁棒性并在真实部署中广泛验证。
LLM 生成的场景和任务虽经程序检查,但仍需用户审核以确保符合评测目标。
统计功效方面,每任务 10 个 episode 对单任务结论和精细策略比较仍显不足,建议增加至至少 100 个 episode。
五、下一步工作
可以继续的方向:
扩展到可变形物体、接触丰富操作和力控任务,提高对现实机器人挑战的覆盖。
进一步刻画并缩小 sim2real 视觉与动力学差距,结合真实世界部署验证 RoboLab 的代理有效性。
改进对开放式、长时程、模糊任务的评估方法,减少对人类判断的依赖。
深入研究任务级和运动级相关性,而不仅是策略级排名相关性。
增加每任务评测次数,提高统计功效,以支持更细粒度的策略比较。
持续利用生成式场景-任务-环境工作流扩展基准,避免性能饱和并保持长期评估价值。