本文基于 HarmonyOS 7(API 26)华为开发者论坛「Harmony Intelligence AI 开放能力深度解读|第二期:文搜图」与 Core Vision Kit《通过文本搜索图片》开发指南、API 参考整理。文中 ArkTS 代码为 V哥 依官方开发指南改写的示意示例,接口名(textSearchImage / init / insertImage / search / release 等)均来自官方开发指南并标注出处;涉及真机表现的部分已明确标注,未做任何实测数据编造。7.0 相关能力需升级至 HarmonyOS 7 并以实际支持机型为准。
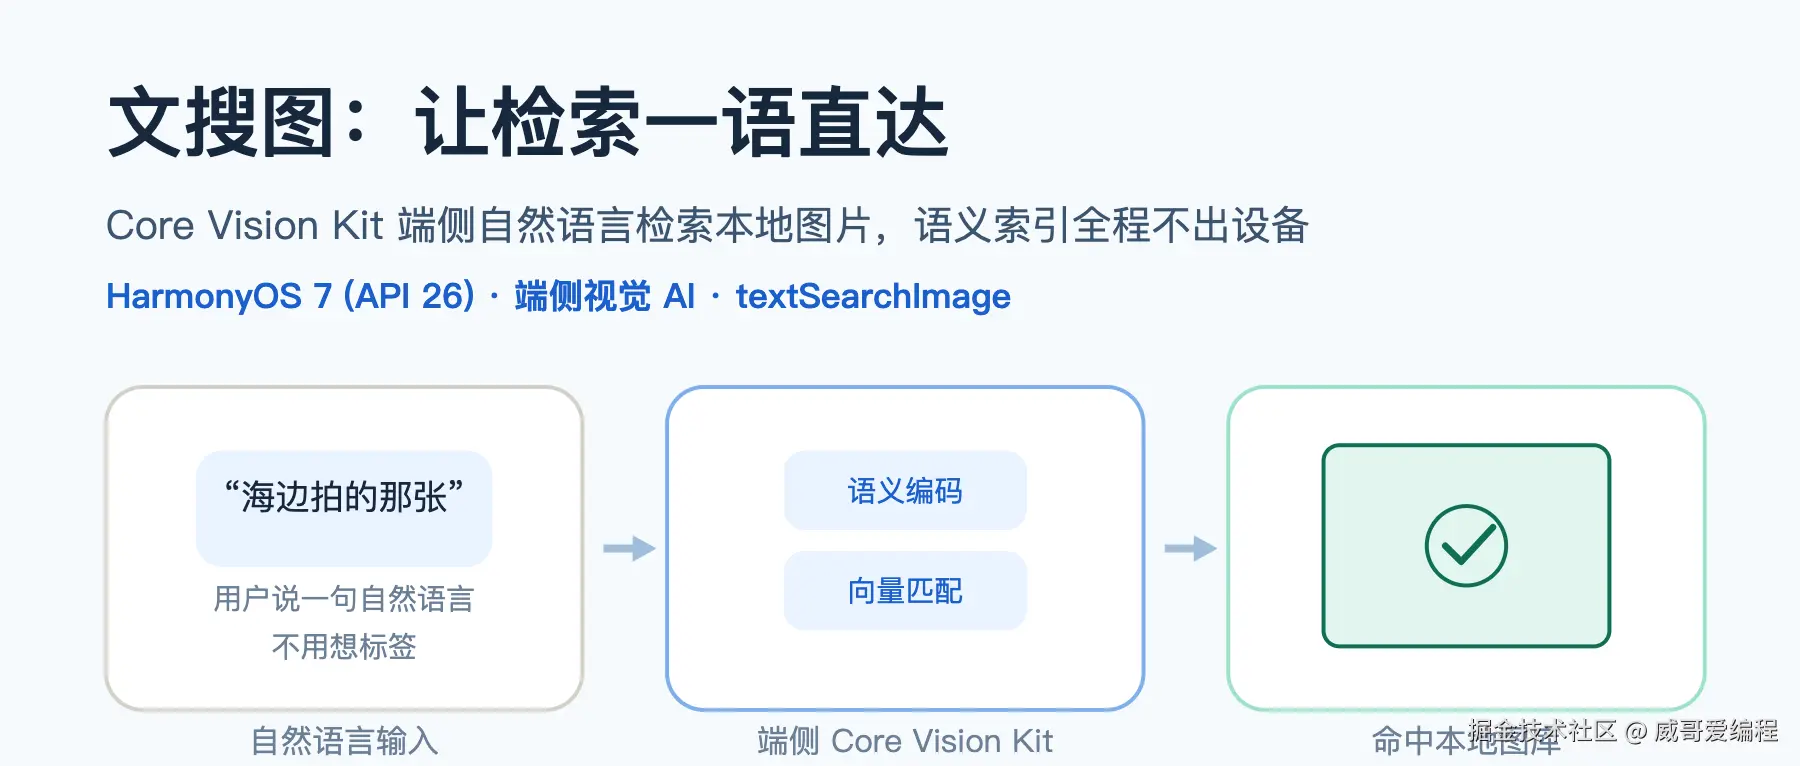
引子:翻了十分钟,他没找到那张照片
V哥有个做社群产品的朋友,上周在群里发消息:"帮V哥想个办法,让用户在我们 App 里找图别那么费劲。"V哥问怎么个费劲法,他说:"用户图库里几千张图,想找'上次团建在海边拍的那张',只能靠相册按时间翻,翻十分钟翻不到。"
这句话V哥记下来了,因为它戳中了相册搜索一个被忽视多年的真相:相册搜索的难点从来不是"搜",是"图库里根本没有文字"。 传统搜索靠文件名、靠你当年手打的标签、靠 EXIF 里的拍摄时间------可"海边团建""猫咪表情包""白板会议纪要"这种描述,从来没被写进任何字段。你不是搜不到,是检索系统压根没有可搜的"词"。
HarmonyOS 7(API 26)Core Vision Kit 的文搜图(通过文本搜索图片)恰恰冲着这个点来:它把"语义索引"这件事放到了端侧,让用户的自然语言描述直接成为检索入口。这一期V哥只讲这一件事------它怎么把"图库没文字"这道墙拆掉,又为什么这件事最好发生在你自己的设备上。
一、先点破一个误解:文搜图补的不是"搜索框"
很多团队一听"以文搜图",第一反应是去接一个搜索服务、搭一套检索后端。方向又错了。
文搜图的官方定义很直白:根据文本描述检索相关图片,用户输入"飞机""鲜花""宠物"这类自然语言,系统在本地图库匹配契合的结果(华为开发者论坛·文搜图深度解读)。注意主语是"在本地图库"------它解决的不是"怎么搜得快",而是"图库里没有文字也能被搜到"。
这背后是三道原来只有云端才做得了的工序,现在被搬到了端侧(同上论坛帖):
- 本地特征向量化:把每张图片的内容解析成标准化特征向量,不再依赖人工标签。
- 实时构建索引:本地自动生成轻量级图片索引,检索无需等待云端往返。
- 语义级特征匹配:打通文本语义与图像特征的关联,实现跨模态检索。
V哥的理解就一句话:文搜图真正的产品价值,是让"用户的描述能力"第一次成了检索入口。 "上次在海边拍的那张"这种需求,过去用户自己都觉得"没法搜",现在能被满足了。这才是和标签搜索本质不同的地方。
二、检索链路:一句话进,结果出,全程不出设备
把端侧文搜图拆成一条链,V哥画成下图------四个环节全在设备内跑完:
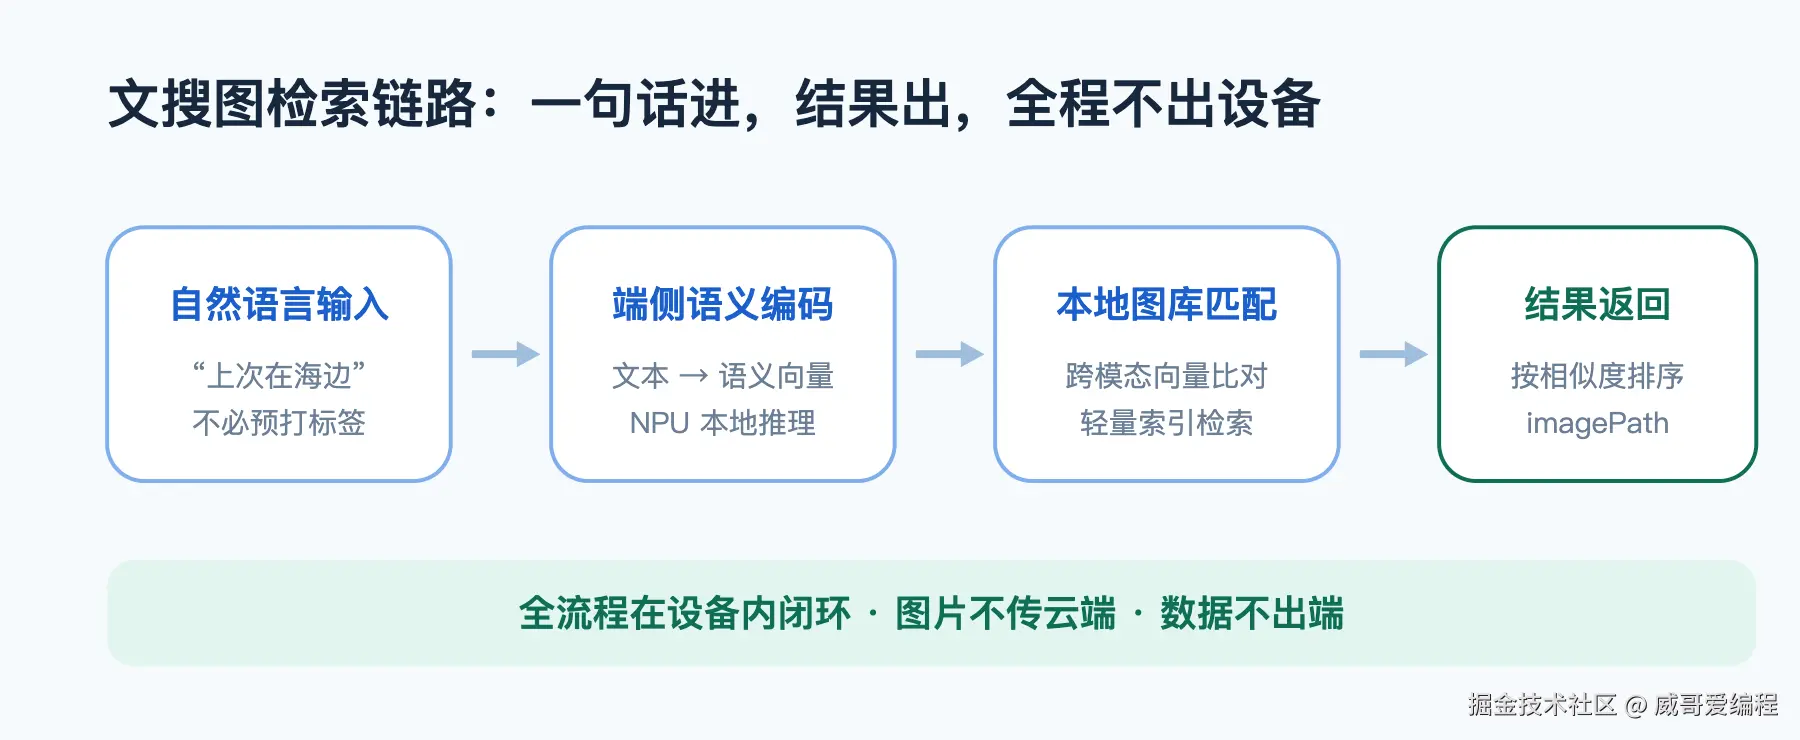
对照官方《通过文本搜索图片》开发指南(开发指南),这条链落到 API 上就是五个动作:init() 初始化 → insertImage() 把图特征插进本地库 → search() 拿自然语言去查 → deleteImage()/clearData() 管理数据 → release() 释放。
端侧闭环带来的两笔账,V哥觉得比"搜得准"更值钱:隐私账和成本账。把私人相册、工作文档传上云端做向量化,是合规评审里最容易被打回的一类;而端侧方案让"数据不出端"从你要额外买的安全能力,变成了系统递到手里的默认值。
三、动手:V哥的最小接入骨架
接口名全部来自官方开发指南(起始版本 26.0.0,挂在 @kit.CoreVisionKit 下)。V哥按指南改写的最小骨架,把生命周期讲清楚:
typescript
// TextSearchImageDemo.ets ------ 文搜图最小接入(依官方开发指南改写,接口名以核实到的官方 SDK 为准)
import { textSearchImage } from '@kit.CoreVisionKit';
import { hilog } from '@kit.PerformanceAnalysisKit';
import { BusinessError } from '@kit.BasicServicesKit';

@Component
struct SearchAlbumPage {
  // scope 是本地索引的命名空间,V哥建议按业务隔离,别全堆进 default
  private readonly scope: string = 'vge_album_scope';

  async aboutToAppear(): Promise<void> {
    // ① 初始化:页面就绪先 init,分析器服务起在端侧
    const ok: boolean = await textSearchImage.init();
    if (!ok) {
      hilog.error(0x0000, 'TextSearch', 'V哥提醒:init 失败,后续检索不会生效');
    }
  }

  async aboutToDisappear(): Promise<void> {
    // ② 释放:页面销毁务必 release,端侧索引资源别常驻
    await textSearchImage.release();
  }

  // ③ 建索引:把本地图的路径喂进去,特征向量化与索引构建在端侧完成
  private async indexImage(path: string): Promise<void> {
    try {
      const result: boolean = await textSearchImage.insertImage(path, this.scope);
      hilog.info(0x0000, 'TextSearch', `V哥:建索引 ${path} -> ${result}`);
    } catch (e) {
      const err = e as BusinessError;
      hilog.error(0x0000, 'TextSearch', `insert failed, code: ${err.code}, msg: ${err.message}`);
    }
  }

  // ④ 检索:一句话进来,命中图按相似度排好队出来
  private async runSearch(query: string): Promise<void> {
    try {
      // topKey 控制返回条数,官方默认 100,V哥按业务截断即可
      const hits = await textSearchImage.search(query, this.scope, 50);
      hits.forEach((item, i) => {
        // item.imagePath 是命中图路径,item.similarity 是相似度
        hilog.info(0x0000, 'TextSearch', `V哥:第${i}张 ${item.imagePath} 相似度 ${item.similarity}`);
      });
    } catch (e) {
      const err = e as BusinessError;
      hilog.error(0x0000, 'TextSearch', `search failed, code: ${err.code}, msg: ${err.message}`);
    }
  }
}五个环节对应官方规定的接入顺序:init() 起服务 → insertImage() 建索引 → search() 出结果 → deleteImage()/clearData() 管数据 → release() 收资源 。核心对象就一个 textSearchImage,方法都是它身上的静态方法,全部挂在 @kit.CoreVisionKit 下(search 返回的对象带 imagePath 与 similarity 字段,详见 API 参考)。
V哥提醒两个边界:第一,scope 是本地索引命名空间,多业务别混用,否则检索会串库;第二,实例务必随页面生命周期 release()------端侧索引虽轻量,但常驻一样吃资源。检索的准确率、耗时与召回表现,一律以你业务图库的真机实测为准,官方没有给通用数字,V哥也不会替它编一个。
顺带一提,V哥前阵子刚写完的图像超分短稿(姊妹篇)管的是"把图变清晰",本篇管的是"把图找到"------一个补信息,一个补入口,合起来正好是 Core Vision Kit 在端侧帮你把图片"既看得清、又找得到"的两块拼图。
四、V哥的判断:检索质量的下限,第一次由用户的话术决定
写了代码只是及格线,这篇真正想抛的观点在这里------
过去相册搜索的质量上限,是工程师预设的标签决定的:你建了"旅行""宠物"标签,用户就只能在这俩词里搜;说"毛茸茸的小动物趴沙发上",系统一脸懵。标签时代,检索边界是工程师替用户划的。
文搜图把这件事反转了:检索的边界变成了用户自己的描述能力。会描述的人,一句话精准命中;不会描述的人,搜出来一堆相关的也未必是他要的。这意味着检索质量的"下限"第一次交到了用户话术手里,而不是工程师的标签库手里。 对产品来说,与其花力气建标签,不如在搜索框旁做"话术引导",给几条示例把用户的表达能力托起来。V哥叫它"检索体验的前端化":后端语义能力越强,前端越要会教用户怎么说话。
五、收尾:索引权回到端侧,主权也回到用户
回头看,文搜图在 HarmonyOS 7 里不只是一个检索功能。它把"语义索引"这件过去只能由云端厂商掌握的事,搬到了每个用户的设备里------图片的元数据主权第一次回到用户自己手上,没有哪台服务器知道他存了什么。
对开发者而言,这笔账很干净:少一套云端检索后端、省一笔带宽与授权费、过合规时少写一页防护说明。代价只是接管一个 textSearchImage 的生命周期------而那是十几行代码以内的事。
7.0 刚发,端侧视觉能力的坑位还空着。V哥的建议很直接:先把你业务里那些"图很多、但用户总找不到"的场景列出来,它们就是文搜图第一批该上的地方。
参考与出处
本文涉及的机制、接口与表述均来自以下官方页面(均已核验):
- 华为开发者论坛 · Harmony Intelligence AI 开放能力深度解读|第二期:文搜图,让检索一语直达------能力定义、"本地特征向量化 / 实时构建索引 / 语义级特征匹配"三大技术、端侧闭环与隐私优势、API 26
- 通过文本搜索图片 开发指南(Core Vision Kit)------textSearchImage / init / insertImage / search / release 接入步骤,起始版本 26.0.0
- 通过文本搜索图片 API 参考(Core Vision Kit)------接口、字段(imagePath / similarity)与版本信息
最后一句:相册搜索的敌人从来不是搜索框,是图库里没有的那行字------文搜图把语义索引搬回端侧,也让"描述能力"第一次成了用户打开自己回忆的钥匙。