C++ 网络编程实战 :C++、HTTP 服务器、socket 编程、fork 多进程、HTTP 协议解析、Linux 网络编程
TCP 三次握手背得滚瓜烂熟,socket 那几个函数也会调,可一旦要自己攒一个 HTTP 服务器,很多人就卡住了:报文格式记不牢、不知道该切几层、写完也不知道对不对,只能靠"看起来能跑"自我安慰。
更麻烦的是,等你真去读别人的 HTTP 服务器代码,往往是一坨------解析、网络、业务全糊在一个文件里,看不出哪层该干什么。
这篇文章把这件事从头拆到底。全部代码就是十来个文件,每一段我都讲透。读完你会拿到三样东西:
一个真正能跑的服务器------浏览器打开有页面,curl 拿到正确状态码,首页、404、301、动态路由全都实测过;
一张清晰的分层地图 ------
TcpServer管进程、Http管协议、业务函数管逻辑,哪个文件干什么活,一眼看清;一份 12 条踩坑清单------全是真跑出来的,包括那些编译零警告、进程不崩、页面"看起来"还能开,因而能活好几年的隐蔽 bug。
文末有完整的运行现象和我踩过的坑,输出都是真跑出来的,不是编的。
一、先看全景:这个项目的分层
写网络程序最怕一上来就扎进代码里出不来。我先把整个项目的层次画出来,你在哪个文件、干的是什么活,心里得有张地图:
bash
+----------------------------------------------------------+
|  Main.cc          入口:注册路由 /login -> Login 函数      |
+----------------------------------------------------------+
|  Http.hpp         应用层:解析HTTP请求 / 构造HTTP响应 /     |
|                   路由分发 / 读静态文件                     |
+----------------------------------------------------------+
|  TcpServer.hpp    网络服务层:accept + fork 并发 + 回调     |
+----------------------------------------------------------+
|  Socket.hpp       socket封装:模板方法模式                  |
|  InetAddr.hpp     地址封装:主机序<->网络序                 |
+----------------------------------------------------------+
|  Util.hpp         工具:读文件 / 按分隔符切行 / 文件大小    |
|  Log.hpp          日志:策略模式(控制台/文件)             |
|  Mutex.hpp        锁:RAII封装                              |
|  Common.hpp       公共枚举 / 宏                             |
+----------------------------------------------------------+这个分层的核心思想就一句话:网络和业务解耦。
TcpServer 根本不知道 HTTP 是什么,它只管"来一个连接,我就 fork 一个进程去跑你给我的回调"。Http 也不关心 socket 怎么创建的,它只管解析报文、填响应。哪天你想把 HTTP 换成别的协议,TcpServer.hpp 一行不用动------这就是我折腾这么多层换来的自由。
二、HTTP 报文长什么样
代码怎么写,取决于报文长什么样。HTTP 请求和响应的结构是理解整个 Http.hpp 的钥匙。
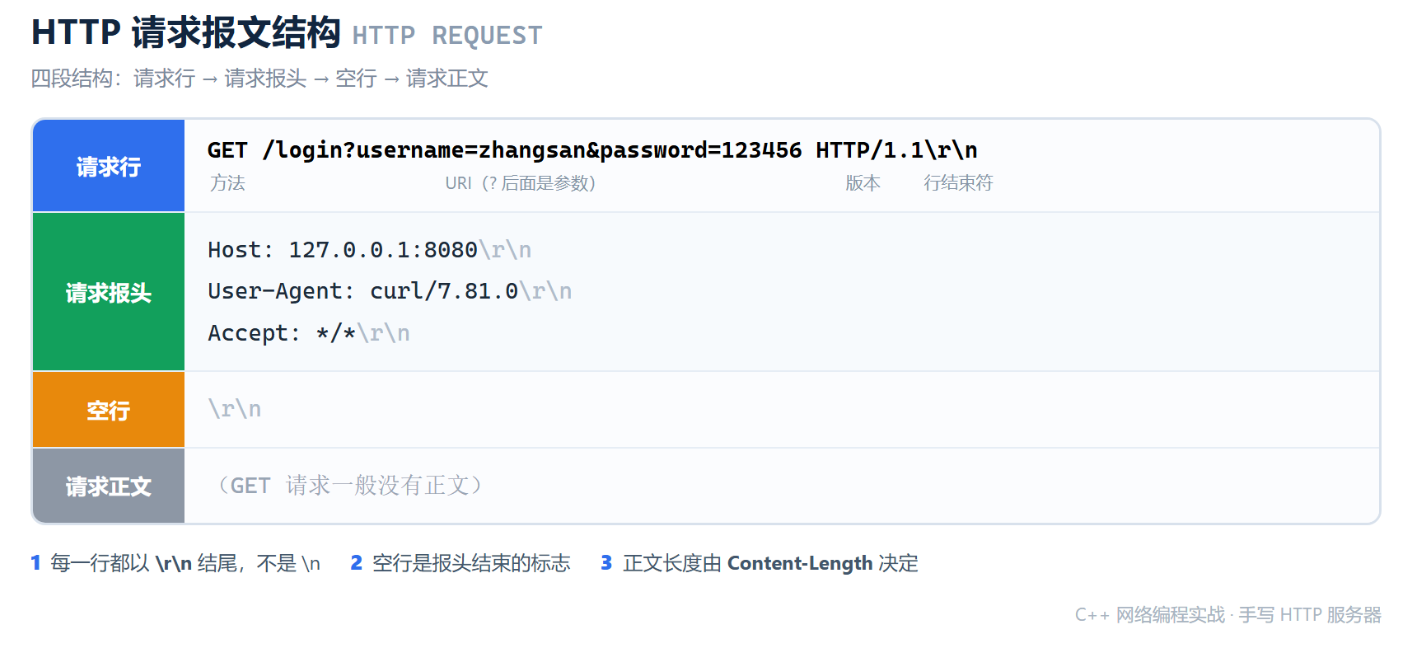
HTTP REQUEST 报文格式图(请求行 / 请求报头 / 空行 / 请求正文)
HTTP RESPONSE 报文格式图(状态行 / 响应报头 / 空行 / 响应正文)
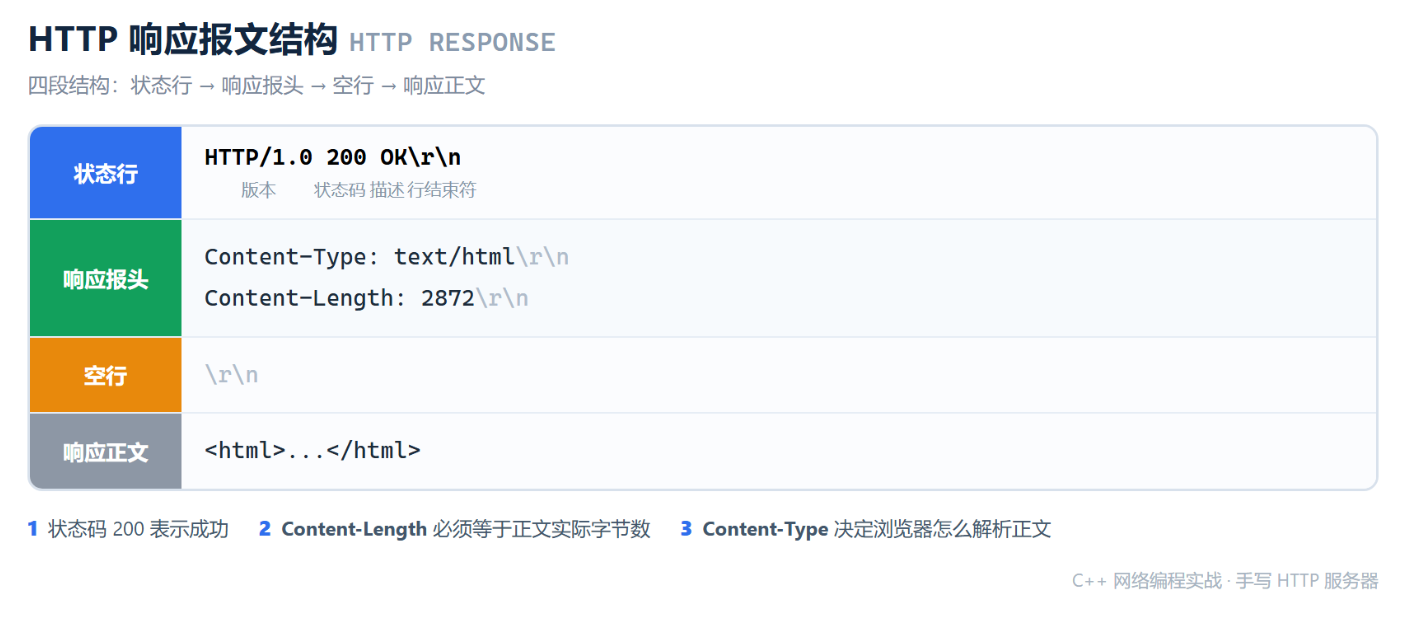
两张图对照着看,结构完全对称,就四段:
bash
请求:
    GET /login?username=zhangsan&password=123456 HTTP/1.1\r\n   <- 请求行
    Host: 127.0.0.1:8080\r\n                                    <- 报头,一堆 Key: Value
    User-Agent: curl/7.81.0\r\n
    Accept: */*\r\n
    \r\n                                                        <- 空行,报头结束的标志
    (body,GET 一般没有)                                        <- 正文

响应:
    HTTP/1.0 200 OK\r\n                                         <- 状态行
    Content-Type: text/html\r\n                                 <- 报头
    Content-Length: 2872\r\n
    \r\n                                                        <- 空行
    <html>...</html>                                            <- 正文
三个必须刻进脑子里的点:
每一行以
\r\n结尾 ,不是\n。这是协议规定的,少个\r浏览器都不认。空行(也就是单独一个
\r\n)是报头结束的标志。解析的时候就是靠它知道"后面是正文了"。正文多长由
Content-Length说了算 ,不是靠\0也不是靠连接断开------因为 TCP 是字节流,没有"报文边界"这个概念,边界全是应用层自己约定的(这就是粘包问题的本质,后面细说)。
我们服务器的活,说白了就是:收一大坨字节流,按上面的格式切开,然后按格式拼一坨回去。
三、地基四件套:Common / Mutex / Log / InetAddr
这四个文件不含任何 HTTP 逻辑,纯粹是地基。我按依赖顺序讲。
3.1 Common.hpp------全项目的"公共词典"
cpp
#pragma once

#include <iostream>
#include <functional>
#include <unistd.h>
#include <string>
#include <cstring>
#include <sys/socket.h>
#include <sys/types.h>
#include <arpa/inet.h>
#include <netinet/in.h>

enum ExitCode
{
    OK = 0,
    USAGE_ERR,
    SOCKET_ERR,
    BIND_ERR,
    LISTEN_ERR,
    CONNECT_ERR,
    FORK_ERR,
    OPEN_ERR
};
这个 enum ExitCode 看着不起眼,其实是个好习惯:进程退出时 exit(SOCKET_ERR),shell 里 echo $? 就能拿到 2,写脚本监控服务器挂没挂的时候特别好用。比满代码的 exit(1) 强多了------1 是什么错?谁知道。
cpp
class NoCopy
{
public:
    NoCopy(){}
    ~NoCopy(){}
    NoCopy(const NoCopy &) = delete;
    const NoCopy &operator = (const NoCopy&) = delete;
};
NoCopy 用 C++11 的 = delete 把拷贝构造和赋值直接删掉。想禁止拷贝的类继承它就行。这版代码里 TcpServer 还没继承它,属于留了个工具在手边。
cpp
#define CONV(addr) ((struct sockaddr*)&addr)这个宏是网络编程的老朋友了。accept、bind 的参数类型是 struct sockaddr*(通用地址结构),但我们实际用的是 struct sockaddr_in(IPv4 专用)。内核接口当年没做泛型,就靠强转凑合------sockaddr_in 前 16 字节和 sockaddr 布局兼容,所以强转是安全的,这是所有 Unix 网络代码的惯用写法。封装成宏,至少代码里不用到处写恶心的强转。
3.2 Mutex.hpp------两把锁的 RAII 封装
cpp
class Mutex
{
public:
    Mutex()
    {
        pthread_mutex_init(&_mutex, nullptr);
    }
    void Lock()
    {
        int n = pthread_mutex_lock(&_mutex);
        (void)n;
    }
    void Unlock()
    {
        int n = pthread_mutex_unlock(&_mutex);
        (void)n;
    }
    ~Mutex()
    {
        pthread_mutex_destroy(&_mutex);
    }
private:
    pthread_mutex_t _mutex;
};
构造时 init,析构时 destroy------这就是 RAII 的味道,锁的生命周期和对象绑定,不会出现"初始化了忘了销毁"的泄漏。
真正有讲究的是下面这个:
cpp
class LockGuard
{
public:
    LockGuard(Mutex &mutex):_mutex(mutex)
    {
        _mutex.Lock();
    }
    ~LockGuard()
    {
        _mutex.Unlock();
    }
private:
    Mutex &_mutex;
};
用法是在栈上创建一个 LockGuard 局部对象,构造时加锁。
关键在析构 :函数不管从哪条路径 return、哪怕抛异常,栈对象的析构函数都会执行,锁一定被释放。如果你手写 lock() ... 中间三行代码 ... unlock(),中间任何一个 early return 都能让锁永远回不去------这种死锁我在真实项目里见过不止一次。所以规矩就是:能 RAII 的绝不手写 lock/unlock。
这版代码是 fork 多进程模型,进程间不共享锁,Mutex 实际用在了 Log.hpp 的多场景预留上(日志模块是照着多线程场景写的)。
3.3 InetAddr.hpp------地址的"翻译官"
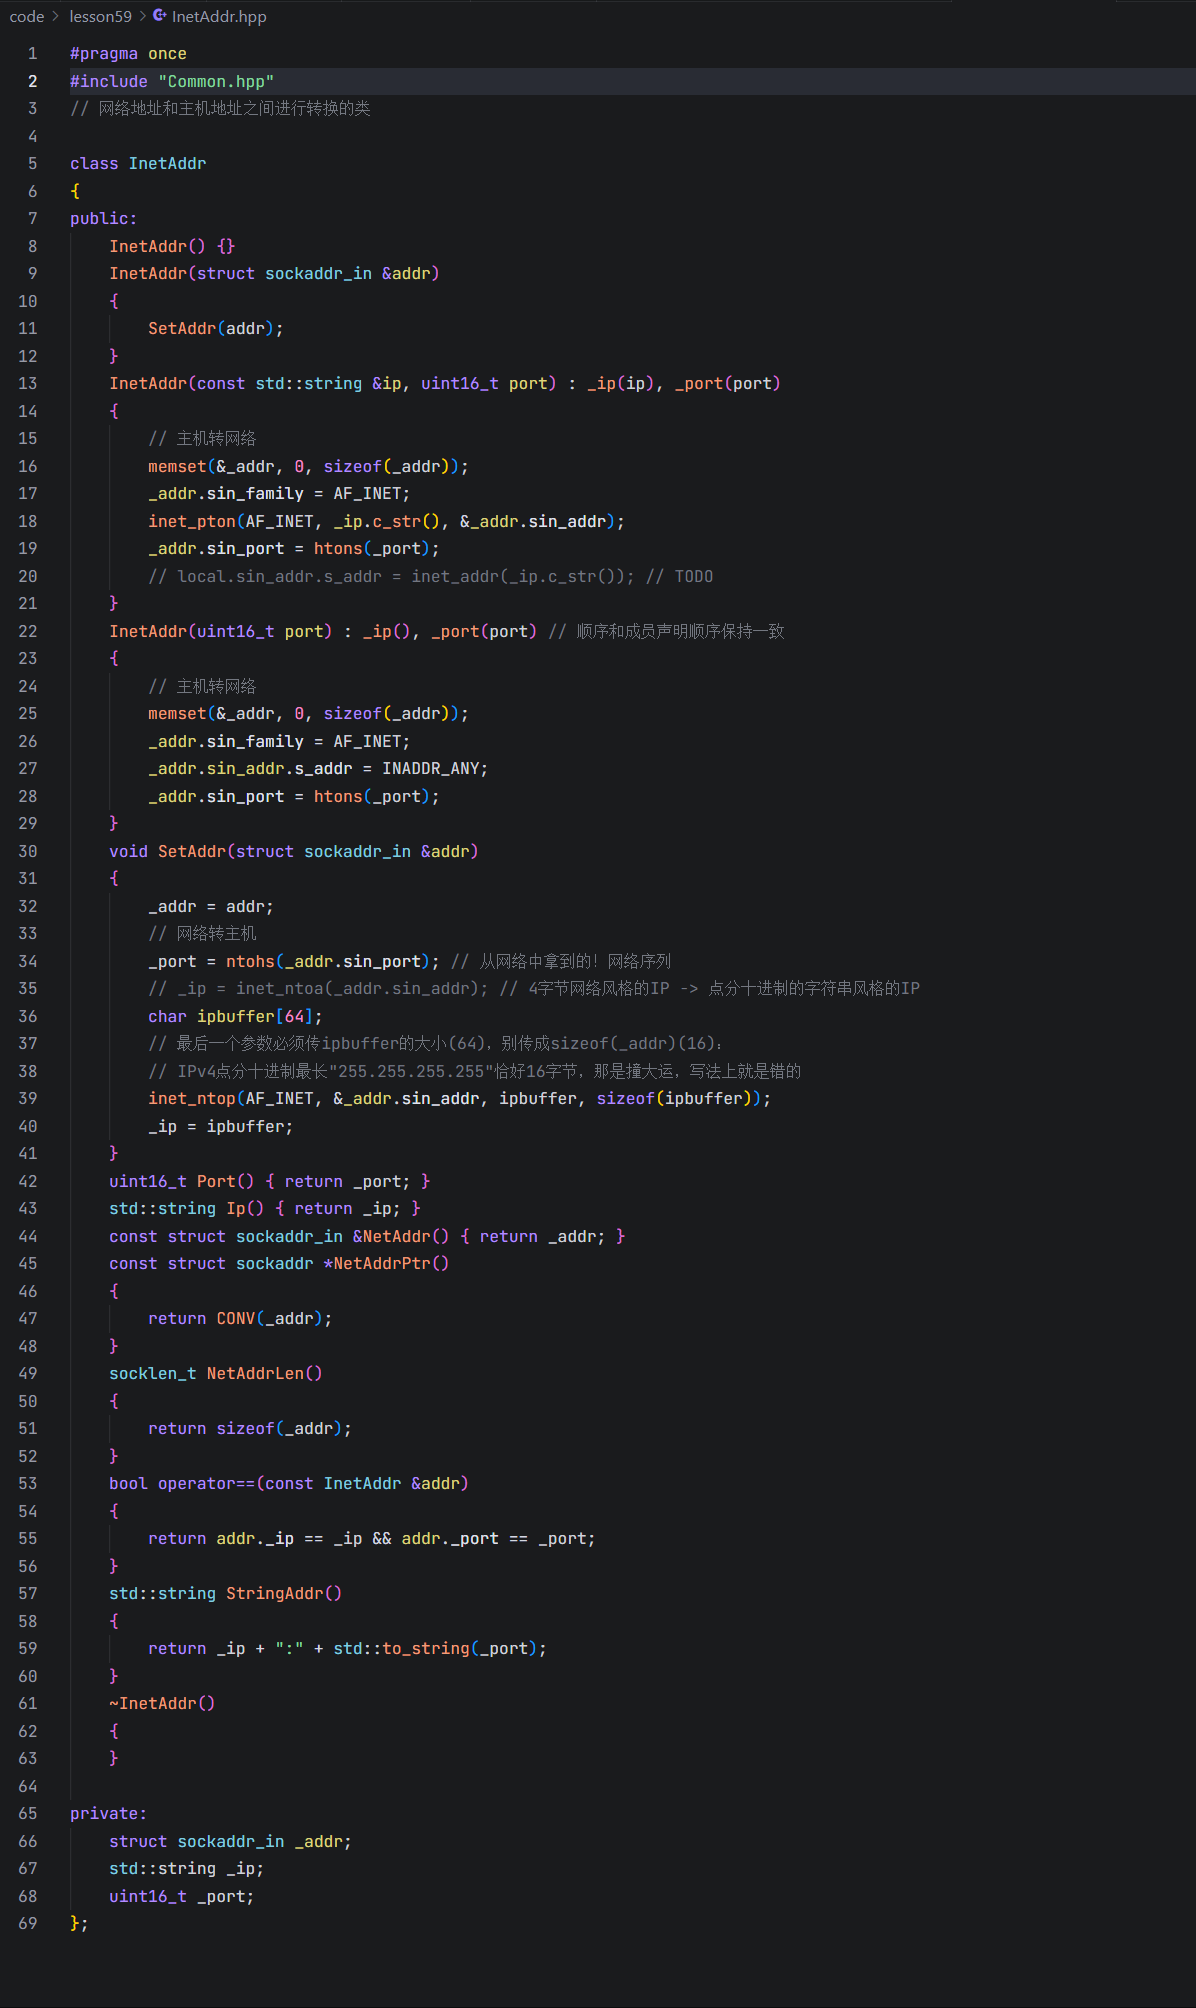
网络地址有两副面孔:内存里是 struct sockaddr_in(4 字节 IP + 2 字节端口,全是大端网络序),人眼看的是 "127.0.0.1" + 8080。InetAddr 就是这两副面孔之间的翻译官,把 sockaddr_in、ip、port 三个装在一个对象里,谁用找谁要。
构造函数有三胞胎:
cpp
InetAddr(struct sockaddr_in &addr)          // 从对端来的:peer地址
InetAddr(const std::string &ip, uint16_t port)  // 客户端连服务器用:指定IP
InetAddr(uint16_t port)                     // 服务器绑定用:INADDR_ANY
服务器绑定时用的是第三个:
cpp
InetAddr(uint16_t port) : _ip(), _port(port) // 顺序和成员声明顺序保持一致
{
    memset(&_addr, 0, sizeof(_addr));
    _addr.sin_family = AF_INET;
    _addr.sin_addr.s_addr = INADDR_ANY;
    _addr.sin_port = htons(_port);
}
INADDR_ANY 就是 0.0.0.0,意思是"本机所有网卡上的这个端口我都听"。你的机器可能有 127.0.0.1(回环)、192.168.x.x(局域网)、公网 IP 好几个地址,绑 ANY 一劳永逸。htons 把主机序转网络序------这个必须转,别问,问就是历史约定:网络字节序统一大端,x86 是小端。
一个 -Wreorder 的坑 :我上面写了句注释"顺序和成员声明顺序保持一致"。C++ 的规矩是:成员初始化列表不管你写成什么顺序,实际初始化顺序永远按成员声明顺序执行 。如果初始化列表顺序和声明顺序不一致,编译器不报错,但 -Wall 会甩你一脸 -Wreorder。我 _port 写在 _ip 前面,声明却在后面,正好踩中。这种 bug 不炸逻辑,但说明你对执行顺序的认知和编译器不一致,得改。
从对端地址转回人话看的是 SetAddr:
cpp
void SetAddr(struct sockaddr_in &addr)
{
    _addr = addr;
    _port = ntohs(_addr.sin_port); // 从网络中拿到的!网络序列
    char ipbuffer[64];
    inet_ntop(AF_INET, &_addr.sin_addr, ipbuffer, sizeof(ipbuffer));
    _ip = ipbuffer;
}
这里有个我改过的 bug:inet_ntop 的最后一个参数是缓冲区大小 ,原来写的是 sizeof(_addr)------那是地址结构的大小 16,不是 ipbuffer 的大小 64。IPv4 点分十进制最长就是 "255.255.255.255" 恰好 16 字节(15 字符 + \0),所以侥幸没出事。但"恰好够"和"写对了"是两回事,哪天有人把 buffer 改小一点就是栈溢出。
老代码里常见的 inet_ntoa 我不建议用------它返回静态缓冲区指针,多线程下两个线程同时调会互相覆盖,inet_ntop 把 buffer 交给调用者,天然线程安全。
3.4 Log.hpp------策略模式日志
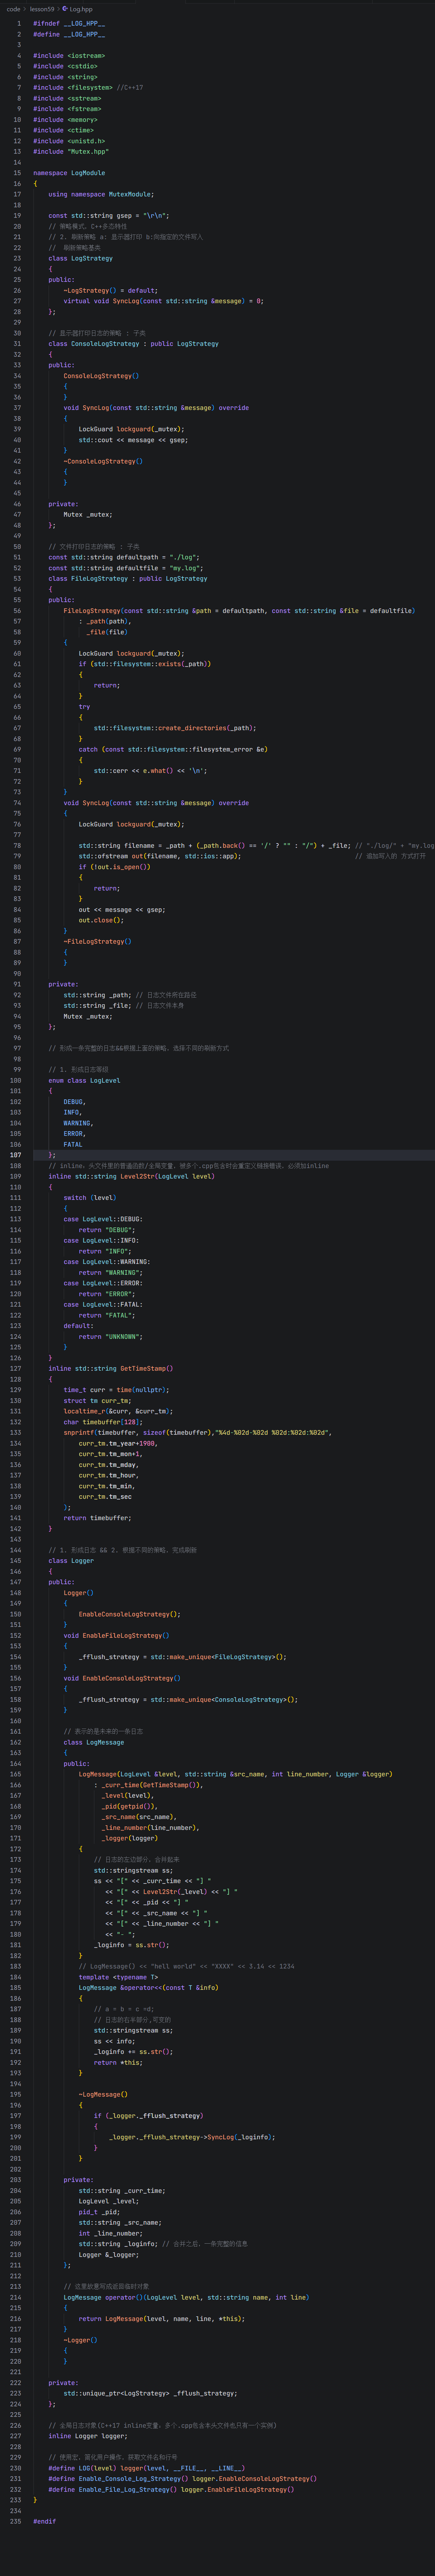
日志模块值得单独一节,因为它是这个项目里"设计模式浓度"最高的地方,而且那个 C++ 技巧相当漂亮。
第一层:刷新策略(策略模式)
cpp
class LogStrategy
{
public:
    ~LogStrategy() = default;
    virtual void SyncLog(const std::string &message) = 0;
};
纯虚基类,约定"日志怎么刷出去"。两个实现:
ConsoleLogStrategy:往std::cout刷,内部带锁;
FileLogStrategy:往文件刷,构造时用 C++17 的std::filesystem::create_directories自动建目录(目录存在就跳过),写的时候以std::ios::app追加模式打开------服务器重启日志不丢。切换策略就一行:
cpp
void EnableFileLogStrategy()   { _fflush_strategy = std::make_unique<FileLogStrategy>(); }
void EnableConsoleLogStrategy(){ _fflush_strategy = std::make_unique<ConsoleLogStrategy>(); }
unique_ptr 换个指向就完成了策略切换,多态+智能指针,不需要 new/delete。想改成"日志进 MySQL"?加个子类就行,其他代码全不动。
第二层:拼一条日志的技巧------临时对象 + 析构刷新
这是整个 Log.hpp 最精妙的地方,我第一次看的时候拍案叫绝:
cpp
class LogMessage
{
public:
    LogMessage(LogLevel &level, std::string &src_name, int line_number, Logger &logger)
        : _curr_time(GetTimeStamp()), _level(level), _pid(getpid()),
          _src_name(src_name), _line_number(line_number), _logger(logger)
    {
        // 日志的左边部分,合并起来
        std::stringstream ss;
        ss << "[" << _curr_time << "] "
           << "[" << Level2Str(_level) << "] "
           << "[" << _pid << "] "
           << "[" << _src_name << "] "
           << "[" << _line_number << "] "
           << "- ";
        _loginfo = ss.str();
    }
    template <typename T>
    LogMessage &operator<<(const T &info)
    {
        std::stringstream ss;
        ss << info;
        _loginfo += ss.str();
        return *this;
    }
    ~LogMessage()
    {
        if (_logger._fflush_strategy)
        {
            _logger._fflush_strategy->SyncLog(_loginfo);
        }
}看构造函数左边拼什么:时间、等级、PID 、文件名、行号。__FILE__ 和 __LINE__ 是编译器内置宏,所以每条日志天然带"案发现场":
bash
[2026-09-19 15:50:37] [DEBUG] [2778380] [Http.hpp] [64] - _method: GET出了问题,日志一翻就知道哪个文件哪一行、是哪个进程打的------fork 模型下 PID 尤其重要,一眼看出是父进程还是哪个子进程在说话。
再看使用侧:
bash
LOG(LogLevel::DEBUG) << "_method: " << _method;宏展开是 logger(LogLevel::DEBUG, __FILE__, __LINE__),调用的是:
cpp
LogMessage operator()(LogLevel level, std::string name, int line)
{
    return LogMessage(level, name, line, *this);  // 故意返回临时对象
}
注意:返回的是临时对象,不是指针不是引用。 后面一连串 << 都在这个临时对象上追加内容。
关键来了------这整条语句结束时,临时对象的生命周期到头,析构函数自动触发,SyncLog 把攒好的完整日志一次性刷出去。
这就是"临时对象析构即刷新"技巧:刷新动作不用用户操心,C++ 的对象生命周期规则替你兜底。这也解释了一个坑------你绝对不能把 LOG(...) 写成多行语句:
cpp
LOG(LogLevel::DEBUG) << "a";
<< "b";   // 编译错误!临时对象上一行就析构了
还有个实现细节:日志里换行我统一用 \r\n(gsep),不用 std::endl------endl 除了换行还会 flush 流,在模板 operator<< 里还有类型推导的坑,我之前被它坑出过编译错误,从此我的日志模块一律自己管换行。
inline 的教训 :Level2Str、GetTimeStamp 这两个自由函数和 Logger logger 这个全局对象,都定义在头文件里。头文件会被多个 .cpp 包含,普通函数和全局变量在每个翻译单元里都会生成一份定义,链接时直接报"multiple definition"。我之前的项目就在这上面崩过。C++17 的解法很干净:全加 inline(变量也有 inline 了),多个翻译单元共享一份。
四、Socket.hpp------把 socket 系统调用包成对象
Linux 的 socket API 是 C 风格的:socket() 返回个 fd,bind/listen/accept 都拿这个 fd 操作。直接在业务代码里裸调这些函数,代码会散得到处都是。我的做法是封装成类:
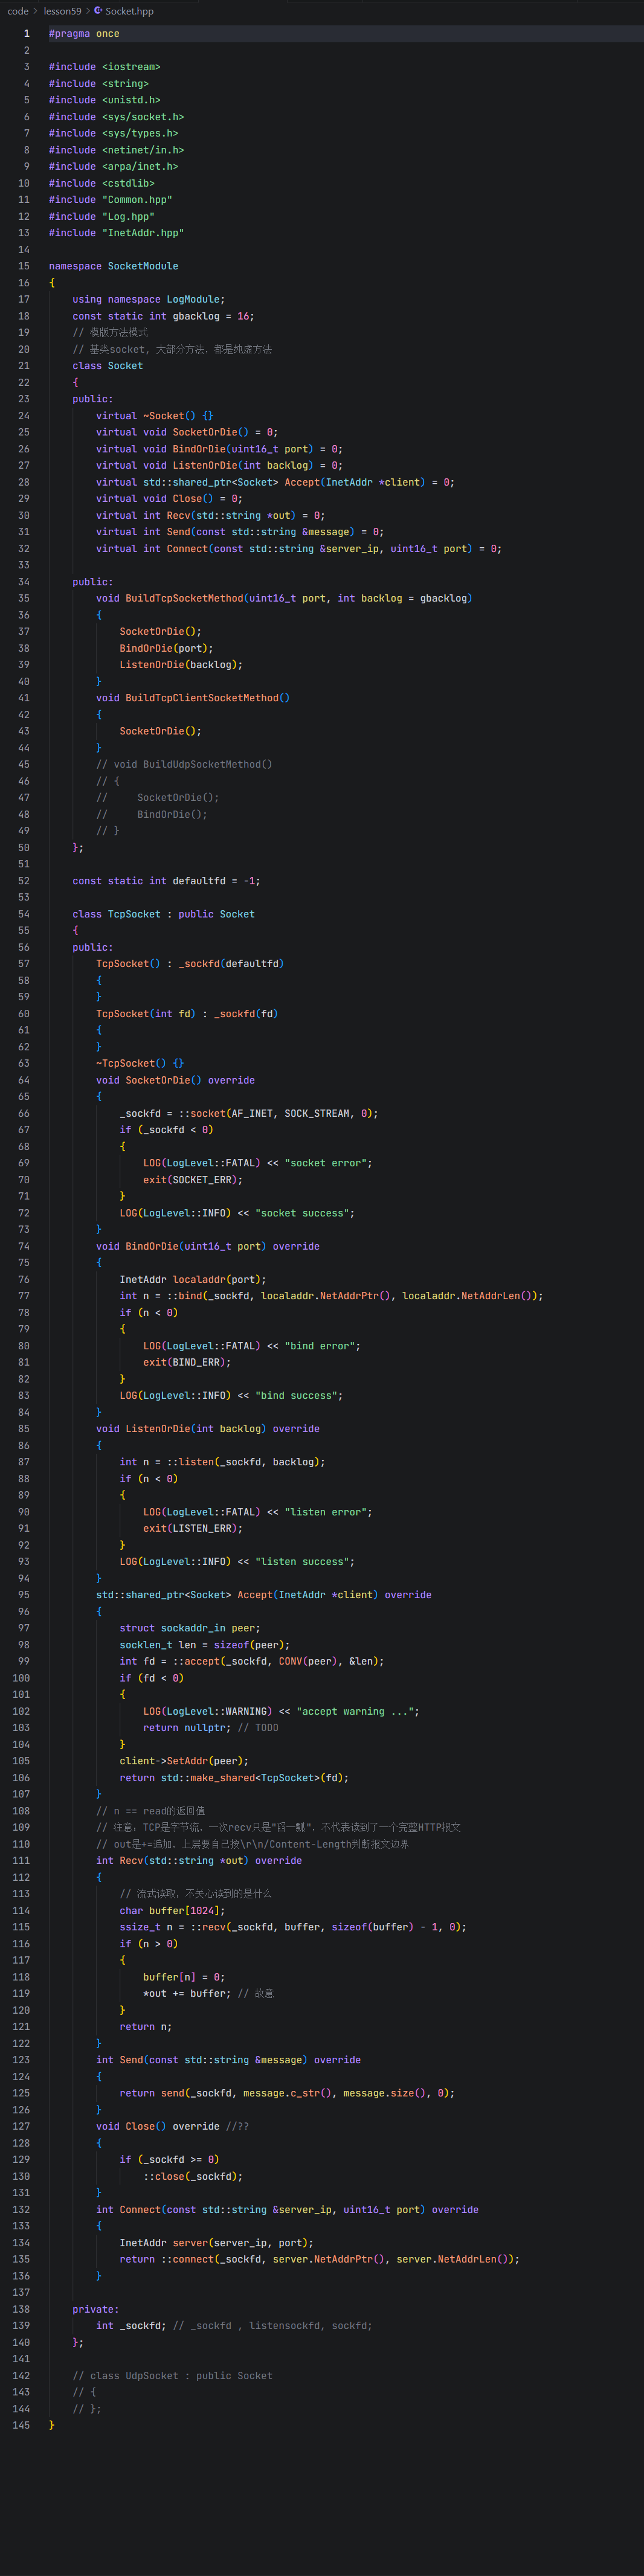
cpp
class Socket
{
public:
    virtual ~Socket() {}
    virtual void SocketOrDie() = 0;
    virtual void BindOrDie(uint16_t port) = 0;
    virtual void ListenOrDie(int backlog) = 0;
    virtual std::shared_ptr<Socket> Accept(InetAddr *client) = 0;
    virtual void Close() = 0;
    virtual int Recv(std::string *out) = 0;
    virtual int Send(const std::string &message) = 0;
    virtual int Connect(const std::string &server_ip, uint16_t port) = 0;

public:
    void BuildTcpSocketMethod(uint16_t port, int backlog = gbacklog)
    {
        SocketOrDie();
        BindOrDie(port);
        ListenOrDie(backlog);
    }
    void BuildTcpClientSocketMethod()
    {
        SocketOrDie();
    }
};这是模板方法模式 :基类把"创建 TCP 服务器 socket 的固定套路"(创建→绑定→监听)在 BuildTcpSocketMethod 里定死,具体每一步怎么干交给子类。现在只有 TcpSocket 一个子类,但哪天要加 UdpSocket,套路是现成的。
每个方法名带 OrDie 是我的命名强迫症:这些操作失败就没法玩了(bind 失败服务器起来干嘛),直接打 FATAL 日志然后 exit。错误分级很重要:能救的救(accept 偶尔失败 return nullptr 继续),救不了的痛快死(bind 失败活着也是浪费电)。
TcpSocket 里最值得细讲的是 Recv:
cpp
int Recv(std::string *out) override
{
    // 流式读取,不关心读到的是什么
    char buffer[1024];
    ssize_t n = ::recv(_sockfd, buffer, sizeof(buffer) - 1, 0);
    if (n > 0)
    {
        buffer[n] = 0;
        *out += buffer; // 故意
    }
    return n;
}
四个细节,全是 TCP 的本质:
buffer 只开 1024:recv 是"来多少舀多少",一次调用最多舀 1023 字节。大报文要上层循环调。
sizeof(buffer) - 1:留 1 字节放\0。
buffer[n] = 0:recv 不帮你加\0,它只返回读了多少字节。不补\0后面按 C 字符串处理就读越界了。
*out += buffer是 += 不是 = :这是"追加"语义,上层多次调用 Recv 把字节流攒起来。注意+=一个char*会在第一个\0处截断 ------HTTP 报文里不会出现\0所以没事,但传二进制协议时这就是 bug,得换成out->append(buffer, n)。
Accept 返回 std::shared_ptr<Socket> 而不是裸 fd:
cpp
std::shared_ptr<Socket> Accept(InetAddr *client) override
{
    struct sockaddr_in peer;
    socklen_t len = sizeof(peer);
    int fd = ::accept(_sockfd, CONV(peer), &len);
    if (fd < 0)
    {
        LOG(LogLevel::WARNING) << "accept warning ...";
        return nullptr;
    }
    client->SetAddr(peer);
    return std::make_shared<TcpSocket>(fd);
}
这是个很舒服的封装设计:accept 出来的通信 fd 直接包成一个新的 TcpSocket 对象交出去,调用方拿到的就是个能收能发的完整对象。
但有个必须说破的细节 :这版 TcpSocket 的析构函数是空的,并不会自动 close fd!
真正关 fd 靠两件事:上层显式调 Close()(TcpServer 里孙子进程干完活那次),以及进程退出时内核兜底回收。
那为什么不顺手在析构里加个 close(_sockfd) 做成完全 RAII?可以,但必须配套把 _sockfd 置回 -1------不然显式 Close() 关一次、析构再关一次就是 double close :fd 号会被系统复用分配给别人,第二个 close 会误伤别人刚打开的文件,这种 bug 能把人逼疯。要么纯显式关(现状),要么彻底 RAII(析构 close + 置 -1),最怕半吊子。TcpSocket(int fd) 这个构造函数就是为 Accept 准备的。
五、TcpServer.hpp------fork 并发模型(本项目的进程戏份全在这)
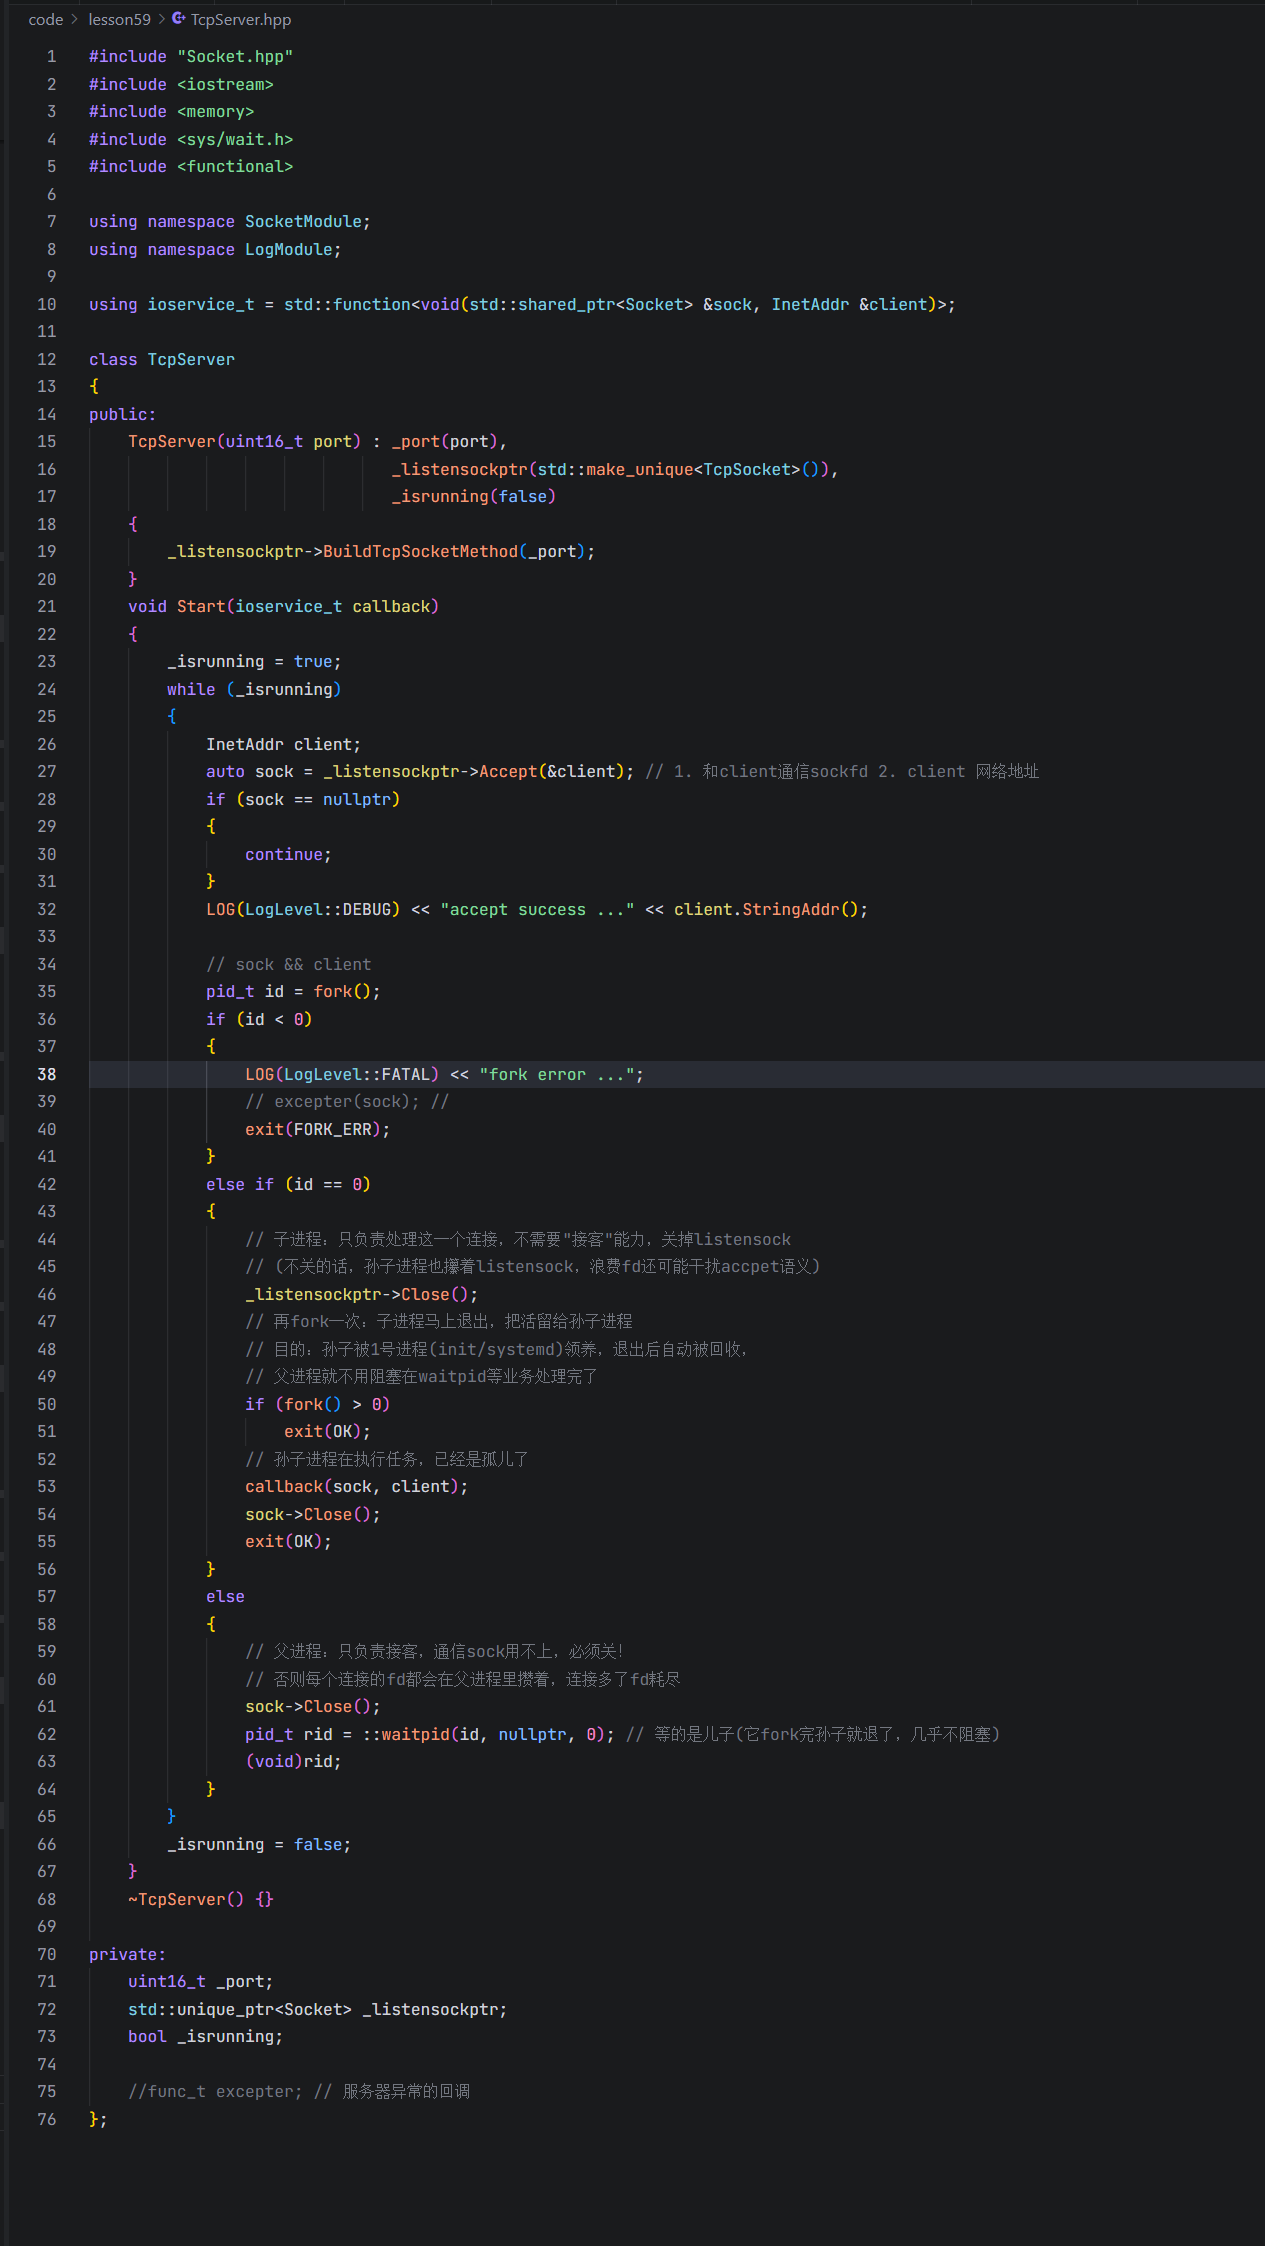
这个文件是纯网络层,对 HTTP 一无所知。先看它怎么定义"业务":
cpp
using ioservice_t = std::function<void(std::shared_ptr<Socket> &sock, InetAddr &client)>;一个 std::function,参数是通信 socket 和对端地址。TcpServer 收到连接后调它,调的谁?Http 传进来的处理函数。这就是回调解耦 :TcpServer 只管接客,接完客把"话筒"递出去。
主循环四步走:
cpp
void Start(ioservice_t callback)
{
    _isrunning = true;
    while (_isrunning)
    {
        InetAddr client;
        auto sock = _listensockptr->Accept(&client); // 1. 拿到通信sockfd和对端地址
        if (sock == nullptr)
        {
            continue;   // accept偶发失败,不断主,继续接下一个
        }
        LOG(LogLevel::DEBUG) << "accept success ..." << client.StringAddr();
        ...fork 分发...
    }
}
accept 拿到的是新的 fd(通信 socket),和 listen socket 是两码事:listensock 负责"拉客",sock 负责"跟这位客人单独聊"。分不清这俩的,可以想象成餐厅门口领位的和进包间服务的不是同一个人。
然后是重头戏,fork 三分支。我把每个分支"谁活着、谁关什么"标清楚:
cpp
pid_t id = fork();
if (id < 0)
{
    LOG(LogLevel::FATAL) << "fork error ...";
    exit(FORK_ERR);
}
else if (id == 0)
{
    // ---- 子进程 ----
    _listensockptr->Close();     // (1) 子进程不拉客,关掉listensock
    if (fork() > 0)              // (2) 二次fork
        exit(OK);                //     子进程自己退出,把活留给孙子
    callback(sock, client);      // (3) 孙子进程干活
    sock->Close();
    exit(OK);
}
else
{
    // ---- 父进程 ----
    sock->Close();               // (4) 父进程不聊天,关掉通信sock
    pid_t rid = ::waitpid(id, nullptr, 0);  // (5) 等儿子退出
    (void)rid;
}
关键点,一个都不能含糊:
(1) 子进程为什么关 listensock? fork 出来的子进程继承父进程所有 fd,包括 listensock。子进程只需要伺候这一个连接,listensock 在它手里纯属多余------不关的话,万一子进程也去 accept,一个连接可能被它抢走,而且每个子进程都攥着 listensock 的引用,fd 计数乱糟糟。
(2) 为什么要 fork 两次? 这是这个模型最精妙的设计。
如果只 fork 一次:父进程要么 waitpid 等子进程处理完业务(业务慢就阻塞了 accept,服务器"卡住"),要么设 SIG_IGN/信号处理回收(代码又多一份)。
二次 fork 的思路是:儿子 fork 完立刻退出,真正干活的孙子变成孤儿,被 1 号进程(init/systemd)领养,孙子退出后由 1 号进程自动收割。父进程 waitpid 等的是儿子------儿子 fork 完就退,waitpid 瞬间返回,主循环立刻回去 accept 下一个客人。处理耗时的业务被完全甩给了孤儿进程。
一句话:waitpid 只等"交接班",不等"干完活"。
(3) 孙子进程干完活的收尾 :callback 跑完 sock->Close() 再 exit(OK)。其实孤儿进程退出时内核同样会回收 fd,这两行更像"好习惯的仪式感"------万一以后业务函数里还有别的代码路径,显式关总是不吃亏的。
(4) 父进程为什么关 sock? 同理反一下:父进程只管拉客。通信 sock 不关,每来一个连接父进程就多攥一个 fd,连接一多直接把进程的 fd 上限耗光(ulimit -n,默认 1024)。fork 模型的铁律:不用的 fd 立刻关,父子各关各的。
(5) waitpid 阻塞在主循环里,不慌吗? 慌的时候才需要信号方案,这里不慌------因为儿子活得极短(fork 完就退),waitpid 实际上不阻塞。
还有一个容易漏的点:fork 失败分支里那个 sock 没 close 就 exit 了------要不要紧?不要紧,进程退出时内核会回收该进程所有的 fd,这是内核的兜底,不是你不用管,是内核替你管了。
六、Util.hpp------三个纯工具函数
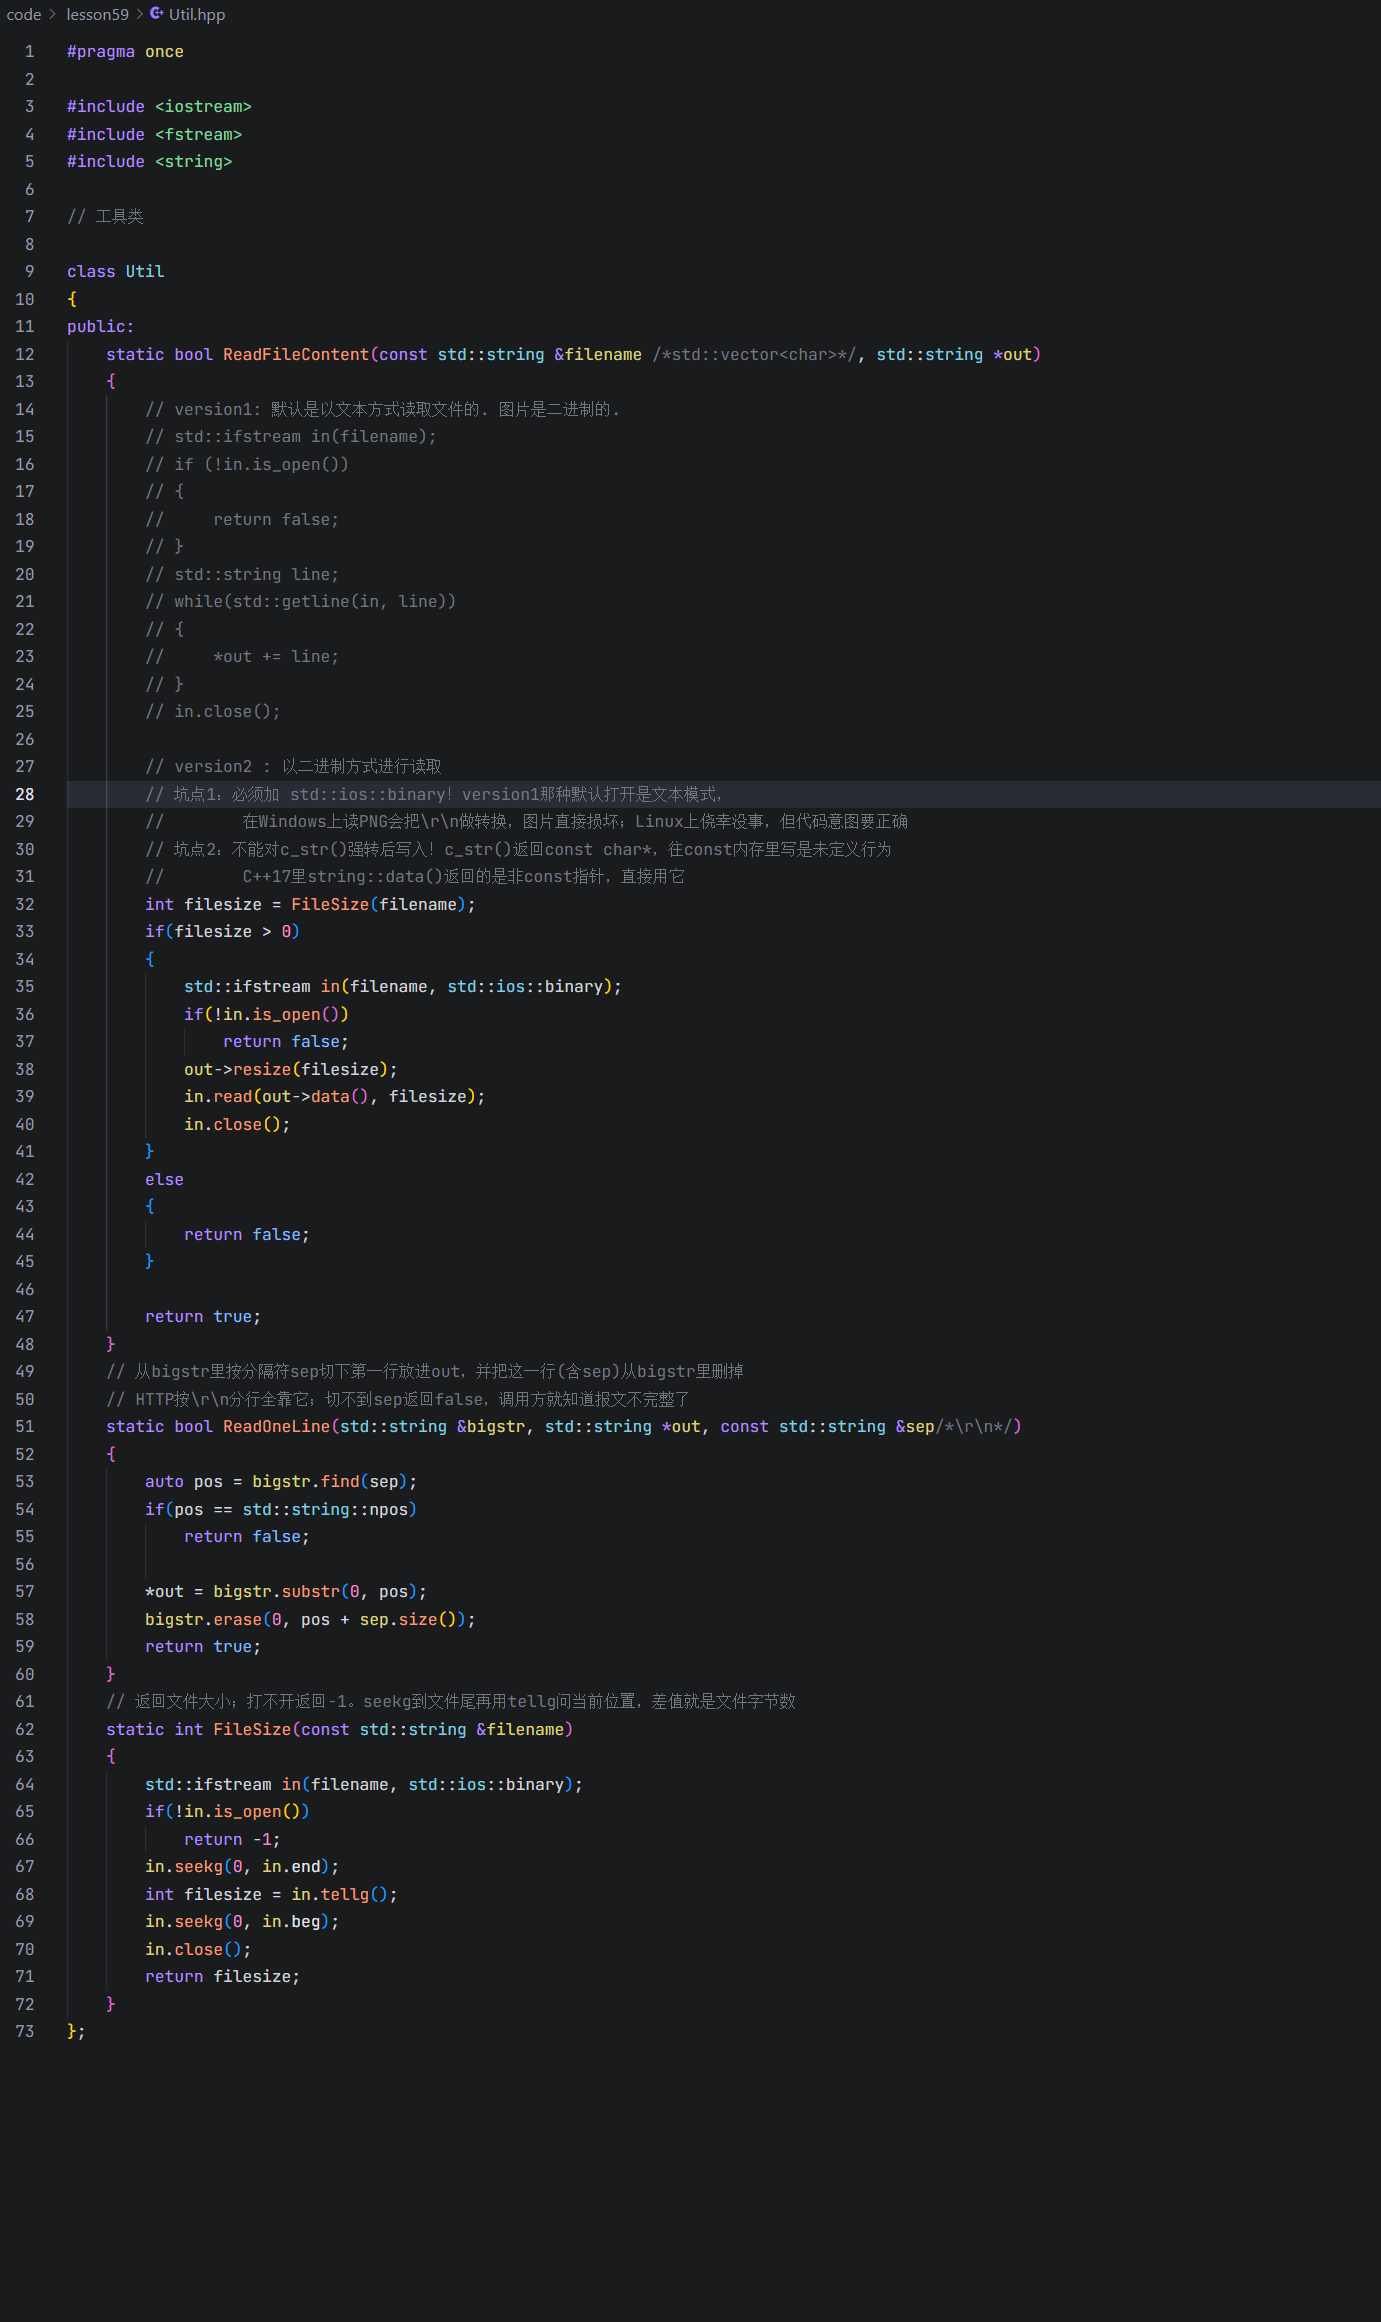
6.1 ReadFileContent:读文件的两个坑
cpp
static bool ReadFileContent(const std::string &filename, std::string *out)
{
    int filesize = FileSize(filename);
    if(filesize > 0)
    {
        std::ifstream in(filename, std::ios::binary);
        if(!in.is_open())
            return false;
        out->resize(filesize);
        in.read(out->data(), filesize);
        in.close();
    }
    else
    {
        return false;
    }
    return true;
}
流程:先问文件多大 → 一次性 resize 好内存 → 一口气读进来。
注释里我留了 version1 的对照(逐行 getline),它有个致命问题:按行读会丢换行符,而且是文本模式。HTTP 要回的可能是图片、视频,任何"按行"的假设都是错的,二进制必须整块读。
坑1:std::ios::binary 必须加 。这版代码原来没加------注释写着"以二进制方式进行读取",打开却默认文本模式。Linux 上侥幸没事(Linux 不区分文本/二进制模式),Windows 上读 PNG 会把 \r\n 做转换,图片直接损坏。代码意图和实现必须一致,侥幸≠正确。
坑2:别对 c_str() 强转写入 。原代码是 in.read((char*)(out->c_str()), filesize)------c_str() 返回 const char*,强转掉 const 往里写是未定义行为。C++17 里 string::data() 返回的就是非 const 指针,光明正大地用。
6.2 ReadOneLine:整个 HTTP 解析的切行核心
cpp
static bool ReadOneLine(std::string &bigstr, std::string *out, const std::string &sep/*\r\n*/)
{
    auto pos = bigstr.find(sep);
    if(pos == std::string::npos)
        return false;

    *out = bigstr.substr(0, pos);
    bigstr.erase(0, pos + sep.size());
    return true;
}
逻辑三行:找分隔符 → 切出前半段 → 把切走的(连同分隔符)从源串里删掉。
妙在 bigstr 是引用传入、原地缩减 :每调一次,"吃掉"一行,剩下的内容还在 bigstr 里。上层循环调它就能把报文逐行剥开。返回 false 意味着"找不到 \r\n 了"------对请求行解析来说就是报文残缺,上层直接放弃。
6.3 FileSize:seekg/tellg 组合拳
cpp
static int FileSize(const std::string &filename)
{
    std::ifstream in(filename, std::ios::binary);
    if(!in.is_open())
        return -1;
    in.seekg(0, in.end);    // 文件指针甩到结尾
    int filesize = in.tellg(); // 问当前位置=第几字节,就是文件大小
    in.seekg(0, in.beg);    // 拨回开头
    in.close();
    return filesize;
}原理就像问你"这本书多厚"------把书签翻到最后一页,看页码。seekg 移动读指针,tellg 报告当前位置,一去一回拿到字节数。打不开文件返回 -1,调用方据此走 404 逻辑。
七、Http.hpp------正戏:报文的解析与组装
这个文件是应用层核心,我拆成四块讲:请求解析、响应组装、路由分发、服务器组装。
7.1 HttpRequest:把请求行嚼碎
cpp
class HttpRequest
{
public:
    HttpRequest() : _is_interact(false) {}
    ...
private:
    std::string _method;
    std::string _uri;
    std::string _version;

    std::unordered_map<std::string, std::string> _headers;
    std::string _blankline;
    std::string _text;

    std::string _args;      // ?后面的参数
    bool _is_interact;      // 是否是带参数的动态交互请求
};
_is_interact 是理解这个类设计的钥匙:请求分两类------静态请求 (要个网页/图片,回文件就行)和动态请求 (/login?username=xxx 这种要跑代码的)。区别就是 URI 里有没有 ?。
反序列化的主干:
cpp
bool Deserialize(std::string &reqstr)
{
    // 1. 提取请求行:从reqstr里按\r\n切下第一行
    std::string reqline;
    bool res = Util::ReadOneLine(reqstr, &reqline, glinespace);
    if (!res) // 连请求行都切不出来,说明报文是空的/残缺的
        return false;
    LOG(LogLevel::DEBUG) << reqline;

    // 2. 对请求行进行反序列化
    ParseReqLine(reqline);
ParseReqLine 用 stringstream 一行搞定三个字段:
cpp
void ParseReqLine(std::string &reqline)
{
    // GET / HTTP/1.1
    std::stringstream ss(reqline);
    ss >> _method >> _uri >> _version;
}
>> 按空白切,正好对应"方法 空格 URI 空格 版本"的格式------用格式本身的规律省掉手写切分,这是 C++ 处理定式文本的惯用招。
接着是 URI 的规整和参数剥离:
cpp
if (_uri == "/")
    _uri = webroot + _uri + homepage; // ./wwwroot/index.html
else
    _uri = webroot + _uri; // ./wwwroot/a/b/c.html
...
const std::string temp = "?";
auto pos = _uri.find(temp);
if (pos == std::string::npos)
{
    return true;   // 没有?,纯静态请求
}
_args = _uri.substr(pos + temp.size()); // username=zhangsan&password=123456
_uri = _uri.substr(0, pos);             // ./wwwroot/login
_is_interact = true;
两个设计点:
浏览器请求
/时补上默认首页 。用户访问http://ip:8080/,URI 是/,你总不能回一句"你要啥文件啊",约定俗成回index.html。URI 加上 webroot 前缀变成磁盘路径 。浏览器说
/index.html,那是相对 Web 根目录的逻辑路径,服务器翻译成./wwwroot/index.html才知道去哪读。这个前缀同时挡住了直接读系统文件的企图------传/etc/passwd拼出来是./wwwroot/etc/passwd,读不到。
但还没完 :传 /../../etc/passwd 这种穿越路径,./wwwroot/../.. 就跳回了系统根目录,照样把系统文件读走(路径规范化必须在拼接前做,这版代码还没做,属于已知待办)------Web 安全永远是攻防博弈,挡一层不够。
带 ? 的请求,? 后面就是参数(query string),格式 key=value&key=value,剥出来存 _args,留给业务函数处理。
已知简化 (注释里我也写了):这版只解析了请求行,header 和 body 没读 。对 GET 取静态页够用;要做 POST 拿 body,得继续按 \r\n 剥 header,找到 Content-Length 再按长度读 body。
7.2 HttpResponse:把响应拼出来
cpp
HttpResponse() : _version("HTTP/1.0"), _code(200), _desc("OK"), _blankline(glinespace)
{
}先看构造函数------这行是我改出来的血泪:_code 是 int,不初始化就是随机值 。原代码全靠每个分支记得先调 SetCode,哪天新加个分支忘了调,Serialize 就把栈上的垃圾数字当状态码发给浏览器,那种 bug 能查一下午。构造时给默认值,防御性编程不丢人。
序列化------注意注释里那句"成熟的 http,应答做序列化,不要依赖任何第三方库":
cpp
std::string Serialize()
{
    std::string status_line = _version + gspace + std::to_string(_code) + gspace + _desc + glinespace;
    std::string resp_header;
    for (auto &header : _headers)
    {
        std::string line = header.first + glinesep + header.second + glinespace;
        resp_header += line;
    }
    return status_line + resp_header + _blankline + _text;
}
纯字符串拼接:状态行 + 报头逐行 + 空行 + 正文。
对比一下:上篇计算器的请求解析用 jsoncpp,是因为业务字段是 JSON、嵌套结构手切容易错;HTTP 请求行是"空格分隔的定式文本",stringstream 就够;而响应序列化是我们生产报文,格式完全由自己控制,字符串拼接最轻量------这也是你以后看 Nginx 源码会看到的手法。
MakeResponse 是静态资源服务的灵魂:
bash
bool MakeResponse()
{
    if (_targetfile == "./wwwroot/favicon.ico")
    {
        LOG(LogLevel::DEBUG) << "用户请求: " << _targetfile << "忽略它";
        return false;
    }
    if (_targetfile == "./wwwroot/redir_test")
    {
        SetCode(301);
        SetHeader("Location", "https://www.qq.com/");
        return true;
    }
    int filesize = 0;
    bool res = Util::ReadFileContent(_targetfile, &_text);
    if (!res)
    {
        _text = "";
        SetCode(404);
        _targetfile = webroot + page_404;
        filesize = Util::FileSize(_targetfile);
        if (filesize <= 0) // 连404.html都不存在时,不能把Content-Length写成-1
            filesize = 0;
        Util::ReadFileContent(_targetfile, &_text);
        SetHeader("Content-Type", Uri2Suffix(_targetfile));
        SetHeader("Content-Length", std::to_string(filesize));
    }
    else
    {
        SetCode(200);
        filesize = Util::FileSize(_targetfile);
        SetHeader("Content-Type", Uri2Suffix(_targetfile));
        SetHeader("Content-Length", std::to_string(filesize));
        SetHeader("Set-Cookie", "username=zhangsan;");
    }
    return true;
}
四个现象级的逻辑:
favicon.ico 直接忽略 :浏览器每次访问都会自动请求一次
站点/favicon.ico(标签页小图标)。我们没这文件,不理它就行------虽然返回 false 意味着这个连接啥也不回,浏览器对 favicon 有自己的容错,不影响页面渲染(实测现象见第九节现象2)。301 重定向 :
SetCode(301)+SetHeader("Location", "https://www.qq.com/"),就这两个头。浏览器收到 301,看到 Location,二话不说跳转到新地址。重定向的本质就这么朴素。404 的兜底逻辑 :文件读不到 → 换 404.html 的内容当正文 → 状态码 404。注意那个
filesize <= 0的保护:404.html 自己也丢了的话,FileSize返回 -1,Content-Length: -1发出去浏览器直接懵------报头数值永远是对方解析的对象,不能有非法值。Set-Cookie :成功响应顺手种了个 cookie。浏览器会存下来,以后每次请求自动带上
Cookie: username=zhangsan------HTTP 本身无状态,会话保持全靠这对配合。
Uri2Suffix 管 MIME 类型:
cpp
if (suffix == ".html" || suffix == ".htm")
    return "text/html";
else if (suffix == ".jpg")
    return "image/jpeg";
else if (suffix == ".png")
    return "image/png";
这里有个我抓出来的经典 bug :原代码写的是 suffix == "png"------少个点,永远匹配不上,PNG 的 Content-Type 一直是空。substr(pos) 从 . 开始切,切出来的是 .png,字符串匹配差一个字符都不行。浏览器拿到空的 Content-Type 就只能靠猜(嗅探),猜错了就当文本下载。这类 bug 编译器不报、运行不崩,页面"看起来"还能开,最容易存活下来。
还有 SetHeader 的语义注释:
bash
// 注意语义:同名key已存在时不覆盖,第二次设置会被丢弃
// 想覆盖的话,把这里改成 _headers[key] = value; 即可"先查再插"实现的是不覆盖语义。这是设计选择(防止后面的代码误改关键头),但你必须知道它------不然明明调了 SetHeader 却"不生效",查半天查不出问题。
7.3 路由表 + 服务器组装
cpp
using http_func_t = std::function<void(HttpRequest &req, HttpResponse &resp)>;

class Http
{
public:
    Http(uint16_t port) : tsvrp(std::make_unique<TcpServer>(port)) {}

    void RegisterService(const std::string name, http_func_t h)
    {
        std::string key = webroot + name; // ./wwwroot/login
        if (_route.find(key) == _route.end())
        {
            _route.insert(std::make_pair(key, h));
        }
    }
路由表就是 unordered_map<路径, 处理函数>。注册时把 /login 也拼上 webroot 前缀变成 ./wwwroot/login------和请求解析后的 URI 同一套格式,查找才能对上。
这就是"注册和查找必须用同一种坐标系",两边坐标系不一致,路由永远 404,而且是那种代码看着全对、就是跑不通的 404。
核心分发逻辑:
cpp
void HandlerHttpRquest(std::shared_ptr<Socket> &sock, InetAddr &client)
{
    std::string httpreqstr;
    // 这里实际是"TCP粘包问题":HTTP报文之间靠空行(\r\n\r\n)分界,只recv一次,
    // 大网页/慢网络时可能只收到半个报文,也可能一次收到好几个报文
    // 完整做法:先读到\r\n\r\n拿到header,解析出Content-Length,再循环recv把body读够
    int n = sock->Recv(&httpreqstr);
    if (n > 0)
    {
        std::cout << "##########################" << std::endl;
        std::cout << httpreqstr;
        std::cout << "##########################" << std::endl;

        HttpRequest req;
        HttpResponse resp;
        if (!req.Deserialize(httpreqstr))
            return;
        if (req.isInteract())
        {
            if (_route.find(req.Uri()) == _route.end())
            {
                // 路由表里没有这个交互路径:不能什么都不回!
                // 不回数据的话,浏览器会一直干等到超时,表现就是页面卡死转圈
                resp.SetCode(404);
                std::string text = "<html><h1>404 Not Found</h1></html>";
                resp.SetHeader("Content-Type", "text/html");
                resp.SetHeader("Content-Length", std::to_string(text.size()));
                resp.SetText(text);
                sock->Send(resp.Serialize());
            }
            else
            {
                _route[req.Uri()](req, resp);
                std::string response_str = resp.Serialize();
                sock->Send(response_str);
            }
        }
        else
        {
            resp.SetTargetFile(req.Uri());
            if (resp.MakeResponse())
            {
                std::string response_str = resp.Serialize();
                sock->Send(response_str);
            }
        }
    }
}这段里最值得圈出来的是交互路径未注册时的处理 。原代码那里是空的------找到路由走回调,找不到就什么都不干。TCP 连接还开着,对方在等响应,我们不回也不关,浏览器就一直转圈等到超时。我实测:curl exit 52(空响应)。任何分支都必须给对方一个交代,哪怕是个 404。
最后 Start 把自己和 TcpServer 缝合:
cpp
void Start()
{
    tsvrp->Start([this](std::shared_ptr<Socket> &sock, InetAddr &client)
                 { this->HandlerHttpRquest(sock, client); });
}
lambda 捕获 this,把 Http 的成员方法包装成 TcpServer 要的 ioservice_t。至此:TcpServer 管连接和进程,Http 管协议,Main.cc 管业务------三层各干各的。
八、Main.cc------把所有积木拼起来
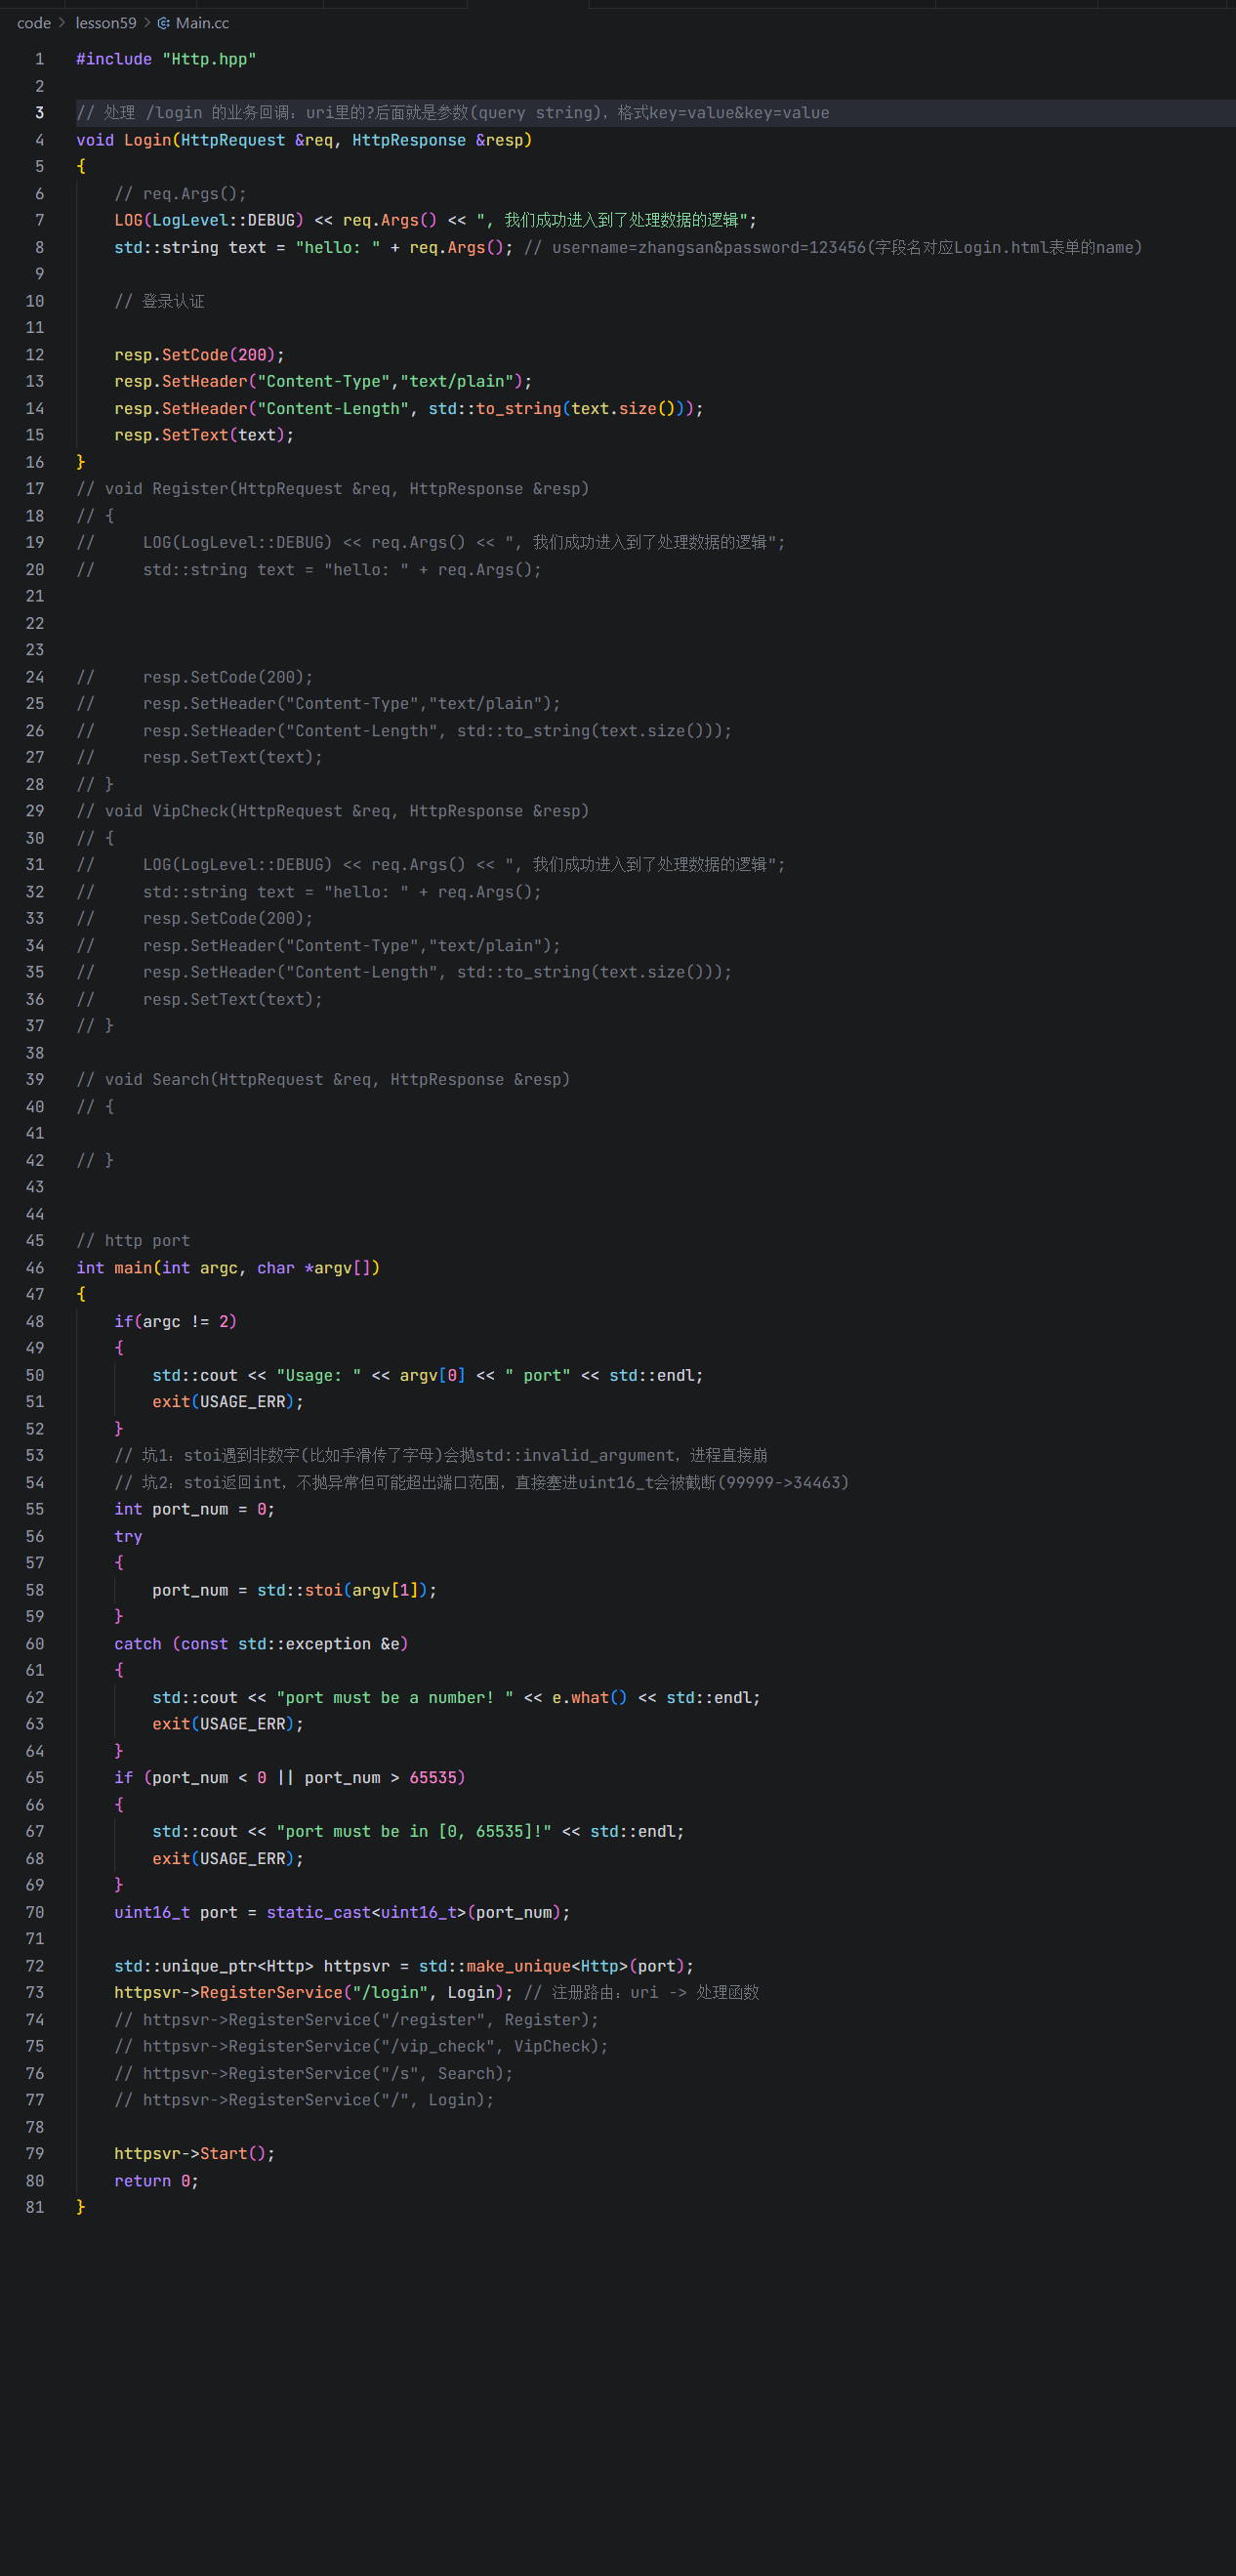
cpp
int main(int argc, char *argv[])
{
    if(argc != 2)
    {
        std::cout << "Usage: " << argv[0] << " port" << std::endl;
        exit(USAGE_ERR);
    }
    // 坑1:stoi遇到非数字会抛std::invalid_argument,进程直接崩
    // 坑2:stoi返回int,超出端口范围直接塞进uint16_t会被截断(99999->34463)
    int port_num = 0;
    try
    {
        port_num = std::stoi(argv[1]);
    }
    catch (const std::exception &e)
    {
        std::cout << "port must be a number! " << e.what() << std::endl;
        exit(USAGE_ERR);
    }
    if (port_num < 0 || port_num > 65535)
    {
        std::cout << "port must be in [0, 65535]!" << std::endl;
        exit(USAGE_ERR);
    }
    uint16_t port = static_cast<uint16_t>(port_num);

    std::unique_ptr<Http> httpsvr = std::make_unique<Http>(port);
    httpsvr->RegisterService("/login", Login); // 注册路由:uri -> 处理函数

    httpsvr->Start();
    return 0;
}命令行参数给端口------端口号不该写死在代码里,不然测试环境 8080、线上 80 就得改代码重编。
std::stoi 这块是我加固过的,两坑都实测过(见第九节现象6):传字母抛异常;传 99999 不抛异常但塞进 uint16_t 静默截断成 34463,服务器绑了个莫名其妙的端口,你查半天"为什么 99999 连不上"。端口本质是个 16 位无符号数,范围 0, 65535,边界必须自己守。
业务回调 Login:
cpp
void Login(HttpRequest &req, HttpResponse &resp)
{
    LOG(LogLevel::DEBUG) << req.Args() << ", 我们成功进入到了处理数据的逻辑";
    std::string text = "hello: " + req.Args();

    resp.SetCode(200);
    resp.SetHeader("Content-Type","text/plain");
    resp.SetHeader("Content-Length", std::to_string(text.size()));
    resp.SetText(text);
}
真实的业务函数就该这么干净:从 req 拿参数(这里偷懒直接回显),往 resp 填状态码、报头、正文。业务代码完全不碰 socket、不碰 recv/send ------网络的事 TcpServer 管了,协议的事 Http 管了。这就是分层给你的自由。
注意 Content-Length 必须和 text.size() 一致,虚标长度浏览器就傻等不存在的字节。
Makefile 就四行,两处讲究:
cpp
# Mutex.hpp用了pthread_mutex,链接要带-pthread
myhttp:Main.cc
	g++ -o $@ $^ -std=c++17 -pthread
.PHONY:clean
clean:
rm -f myhttp-std=c++17:std::filesystem、inline 变量、string::data() 非 const 版,全要 17。-pthread:编译器/链接器需要知道你在用 POSIX 线程库------不加在某些平台上能过,某些平台上运行时炸,别赌。
还有个 Makefile 的暗坑:recipe 行(Tab 开头的命令)里的 # 会原样传给 shell,我第一版把注释写在 g++ 行尾,能跑但脏,后来挪到了独立行。
九、运行现象:真跑起来是什么样
编译、启动(-pthread 已就位):
bash
$ make
g++ -o myhttp Main.cc -std=c++17 -pthread
$ ./myhttp 8080
[2026-09-19 15:50:36] [INFO] [2778366] [Socket.hpp] [72] - socket success
[2026-09-19 15:50:36] [INFO] [2778366] [Socket.hpp] [83] - bind success
[2026-09-19 15:50:36] [INFO] [2778366] [Socket.hpp] [93] - listen success
三条日志,对应 BuildTcpSocketMethod 的三步。[2778366] 是父进程 PID。服务器启动只干这三件事,之后所有日志都是每个连接的处理过程。
现象1:curl 首页------一个完整请求的全过程
bash
$ curl -s -o /dev/null -w "%{http_code} %{size_download}B %{content_type}\n" http://127.0.0.1:8080/
200 2872B text/html
服务端这边同时打出了完整的一套日志:
bash
##########################
GET / HTTP/1.1
Host: 127.0.0.1:8080
User-Agent: curl/7.81.0
Accept: */*

##########################
[DEBUG] [2778380] [Http.hpp] [54] - GET / HTTP/1.1        <- 干活的进程PID是2778380,不是父进程2778366
[DEBUG] [2778380] [Http.hpp] [65] - _uri: ./wwwroot/index.html
[DEBUG] [2778380] [Http.hpp] [66] - _version: HTTP/1.1
[DEBUG] [2778380] [Http.hpp] [223] - 读取文件: ./wwwroot/index.html
几个现象值得品:
#####包着的原始报文就是浏览器/curl 发来的第一手数据,空行肉眼可见------和第二节讲的格式图一一对上。处理请求的进程 PID 是 2778380,启动日志是 2778366------fork 模型的直接证据:父进程接客,孤儿进程干活,日志里的 PID 不会骗人。
URI
/被自动补成./wwwroot/index.html------默认首页逻辑生效。注意 header 打印顺序每次可能不一样(
Set-Cookie有时排在最前)------因为报头存在unordered_map里,哈希表无序 ,序列化时按遍历序输出。HTTP 报头的顺序协议不要求,浏览器不在乎,但强迫症看着难受(想固定顺序就换std::map或者vector<pair>)。
完整响应抓出来看:
bash
HTTP/1.0 200 OK
Set-Cookie: username=zhangsan;
Content-Length: 2872
Content-Type: text/html我还做了个字节级校验:Content-Length: 2872,实际 body 也是 2872 字节,分毫不差。长度报头虚标是 HTTP 的大忌,浏览器会按 Content-Length 读正文,虚了就永远读不满。
现象2:浏览器会偷偷要 favicon.ico
用 curl 模拟浏览器补一刀:
bash
$ curl -s -o /dev/null -w "%{http_code}\n" --max-time 2 http://127.0.0.1:8080/favicon.ico
000            <- 2秒内服务器一个字节都没回
$ echo $?
52             <- curl: Empty reply from server
服务端日志:
bash
[DEBUG] [2804378] [Http.hpp] [54] - GET /favicon.ico HTTP/1.1
[DEBUG] [2804378] [Http.hpp] [65] - _uri: ./wwwroot/favicon.ico
[DEBUG] [2804378] [Http.hpp] [193] - 用户请求: ./wwwroot/favicon.ico忽略它浏览器访问任何网站都会自动 带一次 /favicon.ico 请求(标签页图标),这是浏览器行为,跟页面代码无关。我们选择忽略------浏览器对这个请求有自己的容错,页面照常渲染。如果你在日志里看到莫名其妙的 favicon 请求,不是谁在攻击你,是浏览器的小习惯。
现象3:404------兜底页面
bash
$ curl -s -o /dev/null -w "%{http_code} %{size_download}B\n" http://127.0.0.1:8080/no_such.html
404 1506B
请求的文件不存在,服务器读 wwwroot/404.html 当正文返回,1506 字节就是 404 页面的大小。服务端 WARNING 日志:client want get : ./wwwroot/no_such.html but not found。
现象4:动态交互 /login
bash
$ curl -s "http://127.0.0.1:8080/login?username=zhangsan&password=123456"
hello: username=zhangsan&password=123456走了完全不同的路:is_interact=true → 查路由表命中 ./wwwroot/login → 回调 Login → 回显参数。静态请求读文件、动态请求跑代码,在这个 curl 里肉眼可见地分岔了。
参数里的 & 记得给 shell 加引号,不然 shell 把它当后台运行符,你的 curl 会莫名其妙只发一半。
现象5:301 重定向
bash
$ curl -s -o /dev/null -w "%{http_code} -> %{redirect_url}\n" http://127.0.0.1:8080/redir_test
301 -> https://www.qq.com/
服务器只回了状态行 301 Moved Permanently + Location: https://www.qq.com/,跳转是浏览器/客户端完成的------服务器从不替你跳,它只指路。
现象6:参数传错的防守
bash
$ ./myhttp abc
port must be a number! stoi
$ echo $?
1
$ ./myhttp 99999
port must be in [0, 65535]!
$ ./myhttp -1
port must be in [0, 65535]!
$ ./myhttp
Usage: ./myhttp port
修复前传 abc 是未捕获的 std::invalid_argument 直接 core;传 99999 静默截断成 34463 绑了个鬼端口。现在都拦在门口。
现象7:并发
多开几个终端同时 curl,服务端日志会出现不同的 PID 交错处理------每个连接一个孤儿进程,天然并发。
这也是 fork 模型的好处:进程间隔离,一个连接的处理崩了(比如 stoi 抛异常),死的是那个孤儿进程,父进程和其他连接毫发无损。代价是 fork 开销大,连接量级上去了要换多线程/epoll------那是后续课程的事。
十、踩坑实录:这次检查修掉的问题清单
这一节是我最想写的。这版代码编译零警告、一跑全是坑------下面每一个都是实际运行抓出来的,不是纸面推演:
| # | 位置 | 问题 | 现象 | 修法 |
|---|---|---|---|---|
| 1 | webroot |
代码写 ./wwwroot,磁盘目录叫 www.root,差一个点 |
所有请求 404,包括首页 | 目录改名 wwwroot。Linux 文件系统大小写敏感、名字精确匹配,差一个字符都不行 |
| 2 | MakeResponse |
成功分支报头写成 Conent-Type(拼写错) |
浏览器收不到正确类型头 | 改回 Content-Type |
| 3 | Uri2Suffix |
suffix == "png" 少个点 |
PNG 永远匹配不上,Content-Type 为空 | 改成 ".png" |
| 4 | 交互路由未命中 | 什么都不回 | curl exit 52,浏览器卡死转圈 | 回 404 |
| 5 | ReadFileContent |
打开文件没加 std::ios::binary;(char*)c_str() 强转写入 UB |
Windows 上读图必坏 | 加 binary;改用 data() |
| 6 | stoi |
非数字崩 / 99999 截断 | 服务器绑错端口 | try-catch + 范围检查 |
| 7 | HttpResponse 构造 |
_code 未初始化 |
忘调 SetCode 就发随机状态码 | 构造时给默认值 |
| 8 | inet_ntop |
缓冲区大小传成 sizeof(_addr) |
IPv4 最长恰好 16 字节,纯撞大运 | 传 sizeof(ipbuffer) |
| 9 | 初始化顺序 | 初始化列表顺序和成员声明顺序不一致 | -Wall 报 -Wreorder |
按声明顺序写 |
| 10 | Log.hpp 全局符号 | 头文件里定义函数和全局变量没加 inline | 多个 .cpp 包含会 multiple definition | inline 函数 + C++17 inline 变量 |
| 11 | Makefile | 没带 -pthread |
部分平台运行时炸 | 补上 |
| 12 | favicon/空PNG | 0 字节的图片文件 | ReadFileContent 返回 false → 404 | 这不是 bug:空文件本来就该 404,放真图即可 |
最容易活下来的 bug 是 #2 和 #3:编译器不报、进程不崩、页面"看起来"还能开。这种 bug 的存活时间可以以年计。
所以我的流程是:改完必须 -Wall -Wextra 编译 + curl 逐项实测 + 校验响应头和字节数,光"看代码没问题"不作数。
十一、收个尾:这个项目的口诀
整个服务器拆完,就干四件事:
建连接(socket/bind/listen),接客人(accept + fork), 收报文(recv + 切行解析),回报文(读文件 / 跑业务 + 拼响应)。
分层口诀:
TcpServer 管进程,Http 管协议,业务函数管逻辑,谁也别越界。
几个刻进 DNA 的点:
TCP 是字节流 ,报文边界是应用层的事------HTTP 靠
\r\n和Content-Length,你的协议得自己定(上次是len\r\njson\r\n,一回事)fork 后不用的 fd 立刻关,父子各关各的
二次 fork:儿子交接班,孙子干活,waitpid 不等干完活
任何分支都要给对端一个交代,不回数据人家就挂着
报头数值(Content-Length)和实际字节数必须分毫不差
改完代码:
-Wall -Wextra零警告 + 实测每一项,再相信"我写对了"