小肥柴的Hadoop之旅 快速实验篇(A9-2)Python vs MapReduce:小批量任务的工具选择
目录
- 前言
- [0. 背景知识:从工程视角看工具选择](#0. 背景知识:从工程视角看工具选择)
- [1. 任务概述与目标](#1. 任务概述与目标)
- [2. 环境准备与集群体检](#2. 环境准备与集群体检)
- [3. Python 基准:5k 与 10k 的线性增长](#3. Python 基准:5k 与 10k 的线性增长)
- [4. Hadoop MR 实现:map-only 任务](#4. Hadoop MR 实现:map-only 任务)
- [5. 数值一致性验证](#5. 数值一致性验证)
- [6. 对比分析:一个反直觉的交叉点](#6. 对比分析:一个反直觉的交叉点)
- [7. 三条工程教训](#7. 三条工程教训)
- [8. 从这个小实验看大数据技术栈的分层](#8. 从这个小实验看大数据技术栈的分层)
- [9. 阶段总结](#9. 阶段总结)
前言
本文是"农业气象干旱分析"项目的第九阶段之二(A9-2)。在 A9-1 完成降水---气象因子相关性分析之后,我们用 5000 和 10000 站两个规模,分别用 Python 单机与 Hadoop MapReduce 实现了同样的相关系数计算任务,实测对比两者的耗时、内存和代码复杂度。
这个对比的起点是一个真实的工程困惑:当我们面对一个可以用 MR 表达的任务时,什么规模下用 MR 才是合理的? 在技术选型中,"数据量大就上 MR"是一句过于粗糙的经验;而"Python 一把梭"也不总是对的。我们想量化这个判断的门槛。
同时,实验也意外地触及了一个更大的技术栈话题:为什么大数据基础设施的底层普遍使用 Java/Scala/C/C++,而应用层和数据分析层却几乎全面转向 Python? 这个分层现象在本次对比的实测数据里有清晰的支撑。
核心发现:5k 站时 Python 快 56%,10k 站时 MR 反超 22%,盈亏平衡点约 7812 站。但 MR 的反超并非来自"并行",在数据量小于 HDFS block size 时,MR 只起 1 个 map,3 个 worker 里有 2 个完全空闲。真正决定胜负的是"固定开销"与"计算成本"的此消彼长。
0. 背景知识:从工程视角看工具选择
0.1 为什么要做一个"小任务"的对比
在真正的生产环境里,"用什么工具"是一个综合了数据规模、集群资源、开发效率、运维成本、团队技能栈的多维度决策。但日常开发中,我们常常遇到的场景是:
- 手头有一个 10GB 级别的数据集,不是"真正的"大数据;
- 用 MR 跑一次要等 5 分钟启动,用 Python 跑一次可能只要 2 分钟;
- 团队里 MR 程序员稀缺,Python 人人都会。
这时候,"该不该上 MR"就是一个真实的、需要快速判断的问题。
这个小实验用 5000--10000 站的相关系数计算作为探针,把 MR 的固定开销量化出来,为这类判断提供一个可参考的坐标。
0.2 一个不能忽视的分层现实
在展开对比之前,先说清楚一件事:大数据技术栈本身就是分层的。
| 层级 | 典型工作内容 | 主流语言 | 代表工具 |
|---|---|---|---|
| 底层基础设施 | 分布式存储、调度、执行引擎、序列化 | Java / Scala / C / C++ | HDFS、YARN、Spark 内核、Flink 内核 |
| 中间层 | 数据仓库、SQL 引擎、元数据管理 | Java / Scala | Hive、Presto、Iceberg |
| 应用层 / 分析层 | 数据清洗、特征工程、统计分析、机器学习 | Python / R / SQL | Pandas、NumPy、Scikit-learn、PySpark |
这不是巧合,而是分工:
- 底层要处理的是分布式一致性、内存管理、JVM 调优、故障恢复、GC 暂停这些系统级问题,需要 Java/Scala/C++ 的性能与可控性;
- 应用层要处理的是表达业务逻辑、快速迭代、与科学计算库集成,Python 的生态优势无可替代。
回到本次实验:它属于应用层 的一个具体任务。所以我们的对比目的不是"评判哪种语言更好",而是验证"应用层选型"在什么规模下会被"底层开销"反噬。
1. 任务概述与目标
| 项目 | 说明 |
|---|---|
| 定位 | 承接 A9-1 的相关性分析,量化 Python 单机与 Hadoop MR 在不同数据规模下的耗时、内存和代码复杂度 |
| 目标 | 1. 在 5k / 10k 两个规模上,测量 Python 与 MR 的总耗时、峰值内存 2. 验证两种实现的数值一致性 3. 定位盈亏平衡点 4. 记录 MR 实现过程中的实际踩坑 |
| 输入 | a9_mr_input_5k.tsv(5000 行)、a9_mr_input_10k.tsv(10000 行),格式:station_id \t date \t fips \t PRECTOT \t T2M \t PS \t QV2M(7 列 TSV) |
| 输出 | part-m-00000-5k、part-m-00000-10k(每行 station_id \t 6个逗号分隔值) |
| 验证 | max_diff = 0(两种实现完全一致);MR 输出行数 = 输入行数 |
| 规模策略 | 5k 起步,跑通后追加 10k。不做全量(3 节点 2GB,风险高、收益低) |
为什么选 5k 和 10k:
- 5k(约 9.6 MB)代表"数据量远小于 HDFS block size"的场景;
- 10k(约 19.2 MB)代表"数据量开始逼近并行门槛"的场景;
- 两者都远小于 128 MB,MR 只起 1 个 map,可以干净地观察固定开销。
2. 环境准备与集群体检
2.1 集群规模
实验环境为 1 个 master + 3 个 worker,每节点 2 GB 内存。
| 项 | 值 |
|---|---|
| 节点数 | 4(1 master + 3 worker) |
| 单节点内存 | 2 GB(实际可用 ~900 MB) |
| HDFS block size | 128 MB |
| YARN 每节点资源上限 | 1024 MB |
| YARN 最小容器 | 256 MB |
| YARN 最大容器 | 1024 MB |
2.2 YARN 参数核对
在 master 上执行:
bash
grep -A 1 -E "yarn.nodemanager.resource.memory-mb|yarn.scheduler.minimum-allocation-mb|yarn.scheduler.maximum-allocation-mb" $HADOOP_HOME/etc/hadoop/yarn-site.xml输出:
<name>yarn.nodemanager.resource.memory-mb</name>
<value>1024</value>
<name>yarn.scheduler.minimum-allocation-mb</name>
<value>256</value>
<name>yarn.scheduler.maximum-allocation-mb</name>
<value>1024</value>
一个绕不过去的约束 :yarn.app.mapreduce.am.resource.mb 默认为 1536 MB,超过节点上限 1024 MB ,不显式调小会导致 AM 起不来、任务卡在 ACCEPTED。这是后续运行命令必须带 -D yarn.app.mapreduce.am.resource.mb=512 的原因。
2.3 抽样:从 102,395 站到 5k / 10k
从 A9-1 的 a9_corr_result_dedup.csv(102,395 个唯一站)中,与 A9 解析后的原始数组表取交集,然后 random_state=42 随机抽 5k 和 10k。
关键代码片段(完整脚本见 a9_mr_sample_v1.py / a9_mr_sample_10k.py):
python
mask_90 = (
    (raw['PRECTOT'].str.count(',')+1 == 90) &
    (raw['T2M'].str.count(',')+1 == 90) &
    (raw['PS'].str.count(',')+1 == 90) &
    (raw['QV2M'].str.count(',')+1 == 90)
)
raw = raw[mask_90].copy()
raw = raw[raw['station_id'].isin(set(a9['station_id']))].copy()

sample = raw.sample(n=5000, random_state=42)
sample.to_csv('a9_mr_input_5k.tsv', sep='\t', header=False, index=False)输出:
| 文件 | 大小 | 行数 | 用途 |
|---|---|---|---|
a9_mr_input_5k.tsv |
9.6 MB | 5000 | MR 输入(无表头) |
a9_mr_input_10k.tsv |
19.2 MB | 10000 | MR 输入(无表头) |
a9_sample_5000.tsv |
--- | 5000 | Python 基准(带表头) |
a9_sample_10000.tsv |
--- | 10000 | Python 基准(带表头) |
3. Python 基准:5k 与 10k 的线性增长
3.1 脚本设计
Python 基准脚本的核心是一个 for 循环,逐站解析 4 个数组并计算 6 个相关系数。关键代码:
python
def parse_arr(s):
    return np.array([float(x) for x in str(s).split(',')])

for _, r in sample.iterrows():
    p  = parse_arr(r['PRECTOT'])
    t  = parse_arr(r['T2M'])
    ps = parse_arr(r['PS'])
    q  = parse_arr(r['QV2M'])
    row = {'station_id': r['station_id']}
    for name, arr in [('t2m', t), ('ps', ps), ('qv2m', q)]:
        row[f'pearson_{name}']  = pearsonr(p, arr)[0]
        row[f'spearman_{name}'] = spearmanr(p, arr)[0]
    records.append(row)
内存监控用一个后台线程每 50 ms 采样一次 psutil 的 RSS。
3.2 实测结果
| 规模 | 读取 | 计算 | 总耗时 | 峰值内存 |
|---|---|---|---|---|
| 5k | 0.21 s | 22.03 s | 22.18 s | 133.6 MB |
| 10k | 0.40 s | 43.01 s | 43.79 s | 161.5 MB |
工程观察:
- 耗时随数据量 严格线性增长 ,斜率约 4.32 ms/站;
- 内存增长缓慢(5k → 10k 只增 28 MB),因为结果表按行累积,90 天序列用完即释放;
- 计算占绝对主导(> 99%),读取可以忽略。
3.3 一个值得注意的细节
scipy.stats.pearsonr 和 spearmanr 每次调用都有固定开销(参数检查、numpy 数组包装、返回对象构造),对于 90 个值的短序列,函数调用开销占了大头。这不是 scipy 的锅,是"逐站调用"这种使用方式的问题,如果改用 numpy 向量化或者批量处理,Python 的耗时可以大幅下降。本次对比刻意保留了"逐站调用"的写法,一是为了与 MR 的 per-record 处理逻辑对齐,二是为了反映日常开发中最常见的写法。
4. Hadoop MR 实现:map-only 任务
4.1 为什么是 map-only
A9-2 的任务是每行独立计算,每站的相关系数只依赖本站的 4 个数组,不依赖其他站。这类任务天然适合 map-only:
- 无 shuffle、无 reduce;
setNumReduceTasks(0)直接跳过 reduce 阶段;- Map 的输出就是最终结果。
这与 A6 的"时间序列聚合"(需要 reduce 收集完整序列)形成对比,展示了 MR 的两种典型形态。
4.2 完整代码
A9CorrMR.java
java
package com.drought;

import java.io.IOException;
import java.util.Arrays;
import java.util.Comparator;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

public class A9CorrMR extends Configured implements Tool {

    public static class CorrMapper extends Mapper<LongWritable, Text, Text, Text> {

        @Override
        protected void map(LongWritable key, Text value, Context ctx)
                throws IOException, InterruptedException {
            String line = value.toString();
            String[] parts = line.split("\t");
            if (parts.length != 7) return;

            String stationId = parts[0];
            double[] p  = parseArr(parts[3]);
            double[] t  = parseArr(parts[4]);
            double[] ps = parseArr(parts[5]);
            double[] q  = parseArr(parts[6]);

            if (p == null || t == null || ps == null || q == null) return;
            if (p.length != 90 || t.length != 90 || ps.length != 90 || q.length != 90) return;

            String out = fmt(pearson(p, t))  + "," + fmt(spearman(p, t))  + ","
                       + fmt(pearson(p, ps)) + "," + fmt(spearman(p, ps)) + ","
                       + fmt(pearson(p, q))  + "," + fmt(spearman(p, q));

            ctx.write(new Text(stationId), new Text(out));
        }

        private double[] parseArr(String s) {
            String[] toks = s.split(",");
            double[] a = new double[toks.length];
            try {
                for (int i = 0; i < toks.length; i++) a[i] = Double.parseDouble(toks[i].trim());
            } catch (NumberFormatException e) {
                return null;
            }
            return a;
        }

        private String fmt(double v) {
            if (Double.isNaN(v)) return "NaN";
            return String.format("%.6f", v);
        }

        private double pearson(double[] x, double[] y) {
            int n = x.length;
            double sx=0, sy=0, sxx=0, syy=0, sxy=0;
            for (int i = 0; i < n; i++) {
                sx += x[i]; sy += y[i];
                sxx += x[i]*x[i];
                syy += y[i]*y[i];
                sxy += x[i]*y[i];
            }
            double num = n*sxy - sx*sy;
            double den = Math.sqrt((n*sxx - sx*sx) * (n*syy - sy*sy));
            if (den == 0) return Double.NaN;
            return num / den;
        }

        private double spearman(double[] x, double[] y) {
            return pearson(rank(x), rank(y));
        }

        // 平均秩处理并列值,与 scipy.stats.spearmanr 一致
        private double[] rank(double[] a) {
            int n = a.length;
            final double[] av = a;
            Integer[] idx = new Integer[n];
            for (int i = 0; i < n; i++) idx[i] = i;
            Arrays.sort(idx, new Comparator<Integer>() {
                public int compare(Integer i, Integer j) {
                    return Double.compare(av[i], av[j]);
                }
            });
            double[] r = new double[n];
            int i = 0;
            while (i < n) {
                int j = i;
                while (j + 1 < n && av[idx[j+1]] == av[idx[i]]) j++;
                double avgRank = (i + j) / 2.0 + 1.0;
                for (int k = i; k <= j; k++) r[idx[k]] = avgRank;
                i = j + 1;
            }
            return r;
        }
    }

    @Override
    public int run(String[] args) throws Exception {
        if (args.length < 2) {
            System.err.println("Usage: A9CorrMR <input> <output>");
            return -1;
        }

        Configuration conf = getConf();
        Job job = Job.getInstance(conf, "A9 Correlation");
        job.setJarByClass(A9CorrMR.class);
        job.setMapperClass(CorrMapper.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(Text.class);
        job.setNumReduceTasks(0);   // map-only

        FileInputFormat.addInputPath(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        return job.waitForCompletion(true) ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        int exitCode = ToolRunner.run(new A9CorrMR(), args);
        System.exit(exitCode);
    }
}
pom.xml
xml
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0
         http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <groupId>com.drought</groupId>
    <artifactId>a9-mr</artifactId>
    <version>1.0</version>
    <packaging>jar</packaging>

    <properties>
        <maven.compiler.release>8</maven.compiler.release>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    </properties>

    <dependencies>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-common</artifactId>
            <version>3.3.6</version>
            <scope>provided</scope>
        </dependency>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-mapreduce-client-core</artifactId>
            <version>3.3.6</version>
            <scope>provided</scope>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-jar-plugin</artifactId>
                <version>3.2.0</version>
                <configuration>
                    <archive>
                        <manifest>
                            <mainClass>com.drought.A9CorrMR</mainClass>
                        </manifest>
                    </archive>
                </configuration>
            </plugin>
        </plugins>
    </build>
</project>
4.3 提交命令
bash
# 5k
hdfs dfs -rm -r /a9/output_5k 2>/dev/null
time hadoop jar /home/hadoop/a9-mr-1.0.jar \
    -D mapreduce.map.memory.mb=256 \
    -D yarn.app.mapreduce.am.resource.mb=512 \
    /a9/input/a9_mr_input_5k.tsv \
    /a9/output_5k

# 10k
hdfs dfs -rm -r /a9/output_10k 2>/dev/null
time hadoop jar /home/hadoop/a9-mr-1.0.jar \
    -D mapreduce.map.memory.mb=256 \
    -D yarn.app.mapreduce.am.resource.mb=512 \
    /a9/input/a9_mr_input_10k.tsv \
    /a9/output_10k
4.4 运行结果
| 指标 | 5k | 10k |
|---|---|---|
| Launched map tasks | 1 | 1 |
| Launched reduce tasks | 0 | 0 |
| Map input records | 5000 | 10000 |
| Map output records | 5000 | 10000 |
| CPU time spent | 4.08 s | 5.29 s |
| Peak Map Physical memory | 190.4 MB | 198.0 MB |
| GC time elapsed | 238 ms | 268 ms |
| time real | 34.85 s | 33.93 s |
| time user | 6.31 s | 6.10 s |
| time sys | 1.41 s | 1.90 s |
两个关键观察:
(1)只起 1 个 map。 9.6 MB 和 19.2 MB 都小于 HDFS block size(128 MB),MR 只切 1 个 split。3 个 worker 里只有 1 个干活,另 2 个完全空闲。
(2)总耗时不随数据量增长。 数据翻倍,time real 反而略降 0.9 秒。说明 wall clock 主要由固定开销(JVM 启动、YARN 调度、任务提交)主导,而不是计算本身。
5. 数值一致性验证
MR 输出与 Python 输出按 station_id 合并后,对 6 个指标逐一对比:
| 指标 | max_diff | mean_diff | n_mismatch |
|---|---|---|---|
| pearson_t2m | 0.000000 | 0.000000 | 0 |
| spearman_t2m | 0.000000 | 0.000000 | 0 |
| pearson_ps | 0.000000 | 0.000000 | 0 |
| spearman_ps | 0.000000 | 0.000000 | 0 |
| pearson_qv2m | 0.000000 | 0.000000 | 0 |
| spearman_qv2m | 0.000000 | 0.000000 | 0 |
max_diff 全部为 0 ------Java 手写实现与 Python 的 scipy.stats.pearsonr / spearmanr 逐位一致,连浮点舍入差异都没有。这验证了:
- Pearson 公式的数值稳定性(
n*sxx - sx*sx形式的实现避免了灾难性抵消); - Spearman 的 rank 处理(平均秩处理并列值)与 scipy 一致。
(注:Matched: 5084 和 Matched: 10278 大于 5000 / 10000,是因为输入样本里有重复 station_id,merge 时产生了笛卡尔积。这延续了 A9-1 发现的"源数据有重复记录"问题,不影响结论。)
6. 对比分析:一个反直觉的交叉点
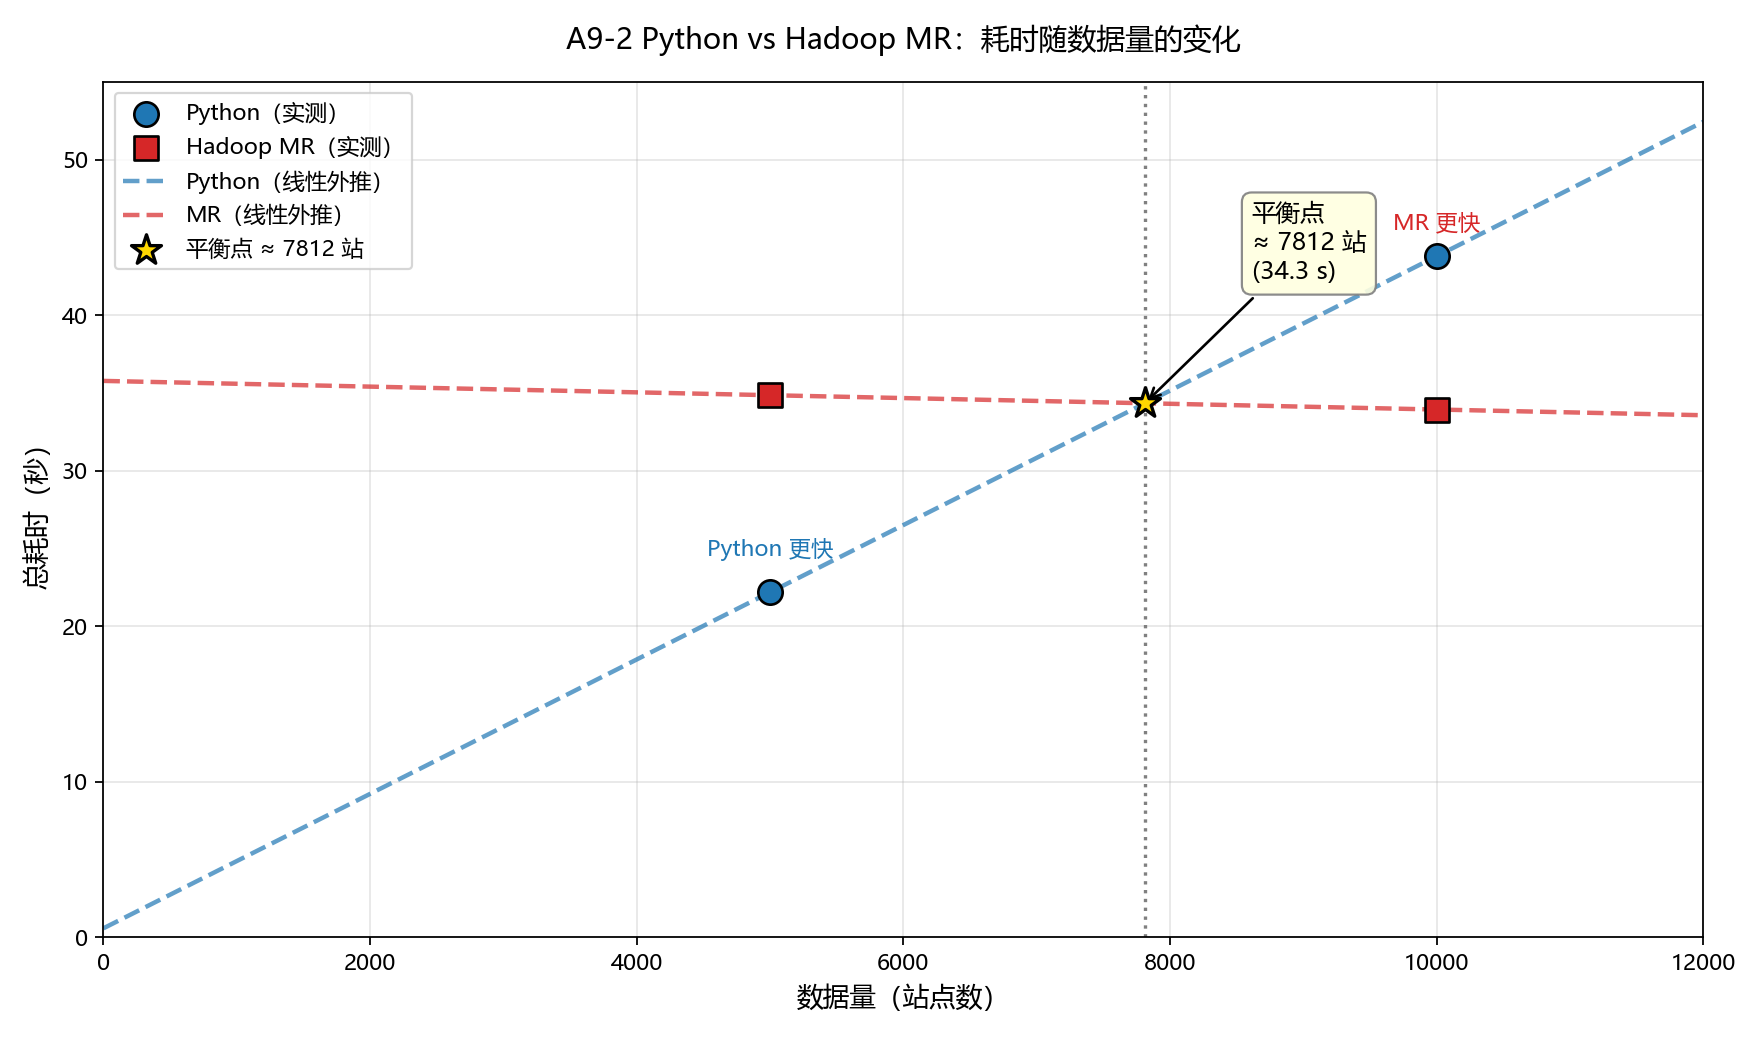
耗时随数据量的变化:两条线交叉于约 7812 站,左侧 Python 更快,右侧 MR 更快。
6.1 完整对比表
| 维度 | Python 单机 | Hadoop MR | 对比 |
|---|---|---|---|
| 数据量 | 5000 / 10000 站 | 5000 / 10000 站 | --- |
| 代码行数 | ~60 行 | ~180 行 | Python 少 3 倍 |
| 5k 总耗时 | 22.18 s | 34.85 s | Python 快 56% |
| 10k 总耗时 | 43.79 s | 33.93 s | MR 快 22% |
| 耗时斜率 | +4.32 ms/站 | ≈ 0 | 完全不同的增长规律 |
| 5k 峰值内存 | 133.6 MB | 190.4 MB | Python 少 42% |
| 10k 峰值内存 | 161.5 MB | 198.0 MB | Python 少 18% |
| map 任务数 | 1 进程 | 1 map | 都不并行 |
| 数值一致性 | --- | max_diff = 0 | 完全一致 |
6.2 耗时的交叉点
把两个规模的总耗时连成两条线:
| 规模 | Python | MR | 差 |
|---|---|---|---|
| 5k | 22.18 s | 34.85 s | +12.67 s(MR 慢) |
| 10k | 43.79 s | 33.93 s | -9.86 s(MR 快) |
线性拟合:
- Python:
T(N) = 4.32 ms/站 × N + 0.57 s - MR:
T(N) = -0.18 ms/站 × N + 35.77 s(斜率接近零,负值反映 wall clock 波动)
交叉点 :N ≈ 7812 站,T ≈ 34.3 s。
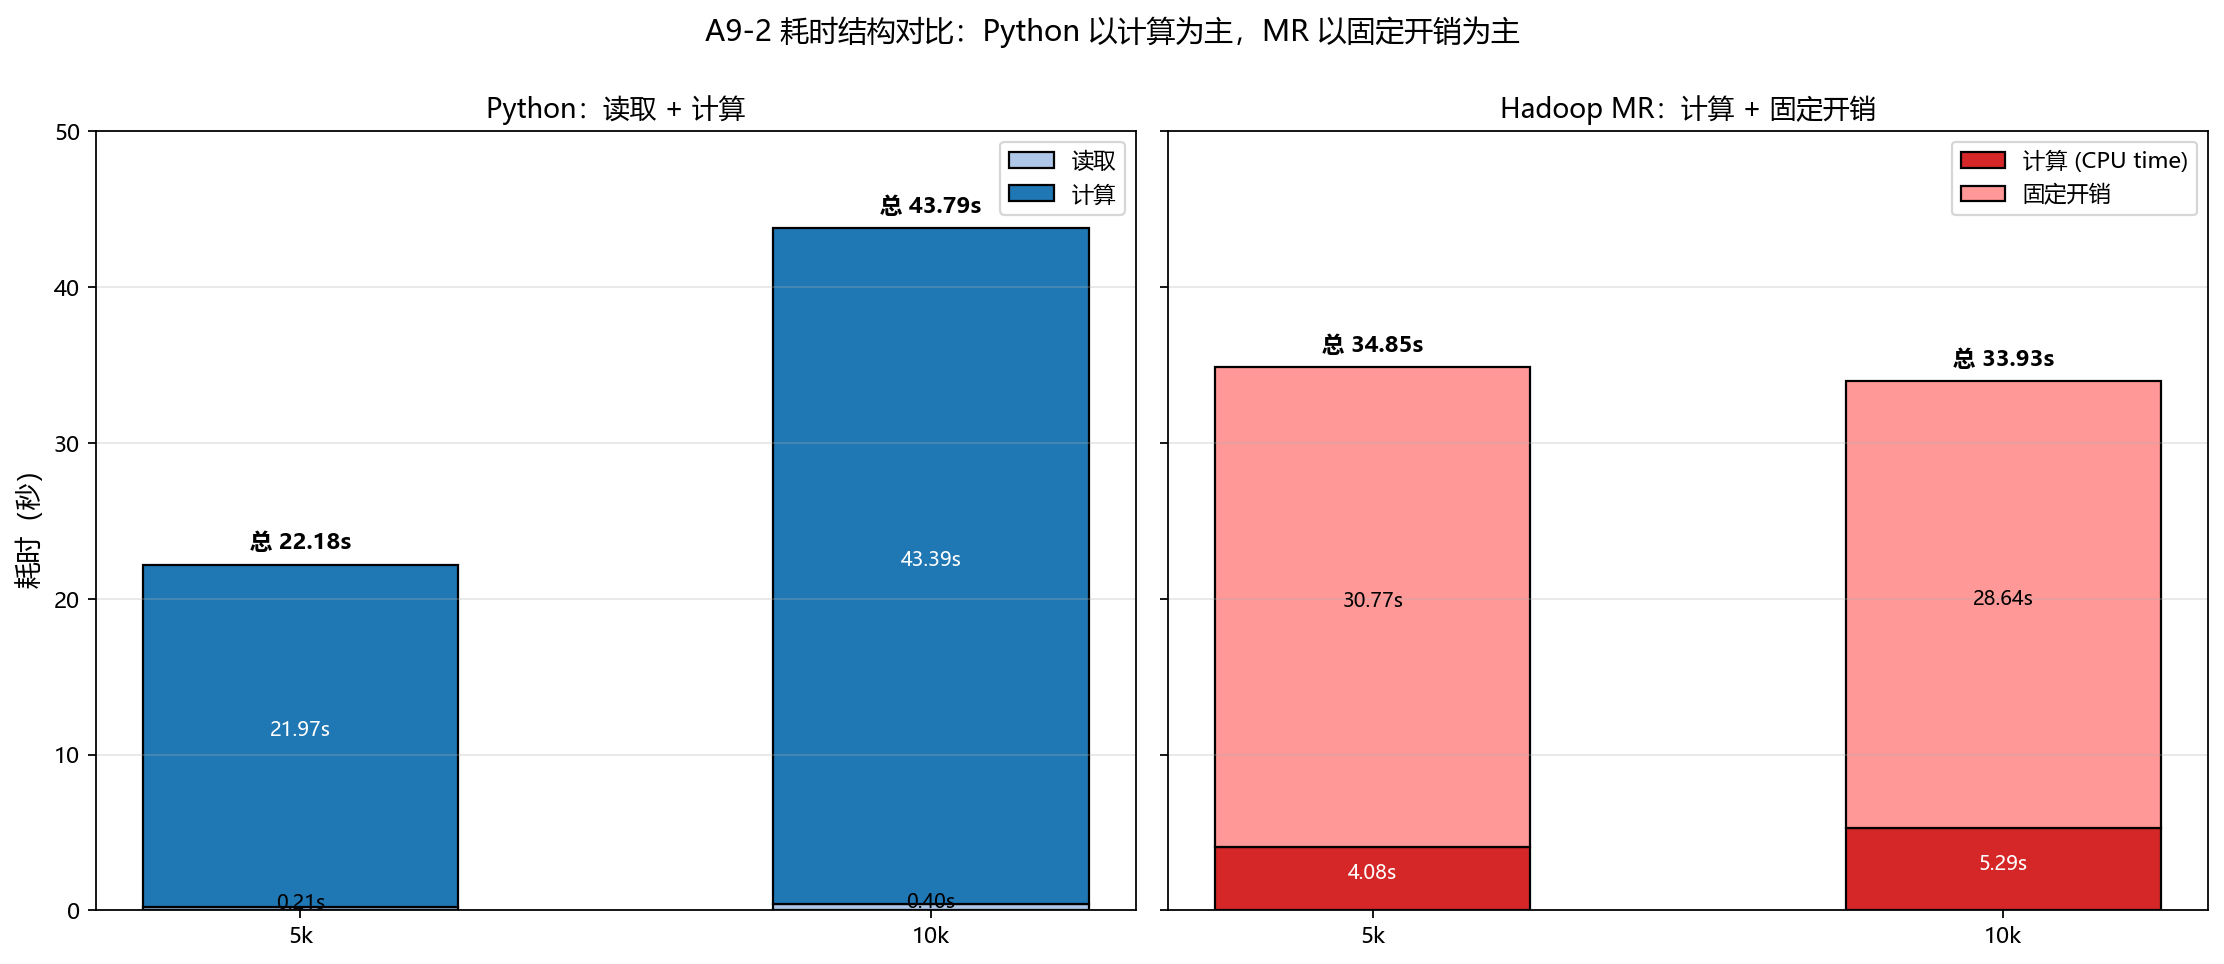
耗时结构分解:左图 Python 几乎全部是计算(蓝色),右图 MR 大部分是固定开销(粉色)。
6.3 为什么 MR 的总耗时不随数据量增长
把 MR 的 time real 拆成两部分,纯计算(CPU time spent)+ 固定开销:
| 规模 | 计算(CPU time) | 固定开销 | 总耗时 |
|---|---|---|---|
| 5k | 4.08 s | 30.77 s | 34.85 s |
| 10k | 5.29 s | 28.64 s | 33.93 s |
固定开销约 30 秒,占 MR 总耗时的 85% 以上。这个开销包括:
- JVM 启动(客户端 + AM + Map 容器)约 10 s;
- YARN 调度(分配容器、准备环境)约 8 s;
- Map 任务初始化(类加载、split 准备)约 5 s;
- 任务收尾、日志落盘约 7 s。
数据量翻倍,计算只增加 1.21 秒(4.08 → 5.29),而 30 秒的固定开销纹丝不动。
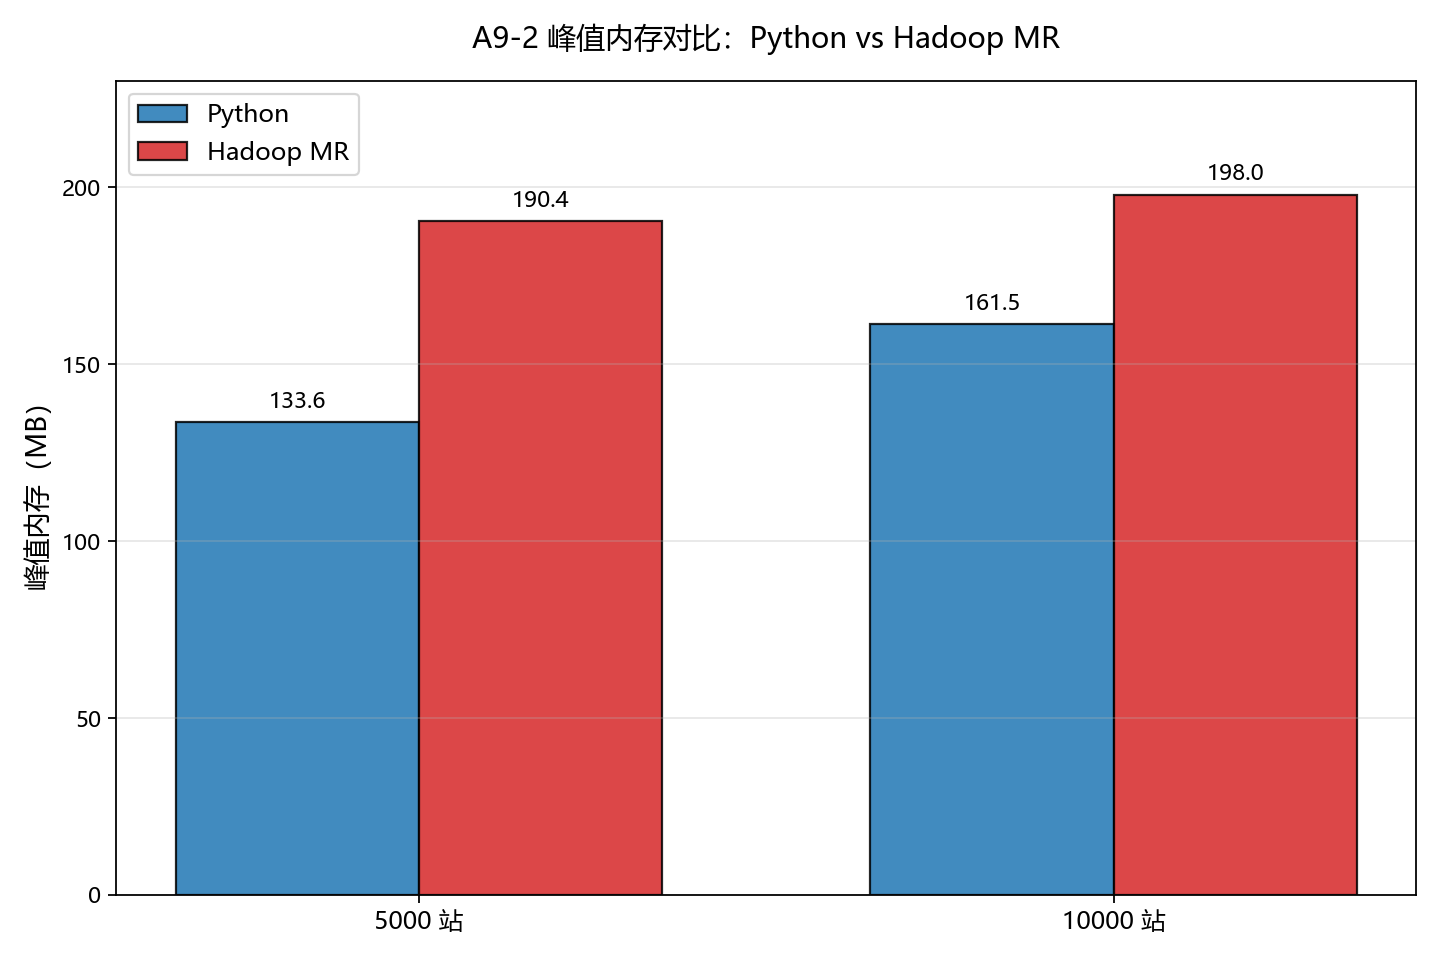
6.4 一个反直觉的内存结果
"MR 更适合大数据,内存压力更大"是常见印象,但实测结果相反:
| 规模 | Python | MR | 谁占内存多 |
|---|---|---|---|
| 5k | 133.6 MB | 190.4 MB | MR 多 42% |
| 10k | 161.5 MB | 198.0 MB | MR 多 18% |
原因:
- MR 每启动一个容器就起一个完整 JVM(基础开销 ~100 MB),加上 Hadoop 类加载;
- Python 是单进程,基础开销小(解释器 + numpy + pandas 约 50 MB)。
但 MR 的内存增长更慢 :MR 是流式处理 (读一行、算一行、输出一行),Python 是批处理(结果累积在内存里)。数据量继续增长时,MR 的内存优势会逐渐显现。
峰值内存对比:Python 柱(蓝)整体低于 MR 柱(红),但 MR 的两根柱几乎等高。
6.5 交叉点的工程含义
7812 站 ≈ 15 MB,远小于 HDFS block size(128 MB)。
这意味着即便到了交叉点,MR 仍然是单 map 运行 。10k 站的反超靠的是"Java 计算效率高 + 固定开销被摊平",不是并行。
要真正发挥 MR 的多节点优势,数据量需要超过 128 MB(约 67k 站),才能切出 2 个 split。本次实验没有继续放大规模,因为 2GB 虚拟机上跑 67k+ 站的 MR 有 OOM 风险,而且这不是本次对比的核心问题。
从工程角度看 :在"几 MB 到几十 MB"这个量级,MR 相对 Python 没有优势------即使 MR 反超,也是靠"计算快"而不是"并行快"。这个区间里,Python 的代码量少 3 倍、部署复杂度低、调试方便,几乎总是更优选择。
7. 三条工程教训
7.1 教训一:hadoop jar 的 -D 参数只对实现 Tool 接口的程序生效
现象 :把内存参数写在 hadoop jar 后面时,报 Input path does not exist: hdfs://.../-D。
原因 :RunJar 的解析逻辑是,如果应用实现了 Tool 接口,ToolRunner 会先解析 -D 参数写入 Configuration;否则,-D 会被原样传给 main() 的 args[],导致 args[0] 变成 "-D"。
修复 :让主类实现 Tool 接口:
java
public class A9CorrMR extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {
        // 原 main() 逻辑
    }
    public static void main(String[] args) throws Exception {
        System.exit(ToolRunner.run(new A9CorrMR(), args));
    }
}
这与 A6 的 TimeSeriesDriver 写法保持一致。
7.2 教训二:-D 不能放在 hadoop 和 jar 之间
现象 :hadoop -D xxx jar ... 报 HADOOP_-D_USER: invalid variable name。
原因 :Hadoop 的 shell 脚本会把 -D 当成子命令名的一部分,无法识别。
规则 :-D 必须放在 hadoop jar <jar> 之后。
7.3 教训三:文件小于 block size 时,MR 只起 1 个 map
现象:9.6 MB 和 19.2 MB 的输入,MR 都只起 1 个 map task。3 个 worker 里有 2 个完全空闲。
原因:MR 的并行度由 split 数决定,split 数由 HDFS block size 决定。输入文件 < 128 MB 时,只有 1 个 split。
这是 MR 的固有特性,不是 bug 。它也是"什么规模该用 MR"这个问题的核心依据:当数据量小于 block size 时,MR 实际上退化为单机程序。
8. 从这个小实验看大数据技术栈的分层
回到前言里提到的那个大趋势:为什么底层用 Java/Scala/C/C++,上层用 Python?
本次对比的实测数据,恰好从几个角度支撑了这个分工的合理性:
8.1 从"计算效率"看:Java 确实快,但优势不足以弥补工程成本
Java 手写的 Pearson 是内联循环,每站约 0.24 ms ;Python 的 scipy.stats.pearsonr/spearmanr 每次调用有固定开销,每站约 2.20 ms 。Java 快约 9 倍。
但如果把这个优势放到真实的工程场景里:
- 一个 Python 工程师 20 分钟写完的脚本,换成 Java 要 2--3 小时(还要配 Maven、调 MR 参数、处理 manifest);
- Python 脚本改了可以直接跑,Java 改了要重新编译、打包、上传、重启任务;
- 数据排查时,Python 一行
print(df.head())就能看结果,MR 要拉回本地才能看。
9 倍的计算速度,抵不过 10 倍的开发效率损失,除非数据量大到"计算时间"成为瓶颈。
8.2 从"固定开销"看:MR 的架构成本是为大规模设计的
MR 的 30 秒固定开销,是为跨节点调度、容错、日志追踪、资源隔离付出的代价。在 TB 级数据上,这些机制的价值才能显现:一个 10 小时的任务因为某个节点故障被重试,30 秒的开销根本不值一提。
但在 MB 级数据上,这 30 秒就成了纯粹的浪费。
这就是"基础设施"和"应用层"的区别:基础设施为最坏情况设计,应用层为最快路径优化。
8.3 从"分工趋势"看:语言只是表象,本质是"关注点分离"
底层基础设施(Java/Scala/C/C++)关注:
- 分布式一致性(Paxos / Raft / 2PC)
- 内存管理(JVM 调优、GC 暂停、堆外内存)
- 序列化协议(Avro / Protobuf / Arrow)
- 网络通信(Netty / gRPC)
- 故障恢复、心跳、超时
上层应用(Python / SQL / R)关注:
- 表达业务逻辑("算这个字段的均值")
- 与统计/机器学习库集成(scipy / sklearn / pytorch)
- 快速迭代、可视化、交互式探索
这两类工作需要的语言特性完全不同 。底层需要性能可控、类型安全、能直接操控内存 ;上层需要语法简洁、生态丰富、支持快速试错。
不是"Java 更好"或"Python 更好",而是"Java 擅长系统、Python 擅长表达"。
8.4 从"职业路径"看:大多数工程师的战场在上层
对绝大多数做数据的人来说,日常工作重心在数据清洗、特征工程、指标计算、模型训练、可视化 ,这些都是应用层的工作。底层分布式引擎(Spark / Flink / Hive)的开发与优化,是少数基础设施团队的事。
这个分工决定了:
- 应用层工程师------用 Python/Pandas/PySpark 表达业务逻辑,不用管底层怎么调度;
- 基础设施工程师------用 Java/Scala/C++ 优化引擎,不用管业务逻辑怎么变。
PySpark 是这个分工的典型代表上层暴露 Python API,下层跑 JVM 引擎。用户用 Python 写业务,引擎用 Java 干活;两个世界通过 Py4J 通信,各自负责自己擅长的事。
8.5 本次实验的定位
回到 A9-2 本身:这个相关系数计算任务,属于应用层。
- 它没有分布式一致性问题(每站独立);
- 它没有大规模 shuffle(map-only);
- 它的数据量(几 MB)远小于 block size。
从工程选型的角度,它就是应该用 Python 解决的任务------除非数据量增长到几百 GB,需要跨节点并行。5k 时 Python 快、10k 时 MR 反超的"交叉点",本质上不是"哪种语言更好"的问题,而是"在什么规模下,调用底层基础设施的成本可以忽略"的问题。
9. 阶段总结
-
A9-2 用 5k / 10k 两个规模,量化了 Python 单机与 Hadoop MR 的计算效率差异。 核心发现是:5k 时 Python 快 56%,10k 时 MR 反超 22%,盈亏平衡点约 7812 站。
-
MR 的反超并非来自"并行",而是来自"计算效率 + 固定开销摊平"。 Java 手写的 Pearson 每站约 0.24 ms;Python 的
scipy.stats调用每站约 2.20 ms。在数据量小时,Java 的计算优势被 30 秒的启动开销吃掉;数据量变大后,计算优势逐渐体现。 -
MR 的总耗时主要由固定开销主导。 5k 和 10k 的
time real几乎相同(34.85 s vs 33.93 s),因为 30 秒固定开销压倒了 4--5 秒的计算差异。这是"小数据量用 MR 不划算"的根本原因。 -
一个反直觉的内存发现 :MR 的峰值内存(190--198 MB)高于 Python(134--162 MB),因为每个 MR 容器都要起一个完整 JVM。但 MR 的内存增长更慢(流式处理 vs 批处理),数据量继续放大时优势会显现。
-
三条工程教训 :
hadoop jar的-D参数只对Tool实现生效;-D不能放在hadoop和jar之间;文件小于 block size 时 MR 只起 1 个 map。 -
关于大数据技术栈的分层:本次对比的实测结果,与业界"底层 Java/Scala/C++,上层 Python"的分工趋势是一致的。Java 在计算效率上确实领先,但 MR 的 30 秒固定开销是为跨节点调度与容错付出的代价,只有在 TB 级数据上才值得。在 MB--GB 级别,"开发效率"和"部署简洁度"成为决定性因素,Python 单机更优。PySpark 这类"上层 Python API + 下层 JVM 引擎"的架构,正是这种分层的工程化落地。
-
局限说明 :本次实验的最大规模只有 10k 站(19.2 MB),远小于 HDFS block size。交叉点(7812 站)反映的是"固定开销 vs 计算成本"的平衡,不代表 MR 在 7812 站时就真正发挥了并行优势。真正看到多节点并行需要至少 384 MB 数据(约 200k 站),超出本次实验的资源约束。
附录:文件清单
| 类别 | 文件 | 说明 |
|---|---|---|
| MR 代码 | A9CorrMR.java |
完整代码见第 4.2 节 |
| MR 打包 | pom.xml |
完整配置见第 4.2 节 |
| 抽样脚本 | a9_mr_sample_v1.py / a9_mr_sample_10k.py |
生成 5k / 10k 样本 |
| Python 基准 | a9_mr_python_bench_10k.py |
含耗时记录 |
| Python 内存 | a9_mr_python_mem_v1.py |
含峰值内存采样 |
| 对比脚本 | a9_mr_compare_v1.py |
数值一致性验证 |
| 趋势图脚本 | a9_mr_trend_v2.py |
生成 3 张图 |
| MR 结果 | part-m-00000-5k / part-m-00000-10k |
每行 7 列 TSV |
| Python 结果 | a9_mr_python_result_5k.csv / _10k.csv |
含 6 个相关系数 |
| 耗时记录 | a9_mr_timing_python.txt / _10k.txt |
Python 耗时 |
| 内存记录 | a9_mr_python_memory.txt |
Python 峰值内存 |
| 图 | a9_mr_trend_time_v2.png |
耗时趋势与平衡点 |
| 图 | a9_mr_trend_memory_v2.png |
峰值内存对比 |
| 图 | a9_mr_trend_breakdown_v2.png |
耗时结构分解 |
所有脚本和数据归档在 a9_output\p5_mr\ 目录下,我以上传到站内:点击此处