摘要:生产环境接口变慢、机器负载高,但瓶颈究竟在 CPU、内存还是 IO?本文把 perf(采样剖析)、strace(系统调用追踪)与火焰图(可视化)串成一套可复用的排查方法论:先粗判方向,再选工具,读图定位根因,最后避开开销与权限陷阱。所有命令均可直接复现。
导语
"服务又变慢了,但 CPU 没满啊?"------这是后端和运维同学最常被问到、也最难一句话答清的问题。
top 里 %CPU 不高,不代表没有性能问题:延迟可能耗在等磁盘 IO、耗在被换页的内存压力上,也可能耗在某个卡住的网络 connect 上,而这部分时间根本不体现在 CPU 占用里。方向判错,后面再怎么调优都是白做。
本文不堆概念,聚焦一个目标:当系统"慢"下来,如何用 perf、strace 和火焰图,在最短时间内把瓶颈钉死在 CPU、内存还是 IO 上。文中所有命令都来自一手工具手册(strace(1)、perf_event_open(2)、内核 perf-security 文档),可放心复现。
一、背景:为什么需要 perf、strace 与火焰图
生产排障的真实困境:"慢"不等于"CPU 满"
一个接口 P99 从 50ms 涨到 800ms,登上去 top 一看:%CPU 可能只有 30%,iowait(IO 等待)却飙到 40%;或者 CPU 看着正常,但 free -h 显示可用内存被吃光、开始 swap。三种典型瓶颈表现完全不同:
- CPU 饱和:用户态或内核态占满 CPU,热点函数需要被定位;
- 内存压力:缺页风暴、缓存未命中率偏高、swap 换入换出;
- IO 阻塞 :磁盘读写等待、或进程卡在某个网络/文件
syscall。
三者解法完全不同,所以第一步永远是"定方向",而不是上来就盲调。
三大工具的分工边界
+----------------+    +----------------+    +------------------+
|     perf       |    |    strace      |    |    火焰图        |
+----------------+    +----------------+    +------------------+
| 基于 PMU 的    |    | 系统调用级    |    | 把 perf 采样     |
| 采样剖析       |    | 追踪          |    | 结果可视化       |
| 定位 CPU 热点  |    | 看进程卡在    |    | 调用栈耗费       |
| 与内核态开销   |    | 哪个 syscall  |    | 一目了然         |
| (on-CPU)      |    | (IO/锁/信号)  |    |                  |
+----------------+ +----------------+ +------------------+- perf :基于 Linux
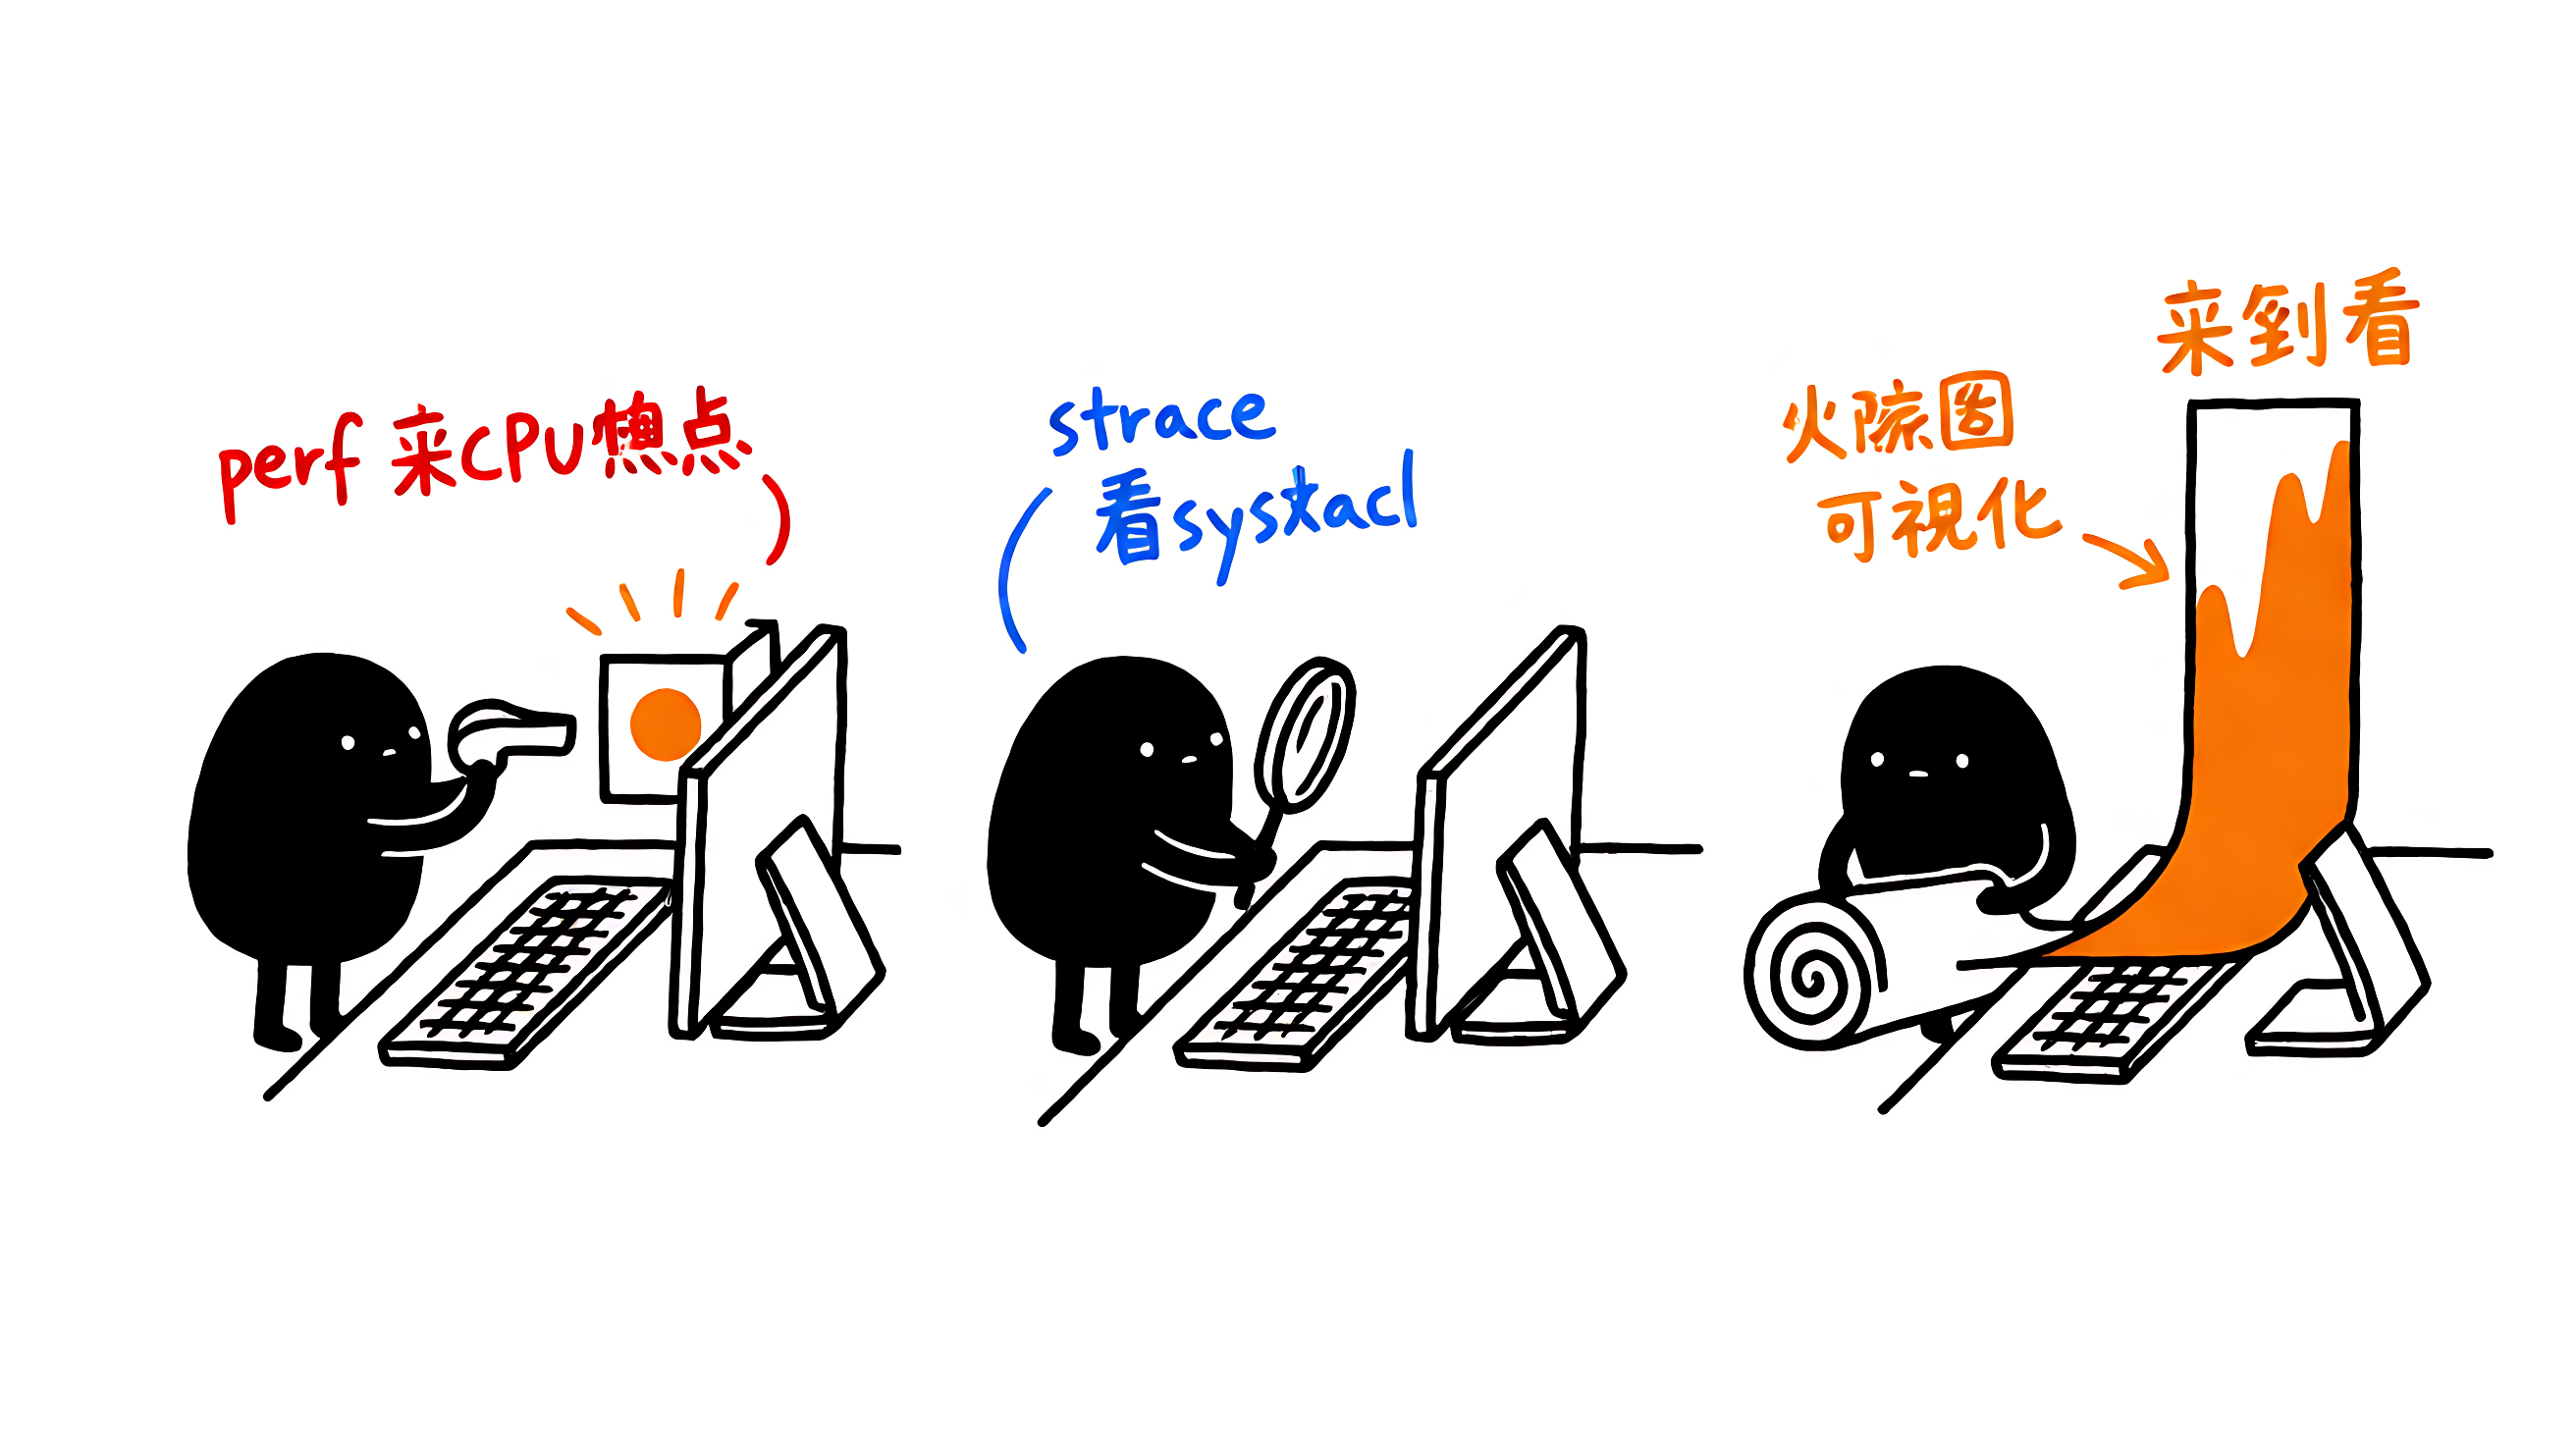
perf_events性能监控子系统,通过 PMU 硬件计数器与软件事件做采样,擅长定位 CPU 热点与内核态开销(on-CPU 时间)。 - strace:系统调用级追踪,擅长看进程"卡在哪个 syscall"------文件 IO、网络 IO、锁、信号都能看到。
- 火焰图:本身不是采集工具,而是把 perf 的采样结果可视化,直观看出"时间花在哪个调用栈"。
三者关系是:perf / strace 负责"采",火焰图负责"看"。
本文阅读路径与读者画像
面向后端开发、运维与 SRE。建议先通读第二节把工具链装好,再按"CPU→内存→IO"顺序理解三类瓶颈的打法,最后用第六节的综合实战串成完整排查剧本。
二、工具链总览与准备
工具来源与版本约束
perf 随 linux-tools 提供,最好与运行内核版本一致 ,否则部分硬件事件可能不可用(这是内核 perf-security 文档明确提到的行为约束)。strace 是独立软件包;火焰图由 FlameGraph 脚本集(perf script 的下游工具)生成。
安装思路(注意版本匹配):
bash
# Debian/Ubuntu:perf 版本需与当前内核对应
apt install -y linux-tools-common linux-tools-$(uname -r) strace

# 校验版本
perf --version
strace -V
uname -r
获取 FlameGraph 脚本集(Brendan Gregg 维护的 stackcollapse-perf.pl 与 flamegraph.pl)后,把脚本目录加入 PATH,后续即可直接调用。
端到端数据流
perf record  (采样,产出 perf.data)
     |
     v
perf script  (导出带调用栈的事件流)
     |
     v
stackcollapse-perf.pl  (折叠相同调用栈,产出 folded 文本)
     |
     v
flamegraph.pl  (生成 SVG)
     |
     v
perf.svg  (火焰图,浏览器打开)
整条链路是"采样 → 导出 → 折叠 → 渲染",每一环产物都明确,排查时哪一步缺了产物一眼能看出来。
容器 / 虚拟化注意点
perf 在容器内需 CAP_PERFMON 或特权,否则多数事件会被内核拒绝;strace 同样受 ptrace 权限限制。在 K8s 等环境里,先确认 Pod 的 securityContext 是否放开相关能力,再决定能否直接 attach。
三、perf 采样原理与 CPU 瓶颈定位
perf 采样原理(一手来源:perf_event_open(2))
perf 基于 Linux perf_events 子系统工作,既支持硬件事件(PMU 计数器,如 CPU cycles),也支持软件事件(如上下文切换、缺页)。
采样的核心机制:通过 sample_period(每 N 个事件采样一次)或 sample_freq(每秒采样次数)控制频率。计数器溢出时,内核把一条样本写入 mmap 环形缓冲区(ring buffer),再经 perf 用户态解析。这就是为什么采样对目标进程侵入小------它只是"周期性记账",而非逐条拦截。
CPU 热点定位标准动作
最常用的采集命令:
bash
# -F 99:每秒采样 99 次(99 Hz 是社区惯例频率,平衡开销与精度)
# -a:系统范围  -g:记录调用栈  -- sleep 30:采样 30 秒
perf record -F 99 -ag -- sleep 30

# 针对某个进程
perf record -F 99 -p $PID -g -- sleep 30

# 交互式查看热点
perf report

# 实时看热点函数
perf top -p $PID

# 看宏观计数器
perf stat -e cycles,instructions,cache-misses -p $PID -- sleep 10
-F 99 而非整百(如 100),是社区为了避免与某些周期性任务"对齐共振"而约定俗成的频率,既能覆盖热点又不会放大自身开销。
如何读 CPU 火焰图
把第三节的采样直接生成火焰图:
bash
perf script | stackcollapse-perf.pl | flamegraph.pl > cpu.svg火焰图的读法:
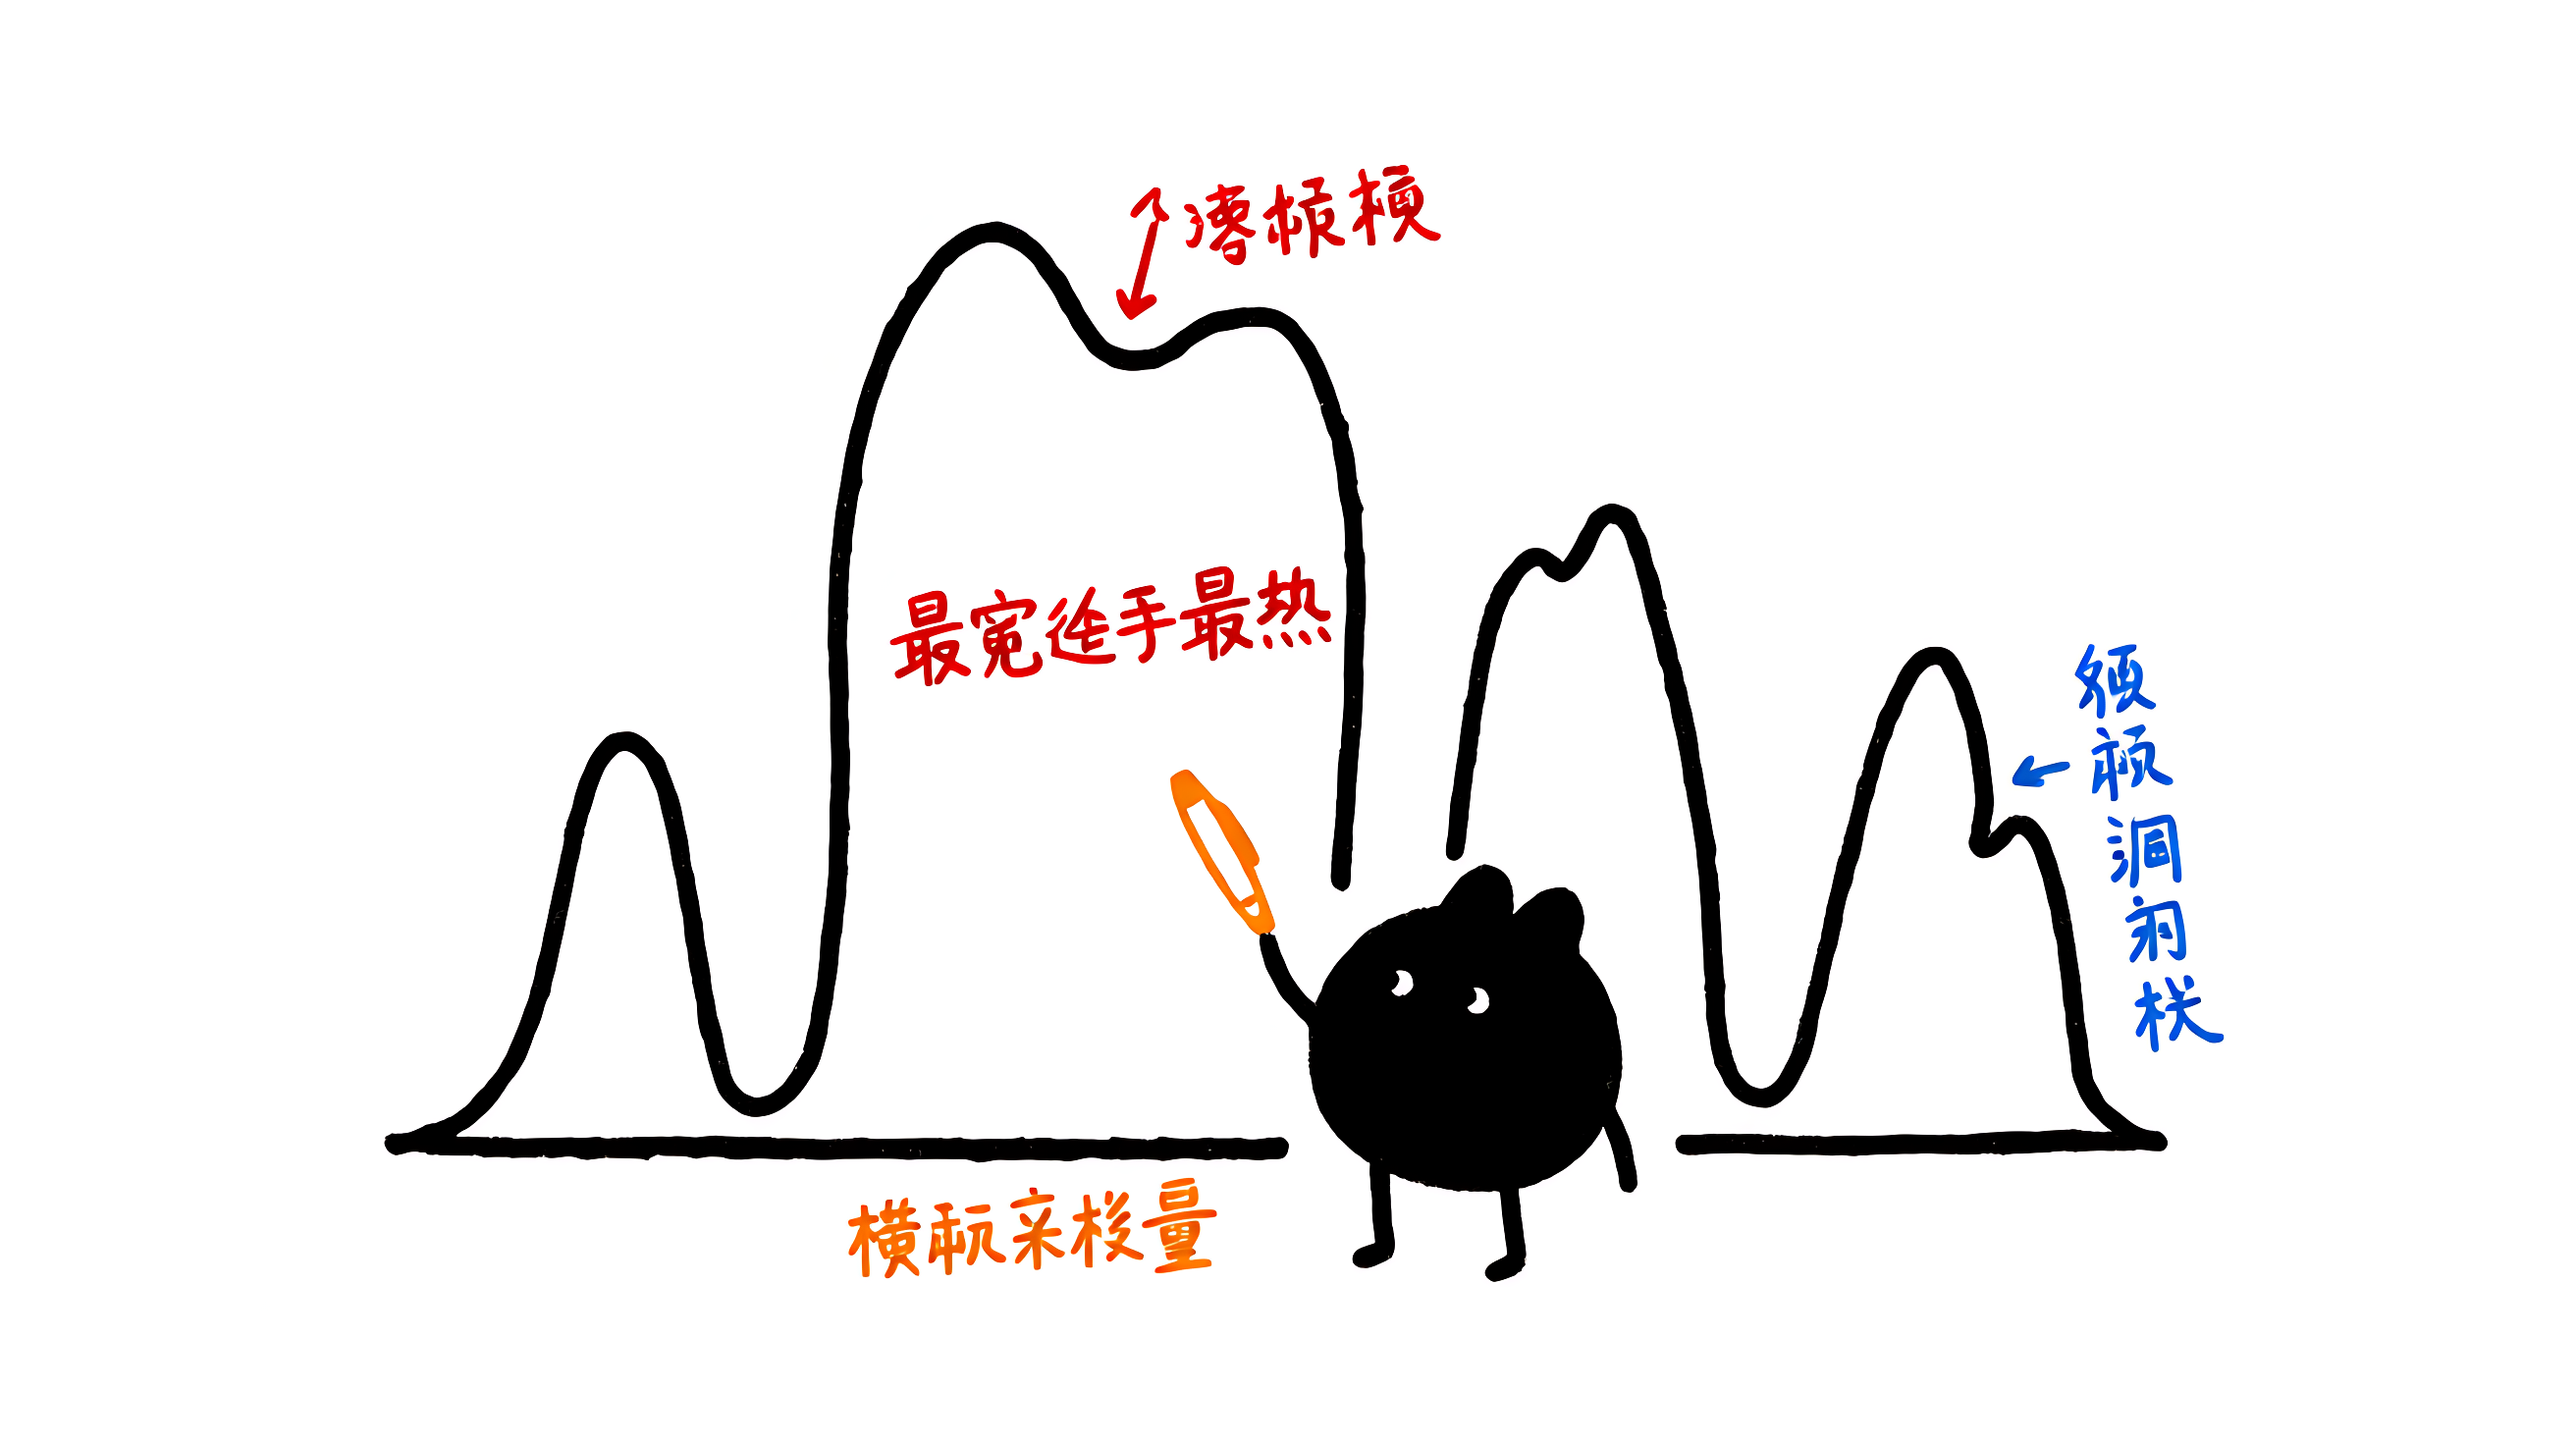
- 横轴是采样总量(不是时间顺序),越宽代表占用 CPU 越多;
- 纵轴是调用栈深度,从下往上是函数调用链;
- 最宽的那个栈就是最耗 CPU 的路径,优先从这里下手优化。
验证要点
- 采样时间要覆盖业务高峰,偶发抖动采样不到会误判;
-F过高(如 999)开销大,还可能因 perf 自身占用污染结果,惯例用 99。
四、内存瓶颈定位
内存类瓶颈的常见形态
内存问题不像 CPU 那样直接"满",常见有:缺页风暴(major/minor faults 过多)、缓存未命中率高、swap 换入换出、以及 RSS 持续增长(疑似内存泄漏)。
用 perf 看内存相关事件(一手:perf_events 事件)
perf 可以直接量化内存与缓存行为:
bash
# 量化缓存与缺页
perf stat -e cache-misses,cache-references,page-faults,minor-faults,major-faults \
  -p $PID -- sleep 10

# 定位是谁在触发缺页(分配热点)
perf record -e page-faults -ag -p $PID -- sleep 10major-faults(需要从磁盘换入的缺页)显著偏高,往往意味着内存压力已经逼出了 IO;cache-misses 高则说明热点数据没留在 CPU 缓存里。
配合系统级观测
bash
free -h && vmstat 1 5
cat /proc/meminfo
vmstat 的 si/so(swap 换入换出)和 free 的 available 列,能快速判断整机是否进入内存紧张状态;结合某进程 RSS 的增长趋势,可辅助判断是否存在泄漏。
说明边界
深度内存泄漏分析通常需要堆剖析工具(如 jemalloc 的 jeprof、Valgrind 等),它们不在本文 perf/strace 主线上,点到为止。
五、IO 瓶颈定位
IO 瓶颈的两种表现
一是磁盘 IO 等待(iowait 高),二是进程在 read/write/open 等 syscall 上阻塞;网络 IO 阻塞也归在这一类。单看 top 的 %CPU 是发现不了这类问题的。
strace 系统调用追踪(一手来源:strace(1))
strace 跟踪进程的系统调用与信号,关键选项:
-c:汇总统计每个系统调用的次数、耗时与错误数,并抑制逐条输出;-T:显示每次系统调用的耗时(默认微秒精度);-tt:每行输出带微秒精度的绝对时间戳;-e trace=file,network:只跟踪"带文件名的调用"和"网络相关调用";-p PID:附加到已运行进程;-f:跟踪由fork/vfork/clone创建的子进程(多线程进程下会附加到所有线程)。
定位"卡在哪个调用"
bash
# 逐条看耗时,聚焦文件与网络调用
strace -Ttt -e trace=file,network -f -p $PID

# 汇总统计算法更快定位热点调用
strace -c -f -p $PID -- sleep 5
-T 标出的高耗时 read/write/connect 就是阻塞点:比如某 connect 每次都要几百毫秒,问题大概率在网络或下游服务,而不是本机 CPU。
系统级 IO 观测联动
bash
iostat -x 1 && pidstat -d 1iostat -x 看磁盘吞吐与 await(IO 平均等待),pidstat -d 看每进程 IO,与 strace 的结论相互印证,避免被单一工具误导。
六、综合实战:一次"接口变慢"的端到端排查
场景设定
某在线接口 P99 时延突增,目标是在 30 分钟内给出根因方向(改代码 / 调参数 / 扩容)。
排查决策树
1. top / mpstat 看 CPU 是否饱和、iowait 是否高        --> 定方向
2. CPU 方向: perf top / perf record 抓热点,或出火焰图
3. syscall 可疑: strace -T 看是否卡在文件/网络调用
4. 内存疑点: perf stat 看 cache/page-fault,结合 free/vmstat
5. 汇总证据 --> 给出 改代码 / 调参数 / 扩容 结论
串联命令示例
把前面各段命令按决策树顺序组合成一次完整排查:
bash
# 1) 定方向
top -b -n 1 | head -20
mpstat 1 3

# 2) CPU 热点 + 火焰图
perf record -F 99 -ag -p $PID -- sleep 20
perf script | stackcollapse-perf.pl | flamegraph.pl > cpu.svg

# 3) syscall 层
strace -Ttt -e trace=file,network -f -p $PID -- sleep 5

# 4) 内存 / 缓存
perf stat -e cache-misses,page-faults -p $PID -- sleep 10
free -h && vmstat 1 5
实战中典型结论:火焰图最宽栈是某个序列化函数 → 改代码优化;strace 显示 connect 高耗时 → 排查下游/网络;vmstat 的 si/so 不为 0 → 加内存或查泄漏。
七、避坑与最佳实践
性能开销红线
- strace 通过 ptrace 显著拖慢目标进程 ,生产环境慎用、避免长时间 attach;统计优先用
-c而非逐条跟踪,拿完数据立刻退出。 - perf 采样频率并非越高越好 。
-F 99是惯例;过高会放大自身开销、干扰结果,甚至在高频率下影响业务吞吐。
火焰图读图陷阱
on-CPU 火焰图只能看"在 CPU 上"的时间 。如果进程实际卡在 IO 或锁(off-CPU 等待),它在 CPU 上几乎不占时间,火焰图会"看起来很干净",让你误以为没有瓶颈。这类场景需要 off-CPU 火焰图(基于 perf sched 延迟事件或 eBPF 工具),否则会漏判。
环境约束
bash
# 检查 perf 权限是否受限
cat /proc/sys/kernel/perf_event_paranoid
# 权限检查
perf stat -a -- sleep 1
perf_event_paranoid 取值越高限制越严:内核文档定义 -1 无限制,>=0 允许整机+进程(排除原始 tracepoint),>=1 仅进程级,>=2 仅"本进程、用户态"采样(看不到内核态与整机数据)。常见发行版默认 2~4,此时普通用户只能做受限的 per-process 用户态采样,需要内核态或整机数据就得 CAP_PERFMON / CAP_SYS_ADMIN。
此外,采样要覆盖真实业务高峰,避免把偶发抖动当成稳定根因。
可复用检查清单
方向判定 --> 工具选择 --> 采样时长 --> 读图 --> 交叉验证 --> 结论
   CPU?       perf       覆盖高峰    最宽栈     iostat/     改代码/
   内存?      strace      不盲调     高耗时      vmstat/     调参数/
   IO?                  频率适度     syscall     free       扩容
总结
排查"慢"的核心不是工具多熟,而是先定方向、再选工具、读图定位、交叉验证 这条链路是否走稳:CPU 热点交给 perf + 火焰图,syscall 阻塞交给 strace,内存与 IO 用 perf 事件叠加 free/vmstat/iostat 互相印证。把本文的命令与决策树收进自己的排查剧本,下次告警来了就能少绕弯路。
参考资料
- strace(1) --- Linux manual page:https://man7.org/linux/man-pages/man1/strace.1.html
- Perf events and tool security --- The Linux Kernel documentation:https://www.kernel.org/doc/html/latest/admin-guide/perf-security.html
- perf 与火焰图生成流程实操(CSDN):https://blog.csdn.net/m0_37749564/article/details/132246865
© 2026 | 转载请注明出处
结论:PASS