GESP C++ 六级编程题第二题:《分树规划》------用 DFS 给一棵树做一次公平分配!
今天的任务是:
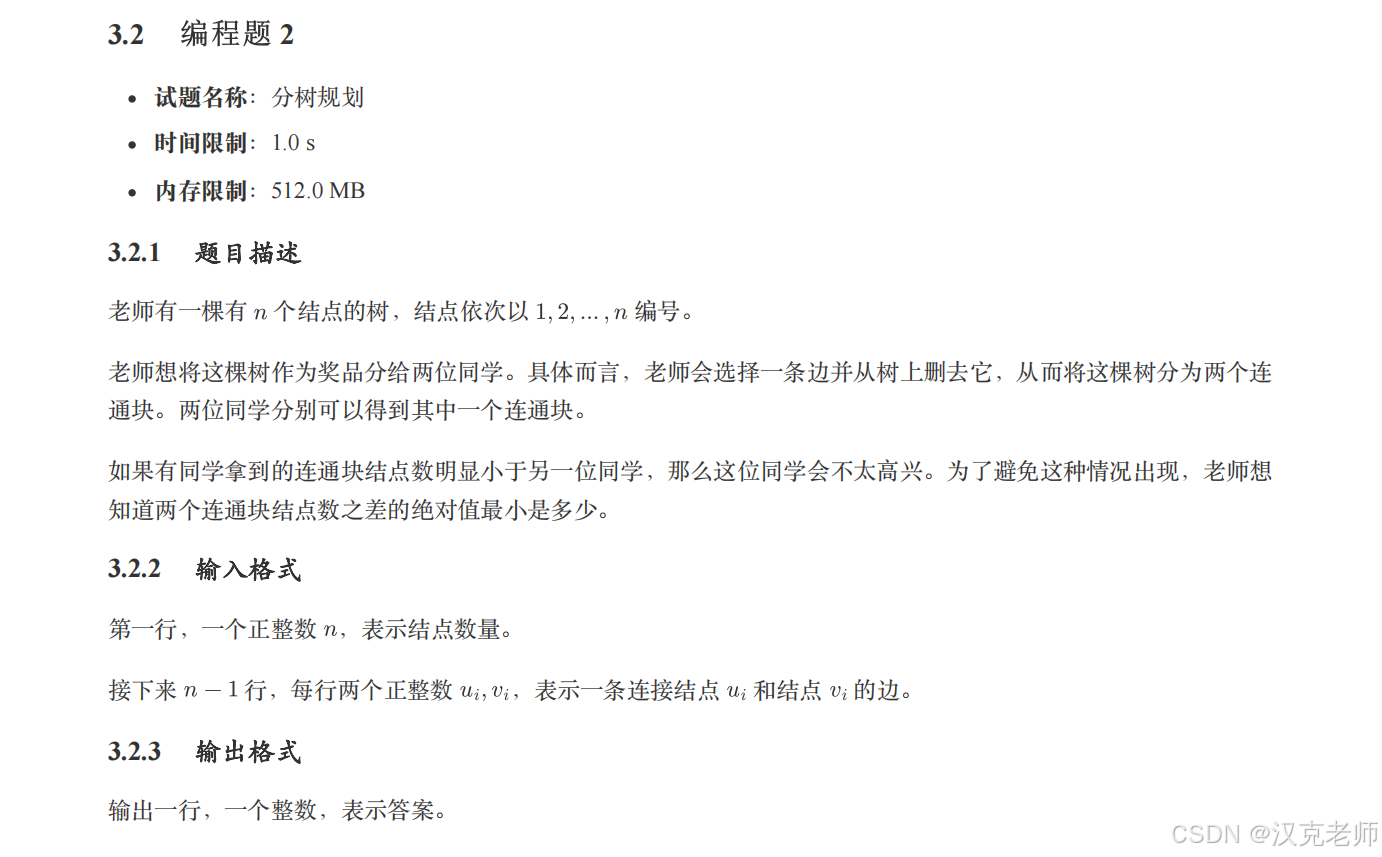
老师有一棵树,想把它分给两位同学。老师只能剪断一条树枝,让树变成两部分。怎样剪,才能让两位同学分到的结点数量尽可能接近呢?
这道题的核心知识是:
-
树的基本概念。
-
深度优先搜索 DFS。
-
子树结点数量统计。
-
枚举每条边对应的划分方案。
-
用
abs()计算两个部分的结点数之差。
一、故事时间:魔法森林的公平分配
想象一下,魔法森林里有一棵由许多结点组成的树。
例如:
        1
        |
        2
        |
        3
        |
        4
这棵树有 4 个结点。
老师想把这棵树分给小明和小红。
规则很简单:
-
选择树上的一条边。
-
把这条边剪断。
-
树就会变成两个互不连接的部分。
-
两位同学各拿一部分。
老师希望两个人拿到的结点数量尽可能接近。
比如剪断 2---3 这条边:
    1
    |
    2

    3
    |
    4
小明得到 2 个结点,小红也得到 2 个结点。
两个人的结点数之差为:
∣2−2∣= 0
差值为 0,说明两个人分得完全一样!
因此,这个例子的答案就是:
但是,如果树的形状更复杂,我们该怎么找到最合适的剪法呢?
我们总不能拿着剪刀,把每条边都剪一遍,再把所有树重新拼起来吧?
其实,我们有更聪明的方法!
二、认识树:树和普通图有什么不同?
在学习算法之前,我们先认识一下这道题中的树。
在 C++ 信奥中,树是一种特殊的图。
这道题中的树有几个重要特点:
-
一共有
n个结点。 -
结点之间通过边连接。
-
任意两个结点之间都存在一条唯一的简单路径。
-
一棵有
n个结点的树,恰好有n-1条边。
例如:
        1
       / \
      2   3
     / \
    4   5
这棵树有 5 个结点、4 条边。
注意:树上的边没有规定必须从父亲指向孩子。
例如,结点 1 和结点 2 相连,那么从 1 可以走到 2,从 2 也可以走回 1。
这意味着,如果我们直接在树上进行 DFS,就需要小心处理一个问题:
不能因为刚刚走到一个结点,就又沿着原来的边走回去!
三、核心思路:把树暂时变成一棵有根树
题目没有规定树的根结点在哪里。
为了方便计算,我们可以暂时选择结点 1 作为根。
例如:
        1
       / \
      2   3
     / \
    4   5
这样一来,我们就能把结点之间的关系理解为:
-
1 是根结点。
-
2 和 3 是 1 的孩子。
-
4 和 5 是 2 的孩子。
于是,我们可以使用一个非常重要的概念:
什么是子树?
以结点 2 为根,它下面包含:
      2
     / \
    4   5
这部分就是结点 2 的子树。
它一共有 3 个结点。
我们定义:
szu = 以结点 u 为根的子树结点数量
例如:
| 结点 u | 子树包含的结点 | szu |
|---|---|---|
| 1 | 1、2、3、4、5 | 5 |
| 2 | 2、4、5 | 3 |
| 3 | 3 | 1 |
| 4 | 4 | 1 |
| 5 | 5 | 1 |
这里有一个重要规律:
每个结点自己的子树,至少包含它自己。
所以:
szu= 1 + 所有孩子的子树结点数之和
这正是 DFS 可以帮我们完成的工作。
四、最重要的观察:剪断一条边,究竟会发生什么?
假设我们已经把树以结点 1 为根。
现在考虑结点 u 与它父亲之间的边。
如果我们剪断这条边,会发生什么?
以刚才的树为例:
        1
       / \
      2   3
     / \
    4   5
如果剪断 1---2:
    1       2
   /       / \
  3       4   5
两部分的结点数分别是:
-
以 2 为根的子树:3 个结点。
-
剩下的部分:5 - 3 = 2 个结点。
如果剪断 2---4:
        1
       / \
      2   3
     / \
    5   4
这次两部分的结点数分别是:
-
结点 4 的子树:1 个结点。
-
剩下的部分:5 - 1 = 4 个结点。
因此,我们发现:
对于一条连接父结点和孩子结点 u 的边,剪断它之后,其中一部分恰好是 u 的整棵子树。
那么:
-
一部分有
sz[u]个结点。 -
另一部分有
n-sz[u]个结点。
两部分的结点数之差的绝对值就是:
化简得到:
这就是本题的关键公式!
为什么这个公式特别有用?
因为我们不需要真的把边剪断。
只要知道 sz[u],就能立即计算剪断这条边后的差值。
所以,问题就变成了:
计算每个结点的子树大小,然后枚举所有非根结点,找出公式值最小的那个。
五、DFS 登场:帮每个结点数一数自己的子孙
我们已经知道,最关键的信息是 sz[u]。
那么,如何计算它呢?
答案是:深度优先搜索 DFS。
1. DFS 的计算顺序
假设树是:
        1
       / \
      2   3
     / \
    4   5
当 DFS 走到结点 1 时:
-
先把结点 1 自己计算进去。
-
进入结点 2。
-
计算结点 2 的子树大小。
-
再进入结点 3。
-
计算结点 3 的子树大小。
-
把孩子们的子树大小加起来。
可以把它想象成一场森林探险:
每个结点都要先派探险队去访问自己的孩子。等孩子们全部探险回来,报告各自发现了多少个结点,自己再把这些数量加起来。
2. DFS 的核心代码
int dfs(int u, int p = 0) {
    int sz = 1;

    for (int i = h[u]; i; i = nx[i]) {
        if (to[i] != p) {
            sz += dfs(to[i], u);
        }
    }

    ans = min(ans, abs(n - 2 * sz));

    return sz;
}
我们逐句理解。
第一句:先把自己算进去
int sz = 1;每个结点至少包含自己。
所以子树大小从 1 开始。
第二句:枚举与当前结点相连的边
for (int i = h[u]; i; i = nx[i])这段代码使用的是链式前向星存图。
它的作用是依次访问与结点 u 相连的所有边。
如果你还没有学过链式前向星,可以先把它理解为:
找出当前结点所有能够直接到达的邻居。
第三句:不要走回父亲
if (to[i] != p)这里的 p 表示当前结点 u 的父结点。
因为树上的边是双向的,如果不加判断,就可能出现:
1 → 2 → 1 → 2 → 1 → ...这样 DFS 就会不停地来回走。
所以我们规定:
如果邻居是刚才的父结点,就跳过它。
第四句:把孩子的子树大小加起来
sz += dfs(to[i], u);这句话做了两件事:
-
递归进入孩子结点
to[i]。 -
把孩子返回的子树大小加到当前的
sz中。
例如:
        1
       / \
      2   3
     / \
    4   5
结点 2 的计算过程是:
sz = 1       // 先计算自己

访问结点4:
sz = 1 + 1 = 2

访问结点5:
sz = 2 + 1 = 3
最终:
sz[2] = 3第五句:计算当前结点对应的划分差值
ans = min(ans, abs(n - 2 * sz));这句代码是本题的核心。
对于当前结点 u,剪断它与父亲之间的边,就会产生两个部分。
差值为:
∣n−2×szu∣|n-2\times szu|
abs() 用来计算绝对值。
min() 用来保留目前找到的最小差值。
每访问一个非根结点,我们就计算一次。
第六句:返回子树大小
return sz;当前结点已经统计完成。
把它的子树大小返回给父结点,让父结点继续完成自己的统计。
六、参考程序
下面我们把整个算法组合起来。
本程序按照试卷中的参考程序思路编写,使用链式前向星存图,并通过 DFS 统计子树大小。
#include <cstdio>
#include <algorithm>
#include <cstdlib>
using namespace std;

const int N = 20005;
const int E = N << 1;

int n;

// 链式前向星
int h[N], to[E], nx[E];
int et = 0;

// 当前找到的最小差值
int ans;

// 添加一条有向边 u -> v
void ae(int u, int v) {
    et++;

    to[et] = v;
    nx[et] = h[u];
    h[u] = et;
}

// DFS:返回以 u 为根的子树大小
// p 表示 u 的父结点
int dfs(int u, int p = 0) {
    // 子树至少包含自己
    int sz = 1;

    // 枚举 u 的所有邻居
    for (int i = h[u]; i; i = nx[i]) {
        int v = to[i];

        // 不走回父结点
        if (v != p) {
            // 加上孩子的子树大小
            sz += dfs(v, u);
        }
    }

    // 尝试剪断 u 与父亲之间的边
    ans = min(ans, abs(n - 2 * sz));

    // 把子树大小返回给父结点
    return sz;
}

int main() {
    scanf("%d", &n);

    // 一棵 n 个结点的树有 n-1 条边
    for (int i = 1; i < n; i++) {
        int u, v;
        scanf("%d%d", &u, &v);

        // 无向边需要添加两个方向
        ae(u, v);
        ae(v, u);
    }

    // 初始化答案
    ans = n;

    // 以结点1为根进行DFS
    dfs(1);

    // 输出最小差值
    printf("%d\n", ans);

    return 0;
}
七、手动模拟:看看 DFS 是怎样完成任务的
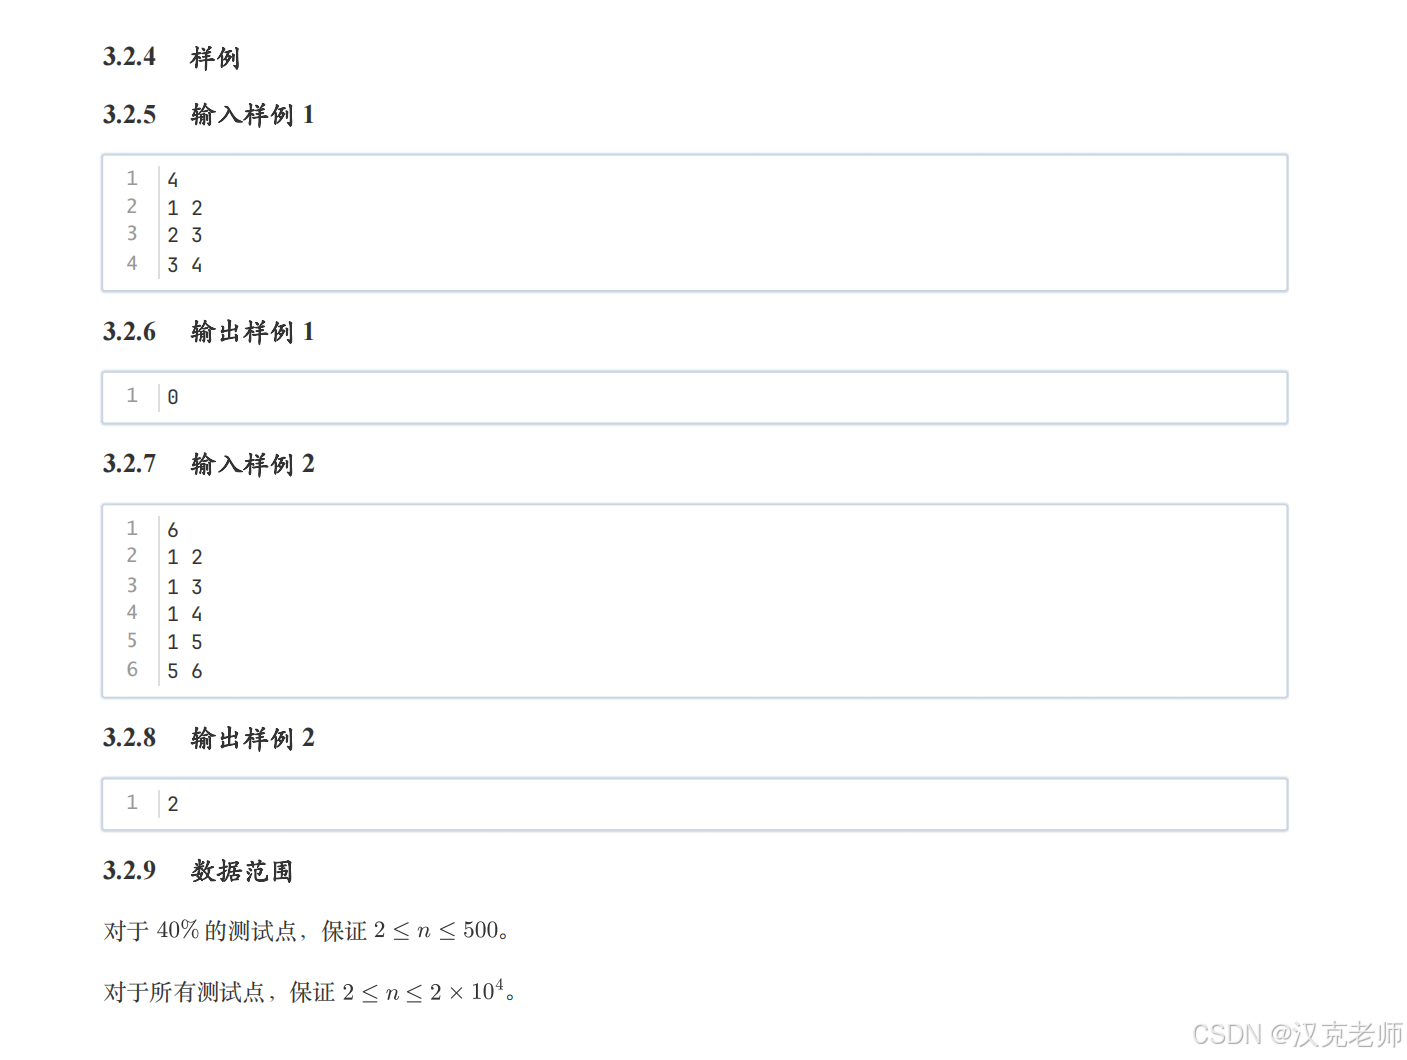
我们使用试卷中的第二个样例。
输入
6
1 2
1 3
1 4
1 5
5 6
这棵树的形状是:
        1
      / | \ \
     2  3  4  5
                  \
                   6
一共有 6 个结点。
我们以结点 1 为根,开始 DFS。
第一步:计算结点 2、3、4、6 的子树大小
结点 2 没有孩子:
sz2 = 1
结点 3 没有孩子:
sz3 = 1
结点 4 没有孩子:
sz4 = 1
结点 6 没有孩子:
sz6 = 1
第二步:计算结点 5 的子树大小
结点 5 有一个孩子 6。
所以:
sz5=1+sz6 = 1+1 = 2
剪断 1---5 这条边后:
-
一部分包含结点 5、6,共 2 个结点。
-
另一部分包含 1、2、3、4,共 4 个结点。
差值为:
目前最小差值是 2。
第三步:计算根结点 1 的子树大小
结点 1 有四个孩子:2、3、4、5。
所以:
sz1 = 1+1+1+1+2 = 6
根结点没有父亲,因此它本身并不对应一条需要剪断的父子边。
参考程序也会计算根结点对应的公式值:
∣6−2×6∣= 6
这个值不会影响已经找到的最小值 2。
最终答案
2
这与试卷样例的输出一致。
八、为什么不需要真的剪断每一条边?
这是一个非常值得思考的问题。
如果使用最直接的方法:
-
找到一条边。
-
剪断它。
-
重新遍历整棵树,计算两部分的结点数。
-
恢复这条边。
-
再尝试下一条边。
这样做会产生很多重复工作。
但我们发现:
只要计算一次每个结点的子树大小,就能得到剪断它与父亲之间的边所产生的两部分大小。
所以我们不必真的剪断边。
只需要计算:
再取所有结果的最小值即可。
这就是本题巧妙的地方:
不必真的动手改变树的结构,而是通过子树大小,直接计算每一种剪法的结果。
九、算法复杂度分析
1. 时间复杂度
一棵树有 n-1 条无向边。
程序把每条无向边存储为两个有向边,因此一共存储 2(n-1) 条有向边。
DFS 从根结点出发,每个结点访问一次,每条存储的边也只会被检查常数次。
因此,时间复杂度为:
这意味着即使树有很多结点,我们也不需要对每条边都重新遍历整棵树。
2. 空间复杂度
程序使用了链式前向星数组:
int h[N], to[E], nx[E];这些数组的大小都与结点数和边数成正比。
此外,DFS 的递归调用也需要栈空间。
因此,整体空间复杂度为:
十、同学们容易犯的错误
错误1:只统计孩子,不统计自己
错误写法:
int sz = 0;如果这样写,结点自己的数量就没有被计算进去。
正确写法:
int sz = 1;记住:子树一定包含它的根结点自己!
错误2:DFS 时忘记跳过父结点
错误写法:
for (int i = h[u]; i; i = nx[i]) {
    sz += dfs(to[i], u);
}
由于边是双向的,这样可能导致 DFS 不断返回父结点,形成无限递归。
正确写法:
if (to[i] != p) {
    sz += dfs(to[i], u);
}
错误3:只考虑一边的结点数
假设剪断一条边后,两部分大小分别是 2 和 8。
如果只记录 2,就无法直接得到题目要求的差值。
正确计算方式是:
∣2−8∣ = 6
或者直接使用:
错误4:忘记取最小值
题目不是要求某一种剪法的差值,而是要求所有剪法中最小的差值。
因此,需要不断更新:
ans = min(ans, abs(n - 2 * sz));十一、举一反三:这道题还告诉了我们什么?
本题有一个重要的算法思想:
当我们把树固定一个根之后,树上的每一条边,都可以对应一个孩子结点的子树。
因此,我们可以利用子树信息来研究删边之后的结果。
类似的思路还可以帮助我们解决其他树上问题,例如:
-
统计每个结点的子树大小。
-
计算删除某条边后两个连通块的大小。
-
判断一棵树能否被划分成满足条件的多个部分。
-
在树上统计某些结点数量或计算子树信息。
十二、最后总结:把这道题装进脑海里的魔法口诀
同学们,今天我们学会了怎样利用 DFS 完成一棵树的公平分配。
请记住下面这段口诀:
树有结点也有边,选个根来理关系;
DFS 先数自己,再把孩子加一起;
剪断父子连接边,一边子树一边外;
总数减去子树数,两边差值算出来;
所有结点试一遍,最小差值就是答案!
最后,再把本题的核心公式记牢:
差值= ∣n−2×szu∣
其中:
-
n是整棵树的结点数量。 -
sz[u]是以u为根的子树结点数量。 -
u是根结点以外的任意结点时,这个公式对应剪断它与父亲之间的边。
这道题最重要的收获,不只是学会写 DFS,而是学会先分析剪断一条边会产生什么结构,再利用子树信息直接计算答案。
附:《分树规划》进阶:不使用链式前向星,还能怎样存图?
对于初学 C++ 的同学来说,链式前向星并不是存储树的唯一方法。
对于《分树规划》这道题,真正重要的是 DFS 统计子树大小,而不是使用哪一种存图方式。
只要能够找到每个结点的邻居,并且避免 DFS 沿着边走回父结点,就可以完成任务。
本题的树有 n 个结点、n-1 条边。我们可以考虑下面几种存图方法:
-
vector邻接表。 -
二维数组邻接矩阵。
-
固定数组模拟邻接表,也就是原程序使用的链式前向星。
下面我们分别看看。
一、方法一:使用 vector 邻接表
同学们已经学习过 vector,可以使用 vector 邻接表。
它的思想非常简单:
每个结点准备一个可以变长的盒子,里面存放与它直接相连的所有结点编号。
例如:
        1
       / \
      2   3
     / \
    4   5
邻接表可以表示为:
结点1:2,3
结点2:1,4,5
结点3:1
结点4:2
结点5:2
在 C++ 中,可以这样定义:
vector<int> tree[N];其中:
tree[u]就代表结点 u 的邻居列表。
1. 添加边
假设输入一条边:
u v因为树是无向的,所以要添加两个方向:
tree[u].push_back(v);
tree[v].push_back(u);
例如,输入:
1 2就相当于:
tree[1] 中加入 2
tree[2] 中加入 1
2. DFS 统计子树大小
有了邻接表,DFS 就会变得非常直观:
int dfs(int u, int p = 0) {
    int sz = 1;

    for (int v : tree[u]) {
        if (v != p) {
            sz += dfs(v, u);
        }
    }

    ans = min(ans, abs(n - 2 * sz));

    return sz;
}
注意这一句:
for (int v : tree[u])它是 C++11 支持的范围 for 循环。
可以把它理解为:
把结点
u的邻居一个一个拿出来,放进变量v中。
这样就不用自己维护边的编号了。
3. 完整程序:vector 邻接表版本
下面的程序保留了原题的 DFS 核心逻辑,只把链式前向星换成了 vector 邻接表。
#include <cstdio>
#include <algorithm>
#include <cstdlib>
#include <vector>
using namespace std;

const int N = 20005;

int n;
vector<int> tree[N];

int ans;

// DFS 返回以 u 为根的子树大小
int dfs(int u, int p = 0) {
    int sz = 1;

    // 遍历 u 的所有邻居
    for (int v : tree[u]) {
        // 不走回父结点
        if (v != p) {
            sz += dfs(v, u);
        }
    }

    // 计算剪断 u 与父亲之间的边后的差值
    ans = min(ans, abs(n - 2 * sz));

    return sz;
}

int main() {
    scanf("%d", &n);

    // 读入 n-1 条无向边
    for (int i = 1; i < n; i++) {
        int u, v;
        scanf("%d%d", &u, &v);

        tree[u].push_back(v);
        tree[v].push_back(u);
    }

    ans = n;

    dfs(1);

    printf("%d\n", ans);

    return 0;
}
4. 这种方法有什么特点?
| 特点 | 说明 |
|---|---|
| 容易理解 | 每个结点直接保存自己的邻居 |
| 容易编写 | 添加边只需要 push_back() |
| 遍历方便 | 使用范围 for 循环 |
| 时间复杂度 | DFS 为 O(n)O(n) |
| 空间复杂度 | O(n)O(n) |
教学建议:如果学生已经学过 vector,我会优先用这种方法讲解本题。
它把存图细节隐藏起来,让学生把注意力集中在 DFS 和子树大小的计算上。
二、方法二:使用二维数组邻接矩阵
如果学生还没有学习 vector,甚至可以使用二维数组来存图。
不过,这种方法虽然容易理解,却有明显的空间和时间代价。
1. 什么是邻接矩阵?
定义:
int g[N][N];如果结点 u 和结点 v 之间有边,就令:
g[u][v] = 1;
g[v][u] = 1;
例如:
        1
       / \
      2   3
可以用下面的矩阵表示:
      1  2  3
    ----------
1 |   0  1  1
2 |   1  0  0
3 |   1  0  0
g[u][v] == 1 表示结点 u 和结点 v 之间有边。
2. 如何遍历邻居?
如果当前在结点 u,就从结点 1 一直检查到结点 n:
for (int v = 1; v <= n; v++) {
    if (g[u][v] == 1 && v != p) {
        sz += dfs(v, u);
    }
}
即使结点 u 只有一个邻居,也需要检查所有可能的结点编号。
3. DFS 的矩阵版本
int dfs(int u, int p = 0) {
    int sz = 1;

    for (int v = 1; v <= n; v++) {
        if (g[u][v] == 1 && v != p) {
            sz += dfs(v, u);
        }
    }

    ans = min(ans, abs(n - 2 * sz));

    return sz;
}
这段代码的子树统计逻辑,与前面的 vector 版本完全一样。
区别仅仅在于:寻找邻居的方式不同。
4. 为什么本题不适合使用邻接矩阵?
题目中最多有约 20000 个结点。
如果使用:
int g[20005][20005];需要存储大约 4 亿个 int。
假设一个 int 占 4 字节,那么仅这个矩阵就需要约:
这已经远远超过题目给出的 512 MB 内存限制。
而且,DFS 每访问一个结点,都要扫描所有 n 个可能的邻居。
因此,时间复杂度会达到:
结论:邻接矩阵适合结点数量较少、需要频繁判断两点之间是否有边的图,但不适合本题这种结点较多、边数很少的树。
三、方法三:链式前向星------原题采用的存图方式
我们再回头看看原程序。
int h[N], to[E], nx[E];
int et;
它没有给每个结点单独准备一个 vector,而是把所有边放在几个普通数组里管理。
可以把它想象成:
-
h[u]:结点u的邻居名单从哪里开始。 -
to[i]:第i条有向边通向哪个结点。 -
nx[i]:同一个结点的下一条边在哪里。 -
et:目前已经存了多少条有向边。
添加边时:
void ae(int u, int v) {
    et++;

    to[et] = v;
    nx[et] = h[u];
    h[u] = et;
}
遍历邻居时:
for (int i = h[u]; i; i = nx[i]) {
    int v = to[i];

    if (v != p) {
        sz += dfs(v, u);
    }
}
链式前向星的主要优点是:
-
使用连续数组存储边,内存开销可预测。
-
不需要为每个结点分别管理动态数组。
-
遍历所有边的效率很高。
-
对于边数较多、需要精细控制存储方式的图问题,它是一种常见的实现方法。
它的缺点也很明显:
代码比 vector 邻接表更难理解。
初学者需要同时理解边编号、下一条边、表头等概念,容易把注意力从 DFS 本身转移到存图细节上。
四、三种方法放在一起比较
| 比较项目 | vector 邻接表 | 邻接矩阵 | 链式前向星 |
|---|---|---|---|
| 存储方式 | 每个结点一个邻居列表 | 二维数组记录两点是否相连 | 普通数组保存边及链接关系 |
| 添加边 | 简单 | 简单 | 需要维护边编号和链接 |
| 遍历邻居 | 只遍历实际邻居 | 扫描所有结点 | 只遍历实际邻居 |
| 空间复杂度 | O(n) | O(n^2) | O(n) |
| DFS 时间复杂度 | O(n) | O(n^2) | O(n) |
| 初学者理解难度 | 较低 | 较低 | 较高 |
| 本题是否适合 | 适合 | 不适合 | 适合 |
这里的复杂度分析针对本题的树结构,假设使用邻接表或链式前向星存储,DFS 正常访问每个结点及其邻接边。
五、那么,链式前向星是本题的最优方法吗?
需要区分两个不同的问题。
1. 从算法复杂度来看
对于本题,vector 邻接表和链式前向星都可以做到:
O(n) 时间复杂度
以及:
O(n) 空间复杂度
所以,它们在渐进复杂度上是相同的。
2. 从教学角度来看
对于初学 C++ 的小学生,我更建议:
优先讲解 vector 邻接表版本。
原因是学生能够把主要精力放在:
-
为什么要以结点 1 为根?
-
为什么
sz从 1 开始? -
为什么要跳过父结点?
-
为什么剪断边后的差值是
abs(n - 2 * sz)? -
为什么 DFS 返回子树大小?
这些才是本题最值得掌握的核心知识。
等学生熟悉邻接表、DFS 和树的基本概念后,再介绍链式前向星,会更容易理解。
3. 从实际编程角度来看
使用 C++11,vector 邻接表是一种完全合理的选择。
链式前向星则适合希望使用固定数组、精细控制存储,或者已经熟悉这种写法的同学。
两者都能有效解决本题。
六、最后送给同学们一个记忆口诀
树上存图有方法,邻接表和前向星;
邻接矩阵也能存,结点太多要小心;
初学先把邻接表学明白,DFS 才是本题的重头戏!
如果这道题是给初学 C++ 的小学生上课,我建议采用下面的顺序:
第一步: 用 vector 邻接表讲清楚树和 DFS。
第二步: 用手动画图理解子树大小与删边后的两个连通块。
第三步: 推导公式:
第四步: 最后再把 vector 邻接表替换为链式前向星,让学生理解不同存图方式的区别。
这样既能完成本题,也能帮助学生建立更扎实的图论基础。