XLinear:用一个轻量 MLP,带外生变量做长期时间序列预测
|----------|-----------------------------------------------------------------------------------------------------------------|
| 论文题目 | XLinear: A Lightweight and Accurate MLP-Based Model for Long-Term Time Series Forecasting with Exogenous Inputs |
| 作者 | Xinyang Chen, Huidong Jin, Yu Huang, Zaiwen Feng |
| 机构 | 华中农业大学信息学院;CSIRO(澳大利亚联邦科工组织)统计机器学习组等 |
| 代码 | https://github.com/Ziwen/XLinear |
| 关键词 | 长期时间序列预测;外生变量 Exogenous Inputs;MLP;门控机制 Gating |
摘要
现实世界的预测问题往往不是"对称"的:变量之间存在非对称的因果关系 ,数据采集成本也不同。一些成本低廉的外生数据 (如当地天气、河流水温)能够揭示内生变量(真正要预测的目标,如作物产量、河流溶解氧)背后的驱动规律。
Transformer 类模型(如 TimeXer)虽能利用外生变量、捕捉长程依赖,但计算开销大 ,且 patch 机制带来排列不变性(permutation invariance) ,容易丢失局部时间模式。本文提出 XLinear ------一个仅由两组 MLP 构成的轻量模型:它从内生变量中提取全局 token(global tokens) 作为枢纽,用带 sigmoid 门控 的多头 MLP 同时刻画时间模式 与跨变量依赖,再由预测头融合输出。在 7 个标准基准和 5 个真实世界数据集上,XLinear 以接近最简单线性模型的开销,取得了全面领先的精度。
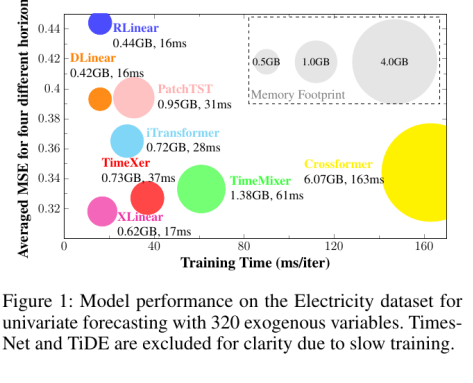
图注 Electricity 数据集单变量预测(含 320 个外生变量)的效率对比:横轴训练时间,纵轴四个预测长度的平均 MSE,气泡大小为显存占用。XLinear 位于左下角,又快、又准、又省内存。
Q1:这篇论文试图解决什么问题?
论文要解决的核心问题是:如何在高效利用外生变量的同时,不付出 Transformer 那样的高计算代价,并且不丢失局部时间模式。
现有方法分两类,各有短板:一类把所有变量"平等对待"或干脆忽略外部信息(DLinear、TimeMixer 等轻量模型),无法利用外生驱动;另一类用 patch-based attention 显式建模外生变量(TimeXer、PatchTST),但 self-attention 计算昂贵,且 patch 切分带来的排列不变性会削弱模型对时间顺序和局部波动的刻画。XLinear 试图在 MLP 框架内,把"时间维度信息"和"外生→内生的跨变量信息"同时显式建模,兼顾精度、速度与内存三者。
Q2:有哪些相关研究?
论文把相关工作梳理为五条线索:
1. 经典深度预测模型: 基于 RNN/CNN 的 LSTNet 等受梯度消失和效率限制;N-BEATS、DLinear、RLinear等纯 MLP/线性模型结构简单,却长期保持极强竞争力。
2. Transformer 长期预测模型: Informer、Autoformer 等靠不同注意力机制降低开销;PatchTST 用 patch 提升效率,但存在排列不变性、丢失局部模式;Crossformer 建模跨维度,但 patch 未对齐会引入噪声;iTransformer倒置结构、把变量当 token,但对时间依赖刻画较弱。
3. 带外生变量的模型: 经典统计中的 ARIMAX、SARIMAX 已引入外部变量;深度模型中 TFT、NBEATSx、TiDE尝试融合外部未来值,但通常要求内生、外生序列在时间上严格对齐。
4. **TimeXer(本文最主要的对标对象):**外生变量预测的当前 SOTA,用 variate-wise cross-attention 引入外部信息;但 patch 机制使模型对位置不敏感,且 self-attention 计算量大、推理慢。
5. **轻量模型与预训练基础模型:**TimeMixer、xPatch 等分解趋势与季节、压缩计算,但大多忽略外生驱动;TimeMOIR 等预训练基础模型受限于训练数据和特定场景,精度尚不及 TimeXer。
Q3:论文如何解决这个问题?
XLinear 的设计极其简洁,整条流水线只有"一个嵌入 + 两个门控模块 + 一个预测头 "。核心思想:用全局 token 当"信使",用 sigmoid 门控替代注意力,分别在时间轴和变量轴上做两次轻量筛选。
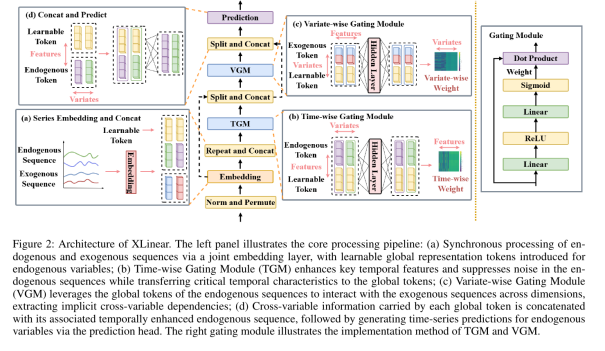
图注 XLinear 整体架构:(a) 序列嵌入与拼接,为内生变量引入可学习全局 token;(b) 时间门控模块 TGM;(c) 变量门控模块 VGM;(d) 拼接并预测。右侧为门控模块内部实现。
① 嵌入 Embedding:联合输入 + 全局 token
先用 RevIN 对内生序列做可逆归一化,再把内生序列 X 与外生序列 E 通过一个联合嵌入层映射到隐空间;同时为每个内生变量引入一个可学习的全局 token,并沿时间维度与内生嵌入拼接。这个全局 token 是后续信息汇聚的"枢纽"。
② 时间门控模块 TGM:放大显著时间模式
TGM 用一个 MLP 在时间轴上捕捉依赖、生成时间门控权重,再经 sigmoid 压缩到 0~1,对内生 token 逐元素加权,作用是放大显著的时间特征、抑制噪声------相当于让 MLP 学会"选择性关注关键时间步",弥补普通 MLP 对时间位置不敏感的缺陷。
③ 变量门控模块 VGM:刻画外生→内生依赖
外生序列同样提取全局 token。外生全局 token 与内生全局 token 经过 MLP + sigmoid 生成变量级权重,在通道维度上调制内生特征,从而刻画外生变量到内生变量的跨变量依赖。由于交互发生在全局 token 之间,不要求两类序列在时间上严格对齐,这是相比 TFT 等模型的一大便利。
④ 预测头与损失
把 TGM 输出的"时间增强"特征与 VGM 输出的"跨变量增强"特征拼接,经一个全连接层直接映射到未来 S 步;训练损失采用标准 MSE,多变量情况下对各通道损失取平均。
|-----------------------|-----------------------|-------------------------|
| 2 组 MLP 构成全部可学习结构 | 2 个 门控模块(时间 + 变量) | 1 个 全局 token 充当信息枢纽 |
Q4:论文做了哪些实验?
实验覆盖 12 个数据集:7 个标准基准(Electricity、Weather、Traffic、ETTh1/h2/m1/m2)和 5 个强外生场景的真实数据集(Kaggle 作物产量 Crop、Darling 河的两个溶解氧 DO 数据集、澳大利亚两条河流的两个水温 GTD 数据集)。对比 TimeXer、PatchTST、iTransformer、Crossformer、TimesNet、TimeMixer、DLinear、RLinear、TiDE 等 10 个基线。
数据集一览
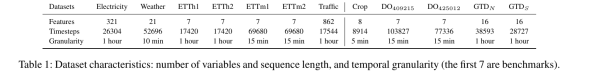
图注 12 个数据集的变量数、序列长度与时间粒度(前 7 个为标准基准,后 5 个为带外生变量的真实应用数据集)。
单变量预测(带外生输入)
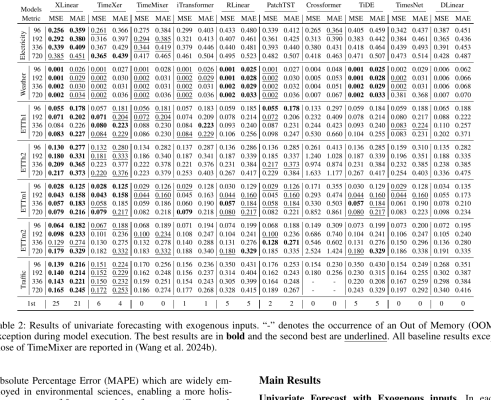
该设定下每个数据集指定最后一个变量为预测目标,其余变量作为外生输入。XLinear 在 89.3%(25/28) 的实验配置上取得最低或次低 MSE,并在 MAE 上覆盖 75% 的配置;除 ETTh1 的 336 步外,几乎在所有情况下都优于 TimeXer、TimeMixer 等强基线。
效率方面,统一参数设置下,XLinear 训练速度比所有基线快至少 39.3% 、显存少 13.9% ;MSE 比 DLinear 低 2.8% ,相比 RLinear 的 MSE / MAE 分别低约 23.5% / 39.6%。
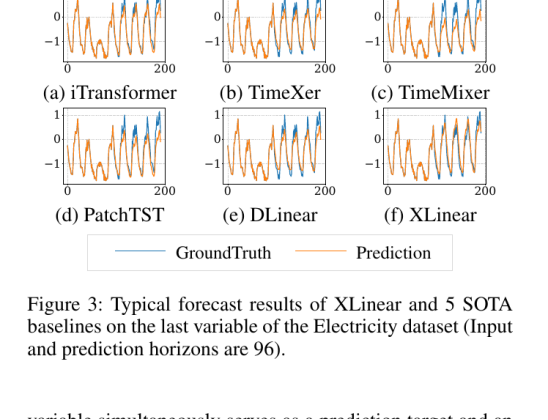
图注 Electricity 数据集最后一个变量上的典型预测结果(输入与预测长度均为 96):蓝线真值、橙线预测。(f) XLinear 对局部波动的还原明显优于其他模型。
在 5 个真实世界数据集上,XLinear 同样以三个代表模型中最低的 MSE / MAE 胜出:NSE(纳什效率系数)在 75% 的行上排名第一,20% 排名第二,且在 75% 的行上 NSE > 0.65,达到水文学意义上的"良好"水平。
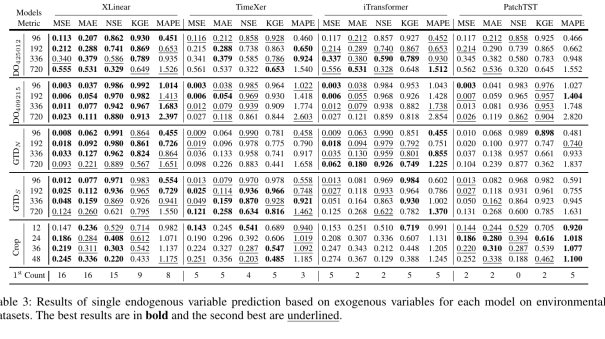
图注 5 个环境数据集上单一内生变量预测结果(含 NSE、KGE、MAPE 等水文指标),加粗为最优、下划线为次优。
多变量预测
多变量设定下,每个变量既是预测目标,又作为其他变量的外生驱动 ,变量间信息高度耦合。XLinear 在超过 91.7% 的"数据集 × 预测长度"组合上,MSE 与 MAE 同时取得最优,其余组合也均排名第二;唯一例外是 862 变量的 Traffic 数据集------iTransformer 的变量注意力机制在这种超高维场景下更有效。
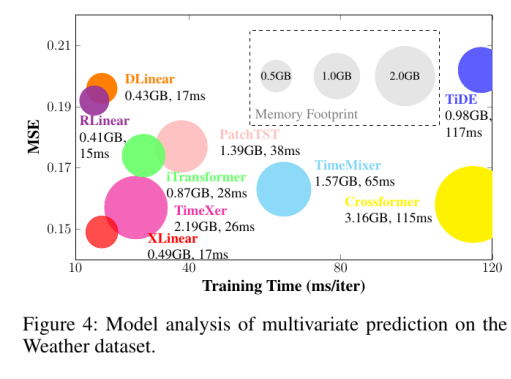
图注 Weather 数据集多变量预测的效率分析:除 DLinear、RLinear 外(MSE 分别高 31.5% 和 28.9%),XLinear 训练快至少 39.3%、显存少 5.1%、MSE 低 28.9%、MAE 低 43.7%。
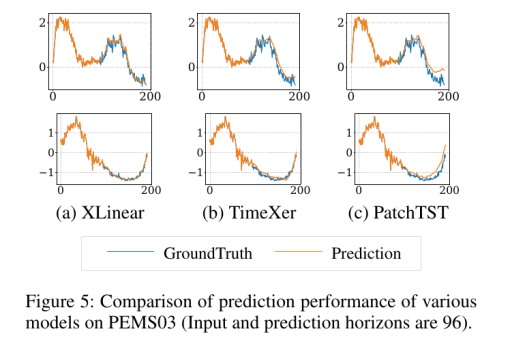
图注 PEMS03 上 XLinear、TimeXer、PatchTST 的预测对比(输入与预测长度均为 96)。
PEMS 交通流预测:对比 patch-based 模型
为检验"patch 机制不利于刻画高频波动"这一判断,论文在 PEMS03/04/07/08 四个高频交通数据集上与 TimeXer、PatchTST 做单内生变量预测对比。所有模型都能捕捉整体趋势,但在短时精细波动上 XLinear 明显更准------这得益于它在嵌入后直接对单个维度建模,而 patch 切分会妨碍高分辨率时间细节的学习。
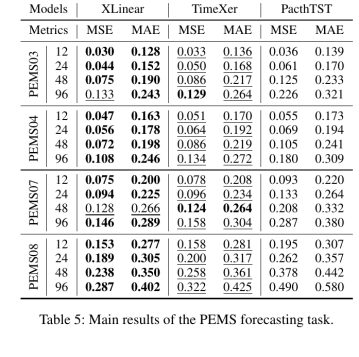
图注 PEMS 四个数据集、12~96 四种预测长度下的 MSE / MAE,XLinear 在绝大多数配置上最优。
权重可视化:模型在"看"什么
论文选取 DE 数据集(EPF 电价数据子集),用风电、区域负荷等外生变量预测电价。可视化显示:风电与电价在多个时间区间存在显著负相关;变量权重中代表风电和电价的通道权重更高,与输入序列中的相关性一致;时间权重则能识别并增强原始序列中的重要特征。
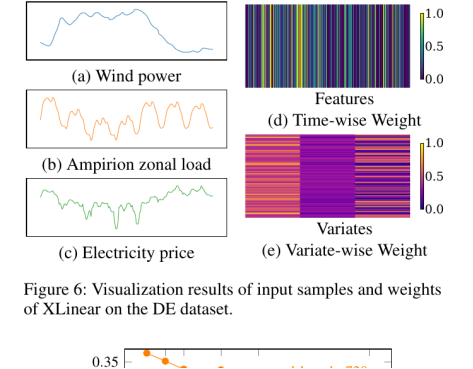
图注 (a)~(c) 风电、区域负荷、电价三个原始序列;(d) 时间权重(沿 Features 轴);(e) 变量权重(沿 Variates 轴)。颜色越亮权重越高。
长回看窗口:越长越占优
作为"时间步依赖"的捕获模型,XLinear 不做时间注意力也能从更长序列中提取有效信息。随着回看长度从 48 增加到 96,各预测长度的 MSE 快速下降,之后继续缓慢下降。
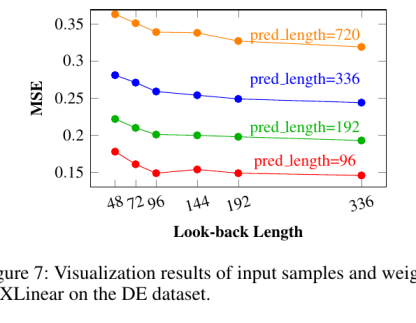
图注 DE 数据集上,四条预测长度(96 / 192 / 336 / 720)的 MSE 随回看窗口(48~336)的变化。
效率方面,XLinear 的训练时间与显存随回看窗口近似线性缓慢增长,而 TimeMixer、PatchTST 的资源需求至少呈二次增长。在 512 窗口、96~336 步预测上,XLinear 全面优于 TimeMixer 和 PatchTST;窗口延长到 720 时,XLinear 已明显优于 TimeMixer、与 PatchTST 相当,说明它更善于利用长历史信息。
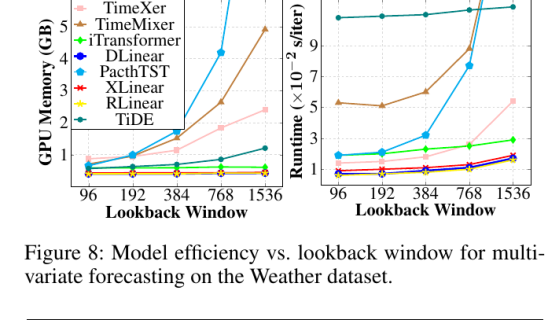
图注 Weather 数据集上显存(左)与训练时间(右)随回看窗口的变化。
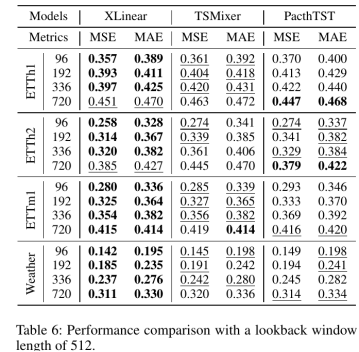
图注 回看窗口为 512 时,XLinear 与 TimeMixer、PatchTST 的性能对比。
消融实验
为评估两类信息源的贡献,论文对比三种配置:(a) 完整 XLinear;(b) 仅用内生序列(ES )捕捉时间依赖;(c) 仅用全局 token(GT)刻画外生交互。结果显示整合两类信息的完整模型表现最好;且内生全局 token 单独使用时整体优于纯时间序列------它同时捕获目标的总体时间特征与外生信息,证明两类信息是互补关系。
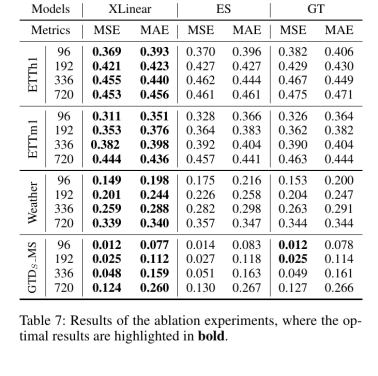
图注 消融实验结果:完整 XLinear、仅内生序列(ES)、仅全局 token(GT)三种配置的 MSE / MAE。
Q5:有什么可以进一步探索的点?
论文在结论中给出了三个明确的未来方向:
**1.**可扩展性:当前模型面向超长序列仍有压力,希望增强对数百变量、更长时间跨度输入的处理能力;
**2.**回看窗口的自适应选择:目前 lookback 长度依赖实验人工确定,可研究如何自动优化窗口以进一步提升精度;
**3.**面向运营部署的可靠性:增强预测的稳定性与可信度,支撑真实业务场景落地。
此外,门控权重目前仅用于可视化解释,如何与因果推断结合、实现外生变量的自动筛选,也是自然的延伸点。
Q6:总结一下论文的主要内容
XLinear 是一个仅用 MLP + sigmoid 门控 的轻量时间序列预测模型,专门应对"用低成本外生变量增强内生目标预测"这一非对称场景。
它以全局 token 为枢纽,分别用 TGM 抓时间模式、VGM 抓跨变量依赖 ,在 12 个数据集上同时打赢了"精度仗"和"效率仗":多变量任务 91.7% 的配置取得最优,训练比最高效的 Transformer 快至少 30%,显存占用与 DLinear 相当。
核心启示:在带外生变量的长期预测中,设计良好的门控 MLP 完全可以替代昂贵的注意力机制。
完整实验结果
以下为论文两张核心结果总表的完整截图,供查阅具体数值时参考。
图注 带外生输入的单变量预测完整结果(7 个基准 × 4 个预测长度 × 10 个模型),"-"表示显存不足(OOM)。
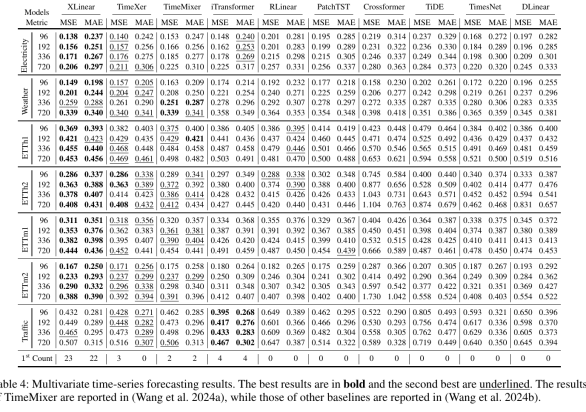
图注 多变量时间序列预测完整结果,加粗为最优、下划线为次优。
相关链接
论文原文(arXiv: 2601.09237):https://arxiv.org/abs/2601.09237
讲解视频:https://space.bilibili.com/51422950?spm_id_from=333.1007.0.0