文章目录
- VGG与AlexNet的对比
-
- VGG构造的features部分
- 主要升级点
- [为什么 3×3 堆叠是重要升级](#为什么 3×3 堆叠是重要升级)
- [也要看到 VGG 的代价](#也要看到 VGG 的代价)
- 与GoogLeNet的对比
- 疑问
-
- 感受野与参数量是不一样的
- 卷积核里的权重就是神经网络自己要学的参数
- 在深度学习项目中,全联接层会更占内存吗?
-
- [1. 参数量:卷积层通常比全连接层少很多](#1. 参数量:卷积层通常比全连接层少很多)
- [2. 训练显存:卷积层的激活值可能很大](#2. 训练显存:卷积层的激活值可能很大)
- [3. 可以这样记](#3. 可以这样记)
- 上面说的中间激活值是什么?
- 卷积核的通道数和上一层的通道数是一样的,卷积核的组数能够改变其通道数,对吗?
-
- [1. 普通卷积:卷积核通道数 = 输入通道数](#1. 普通卷积:卷积核通道数 = 输入通道数)
- [2. 分组卷积:卷积核通道数不一定等于完整输入通道数](#2. 分组卷积:卷积核通道数不一定等于完整输入通道数)
- 更准确的总结
VGG与AlexNet的对比
VGG 相比 AlexNet 最大的升级不是"多几层"那么简单,而是把卷积神经网络从 AlexNet 那种大卷积核、结构不太统一的深度模型 ,升级成了 全 3×3 小卷积核、可重复堆叠、更规整的深度网络范式。
VGG构造的features部分
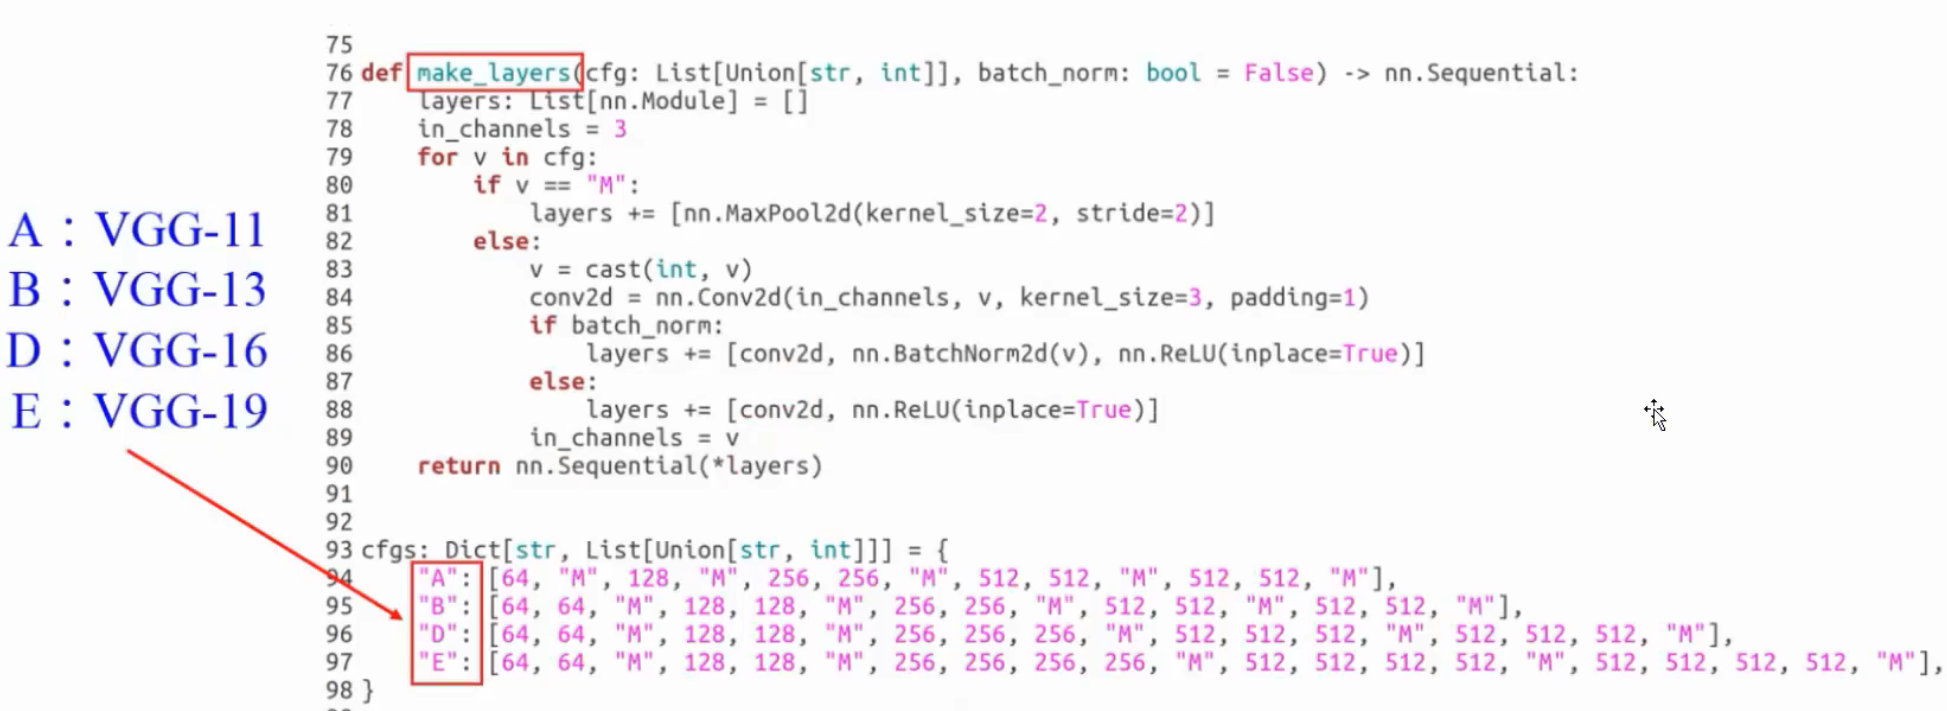
-
其中16与19在下方可以展示出来
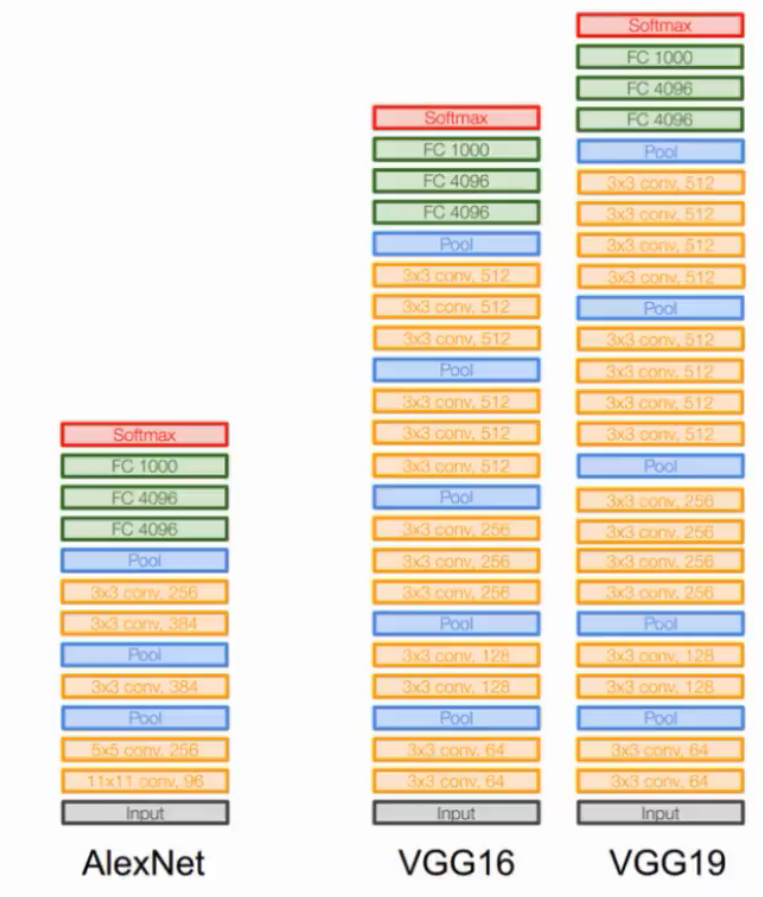
-
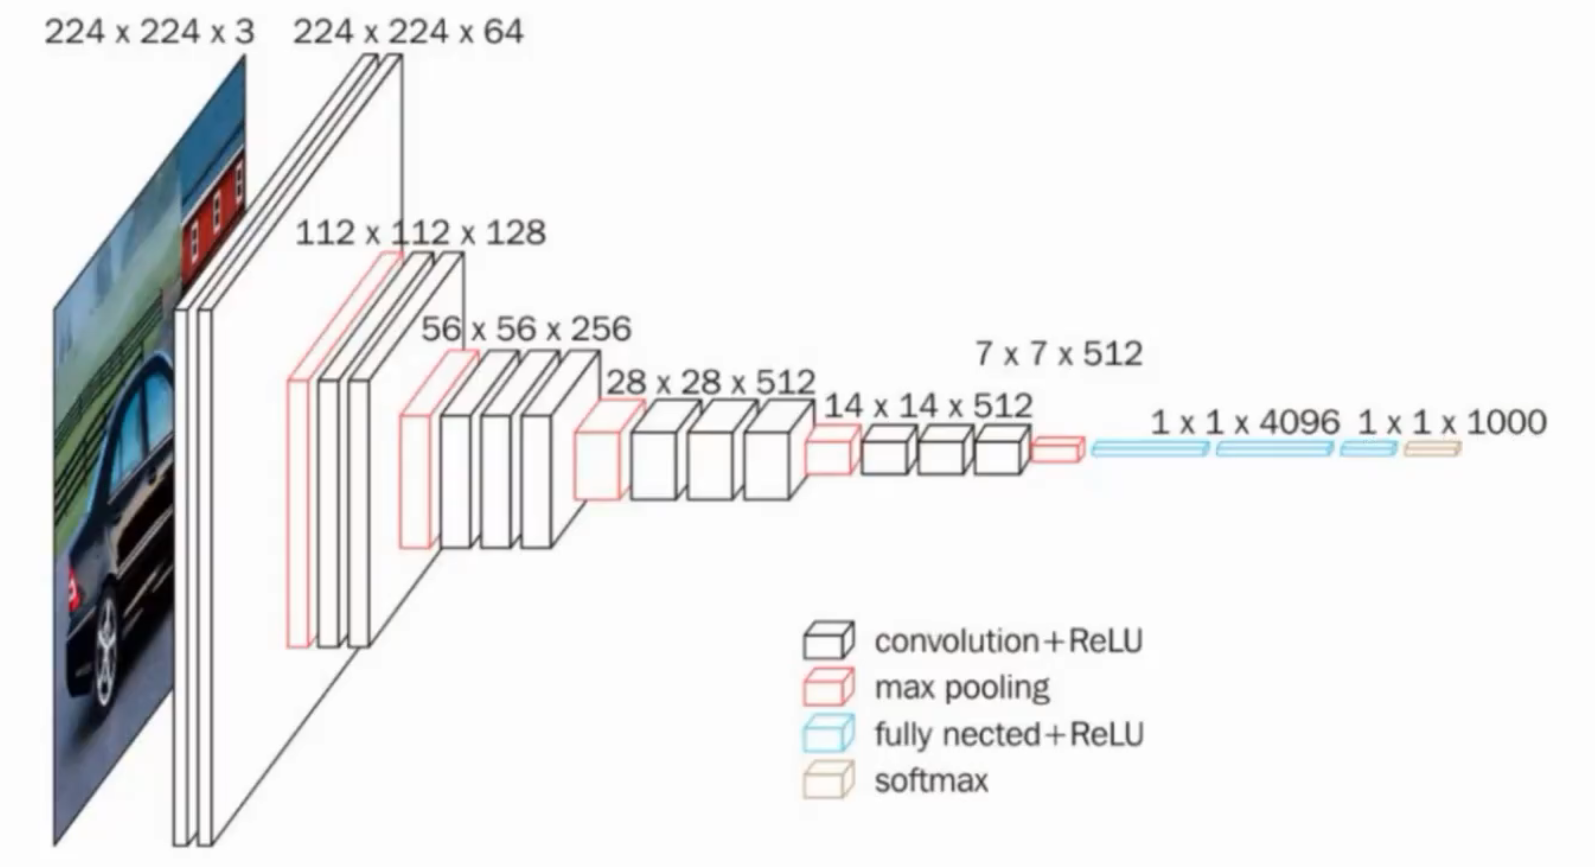
VGG-16全过程
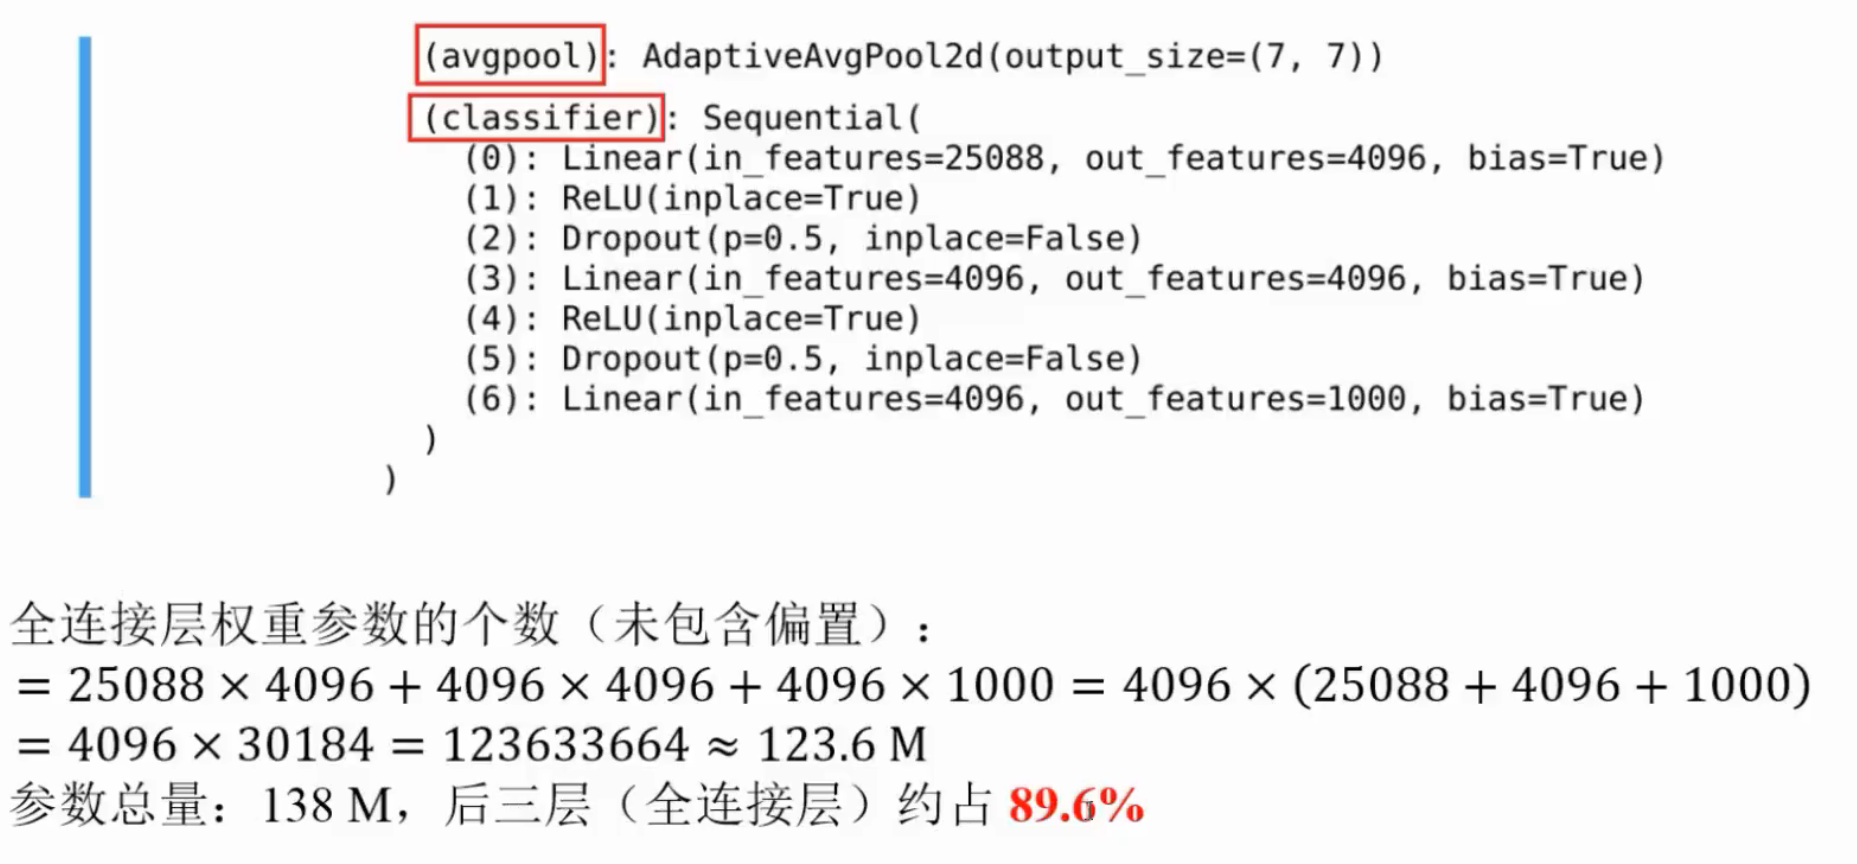
- VGG-16占用的内存,后面的全联接层占用将近90%
主要升级点
| 方面 | AlexNet | VGG |
|---|---|---|
| 卷积核 | 11×11、5×5 等大卷积核 | 全部主要用 3×3 小卷积核 |
| 网络深度 | 5 层卷积 + 3 层全连接 | VGG16 有 13 层卷积 + 3 层全连接;VGG19 更深 |
| 感受野 | 靠大卷积核直接获得 | 多个 3×3 堆叠等效大感受野 |
| 非线性 | 每层后接 ReLU | 更多 3×3 层意味着更多 ReLU,非线性更强 |
| 池化 | 有 3×3 池化 | 统一用 2×2 最大池化 |
| 归一化 | 使用 LRN | 去掉 LRN |
| 结构风格 | 有效但不统一 | 高度规整,易于复现和迁移 |
为什么 3×3 堆叠是重要升级
VGG 用多个 3×3 卷积代替 AlexNet 中的大卷积核,比如:
- 2 个 3×3 卷积 ≈ 1 个 5×5 卷积的感受野;
- 3 个 3×3 卷积 ≈ 1 个 7×7 卷积的感受野。
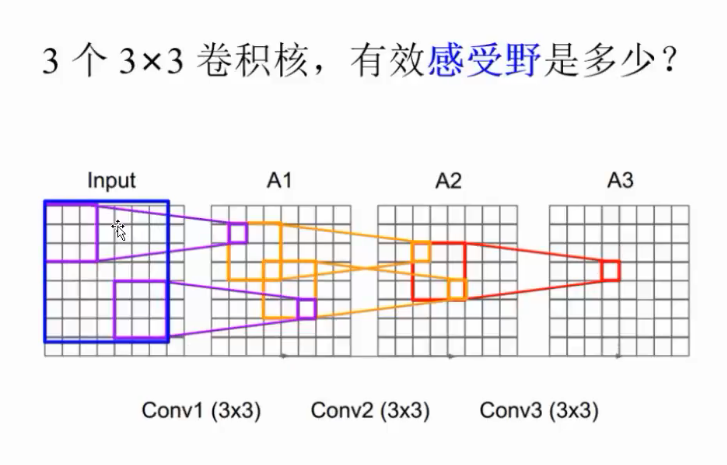
这样做有三个好处:
-
参数更少
在相同通道数下,多个 3×3 卷积的参数量通常低于单个大卷积核。比如一个 7×7 卷积相当于 49 倍通道平方级参数,而 3 个 3×3 卷积只有 27 倍。
-
非线性更强
每加一层 3×3 卷积就会多一次 ReLU,网络表达能力更强,能学习更复杂的特征。
-
结构更统一
AlexNet 第一层用 11×11,后面又有 5×5,结构比较杂;VGG 基本统一成 3×3 卷积 + 2×2 池化,模块感很强,后面很多骨干网络都受它影响。
也要看到 VGG 的代价
VGG 虽然结构更漂亮、特征提取能力更强,但参数量很大。VGG16 大约有 1.38 亿参数,其中大部分集中在最后的全连接层,所以显存占用和推理成本都比 AlexNet 高很多。
可以把它理解成:
AlexNet 证明了"深度 CNN 有用",VGG 则证明了"用统一的小卷积核不断加深网络,能进一步提升性能"。 再往后,ResNet 才真正解决了"网络太深反而难训练"的问题。
与GoogLeNet的对比
GoogLeNet 和 AlexNet、VGG 最大的区别不是"更深",而是从"堆层数"转向"设计模块" 。它用 Inception 模块 、1×1 卷积降维 、全局平均池化来让网络更深、更准,同时参数反而更少。
三者核心差异
| 维度 | AlexNet | VGG | GoogLeNet |
|---|---|---|---|
| 层数 | 8 层 | VGG16:16 层;VGG19:19 层 | 22 层 |
| 卷积核 | 11×11、5×5 等大核 | 几乎全部 3×3 | 1×1、3×3、5×5 并行 |
| 设计思路 | 加深 LeNet,证明 CNN 有效 | 用多个 3×3 堆叠获得更大感受野 | 用 Inception 模块做多尺度特征提取 |
| 参数量 | 约 6000 万 | 约 1.38 亿 | 约 500 万--700 万 |
| 尾部结构 | 大尺寸全连接层 | 大尺寸全连接层 | 用全局平均池化替代大 FC |
| 特点 | 引入 ReLU、Dropout、多 GPU | 结构统一、可复现、但参数多 | 高效、多尺度、参数少、结构复杂 |
GoogLeNet 最关键的三个升级
1. Inception 模块:并行多尺度卷积
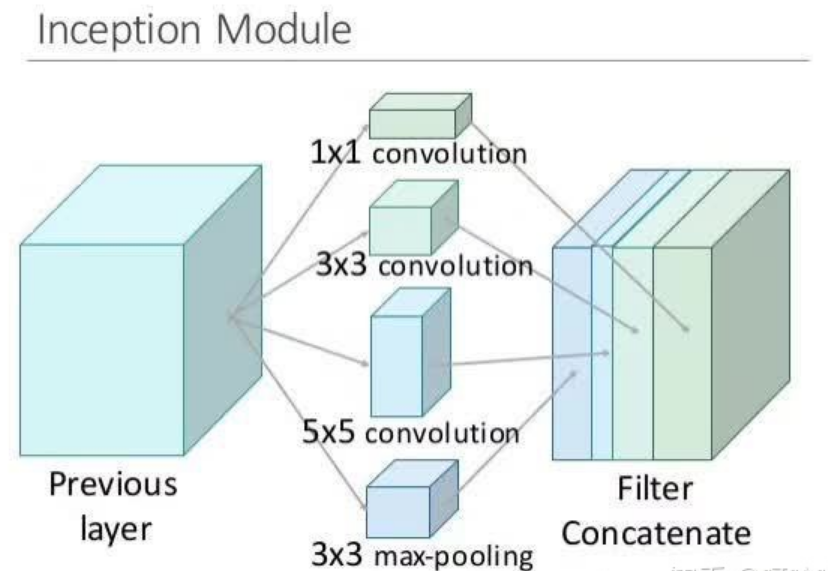
AlexNet 和 VGG 主要是串行堆叠卷积层:一层接一层。
GoogLeNet 则把一层设计成一个 Inception 模块,对同一个输入同时做:
- 1×1 卷积
- 3×3 卷积
- 5×5 卷积
- 3×3 最大池化
然后把这四路输出在通道维度上拼接起来。
这样网络就能在同一层同时捕获:
- 小尺度细节
- 中等尺度结构
- 大尺度上下文
- 显著性特征
相当于让网络自己选择"用多大感受野看这张图"。
2. 1×1 卷积:先降维,再计算
如果直接对很多通道做 5×5 卷积,计算量会很大。GoogLeNet 在 3×3、5×5 卷积之前先加 1×1 卷积做通道压缩。
比如输入 64 通道:
- 直接做 5×5 卷积:计算量很大;
- 先用 1×1 卷积压到 32 通道,再做 5×5:计算量大幅下降。
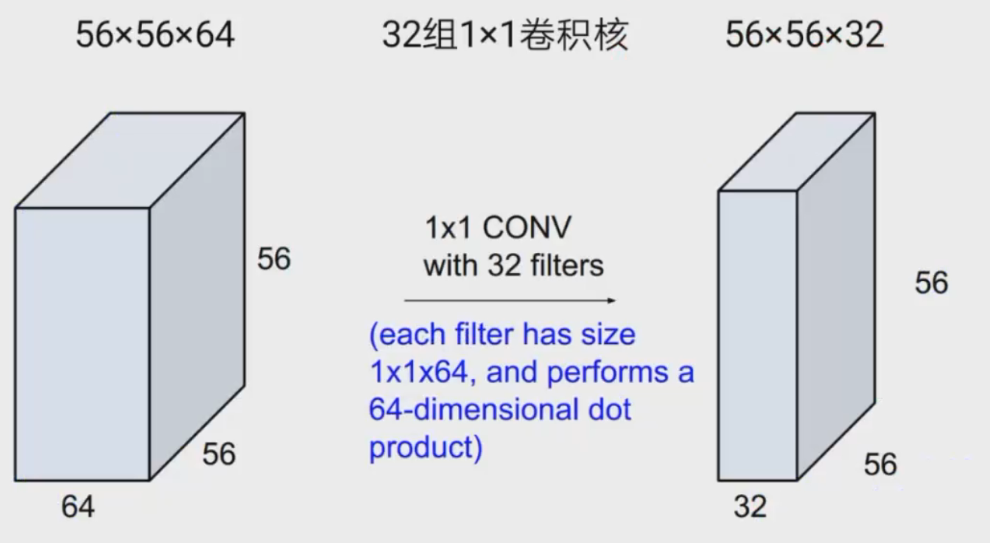
1×1 卷积还能增加非线性,因为后面还会接激活函数。
3. 全局平均池化替代全连接层
AlexNet 和 VGG 最后都有很大的全连接层,参数量非常夸张。VGG16 的全连接层就占了绝大多数参数。
GoogLeNet 最后不用大 FC,而是用 全局平均池化,把每个通道的特征图直接平均成一个值,再接分类层。
这就是它参数量只有几百万的重要原因。
一句话总结
- AlexNet:证明深度 CNN 可行;
- VGG:证明小卷积核堆深有效,但参数很重;
- GoogLeNet :证明结构设计和计算效率同样重要,用 Inception 模块和 1×1 卷积让网络既深又轻。
后面 ResNet 再解决"网络太深难训练"的问题,GoogLeNet 其实已经为"高效深度网络"打下了很重要的基础。
疑问
感受野与参数量是不一样的
32 = 27 这个数,在 VGG 里确实会反复出现,但它不是"感受野大小",而是:
3 个 3×3 卷积核里,每个核有 9 个权重,3 层一共 3 × 9 = 27 个权重系数。
先看感受野
感受野是指:输出上的一个点,能"看到"输入上多大的区域。
- 1 个 3×3 卷积:感受野 = 3
- 2 个 3×3 堆叠:感受野 = 5
- 3 个 3×3 堆叠:感受野 = 7
所以 VGG 说:
3 个 3×3 卷积堆叠,感受野 ≈ 1 个 7×7 卷积。
这里说的是"看得一样大",不是"参数一样多"。
再看参数量
假设输入通道数和输出通道数都是 C,并且只算卷积核权重,不算 bias。
一个 7×7 卷积层的参数量是:
7 × 7 × C × C = 49C²
三个 3×3 卷积层的参数量是:
3 × (3 × 3 × C × C) = 27C²
所以:
27C² < 49C²
也就是说,在获得相同 7×7 感受野的前提下,3 个 3×3 卷积比 1 个 7×7 卷积少约 45% 的参数。
如果考虑通道数,一个卷积核的参数量是:
kernel_h × kernel_w × in_channels × out_channels
所以 VGG 里"参数更少"的意思是:
用 3 个 3×3 达到和 1 个 7×7 相同的感受野,但权重参数从 49C² 降到 27C²。
而且每层后面都会接一次 ReLU,所以 3 个 3×3 还比 1 个 7×7 多了两次非线性变换,表达能力更强。
卷积核里的权重就是神经网络自己要学的参数
和全连接层里的权重本质一样的
它不是人写死的
传统图像处理里,卷积核可以是人工设计的,比如:
- 边缘检测核
- 模糊核
- 锐化核
这些值是工程师根据经验写好的,训练时不会变。
但在 CNN 里,卷积核的值一开始是随机初始化的,比如用 Xavier 或 He 初始化。
训练时怎么学
训练过程大致是:
- 初始化:给每个卷积核随机赋一组小数值。
- 前向传播:用这些卷积核对图像做卷积,得到特征图。
- 算损失:看模型预测和真实标签差多少。
- 反向传播:计算损失对每个权重的梯度。
- 更新权重:按梯度方向微调卷积核里的每个值。
反复很多轮以后,卷积核就不再是随机噪声了,会逐渐变成能提取边缘、纹理、形状等特征的"过滤器"。
一个 3×3 卷积核有多少权重?
如果输入有 C_in 个通道,输出有 C_out 个通道,那么一个卷积层会学:
C_out × C_in × 3 × 3 个权重
比如输入 3 通道、输出 16 通道、卷积核 3×3:
16 × 3 × 3 × 3 = 432 个权重
每个卷积核不是只有 9 个数,而是 9 × 输入通道数 个数。
所以可以把它理解成:
卷积核 = 一组可学习的权重矩阵,网络通过训练自动决定每个位置该取什么值。
在深度学习项目中,全联接层会更占内存吗?
要看说的"内存"是哪一种。按参数量/模型权重来看,卷积层通常远小于全连接层;但按训练时中间激活值来看,卷积层不一定少。
1. 参数量:卷积层通常比全连接层少很多
卷积层之所以参数少,是因为它共享卷积核权重:同一个 3×3 卷积核会在整张特征图上滑动复用。
全连接层则是每个输入维度都有独立权重,所以一旦输入维度很大,参数量会爆炸。
以 VGG16 为例,输入是 224×224×3:
- 总参数量约 1.38 亿
- 卷积层部分约 1470 万
- 全连接层部分约 1.236 亿
- 全连接层占参数量约 90%
尤其是第一个全连接层,输入是 7×7×512 = 25088,输出是 4096,仅这一层就有约 1.02 亿参数。
所以如果只看"模型权重占多少内存",你的直觉基本正确:卷积层参数少,全连接层参数多。
2. 训练显存:卷积层的激活值可能很大
训练时 GPU 显存不只存参数,还要存:
- 模型参数
- 每层输出的激活值
- 反向传播的梯度
- 优化器状态
其中激活值往往很占显存。
卷积层输出的是特征图,比如形状是:
[batch_size, channels, height, width]
如果分辨率高、batch size 大,激活值就会很大。比如前面几层卷积输出可能是 224×224×64,这种空间尺寸很大,激活值显存并不小。
而全连接层输出通常只是一个一维向量,比如 4096 维,激活值本身不大;但它前面的权重矩阵非常大,所以参数显存高。
3. 可以这样记
| 比较维度 | 卷积层 | 全连接层 |
|---|---|---|
| 参数量 | 少,因为权重共享 | 多,每个输入都有独立权重 |
| 参数显存 | 通常较小 | 通常较大 |
| 激活值显存 | 可能很大,尤其高分辨率时 | 通常较小 |
| 计算量 | 可能很高,因为要在空间上滑动 | 取决于输入维度 |
所以更准确的说法是:
卷积层的参数量和参数显存通常远小于全连接层;但卷积层在训练时产生的中间激活值可能很多,尤其输入图像分辨率高、batch size 大时,显存占用不一定低。
这也是为什么后来很多网络,比如 ResNet、GoogLeNet,会用全局平均池化替代大尺寸全连接层,能显著减少参数量。
上面说的中间激活值是什么?
中间激活值就是网络前向传播时,每一层算出来的"输出结果"。
用一个例子理解
假设输入一张 224×224×3 的图片,经过第一层卷积后,输出可能是 112×112×64 的张量。这个张量就是第一层的激活值。
它会被送到第二层继续计算,第二层又输出一个新的张量------这就是第二层的激活值。
一层一层往下传,每一层都会产生一个"中间结果",这些就是中间激活值。
为什么训练时要存下来?
因为反向传播需要它们。
反向传播计算梯度时,要用到前向传播时每一层的输出。如果前向时没存,反向就没法算。所以训练过程中,所有层的激活值都要同时留在显存里,直到反向传播结束才能释放。
为什么卷积层的激活值可能很大?
卷积层输出的是三维特征图(高 × 宽 × 通道数),比如:
112 × 112 × 64 = 802,816个数值
如果 batch size 是 32,那这一层的激活值就有:
802,816 × 32 ≈ 2569 万个数值
按 FP32(4 字节)算,约 100 MB,仅一层就占这么多。
而全连接层输出只是一个一维向量,比如 4096 维,激活值本身很小。
总结
| 卷积层 | 全连接层 | |
|---|---|---|
| 参数量 | 少(权重共享) | 多(每个输入独立权重) |
| 激活值 | 可能很大(空间分辨率高) | 通常很小(一维向量) |
所以之前说的"卷积层显存不一定少",指的是激活值显存,不是参数显存。
卷积核的通道数和上一层的通道数是一样的,卷积核的组数能够改变其通道数,对吗?
理解基本方向是对的,但要分两种情况看。
1. 普通卷积:卷积核通道数 = 输入通道数
在标准卷积里:
- 每个卷积核的通道数必须等于上一层输出的通道数;
- 卷积核的个数决定输出通道数。
比如输入是 64 通道,用 128 个 3×3 卷积核:
- 每个卷积核形状是
3 × 3 × 64; - 输出就是
128通道。
所以这里你说的"卷积核的通道数和上一层的通道数一样"是对的。
2. 分组卷积:卷积核通道数不一定等于完整输入通道数
如果用了 分组卷积 groups > 1,就不一样了。
假设输入 64 通道,输出 128 通道,groups=4:
- 输入被分成 4 组,每组
16通道; - 每组卷积核只负责对应的那
16个输入通道; - 所以每个卷积核的通道数是
64 / 4 = 16,而不是完整的64。
这时可以说:通过改变组数,确实可以改变每个卷积核实际连接的通道数。
更准确的总结
| 情况 | 卷积核通道数 | 输出通道数 |
|---|---|---|
| 普通卷积 | 等于输入通道数 | 等于卷积核个数 |
| 分组卷积 | 等于 输入通道数 / groups |
仍等于卷积核个数 |
| 深度可分离卷积 | 每组只处理 1 个通道 | 取决于后面逐点卷积 |
所以更严谨的说法是:
普通卷积中,单个卷积核的通道数等于输入通道数;输出通道数由卷积核个数决定。分组卷积中,每个卷积核只连接输入的一部分通道,组数会影响每个卷积核实际处理的通道数。