摘要:分布式系统里一个弱依赖抖动就可能引发整条链路雪崩。本文以 Sentinel 为例,先用雪崩链路讲清服务容错为什么必要,再逐层拆解其核心模型(Resource + Slot Chain + LeapArray 滑动窗口),随后给出限流、熔断降级、热点参数限流与系统自适应的可落地代码与参数对照表,最后按"服务提供方 / 调用方"分角色给出生产最佳实践,帮你把容错真正落到代码里。
导语
你有没有遇到过这样的故障:某个下游接口突然变慢,调用它的服务线程越堆越多,慢慢连带着上游一起超时,最后整个核心链路不可用,重启都来不及------这就是典型的雪崩效应。
在微服务架构里,服务之间彼此调用是常态。任何一个节点不稳定,都会沿着调用链被一层层放大。想让系统"局部坏、整体活",就得在服务之间布防。本文不讲空泛理论,直接拿 Sentinel 把限流、熔断、降级三件事做一遍,配代码、配参数表,照着抄就能用。
声明:本文基于个人使用体验,非商业推广。
一、为什么需要服务容错:从雪崩效应说起
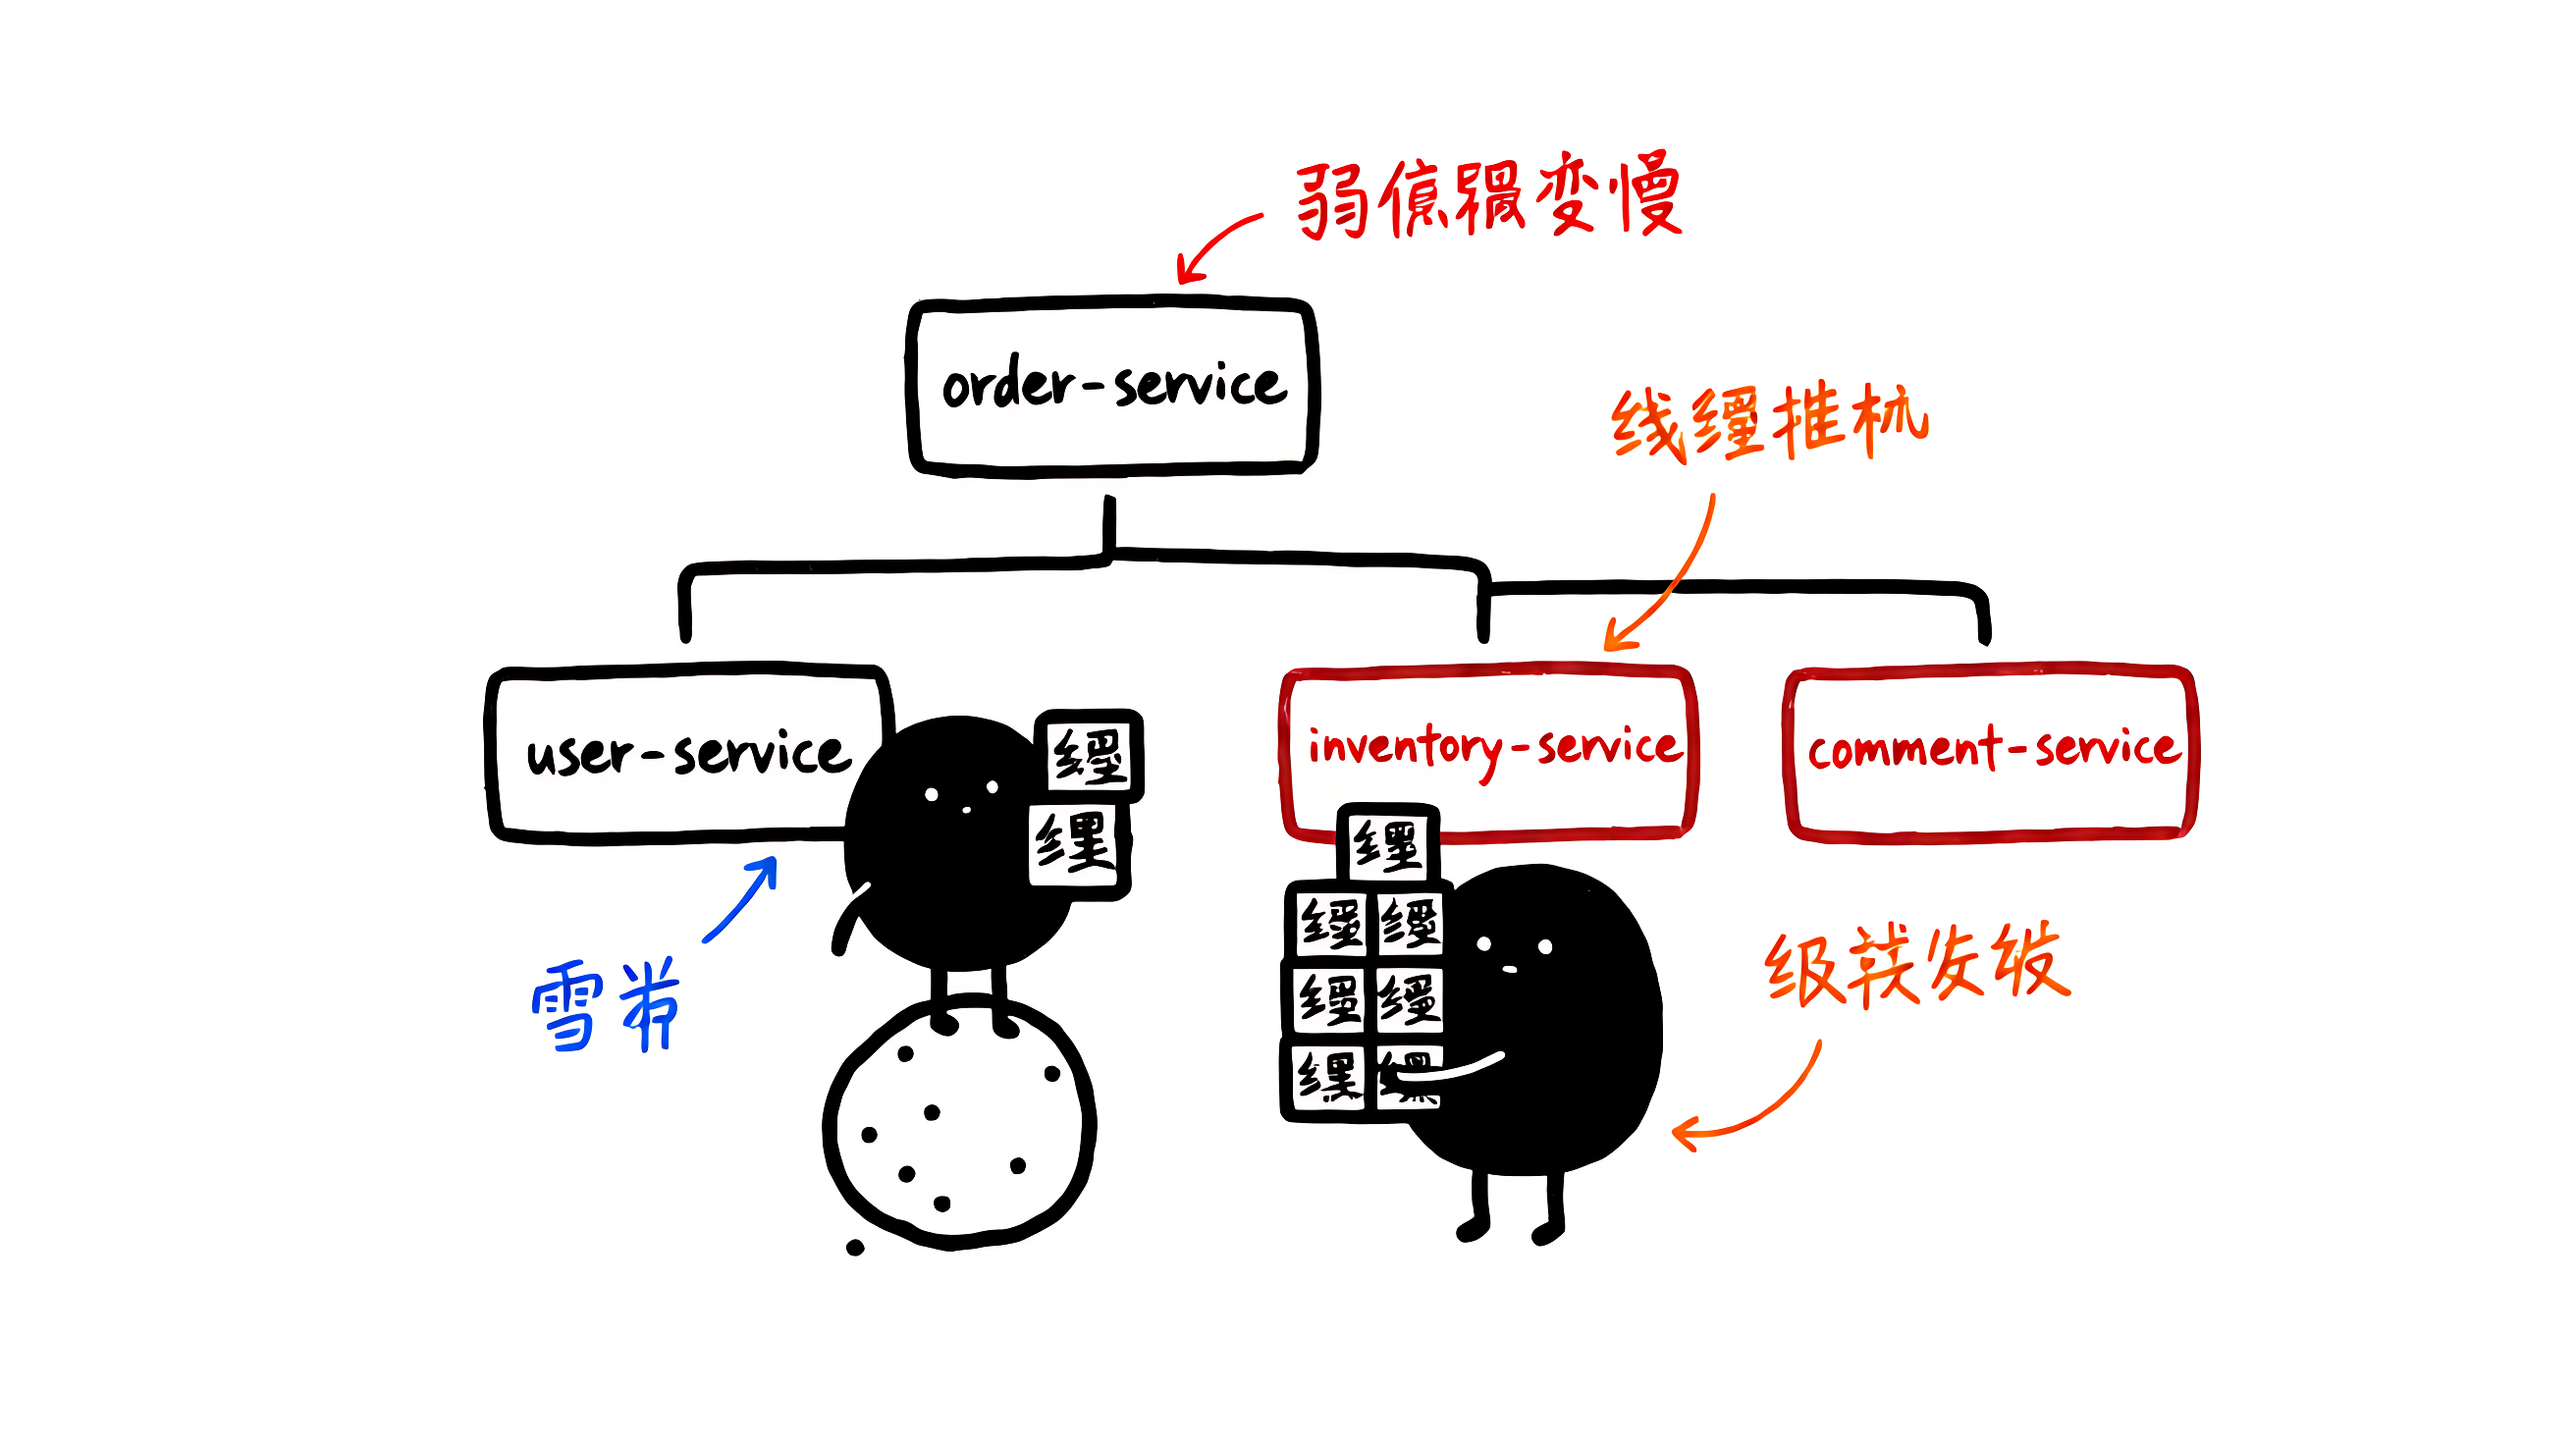
分布式系统由一堆相互调用的服务组成,调用关系天然是一棵"调用树"。当其中一个弱依赖(比如商品详情里的库存查询、评论服务)响应变长,灾难是这样传导的:
text
machine-root(机器入口)
   └─ order-service(订单入口)
        ├─ user-service       ← 正常
        ├─ inventory-service  ← 变慢/异常
└─ comment-service ← 变慢调用方为等下游返回会一直占用线程。下游越慢,占用线程越多,直到调用方的线程池 / 连接池被耗尽,于是连本来健康的接口也拿不到线程,自身彻底不可用。一个点的慢,最终拖垮一片。
雪崩的根因可以归纳成一条链:
text
弱依赖响应变长
   → 调用方线程堆积
   → 线程池 / 连接耗尽
   → 调用方自身不可用
   → 上游继续被拖垮(级联失败)
应对这种问题,工程上沉淀出"服务容错三板斧":
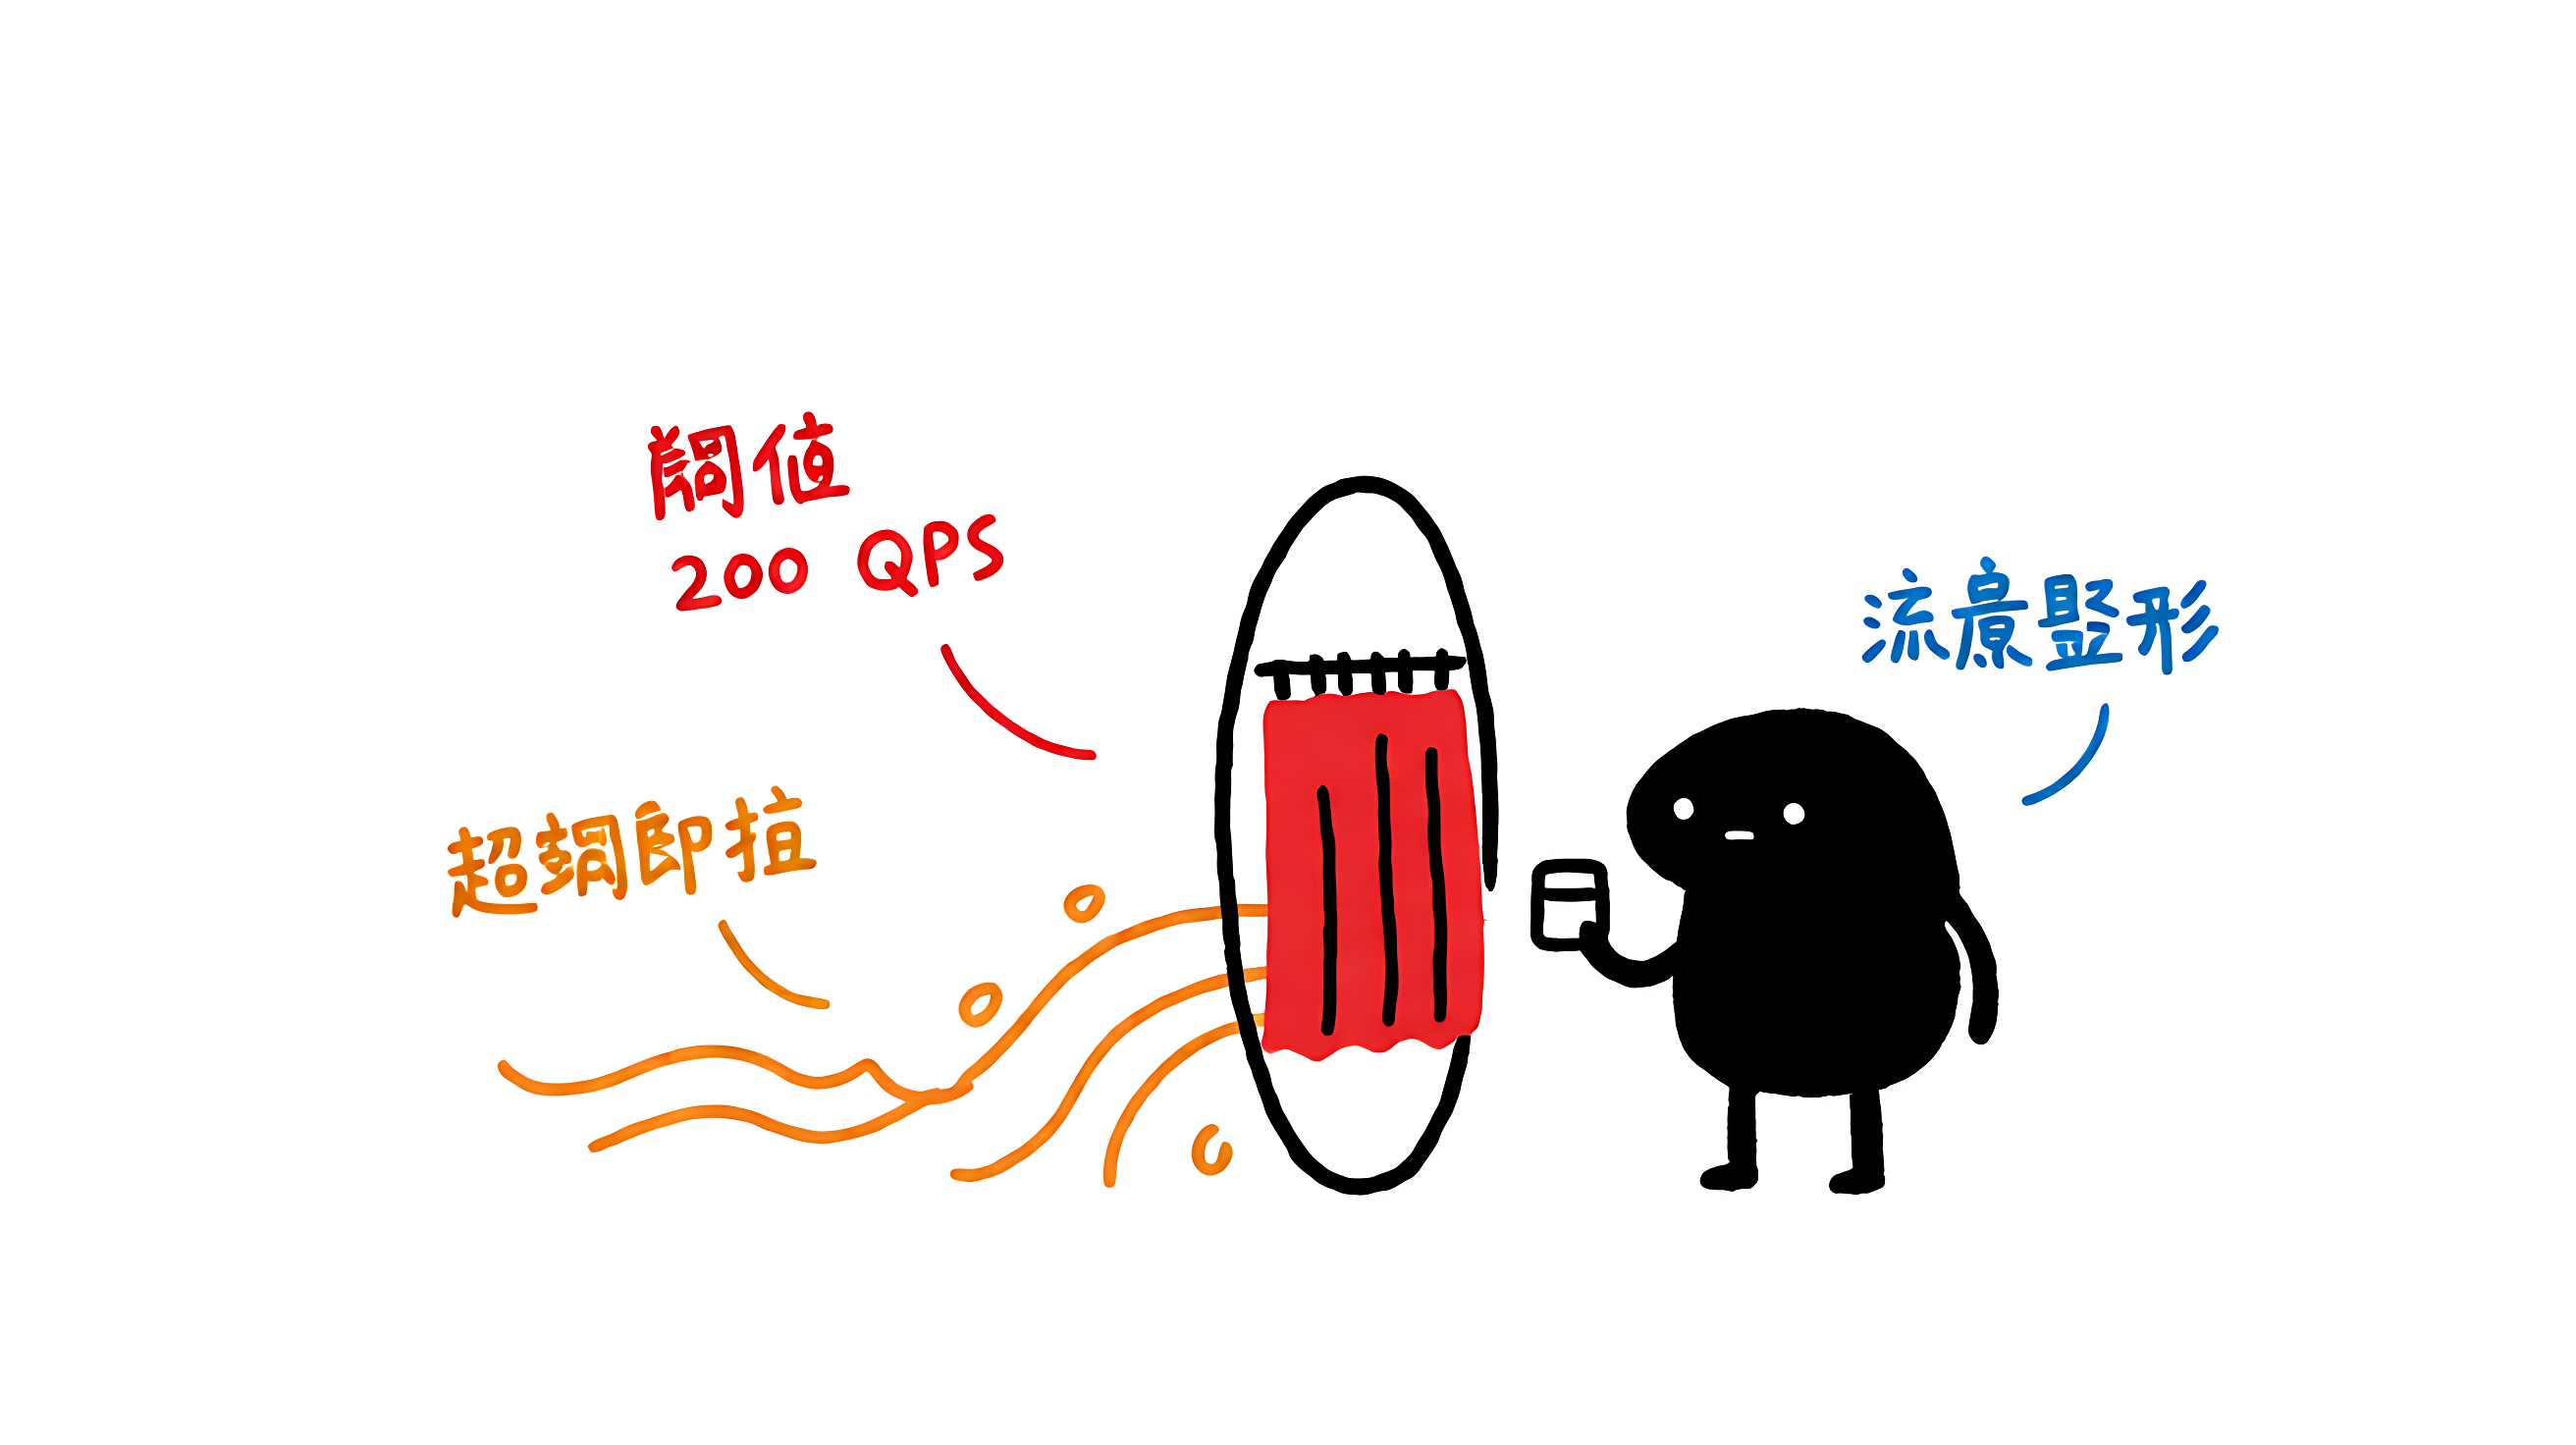
- 限流:控制入口流量形状,不让洪峰打垮自己(管"进来的量")。
- 隔离:用信号量 / 线程池把不稳定调用圈起来,避免挤占正常资源。
- 熔断降级:发现某个依赖已经不可靠,直接切断并走降级逻辑,不再无谓等待。
这套组合拳的目标只有一句话:在局部不稳定的时候,避免整体雪崩。
二、Sentinel 是什么:核心模型与工作原理
Sentinel 的核心抽象是 Resource(资源):一个服务、一个方法、甚至一段代码块,只要"埋点"标记成资源,就能套用保护规则。你可以把它理解成"被保护的对象"。
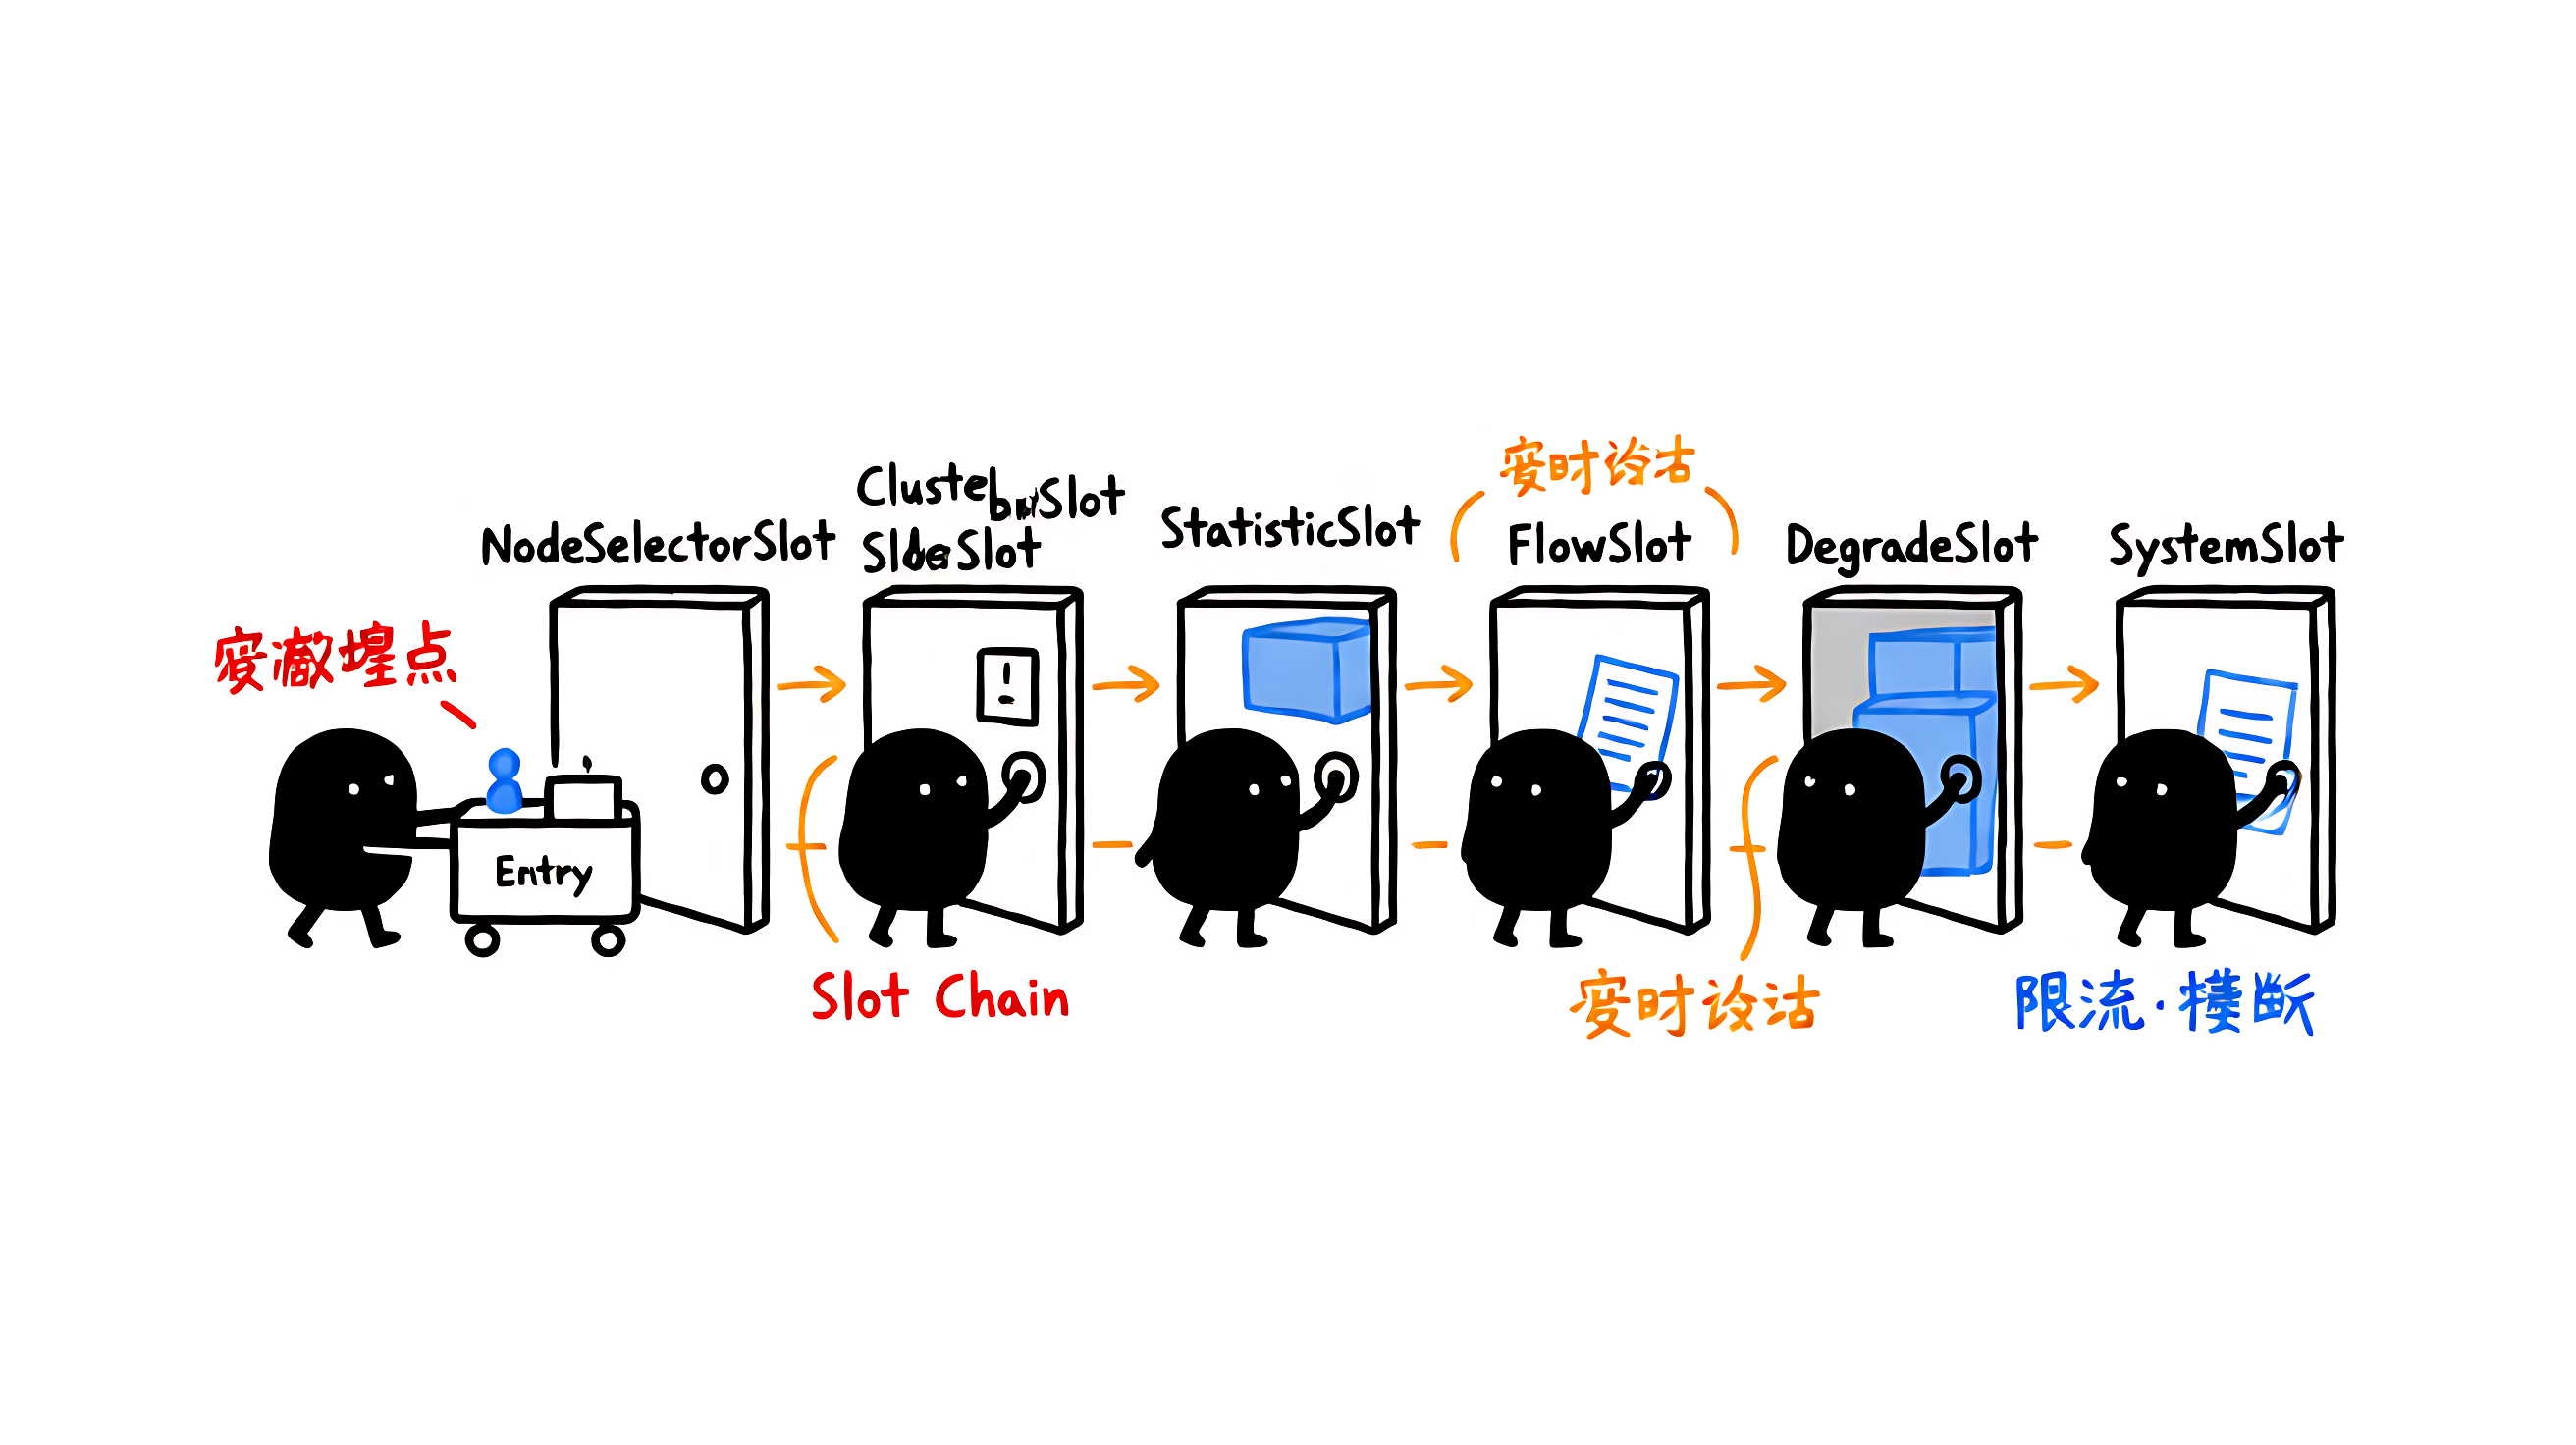
调用资源时,Sentinel 会创建一个 Entry ,而每次创建 Entry 都会同时构建一整套功能插槽(Slot Chain),按顺序各司其职:
text
ContextUtil.enter → SphU.entry
        │
        ▼  Entry 创建时构建 Slot Chain
┌──────────────────────────────────────────┐
│ NodeSelectorSlot   构建资源的调用路径树    │
│ ClusterBuilderSlot 构建集群节点统计信息    │
│ StatisticSlot     实时统计指标(QPS/RT...)  │
│ FlowSlot          执行限流规则             │
│ DegradeSlot       执行熔断降级规则         │
│ SystemSlot        系统自适应保护           │
└──────────────────────────────────────────┘
        │
        ▼  entry.exit() 释放
几个关键插槽:
- NodeSelectorSlot:维护每个资源的调用路径(调用树),用于实现链路限流。
- ClusterBuilderSlot:维护集群维度的统计节点。
- StatisticSlot:在运行时实时收集 QPS、线程数、响应时间、异常数等指标。
- FlowSlot / DegradeSlot / SystemSlot:分别对应限流、熔断、系统保护三类规则。
埋点的最小骨架是这样的:
java
try (Entry entry = SphU.entry("createOrder")) {
    // 被保护的业务逻辑
    doCreateOrder();
} catch (BlockException e) {
    // 被限流 / 熔断时进入这里,返回降级结果
    return fallback();
}
底层指标统计用了一个高性能数据结构 LeapArray(滑动窗口)。它把 1 秒切成多个时间窗,每个请求落到对应窗里累加,规避了"固定窗口"在窗口临界点的计数跳变问题(比如第 59 秒末和第 0 秒初各来一波,固定窗口会误判不超限,滑动窗口则能平滑反映真实速率)。这也正是它能在高并发、写多读少的场景下保持低开销的原因。
三、限流实战:流量控制(FlowSlot)
限流是 Sentinel 用得最多的能力,由 FlowRule 定义。两个最关键的维度:
1. 阈值类型 grade
0= 并发线程数(保护线程不被耗尽,本质是信号量隔离)1= QPS(按每秒请求数,最常见)
2. 控制行为 controlBehavior(达到阈值后怎么办)
| 行为 | 常量 | 对应算法 | 适用场景 |
|---|---|---|---|
| 直接拒绝 | CONTROL_BEHAVIOR_DEFAULT |
计数器 | 已压测出明确水位,超了就挡 |
| 冷启动 | CONTROL_BEHAVIOR_WARM_UP |
令牌桶预热 | 低水位突增流量(如刚重启、大促预热) |
| 匀速排队 | CONTROL_BEHAVIOR_RATE_LIMITER |
漏桶 | 间隔性突发流量(如消费消息队列) |
一个 QPS + 冷启动的限流配置:
java
List<FlowRule> rules = new ArrayList<>();
FlowRule rule = new FlowRule();
rule.setResource("createOrder");                  // 资源名
rule.setGrade(RuleConstant.FLOW_GRADE_QPS);      // 按 QPS 限流
rule.setCount(200);                              // 单机阈值 200 QPS
rule.setControlBehavior(RuleConstant.CONTROL_BEHAVIOR_WARM_UP);
rule.setWarmUpPeriodSec(10);                     // 10 秒内从低水位升到阈值
rules.add(rule);
FlowRuleManager.loadRules(rules);                // 规则实时生效
除了基础阈值,Sentinel 还支持基于调用关系的限流:
- 按调用方
limitApp:default(不区分来源)、指定origin、或other。生效优先级是origin > other > default------也就是说,配置了特定来源的限流后,特定来源走自己的阈值,其余来源走other,都没命中的话走default。 - 链路限流
CHAIN:只统计从某个特定入口进来的流量,避免被无关入口污染。 - 关联限流
RELATE:当"读"和"写"竞争同一资源时,可以让写优先、限制读,保护写入路径。
运行期想看实时指标,Sentinel 在本地开了端口,直接 curl 就能拿到:
bash
curl localhost:8719/cnode?name=createOrder返回里重点关注几个字段:thread(当前并发线程)、pass(通过数)、blocked(被拦截数)、rt(平均响应时间)。blocked 持续上涨说明阈值偏紧,可调大 count;rt 偏高则要回头查下游。
被限流时 Sentinel 会抛 FlowException(它是 BlockException 的子类),在 catch 里写降级逻辑即可,如上面埋点骨架所示。
四、熔断降级实战(DegradeSlot)
限流管"入口流量",熔断管"切断不稳定依赖"。当某个下游失败率或慢调用比例过高时,与其反复超时等待,不如先熔断一段时间,直接走降级。
Sentinel 1.8.0 起提供三种熔断策略:
| 策略 | 常量 | 含义 | 阈值范围 |
|---|---|---|---|
| 慢调用比例 | DEGRADE_GRADE_RT |
响应超过临界值的调用占比超标即熔断 | count=RT 临界值(ms) |
| 异常比例 | DEGRADE_GRADE_EXCEPTION_RATIO |
异常调用占比超标即熔断 | 0,1 |
| 异常数 | DEGRADE_GRADE_EXCEPTION_COUNT |
统计窗口内异常数超标即熔断 | 整数 |
熔断器是一个典型状态机:
text
        错误率/慢调用超阈值
   ┌──────────┐  ───────────────►  ┌──────────┐
   │  Closed  │                    │   Open   │
   │ (正常) │  ◄───────────────  │(已熔断)│
   └──────────┘   探测成功          └──────────┘
        ▲   │ 探测请求                     │  timeWindow 后
        │   │                             ▼
        │   │                       ┌──────────┐
        │   └───────────────────────│ Half-Open│
        │       探测失败再熔断        │(探测中)│
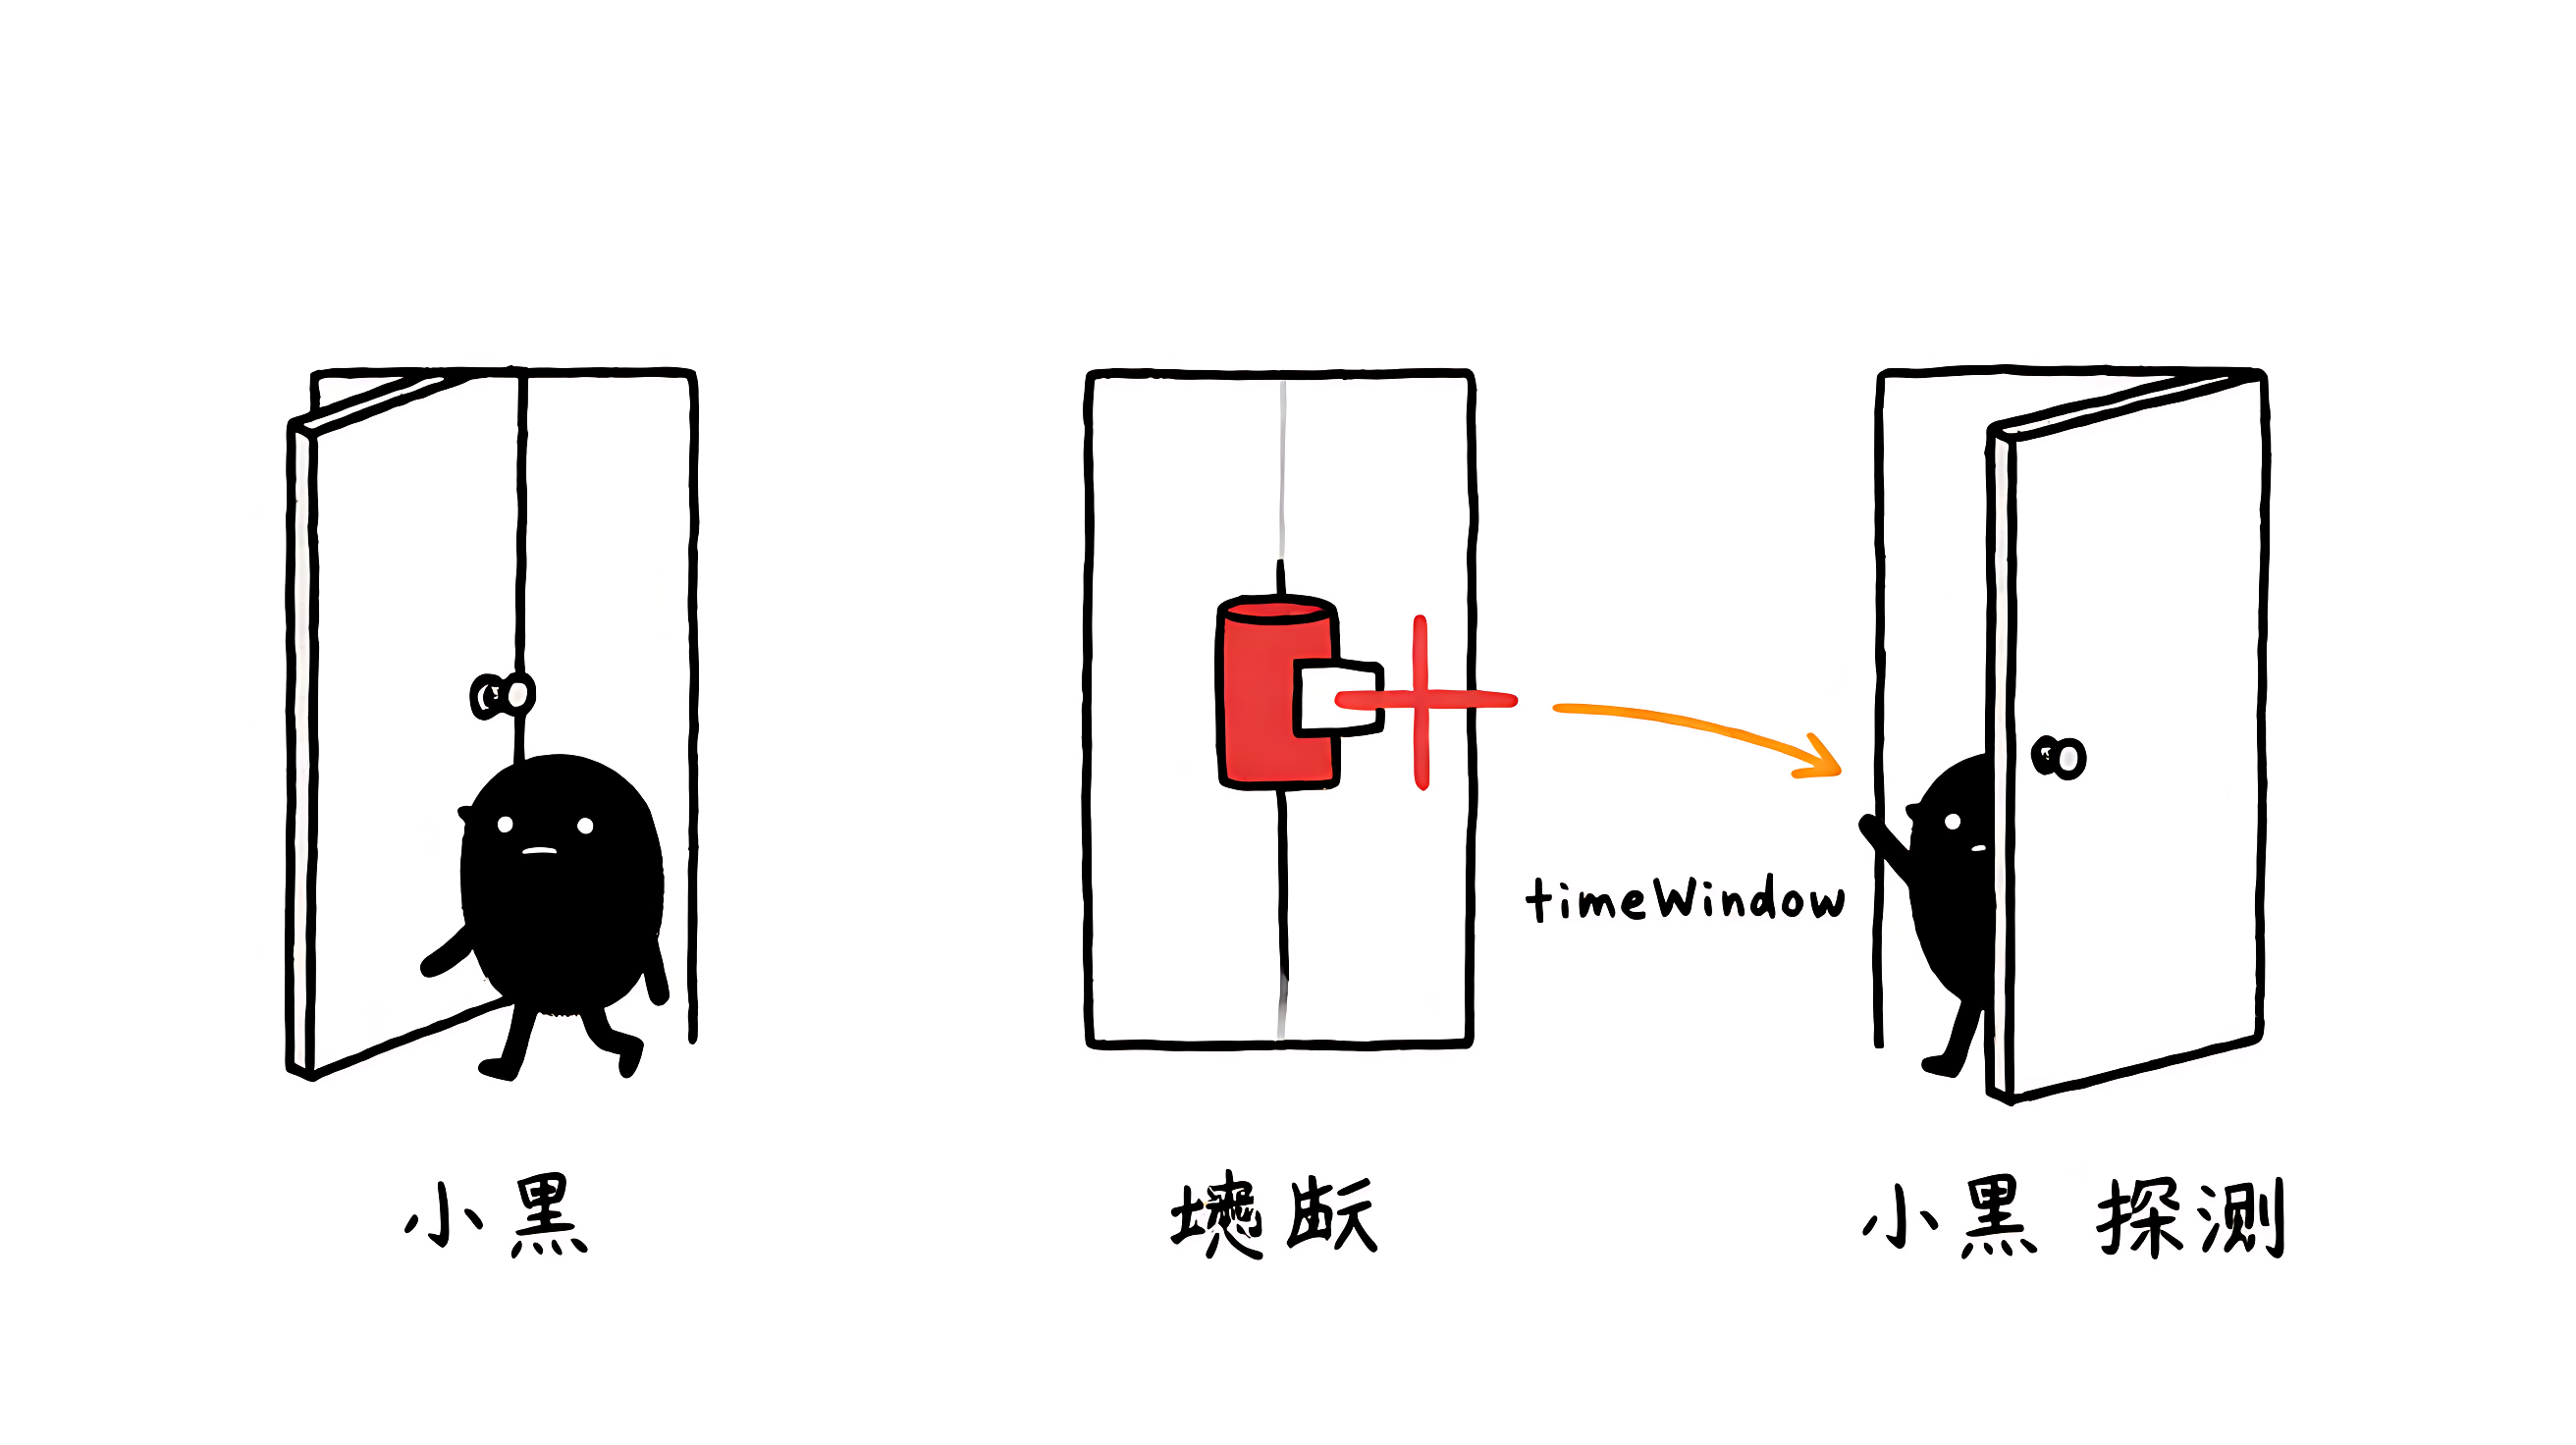
│ └──────────┘- Closed:正常放行,持续统计指标。
- Open :达到阈值触发熔断,
timeWindow秒内所有请求直接失败走降级。 - Half-Open:熔断时长过后放一个探测请求,成功则回到 Closed,失败则重新进入 Open。
慢调用比例的一个示例配置:
java
List<DegradeRule> rules = new ArrayList<>();
DegradeRule rule = new DegradeRule("queryProduct")
    .setGrade(RuleConstant.DEGRADE_GRADE_RT)  // 慢调用比例策略
    .setCount(300)          // 响应超过 300ms 算"慢调用"
    .setSlowRatioThreshold(0.5)  // 慢调用占比超过 50%
    .setMinRequestAmount(5)      // 统计窗口内最少请求数,低于则不熔断
    .setStatIntervalMs(10000)    // 统计窗口 10 秒
    .setTimeWindow(10);          // 熔断 10 秒后进入半开探测
rules.add(rule);
DegradeRuleManager.loadRules(rules);
几个核心参数要记牢:
| 字段 | 含义 | 说明 |
|---|---|---|
count |
慢调用 RT 临界值 / 异常阈值 | 慢调用策略下单位是 ms |
timeWindow |
熔断时长 | 单位秒 |
minRequestAmount |
最小请求数 | 低于它不触发熔断,避免低流量误判 |
statIntervalMs |
统计时长 | 单位毫秒 |
slowRatioThreshold |
慢调用比例阈值 | 1.8.0+ 引入 |
注意:业务异常不会自动计入熔断统计 。只有 BlockException 之外的业务异常,需要你主动用 Tracer.trace(t) 记录,否则熔断器看不到异常、不会触发。如果用了 Sentinel 的适配模块(Dubbo、Spring Web 注解等),这部分通常会自动处理。
五、进阶能力:热点参数限流与系统自适应保护
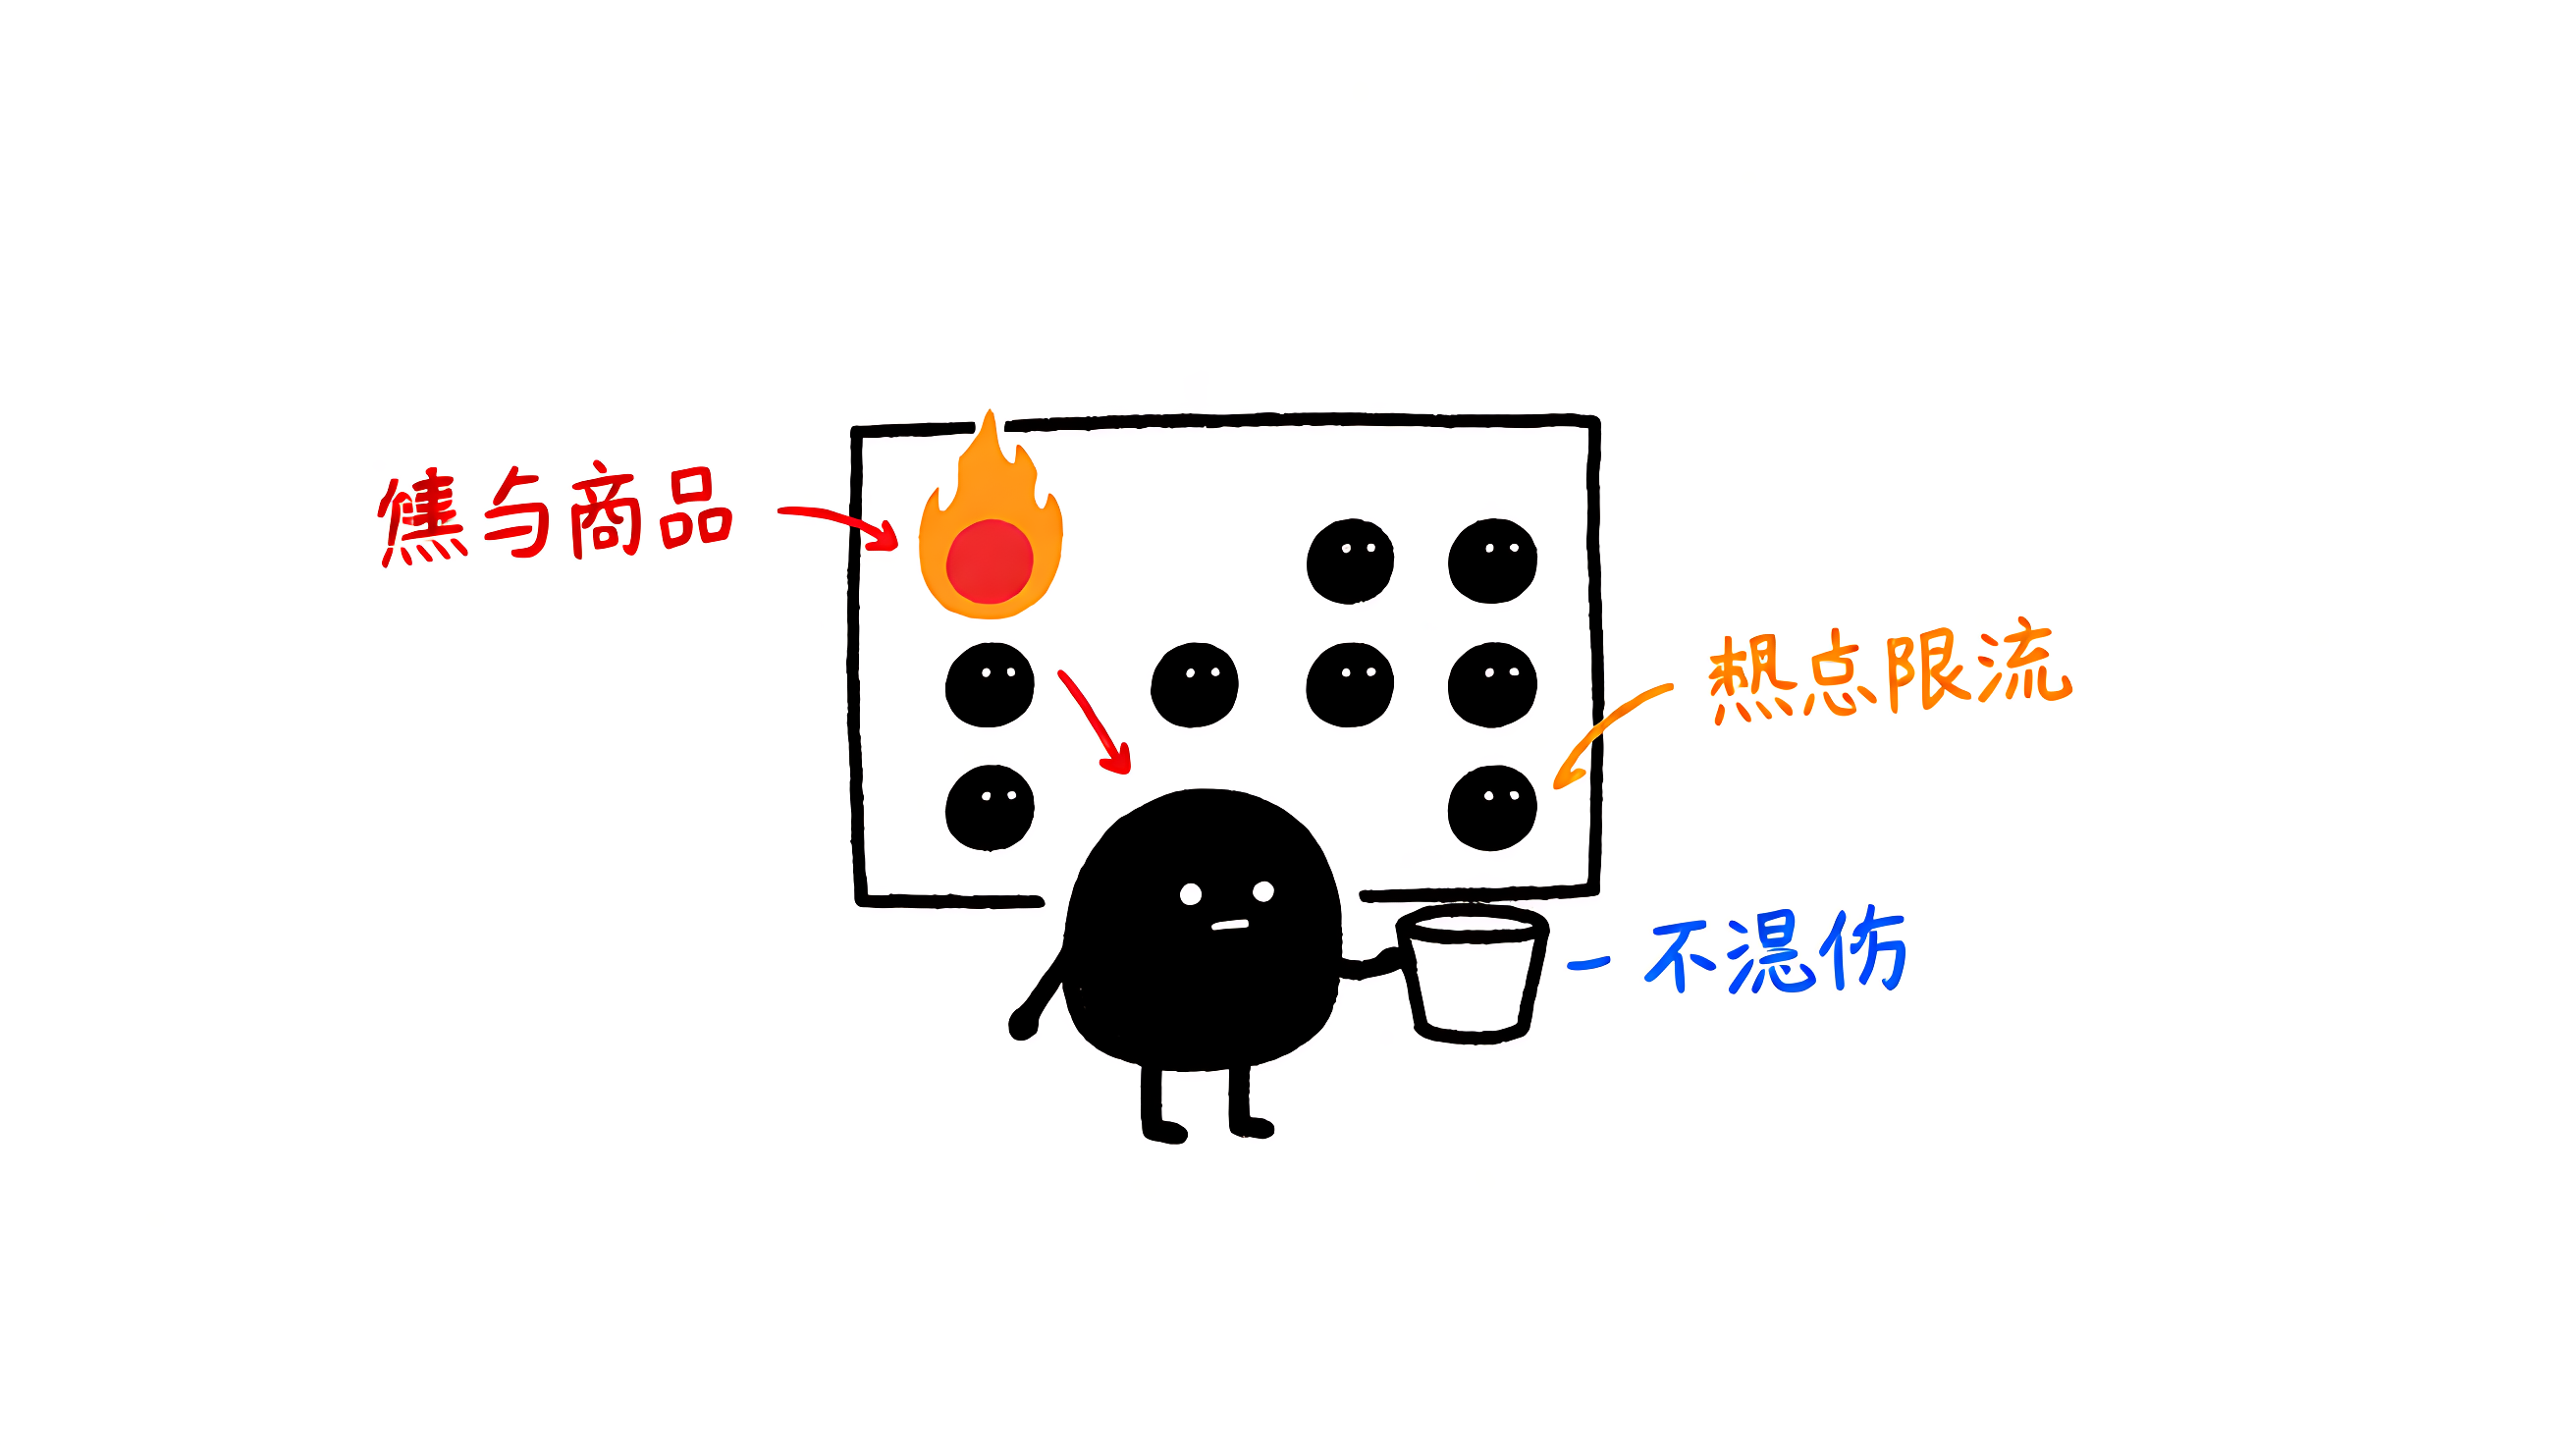
当限流粒度要细到"参数"级别时,基础限流就不够了。典型场景是"黑马商品"------某个爆款 itemId 被疯狂访问,把缓存击穿打挂数据库,而其它商品其实很正常。
热点参数限流用 LRU 识别最近最常访问的 Top-K 参数,结合令牌桶算法做参数级流控:
java
ParamFlowRule rule = new ParamFlowRule("getItemById")
    .setParamIdx(0)                          // 对第 0 个参数(itemId)限流
    .setGrade(RuleConstant.FLOW_GRADE_QPS)
    .setCount(100);                          // 单个热点参数 100 QPS
ParamFlowRuleManager.loadRules(Collections.singletonList(rule));

// 埋点时把参数传进去,Sentinel 才能识别热点
try (Entry entry = SphU.entry("getItemById", EntryType.IN, 1, itemId)) {
    return itemRepository.get(itemId);
} catch (BlockException e) {
    return cachedOrFallback(itemId);
}
这样即使某个 itemId 被打爆,也只限制它自己,不会误伤其它商品。
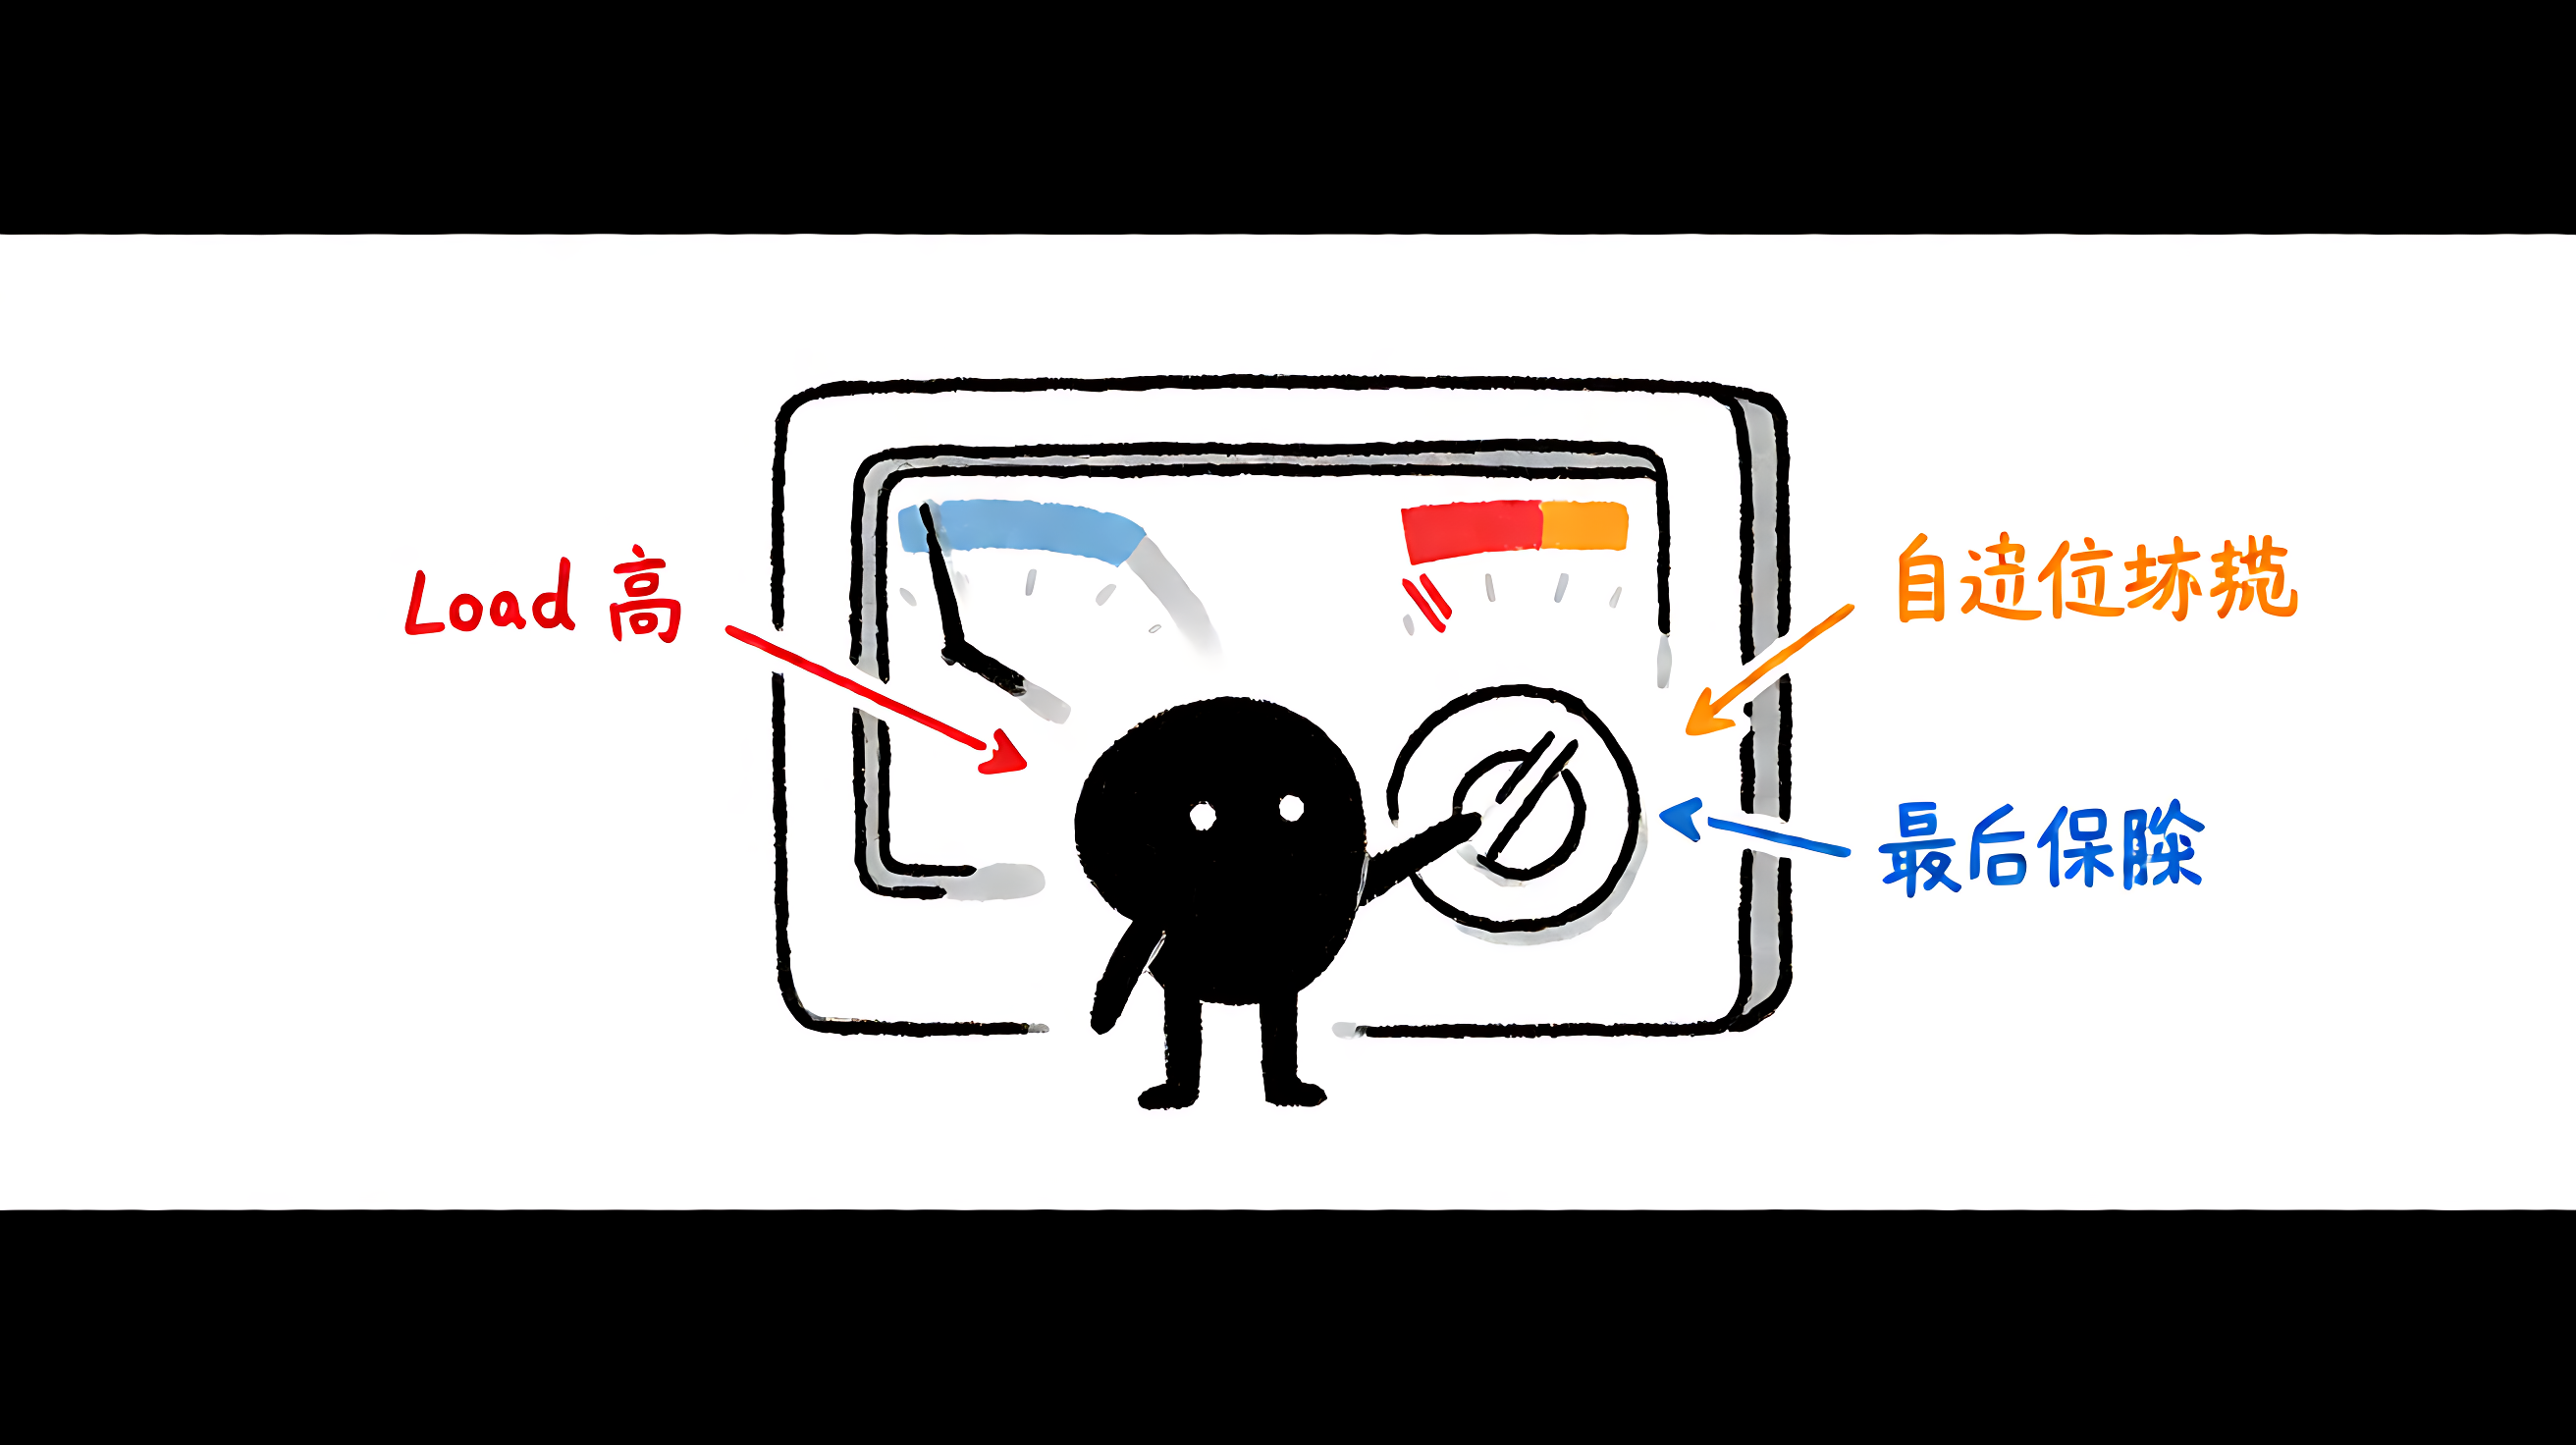
**系统自适应保护(SystemSlot)**则是全局兜底:它综合机器的 Load、CPU 使用率、以及入口的 QPS / RT / 并发线程数,自适应地调节入口流量。简单说,当系统自身快扛不住时,不管单条规则怎样,整体先收缩,等负载降下来再恢复。它适合放在最外层做"最后一道保险",而不是替代单资源的限流熔断。
六、生产落地最佳实践
光会配规则不够,落地的关键点在于"谁在布防"。
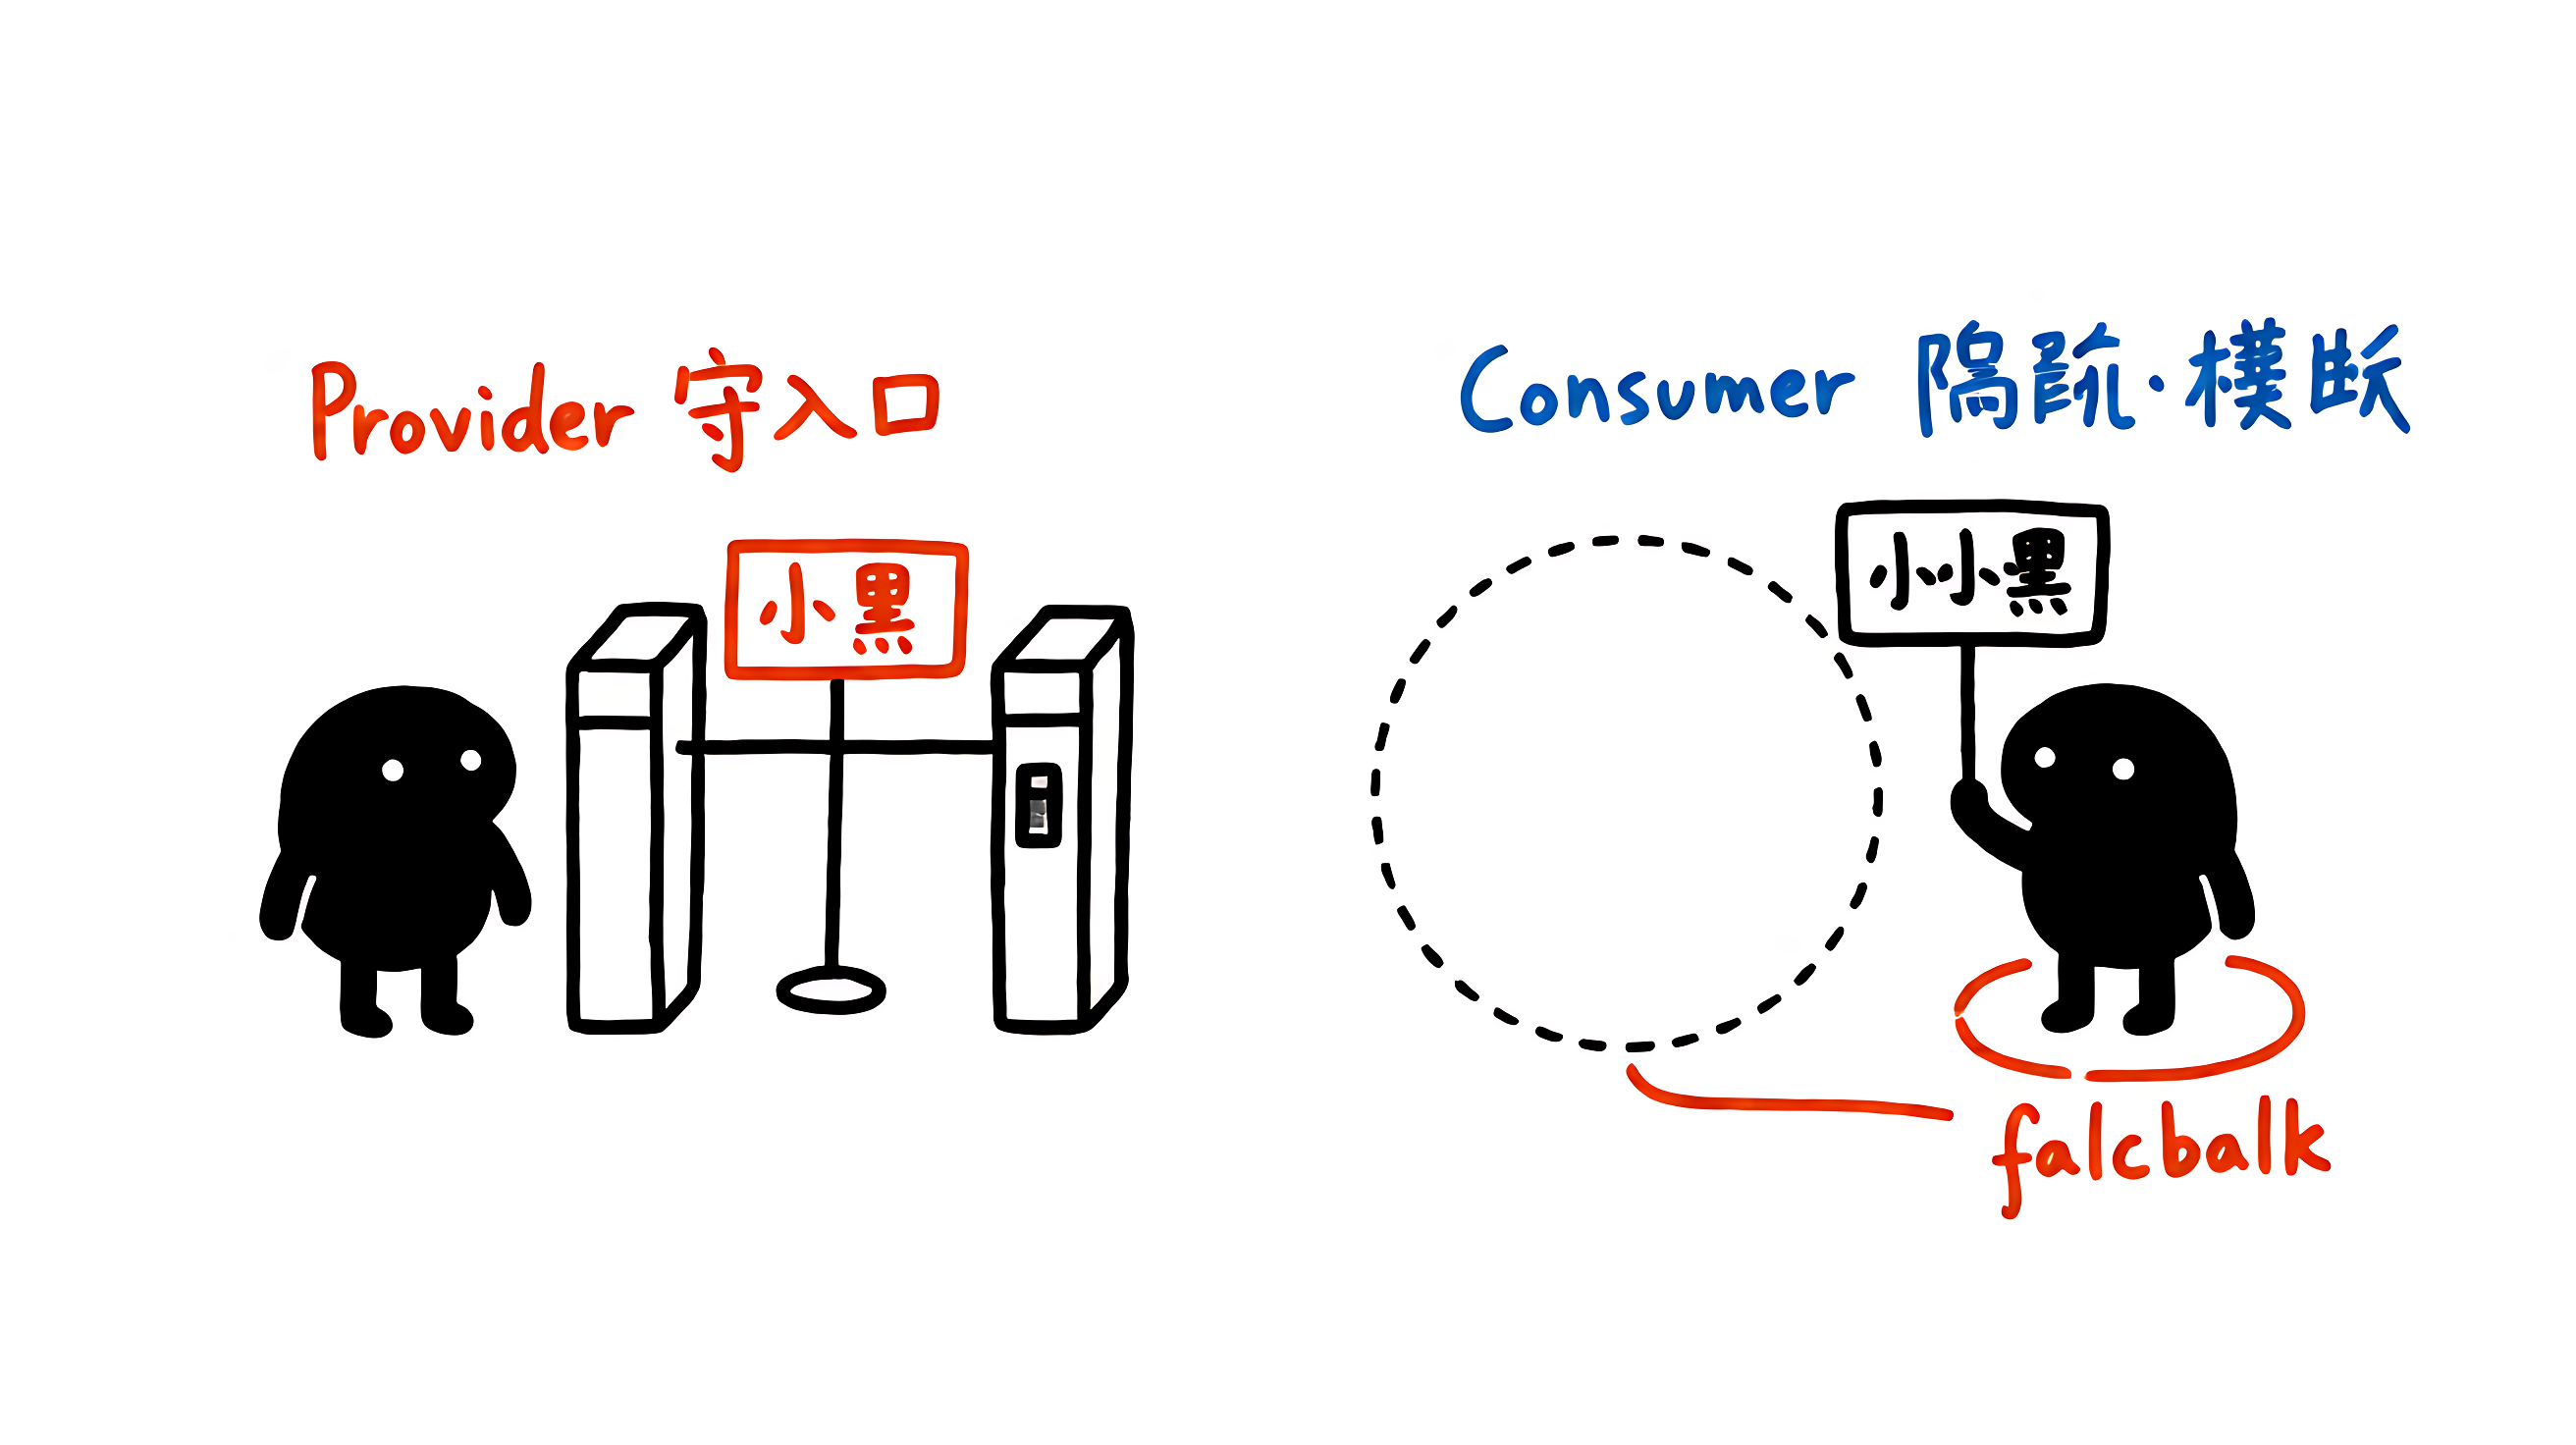
服务提供方(Provider):按自己的处理能力做 QPS 模式限流。明确知道单机容量后,超出阈值的请求直接拒绝,保护自己不被流量洪峰打垮。Provider 不关心是谁在调,只守住入口。
服务调用方(Consumer):重点防"被不稳定依赖拖垮"。两件事:
- 用信号量隔离(并发线程数限流)限制慢调用占用的线程,避免一个慢下游把调用方线程吃光;
- 给不稳定依赖配熔断降级 ,异常 / 慢调用超阈值后自动熔断,走
fallback返回降级结果。
一个调用方视角的防护与降级:
java
public Product queryProduct(long id) {
    try (Entry entry = SphU.entry("queryProduct")) {
        return productClient.get(id);            // 可能变慢/异常的下游
    } catch (BlockException e) {
        // 被熔断或限流:返回降级结果,别让调用方干等
        return Product.degraded(id);
    } catch (Throwable t) {
        Tracer.trace(t);                          // 记录业务异常,参与熔断统计
        return Product.degraded(id);
    }
}
这里有几条务必遵守的生产经验:
- 熔断不能替代超时。即便接了熔断器,HTTP / RPC 客户端仍必须配置请求超时,否则 Half-Open 探测也可能被一个长连接卡死。
- 熔断只适合弱依赖。核心链路上的强依赖走降级要想清楚返回什么,别返回错误数据。
- 规则要能动态调 。硬编码
loadRules只能重启改。生产环境建议接 Sentinel Dashboard 或 Nacos 等数据源,规则实时下发,不用发版。
七、总结
服务容错的本质,是在"局部一定会出问题的分布式系统"里,保证整体尽量可用。Sentinel 以"流量"为切入点,用统一的 Slot Chain 把限流、熔断、系统保护串在一起,是云原生微服务容错里非常成熟的组件。
记住三件事的分工:限流管"入口形状",熔断管"切断不稳定依赖",隔离管"圈住故障范围"。三者配合,再加上客户端超时兜底,才能从工程上真正防住雪崩。
落到代码上的顺序建议(可直接照做):
- 先对核心接口压测定水位;
- Provider 按容量做 QPS 限流,超阈即拒;
- Consumer 对弱依赖做信号量隔离 + 熔断降级 + fallback;
- 接 Dashboard / Nacos 数据源,让规则可动态实时调整。
把这几步做完,你的服务就从"一坏全坏"变成了"坏一点、整体还在"。
关于 Sentinel 如何解决微服务雪崩、从限流到熔断的完整落地思路,CSDN 上有一篇同主题实战梳理可作为补充阅读:微服务容错:Sentinel,解决服务雪崩问题。
参考资料
- Sentinel 官方文档:https://sentinelguard.io/zh-cn/docs/introduction.html
- Sentinel GitHub 仓库:https://github.com/alibaba/Sentinel
© 2024 | 转载请注明出处
结论:PASS