前言
大家好,这里是程序员阿亮!
好久不见哈哈哈,前阵子一直在找下一段实习,就一直没来更新了~
今天来给大家写点新东西!
Redis 这个技术栈,想必大家都不陌生,新一代助攻服务端的程序员基本上都接触过它不过今天,我们不聊它在传统的业务场景中解决高并发高性能的问题,而是研究它在Agent 中的使用!
一、技术背景
在 LLM 应用从单纯的单轮 Prompt 工程演变为具备规划(Planning)、反思(Reflection)与工具调用能力的 AI Agent(智能体) 架构后,现代系统架构面临的挑战已不再是"模型参数有多大",而是"工程底座有多快、状态有多稳"。
传统无状态的 LLM 请求无法满足 Agent 复杂的执行闭环。每一次 Agentic Loop 包含数次甚至数十次思考过程(ReAct / Plan-and-Solve)、外部工具调用以及长文本注入。这带来了三个严峻的工程挑战:
-
端到端高延迟:每一次链式调用都会放大推理等待;
-
算力与 Token 成本剧增:高频重复意图与冗余上下文造成大量开销;
-
脆弱的运行时状态管理:多轮会话断点、分布式 Agent 间协同及并发工具调用需要低延迟共享状态。
在这一背景下,Redis 不再只是一个传统的 Key-Value 缓存,而是跃升为 AI 系统的"实时上下文引擎(Real-Time Context Engine)"与"智能体记忆中枢(Agent Memory Fabric)"。
本文将从系统架构视角深入探讨 Redis 如何支撑生产级 AI Agent 系统。
本文,我就从Agent系统的角度,讲解一下Redis的使用
二、Redis 在 AI Agent 系统中的全景架构
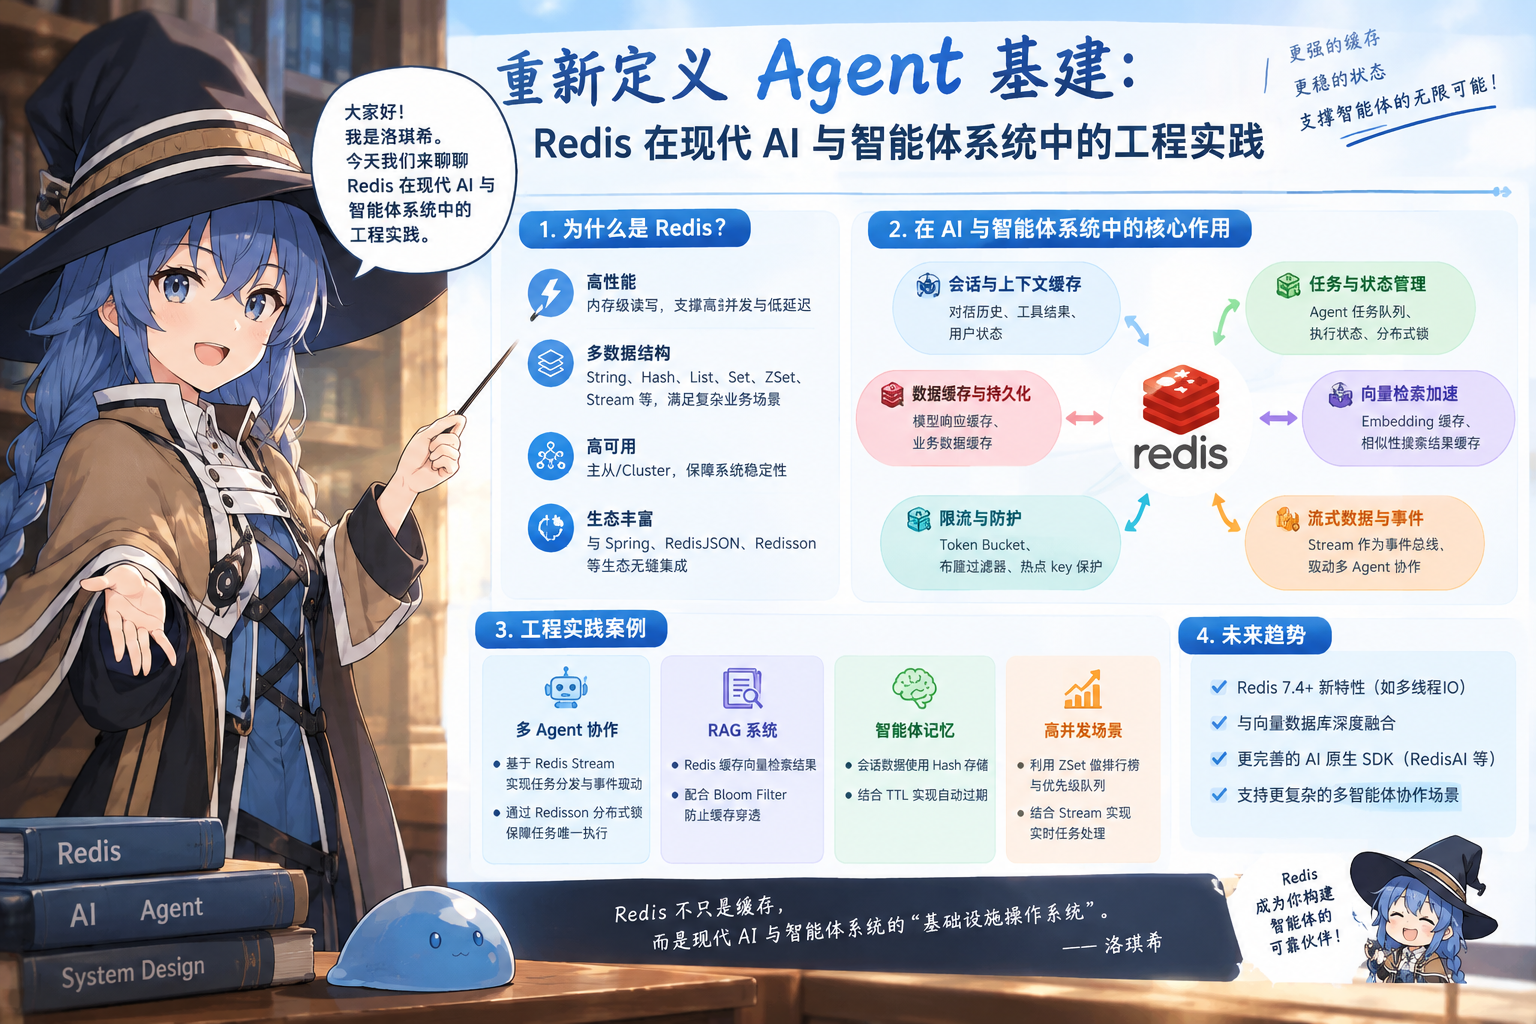
在一个典型的企业级 Agent 架构中,Redis 承担了多个横跨数据与通信层面的职责:
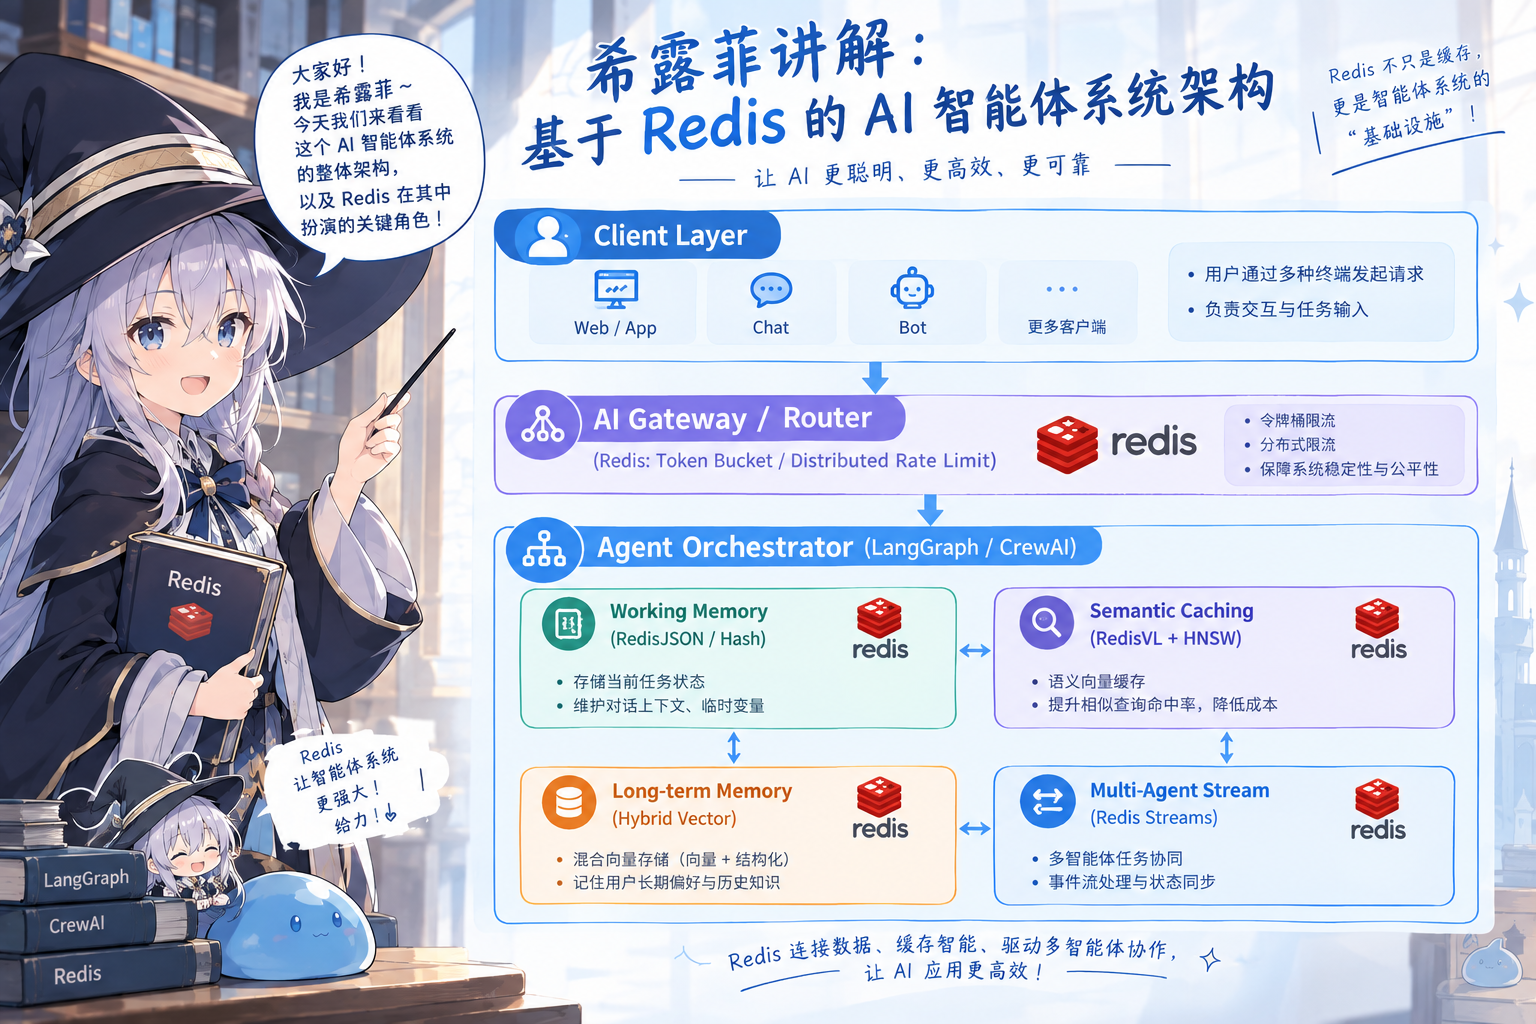
这张图是我用GPT生成的,关于Redis在一个Agent系统中的使用总揽,接下来给大家一一讲解~
三、智能体记忆网络:三层分级记忆系统
Agent 的"思考"依赖于上下文,但上下文窗口不是无限且廉价的。在工程上,直接将历史全量塞给模型既消耗 Token 又会导致模型注意力发散(Lost in the Middle)。结合 Redis 的数据结构,可以搭建一个高效的三层记忆拓扑:
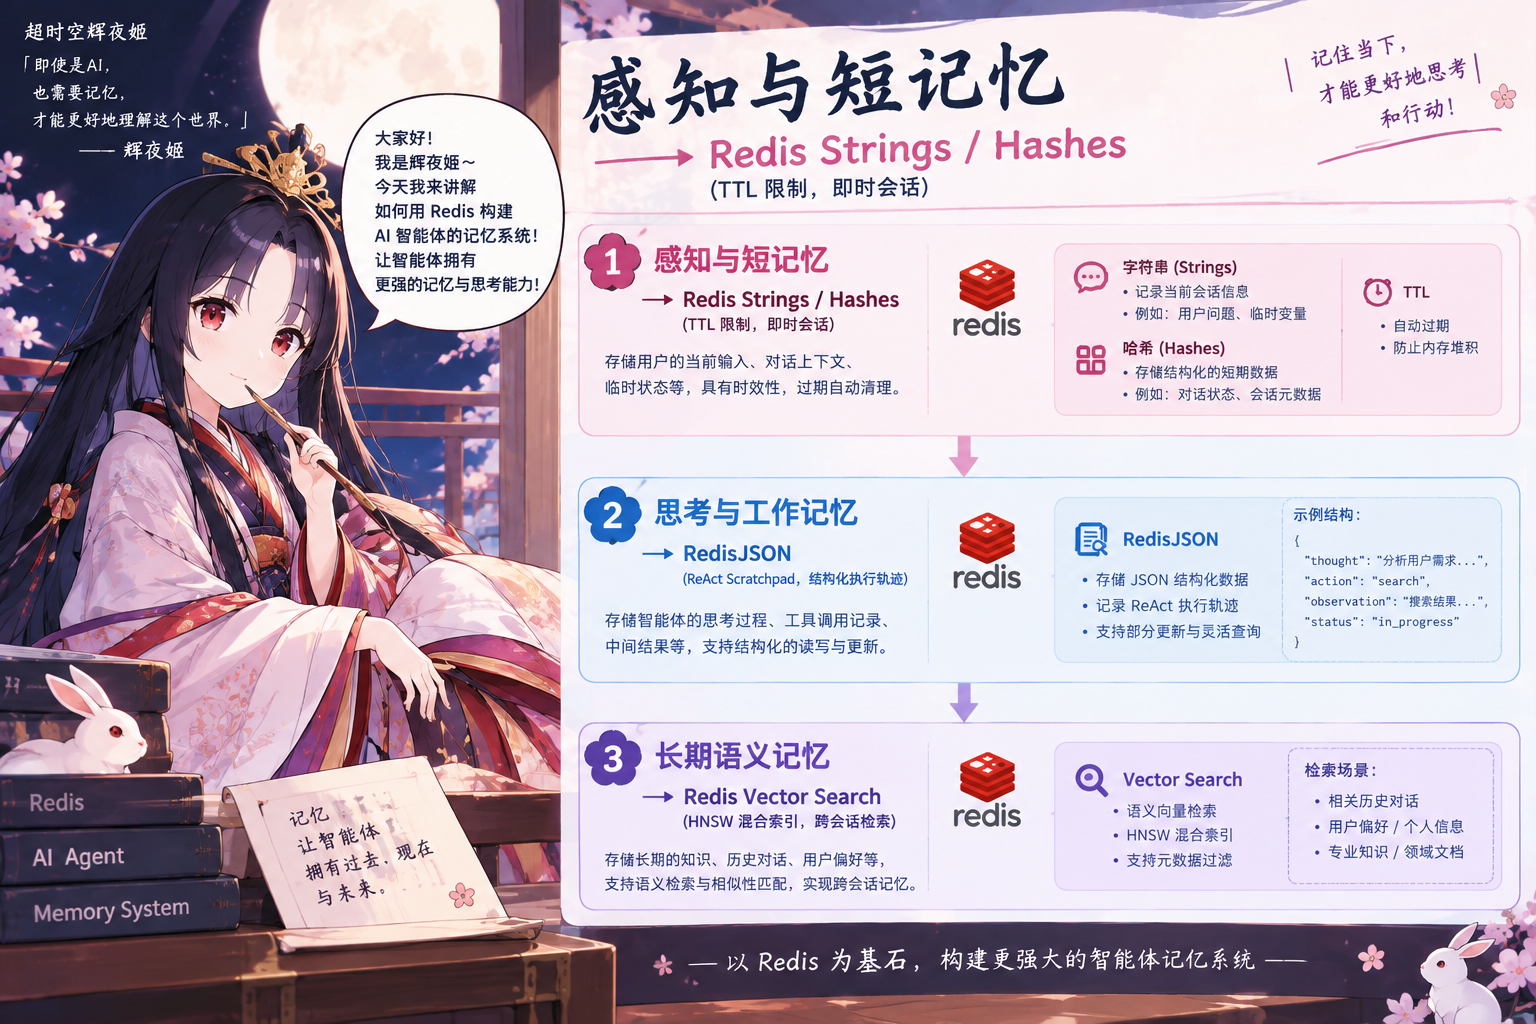
1. 思考工作记忆(Working Memory & Scratchpad)
在 ReAct(Reasoning + Acting)模式下,Agent 在单次任务中会经历多次内部循环:Thought -> Action -> Observation -> Thought。
-
数据结构 :RedisJSON
-
优势:
-
支持 JSONPath 原生增删改查,能够在不反序列化整个对象的情况下,原子性追加 Thought 轨迹;
-
读写延迟在亚毫秒级,不会为密集的单步思考循环引入系统开销;
-
执行完任务后,支持设置极短的生存时间(TTL),保证内存高效回收。
-
2. 会话窗口状态(Session Memory)
-
数据结构:Redis List 或固定长度队列 LTRIM
-
优势:通过固定滑动窗口保留最近 N 轮对话。对于长对话,结合轻量摘要模型将溢出的上下文压缩后以哈希格式保存,从而在有限的上下文窗口与高保真信息间取得平衡。
3. 长期语义记忆(Long-term Semantic Memory)
Agent 需要跨 Session 记住用户的偏好、过往任务决策结果或外部知识库。
-
数据结构:Redis Search & Vector Capability(HNSW 或 FLAT 索引)
-
实现逻辑 :
Redis 能够将高维向量(Float32 数组)与标量字段(如 user_id、timestamp、status)存储在同一个 Hash 或 JSON 文档中。
通过混合搜索(Hybrid Search),可以在一次查询中同时执行元数据过滤和近邻检索:
这避免了先在外部向量库检索出一堆结果、再在业务层拉取主库关联数据进行过滤的性能损耗。
Redis的Vector特性也是Redis跟上新时代的表现~
四、语义缓存(Semantic Caching):降本增效的核心枢纽
传统的 HTTP 缓存依赖精准的哈希匹配(如 MD5(Prompt)),但在自然语言场景下,以下两个 Prompt 表达完全相同的意图:
-
"如何退订下个月的订阅服务?"
-
"怎样取消下个月的自动续费?"
在传统缓存中,这是两次昂贵的 LLM API 调用与数秒的等待。通过 Redis 的向量搜索功能,我们能够构建语义缓存。
工作流程
-
客户端发送输入,通过轻量级 Embedding 模型(如 bge-small 或 text-embedding-3-small)生成向量;
-
在 Redis 中检索是否存在余弦距离(Cosine Distance)小于设定阈值 (通常设在 0.1~0.15 之间)的历史 Prompt;
-
Cache Hit:直接返回已缓存的 LLM 答案,耗时从几秒降至 10ms 以内,且 API 调用成本为 0;
-
Cache Miss:请求真实大模型,获得结果并回填至 Redis(带 TTL)。
五、多 Agent 协同与异步工具总线
在多 Agent 协作系统(如 LangGraph, CrewAI, AutoGen)中,任务往往被拆解成子流水线(Planner Agent -> Coder Agent -> Critic Agent)。
同步调用模型会导致整个调用链路出现级联阻塞,任何外部 API 超时都会导致整个 Agent 任务崩溃。这时,Redis 是天然的分布式事件总线。
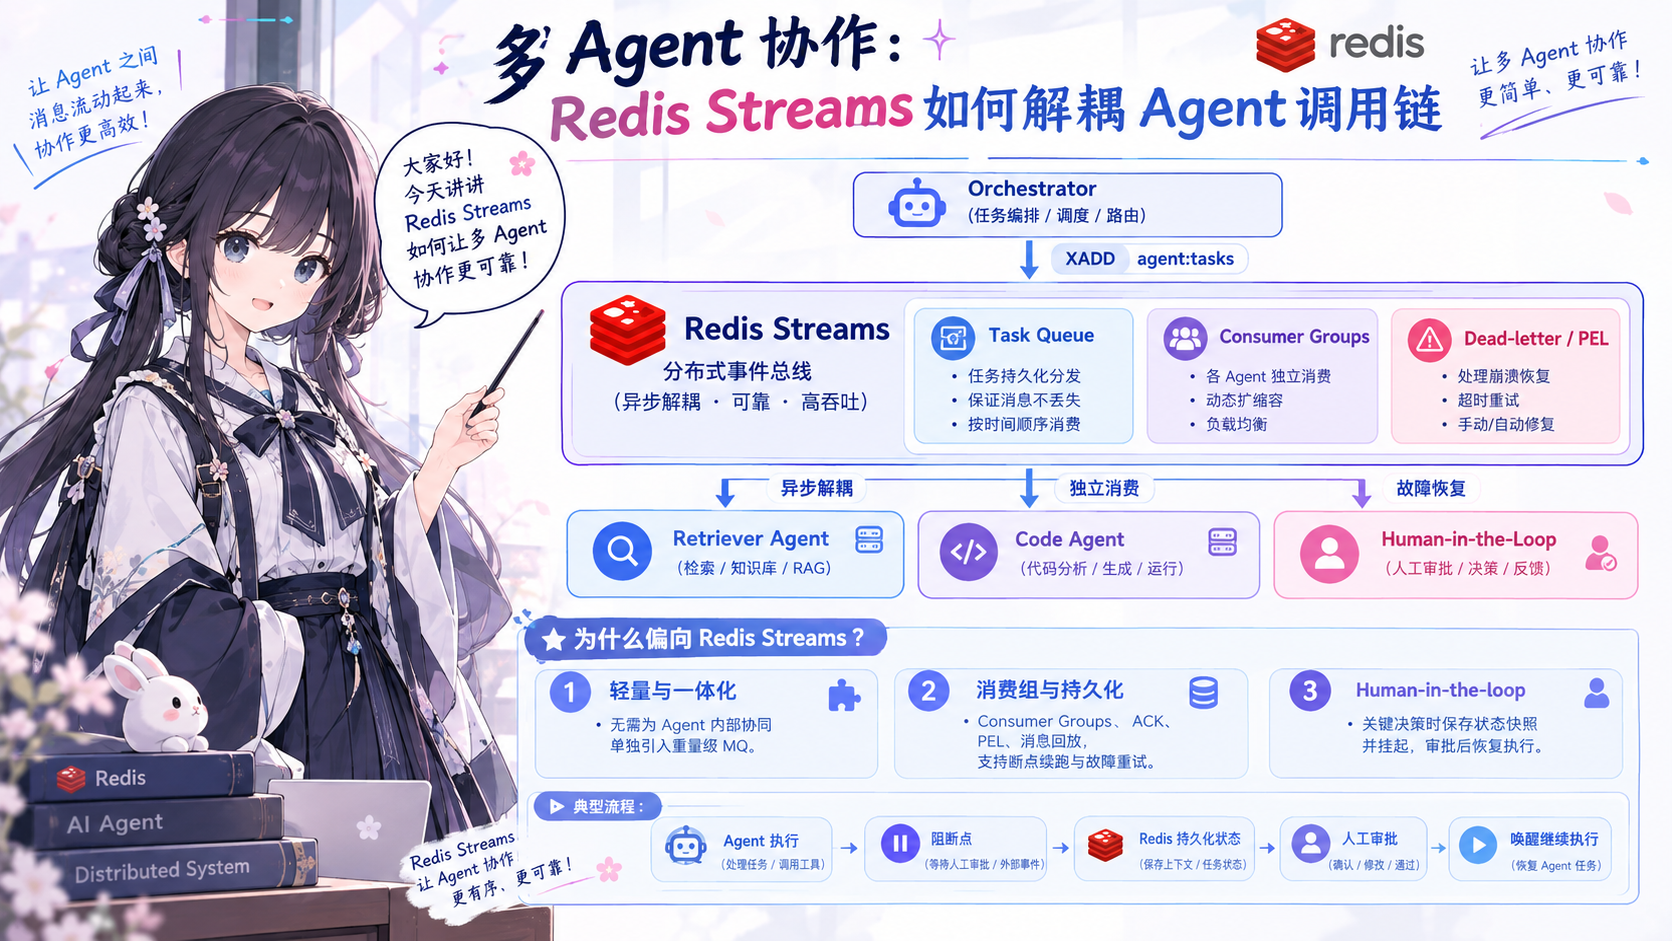
为什么在 Agent 编排中偏向 Redis Streams?
-
轻量与一体化:不需要为了 Agent 内部协同而单独引入重量级的消息中间件;
-
支持消费组与持久化:相比普通 Pub/Sub,Redis Streams 提供了消费组、消息 ACK、Pending Entries List (PEL) 以及消息回放能力,天然支持断点续跑和故障重试;
-
人在回路(Human-in-the-loop, HITL):复杂的 Agent 在做关键决策(如转账、删库)时需要人工审批。Agent 执行到阻断点时,可将状态快照持久化到 Redis,转入挂起状态,通过 XREADBLOCK 或等待审批指令再平滑唤醒。
六、模型网关防护:分布式限流与配额管控
LLM 供应商通常对账号施加严苛的速率限制(如 TPM、RPM)。同时,企业级应用需对多租户做成本配额控制。
通过 Redis 配合高效的 Lua 脚本,可以在网关层以原子操作实现滑动窗口或令牌桶限流,防止瞬间高并发击穿模型上游限额:
Lua
-- 滑动窗口请求速率控制 Lua 脚本
local key = KEYS[1]
local now = tonumber(ARGV[1])
local window = tonumber(ARGV[2])
local limit = tonumber(ARGV[3])

-- 清理窗口外的过期数据
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)
-- 统计当前窗口内的请求数
local current_requests = redis.call('ZCARD', key)

if current_requests < limit then
    -- 记录本次请求
    redis.call('ZADD', key, now, now)
    redis.call('EXPIRE', key, math.ceil(window / 1000))
    return 1 -- 放行
else
    return 0 -- 触发限流
end
七、生产落地的架构避坑指南
尽管 Redis 在 AI 架构中能力全面,但在高可用与生产规划时,仍需避开以下几个常见陷阱:
1. 向量索引的内存开销与容量规划
-
HNSW 的内存放大:Redis 的 HNSW 索引极快,但图拓扑结构和高维向量数据全都在内存中。
-
比如 1536 维度的 OpenAI Embedding,单条向量纯浮点数据约 6KB,加上 HNSW 的边结构和 Redis 结构开销,单条记录可能消耗 8~12KB 内存。
-
建议 :百万级以上中低频访问的冷知识库,应剥离至基于磁盘或对象存储的专业向量数据库;而高频访问的短期语义缓存、实时工作会话与动态实体画像,优先留在 Redis 中。
-
-
如果内存受限,可以评估考虑标量量化(Scalar Quantization)或适当调整 HNSW 的 M(每个节点的邻居数)和 efConstruction 参数。
2. 持久化机制(AOF / RDB)与容灾考量
Agent 的记忆与状态数据不同于传统短生命周期的页面缓存。一旦实例宕机且无持久化,会导致所有正在运行的 Long-running Agent 任务执行轨迹丢失。
-
建议对承载 Agent 状态的 Redis 节点启用 AOF (Everysec) 与混合持久化(AOF-RDB);
-
生产环境建议主从集群部署,并配合 Sentinel 或 Redis Cluster 实现高可用故障自愈。
3. 连接池与高并发瓶颈
Agent 在一次循环中可能高频查询缓存、写入轨迹和请求锁。在 Python 环境(异步框架如 FastAPI、AsyncIO)下,请确保使用 redis-py 的连接池或异步客户端,避免在密集的 Agent 反思循环中因频繁握手建连造成明显的延迟抖动。
结语:构建确定性与高吞吐的 AI 基础设施
大语言模型(LLM)赋予了系统强大的"心智"与"创造力",但这层心智本质上是无状态、非确定性且高延迟的。
将 Redis 引入 AI Agent 系统,本质上是用成熟、可靠的亚毫秒级确定性系统 去包裹和约束非确定性的模型调用:
-
用语义缓存对抗延迟与成本;
-
用分级记忆赋能模型持久上下文;
-
用事件流支撑复杂 Agentic 编排的稳健运行。
在 AI 走向工程化深水区的当下,合理运用 Redis 的各项能力,是让 AI Agent 从原型演示平稳迈向工业级生产系统的核心技术基石。