C 语言预处理中的宏展开、条件编译与头文件保护
- [C 语言预处理中的宏展开、条件编译与头文件保护](#C 语言预处理中的宏展开、条件编译与头文件保护)
- [1. 阅读前问题卡:C 语言预处理](#1. 阅读前问题卡:C 语言预处理)
- [1.1 阅读前先看这几个问题](#1.1 阅读前先看这几个问题)
- [1.2 读完后完成这 3 道高频问题](#1.2 读完后完成这 3 道高频问题)
- [1.3 自检清单](#1.3 自检清单)
- [2. 前言](#2. 前言)
- [2.1 先把源代码整理成"可交给编译器的版本"](#2.1 先把源代码整理成“可交给编译器的版本”)
- [2.2 宏是"按文本改稿",函数是"交给专人处理"](#2.2 宏是“按文本改稿”,函数是“交给专人处理”)
- [2.3 条件编译控制"哪些内容进入成品"](#2.3 条件编译控制“哪些内容进入成品”)
- [3. 学习目标](#3. 学习目标)
- [4. 预定义符号](#4. 预定义符号)
- [5. #define 定义常量](#define 定义常量)
- [6. #define 定义宏](#define 定义宏)
- [6.1 宏定义中括号的使用](#6.1 宏定义中括号的使用)
- [6.2 带有副作用的宏参数](#6.2 带有副作用的宏参数)
- [6.3 宏替换的规则](#6.3 宏替换的规则)
- [6.4 宏和函数的对比](#6.4 宏和函数的对比)
- [7. 命名约定](#7. 命名约定)
- 8. #undef
- [9. 条件编译](#9. 条件编译)
- [10. 头文件的包含](#10. 头文件的包含)
- [10.1 头文件被包含的方式](#10.1 头文件被包含的方式)
- [10.1.1 本地文件包含](#10.1.1 本地文件包含)
- [10.1.2 库文件包含](#10.1.2 库文件包含)
- [10.2 嵌套文件包含](#10.2 嵌套文件包含)
- [11. 其他预处理指令](#11. 其他预处理指令)
- [12. 命令行定义(加餐)](#12. 命令行定义(加餐))
- [13. # 和 ##(加餐)](# 和 ##(加餐))
- [13.1 # 运算符](# 运算符)
- [13.2 ## 运算符](## 运算符)
- [14. Vibe coding 代码实战](#14. Vibe coding 代码实战)
1. 阅读前问题卡:C 语言预处理
1.1 阅读前先看这几个问题
建议先读:先看预定义符号和 #define 定义常量,再精读宏括号、副作用、条件编译与头文件包含。
- 预处理器在编译流程中承担什么工作?
__FILE__、__LINE__、__DATE__、__TIME__和__STDC__分别提供哪些信息? - 对象式宏与函数式宏有什么区别?为什么宏名与参数列表左括号必须紧邻,常量替换文本通常不应以
;结尾? - 为什么数值宏既要给每个参数加括号,还要给整体表达式加括号?
SQUARE(a + 1)与10 * DOUBLE(a)分别会怎样展开? MAX(x++, y++)为什么有副作用风险?宏展开后参数会被求值几次,x、y和z的结果如何变化?- 宏与函数在代码规模、执行速度、类型、调试、递归和运算符优先级方面有哪些差异?
- 条件编译如何决定代码是否交给编译器?
#if、#ifdef、#elif、#else、#endif与头文件保护怎样配合? #include <xxx.h>和#include "xxx.h"的查找策略有何不同?#字符串化与##记号粘合分别解决什么问题?
1.2 读完后完成这 3 道高频问题
1.2.1 高频问题 1:请从预处理器的职责出发,串联预定义符号、宏替换、条件编译、#include 和头文件保护,说明源代码如何在进入编译器前被处理。
1.2.2 高频问题 2:请解释函数式宏中参数括号和整体括号的必要性,并结合 SQUARE、DOUBLE 和 MAX 示例说明运算符优先级与副作用会造成什么结果。
1.2.3 高频问题 3:请比较 #include <xxx.h> 与 #include "xxx.h" 的查找差异,并说明条件编译如何用于调试开关、跨平台适配和避免头文件重复包含。
1.3 自检清单
- 我能区分预处理阶段与编译阶段的职责。
- 我能说明预定义符号、对象式宏、函数式宏和
#undef的用途。 - 我能解释宏参数括号、整体括号和副作用参数的风险。
- 我能说出宏与函数至少 3 个差异,并指出各自适用边界。
- 我能说明条件编译、
#include查找和头文件保护的关系。 - 我能手工展开一个使用
#或##的宏,并判断生成结果是否为合法标识符。
2. 前言
2.1 先把源代码整理成"可交给编译器的版本"
想象一份要交给印刷厂的稿件:正式排版前,编辑会把日期、页码和统一替换词填进去,把不需要的段落删掉,再把引用的附件内容插入正文。对应到 C 语言,预处理器负责展开预定义符号和宏、按条件保留或丢弃代码,并把 #include 指向的头文件内容插入当前位置;编译器接着处理这份已经整理好的源代码。
2.2 宏是"按文本改稿",函数是"交给专人处理"
柜台可以直接把同一段固定文字替换进许多表格,也可以把参数交给工作人员按类型和规则办理。对象式宏和函数式宏都属于前一种文本替换:参数原样嵌入,速度和类型通用性可能有优势,但会带来括号、重复求值和调试困难;函数则有明确参数类型和独立调用边界。# 把参数变成字符串,## 把两段记号拼成一个标识符,都是在改稿阶段完成的文本组合。
2.3 条件编译控制"哪些内容进入成品"
公告栏会根据当天的开关只张贴某一组通知,重复张贴同一份公告时则先检查是否已经贴过。条件编译对应前一种选择:#if、#ifdef 等指令决定哪些代码保留下来;头文件保护对应后一种检查,用宏标记或 #pragma once 避免同一头文件内容被重复展开。
3. 学习目标
- 深刻理解编译器在预处理阶段的工作。
- 掌握
#define定义常量和宏。 - 掌握宏在编写时的各种细节,以及宏和函数的对比。
- 掌握条件编译和代码编写。
- 掌握条件编译在头文件包含中的作用。
- 了解
#和##的作用,能够阅读和理解这类代码。
4. 预定义符号
C 语言设置了一些预定义符号,可以直接使用,预定义符号也是在预处理期间处理的。
c
__FILE__  //进行编译的源文件
__LINE__  //文件当前的行号
__DATE__  //文件被编译的日期
__TIME__  //文件被编译的时间
__STDC__  //如果编译器遵循 ANSI C,其值为 1,否则未定义
举个例子:
c
printf("file:%s line:%d\n", __FILE__, __LINE__);5. #define 定义常量
基本语法:
c
#define name stuff举个例子:
c
#define MAX 1000
#define reg register       //为 register 这个关键字,创建一个简短的名字
#define do_forever for(;;) //用更形象的符号来替换一种实现
#define CASE break;case    //在写 case 语句的时候自动把 break 写上。

// 如果定义的 stuff 过长,可以分成几行写,除了最后一行外,每行的后面都加一个反斜杠(续行符)。
#define DEBUG_PRINT printf("file:%s\tline:%d\t \
                           date:%s\ttime:%s\n", \
                           __FILE__, __LINE__,    \
                           __DATE__, __TIME__)
**思考:**在 define 定义标识符的时候,要不要在最后加上 ;?
比如:
c
#define MAX 1000;
#define MAX 1000
建议不要加上 ;,这样容易导致问题。
比如下面的场景:
c
if(condition)
    max = MAX;
else
max = 0;如果是加了分号的情况,等替换后,if 和 else 之间就是 2 条语句,而没有大括号的时候,if 后边只能有一条语句。这里会出现语法错误。
6. #define 定义宏
#define 机制包括了一个规定,允许把参数替换到文本中,这种实现通常称为宏。
下面是宏声明的语法形式:
c
#define name( parament-list ) stuff其中的 parament-list 是一个由逗号隔开的符号表,它们可能出现在 stuff 中。参数列表的左括号必须与 name 紧邻,如果两者之间有任何空白存在,参数列表就会被解释为 stuff 的一部分。
举例:
c
#define SQUARE( x ) x * x

SQUARE(5);
SQUARE 宏接收一个参数 x,如果在上述声明之后,对 SQUARE(5); 这句代码,经过预处理器处理后,替换成表达式 5 * 5。
6.1 宏定义中括号的使用
前面写的 SQUARE 宏是不是完全正确呢?我们再看一个案例。
c
#include <stdio.h>

int main()
{
    int a = 5;
    printf("%d\n", SQUARE( a + 1 );
    return 0;
}
乍一看,你可能觉得这段代码将打印 36,因为 a + 1 得到 6,6 的平方就是 36 了。
但是事实上它将打印 11,为什么呢?
原因就是:宏的参数是原样 替换到宏体内的文本中的,参数 x 被替换成 a + 1,这样宏体中的 x 会被替换成 a+1。
所以这条语句替换完后,实际上变成了:
c
printf("%d\n", a + 1 * a + 1);这样就比较清晰了,由替换产生的表达式并没有按照预想的次序进行求值。
宏参数中的操作符和宏体中的操作符的优先级,导致计算顺序和预期不相符。
**解决办法:**在宏定义中给宏体内的参数文本加上括号,这样保证替换到宏体中的每个参数都是独立的表达式。
c
#define SQUARE(x) (x) * (x)这样预处理之后就产生了预期的效果:
c
printf("%d\n", (a + 1) * (a + 1));这里还有一个宏定义:
c
#define DOUBLE(x) (x) + (x)定义中我们使用了括号,想避免之前的问题,但是这个宏可能会出现新的错误。
c
int a = 5;
printf("%d\n", 10 * DOUBLE(a));
这将打印什么值呢?看上去,好像打印 100,但事实上打印的是 55。
我们发现替换之后:
c
printf("%d\n", 10 * (5) + (5));乘法运算先于宏定义的加法,所以出现了 55。
这个问题的解决办法是在宏定义表达式两边加上一对括号就可以了。
c
#define DOUBLE(x) ( ( x ) + ( x ) )**结论:**用于对数值表达式进行求值的宏定义都应该用上述方式加上括号,避免在使用宏时由于参数中的操作符和邻近操作符之间不可预料的相互作用。
6.2 带有副作用的宏参数
当宏参数在宏的定义中出现超过一次的时候,如果参数带有副作用,那么你在使用这个宏的时候就可能出现危险,导致不可预测的后果。副作用就是表达式求值的时候出现的永久性效果。
副作用举例:
c
x+1;//不带副作用
x++;//带有副作用请看下面的代码,MAX 宏可以证明具有副作用的参数所引起的问题。
c
#include <stdio.h>

#define MAX(a, b) ( (a) > (b) ? (a) : (b) )

int main()
{
    x = 5;
    y = 8;
    z = MAX(x++, y++);
    printf("x=%d y=%d z=%d\n", x, y, z);//输出的结果是什么?

    return 0;
}
这里我们得知道预处理器处理之后的结果是什么:
c
z = ( (x++) > (y++) ? (x++) : (y++));所以输出的结果是:x=6 y=10 z=9。
6.3 宏替换的规则
在程序中扩展 #define 定义符号和宏时,需要涉及几个步骤。
- 在调用宏时,首先对参数进行检查,看看是否包含任何由
#define定义的符号。如果是,它们首先被替换。 - 替换文本随后被插入到程序中原来文本的位置。对于宏,参数名被它们的值所替换。
- 最后,再次对结果文件进行扫描,看看它是否包含任何由
#define定义的符号。如果是,就重复上述处理过程。
注意:
- 宏参数和
#define定义中可以出现其他#define定义的符号。但是对于宏,不能出现递归。 - 当预处理器搜索
#define定义的符号的时候,字符串常量的内容并不被搜索。
6.4 宏和函数的对比
我们学到这里发现宏和函数是有很多相似性的,那什么情况使用宏?什么情况使用函数呢?
宏通常被应用于执行简单的运算。
比如在两个数中找出较大的一个时,写成下面的宏,更有优势一些。
c
#define MAX(a, b) ((a)>(b)?(a):(b))那为什么不用函数来完成这个任务?
原因有二:
- 用于调用函数和从函数返回的代码可能比实际执行这个小型计算工作所需要的时间更多。所以宏比函数在程序的规模和速度方面更胜一筹。
- 更为重要的是函数的参数必须声明为特定的类型。所以函数只能在类型合适的表达式上使用。反之这个宏可以适用于整型、长整型、浮点型等可以用于
>来比较的类型。宏的参数是类型无关的。
和函数相比宏的劣势:
- 每次使用宏的时候,一份宏定义的代码将插入到程序中,除非宏比较短,否则可能大幅度增加程序的长度。
- 宏是没法调试的,程序到调试的时候,宏已经被替换了,所以程序执行的代码和程序员看到的代码是不一致。
- 宏由于类型无关,也就不够严谨。
- 宏可能会带来运算符优先级的问题,导致程序容易出现错。
宏有时候可以做函数做不到的事情。比如:宏的参数可以出现类型,但是函数做不到。
c
#define MALLOC(num, type)\
    (type )malloc(num sizeof(type))
...
//使用
MALLOC(10, int);//类型作为参数

//预处理器替换之后:
(int *)malloc(10*sizeof(int));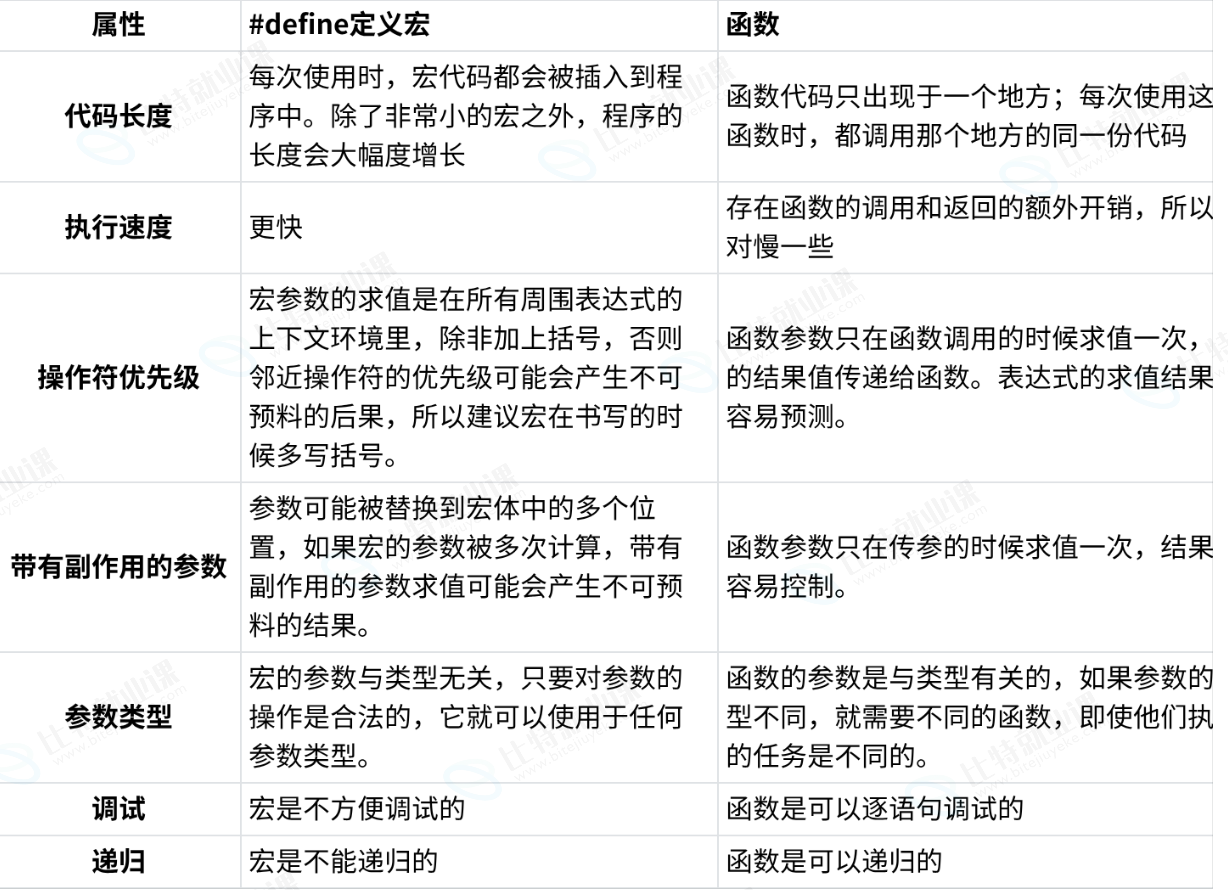
7. 命名约定
一般来讲函数和宏的使用语法很相似。所以语言本身没法帮我们区分二者。
那我们平时的一个习惯是:
- 把宏名全部大写。
- 函数名不要全部大写。
8. #undef
这条指令用于移除一个宏定义,如果现存的一个名字需要被重新定义,那么可以先移除旧名字。
语法形式如下:
c
#undef NAME9. 条件编译
你在开发时希望在屏幕上打印一些调试信息,但正式发布时这些信息必须全部消失。你会怎么做?
手动删除 printf?那下次调试又得加回来,太蠢了。
条件编译就是用来解决这类"根据条件保留或丢弃代码"的问题的。它在编译前由预处理器处理,符合条件的代码才会被编译器看到。
C 语言中就是使用条件编译指令来完成,将一条语句(一组语句)编译或者放弃是很方便的。
下面代码中的橙色部分就是条件编译的代码,决定了第 12 行代码是否保留。
c
#include <stdio.h>
#define __DEBUG__

int main()
{
    int i = 0;
    int arr[10] = {0};
    for(i = 0; i < 10; i++)
    {
        arr[i] = i + 1;
#ifdef __DEBUG__
        printf("%d\n", arr[i]);//为了观察数组是否赋值成功。
#endif //__DEBUG__
    }
    return 0;
}
下面是常见的条件编译指令:
-
#if常量表达式c#if 常量表达式 //... #endif //常量表达式由预处理器求值。 //如: #define __DEBUG__ 1 #if __DEBUG__ //.. #endif -
多个分支的条件编译
c#if 常量表达式 //... #elif 常量表达式 //... #else //... #endif -
判断是否被定义
c#if defined(symbol) #ifdef symbol #if !defined(symbol) #ifndef symbol -
嵌套指令
c#if defined(OS_UNIX) #ifdef OPTION1 unix_version_option1(); #endif #ifdef OPTION2 unix_version_option2(); #endif #elif defined(OS_MSDOS) #ifdef OPTION2 msdos_version_option2(); #endif #endif
条件编译的三大典型场景:头文件保护、调试开关、跨平台的代码适配。
AI 提示词 1:编写样例代码,展示一下 C 语言中条件编译在调试开关方面的使用。
AI 提示词 2:编写样例代码,展示一下 C 语言中条件编译在跨平台的代码适配方面的使用。
10. 头文件的包含
到目前为止,我们见过了两种头文件包含的方式,#include <xxx.h> 和 #include "xxx.h",它们有什么区别吗?接下来我们看看。
10.1 头文件被包含的方式
10.1.1 本地文件包含
c
#include "xxx.h"查找策略:
先在源文件所在目录下查找,如果该头文件未找到,编译器就像查找库函数头文件一样在标准位置查找头文件。
如果找不到就提示编译错误。
Linux 环境的标准头文件的路径:
text
/usr/includeVS 环境的标准头文件的路径:
text
C:\Program Files (x86)\Microsoft Visual Studio 12.0\VC\include
//这是 VS2013 的默认路径
注意按照自己的安装路径去找。
10.1.2 库文件包含
c
#include <xxx.h>查找头文件直接去标准路径下去查找,如果找不到就提示编译错误。
这样是不是可以说,对于库文件也可以使用""的形式包含?
答案是肯定的,可以,但是这样做查找的效率就低些,当然这样也不容易区分是库文件还是本地文件了。
10.2 嵌套文件包含
我们已经知道,#include 指令可以使另外一个文件被编译。就像它实际出现于 #include 指令的地方一样。
这种替换的方式很简单:预处理器先删除这条指令,并用包含文件的内容替换。
一个头文件被包含 10 次,那就实际被编译 10 次;如果重复包含,对编译的压力就比较大。
test.c:
c
#include "test.h"
#include "test.h"
#include "test.h"
#include "test.h"
#include "test.h"

int main()
{
    return 0;
}test.h:
c
void test();
struct Stu
{
    int id;
    char name[20];
};如果直接这样写,test.c 文件中将 test.h 包含 5 次,那么 test.h 文件的内容将会被拷贝 5 份在 test.c 中。
如果 test.h 文件比较大,这样预处理后代码量会剧增。如果工程比较大,有公共使用的头文件,被大家都能使用,又不做任何的处理,那么后果真的不堪设想。
如何解决头文件被重复引入的问题?答案:条件编译。
每个头文件的开头写:
c
#ifndef __TEST_H__
#define __TEST_H__
//头文件的内容
#endif //__TEST_H__
或者:
c
#pragma once就可以避免头文件的重复引入。
注:
推荐《高质量 C/C++ 编程指南》中附录的考试试卷(很重要)。
笔试题:
- 头文件中的
ifndef/define/endif是干什么用的? #include <filename.h>和#include "filename.h"有什么区别?
11. 其他预处理指令
c
#error
#pragma
#line
...
不做介绍,自己去了解。
#pragma pack() 在结构体部分介绍。
参考《C 语言深度解剖》学习,大家可以借助于 AI 学习一下,其实都很简单。
AI 提示词:介绍一下
#pragma在 C 语言中的使用,并给出代码演示。
其他的类似~
12. 命令行定义(加餐)
许多 C 的编译器提供了一种能力,允许在程序编译的命令行中定义符号。用于在编译的过程中指定程序中一些符号的值,方便我们在不修改代码的基础上,编译出不同版本的程序。
例如:当我们根据同一个源文件要编译出一个程序的不同版本的时候,这个特性有点用处。(假定某个程序中声明了一个某个长度的数组,如果机器内存有限,我们需要一个很小的数组,但是另外一个机器内存大些,我们需要一个数组能够大些。)
test.c:
c
#include <stdio.h>

int main()
{
    int array[SZ];
    int i = 0;
    for(i = 0; i < SZ; i ++)
    {
        array[i] = i;
    }

    for(i = 0; i < SZ; i ++)
    {
        printf("%d ", array[i]);
    }
    printf("\n");
    return 0;
}
编译指令:
text
//linux 环境演示
gcc -DSZ=10 test.c
13. # 和 ##(加餐)
13.1 # 运算符
# 运算符将宏的一个参数转换为字符串字面量,# 运算符所执行的操作可以理解为**"字符串化"**。
它仅允许出现在带参数的宏的替换列表中。
当我们有一个变量 int a = 10; 的时候,我们想打印出:the value of a is 10。
就可以写:
c
#define PRINT(n, format) printf("the value of " #n " is "format"\n", n);当我们按照下面的方式调用的时候:
c
PRINT(a, "%d"); //当我们把 a 替换到宏的体内时,就出现了 #a,而 #a 就是转换为 "a",是一个字符串代码就会被预处理为:
c
printf("the value of " "a" " is ""%d""\n", a);运行代码就能在屏幕上打印:
text
the value of a is 1013.2 ## 运算符
## 可以把位于它两边的符号合成一个符号,它允许宏定义从分离的文本片段创建标识符。## 被称为记号粘合。
这样的连接必须产生一个合法的标识符,否则其结果就是未定义的。
这里我们想想,写一个函数求 2 个数的较大值的时候,不同的数据类型就得写不同的函数。
比如:
c
int int_max(int x, int y)
{
    return x > y ? x : y;
}

float float_max(float x, float y)
{
    return x > y ? x : y;
}
但是这样写起来太繁琐了,现在我们这样写代码试试:
c
//宏定义
#define GENERIC_MAX(type) \
type type##_max(type x, type y)\
{                         \
    return (x>y?x:y);     \
}
使用宏,定义不同函数:
c
GENERIC_MAX(int)   //替换到宏体内后 int##_max 生成了新的符号 int_max 做函数名
GENERIC_MAX(float) //替换到宏体内后 float##_max 生成了新的符号 float_max 做函数名

int main()
{
    //调用函数
    int m = int_max(2, 3);
    printf("%d\n", m);
    float fm = float_max(3.5f, 4.5f);
    printf("%f\n", fm);

    return 0;
}
输出:
text
3
4.500000
在实际开发过程中 ## 使用的很少,很难取出非常贴切的例子。
14. Vibe coding 代码实战
实现一个支持多语言、多版本的计算器,主要是体会条件编译的使用场景。
提示词:
-
使用 C 语言实现一个多版本、支持双语言的控制台程序的计算器。
-
普通版本的计算器支持整数的加法和减法,Pro 版本的计算器新增支持整数的乘法和除法,除法需要检测除数是否为 0。
-
计算器支持中文和英文,默认是中文提示信息。
-
可以使用条件编译。
-
可以加上简易的调试信息和日志的输出。
15.回答问题卡的问题
问题 1:预处理器在编译流程中承担什么工作?__FILE__、__LINE__、__DATE__、__TIME__ 和 __STDC__ 分别提供哪些信息?
答:
负责展开宏,按条件保留或丢弃代码,并把#include 的内容插入当前位置
FILE 进行编译的源文件
LINE 文件当前的行号
DATE 文件被编译的日期
TIME 文件被编译的时间
STDC 如果编译器遵循 ANSI C,在符合 ANSI C 的实现中其值为 1,否则未定义
问题 2:对象式宏与函数式宏有什么区别?为什么宏名与参数列表左括号必须紧邻,常量替换文本通常不应以 ; 结尾?
答:
对象式宏没有参数,函数试宏有
只有宏名与参数列表左括号紧邻预处理才会把它视为函数式宏,否则为对象式宏
常量宏不写分号,是避免替换后在 if/else 等上下文中产生多余语句。
问题 3:为什么数值宏既要给每个参数加括号,还要给整体表达式加括号?SQUARE(a + 1) 与 10 * DOUBLE(a) 分别会怎样展开?
答:
防止由于宏参数中的操作符和宏体中的操作符的优先级,使计算顺序和预期不符
展开为:
a + 1 * a + 1
10 * (a)+(a)
安全写法是 ((x) * (x)) 和 ((x) + (x))。
问题 4:MAX(x++, y++) 为什么有副作用风险?宏展开后参数会被求值几次,x、y 和 z 的结果如何变化?
答:
第 1 步:判断条件 (x++) > (y++)
- 取
x++的值 → 5 ,然后x变成 6 - 取
y++的值 → 8 ,然后y变成 9 - 比较:
5 > 8→ 假(false)
此时:
x = 6y = 9
第 2 步:因为是假,走 : 后面的分支,执行 (y++)
- 取
y++的值 → 9 ,然后y变成 10 - 这个值赋给
z→z = 9
此时:
x = 6y = 10z = 9
第 3 步:三元运算符结束,赋值完成
最终结果:
text
x = 6
y = 10
z = 9宏的参数会被原封不动地替换到宏体的每一个使用位置。如果参数带有副作用(++、--、赋值、函数调用等),那么它在宏体里出现几次,就会被执行几次。
带副作用的参数到底被求值几次,取决于三元运算符走了哪条分支,这正是危险之处。
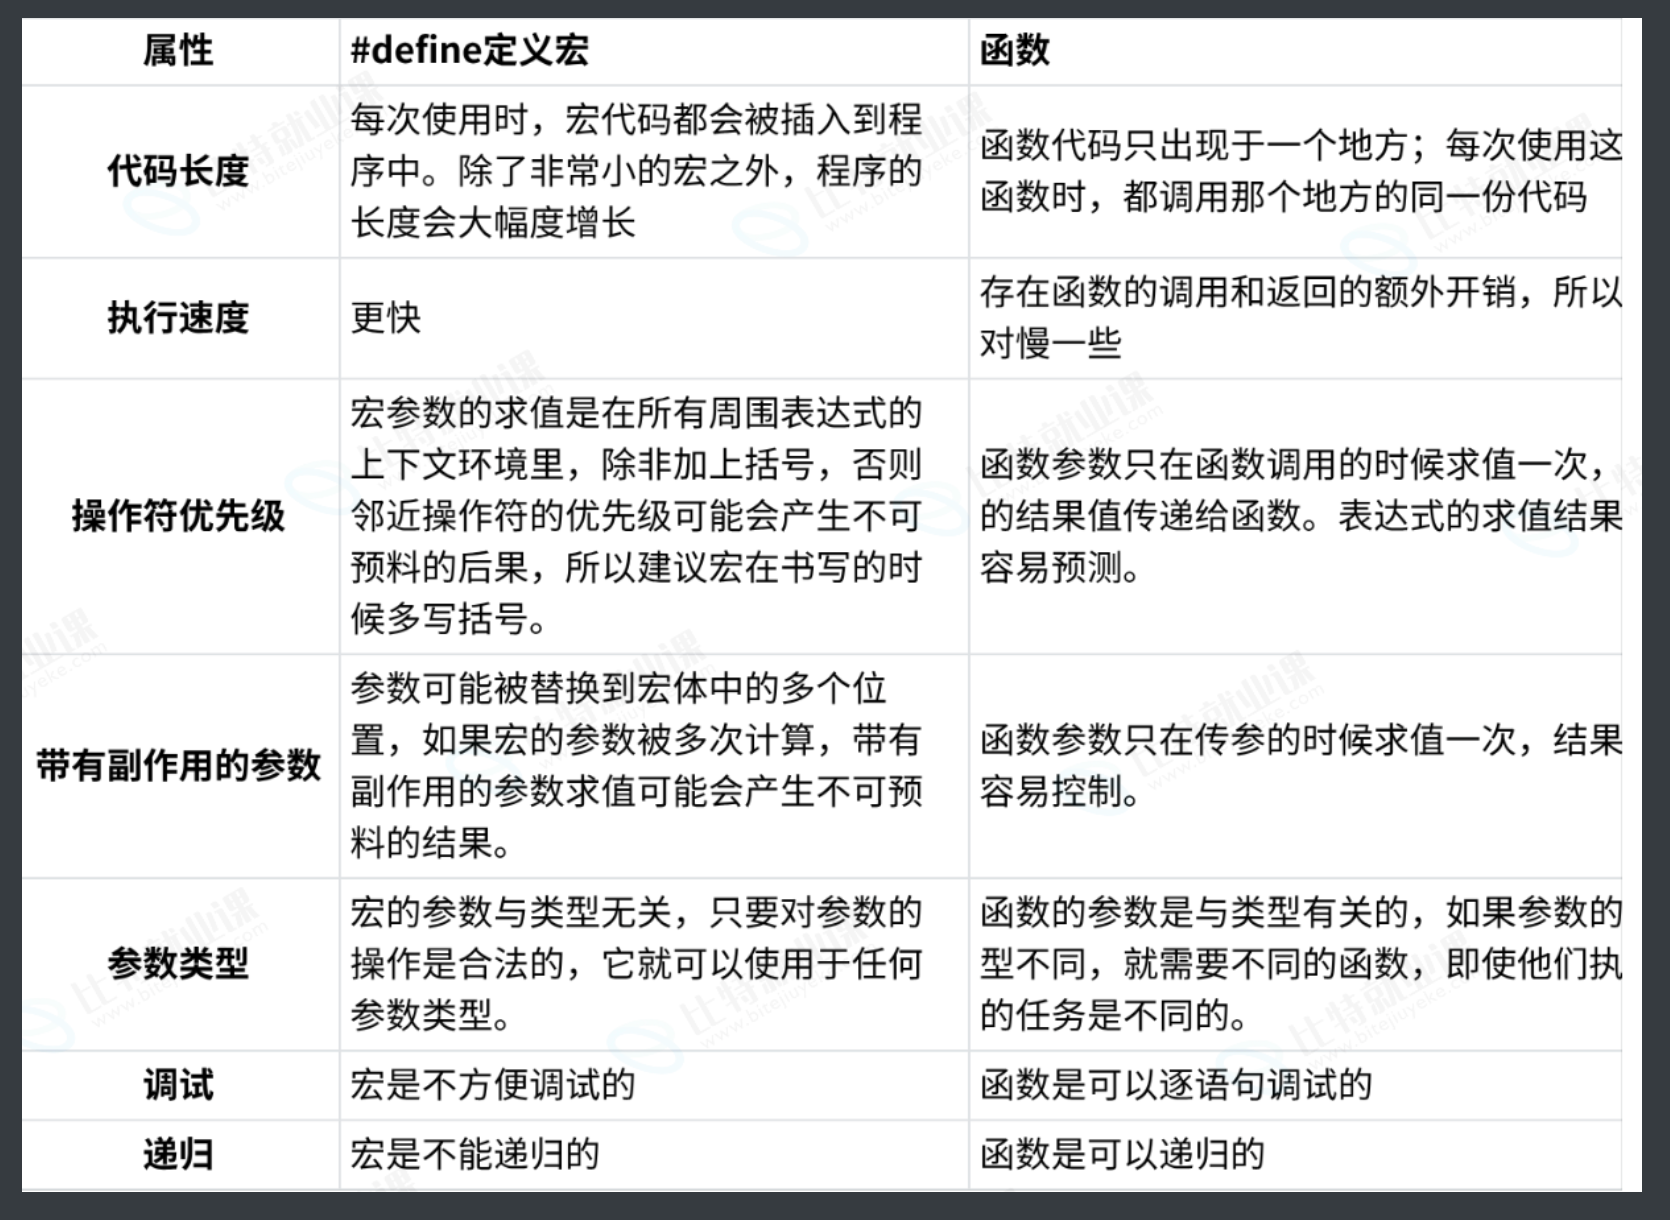
问题 5:宏与函数在代码规模、执行速度、类型、调试、递归和运算符优先级方面有哪些差异?
答:
宏的优势
- 用调用函数和从函数返回的代码可能比实际执行这个小型计算工作所需要的时间更多。所以宏比函数在程序的规模和速度方面更胜一筹。
- 更为重要的是函数的参数必须声明为特定的类型。所以函数只能在类型合适的表达式上使用。反之这个宏可以适用于整型、长整型、浮点型等可以用于
>来比较的类型。宏的参数是类型无关的。
宏的劣势
-
每次使用宏的时候,一份宏定义的代码将插入到程序中,除非宏比较短,否则可能大幅度增加程序的长度。
-
宏是没法调试的,程序到调试的时候,宏已经被替换了,所以程序执行的代码和程序员看到的代码是不一致。
-
宏由于类型无关,也就不够严谨。
-
宏可能会带来运算符优先级的问题,导致程序容易出现错。
-
宏结果会再次扫描,但宏定义不能递归展开;函数有明确调用边界,可以递归。
宏复制替换文本可能增大代码,不代表所有场景都比函数更快或更小。
问题 6:条件编译如何决定代码是否交给编译器?#if、#ifdef、#elif、#else、#endif 与头文件保护怎样配合?
答:
条件编译发生在预处理阶段 (在正式编译之前)。预处理器会根据条件编译指令中的条件表达式的真假,来决定保留还是丢弃代码块。
-
#if:后面跟常量表达式。如果表达式结果为真(非0),则编译后面的代码。 -
#ifdef:判断某个宏是否已定义 (#ifdef MACRO等价于#if defined(MACRO))。 -
#ifndef:判断某个宏是否未定义(常用于头文件保护)。 -
#elif:相当于else if,当前面的#if或#elif条件不满足时,检查当前条件。 -
#else:当前面所有条件都不满足时,编译这里的代码。 -
#endif:必须存在,用于结束一个条件编译块。它们必须成对出现// my_header.h
#ifndef MY_HEADER_H // 1. 如果 MY_HEADER_H 没有被定义过
#define MY_HEADER_H // 2. 则定义它,并开始编译下面的内容// ... 头文件的实际内容(结构体、函数声明等) ...
#endif // 3. 结束条件编译块
执行流程:
-
第一次 被
#include时:MY_HEADER_H未定义,条件为真。预处理器会定义MY_HEADER_H,并把头文件内容交给编译器。 -
第二次 被
#include时:MY_HEADER_H已经被定义过了,#ifndef条件为假。预处理器会直接跳过头文件内容,直到#endif,从而避免了重复编译。
问题 7:#include <xxx.h> 和 #include "xxx.h" 的查找策略有何不同?# 字符串化与 ## 记号粘合分别解决什么问题?
答:
库文件包含#include <xxx.h>:查找头文件直接去标准或库路径下去查找,如果找不到就提示编译错误。
本地文件包含 #include "xxx.h":先在源文件所在目录下查找,如果该头文件未找到,编译器就像查找库函数头文件一样在标准位置查找头文件。如果找不到就提示编译错误。
# 运算符将宏的一个参数转换为字符串字面量,# 运算符所执行的操作可以理解为**"字符串化"**。
它仅允许出现在带参数的宏的替换列表中。
## 可以把位于它两边的符号合成一个符号,它允许宏定义从分离的文本片段创建标识符。## 被称为记号粘合。
这样的连接必须产生一个合法的标识符,否则其结果就是未定义的。
这里我们想想,写一个函数求 2 个数的较大值的时候,不同的数据类型就得写不同的函数。
高频问题 1:请从预处理器的职责出发,串联预定义符号、宏替换、条件编译、#include 和头文件保护,说明源代码如何在进入编译器前被处理。
答:
预处理器先展开预定义符号和宏,再按条件编译结果保留代码;#include 会插入头文件内容,头文件保护用宏标记让内容只展开一次。完成后,编译器接收的是整理好的源代码。
高频问题 2:请解释函数式宏中参数括号和整体括号的必要性,并结合 SQUARE、DOUBLE 和 MAX 示例说明运算符优先级与副作用会造成什么结果。
答:
参数括号隔离实参运算符,整体括号隔离宏表达式与调用处运算符;否则 SQUARE(a+1) 和 10*DOUBLE(a) 会分别出现 a+1*a+1、10*(a)+(a) 的问题。MAX(x++,y++) 即使括号正确,也会因参数在比较和分支中重复求值而产生副作用。
高频问题 3:请比较 #include <xxx.h> 与 #include "xxx.h" 的查找差异,并说明条件编译如何用于调试开关、跨平台适配和避免头文件重复包含。
答:
双引号先查当前源文件目录,尖括号按标准或库路径查找。条件编译可用宏控制调试输出、按平台宏选择实现,并用 #ifndef/#define/#endif 防止头文件重复包含。