例子:班主任猜学生来自哪个小学
场景设定
某初中班主任发现,班上50个学生的数学成绩 x1,...,x50 明显分成两类:一类成绩普遍偏高,一类普遍偏低。他怀疑这些学生来自两所不同的小学(A小学和B小学),但档案里没有记录每个学生毕业于哪所小学。
他想估计:
-
A小学毕业生的数学成绩均值 μA 和方差 σA2
-
B小学毕业生的数学成绩均值 μB 和方差 σB2
-
以及两所小学的学生各占多少比例 πA,πB,表示随便抽一个学生,他属于 A 班的概率是 πA,属于 B 班的概率是 πB(且 πA+πB=1)
这里,每个学生"来自哪所小学"就是隐变量 zi。
-
观测数据 xi:学生的数学成绩,能看到。
-
隐变量 zi:学生来自A还是B,看不到。
如果档案里写了"毕业于A小学",那就没有隐变量了,直接分组算均值和方差就行。但正因为没写,只能看到成绩,看不到来源,所以 zi是隐藏的。
1. 不引入隐变量,直接算很麻烦
这里的 MLE(最大似然估计)目标是找出一组参数 θ={πA,πB,μA,σA2,μB,σB2},使得这 50 个成绩被观测到的概率最大。
你只有成绩 xi,似然函数为:
这个函数的值越大,说明这组参数越能解释当前的数据。
:连乘符号。因为假设 50 个学生的成绩是相互独立 的,所以"同时观测到这 50 个成绩"的总概率,等于每个学生成绩出现概率的乘积。
正态分布(高斯分布)的概率密度函数。它表示:如果学生属于 A 群体,那么考出成绩 xi 的概率密度是多少。
因为我们不知道 第 i 个学生到底属于 A 班还是 B 班(这就是缺少隐变量),所以对于单独一个学生 xi,我们不能武断地说他就是 A 或 B。我们只能计算他考出这个成绩的总概率,这由两部分组成:
-
他属于 A 且考出 xi 的概率:πA×N(xi∣μA,σA2)
-
他属于 B 且考出 xi 的概率:πB×N(xi∣μB,σB2)
根据全概率公式,这个学生考出 xi 的总概率,就是这两种可能性的和:
P(xi)=πAN(xi∣μA,σA2)+πBN(xi∣μB,σB2)
把每个学生的 P(xi) 乘起来,就得到了整个样本集的似然函数 L(θ)
然后取 log 对每个参数求偏导,令偏导数等于 0,然后解方程组。
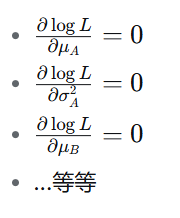
当你对 μA 求导时,根据链式法则,你会得到类似这样的项:
这就导致所有的参数死死地纠缠在一起(耦合在一起)。无法像解普通高斯分布那样,得出一个干净的、独立的解析解(闭式解,Closed-form solution)。比如,无法写出 μA=1/n∑xi 这种直接的公式。
2. 如果知道每个学生来自哪所小学,就太简单了
假设班主任偷偷拿到了档案,知道每个学生来自A还是B。那直接:
-
A小学组:算成绩均值和方差
-
B小学组:算成绩均值和方差
-
比例:数一数各有多少人
一步到位,但问题是:档案没有,zi 未知。
于是EM的思路就是:
既然不知道每个学生具体来自哪所小学,那就先根据当前参数,猜 每个学生来自A和B的概率(E步);然后根据这些概率,加权算出新的均值和方差(M步);再回头重新猜,反复迭代。(可以证明收敛)
3. EM具体怎么操作?
初始化
先随便猜一组参数,比如:
-
μA=85,σA=5
-
μB=60,σB=5
-
πA=0.5,πB=0.5
E步:猜每个学生来自A/B的概率
对每个学生 xi,用贝叶斯公式算"责任度"("责任度"(Responsibility)指的是某个数据点 i 由某个特定的子分布(或类别)生成的概率。):
比如一个学生考了82分:
-
在A分布下概率较高,在B分布下概率较低
-
算出 γiA=0.9,γiB=0.1
意思是:这个学生有90%的可能来自A小学,10%来自B小学。
M步:用责任度加权更新参数
E步(Expectation) :先随便猜一组参数,然后利用上一张图的公式算出每个点对 A 和 B 的责任度 γ。
M步(Maximization) :拿着算出来的责任度 γ 作为权重,代入这张图的公式,重新计算更好的 参数。
循环:用新的参数再去算新的责任度,再更新参数......如此反复,直到参数不再变化,模型就训练好了。
数据
| 学生 | 成绩 |
|---|---|
| 1 | 92 |
| 2 | 78 |
| 3 | 72 |
| 4 | 55 |
初始参数
-
μA=80,σA=10
-
μB=65,σB=10
-
πA=0.5,πB=0.5
第1轮
E步:
学生1(92):
-
A:(92−80)^2/200=144/200=0.72 exp(−0.72)=0.487
-
B:(92−65)^2/200=729/200=3.645 exp(−3.645)=0.026
-
γ1A=0.487/(0.487+0.026)=0.95
| 学生 | 成绩 | γiAγiA | γiBγiB |
|---|---|---|---|
| 1 | 92 | 0.95 | 0.05 |
| 2 | 78 | 0.70 | 0.30 |
| 3 | 72 | 0.48 | 0.52 |
| 4 | 55 | 0.07 | 0.93 |
M步:
A组总权重:0.95+0.70+0.48+0.07=2.20
μA= (0.95×92+0.70×78+0.48×72+0.07×55) / 2.20 = 82.0
μB= (0.05×92+0.30×78+0.52×72+0.93×55) / 1.80 = 64.8
第1轮结束:
| 参数 | A小学 | B小学 |
|---|---|---|
| 均值 | 82.0 | 64.8 |
| 标准差 | 9.66 | 约9.5 |
| 比例 | 0.55 | 0.45 |
第2轮
用新参数重新算E步。因为 μA从80升到82,μB 从65降到64.8,变化不大,所以责任度变化也不大,但会稍微调整:
-
学生2(78)的 γ2A 可能从0.70升到0.75左右
-
学生3(72)的 γ3A 可能从0.48降到0.45左右
M步再更新,μA 会稍微升一点,μB 稍微降一点。
第3、4轮
每轮变化越来越小,最后稳定在某个值,比如:
-
μA≈83
-
μB≈63
-
πA≈0.5
收敛。
四、引入隐变量后变简单了吗?
单步确实变简单了
-
E步:只是算每个学生的后验概率,套公式就行。
-
M步:只是加权算均值和方差,有闭式解,非常简洁。
引入隐变量后,M步里 μA 只出现在A组的加权公式里,μB 只出现在B组里,解耦了。
但整体变成了迭代
-
不能一步求出全局最优,要反复E/M。
-
可能收敛到局部最优:如果初值猜得不好,比如把 μAμA 初始化成60、μBμB 初始化成85,可能也能收敛,但分组含义反了;更糟的是可能卡在某个不合理的局部解。
-
对初值敏感:初始化不同,结果可能不同。
结论:引入隐变量不是让问题"变简单"了,而是让问题"变得可解"了。 它把"不知道每个学生来自哪所小学"这个大难题,拆成"先猜概率,再加权算参数"的小步骤,每步都容易做,而且保证整体不倒退。