串口接收不定长数据,几乎每个 STM32 工程师都写过。最常见的解法就是「DMA + 空闲中断 IDLE」:DMA 把字节搬进内存,IDLE 一触发就知道一帧收完了。网上教程一抓一大把,但跑得起来和用得稳妥是两回事。高波特率下丢包、H7 上读到脏数据、ISR 里处理太久卡死别的任务,这些坑教程很少讲全。
这篇把"完整实现"拆开:先讲三者各自干什么,再给两套可编译方案(普通 DMA 重启版 + 循环 DMA 环形缓冲版),最后把 Cache 一致性、NDTR 竞态、RTOS 集成这几个真坑一次说清。代码基于 STM32F4 HAL,H7 差异单独标。
一、三个角色各自的活:为什么是它们仨
不定长串口接收的本质难点只有一个:你不知道一帧有多长,又不想每收一个字节就打断 CPU。
-
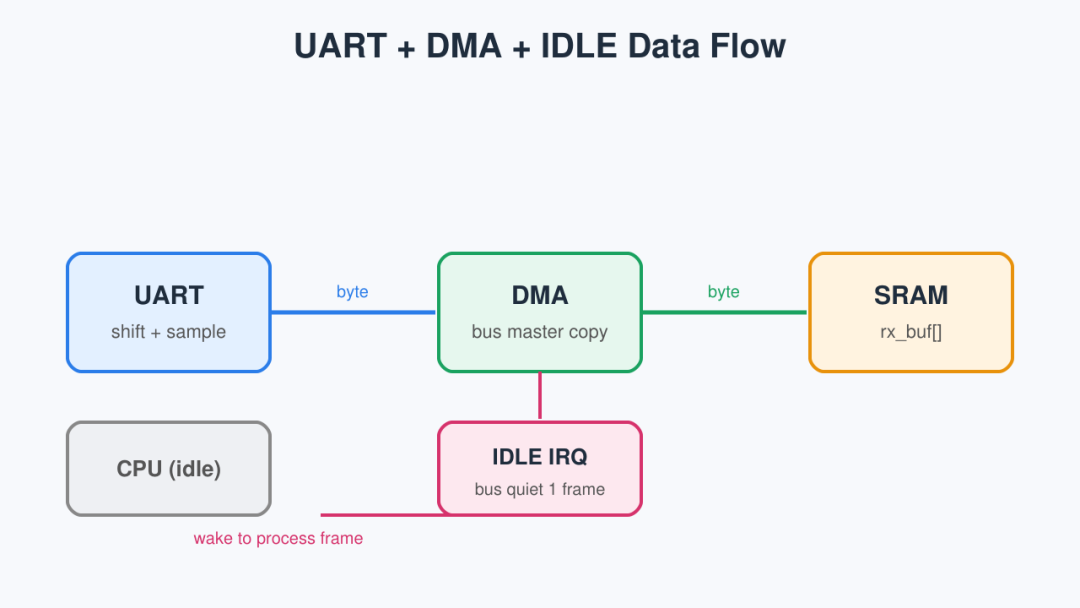
UART 外设 :负责把 RX 引脚上的串行位流,按波特率采样、去掉起始/停止位,拼成并行字节,送进
USARTx->DR(数据寄存器)。它只管"到字节了",不管"帧到哪了"。 -
DMA :总线主设备,被授权后可以自己发起总线事务 ,把
USARTx->DR里的字节直接搬到你指定的 SRAM 缓冲,全程不经过 CPU 寄存器、不进流水线。CPU 在这段时间里可以去干别的,甚至进低功耗。 -
IDLE 中断 :UART 检测到总线上连续一个字节时间(1 个 frame,含停止位)没有新数据时,置 IDLE 标志并触发中断。它就是我们判断"一帧结束了"的天然信号,不用约定长度,也不用靠超时定时器轮询。
三者组合的逻辑一句话:UART 收 → DMA 搬 → 总线安静了 IDLE 喊一嗓子 → CPU 才来处理这一帧。 CPU 在整个传输过程中基本是"隐身"的。
二、核心机制:IDLE 怎么算长度
IDLE 触发后,你得知道"这次搬了多少字节"。DMA 控制器里有个寄存器 NDTR(Number of Data items To Receive,不同系列叫 CNDTR/NDT):它记录还剩多少字节没搬。
假设缓冲大小 RX_BUF_SIZE,DMA 从满计数 RX_BUF_SIZE 开始递减,每搬一个字节减 1。于是:
本次接收长度 = RX_BUF_SIZE - DMA 当前剩余计数
= RX_BUF_SIZE - __HAL_DMA_GET_COUNTER(&hdma_uart_rx)
这个"剩余计数"就是解帧的关键。注意:读 NDTR 的时机必须是在 IDLE 触发、且下一字节还没到来之前,否则计数会被后续数据改掉。这正是后面普通 DMA 方案的竞态来源。
IDLE 标志的清除也有坑,不同系列不一样:
-
F1/F4 :必须先读
USARTx->SR,再读USARTx->DR,标志才清。HAL 提供__HAL_UART_CLEAR_IDLEFLAG(&huart)。 -
清不干净,IDLE 会一直反复进中断。
三、CubeMX / HAL 配置要点
-
打开目标 UART,Mode 设
Asynchronous。 -
在
DMA Settings里添加USARTx_RX的 DMA 请求:• Direction:Peripheral To Memory
• Mode :先选
Normal(普通模式,方案 A);要上环形缓冲再选Circular(方案 B)• Increment Address:Peripheral 不增、Memory 自增
• Data Width:Byte(外设和内存都 Byte)
-
IDLE 中断不在 CubeMX 的 NVIC 勾选项里 ,需要代码手动开:
cpp__HAL_UART_ENABLE_IT(&huart1, UART_IT_IDLE);通常在
MX_USART1_UART_Init()之后、启动 DMA 之前调用一次。 -
启动接收:
HAL_UART_Receive_DMA(&huart1, rx_buf, RX_BUF_SIZE);
四、方案 A:普通 DMA + IDLE 重启(最简可编译版)
思路:DMA 设为 Normal,收满 RX_BUF_SIZE 或 IDLE 触发时,在回调里算出长度、拷走数据、再重新启动 DMA。
cpp
#define RX_BUF_SIZE  128
uint8_t rx_buf[RX_BUF_SIZE];
volatile uint8_t rx_done = 0;
volatile uint16_t rx_len = 0;

void MX_USART1_UART_Init(void)
{
    // ... HAL 自动生成 ...
    __HAL_UART_ENABLE_IT(&huart1, UART_IT_IDLE);   // 手动开 IDLE
    HAL_UART_Receive_DMA(&huart1, rx_buf, RX_BUF_SIZE);
}

// IDLE 中断统一入口:UART 全局中断里判断
void USART1_IRQHandler(void)
{
    if (__HAL_UART_GET_FLAG(&huart1, UART_FLAG_IDLE))
    {
        __HAL_UART_CLEAR_IDLEFLAG(&huart1);         // 先清标志
        rx_len = RX_BUF_SIZE - __HAL_DMA_GET_COUNTER(&huart1.hdmarx);
        rx_done = 1;                                // 通知主循环/任务
        // 重启 DMA(Normal 模式收完就停了,必须重开)
        HAL_UART_DMAStop(&huart1);
        HAL_UART_Receive_DMA(&huart1, rx_buf, RX_BUF_SIZE);
    }
    HAL_UART_IRQHandler(&huart1);                   // 交给 HAL 处理其他标志
}
主循环里:
cpp
if (rx_done)
{
    rx_done = 0;
    process_frame(rx_buf, rx_len);   // 真正解析一帧
}
方案 A 的两个硬伤:
-
NDTR 竞态 :
HAL_UART_DMAStop之前如果又来一字节,长度算错;更糟的是 Normal 模式下 DMA 收满RX_BUF_SIZE后自动停止 ,此时若帧还没结束、字节继续进来就会直接丢。 -
溢出即丢 :一旦一帧超过
RX_BUF_SIZE,普通模式无能为力。
适合:波特率不高(≤115200)、帧长可控、对偶发丢包不敏感的场景。
五、方案 B:循环 DMA + 环形缓冲(高吞吐不丢包)
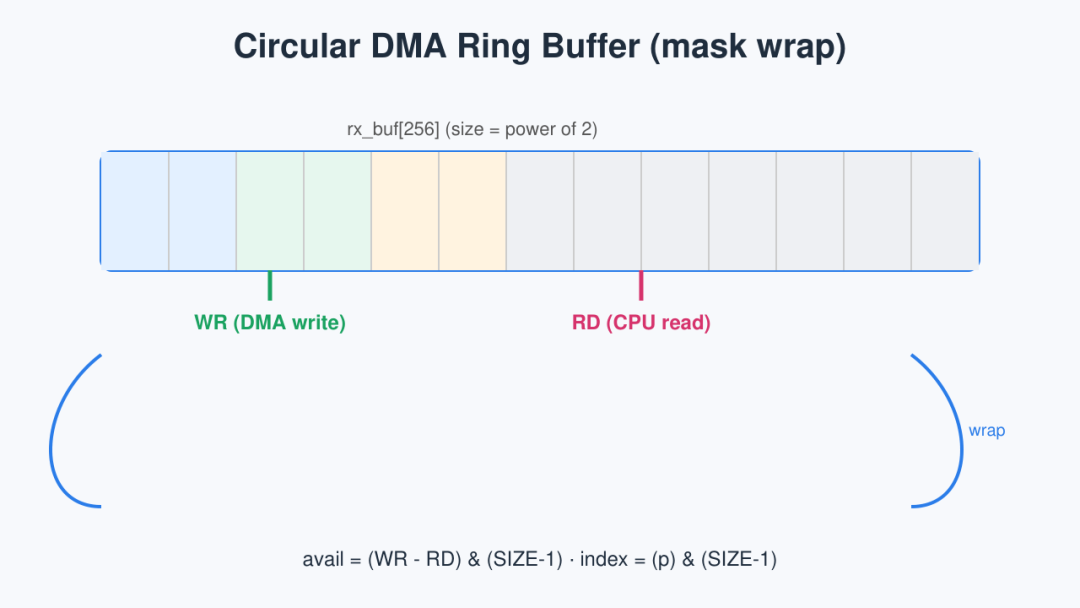
把 DMA 设成 Circular 模式,它永不停止 ,在 rx_buf 里循环写;我们在上层维护一个读指针 rd,配合一个"已被 DMA 写到哪了"的写指针(由 NDTR 反推),构成一个单生产者(DMA)/单消费者(CPU)环形队列。只要消费速度跟得上,理论上不丢包。
cpp
#define RX_BUF_SIZE  256          // 必须是 2 的幂,便于掩码回绕
uint8_t rx_buf[RX_BUF_SIZE];
volatile uint16_t rd = 0;         // 应用层读指针

// 取当前 DMA 已写到的位置(写指针由剩余计数反推)
static inline uint16_t dma_wr(void)
{
    uint16_t cnt = __HAL_DMA_GET_COUNTER(&huart1.hdmarx); // 剩余
    return (RX_BUF_SIZE - cnt) & (RX_BUF_SIZE - 1);       // 已写位置,掩码回绕
}

// 从环形缓冲读出所有可用字节,返回个数(处理回绕拷贝)
uint16_t uart_ring_read(uint8_t *out, uint16_t max)
{
    uint16_t wr = dma_wr();
    uint16_t avail = (wr - rd) & (RX_BUF_SIZE - 1);
    uint16_t n = avail < max ? avail : max;
    for (uint16_t i = 0; i < n; i++)
    {
        out[i] = rx_buf[(rd + i) & (RX_BUF_SIZE - 1)];
    }
    rd = (rd + n) & (RX_BUF_SIZE - 1);
    return n;
}
什么时候"收割"?两个入口都行:
-
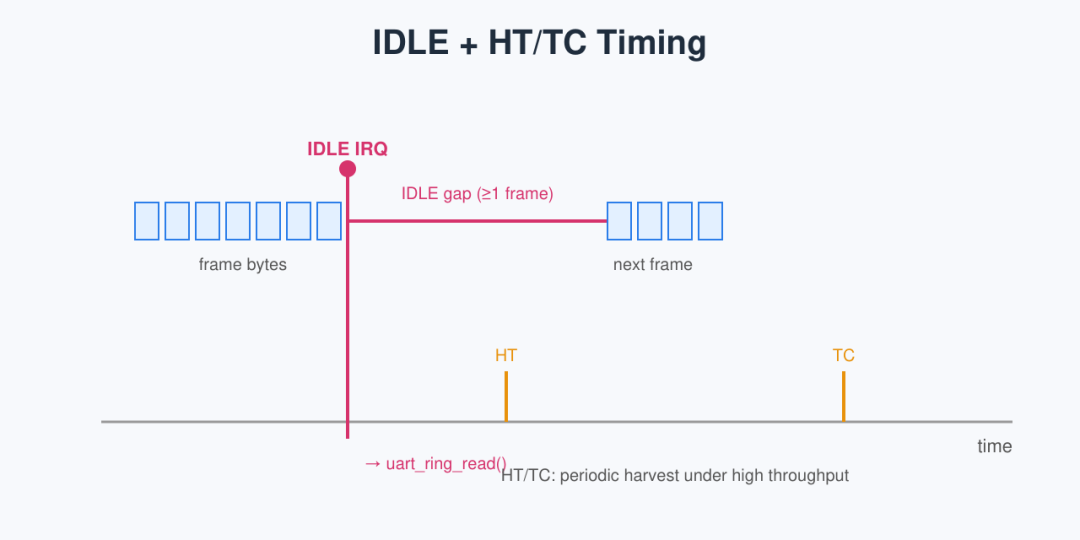
IDLE 触发时 :一帧大概率结束了,调
uart_ring_read把积攒的字节交给解析器; -
DMA 半满/全满中断(HT/TC):高吞吐下 IDLE 可能来得很晚,配合 HT/TC 中断周期性收割,进一步降低缓冲压力。
环形缓冲的关键在 掩码回绕 (& (SIZE-1)),前提是 RX_BUF_SIZE 是 2 的幂。这样 wr 越过末尾会自动绕回开头,无需 if 判断。
六、两个真坑,教程很少一次讲全
坑 1:H7/F7 的 D-Cache 一致性
F4 及以下是单总线、无独立 D-Cache,DMA 写的内存 CPU 立刻能看到。但 STM32F7/H7 带 D-Cache(且默认开启):DMA 把数据写进 SRAM,CPU 却可能从 Cache 里读到旧值,表现出来的就是"数据偶尔错位、偶发全 0、时好时坏"。
解决:在 CPU 读缓冲之前,把这块内存的 Cache 行作废,强制从 SRAM 重新加载:
cpp
// 读之前(H7/F7)
SCB_InvalidateDCache_by_Addr((uint32_t*)rx_buf, RX_BUF_SIZE);
process_frame(rx_buf, rx_len);
若缓冲地址/长度不是 32 字节对齐,Invalidate 可能误伤相邻 Cache 行,稳妥做法是把 rx_buf 用 __ALIGN(32) 对齐,或只 Invalidate 实际接收到的那一段。这是 F7/H7 上"DMA 收数不对"的头号原因。
坑 2:ISR 里别干重活
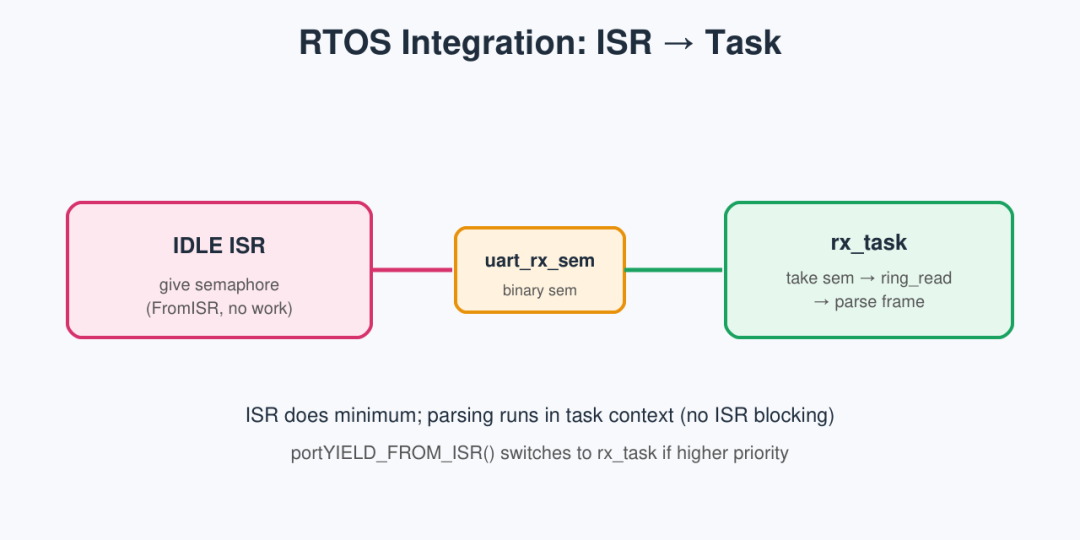
IDLE 中断是硬中断 ,在里面调 printf、解协议、甚至 malloc 都会拖死系统,还可能破坏 RTOS 临界区。正确姿势是ISR 只置标志/发信号量,解析放到任务里:
cpp
// 在 IDLE 回调里(RTOS 环境)
void HAL_UART_IdleCpltCallback(UART_HandleTypeDef *huart)
{
    BaseType_t xHigherPriorityTaskWoken = pdFALSE;
    xSemaphoreGiveFromISR(uart_rx_sem, &xHigherPriorityTaskWoken);
    portYIELD_FROM_ISR(xHigherPriorityTaskWoken);
}
任务侧阻塞等信号量,拿到后 uart_ring_read + 解析,干净且不影响其他任务调度。
七、选型建议
| 维度 | 方案 A 普通 DMA 重启 | 方案 B 循环 DMA 环形缓冲 |
|---|---|---|
| 实现复杂度 | 低,几十行 | 中,需维护双指针 |
| 高波特率吞吐 | 一般,有暂停窗口 | 强,DMA 不停车 |
| 超长帧/突发 | 易丢 | 不丢(消费跟得上) |
| 中断频率 | 每帧一次 | 每帧一次 + 可选 HT/TC |
| 适用 | 调试口、低速指令 | 模块通信、GPS/4G 上云 |
工程实践:只要不是纯调试口,直接上方案 B。它不比 A 难多少,却省掉了"偶发丢包查三天"的苦。
八、小结
UART+DMA+IDLE 不是新把戏,但"完整实现"和"demo"之间隔着三道坎:是否处理了 NDTR 竞态与溢出、是否考虑了 Cache 一致性、ISR 是否只做最小动作。把环形缓冲 + 掩码回绕 + Cache 作废 + 信号量这四件套吃透,这套接收机就能直接进产品。
你现在的项目里串口接收用的是哪种?有没有遇到过 H7 上"数据偶尔错"的灵异事件?评论区聊聊。