文章目录
- 一、Redis基础
-
- [1.1 认识Redis](#1.1 认识Redis)
- [1.2 Redis 特性](#1.2 Redis 特性)
- [1.3 Redis的适用场景](#1.3 Redis的适用场景)
- [1.4 Redis版本规则与特性](#1.4 Redis版本规则与特性)
- [1.5 Redis基础命令行](#1.5 Redis基础命令行)
- [1.6 Redis客户端与服务器交互过程](#1.6 Redis客户端与服务器交互过程)
- 二、全局通用命令
-
- [2.1 get/set](#2.1 get/set)
- [2.2 keys](#2.2 keys)
- [2.3 exists](#2.3 exists)
- [2.4 del](#2.4 del)
- [2.5 expire/pexpire](#2.5 expire/pexpire)
- [2.6 ttl/pttl](#2.6 ttl/pttl)
- Redis中key的过期删除策略
- [2.7 type](#2.7 type)
- 三、数据类型与内部编码
-
- [3.1 数据类型](#3.1 数据类型)
- [3.2 内部编码](#3.2 内部编码)
- 四、单线程架构
-
- [4.1 单线程模型的工作过程](#4.1 单线程模型的工作过程)
- [4.2 单线程为什么这么快](#4.2 单线程为什么这么快)
一、Redis基础
1.1 认识Redis
Redis 全称 REmote Dictionary Server(远程字典服务器),是当下互联网行业使用最广泛的内存 NoSQL 数据库。不同于普通的键值数据库,Redis 的 value 并非只能存储简单字符串,而是支持字符串、哈希、列表、集合、有序集合等丰富的数据结构,同时拓展了位图、HyperLogLog、GEO 地理位置、Stream 流等高级能力。
Redis 将绝大部分数据存放于内存,带来极高的读写性能,官方标称可达10 万 QPS。同时提供 RDB、AOF 两套持久化方案,可以把内存数据落地磁盘,规避断电、机器宕机带来的数据丢失风险。除此之外还具备键过期、发布订阅、事务、流水线 Pipeline、Lua 脚本、主从复制、哨兵、集群等全套能力。
Redis 官方原生并不支持 Windows 操作系统,Windows 版本是微软团队维护的分支。生产环境一律使用 Linux 操作系统运行 Redis。
1.2 Redis 特性
-
性能极高,读写速度快
- 全部数据存储在内存中,内存访问速度远高于磁盘,这是最根本原因。谷歌硬件性能统计,内存访问约100ns,磁盘寻道需要10ms级别,相差十万倍。
- Redis核心功能就是操作内存中的数据结构,都是比较简单的逻辑
- 网络上,Redis使用了IO多路复用的方式(epoll),也就是使用一个线程管理多个socket。
- 单线程执行命令 。Redis 6.0版本引入多线程,但多线程仅仅负责网络IO读写、协议解析,所有数据命令依旧是单线程执行。单线程规避多线程锁竞争、线程上下文切换的巨大开销。
- Redis使用C语言编写,代码贴近操作系统底层,没有高级语言额外开销。
-
基于键值对的数据结构服务器:普通KV数据库value只能存字符串,Redis value支持多种复杂数据结构:
string、hash、list、set、zset,衍生Bitmaps、HyperLogLog、GEO、Stream。开发者可以直接使用内置数据结构完成业务,不需要自己做二次封装,大幅提升开发效率。 -
功能丰富,除基础数据结构外,配套大量实用能力:
- 键过期:key设置TTL过期时间,天然适合缓存场景;
- 发布订阅:实现简单消息广播;
- Lua脚本:把多条命令打包在脚本中执行,保证原子执行;
- 简易事务;
- Pipeline流水线:把多条命令打包一次性发给服务端,减少网络往返RTT。
-
简单稳定
- 代码量小:早期版本代码约2万行,3.0加入集群后约5万行,对比其他NoSQL体量很小,开发者可以通读理解源码。
- 单线程模型,服务端、客户端逻辑都更简单。
- 不依赖第三方系统库,事件驱动模型全部自己实现。
- 生产环境稳定性很高,极少因为Redis自身bug发生宕机。
-
支持多语言客户端:Redis使用简单的TCP通信协议,Java、C++、Python、PHP、NodeJS、Go等主流编程语言都拥有成熟客户端
-
持久化:内存数据易失,断电数据丢失。Redis提供RDB、AOF两种持久化,把内存数据保存硬盘(相当于把内存中的数据备份),重启可以加载文件恢复数据。
-
主从复制:支持主从复制,一台主节点的数据自动同步到多台从节点,生成多份数据副本。主从复制是哨兵、集群的底层基础。可以实现数据备份、读写分离。
-
高可用与分布式
- Redis Sentinel哨兵:实现故障自动发现、故障转移,解决主节点宕机人工切换,实现高可用;
- Redis Cluster集群:官方分布式分片方案,实现横向扩容,提升存储容量与读写吞吐量。
1.3 Redis的适用场景
典型适用业务场景
- 缓存(Cache) 缓存是Redis最经典场景。把热点数据放到Redis,请求优先读取Redis,缓存未命中才查询后端MySQL数据库。既加速接口响应,又大幅降低数据库压力。同时Redis支持key过期、内存淘汰策略,完美适配缓存业务。
- 计数器应用 视频播放量、文章浏览数、点赞数。高并发场景,数据库做自增压力巨大,Redis的INCR系列命令可以高性能完成计数。计数数据可以异步落地到数据库。
- 社交网络业务 点赞、踩、粉丝关系、共同好友、消息推送。社交业务访问量大,关系型数据库处理关系类数据成本高,Redis的数据结构可以轻松实现。
- 简易消息队列 利用List的阻塞弹出
brpop/blpop实现阻塞队列;也可以使用发布订阅完成消息广播。但它不是专业MQ,没有完备的消息确认、死信队列,适合简单业务。
不适合的场景
Redis数据主要放在内存,内存硬件成本远高于磁盘。
海量冷数据不适合存入Redis。像冷数据这样访问频率极低的数据,全部放在Redis会带来极高硬件成本,冷数据应该存MySQL、HDFS这类磁盘存储。
原则:Redis优先存放热数据。冷热分离,热数据Redis加速,冷数据磁盘存储。
1.4 Redis版本规则与特性
Redis版本命名借鉴Linux:版本第二位偶数代表稳定版本,奇数代表开发测试版本。生产环境务必选用偶数稳定版。
- 2.6:支持Lua脚本、毫秒级key过期、位图命令bitcount;
- 2.8:部分复制PSYNC雏形,Sentinel哨兵正式生产可用;
- 3.0:正式发布Redis Cluster集群;
- 3.2:新增GEO地理位置,list底层使用quicklist;
- 4.0:模块扩展能力、PSYNC2.0完整部分复制、LFU淘汰算法、unlink异步删除、RDB‑AOF混合持久化;
- 5.0:新增Stream流数据类型;
- 6.0:IO多线程、ACL权限管控、SSL加密、客户端缓存;
- 7.0:AOF改为多文件存储,RDB格式升级。
1.5 Redis基础命令行
Redis官方不支持Windows,Windows版本由微软开源小组维护,生产环境全部部署Linux。
Redis重要程序文件
| 文件 | 功能 |
|---|---|
| redis‑server | Redis服务主程序 |
| redis‑cli | Redis命令行交互客户端 |
| redis‑benchmark | 性能压测工具 |
| redis‑check‑aof | 修复损坏AOF持久化文件 |
| redis‑check‑rdb | 修复损坏RDB快照文件 |
| redis‑sentinel | 哨兵程序,实际是redis‑server软链接 |
- 配置文件:
/etc/redis.conf - 持久化文件目录默认:
/var/lib/redis/ - 日志目录默认:
/var/log/redis/
命令行客户端
redis‑cli两种使用模式:
- 交互式:进入客户端之后逐行输入命令
bash
redis-cli -h 127.0.0.1 -p 6379
127.0.0.1:6379> ping
PONG
127.0.0.1:6379> set key hello
OK
127.0.0.1:6379> get key
"hello"-
命令模式,直接执行命令输出结果,适合脚本调用
redis-cli -h 127.0.0.1 -p 6379 get key
本地默认端口6379,不写‑h、‑p默认连接本机6379。
1.6 Redis客户端与服务器交互过程
Redis 使用TCP 协议 进行通信,默认端口 6379,通信协议是RESP(Redis 序列化协议)
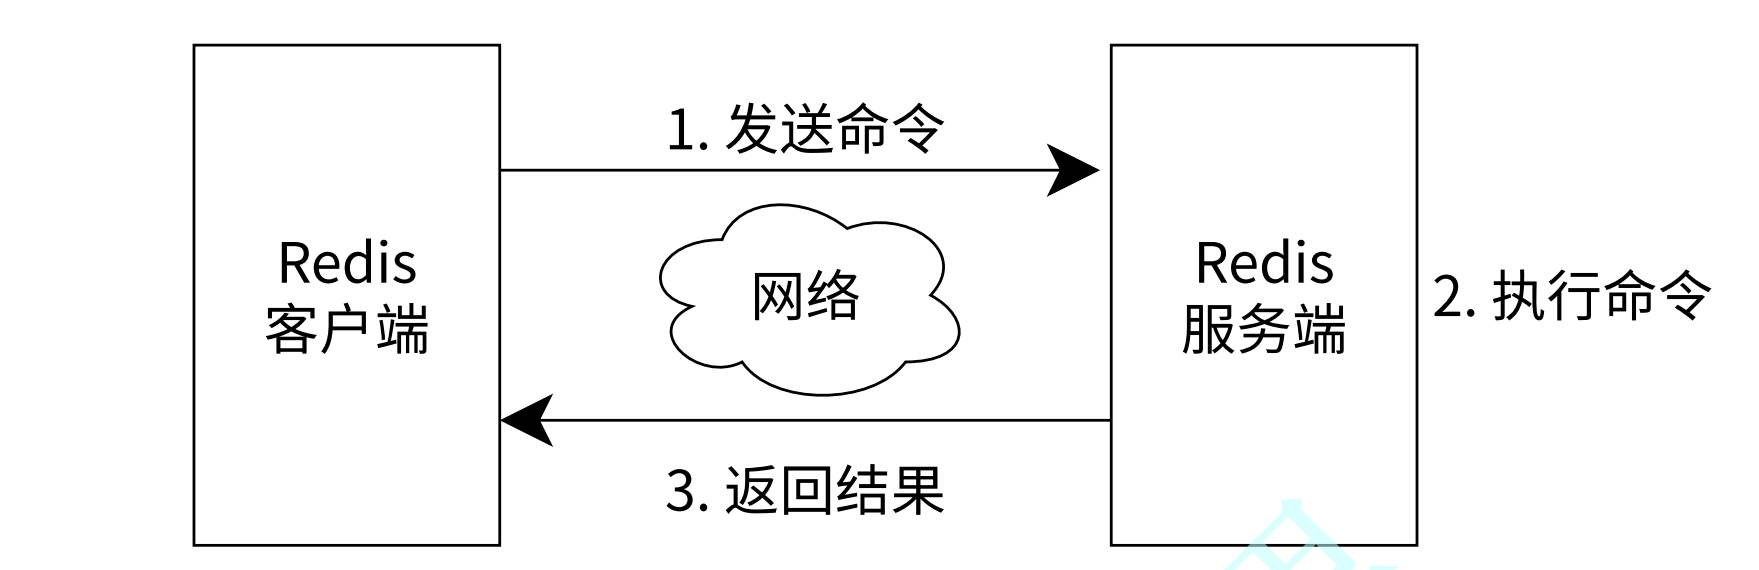
- 建立 TCP 连接 客户端向 Redis 服务端发起 TCP 三次握手,建立 socket 连接。一个客户端对应一条 socket 通道,多个客户端可以同时连服务器。
- 客户端构造 RESP 协议请求 客户端(Java 的 Jedis/Lettuce 等)把我们调用的命令,例如
set key value,封装成RESP 格式字符串,通过 socket 发送给 Redis 服务器。 - Redis 服务器读取请求 Redis 是单线程事件模型(IO 多路复用),监听所有 socket 事件。读到客户端发来 RESP 请求,解析出真实 Redis 命令。
- 执行命令 解析完成,调用内部函数执行这条命令,操作内存数据。同一时刻只执行一条命令,命令串行执行。
- 封装 RESP 响应结果 把执行后的返回值(成功、字符串、nil、数字等)包装成 RESP 响应报文。
- 回写给客户端 通过 socket 把 RESP 响应发送回客户端。
- 客户端解析 RESP 响应 客户端解析 RESP 报文,转换成编程语言的数据对象,给到业务代码使用。
- 连接维持 / 关闭
- 如果是长连接:socket 保持,复用来反复收发命令(连接池就是利用长连接)
- 如果短连接:交互完成后关闭 TCP 连接,四次挥手断开。
二、全局通用命令
redis按照键值对的形式存储数据,key是字符串类型,""或''可以加上也可以省略。value可以有多种类型,包括字符串,哈希表,列表,集合和有序集合等。
全局命令就是指可以操作任意数据类型的命令。
redis中命令不区分大小写。
2.1 get/set
get/set用于存取键值对
语法:
bash
set key value
get key
注意: get命令只能用于value为String类型的key
2.2 keys
通过通配符描述一个key,符合描述的key就可以被查询出来
语法:
bash
keys pattern 通配符:
?:匹配任意一个字符*:匹配任意数量的任意字符[字符1 字符2...]:给出固定选项,指定匹配其中一个字符[^字符]:排除字符,其余的字符都可以匹配[字符1-字符2]匹配字符1到字符2之间任意一个字符
时间复杂度: O(N)
注意: 如果使用keys *就相当于查询所有的key,生产环境中key的数量非常多,而redis是单线程的服务器,会阻塞整个Redis。因此生产环境中禁止使用keys命令
2.3 exists
判断key是否存在,一次查询多个key,返回存在key的数量。
语法:
bash
EXISTS key [key ...]示例:
bash
redis> SET key1 "Hello"
"OK"
redis> EXISTS key1
(integer) 1
redis> EXISTS nosuchkey
(integer) 0
redis> SET key2 "World"
"OK"
redis> EXISTS key1 key2 nosuchkey
(integer) 2
时间复杂度: redis是按照 哈希表 来组织键值对的,对于单个key,时间复杂度是O(1),官方文档给出的时间复杂度是O(N),N是指待查询key的数量。
为什么redis要设计一个命令可以操作多个key?
redis是客户端-服务器结构的程序,客户端和服务器之间使用网络 通信。如果分开操作,就会产生多个轮次的通信。而网络通信与内存相比,效率低,成本高,每一次网络通信都涉及封装 和分用。
因此redis很多命令都支持多种操作,从而减少客户端和服务器的交互次数。
2.4 del
删除一个或多个key,返回成功删除个数
语法:
bash
DEL key [key ...]时间复杂度: O(1)
当Redis作为缓存 ,与MySQL中的drop或delete命令相比,Redis中的del命令危险程度并不大。
Redis主要应用场景就是缓存,此时Redis中存储热点数据,全量数据在MySql中,随时间推移Redis中可能存在没用的key,因此删除少量的key影响并不大,可以再从MySQL中读取数据;但是如果大批量删除数据,大量的请求就直接打给MySQL,此时问题就比较严重了。
当Redis作为数据库 ,Redis中就保存全量数据,此时与MySQL一样,del命令就要谨慎操作
2.5 expire/pexpire
expire可以为key设置过期时间,超出时间key就会自动删除
语法:
bash
expire key seconds可以使用pexpire设置过期时间,单位是毫秒。
返回值:
- 1:设置成功
- 0:设置失败
只能为已经存在的key设置过期时间,如果key不存在则返回0
时间复杂度: O(1)
基于Redis实现的分布式锁,为了防止出现不能正确解锁现象,通常会在加锁的时候设置过期时间。所谓的使用Redis作为分布式锁,就是给Redis里写一个特殊的key-value,超出时间后删除特殊的key
2.6 ttl/pttl
ttl可以获取key剩余存活秒数,返回-1表示永不过期,返回-2表示key不存在
语法:
bash
ttl key pttl可以获取key剩余存活时间,单位是毫秒
时间复杂度: O(1)
TYPE key          # 查看key对外数据类型
SCAN 0            # 渐进式遍历key,分批返回,不会阻塞Redis,生产替代KEYS
KEYS会扫描全部key,实例key数量几十万上百万的时候,会阻塞Redis全部命令。线上遍历key必须用SCAN。
Redis中key的过期删除策略
Redis采用惰性删除+定期删除两种策略搭配使用。
- 惰性删除:Redis在访问或修改key时都会先检查key是否过期,如果已经过期,就会直接删除key,返回nil给客户端;如果没有过期就会把数据返回给客户端。
- 定期删除:每隔一段时间随机抽取一部分key进行检查,删除其中过期的key。
定期删除中抽取检查的过程是非常快的,因为Redis是单线程程序,处理命令和扫描过期key都在同一个线程中,如果一次扫描了大批量的key,就会导致正常的处理请求命令被阻塞。
2.7 type
type命令用于返回key对应的value的数据类型。
语法:
bash
type key时间复杂度: O(1)
返回值:
none:key不存在stringlistsetzsetstream:当redis作为消息队列时,使用这个类型的value
使用示例:
bash
redis> SET key1 "value"
"OK"
redis> LPUSH key2 "value"
(integer) 1
redis> SADD key3 "value"
(integer) 1
redis> TYPE key1
"string"
redis> TYPE key2
"list"
redis> TYPE key3
"set"
三、数据类型与内部编码
我们用type key看到的是对外暴露的数据类型;Redis底层有一套内部编码,Redis会根据数据的数量、大小,自动切换底层编码,兼顾内存占用与读写性能。
数据类型 vs 数据结构:这里的数据类型和数据结构与Java语言中的概念不一样。Redis 的数据类型是对外提供给用户使用的,是业务层面概念;底层数据结构是 Redis 内部实现存储的工具。一个 Redis 数据类型,在不同条件下可以切换不同底层数据结构,切换过程对使用者透明,用户无感知。底层数据结构对应用户是不可见的,没有操作命令。
3.1 数据类型
Redis内置了很多数据类型,其中最常用的有五种:
- String 字符串
- Hash 哈希
- List 列表
- Set 集合
- ZSet 有序集合:内部存储了score,表示权重
3.2 内部编码
针对上述的数据类型,源码层面会进行特定的优化,来达到节省时间/空间的效果。这些优化就要依靠内部具体实现的数据结构,也就是编码方式。
举个例子:对于外部来说,hash的作用就是存储键值对,保证O(1)的时间复杂度就可以找到;但是对于内部来说,不一定使用标准的哈希表,在某些特定场景下可能使用不同的数据结构来实现功能,用户感知不到这些变化。
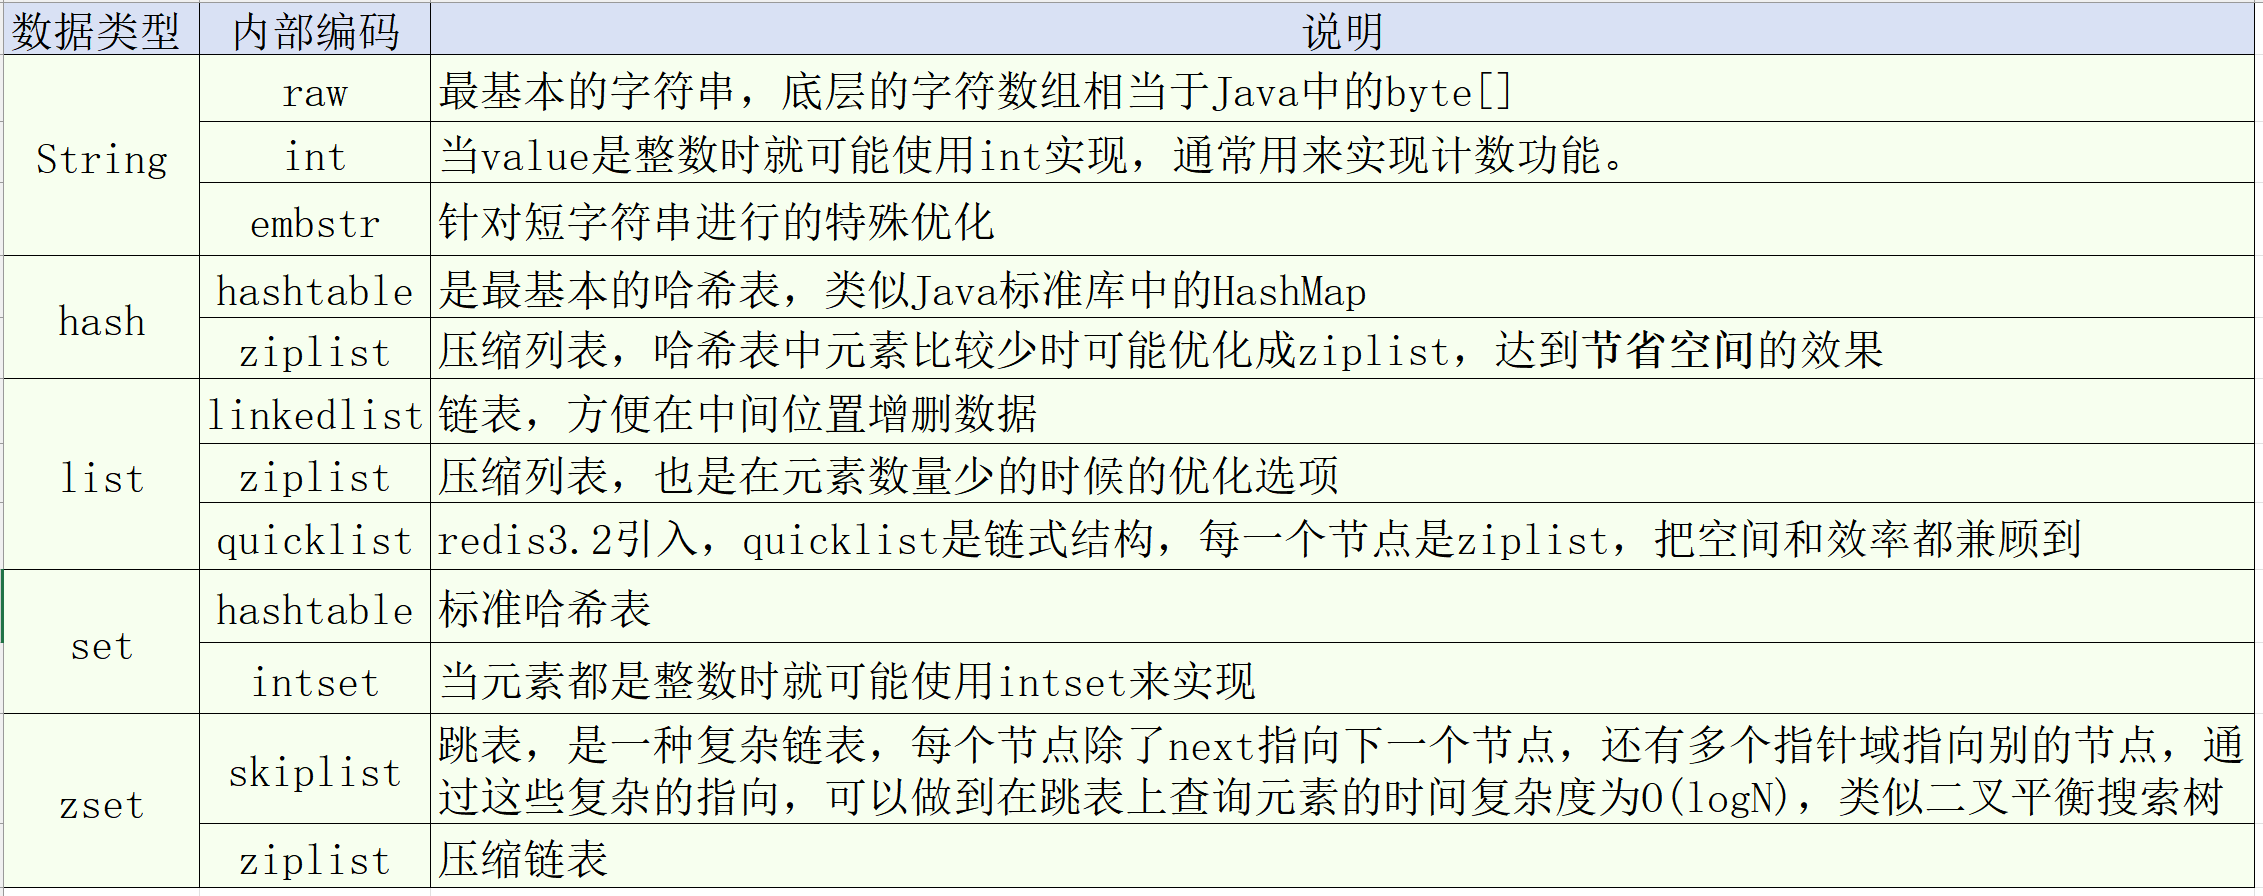
object encoding key命令可以查看key的底层内部编码:
bash
127.0.0.1:6379> set hello world
OK
127.0.0.1:6379> lpush mylist a b c
(integer) 3
127.0.0.1:6379> object encoding hello
"embstr"
127.0.0.1:6379> object encoding mylist
"quicklist"
四、单线程架构
4.1 单线程模型的工作过程
假设有三个客户端同时向redis服务器发送请求,宏观上这三个请求是并发的:
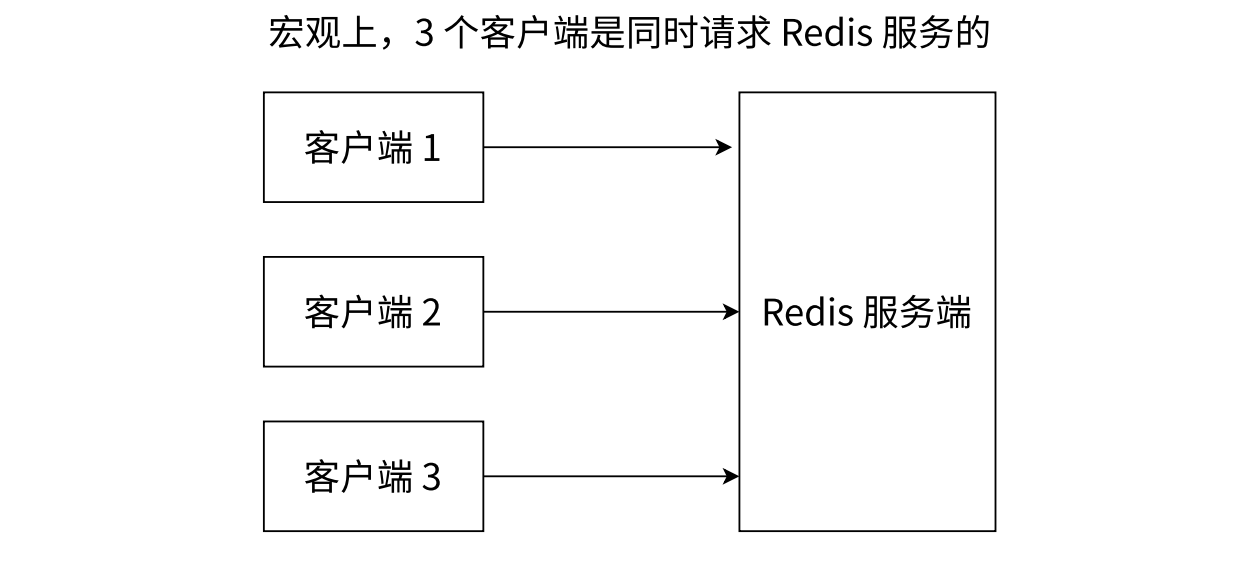
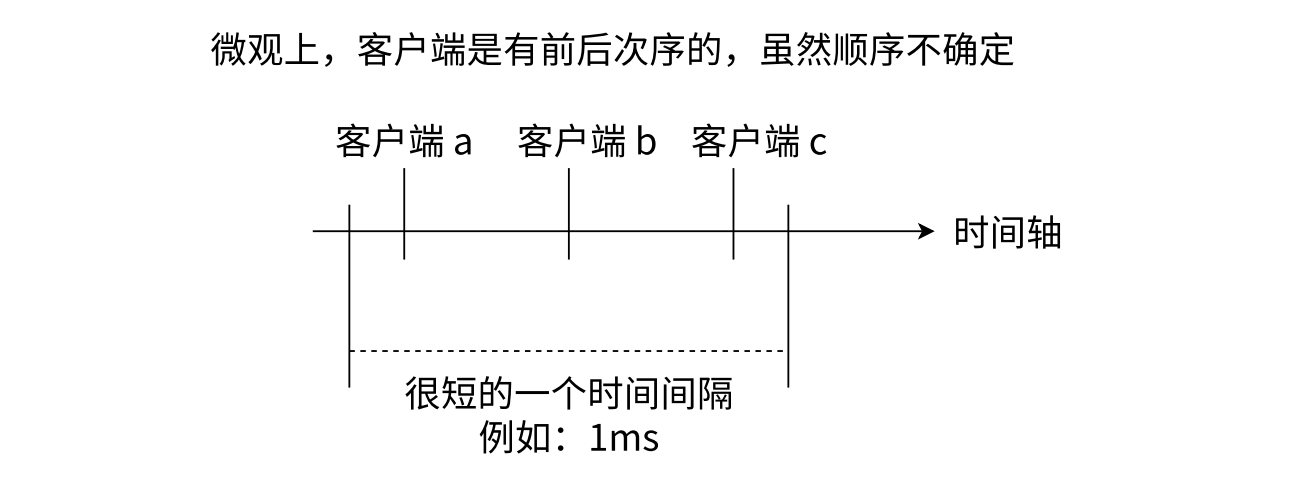
而redis服务器是单线程模型(6.0引入IO多线程,命令执行依旧是单线程),所有请求到达服务器就要在队列里排队,再等待redis服务器取出命令执行,因此微观上来讲,redis服务器就是串行执多个命令的。
4.2 单线程为什么这么快
- redis主要是访问内存,而MySQL主要是访问硬盘,内存访问速度远高于磁盘,这是最根本原因。谷歌硬件性能统计,内存访问约100ns,磁盘寻道需要10ms级别,相差十万倍。
- 逻辑简单,Redis核心功能就是操作内存中的数据结构,都是比较简单的逻辑;而MySQL的增删改查涉及到各种约束,也提供了丰富的功能(多表联查,排序,视图等),这些操作都需要更复杂的功能支撑,就会导致更多的开销。
- 单线程执行命令 。Redis 6.0版本引入多线程,但多线程仅仅负责网络IO读写、协议解析,所有数据命令依旧是单线程执行。单线程规避多线程锁竞争、线程上下文切换的巨大开销。
- 使用epoll这样的IO多路复用机制,一个线程可以管理多个socket。
一个服务器对应多个客户端,就有多个socket,而服务器和客户端之间的通信不一定都很频繁,大部分的socket都是静默的,没有数据需要传输。也就是说同一时刻只有少数的socket是活跃的。
可以通过多线程,为每一个客户端分配一个线程,但多个线程的创建调度以及销毁的开销都很大,并且大部分线程是空闲的,因此通过IO多路复用,让一个线程来处理多个socket。
IO多路复用也是操作系统实现的,操作系统向外提供一套API。Redis采用了epoll,相当于事件通知/回调机制。epoll适合在事件交互不频繁的场景下使用。
注意:
- 这里"快"的概念是与MySQL这样的关系型数据库做比较,但是与直接在内存中操作变量相比,redis就慢得多。因为redis是先通过网络再操作内存。
- 在学习多线程时我们认为多线程可以一定程度上提高效率,但是这里却说单线程是Redis高效率的原因。这是因为多线程可以在CPU密集型的任务 中发挥优势,使用多个线程可以充分利用CPU多核资源。但是对于Redis来说,核心任务主要就是操作内存中的数据结构,这些操作不会吃很多CPU,也就是说单个核心就可以解决问题了,如果这个时候引入多线程,并不会明显的提高效率,反而会因为线程安全,锁竞争,线程阻塞等问题降低效率。
单线程的风险是一个慢命令会阻塞全部请求 。 如果一次性读取几十万元素的集合、大量数据的hgetall,会造成整个服务卡顿。
对策:
- 避免大key;
- 用
scan/hscan/sscan/zscan渐进式分批遍历; - 业务拆分,不要把海量数据放到同一个key。