什么是langchain
LangChain 作为大模型与应用间的中间层,可统一调用各类大模型、管理提示词与上下文,还能集成外部工具和数据源,快速搭建具备推理、行动能力的智能体。
核心定位三点:
- 打通大模型与外部资源:统一接口对接数据库、检索引擎、API、文件系统等;
- 封装底层复杂逻辑:抽象工具调用、记忆等能力,降低智能体开发难度;
- 支撑多智能体协作:依托 LangGraph 等生态,从单智能体拓展至多智能体协作,可构建工业级智能体。
应用场景:检索增强生成(RAG),agent智能体构建,对话系统与聊天机器人,多模态应用开发,自动化写作与格式化生成,数据连接与结构化处理
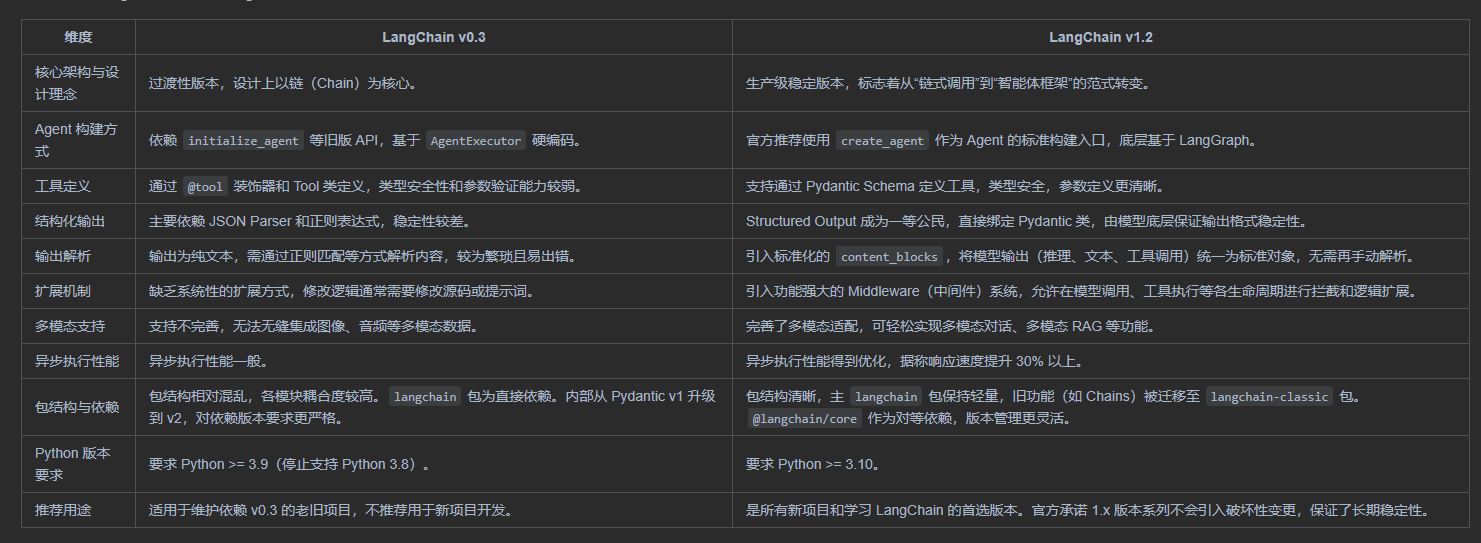
- langchain-core:官方推荐的核心 API。比如 Runnable、BaseMessage 等。
- langchain-classic:冗余代码移或不推荐使用的经典 API 移到此。比如 0.x 中常用而 1.x 移除的 API
都在这里。 - langchain-community:第三方集成,比如合作伙伴包
langchain-openai、langchain-anthropic 等,按需安装、避免臃肿。 - langgraph:深度整合 LangGraph 1.0,协调多个 Chain、Agent、Tools
完成更复杂的任务,并且还支持循环调用,是 LangChain 图形化的增强版。
API 文档
Github 地址:https://github.com/langchain-ai
中文文档地址:https://docs.langchain.org.cn/oss/python/langchain/overview
英文文档地址:https://docs.langchain.com/oss/python/langchain/overview
API 文档查询地址:https://reference.langchain.com/python/langchain/
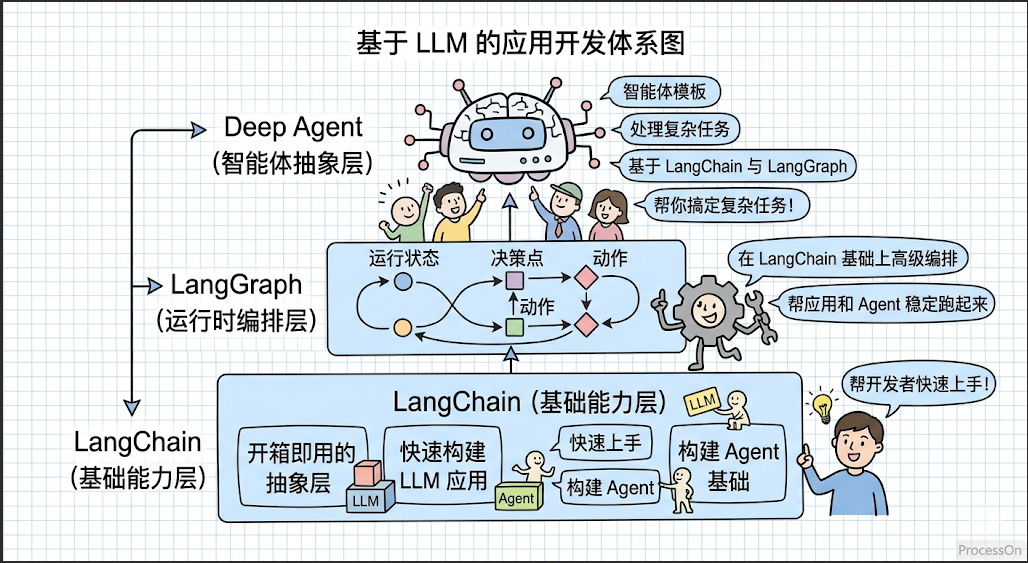
LangChain 是整个生态的核心与起点,为开发者提供了模型调用、工具与中间件集成、智能体构建等一整套基础能力。
其核心价值如下:
统一的模型抽象层:屏蔽了不同模型服务提供商(如 OpenAI、Anthropic、Ollama 等)的接口差异,提供一致的调用方式。
高度模块化的设计:使用 Message、Tool、Agent、Middleware 等组件实现灵活的组合与扩展。
丰富的集成生态:预置了丰富的数据源、API、中间件等,构成了强大的 AI 能力枢纽。
在整体架构中,LangChain 如同智能体的操作系统内核,是所有上层能力构建的基础。
结论:如果你需要构建简单的智能体应用,无需复杂的编排需求,那就选择 LangChain。
当智能体的任务从单一指令执行扩展为多步骤、有状态的复杂工作流时,LangGraph 应运而生。
其核心思想是将智能体内部抽象为一张有向图。
节点(Node):代表独立的功能单元或决策点。
边(Edge):定义了节点之间的流转条件与路径。
状态(State):作为一个共享上下文,在节点间传递并持久化存储任务信息。
通过这种图式结构,LangGraph 让智能体的工作流节点交互变得显式、可控、可观测。
Deep Agent 是新推出的全新组件,被定位为 Agent Harness(智能体执行框架)。它构建于 LangChain 与 LangGraph 之上,增加了规划能力、文件系统、子 Agent 等高级功能。旨在让开发者无须从零构建复杂的控制逻辑,即可创建具备深度规划、长期记忆与多专家协作能力的智能体。
Deep Agent 的核心能力如下:
显式规划:自主生成、执行并动态调整多步任务计划。
虚拟文件系统:为智能体提供结构化的中间结果与知识存储。
子智能体:支持任务在多个智能体之间的分解与协作。
长期记忆:通过与 LangGraph 状态存储的结合,实现跨对话的经验积累。
可扩展中间件:允许嵌入安全审计、性能监控或自定义业务逻辑。
什么是RAG
让模型回答具备1.正确性,2.实时性,3.减少幻觉,4.有据可依
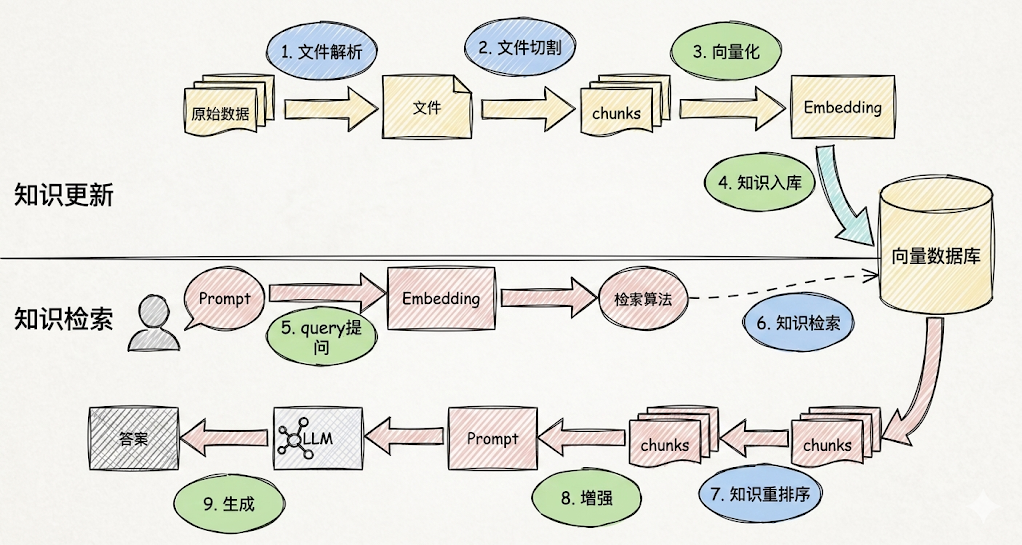
这些过程中的难点:1、文件解析;2、文件切割;3、知识检索;4、知识重排序。
文件解析:如果是 PDF,内部包含文件、图片、表格,图片上还有文字,需要处理。
文件切割:没有固定的格式。
知识重排序:在 RAG 应用中,随着文档数量增加,召回准确率会下降,引入 reranker(重排器)可对初步召回的较多 chunk(如 top 20 或 top 50)进行精排,提高召回准确率,防止 LLM 处理无关信息,减少时间和成本。
此外,与基于基本矢量搜索的 RAG 相比,reranker 增强型 RAG 的成本更高,但与仅依靠 LLM 生成答案相比,它的成本低些。
Reranker 的使用场景
适合:追求回答高精度和高相关性的场景中特别适合使用 Reranker,例如专业知识库或者客服系统等应用。
不适合:引入 reranker 会增加召回时间,增加检索延迟。服务对响应时间要求高时,使用 reranker 可能不合适。
什么是Agent开发
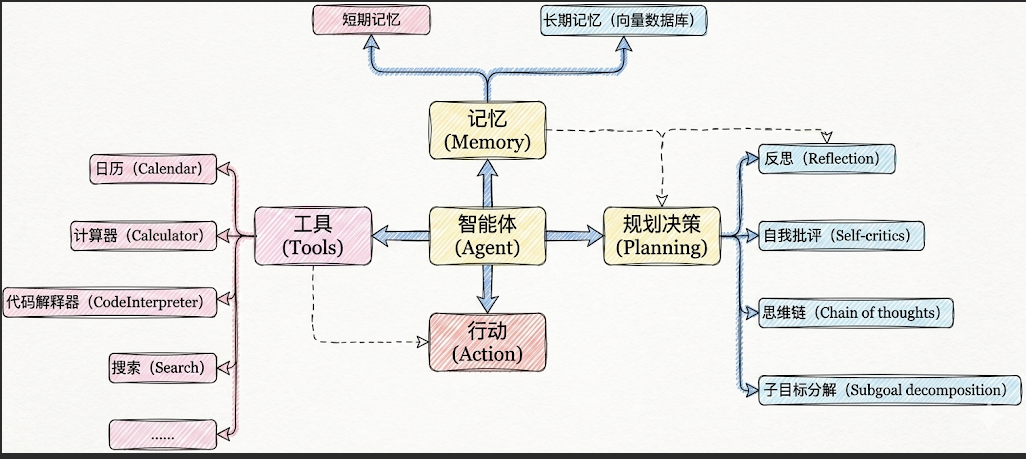
充分利用 LLM 的推理决策能力,通过增加规划、记忆和工具调用的能力,构造一个能够独立思考、逐步完成给定目标的 Agent(智能体)。
大模型应用开发的场景
1.纯prompt场景
Prompt 是操作大模型的唯一接口;
当人看:你说一句,ta 回一句,你再说一句,ta 再回一句......
2.Agent+Function Calling
Agent:AI 主动提要求;
Function Calling:需要对接外部系统时,AI 要求执行某个函数;
当人看:你问 ta"我明天去杭州出差,要带伞吗?",ta 让你先看天气预报,你看了告诉 ta,ta 再告诉你要不要带伞。
3.RAG(Retrieval-Augmented Generation)
RAG:需要补充领域知识时使用。
Embeddings:把文字转换为更易于相似度计算的编码。这种编码叫向量;
向量数据库:把向量存起来,方便查找;
向量搜索:根据输入向量,找到最相似的向量。
4:Fine-tuning(精调/微调)
举例:努力学习考试内容,长期记住,活学活用。
模型创建与调用
| 平台 | 网址 | 备注 |
|---|---|---|
| OpenRouter | https://openrouter.ai/ | 全球主流,含国外模型 |
| CloseAI | https://platform.closeai-asia.com/ | 亚洲最大,含国外模型 |
| 阿里云百炼 | https://bailian.console.aliyun.com/ | 企业端友好 |
| 硅基流动 | https://www.siliconflow.cn/ | 性价比高,适合个人 |
| 百度千帆 | https://console.bce.baidu.com/qianfan/overview | 主打百度生态 |
| 火山引擎 | https://console.volcengine.com/ark/ | 主打字节多模态生态 |
1.调用模型
python
DEEPSEEK_API_KEY=<Your API Key>
DEEPSEEK_BASE_URL=https://api.deepseek.com

from langchain_deepseek import ChatDeepSeek
import os

from dotenv import load_dotenv

# 通过load_dotenv()将.env中的变量加载为环境变量
# override=True表示:无论你当前的操作系统、终端或者虚拟环境中是否已经存在同名的环境变量,
都会强行用 .env 文件里写的值去覆盖它
load_dotenv(override=True)

# 从环境变量读取配置
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")
# 创建DeepSeek LLM
deepseek_llm = ChatDeepSeek(
    api_key=DEEPSEEK_API_KEY,
    api_base=DEEPSEEK_BASE_URL, # 注意:这里是api_base,不是base_url
    model_name="deepseek-v4-flash",
)

print(deepseek_llm.invoke("请介绍一下你自己"))
2.初始化模型
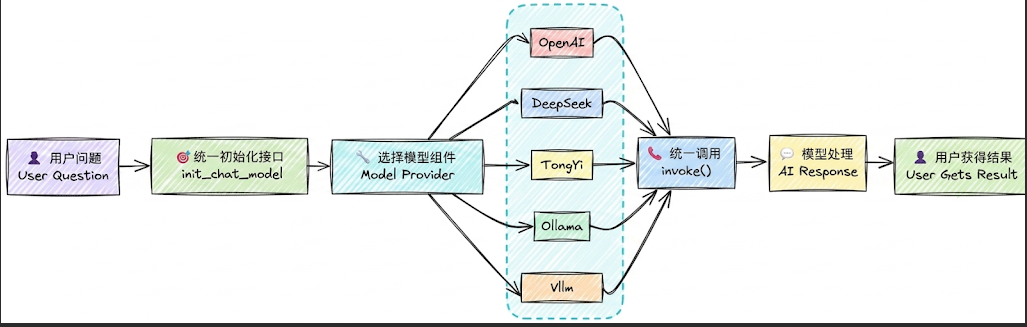
python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    "provider:model_name",  # 提供商:模型名称
    api_key="your-api-key",  # API 密钥(可选,可从环境变量读取)
    temperature=0.7,         # 温度参数(可选)
    max_tokens=1000,         # 最大 token 数(可选)
    **kwargs                 # 其他模型特定参数
)
python
#调用阿里百炼大模型

#环境变量

DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
DASHSCOPE_API_KEY=<YOUR_API_KEY>
#代码:

from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)

DASHSCOPE_API_KEY=os.getenv("DASHSCOPE_API_KEY")
DASHSCOPE_BASE_URL=os.getenv("DASHSCOPE_BASE_URL")

model = init_chat_model(model="qwen-plus",
                        model_provider="openai",
                        api_key=DASHSCOPE_API_KEY,
                        base_url=DASHSCOPE_BASE_URL)

print(model.invoke("你好,用一句话回答"))
model_provider支持哪些provider?
model_provider 表示模型的提供者,支持的providers有:anthropic、anthropic_bedrock,azure_ai、azure_openai、bedrockbedrock_converse、cohere、deepseek、fireworks、google_anthropic_vertex、google_genai、google_vertexaigrog、huggingface、ibm、mistralai、nvidia、ollama、openai、openrouter、perplexity、together、upstage、xai。
- 如果 model_provider="openai",会自动加载langchain-openai
的依赖包,底层调用的是ChatOpenAI 类。 - 如果 model_provider="deepseek",会自动加载langchain-deepseek
的依赖包,底层调用的是ChatDeepSeek 类。
像阿里的dashscope 尚未被LangChain官方纳入模型的统一注册体系,暂时不知道"dashscope"的提供者是谁。此时可以将model_provider设置为openai,底层将会用openai的规范处理请求,这就要求我们调用的模型服务是OpenAI Compatible的。
问题2:如果在model参数中没有指明模型提供者,必须在model_provider中指明?
可以在model参数中通过前缀指定模型供应商,和模型名称之间用冒号分割,等价于通过model_provider参数指定供应商。如果两个位置都没有指明供应商,LangChain底层会按照内置规则自动推断。
3.模型初始化参数
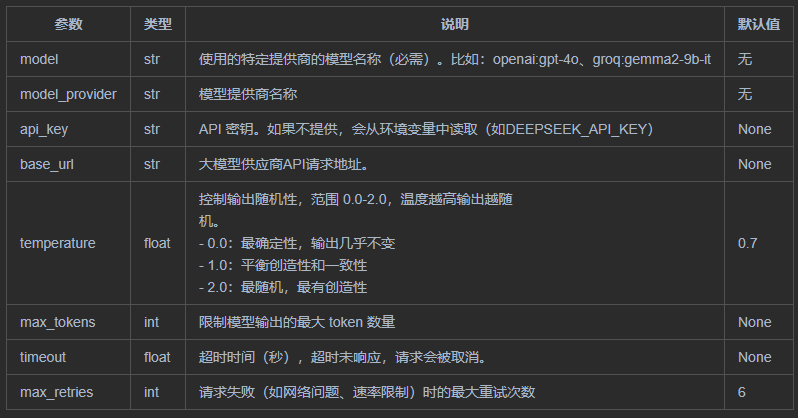
4.模型调用
在 LangChain 中,模型调用(Invocation)是指通过特定方法触发大语言模型生成输出的过程。根据不同的应用场景和需求,LangChain 提供了几种核心的调用方式,主要是 invoke() 、stream() 和batch() 方法,以及它们的异步版本 ainvoke() 、astream() 和abatch(),
- invoke():阻塞式,一次性返回完整结果问答、批处理任务、无需实时反馈的场景。
- ainvoke():非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
- stream():流式输出,实时返回每个token聊天机器人、长文本生成、需要提升用户体验的交互应用。
- asteam():非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
- batch():批量处理多个输入高并发场景,需要同时处理大量请求。
- abatch():非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
invoke()函数输入有这样几种:
1.一次性提问
python
# 向模型发送单条数据
prompt = "翻译成英文:你好世界"
response = model.invoke(prompt)
2.字典列表
python
messages = [
    {"role": "system", "content": "系统提示"},
    {"role": "user", "content": "用户消息"},
    {"role": "assistant", "content": "AI回复"},  # 可选,用于对话历史
    {"role": "user", "content": "继续提问"}
]
response = model.invoke(messages)
3.消息对象列表
使用内置的消息类(如 SystemMessage、HumanMessage、AIMessage),将消息对象列表输入模型。
python
# 使用消息对象格式构建消息
messages = [
    SystemMessage("你是一个专业的数学老师。"),
    HumanMessage("2 + 3 * 2 = ?"),
    AIMessage("8"),
    HumanMessage("我刚才问什么问题了?")
]
response = model.invoke(messages)
4.返回值详解
invoke 返回一个AIMessage对象
python
def invoke(
    self,
    input: LanguageModelInput,
    config: RunnableConfig | None = None,
    *,
    stop: list[str] | None = None,
    **kwargs: Any,
) -> AIMessage:
python
AIMessage(
 content='2 + 3 * 2 = **8**',
 additional_kwargs={'refusal': None},
 response_metadata={
     'token_usage': {
         'completion_tokens': 15,
         'prompt_tokens': 16,
         'total_tokens': 31,
         'completion_tokens_details': {
             'accepted_prediction_tokens': 0,
             'audio_tokens': 0,
             'reasoning_tokens': 0,
             'rejected_prediction_tokens': 0
         },
         'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens':
0},
         'latency_checkpoint': {
             'engine_tbt_ms': 4,
             'engine_ttft_ms': 36,
             'engine_ttlt_ms': 100,
             'pre_inference_ms': 86,
             'service_tbt_ms': 4,
             'service_ttft_ms': 280,
             'service_ttlt_ms': 338,
             'total_duration_ms': 259,
             'user_visible_ttft_ms': 194
         }
     },
     'model_provider': 'openai',
     'model_name': 'gpt-5.4-mini-2026-03-17',
     'system_fingerprint': None,
     'id': 'chatcmpl-DgWobsxhDOqzjqVFwbZYKRnovpEiV',
     'service_tier': 'default',
     'finish_reason': 'stop',
     'logprobs': None
 },
 id='lc_run--019e3659-5ee2-7b62-bc8a-741e27374b43-0',
 tool_calls=[],
 invalid_tool_calls=[],
 usage_metadata={
     'input_tokens': 16,
     'output_tokens': 15,
     'total_tokens': 31,
     'input_token_details': {'audio': 0, 'cache_read': 0},
     'output_token_details': {'audio': 0, 'reasoning': 0}
 }
)
python
AIMessage(
    # --- 核心内容 ---
    content='2 + 3 * 2 = **8**',  # 模型生成的最终文本答案

    additional_kwargs={
        'refusal': None# 模型拒绝回答的情况(如触碰安全策略),None 表示正常回答
    },

    # --- 响应元数据(API 返回的详细原始数据) ---
    response_metadata={
        'token_usage': {
            'completion_tokens': 15,    # 生成回答消耗的 Token 数(输出)
            'prompt_tokens': 16,        # 用户输入消耗的 Token 数(输入)
            'total_tokens': 31,         # 本次交互总共消耗的 Token

            'completion_tokens_details': {
                'accepted_prediction_tokens': 0, # 预测性生成的 Token 数
                'audio_tokens': 0,               # 音频生成消耗(如有)
                'reasoning_tokens': 0,# 推理模型(如 o1)思考过程消耗的 Token
                'rejected_prediction_tokens': 0  # 被拒绝的预测 Token
            },

            'prompt_tokens_details': {
                'audio_tokens': 0,   # 输入中的音频 Token 数
                'cached_tokens': 0   # 命中的缓存 Token 数(能省钱/提速)
            },

            # --- 延迟性能监控(单位:毫秒 ms) ---
            'latency_checkpoint': {
                'engine_tbt_ms': 4,        # 引擎 Token 间平均间隔时间
                'engine_ttft_ms': 36,      # 引擎生成首个 Token 的时间
                'engine_ttlt_ms': 100,     # 引擎生成最后一个 Token 的时间
                'pre_inference_ms': 86, # 推理前的预处理耗时(安全审核、Token 化等
预处理)
                'service_tbt_ms': 4, # 服务端token与token之间生成的间隔时间,决定
了打字机效果是否丝滑。
                'service_ttft_ms': 280,  # 服务端接收到请求到输出首字的总时间
                'service_ttlt_ms': 338,    # 服务端完成全部输出的总时间
                'total_duration_ms': 259,  # 本次请求在系统中记录的总持续时长
                'user_visible_ttft_ms': 194   # 用户看到第一个字跳出来等待的时间
            }
        },
        'model_provider': 'openai',               # 模型供应商
        'model_name': 'gpt-5.4-mini-2026-03-17',  # 使用的具体模型版本
        'system_fingerprint': None,          # 系统指纹,用于追踪模型后端的配置变
更
        'id': 'chatcmpl-DgWobsxhDOqzjqVFwbZYKRnovpEiV', #API层面的响应 ID
        'service_tier': 'default',    # 服务层级(如按量付费或订阅)
        'finish_reason': 'stop',     # 停止原因:stop(自然结束)、length(长度受
限)
        'logprobs': None            # 对数概率(通常用于分析词汇选择的可能性)
    },

    # --- LangChain 内部标识 ---
    id='lc_run--019e3659-5ee2-7b62-bc8a-741e27374b43-0',
    # LangChain 追踪此条运行的唯一 ID

    # --- 工具调用信息 ---
    tool_calls=[],             # 正常触发的外部工具调用列表
    invalid_tool_calls=[],     # 触发失败或格式错误的工具调用
     # --- 统一消耗元数据(LangChain 标准化后的消耗格式) ---
    usage_metadata={
        'input_tokens': 16,    # 输入 Token 数
        'output_tokens': 15,   # 输出 Token 数
        'total_tokens': 31,    # 总 Token 数
        'input_token_details': {
            'audio': 0,
            'cache_read': 0    # 从缓存中读取的输入数量
        },
        'output_token_details': {
            'audio': 0,
            'reasoning': 0     # 包含在输出中的推理 Token
        }
    }
)- 核心内容与基本信息
content : 模型生成的文本回答。这是你最关心的核心输出。
id : 本次运行在 LangChain 内部生成的唯一标识符(Run ID)。
additional_kwargs : 包含特定供应商的额外参数。
refusal : 如果模型拒绝回答(涉及敏感政策),此处会显示拒绝原因。
- 消耗统计 (Token Usage)
这部分决定了你这一行输入操作花了多少钱:
prompt_tokens / input_tokens : 输入 Token 数。你发送给模型的问题长度。
completion_tokens / output_tokens : 输出 Token 数。模型回答生成的长度。
total_tokens : 总消耗。 两者之和。
reasoning_tokens : 推理 Token 数。 如果是 O1/O3 等推理模型,这里会显示它在"思考"时消耗的 Token。
cached_tokens : 缓存命中的 Token 数。重复提问时,如果命中了模型商的缓存,这部分费用通常更低。
- 响应元数据 (Response Metadata)
这部分是 API 返回的原始详细信息:
model_name : 实际调用的模型具体版本(如 gpt-5.4-mini)。
model_provider : 模型供应商(如 openai)。
finish_reason : 生成停止的原因。
stop : 正常回答结束。
length : 达到最大 Token 限制被截断。
system_fingerprint : 系统指纹,用于追踪模型后端的配置变更。
- 性能与延迟 (Latency Checkpoint)
这是针对 API 响应速度的深度拆解(单位通常为毫秒 ms):
total_duration_ms : 总耗时。从请求发出到完全收到的总时间(259ms)。
user_visible_ttft_ms : 首字到达时间。用户看到第一个字跳出来等待的时间(194ms),这是体感快慢的关键。
engine_ttft_ms : 引擎层面的首字到达时间(36ms)。
engine_ttlt_ms : 引擎生成最后一个字的时间(100ms)。
pre_inference_ms : 推理前处理耗时。包括安全审核、Token 化等预处理(86ms)。
service_tbt_ms : Time Between Tokens。字与字之间生成的间隔时间,决定了打字机效果是否丝滑。
- 工具调用信息
tool_calls : 结构化工具调用列表。如果模型决定调用某个 Python 函数或搜索工具,参数会在这里。
invalid_tool_calls : 格式错误的工具调用尝试。
举例:访问所有信息
response = model.invoke("用一句话解释什么是 AI")
-
获取回复内容
print("AI 回复:", response.content)
-
获取响应元数据
metadata = response.response_metadata
print(f"使用的模型: {metadata'model_name'}")
print(f"结束原因: {metadata'finish_reason'}")
print(f"模型提供商:{metadata'model_provider'}\n")
-
获取 Token 使用情况
usage = metadata.get('token_usage', {})
print(f"输入 tokens: {usage.get('prompt_tokens')}")
print(f"输出 tokens: {usage.get('completion_tokens')}")
print(f"总计 tokens: {usage.get('total_tokens')}")
-
获取消息 ID
print(f"消息 ID: {response.id}")
AI 回复: AI(人工智能)就是让机器模拟人类的学习、推理、识别和决策能力。
使用的模型: gpt-5.4-mini-2026-03-17
结束原因: stop
模型提供商:openai
输入 tokens: 13
输出 tokens: 28
总计 tokens: 41
消息 ID: lc_run--019e3665-8dfa-7c53-a9a5-4995348a0258-0
5.美化响应输出
1.使用pretty_print()
2.使用 rich 库
3.模型配置信息profile
这是LangChain针对模型的能力画像,但是否存在,取决于LangChain在集成模型厂商的服务时是否声明了能力画像。
6.模型初始化参数
查看所有初始化参数
python
查看ChatDeepSeek支持的完整参数列表

from langchain_deepseek import ChatDeepSeek

print(ChatDeepSeek.model_fields.keys())
查看init_chat_model的某model_provider支持的完整参数列表
python
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(override=True)

# 1. 实例化一个你感兴趣的模型对象
# 即使不传入具体 key,通常也能初始化成功
temp_model = init_chat_model(
    model="deepseek-v4-flash",
    model_provider="deepseek",
)

# 2. 现在它已经是一个具体的 ChatDeepSeek 对象了
# 你可以使用你熟悉的 .model_fields.keys()
print(temp_model.model_fields.keys())
模型类的参数构成
以ChatDeepSeek为例,完整参数列表由如下几部分构成:
1、客户端与连接参数 (Networking)
这类参数决定了代码"怎么连到服务端",而不是"让模型怎么生成"。
参数名 说明
api_key / openai_api_key 鉴权密钥。DeepSeek 通常兼容 OpenAI 接口格式。
api_base / openai_api_base 接口地址(如 https://api.deepseek.com)。
request_timeout 网络请求超时时间。
max_retries 请求失败时的重试次数。
http_client / http_async_client 手动传入 httpx.Client 实例(用于更复杂的网络配置)。
openai_proxy 代理服务器配置。
default_headers / default_query 每次请求时默认携带的 HTTP Header 或 Query 参数。
2、模型推理参数 (Model Inference)
这些是直接传递给 DeepSeek 模型 API 的参数,决定了生成内容的质量和风格。
参数名 说明
model_name 指定具体的模型(如 deepseek-chat 或 deepseek-reasoning)。
temperature 采样温度,越高越随机。
top_p 核采样参数。
max_tokens 最大输出 token 数。
stop 停止符列表。
streaming 是否开启流式传输。
n 生成几个候选回复。
reasoning 是否启用推理模式
reasoning_effort (DeepSeek R1 特色) 控制思考链(COT)的深度。
presence_penalty / frequency_penalty 惩罚项(存在惩罚、频率惩罚),用于减少内容重复。
store 是否存储对话。
logit_bias 调整特定词汇出现的概率。
3、LangChain 框架通用参数
由 LangChain 的BaseChatModel 定义,所有其子类ChatXxx 都具备的,用于管理 LangChain 内部的逻辑(如日志、回调、元数据),仅在内部生效。
参数名 说明
name 给模型实例起个名字,用于在 Trace(如 LangSmith)中区分。
verbose 是否打印详细日志。
callbacks 回调处理器,用于集成 LangSmith 或自定义监控。
tags / metadata 用于标记该实例的标签和元数据。
cache 是否缓存该模型的请求结果。
rate_limiter LangChain 内部的频率限制器。
模型调用中config参数
在调用模型时(如使用 invoke()、ainvoke()、stream()、batch()等方法时),我们可以传入config参数。
python
def invoke(
    self,
    input: LanguageModelInput,
    config: RunnableConfig | None = None,
    *,
    stop: list[str] | None = None,
    **kwargs: Any,
) -> AIMessage
config参数:允许在调用模型时,动态地配置和控制模型的行为,而无需在初始化时就固定所有参数,这为应用带来了极大的灵活性和可维护性。
config中支持配置的参数如下:
配置项 类型 描述
run_name str 为当前运行设置一个可读的名称。如在LangSmith追踪系统中快速定位和识别不同的运行任务。
tags Liststr 为运行设置标签,用于分类和过滤。如在LangSmith追踪系统中快速定位和识别不同的运行任务。
callbacks ListBaseCallbackHandler 设置回调处理器,在运行的不同阶段(开始、流输出、结束等)触发。与一些监控平台(如LangSmith)集成进行深度追踪和调试。
metadata Dictstr,Any 附加任意的键值对元数据。记录本次调用的业务上下文,如{"user_id": "123", "session_id": "abc"}
max_concurrency int 限制当前可运行对象的最大并发运行数。防止对API接口或本地资源造成过大压力,实现简单的速率限制。
recursion_limit int 限制运行时递归调用的最大深度。主要在复杂的工作流(如Agent执行多步工具调用)中,防止出现无限递归循环。
configurable DictStr,Any 一个万能字典,用于传递其他可配置参数。实现更高级的动态行为,如配置可替代的模型或组件。
langSmith监控管理平台的使用
LangSmith 是 LangChain 生态系统中专门用于 LLM(大语言模型)应用调试、监控、评估和管理的平台。
🔍 追踪(tracing):记录每次 LLM 调用的详细信息
📊 监控(monitoring):实时查看应用性能
🐛 调试(debug):排查问题和优化性能
📈 评估(evaluate):系统化测试 LLM 应用
具体功能
功能1:核心应用与开发
1、Tracing(追踪)
功能:这是 LangSmith 最核心的功能。它会完整记录你大模型应用的每一次调用链路(Trace)。
作用:当你的 Agent(智能体)或 RAG 系统运行变慢或报错时,点击进入对应的项目(如上图中的 langchain1.2_smith),你可以看到每一步具体的 Prompt 是什么、模型返回了什么、消耗了多少 Token,以及每一个链条节点的耗时,非常方便排查 Bug 和优化性能。
2、Monitoring(监控)
功能:提供生产环境的高级数据可视化看板。
作用:帮你从宏观角度监控应用在一段时间内的运行状况。你可以看到 Token 消耗趋势、QPS(每秒请求数)、错误率、平均延迟(Latency)以及成本预估。适合应用上线后观察系统的稳定性和开销。
3、Datasets & Experiments(数据集与实验)
功能:用于管理测试数据集并运行对比实验。
作用:你可以把用户的真实输入、特定的边界情况(Edge Cases)存为数据集。当你修改了 Prompt 或更换了底层大模型时,可以在这里运行自动化对比测试,直观看到新旧版本在同一批测试集上的表现差异。
4、Evaluators(评估器)
功能:配置和自动化评估任务。
作用:大模型的输出往往难以用传统的断言(Assert)来测试。这里允许你配置基于规则(如关键词匹配)或基于模型(LLM-as-a-judge)的评估指标(如:答案相关性、是否包含幻觉等),对追踪到的数据或实验结果进行自动打分。
5、Annotation Queues(标注队列)
功能:人工反馈与数据清洗工具。
作用:在应用开发或初上线阶段,你可以把一部分痕迹(Traces)发送到标注队列中,让团队中的核心成员、业务专家或人工客服进行手动打分、纠正回答或贴标签,这些高质量的人工标注数据后续可直接用于微调模型或充当测试集。
功能2:提示词与调试工具
1、Prompts(提示词管理)
功能:类似"提示词版的 GitHub"。
作用:把 Prompt 从代码中解耦出来,统一在云端管理。你可以在这里对 Prompt 进行版本控制(如 v1、v2),直接在代码中通过 API 动态拉取最新的提示词。它还支持团队协作和 Prompt 的分享。
2、Playground(演练场)
功能:一个网页端的模型交互界面。
作用:无需写任何代码,直接在这里选择不同的模型(如 OpenAI、Anthropic 或是本地模型),快速微调并测试你的 Prompt 效果,还可以一键将调整好的 Prompt 保存到上方的 Prompts 仓库中。
3、Studio(工作室)
功能:通常与 LangGraph 深度集成,提供可视化的图形交互界面。
作用:如果你的应用是基于图结构(Graph-based)的复杂复杂 Agent 架构,Studio 可以让你可视化地看到状态机(State)在各个节点之间的流转,甚至支持在某个节点"暂停",手动修改数据后再继续向下执行,是调试复杂智能体交互的利器。
4、Context Hub(上下文中心)
功能:管理全局上下文或通用组件配置。
作用:用于存放可在多个项目或 Prompt 中复用的公共上下文模板、全局变量或系统预设提示。
功能3:部署与沙盒
1、Deployments(部署)
功能:一键将你的 LangChain 应用或 LangGraph Agent 部署为线上可用的 API 服务(通常依托于 LangGraph Cloud)。
作用:提供开箱即用的生产端点,帮你处理高并发、队列管理和状态持久化,让你专注于编写业务逻辑。
2、Sandboxes(沙盒)
功能:提供轻量级的在线运行和测试环境。
作用:在不污染生产环境的前提下,供开发人员安全地试运行、测试新部署的 Agent 或执行自动化脚本。
如何接入,登录langsmith官网注册登录,设置apikey,放到项目密钥文件中
在 .env 配置文件中,添加四个环境变量:
python
# 是否启用Langsmith监控功能
LANGSMITH_TRACING=true

# Langsmith监控WebUI地址
LANGSMITH_ENDPOINT=https://api.smith.LangChain.com

# 创建的API_KEY
LANGSMITH_API_KEY=<YOUR_API_KEY>

# 自定义项目名称,可以在Langsmith WebUI监控页面根据名称查看对应的运行记录
LANGSMITH_PROJECT="pr-clear-harmony-32"
添加上述环境变量后,在程序中通过 load_dotenv() 加载,而后运行 LangChain 代码,LangSmith 会自动记录运行指标,并同步至后台服务,我们可以在 LangSmith 官网查看运行记录
在 LangSmith 官方 WebUI 的 Tracing 界面下,可以看到按照 LANGSMITH_PROJECT 命名的项目。
消息与提示词模板
1.LangChain的消息(Message)对象包含三种字段
Role:消息所属的角色或类型,如system 、user 、assistant 。
Content:消息内容
Metadata:(可选)元数据,存储额外信息。如:消息ID、响应时间、token消耗量、消息标签等
LangChain定义了很多消息类型,通过role 区分。常用的有四种。
1、系统消息
也称为系统提示词,用于在对话开始时为模型设定角色、行为准则和上下文背景。它像是给AI助手的一份工作说明书,决定了其回答问题的风格、领域和专业范围。
python
{"role": "system", "content": "你是个精通编程的软件架构师"}2、用户消息
也称为用户提示词,在多轮对话中,它表示用户的一次输入。可以包含简单的文本问题,也可以是复杂的多模态内容(如图片、音频、文档等)。
python
{"role": "user", "content": "你好啊~"}3、助手(AI)消息
代表模型的回复,包括生成的文本、工具调用、元数据等。
python
{"role": "assistant", "content": "我也很高兴认识你"}
{
    "role": "assistant",
    "content": "",
    "tool_calls": [{
        "name": "get_weather",
        "args": {"location": "北京"},
        "id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"
    }]
}
4、工具调用消息
工具调用结果匹配的消息类型。将此消息返回给模型,让模型基于这个结果继续生成回复。在Tools一节详细介绍。
{"role": "tool", "content": "今天天气很好", "tool_call_id":"call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"}
问题:为什么使用不同的消息类型?
明确角色:清晰区分系统提示、用户输入和 AI 回复
控制行为:通过 SystemMessage 精确控制 AI 的行为
对话历史:构建完整的多轮对话上下文
调试友好:更容易追踪和调试对话流程
3.LangChain支持两种消息格式。
1.JSON格式,2.对象格式
提示词模板
在LangChain 1.0中,ChatPromptTemplate 是用于生成消息列表的核心组件。
ChatPromptTemplate是创建聊天消息列表的提示模板。它比普通 PromptTemplate 更适合处理多角色、多轮次的对话场景。支持 System /Human /AI 等不同角色的消息模板。
python
from dotenv import load_dotenv
from langchain_core.prompts import ChatPromptTemplate
import os
from langchain.chat_models import init_chat_model

######1、提供大模型#########
load_dotenv(override=True)

CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")

model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=CLOSEAI_API_KEY,
    base_url=CLOSEAI_BASE_URL
)

######2、提供提示词#########
chat_prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个数学家,你可以计算任何算式"),
    ("human", "{text}"),
])

# 输入提示
prompt_value = chat_prompt.invoke({
    "text":"我今年18岁,我的舅舅今年38岁,我的爷爷今年72岁,我和舅舅一共多少岁了?"
})

######3、结合提示词,调用大模型#########
# 得到模型的输出
output = model.invoke(prompt_value)
# 打印输出内容
print(output.content)
搭建可复用模板库:
python
# templates.py文件声明如下

from langchain_core.prompts import ChatPromptTemplate

class PromptLibrary:
    """可复用的提示词模板库"""

    TRANSLATOR = ChatPromptTemplate.from_messages([
        ("system", "你是专业翻译,精通{source_lang}和{target_lang}"),
        ("user", "翻译以下文本:\n{text}")
    ])

    CODE_REVIEWER = ChatPromptTemplate.from_messages([
        ("system", "你是{language}代码审查专家,重点关注{focus}"),
        ("user", "审查代码:\n```{language}\n{code}\n```")
    ])

    SUMMARIZER = ChatPromptTemplate.from_messages([
        ("system", "你是内容摘要专家"),
        ("user", "将以下内容总结为{num}个要点:\n{content}")
    ])

    TUTOR = ChatPromptTemplate.from_messages([
        ("system", "你是{subject}导师,学生水平:{level}"),
        ("user", "{question}")
    ])
python
# 其它文件中使用:

from templates import PromptLibrary

messages = PromptLibrary.TRANSLATOR.format_messages(
    source_lang="英语",
    target_lang="中文",
    text="Hello World"
)
tools工具调用
工具是构建智能体的核心要素之一!智能体的手臂
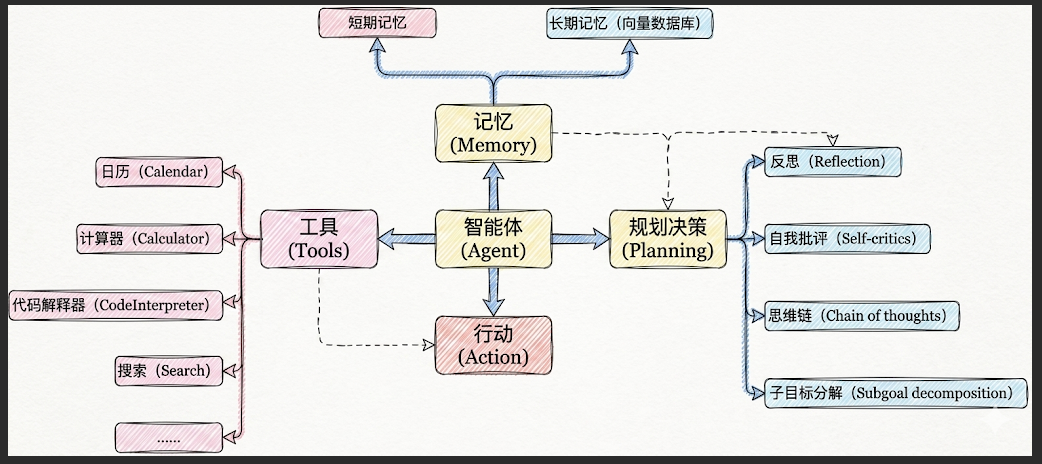
经典调用流程:
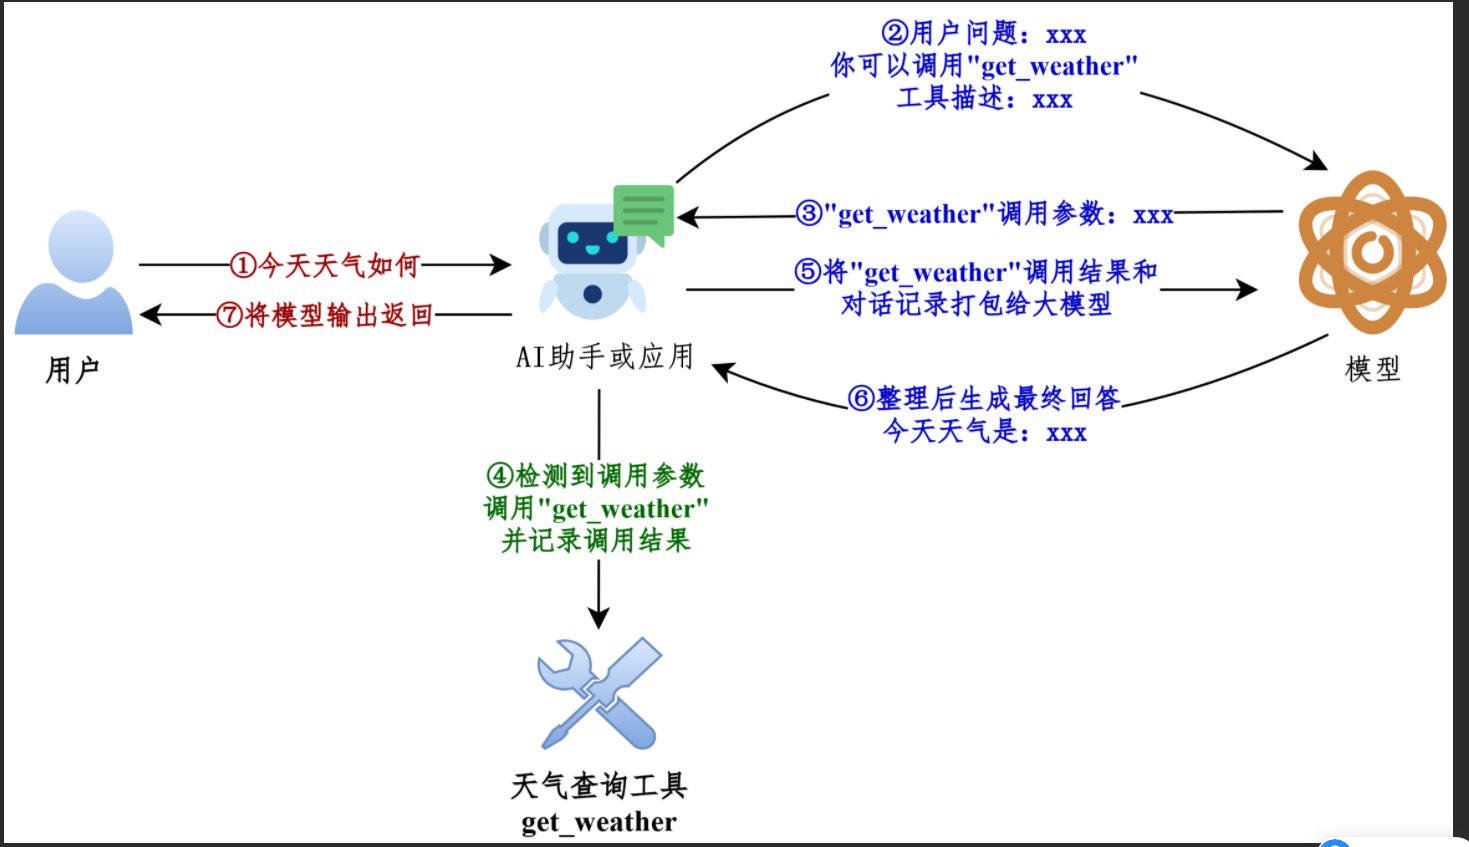
工具调用流程总结:
所以如果真正要大模型根据工具调用结果进行回复,完整的调用流程包括如下四个步骤:
步骤1:模型绑定工具:通过model.bind_tools(...)绑定一个或者多个工具。
步骤2:模型生成工具调用请求:用户输入问题,调用模型(比如invoke())。如果需要调用工具,模型返回包含工具调用信息(如工具名称和参数)的AIMessage。
步骤3:开发者手动执行工具:用户从响应中提取工具调用信息并手动调用对应的工具(比如工具.invoke())。
步骤4:将工具执行结果ToolMessage传递给模型生成最终结果:将之前用户提问内容和手动执行工具结果ToolMessage返回模型,模型最终生成回复。
特别注意:大模型调用工具是单次推理,直接响应,需要开发者手动执行工具并管理循环,适合简单、确定的任务。
使用@tool装饰器(推荐)
使用 @tool 装饰器修饰,可以自动将普通 Python 函数转化为智能体可调用的工具。
工具声明
1.使用 docstring
python
from langchain_core.utils.function_calling import convert_to_openai_tool
from langchain.tools import tool

@tool
def get_weather(city: str):
    """
    天气查询工具
    """
    return f"{city}天气晴朗"

print(convert_to_openai_tool(get_weather))
2.@tool 的参数 description 可以更改工具描述,优先级高于 docstring 的函数说明
python
from langchain_core.utils.function_calling import convert_to_openai_tool
from langchain.tools import tool
from rich import print as rprint

@tool(description="根据城市名称查询当日天气的工具")
def get_weather(city: str):
    """
    天气查询工具
    """
    return f"{city}天气晴朗"

rprint(convert_to_openai_tool(get_weather))
解析docstring:parse_docstring
当我们没有向 @tool 传递 description 参数时,默认情况下, tool 会将 docstring 整体视为description,
python
from langchain_core.utils.function_calling import convert_to_openai_tool
from rich import print as rprint

@tool
def get_weather(city: str, units: str = "celsius", include_forecast: bool =
False) -> str:
    """
    获取当日天气,可选择是否同时查询未来五日天气预报

    Args:
        city: 城市
        units: 气温单位,可选:celsius-摄氏度,fahrenheit-华氏度
        include_forecast: 是否包含未来五日的天气预报
    """
    temp = 22 if units == "celsius" else 72
    result = f'{city}当天气温: {temp} {"摄氏度" if units == "celsius" else "华
氏度"}'
    if include_forecast:
        result += "\n未来五天都是晴天"
    return result

rprint(convert_to_openai_tool(get_weather))
自定义args_schema
使用Pydantic模型定义
当工具的参数变得复杂,需要 枚举值、 范围限制 或 更复杂的业务逻辑验证 时,Pydantic 模型是理想的选择,提供强大的类型检查和数据验证。
使用Pydantic 的主要优势在于能够精确控制工具参数的格式和验证规则,让大模型更准确地理解如何调用工具。
通过继承核心基类 BaseModel 定义数据模型,从而声明字段结构、类型约束、默认值以0及校验规则。
python
#基础类型
from pydantic import BaseModel

class WeatherInput(BaseModel):
    city: str

print(WeatherInput(city="北京"))

#进阶
from pydantic import BaseModel, Field

class WeatherInput(BaseModel):
    city: str = Field(
        default= "北京",
        description="城市"
    )
    unit: Literal["celsius", "fahrenheit"] = Field(
        default="celsius",
        description="气温单位"
    )
    include_forecast: bool = Field(
        default=False,
        description="是否包含未来五日天气预报"
    )

print(WeatherInput())
python
from pydantic import BaseModel, Field
from langchain.tools import tool
from langchain_core.utils.function_calling import convert_to_openai_tool

class WeatherInput(BaseModel):
    city: str = Field(
        default= "北京",
        description="城市"
    )
    unit: Literal["celsius", "fahrenheit"] = Field(
        default="celsius",
        description="气温单位"
    )
    include_forecast: bool = Field(
        default=False,
        description="是否包含未来五日天气预报"
    )

@tool(args_schema=WeatherInput)
def get_weather(city: str, unit: str = "celsius", include_forecast: bool =
False) -> str:
    """获取当日天气,可选未来五日天气预报"""
    temp = 22 if unit == "celsius" else 72
    result = f'{city}当天气温: {temp} {"摄氏度" if unit == "celsius" else "华氏
度"}'
    if include_forecast:
        result += "\n未来五天都是晴天"
    return result

convert_to_openai_tool(get_weather)
使用Json Schema定义
在 LangChain 中,还可以直接使用 JSON Schema 字典 来定义工具的参数模式。这种方式提供了极大的灵活性。
因为工具参数模式可以基于数据库配置或用户输入在 运行时动态生成,所以这种方式特别适合参数结构需要动态生成的场景。
通过 @tool(args_schema=json_schema_dict) 将一个符合 JSON Schema 标准的字典与工具函数关联。
python
from langchain.tools import tool
from langchain_core.utils.function_calling import convert_to_openai_tool

weather_schema = {
    "type": "object",
    "properties": {
        "location": {"type": "string"},
        "units": {"type": "string"},
        "include_forecast": {"type": "boolean"}
    },
    "required": ["location", "units", "include_forecast"]
}

@tool(args_schema=weather_schema)
def get_weather(city: str, unit: str = "celsius", include_forecast: bool =
False) -> str:
    """获取当日天气,可选未来五日天气预报"""
    temp = 22 if unit == "celsius" else 72
    result = f'{city}当天气温: {temp} {"摄氏度" if unit == "celsius" else "华氏
度"}'
    if include_forecast:
        result += "\n未来五天都是晴天"
    return result

print(convert_to_openai_tool(get_weather))
funcation call总结:
1.工具声明要有清晰的描述
2.工具功能也要单一,符合设计原则
3.工具调用失败要有三层防护,1.工具内部要进行处理,2.agent要重试(prompt)3.调用方要重试
python
工作流程:
① 你调用 call_agent("你好")。
② 程序进入函数,执行 agent.invoke(...)。
③ 如果执行成功:正常返回结果, @retry 什么都不做。
④ 如果执行失败(报错): @retry 会拦截这个错误,不让程序直接崩溃。它会默默地帮你再次触发agent.invoke(...)。
⑤ 如果连续 3 次都报错:它终于放弃了,把第 3 次的报错真正抛出来,程序此时才会报错中止。
4.要返回字符串
在编写传统的 Python 代码时,返回字典(dict)显然更方便后续代码处理。但在 LangChain 的工具(Tools)生态中,强烈建议工具返回字符串(str)。因为:
1)大模型(LLM)的本质只吃"文本"
2)避免大模型"胡思乱想"(乱码与格式问题)
如果你返回一个包含中文的字典 {"name": "张三"},LangChain 在强制将其转换为字符串时,默认可能会采用 Unicode 编码,变成 {"name": "\u5f20\u4e09"}。
大模型虽然能理解 Unicode,但极易受到干扰。直接看到中文 张三 的大模型,和看到\u5f20\u4e09 的大模型,其输出的稳定性和准确率是有差距的。通过手动 json.dumps(...,ensure_ascii=False),你确保了喂给大模型的是最干净、最直观的纯文本。
json.dumps()是 Python 标准库 json模块中的函数,用于将 Python 对象(如字典、列表)序列化成一个 JSON 格式的字符串。
ensure_ascii=False : 这个参数默认值为 True,表示所有非 ASCII 字符(如中文)会被转换成\uXXXX形式的转义序列。设置为 False后,中文、表情符号等字符就能在 JSON 字符串中正常显示,而不是一堆乱码。
- 选择同步 vs 异步
同步工具:简单场景,CPU 密集型任务
异步工具:IO 密集型(API 调用、数据库、文件操作)