最近在 Agent 和模型应用圈里,开始有人讨论一个叫 Jev 的模型。它有时也会被写成 "JEV",但 TypeSafe AI 官方使用的名称是 Jev。
第一次看到它,很容易产生几个疑问:
- 这是不是又一个大语言模型?
- 它是不是一个新的 Agent?
- 它和本地 Harness、Skill、OpenAI Agent 分别是什么关系?
- 那些可供选择的选项,到底是谁提供的?
- 如果已经在使用 OpenAI,还有没有必要接入它?
先给出结论:
Jev 不是聊天模型,也不是 Agent Runtime。它是 TypeSafe AI 提供的一种 System One 决策模型:业务代码提交状态和一组类型化问题,它返回可以直接被程序消费的选择、分数、概率分布和置信度。
它最适合放在 Agent Harness 与外部工具之间的决策位置。Agent 仍然负责理解任务和规划,Harness 仍然负责权限、状态、工具执行与重试,Jev 只处理那些候选范围已经确定、但仍需要模型判断的问题。
本文基于 2026 年 9 月 20 日可见的 TypeSafe AI 与 OpenAI 官方公开资料整理。
一、为什么普通 LLM 不总适合做程序决策
大语言模型的原生目标是生成文本。
用户提出问题后,模型可以返回解释、代码、计划或者自然语言答案。这对人与模型交流非常合适,但程序真正想要的经常不是一段话,而是一个稳定的分支条件:
text
应该交给 billing 还是 technical?
可以自动执行还是必须人工确认?
风险属于 low、medium 还是 high?
这个结果是否应该被接受?
传统做法通常是要求 LLM 输出 JSON:
json
{
  "department": "billing",
  "confidence": 0.91,
  "reason": "用户反馈重复扣款"
}
这种方式已经比自由文本稳定,但仍然有三个问题。
第一,JSON 格式正确,不代表判断正确。
第二,模型自己生成的 confidence: 0.91 往往只是一个文本字段,不能自动视为经过校准的正确率。
第三,程序最终只需要一个分支,但大模型仍然走了一遍完整的文本生成过程。
TypeSafe 对 Jev 的定位,就是把"给人看的文本生成"与"给代码用的判断"拆开。
二、Jev 到底是什么
TypeSafe 官方把 Jev 称为其旗舰模型,也是第一个 System One model。
调用方提交两部分内容:
state:需要判断的当前状态,可以是字符串、对象或数组;questions:针对状态提出的类型化问题。
Jev 当前公开的核心问题类型有三种:
| 类型 | 用途 | 主要返回值 |
|---|---|---|
Choice |
从调用方给出的候选项中选择一个 | choice、probabilities、confidence |
Score |
根据调用方给出的等级标准评分 | score、probabilities、confidence |
Noul |
判断一个命题为真的程度 | 0 到 1 的 noul |
例如,业务系统可以同时询问:
- 这是不是支付问题;
- 用户语气是否愤怒;
- 工单紧急程度是多少;
- 下一步应该退款、追问信息还是转人工。
这些问题可以在一次请求中提交。官方文档说明,每个问题会针对同一份 state 独立评估。
这里最重要的设计思想是:
模型提供判断,代码拥有工作流。
Jev 不负责决定接下来再调用哪个模型,也不负责循环、读文件、发消息或执行退款。它只返回结构化判断,真正的动作仍然由代码决定。
三、它处于 Agent 架构的哪一层
把 Agent 系统拆开后,大致可以看到四层:
text
用户与业务系统
      ↓
Agent / LLM
      ↓
Harness / Runtime
      ↓
工具、数据库和外部服务
Jev 不嵌在大语言模型权重里,也不替代 Harness。更准确地说,它是 Harness 可以调用的一个专用决策服务,与通用 LLM 相邻。
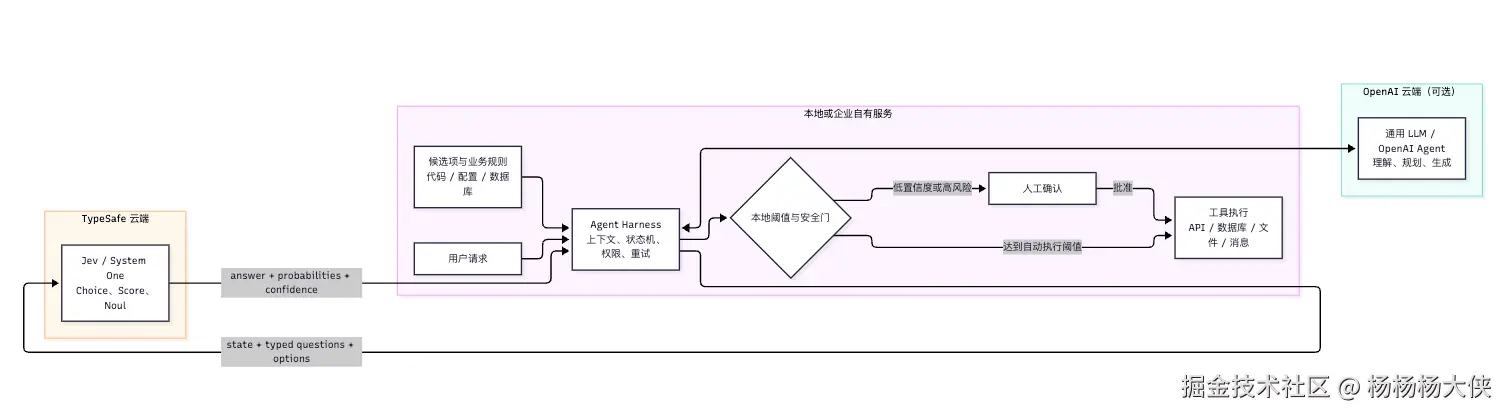
这张图也解释了"它离 LLM 很近"是什么意思:
- 在逻辑上,它与 LLM 都是 Harness 的模型能力;
- 在部署上,Harness 可以在本地或企业服务端,Jev 默认通过 TypeSafe 云端 API 调用;
- 在控制权上,权限、阈值、审批和真实执行仍留在本地 Harness。
因此它和现有 LLM 并不冲突。一个 Agent 可以让通用 LLM 负责开放式规划,再让 Jev 负责某个封闭决策。
四、候选项是谁给的
候选项不是 Jev 在云端临时创造的,而是调用方提供的。
这些候选项通常来自四个地方:
- 业务代码中的固定枚举;
- 配置中心中的动态规则;
- 当前用户拥有权限的工具集合;
- 上一步检索或业务查询得到的有效候选记录。
例如退款场景中,Harness 可能只允许三个选项:
text
refund       证据充分,允许自动退款
ask_user     缺少必要信息,继续询问
human_review 高风险或结论不明确,转人工
Jev 的任务不是发明第四个动作,而是在这三个动作之间判断。
一个完整流程可以写成:
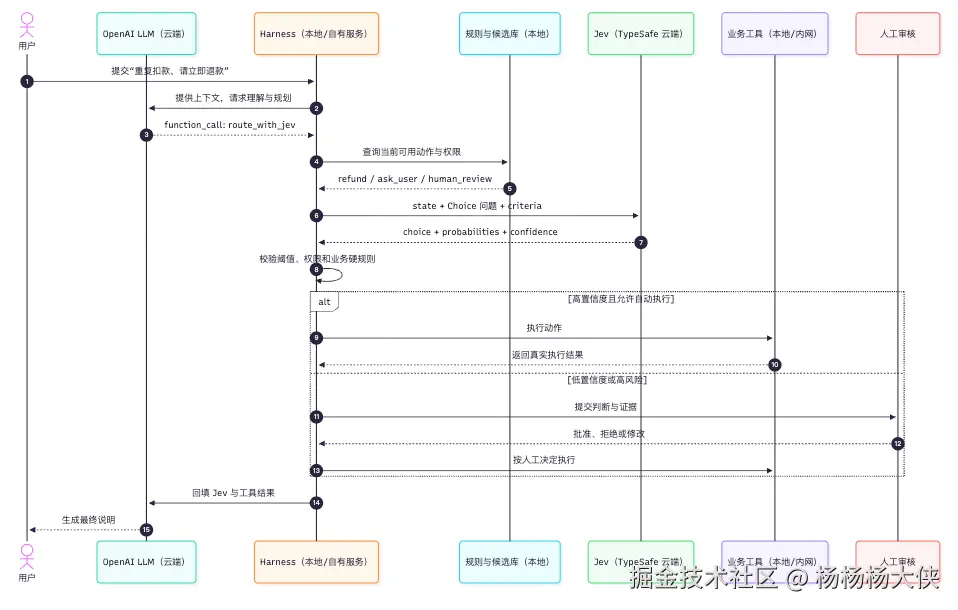
这里有一个很容易混淆的点:LLM 可以建议"应该调用路由工具",但候选项和最终执行权限不应该完全交给 LLM 自由生成。
一个更稳妥的系统会把候选项约束在代码里,并在 Jev 返回之后再次执行本地校验。
五、直接调用 Jev API
Jev 当前公开的 HTTP 入口是:
以下代码仅用于说明集成边界,本文未实际调用任何 API。模型名称、SDK 方法、账号权限和接口细节请以运行时所使用版本的官方文档为准。
text
POST https://api.typesafe.ai/v1/systemone下面是一个最小请求:
bash
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": {
      "ticket": "用户反馈被重复扣款,并要求立即退款"
    },
    "model": "jev-latest",
    "questions": {
      "next_action": {
        "type": "choice",
        "instructions": "下一步应该如何处理?",
        "criteria": {
          "refund": "重复扣款证据充分,允许自动退款",
          "ask_user": "缺少订单号、支付记录等必要信息",
          "human_review": "高风险、证据冲突或需要人工授权"
        }
      }
    }
  }'
返回结构类似下面这样,数值仅用于展示字段含义:
json
{
  "model": "jev-1.x.x",
  "answers": {
    "next_action": {
      "type": "choice",
      "choice": "human_review",
      "probabilities": {
        "refund": 0.21,
        "ask_user": 0.14,
        "human_review": 0.65
      },
      "confidence": 0.52
    }
  },
  "usage": {
    "input_tokens": 0,
    "output_tokens": 0
  }
}
程序不应该看到 choice 后就直接执行。更合理的做法是同时检查:
python
if answer.choice == "refund" and answer.confidence >= 0.85:
    execute_refund()
else:
    request_human_review()
阈值只是业务策略示例,不是 TypeSafe 为所有场景规定的通用值。真实阈值需要用自己的数据集评估。
六、使用 TypeSafe Python SDK
安装 SDK:
bash
pip install typesafe-sdk
export TYPESAFE_API_KEY="your-key"
同步调用示例:
python
from typesafe_sdk import Choice, TypeSafeClient


with TypeSafeClient() as client:
    result = client.system_one(
        state={
            "ticket": "用户反馈被重复扣款,并要求立即退款",
        },
        questions={
            "next_action": Choice(
                instructions="下一步应该如何处理?",
                criteria={
                    "refund": "证据充分,可以自动退款",
                    "ask_user": "缺少必要信息,需要继续询问",
                    "human_review": "存在风险,需要人工审核",
                },
            )
        },
    )

answer = result.choices["next_action"]

print(answer.choice)
print(answer.probabilities)
print(answer.confidence)
SDK 代码运行在本地 Harness 或自己的应用服务中,但 system_one 会请求 TypeSafe 云端。API Key 应保存在应用服务的秘密管理系统中,不应写入 Prompt、仓库或交给前端。
七、OpenAI Agent 如何调用 Jev
OpenAI 并没有公开的"内置 Jev 工具"。如果要组合两者,最直接的方式是把 Jev 封装成一个 Function Tool。
OpenAI 模型只产生 function_call,真正的 TypeSafe 请求仍由本地 Harness 或应用服务器发起。
下面是一个使用 Responses API 的完整最小骨架:
python
import json
import os

from openai import OpenAI
from typesafe_sdk import Choice, TypeSafeClient


openai = OpenAI()
jev = TypeSafeClient()
OPENAI_MODEL = os.environ["OPENAI_MODEL"]


def route_with_jev(ticket: str) -> dict:
    result = jev.system_one(
        state={"ticket": ticket},
        questions={
            "route": Choice(
                instructions="哪个部门应该处理这张工单?",
                criteria={
                    "billing": "支付、扣款、发票和退款问题",
                    "technical": "程序错误、接口或服务异常",
                    "human_review": "信息不足、风险较高或责任不明确",
                },
            )
        },
    )

    answer = result.choices["route"]
    return {
        "choice": answer.choice,
        "probabilities": answer.probabilities,
        "confidence": answer.confidence,
    }


tools = [
    {
        "type": "function",
        "name": "route_with_jev",
        "description": "使用 Jev 在固定候选部门中判断工单路由",
        "parameters": {
            "type": "object",
            "properties": {
                "ticket": {"type": "string"},
            },
            "required": ["ticket"],
            "additionalProperties": False,
        },
        "strict": True,
    }
]

input_items = [
    {
        "role": "user",
        "content": "用户说自己被重复扣款了,应该怎么处理?",
    }
]

# 第一次请求:让 OpenAI 模型生成对 route_with_jev 的函数调用。
response = openai.responses.create(
    model=OPENAI_MODEL,
    input=input_items,
    tools=tools,
    tool_choice={"type": "function", "name": "route_with_jev"},
)

# 原样保留模型返回的输出项,供下一轮继续使用。
input_items += response.output

# Harness 解析函数参数,并真正调用 TypeSafe Jev。
for item in response.output:
    if item.type != "function_call" or item.name != "route_with_jev":
        continue

    arguments = json.loads(item.arguments)
    jev_result = route_with_jev(arguments["ticket"])

    input_items.append(
        {
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(jev_result, ensure_ascii=False),
        }
    )

# 第二次请求:将 Jev 结果交回模型,生成面向用户的说明。
final_response = openai.responses.create(
    model=OPENAI_MODEL,
    input=input_items,
    tools=tools,
    tool_choice="none",
)

print(final_response.output_text)
运行前,应把 OPENAI_MODEL 设置为自己项目有权限使用、并支持对应工具能力的模型。
这段代码中,两个系统的职责边界非常清楚:
text
OpenAI:理解用户问题,决定调用哪个函数,生成最终解释
Harness:保存状态,解析函数调用,持有两个 API Key
TypeSafe:对固定候选项进行判断
本地规则:检查阈值、权限和是否需要人工审批
八、如果使用 OpenAI Agents API
OpenAI 公开提供可复用的自定义 Agent。可以把同一个函数定义放入 agent.tools:
python
agent = openai.beta.agents.create(
    name="ticket-router",
    model=OPENAI_MODEL,
    instructions="处理工单路由前,调用 route_with_jev。",
    tools=tools,
)
Agent 需要函数结果时,会进入 agent.session.requires_action。应用服务取得待执行调用,运行 route_with_jev,再提交工具结果:
python
openai.beta.agents.sessions.events.create(
    session_id,
    events=[
        {
            "type": "agent.session.input.tool_result",
            "turn_id": action.turn_id,
            "call_id": action.call_id,
            "success": True,
            "output": json.dumps(jev_result, ensure_ascii=False),
        }
    ],
)
这也说明了为什么说"Jev 调用发生在 Harness"。OpenAI 官方文档明确区分了函数定义与函数执行:Agent 请求调用,你的应用代码返回结果,Harness 再继续当前轮次。即使 Agent Session 使用托管环境,自定义函数也不会因此自动在那个环境里执行。
九、TypeSafe 有没有提供自己的 Agent
在本文列出的、截至 2026 年 9 月 20 日可见的 TypeSafe 官方公开资料中,未发现独立托管的 Agent Runtime、Agent Builder 或完整 Agent 产品;这不排除未公开或面向特定客户的企业能力。
它提供了一个名字容易让人误解的 Agent Skill。
安装方式例如:
bash
npx skills add typesafe-ai/skills --skill typesafe-ai这个 Skill 可以装进 Codex、Claude Code 等现有 Agent 环境,为宿主 Agent 提供:
- TypeSafe API 的上下文;
- Choice、Score、Noul 的使用方式;
- 问题拆分与架构模式;
- SDK 示例与最佳实践。
但 Skill 本身不会创建执行循环,不会管理工具权限,也不会凭空获得调用能力。宿主 Agent 仍然需要:
- 支持读取 Skill;
- 能生成或运行调用代码;
- 获得
TYPESAFE_API_KEY; - 由 Harness 授予必要的网络和执行权限。
所以更准确的说法是:
TypeSafe 提供了给现有 Agent 使用的 Skill,而不是提供了一个新的 Agent。
十、OpenAI 自己有没有类似能力
在 OpenAI 官方公开资料中,没有找到 OpenAI 使用 TypeSafe 或 Jev 的披露。这只能说明"没有公开证据",不能推导为 OpenAI 内部从未使用。
OpenAI 自身提供了一组相近但不完全等价的能力:
| OpenAI 能力 | 能解决什么 | 与 Jev 的主要差异 |
|---|---|---|
| Structured Outputs | 用 JSON Schema 和 enum 限定输出结构 |
保证结构,不等于提供完整候选概率分布和校准置信度 |
| Function Calling | 让模型选择并请求调用外部函数 | 是工具编排协议,不是独立判断模型 |
| Moderation | 返回固定安全类别、标记和类别分数 | 分类体系面向内容安全,不能任意定义业务候选项 |
| Graders | 使用标签或分数评价输出 | 主要面向 Evals、测试和优化流程 |
logprobs |
返回输出 Token 的对数概率 | Token 概率不等于业务选项的语义概率或正确率 |
| Agents API | 创建带 Instructions、Tools 和 Session 的 Agent | 属于 Agent 与 Harness 层,不是 Jev 这种决策原语 |
如果只需要模型稳定输出规定字段,可以直接使用 Structured Outputs:
python
response = openai.responses.create(
    model=OPENAI_MODEL,
    input="用户被重复扣款,应该交给哪个部门?",
    text={
        "format": {
            "type": "json_schema",
            "name": "route_decision",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "choice": {
                        "type": "string",
                        "enum": [
                            "billing",
                            "technical",
                            "human_review",
                        ],
                    },
                    "reason": {"type": "string"},
                },
                "required": ["choice", "reason"],
                "additionalProperties": False,
            },
        }
    },
)

print(response.output_text)
它可以保证 choice 不会跑出枚举范围,但如果再增加一个 confidence 数字,那仍然只是模型按要求生成的字段,不能未经评估就当成真实正确率。
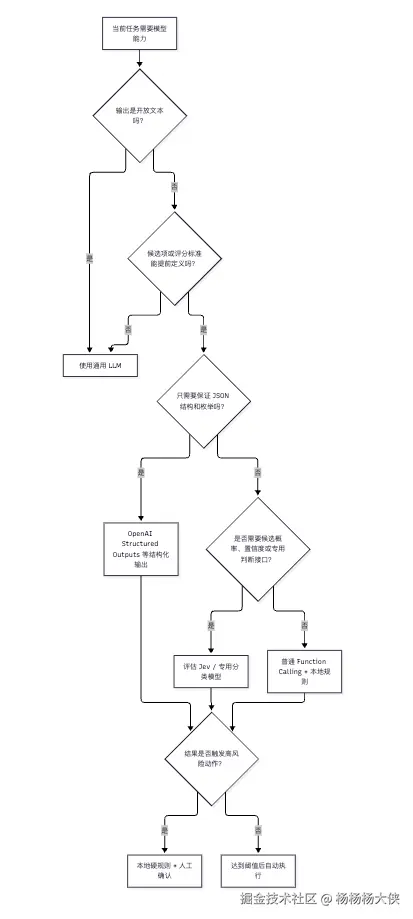
十一、什么时候值得使用 Jev
Jev 的价值并不是让 Agent "更聪明",而是把一部分开放式生成问题改造成边界清晰的判断问题。
适合的场景包括:
- 工单、邮件、线索和内容路由;
- 风险分级与人工升级;
- 从有限工具中选择下一步动作;
- 对候选结果进行排序或验收;
- 在自动执行前增加一个模型判断门;
- 同一份状态需要同时判断多个独立维度。
不太适合的场景包括:
- 写文章、写代码、生成总结等开放式输出;
- 需要多步搜索和长链推理的问题;
- 候选空间根本无法提前定义的问题;
- 仅靠确定性代码规则就能可靠解决的问题;
- 对额外网络延迟、第三方数据传输完全无法接受的场景。
选型可以简化为下面这张图:
十二、落地时最容易踩的坑
1. 把置信度直接当正确率
无论使用哪种模型,阈值都应该基于自己的验证集、误判成本和业务场景设置。不要看到 0.9 就默认可以自动执行。
2. 让模型自由生成可执行动作
候选动作应来自权限系统、代码或配置,而不是让模型自由创造工具名。模型判断的是"选哪个",Harness 判断的是"能不能执行"。
3. 把第三方 API Key 放进 Prompt
OpenAI Key 和 TypeSafe Key 都应由服务端持有。模型只看到函数描述和必要参数,不应该看到真实凭据。
4. 没有失败回退
TypeSafe API 可能返回鉴权错误、参数校验错误、限流或过载。调用方至少要设计:
text
重试退避
→ 超时上限
→ 降级到本地规则或备用模型
→ 仍无法判断时转人工
5. 把 Skill 当成 Runtime
Skill 只是说明与方法集合。真正的网络调用、循环、权限和工具执行仍然需要 Agent Harness 支持。
总结
Jev 的核心价值可以压缩成一句话:
它不是再造一个 Agent,而是给 Agent 系统增加一个面向程序决策的专用模型接口。
在完整系统中,各层应保持清晰分工:
text
通用 LLM:理解、规划与生成
Jev:在固定边界内判断
Skill:告诉 Agent 如何正确接入
Harness:组装上下文、管理状态和执行工具
业务代码:提供候选项、权限、阈值与最终兜底
如果当前系统只是聊天或内容生成,没有必要为了"流行"而增加 Jev。
但如果已经在做 Agent 自动化,并且开始遇到路由不稳定、JSON 置信度不可信、工具选择难以审计等问题,那么这类 System One 决策层确实值得认真评估。
参考资料
TypeSafe AI
- Introduction:Jev 与 System One
- HTTP API Reference
- Python SDK
- JavaScript SDK
- Agent Skill
- Models
- TypeSafe AI GitHub