目录
[二、Langchain 对话API调用](#二、Langchain 对话API调用)
[2.1 模型调用基本说明](#2.1 模型调用基本说明)
[2.2 invoke 使用](#2.2 invoke 使用)
[2.2.1 invoke() 方法说明](#2.2.1 invoke() 方法说明)
[2.2.2 invoke 案例一](#2.2.2 invoke 案例一)
[2.2.3 invoke 案例二,记忆传递](#2.2.3 invoke 案例二,记忆传递)
[2.2.4 使用消息对象列表](#2.2.4 使用消息对象列表)
[2.3 invoke 方法返回值](#2.3 invoke 方法返回值)
[2.4 流式调用(stream )](#2.4 流式调用(stream ))
[2.5 批量调用](#2.5 批量调用)
[2.5.1 一次性接收所有响应](#2.5.1 一次性接收所有响应)
[2.5.2 按完成顺序接收响应](#2.5.2 按完成顺序接收响应)
[2.6 异步调用](#2.6 异步调用)
[2.6.1 同步和异步](#2.6.1 同步和异步)
[2.6.2 异步方法使用](#2.6.2 异步方法使用)
[2.6.3 如何处理模型调用失败](#2.6.3 如何处理模型调用失败)
[2.7 美化模型输出](#2.7 美化模型输出)
[2.7.1 使用pretty_print()](#2.7.1 使用pretty_print())
[2.7.2 使用rich库](#2.7.2 使用rich库)
一、前言
在上一篇我们详细介绍了如何在本地搭建Langchain 环境,并且调用主流的大模型平台的API实现通用的对话能力,本篇进一步深入了解在Langchain 中调用大模型常用的API ,以及输入输出的详细使用。
二、Langchain 对话API调用
2.1 模型调用基本说明
在 LangChain 中,模型调用(Invocation)是指通过特定方法触发大语言模型生成输出的过程。
根据不 同的应用场景和需求,LangChain 提供了几种核心的调用方式,主要有:invoke()
,stream() ,batch() 以及它们的异步版本 ainvoke() 、 astream() 和 abatch(),具体来说:
-
invoke() :阻塞式,一次性返回完整结果问答、批处理任务、无需实时反馈的场景。
-
ainvoke() :非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
-
stream() :流式输出,实时返回每个 token聊天机器人、长文本生成、需要提升用户体验的交互应用。
-
asteam() :非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
-
batch() :批量处理多个输入高并发场景,需要同时处理大量请求。
-
abatch() :非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
2.2 invoke 使用
invoke() 是 LangChain 中最核心的方法,它的工作模式是阻塞式的,即程序会等待模型完全生成整个响应后,再一次性将结果返回给用户。
2.2.1 invoke() 方法说明
invoke 方法的作用如下:
-
接收你的输入(问题、指令、对话历史等)
-
发送给 LLM 模型(如 GPT-4、Llama、Claude 等)
-
返回模型的响应(文本回复 + 元数据信息)
基本语法:
python
response = model.invoke(input, config=None)参数详解:
|--------|------------------------------------------|---------------------|------|---------|
| 参数 | 类型 | 说明 | 是否必须 | 默认值 |
| input | str | listdict | listMessage 等 | 你要发送给模型的内容 | 是 | 无 |
| config | dict | 高级配置(回调函数、元数据、 标签等) | 可选 | None |
2.2.2 invoke 案例一
invoke方法非常灵活,支持三种形式的输入: 文本输入 、 字典列表 、 消息对象列表 。
1、文本输入
简单的一次性问答,直接传入一个问题或指令。
-
适用场景:快速测试,不需要保留对话历史的简单生成任务。
-
缺点:无法设置系统提示(system prompt),无法传递对话历史
下面是一个完整的案例:
- 在 invoke 中直接输入文本,即可自动转化为 user message 并进行对话
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

#1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv ("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

# 3、模型调用
response = model.invoke("你好,介绍一下自己")
print(response)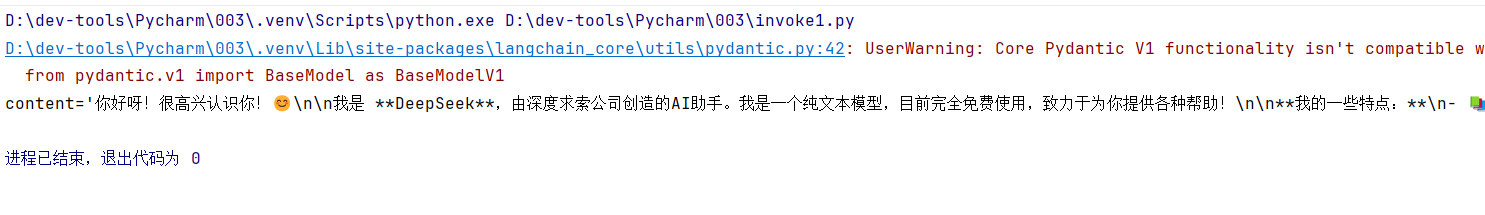
2、字典列表
推荐使用,这种方式很灵活,创建字典列表组成消息。一条消息通常包含 role(角色) 、 content(内容) 等信息。
-
适用场景:可以设置系统提示,表达多轮对话历史,JSON 兼容,易于序列化和网络传输,生产环境推荐。
-
缺点:代码稍微多一点(但更清晰)
格式:
python
messages = [
    {"role": "system", "content": "系统提示"},
    {"role": "user", "content": "用户消息"},
    {"role": "assistant", "content": "AI回复"}, # 可选,用于对话历史
    {"role": "user", "content": "继续提问"}
    ]
参数中的角色说明:
|-----------|--------------|-------------------|---------------------|
| 角色 | 英文 | 作用 | 示例 |
| system | System | 设定 AI 的行为、角色、规则 | "你是一个专业的 Python 导师" |
| user | Human/User | 用户的输入/问题 | 什么是装饰器? |
| assistant | AI/Assistant | AI 的历史回复(用于对话上下文) | "装饰器是一种设计模式..." |
"user"和 "human"有时可以互换,但遵循你选择的主要模型提供商(如OpenAI)的惯例使用
"user"是最稳妥的做法。
下面是一个完整的案例
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

# 使用字典格式构建消息
messages = [
    {"role": "system", "content": "你是一个专业的大学数学教授"},
    {"role": "user", "content": "解释一下什么是蝴蝶效应?"}
]

response = model.invoke(messages)
print(response)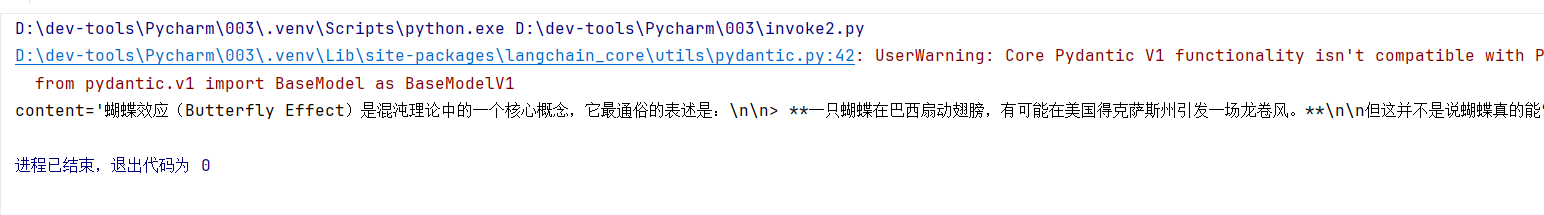
3、多轮对话(带历史)
在很多场景下需要大模型记住历史的对话,下面这种使用assistant的方式是最简单的一种形式
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

# 使用字典格式构建消息
# messages = [
#     {"role": "system", "content": "你是一个专业的大学数学教授"},
#     {"role": "user", "content": "解释一下什么是蝴蝶效应?"}
# ]

# 使用字典格式构建消息
messages = [
    {"role": "system", "content": "你是一个专业的数学老师。"},
    {"role": "user", "content": "2 + 3 * 2 = ?"},
    {"role": "assistant", "content": "8"},
    {"role": "user", "content": "我刚才问了什么问题?"}
]

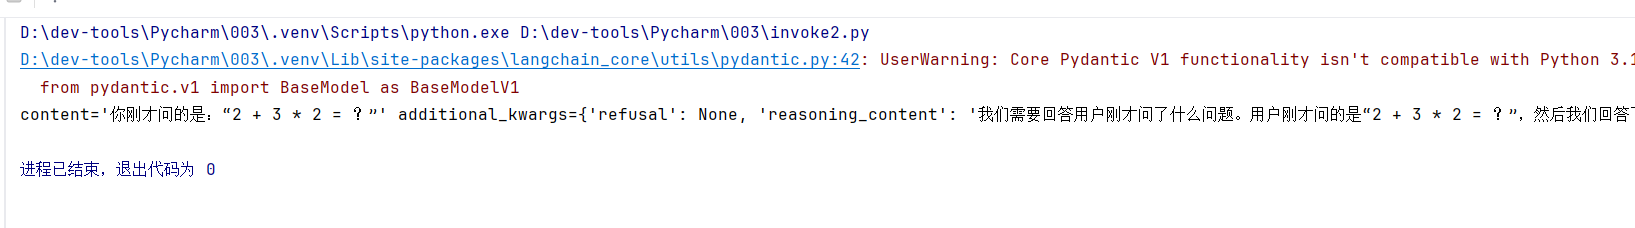
response = model.invoke(messages)
print(response)
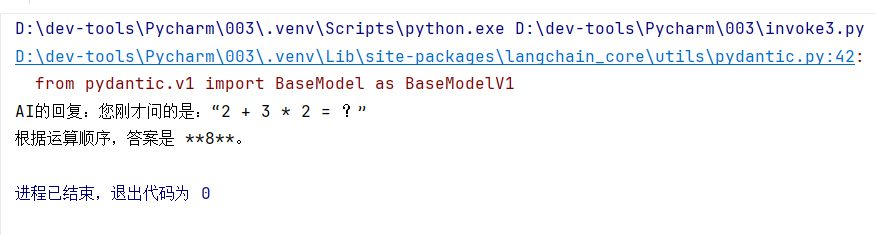
通过输出结果可以看到AI记住了第一轮的对话
2.2.3 invoke 案例二,记忆传递
如果不传递历史会话,AI 会在对话过程中"失忆",在下面的案例中,通过在role的字典中添加assistant 的方式来记住历史对话
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

conversation = [
    {"role": "system", "content": "你是一个非常友好的AI助手"},
    {"role": "user", "content": "你好,我叫小明"}
]

# 第一次对话
response1 = model.invoke(conversation)
# 打印响应
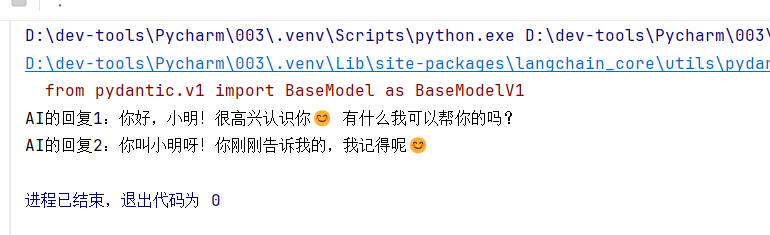
print(f"AI的回复1:{response1.content}")

# 添加记忆
conversation.append({"role": "assistant", "content": response1.content})
conversation.append({"role": "user", "content": "我叫什么名字?"})

# 第二次对话
response2 = model.invoke(conversation)
print(f"AI的回复2:{response2.content}")
通过输出结果可以看到,大模型记住了第一次对话内容
2.2.4 使用消息对象列表
使用内置的消息类(如 SystemMessage, HumanMessage, AIMessage),将消息对象列表输入模型。
-
适用场景:需要类型检查(针对大型项目)、IDE 自动补全的场景
-
缺点:代码较长、不如字典简洁、难以序列化(JSON)
消息类型对照:
|---------------|----------------------------|--------|
| 消息类 | 对应字典格式 | 作用 |
| SystemMessage | {"role": "system", ...} | 系统提示 |
| HumanMessage | {"role": "user", ...} | 用户输入 |
| AIMessage | {"role": "assistant", ...} | AI 回复 |
下面看一个具体的示例
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, AIMessage, HumanMessage
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

# 使用消息对象格式构建消息
messages = [
    SystemMessage("你是一个专业的数学老师。"),
    HumanMessage("2 + 3 * 2 = ?"),
    AIMessage("8"),
    HumanMessage("我刚才问什么问题了?")
]
response = model.invoke(messages)
# 打印响应
print(f"AI的回复:{response.content}")
执行一下结果如下
2.3 invoke 方法返回值
invoke 返回一个 AIMessage对象 ,源码如下:
python
def invoke(
self,
input: LanguageModelInput,
config: RunnableConfig | None = None,
*,
stop: list[str] | None = None,
**kwargs: Any,
) -> AIMessage:
python
# 使用字典格式构建消息
response = model.invoke([HumanMessage("2 + 3 * 2 = ?")])
# 打印响应
print(type(response))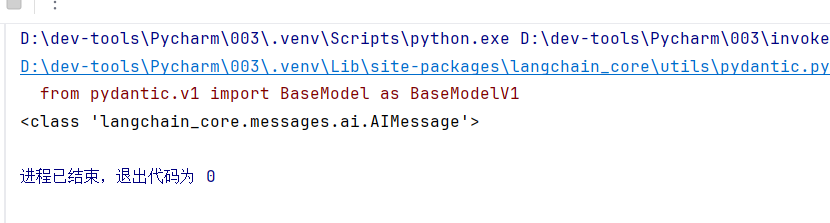
通过rich 包让输出结果看起来更直观一些
python
from rich import print as rprint
rprint(response)
返回值如下
python
AIMessage(
    content='8',
    additional_kwargs={
        'refusal': None,
        'reasoning_content': 'We need answer in Chinese likely. Need compute
2+3*2=8. Need concise.'
    },
    response_metadata={
        'token_usage': {
            'completion_tokens': 23,
            'prompt_tokens': 93,
            'total_tokens': 116,
            'completion_tokens_details': {
                'accepted_prediction_tokens': None,
                'audio_tokens': None,
                'reasoning_tokens': 21,
                'rejected_prediction_tokens': None,
                'text_tokens': None
            },
            'prompt_tokens_details': {
                'audio_tokens': None,
                'cache_write_tokens': None,
                'cached_tokens': 0,
                'image_tokens': None,
                'text_tokens': None
            },
            'prompt_cache_hit_tokens': 0,
            'prompt_cache_miss_tokens': 93
        },
        'model_provider': 'deepseek',
        'model_name': 'deepseek-v4-flash',
        'system_fingerprint': 'a26a7955944dc5c60445bff77fac9c8e',
        'id': '7f5c4648-6f30-4777-9fd4-d5706ffeaa1f',
        'finish_reason': 'stop',
        'logprobs': None
    },
    id='lc_run--01a080f1-176b-7452-8fb2-0155f26ea265-0',
    tool_calls=[],
    invalid_tool_calls=[],
    usage_metadata={
        'input_tokens': 93,
        'output_tokens': 23,
        'total_tokens': 116,
        'input_token_details': {'cache_read': 0},
        'output_token_details': {'reasoning': 21}
    }
)
核心内容与基本信息
-
content : 模型生成的文本回答。这是你最关心的核心输出
-
id : 本次运行在 LangChain 内部生成的唯一标识符(Run ID)
-
additional_kwargs : 包含特定供应商的额外参数
- refusal : 如果模型拒绝回答(涉及敏感政策),此处会显示拒绝原因。
2.4 流式调用(stream)
invoke 和 stream 有什么区别?
-
invoke() :同步调用,在模型输出完成后一次性获取响应,对于输出文本很长的场景,用户体验不好。
-
stream() :流式调用,实时返回响应片段。调用后,返回一个 迭代器(iterator) ,可以通过循环来实时处理每一个新生成的chunk内容块。
注意:流式输出依赖于模型供应商对于流式输出的支持。
下面是完整的案代码
python
from langchain_community.chat_models import ChatTongyi
from dotenv import load_dotenv
import os

#1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DASHSC0PE_API_KEY = os.getenv ("DASHSC0PE_API_KEY")

# 2、模型初始化
llm_tongyi = ChatTongyi(
    model="qwen3-max",
    api_key = DASHSC0PE_API_KEY
)

# 3、模型调用
# response = llm_tongyi.invoke("请用一句话介绍自己")
# print(response)

for chunk in llm_tongyi.stream("写一首七言律诗,总结大模型的发展"):
    print(chunk.text, end="", flush=True)  # 逐token输出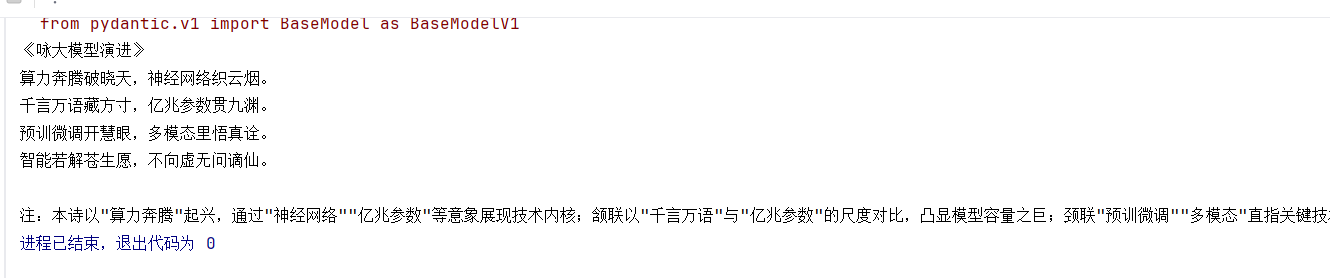
stream 输出不再是整段返回,而是流式输出,主要有下面特点
-
响应速度更快 --- 用户不必等待完整输出
-
交互体验更流畅 --- 尤其在长文本或复杂推理场景下
-
可实时展示模型思考过程
2.5 批量调用
batch() 方法允许你一次性 发送一组请求 (含多条独立请求),模型会在后台 并行处理 ,然后返回 所有结果的列表 。
-
与逐个顺序调用(invoke)相比,能大幅 减少网络往返开销 和 等待时间 ,显著提升性能、降低成本。
-
**适用场景:**文档摘要、批量问答、数据预处理、多样本分类等。
2.5.1 一次性接收所有响应
batch()特点是等待所有请求处理完毕,按原始输入顺序返回结果列表。
如下完整的案例
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
llm_deepseek = init_chat_model(
    model="deepseek-v4-pro",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

messages = [
    "你好,你是谁?",
    "2 + 3 * 5 = ?",
    "中国首都在哪里?"
]

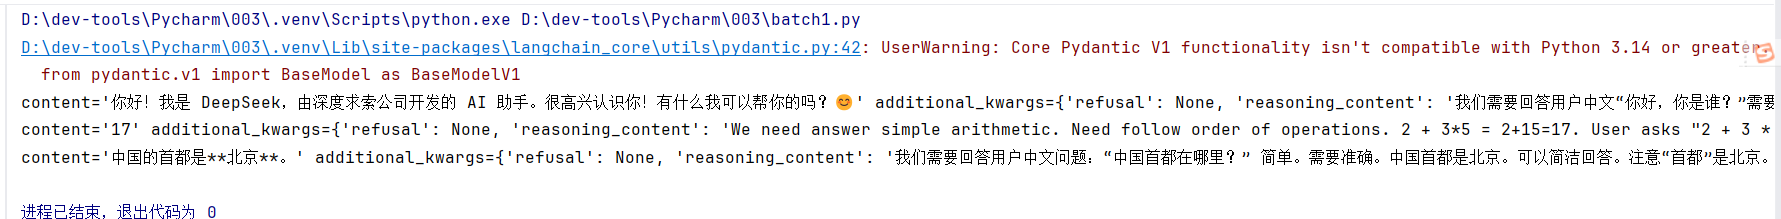
responses = llm_deepseek.batch(messages)

for response in responses:
    print(response)
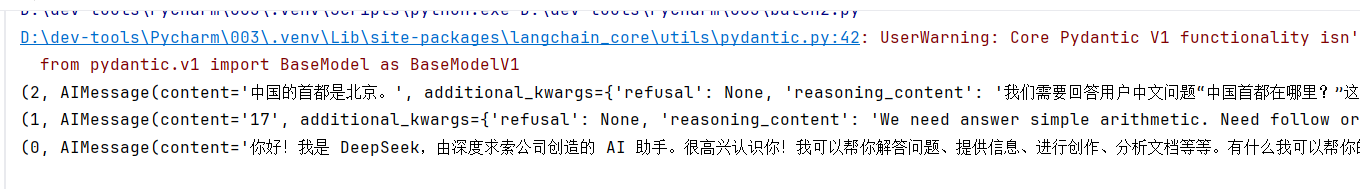
通过结果可以看到一次性输出了所有问题的结果
2.5.2 按完成顺序接收响应
当输入列表很大或单个模型调用耗时差异显著时, batch_as_completed() 允许应用在收到第一个结果后立即返回响应,而不会等待批次内所有任务完成才响应。即batch_as_completed() 每个请求完成后立即 yield 结果, 结果可能乱序 。
但是,每个返回的响应都被放在一个 元组 中,元组的第一个元素是原始输入的 index 索引,可根据索引重新排序。
如下完整的示例
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
llm_deepseek = init_chat_model(
    model="deepseek-v4-pro",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

messages = [
    "你好,你是谁?",
    "2 + 3 * 5 = ?",
    "中国首都在哪里?"
]

responses = llm_deepseek.batch_as_completed(messages)

for response in responses:
    print(response)
在输出结果时,可以很明显看到有一个顺序输出的过程
2.6 异步调用
2.6.1 同步和异步
同步(sync) :
-
概念:发起一个任务之后,需要 等待该任务完成后 ,才能继续执行后续任务。
-
表现:当前执行流 会被『阻塞』 。
异步:
-
概念:发起一个任务之后, 不必等该任务完成 ,就可以继续执行其他任务。
-
备注:虽然不必等待任务完成,但任务完成后,仍然可以通过特定方式获取结果。
-
表现:当前执行流 不会被『阻塞』 。
在LangChain框架中,异步方法(ainvoke、astream、abatch)与它们的同步版本(invoke、
stream、batch)相比,具备如下特点:
-
避免阻塞主线程 :同步调用会阻塞程序执行,而异步方法让应用程序在等待API响应时保持响应性。
-
优化资源利用 :异步操作可以更高效地利用系统资源,减少空闲等待时间
2.6.2 异步方法使用
在下面的代码中引入asyncio 这个模块开启异步任务的调用,ainvoke 使用代码如下:
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
import asyncio
import time

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
llm_model = init_chat_model(
    model="deepseek-v4-pro",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

async def demo_async_invoke():
    print("=== 演示:ainvoke 的异步(非阻塞)效果 ===")
    start_time = time.perf_counter()  # 记录开始时间
    print("程序开始...")

    # 1. 创建任务 (Task)
    print(">>> 发起异步模型调用 (ainvoke)...")
    async_task = asyncio.create_task(llm_model.ainvoke("用一句话解释人工智能。"))

    # 2. 并行执行其他任务
    print(">>> 模型请求已在后台发送,继续执行本地逻辑...")
    for i in range(3):
        await asyncio.sleep(1)  # 使用异步等待,释放控制权
        print(f">>> 正在执行第{i + 1}个任务... (已耗时 {time.perf_counter() - start_time:.2f}s)")

    # 3. 获取模型结果
    print(">>> 本地任务完成,检查模型状态...")
    response = await async_task
    end_time = time.perf_counter()

    print(f">>> 模型返回: {response.content}")
    print(f"=== 总运行耗时: {end_time - start_time:.2f}s ===")

async def main():
    await demo_async_invoke()

if __name__ == "__main__":
    asyncio.run(main())
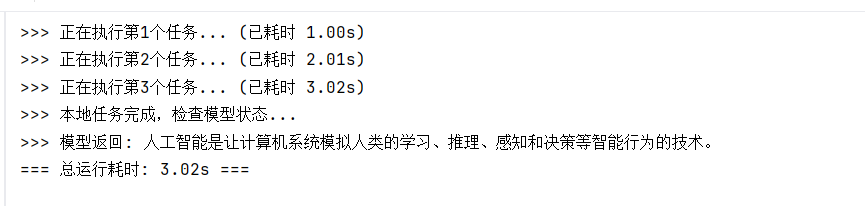
通过输出结果日志可以看到多个任务在并行执行
astream 使用代码如下:
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
import asyncio
import time

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
llm_model = init_chat_model(
    model="deepseek-v4-pro",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

async def demo_async_stream():

    """演示异步调用的非阻塞特性"""
    print("=== 演示:astream 的异步(非阻塞)效果 ===")
    start_time = time.perf_counter()  # 记录开始时间
    print("程序开始...")

    # 1. 发起异步流式请求
    # 注意:此时请求已发出,返回的是一个异步生成器
    print(">>> 发起异步流式调用 (astream)...")
    stream_resp = llm_model.astream("请用一句话解释机器学习的基本概念。")

    # 2. 在等待流式响应的同时,执行其他任务
    print(">>> 流式请求已发送,程序无需等待,继续执行其他异步任务...")
    for i in range(3):
        # 使用 asyncio.sleep 而非 time.sleep
        # 这允许事件循环在等待时去处理上面的 stream_resp 网络 IO
        await asyncio.sleep(1)
        # print(f">>> 正在执行并发任务 {i + 1}... ")
        print(f">>> 正在执行第{i + 1}个任务... (已耗时 {time.perf_counter() -
                                                start_time:.2f}s)")
    # 3. 现在开始处理流式结果
    print(">>> 模拟任务已完成,开始读取缓冲区中的流式结果...")
    end_time = time.perf_counter()
    print(">>> 流式输出: ", end="", flush=True)

    async for chunk in stream_resp:
        # LangChain 的消息块通常通过 .content 获取内容
        content = chunk.content if hasattr(chunk, 'content') else str(chunk)
        print(content, end="", flush=True)

    print("\n>>> 流式输出结束\n")
    print(f"=== 总运行耗时: {end_time - start_time:.2f}s ===")

async def main():
    await demo_async_stream()

if __name__ == "__main__":
    asyncio.run(main())
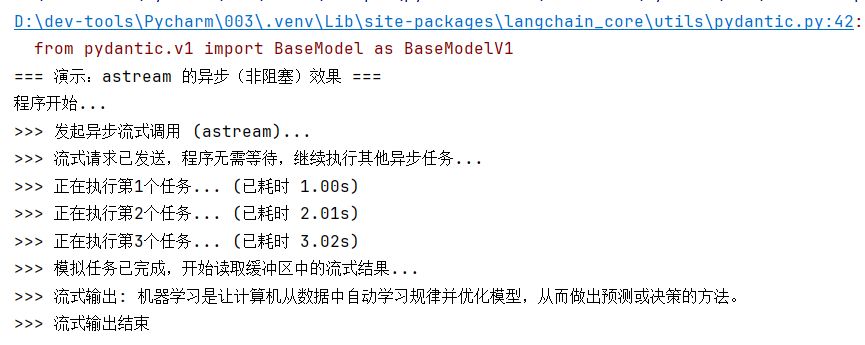
执行效果如下
2.6.3 如何处理模型调用失败
如果在调用中失败,可以通过使用 try-except 块捕获异常:
python
try:
    response = model.invoke("Hello")
    print(response.content)
except ValueError as e:
    print(f"配置错误: {e}")
except ConnectionError as e:
    print(f"网络错误: {e}")
except Exception as e:
    print(f"未知错误: {e}")
2.7 美化模型输出
2.7.1 使用pretty_print()
我们查看响应的方式是直接print(response),返回的内容比较杂乱,可以调用 pretty_print() 美化输出内容。
python
# 向模型发送单条数据
response = llm_tongyi.invoke("请用一句话介绍自己")
# 美化输出响应
response.pretty_print()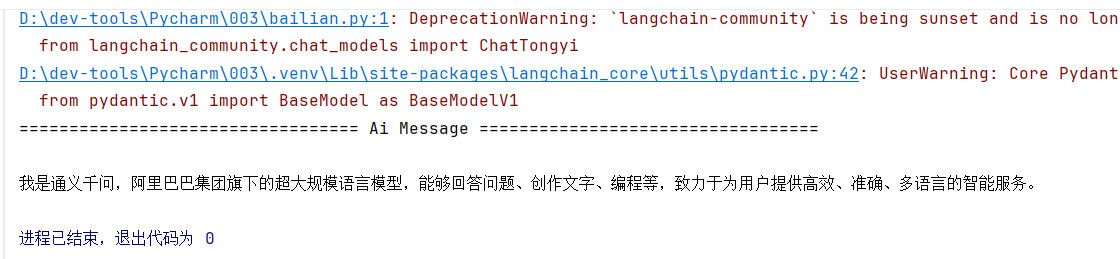
2.7.2 使用rich库
如果你在终端(Terminal)工作,想要色彩鲜明、排版优雅的调试界面,可以使用 rich 这个库。
python
from rich import print as rprint
rprint(response)
三、写在最后
本文通过案例操作详细介绍了Langchain 中对话API的使用,更深入的可以基于此继续深入研究,希望对看到的同学有用,本篇到此结束,感谢观看。