这是「AI Agent 入门指南 · 概念篇」的第 5 篇,也是"核心循环"模块的第一篇。
前面四篇讲完了"大脑",从这一篇开始,我们看它怎么"动起来"。
一、为什么要学
如果你只能从整个概念篇里挑一个概念来理解 Agent,那应该是循环。
因为:
Agent 和普通 Chatbot 最本质的区别,不是"更聪明",而是"它会循环"。
Chatbot 是"一问一答":你问,它答,结束。
Agent 是"一个循环":它想一步 → 做一步 → 看结果 → 再想下一步 → 再做......直到任务完成。
理解了循环,你就理解了 Agent 的"发动机"。
而且,理解循环还能解释很多工程现象:
- 为什么 Agent 比普通对话慢?(每一步都要调一次 LLM)
- 为什么 Agent 比普通对话贵?(调用的次数多)
- 为什么 Agent 会卡死?(循环没有终止条件)
- 为什么 Agent 会越走越偏?(上一步的错误被带进下一步)
二、解决什么问题
第 2 篇我们说过:LLM 只会生成文字,一次调用只能产生一次输出。
那么问题来了:
如果一件事需要多步才能完成,怎么办?
比如"分析支付异常"这个任务,需要:查日志 → 发现超时 → 查监控 → 发现下游慢 → 查部署 → 得出结论。
这是一串步骤,不是一次输出能搞定的。
最笨的办法是:你手动一步步来------"先查日志"→ 看结果 → "现在查监控" → 看结果 → ......
Agent 循环要解决的,就是把这个"人工多轮"变成"自动多轮"。
它让 LLM 自己决定下一步做什么,自己看结果,自己继续------人只在开头给任务,在结尾收结果。
三、核心概念
1. Agent Loop 的定义
一句话:
Agent Loop = 让 LLM 反复执行"思考 → 行动 → 观察",直到任务完成。
拆成三步:
| 步骤 | 谁在做 | 做什么 |
|---|---|---|
| 思考(Think) | LLM | 根据当前情况,决定下一步做什么 |
| 行动(Act) | 工具/系统 | 执行 LLM 决定的动作 |
| 观察(Observe) | 工具/系统 | 把执行结果返回给 LLM |
然后回到第一步,LLM 看到新结果,再决定下一步。
2. 这个模式有个名字:ReAct
你会在很多地方看到 "ReAct" 这个词,它就是 Reasoning + Acting(推理 + 行动)的缩写。
它指的就是这个循环:
Reason(推理):我需要先查日志
Act(行动)   :调用查日志工具
Observe(观察):日志显示有超时
Reason(推理):超时可能是下游问题,我该查监控
Act(行动)   :调用查监控工具
...
ReAct 不是某个框架的名字,而是一种"边想边做"的范式。 它的核心洞察是:
不要一开始就规划好所有步骤,而是"走一步看一步"。
(当然,"先规划再执行"也是一种范式,我们在第 7 篇"规划"里会对比。)
3. 循环什么时候停
这是循环设计里最关键的问题之一。如果不知道什么时候停,就会无限循环。
常见的终止条件有四种:
| 终止条件 | 说明 | 例子 |
|---|---|---|
| LLM 认为完成 | 它输出"最终答案",不再调工具 | "结论是:下游部署导致超时" |
| 达到最大步数 | 硬性限制,防止无限循环 | "最多 20 步,超了就停" |
| 达到预算上限 | token / 时间 / 花费超限 | "超过 10 万 token 就停" |
| 出错且无法恢复 | 连续失败,放弃 | "连续 3 次工具调用失败" |
成熟的 Agent 系统,这四种条件通常都要有。 只靠第一种("它自己觉得完成了")是危险的------因为 LLM 可能"觉得自己完成了"但其实是错的,也可能"一直觉得没完成"而陷入死循环。
4. 循环的代价
这是新人最容易忽略的一点:
循环不是免费的。每一圈,都要调一次 LLM。
一次 LLM 调用意味着:花钱 + 花时间。
1 步   → 1 次 LLM 调用
10 步  → 10 次 LLM 调用
50 步 → 50 次 LLM 调用而且每一圈都要把之前所有历史 重新发一遍(因为 LLM 无状态),所以越往后越贵、越慢。
这就是为什么:
- Agent 比普通对话贵得多
- 好的 Agent 设计要"尽量少绕弯"
- 上下文管理(第 4 篇)如此重要
5. 循环可能失控
循环带来自主性,也带来风险:
- 无限循环:LLM 反复做同一件事,停不下来。
- 越走越偏:第一步的小错误,被后面每一步放大。
- 死磕:一个方法不行,它不换方法,反复重试。
这些都不是"模型太笨",而是"循环缺约束"。 所以成熟系统会有:步数上限、循环检测、失败重试策略等机制。(这正是工程实践系列里"护栏"要讲的。)
四、一张图讲懂
Agent 循环的完整结构:
                    ┌─────────────────┐
                    │   用户任务       │
                    └────────┬────────┘
                             │
                             ▼
              ┌──────────────────────────┐
              │                          │
              │   ┌──────────────────┐   │
              │   │  1. 思考(LLM)   │   │
              │   │  下一步做什么?    │   │
              │   └────────┬─────────┘   │
              │            │             │
              │            ▼             │
              │   ┌──────────────────┐   │
              │   │  2. 行动(工具)  │   │
              │   │  真正执行操作     │   │
              │   └────────┬─────────┘   │
              │            │             │
              │            ▼             │
              │   ┌──────────────────┐   │
              │   │  3. 观察         │   │
              │   │  拿到执行结果     │   │
              │   └────────┬─────────┘   │
              │            │             │
              │            └─────────────┤
              │              (回到 1)    │
              └──────────────┬───────────┘
                             │
                  终止条件满足?
                             │
                             ▼
                    ┌─────────────────┐
                    │   最终结果       │
                    └─────────────────┘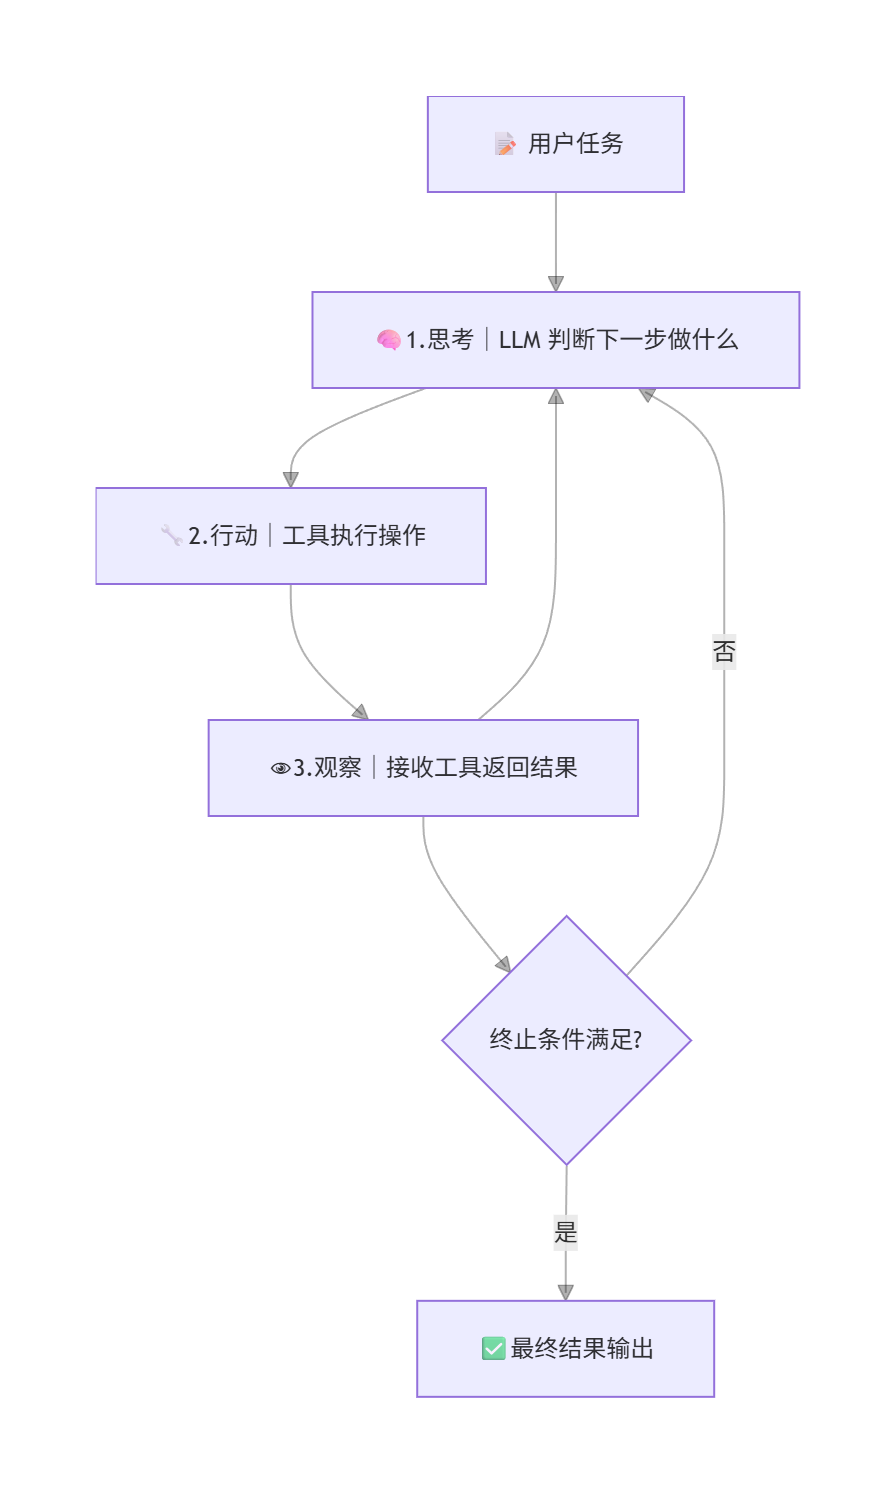
关键点:它是一个环,不是一条线。 这个"环"就是 Agent 的发动机。
五、一个例子
我们完整走一遍"分析支付异常"的循环,看看每一步发生了什么。
任务:"帮我分析一下昨天支付服务为什么异常。"
第 1 圈:
- 🧠 思考:"我需要先看日志。" → 决定调用
查日志(service=支付, date=昨天) - 🔧 行动:工具执行,返回"发现 3 次超时"
- 👁 观察:LLM 看到结果
第 2 圈:
- 🧠 思考:"超时通常是下游问题,我去看下游监控。" → 调用
查监控(service=下游) - 🔧 行动:工具执行,返回"下游响应时间从 100ms 涨到 2000ms"
- 👁 观察:LLM 看到结果
第 3 圈:
- 🧠 思考:"响应时间突然变慢,可能是有部署。" → 调用
查部署记录(date=昨天) - 🔧 行动:工具执行,返回"下午 3 点有一次下游部署"
- 👁 观察:LLM 看到结果
第 4 圈:
- 🧠 思考:"线索够了,可以给结论。" → 输出最终答案(不调工具)
- ✅ 循环终止
注意第 4 圈------它没有"行动",而是直接给答案。这就是"LLM 认为完成"的终止条件。
而且注意:第 2、3 圈的调查方向,是它根据上一步结果临时决定的,不是一开始就规划好的。这就是"走一步看一步"。
六、常见误区
Q1:循环就是"重复调用 LLM"吗?
不只是。关键是"每次调用都带着上一步的结果"。 如果每次调用都是独立的、不带结果,那只是"重复",不是"循环"。
循环的本质是:上一圈的结果,成为下一圈的输入。 这才叫"反馈"。
Q2:循环步数越多,Agent 就越强吗?
不是。步数多只是"能处理更复杂的任务",但也意味着更慢、更贵、更容易出错。
好的 Agent 追求的不是"步数多",而是"用最少的步数把事办好"。一个 3 步能解决的 Agent,比一个 30 步的更好。
Q3:怎么防止它无限循环?
三个常见手段:
- 步数上限(硬性封顶)
- 循环检测(发现它在重复同样的动作就打断)
- 预算上限(token/时间/费用超了就停)
这些是"工程护栏",不是"模型能力"。别指望模型自己不会绕圈。
Q4:ReAct 是唯一的循环方式吗?
不是。除了"边想边做"(ReAct),还有"先规划再执行"(Plan-and-Execute)、"反思改进"(Reflection)等模式。它们都是循环的不同变体。第 7 篇"规划"会专门讲这些模式的取舍。
七、下一步
现在你知道了 Agent 的"发动机"长什么样:
思考 → 行动 → 观察 → 再思考 → ...但这里有个问题:"行动"这一步,LLM 是怎么"做到"的?
它只是一台生成文字的机器,它怎么能"查日志""写文件""调 API"?
答案就是循环里最关键的一环:
06 工具调用:Agent 的"双手"
系列导航
- 上一篇:04 上下文窗口------大脑为什么会"忘"
- 下一篇:06 工具调用------Agent 的"双手"
- 完整脉络:认识大脑(01-04)→ 核心循环(05-07)→ 记忆知识(08-09)→ 生态协作(10-12)→ 可靠全景(13-15)