过去几年,我们似乎习惯了一件事情:
只要系统里需要一点"智能",就塞进去一个大模型。
用户意图识别,用 LLM。
选择哪个 Tool,用 LLM。
判断任务是否完成,用 LLM。
评估 Agent 输出是否正确,还是用 LLM。
甚至只是判断一个操作"危险不危险",很多 Agent 框架也会专门再调用一次 LLM。
于是,一个很有意思的现象出现了:
我们正在让一个擅长"生成文本"的模型,承担越来越多根本不需要生成文本的工作。
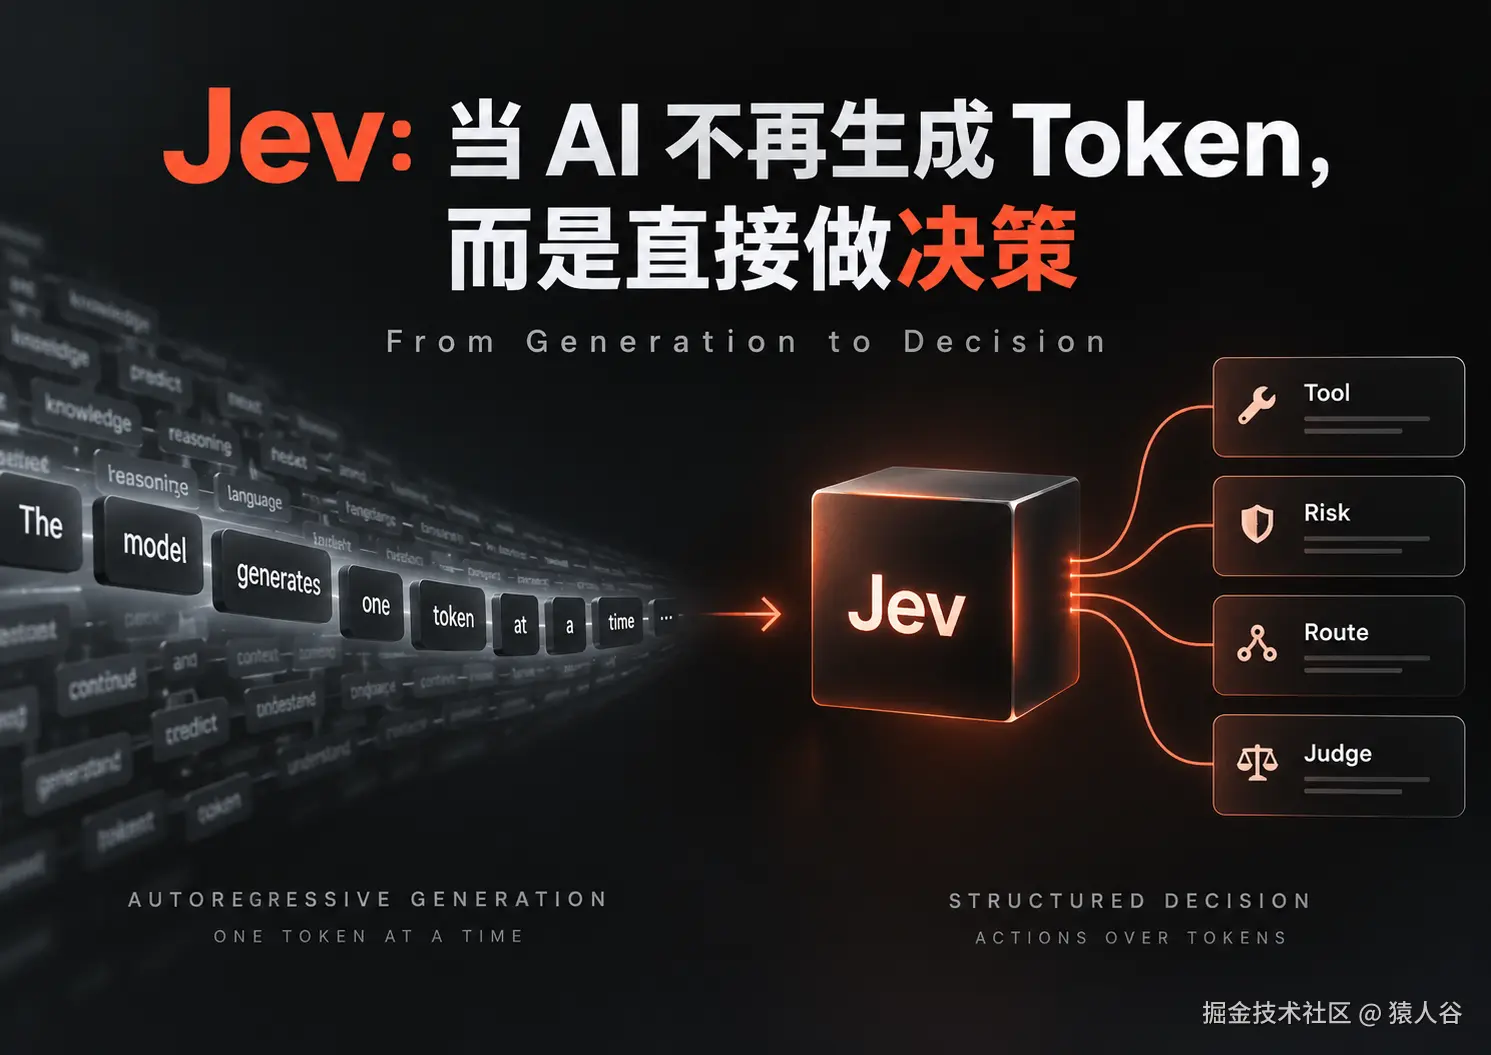
2026 年 9 月 15 日,TypeSafe AI 发布了一个很有意思的新模型------Jev。
它既不是 Chatbot,也不是传统意义上的生成式 LLM。
因为:
Jev 根本不生成文本。
它只做一件事情:
Decision。
给它一个 State,再告诉它需要判断什么,它直接返回一个结构化的 Decision,以及这个 Decision 对应的概率。
TypeSafe 把这类模型定义为:
System One Model。
如果这个方向继续发展下去,我认为它真正值得关注的地方,并不是又多了一个新的 AI 模型,而是它可能会改变我们今天构建 Agent、Harness 和 AI Application 的方式。
1. 为什么我们需要一个"不生成文字"的 AI?
先看一个最简单的例子。
假设我们正在构建一个客服系统,现在收到这样一条消息:
I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.
程序需要判断三件事情:
- 这个问题是否紧急?
- 应该分配给哪个部门?
- 用户当前的情绪程度是多少?
今天比较常见的方式,是把这些内容交给 LLM:
text
用户消息
   ↓
LLM
   ↓
生成:
{
  "urgent": true,
  "department": "billing",
  "emotion": "frustrated"
}
   ↓
解析 JSON
   ↓
验证 Schema
   ↓
程序继续执行
从工程角度看,其实有点奇怪。
因为我们最终需要的,并不是一段文字。
程序真正需要的只是:
text
urgent = true
department = billing
emotion = frustrated
但是为了获得这几个变量,我们却启动了一个生成式模型,让它:
Token 1 → Token 2 → Token 3 → Token 4......
最后再把生成出来的字符串重新解析成程序可以使用的数据。
这本质上是:
用一个 Text Generator 模拟 Function。
Jev 想改变的就是这一层。
TypeSafe 对它的描述非常直接:
Unstructured state in, typed probabilistic decisions out.
也就是:
text
State
 ↓
Jev
 ↓
Decision
没有长文本生成。
没有 JSON Parsing。
也不需要模型"写一句话解释一下"。
TypeSafe 因此把 Jev 称为一种 frontier-intelligence function call。
2. Jev 最核心的思想:Decision,而不是 Generation
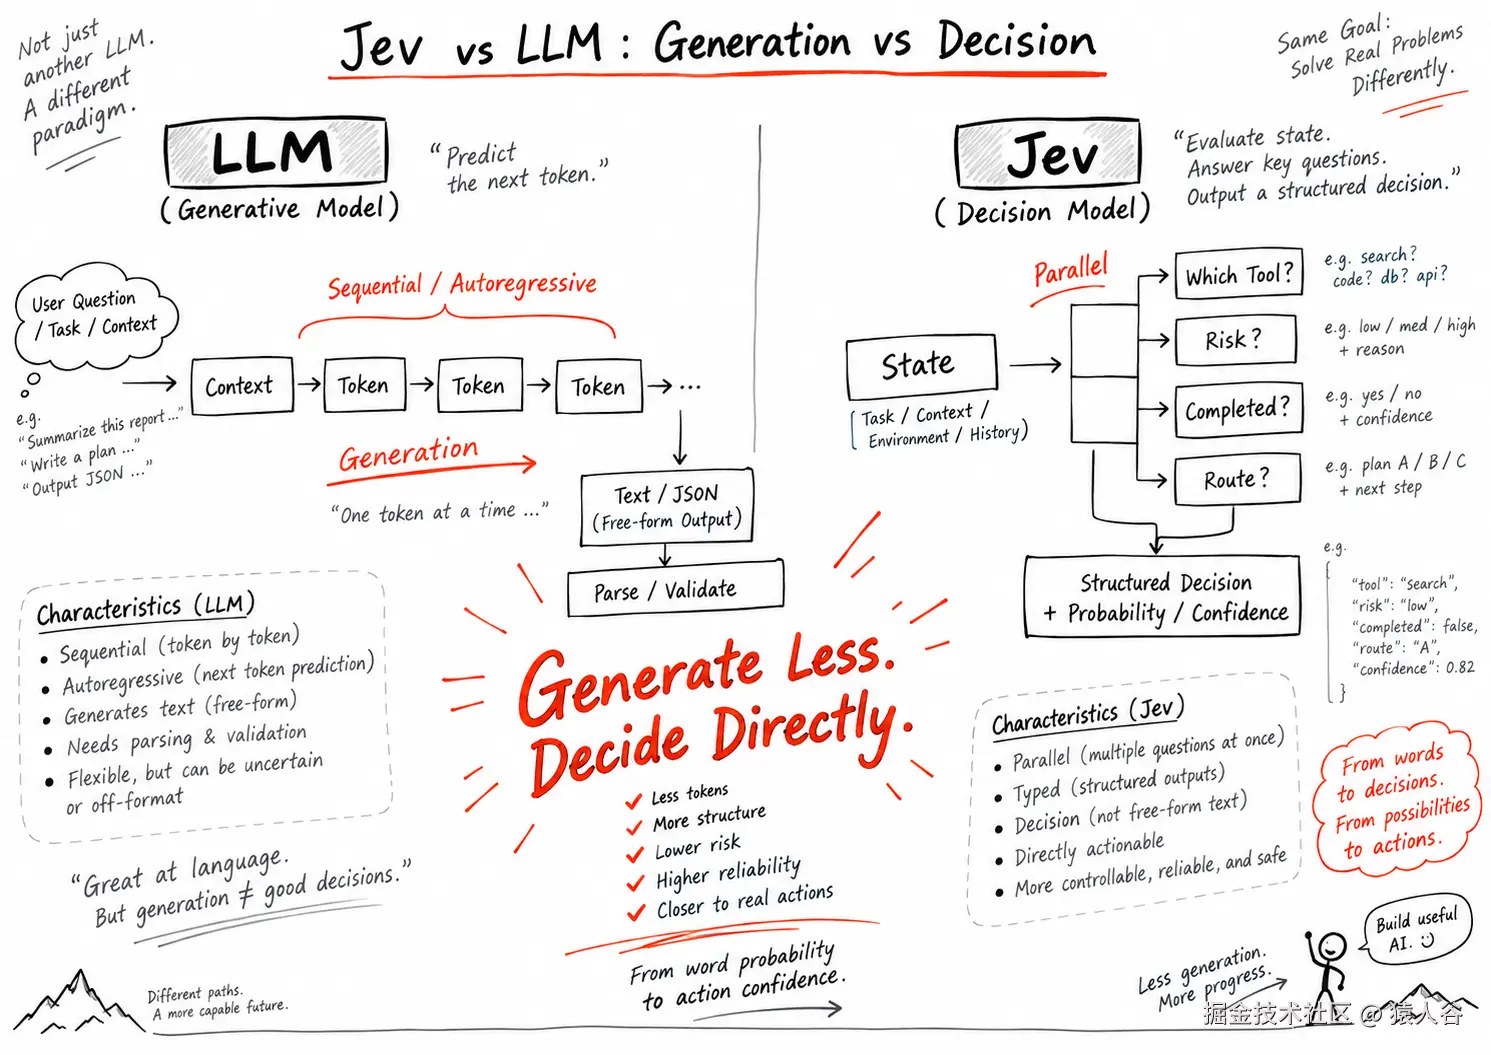
传统 LLM 的基本范式是:
text
Context
   ↓
Token
   ↓
Token
   ↓
Token
   ↓
Token
   ↓
Answer
这是典型的 Autoregressive Generation。
前一个 Token 生成之后,才能继续生成下一个 Token。
而 Jev 的思路是:
text
                 ┌── urgent?
                 │
State ───────────┼── department?
                 │
                 ├── risk?
                 │
                 └── completed?
这些问题可以一起评估,并直接返回结构化结果。
目前 Jev 主要提供三种 Decision Primitive:
1. Choice
从几个明确选项中选择一个。
例如:
text
Which team should handle this request?

- Billing
- Technical Support
- Sales
- Security
返回:
text
Technical Support  0.91
Billing            0.06
Sales              0.02
Security           0.01
2. Score
根据预先定义好的 Rubric 评分。
例如:
text
Risk Level:

0 = Safe
1 = Low
2 = Medium
3 = High
Jev 可以返回对应的评分及概率分布。
3. Noul
这是 Jev 很有特色的一个 Primitive。
本质上就是:
某个判断成立的概率是多少?
例如:
text
Is this operation dangerous?返回:
text
0.87这不是:
text
"Yes, I think this operation may be dangerous."而是直接:
text
risk_probability = 0.87程序马上就可以使用:
python
if risk_probability > 0.8:
    require_confirmation()
这也是 Jev 和传统 Chat Model 在工程理念上的一个重要区别。
3. 更重要的不是"快",而是 Calibrated Confidence
很多人第一次看到 Jev,会首先关注它的速度。
TypeSafe 官方公布的数据里,在适合 System One 的任务上,Jev 相比一些传统 LLM 可以获得几十倍到近两百倍的速度优势,以及显著的成本优势。
官方当前给出的典型推理延迟大约是:
70--500ms。
当前公开价格约为:
$0.042 / 1M input tokens,output 不收费。
原因也非常简单:
它没有传统意义上的 output token generation。
但在我看来:
速度和成本其实还不是 Jev 最重要的地方。
真正值得关注的是另外一个能力:
Calibrated Confidence。
今天我们让 LLM 判断某件事情时,很容易得到这种结果:
text
I am 95% confident that this request is malicious.问题在于:
这个 95% 到底意味着什么?
很多情况下,它仍然只是模型生成出来的一段文本。
它并不天然意味着:
当模型说 95% 时,它长期来看真的有约 95% 的概率是正确的。
TypeSafe 为 Jev 使用了一种新的训练方式:
RLCD
即:
Reinforcement Learning for Calibrated Decisions。
它试图训练模型的并不仅仅是:
"选出正确答案。"
还包括:
"知道自己有多确定。"
这件事情对 Agent 非常重要。
因为真正成熟的自动化系统通常不应该只有:
text
YES
NO
而应该是:
text
High Confidence
      ↓
自动执行

Medium Confidence
      ↓
进一步验证

Low Confidence
      ↓
交给更强模型 / Human
也就是:
text
                  ┌── Execute
                  │
Decision ─────────┼── Escalate to LLM
                  │
                  └── Human Review
Confidence 本身成为了程序控制流的一部分。
我认为这是 Jev 最值得长期关注的地方之一。 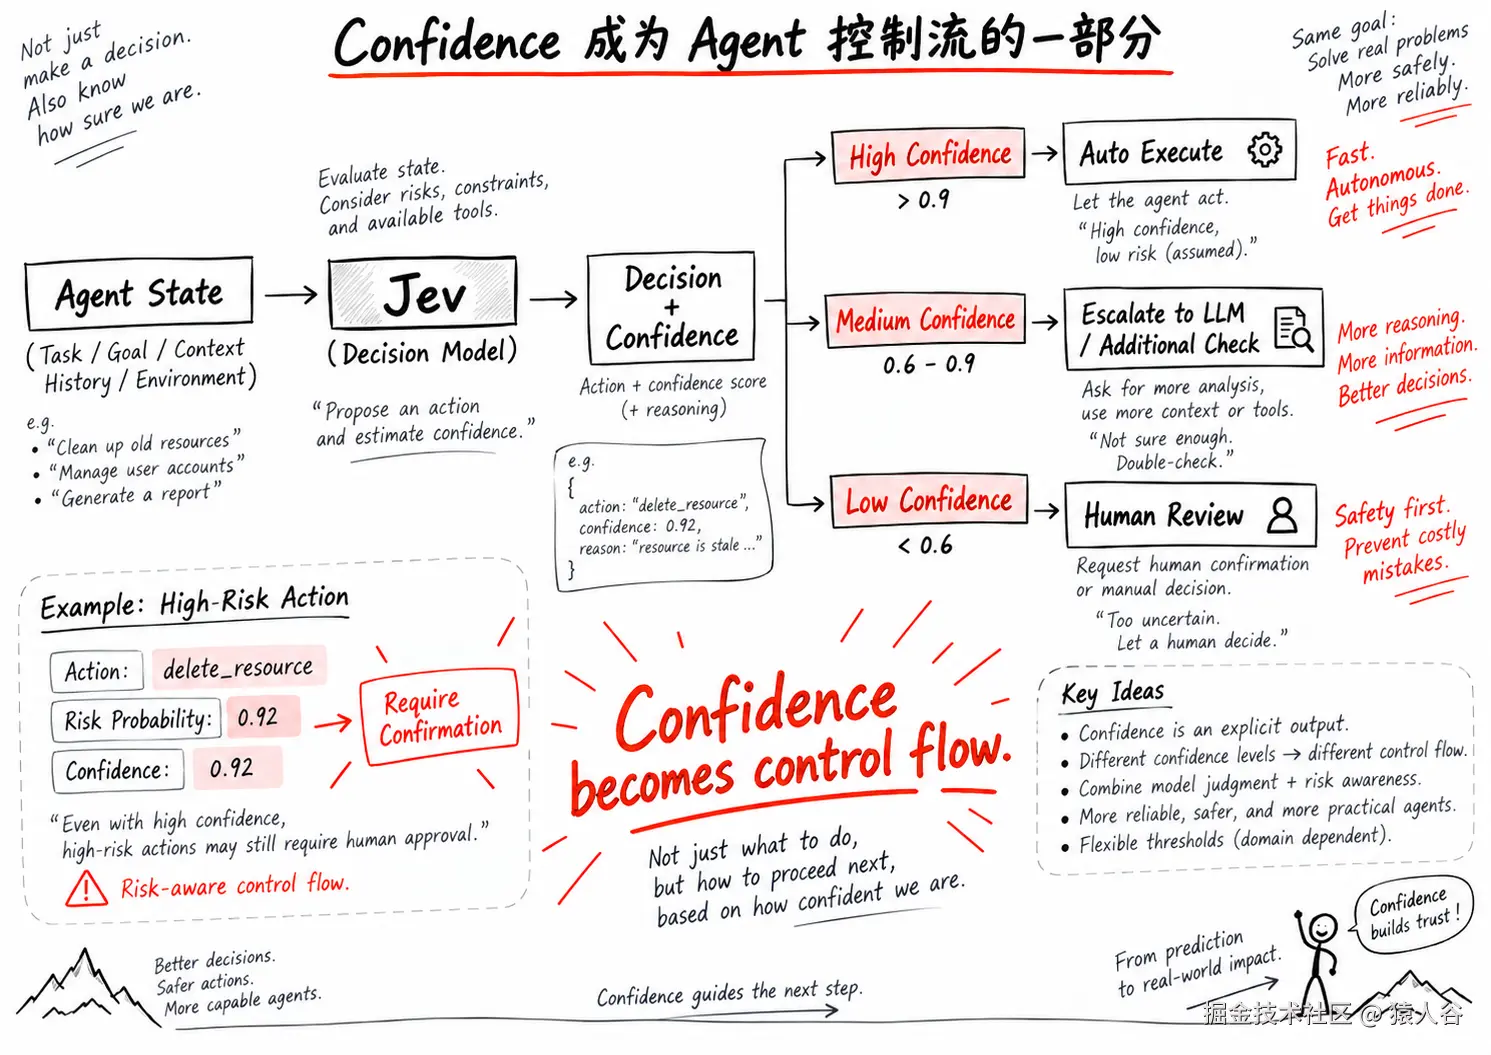
4. Jev 最适合放在哪里?
答案其实非常明确:
Agent Loop 中的 Decision Point
今天一个典型 Agent Loop 可能长这样:
text
LLM
 ↓
选择 Tool
 ↓
执行 Tool
 ↓
LLM
 ↓
判断 Tool Result
 ↓
LLM
 ↓
判断任务是否完成
 ↓
LLM
 ↓
决定下一步
仔细看就会发现:
这里真正需要语言生成能力的地方,其实并没有想象中那么多。
很多步骤本质上只是:
text
Which Tool?
Continue?
Retry?
Stop?
Safe?
Completed?
Which Agent?
这些都属于:
Decision Problem。
于是可以变成:
text
                   Agent State
                        │
               ┌────────┴────────┐
               │                 │
             Jev                LLM
               │                 │
           Decision          Generation
               │                 │
     ┌─────────┼─────────┐       │
     ↓         ↓         ↓       ↓
   Route      Risk     Select   Reasoning
   Tool       Check     Tool    / Response
LangChain 在 Jev 发布两天后就专门写了一篇:
Building a Harness with Jev
其中一个核心观点也是:
Agent Loop 中大量步骤其实是 decision,而不是 generation。
LangChain 随后提供了 TypeSafeClassifier 集成,使 Jev 可以直接作为 decision component 加入 Agent Workflow。
这件事情其实很有意思。
因为它意味着:
未来 Agent 架构里,LLM 不一定继续处于所有控制流的中心。
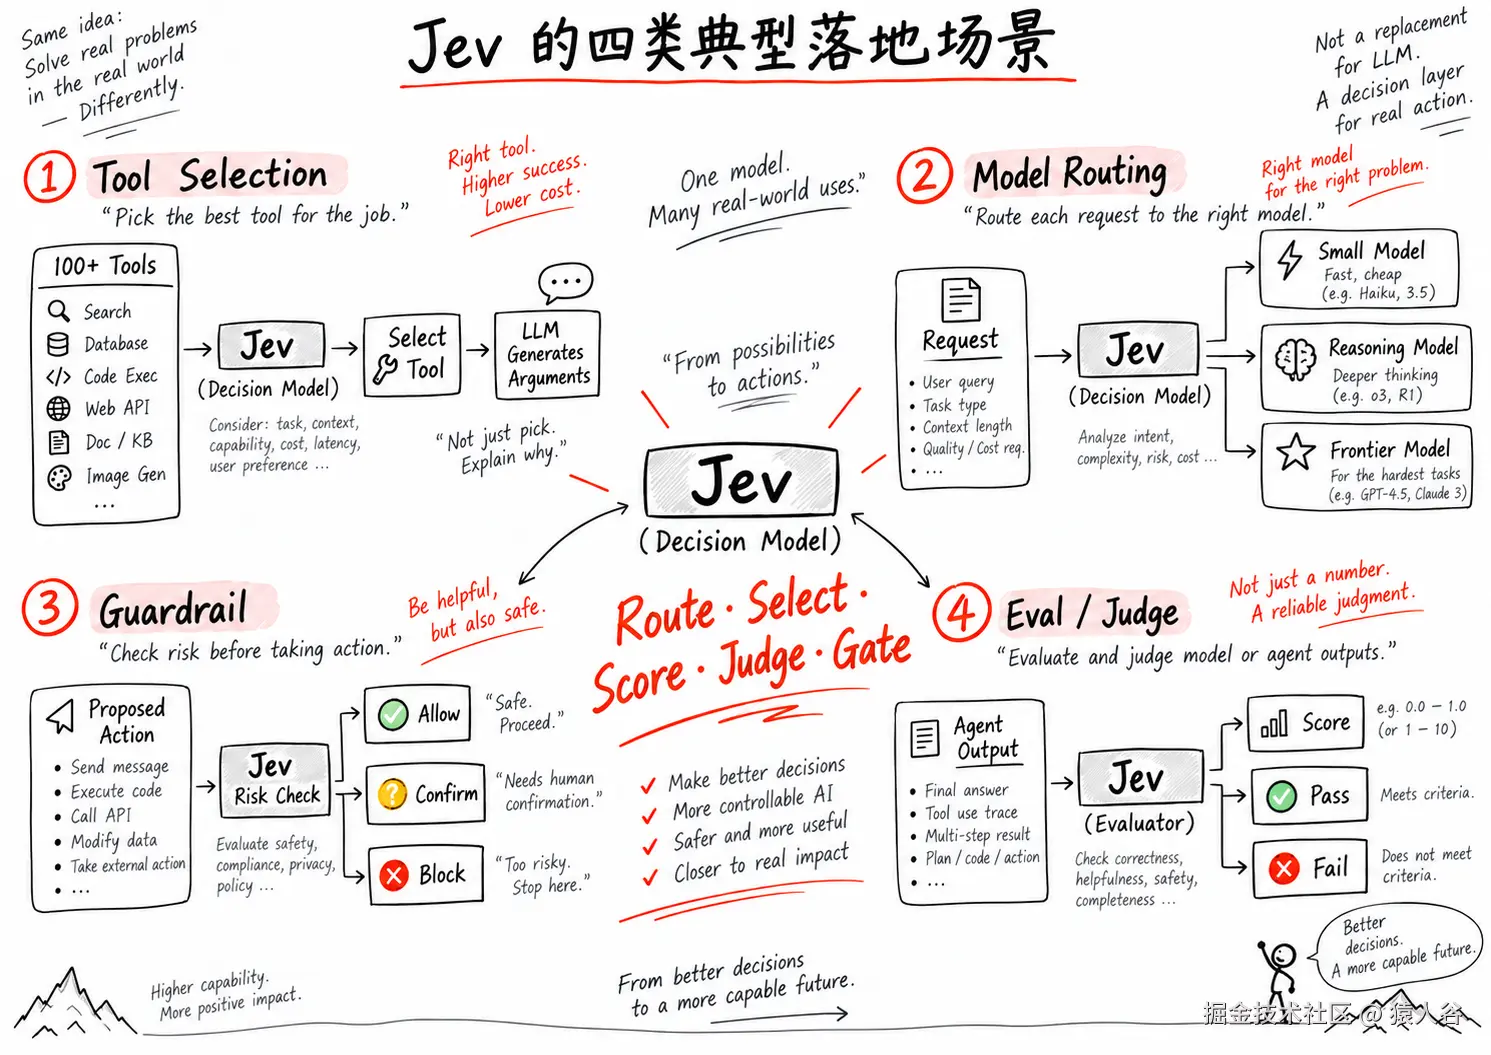
5. Jev 目前最有价值的实践之一:Tool Selection
这是我认为目前 Jev 最容易理解,也最现实的落地方向。
现在很多 Agent 都面临一个问题:
Tool 越来越多。
早期一个 Agent 可能只有:
text
Search
Calculator
Database
Email
四五个 Tool。
现在随着:
- MCP
- Skills
- Plugins
- Browser
- Database
- SaaS API
- Enterprise Tools
不断接入,一个 Agent 拥有几十甚至上百个 Tool 已经并不罕见。
传统方式通常是:
text
Prompt

Tool A schema
Tool B schema
Tool C schema
...
Tool Z schema

↓

LLM

↓

选择 Tool
+
生成 arguments
这会产生两个问题。
第一:
Tool 越多,Context 越大。
第二:
Tool Selection 和 Argument Generation 被绑在了一起。
实际上,这是两个不同的问题。
选择 Tool 是:
text
Classification / Routing生成参数则是:
text
Generation完全可以拆开:
text
100 Tools
   ↓
Jev
   ↓
选择 Tool #37
   ↓
只把 Tool #37 Schema
交给 LLM
   ↓
LLM 生成 Arguments
也就是:
Jev selects. LLM fills arguments. Code executes.
这会直接减少大量无意义的 Tool Schema Context。
目前已经有公开的 Jev Agent Tool Selection 实践在测试类似模式,包括在 100 个 mocked tools 环境中比较传统 LLM Tool Selection 和 Jev routing。
6. 第二个非常现实的场景:Model Routing
Jev 还有一个我认为非常适合生产环境的场景:
模型路由。
今天一个 AI 系统完全没有必要:
每个问题都调用最强、最贵的模型。
比如:
text
用户请求
   ↓
Jev 判断任务难度
   │
   ├── Simple
   │      ↓
   │   Fast Model
   │
   ├── Medium
   │      ↓
   │   Balanced Model
   │
   └── Complex
          ↓
       Frontier Model
这实际上是在做:
Semantic Model Routing。
相比传统规则:
python
if token_count > 1000:Jev 判断的是:
这个任务在语义上究竟复杂不复杂?
这意味着未来的 AI Gateway 很可能越来越像:
text
                 Request

                    ↓

             Decision Model

          ┌────────┼────────┐
          ↓        ↓        ↓
       Cheap     Medium   Frontier
       Model      Model     Model
这也是目前 Jev 社区里非常活跃的一类实践,包括针对 Claude Code、Codex 等 Coding Agent 的动态 Model Routing。
7. 第三个重要方向:Guardrail
Agent 越来越能操作真实世界之后,一个问题会越来越重要:
这个 Action 到底能不能执行?
例如 Coding Agent 准备运行:
bash
rm -rf ...或者:
text
DROP TABLE又或者 Agent 准备:
text
发送邮件
付款
修改生产环境
删除资源
提交代码
这时可以增加一个 Decision Layer:
text
Agent proposed action
        ↓
       Jev
        ↓
   Risk Evaluation
        ↓
 ┌──────┼───────┐
 ↓      ↓       ↓
Allow Confirm  Block
Vercel 在介绍 Jev 与 Agent Loop 的结合时,也特别强调:
真正的 Tool Execution 和 Permission 仍然应该由 Application Code 控制。
也就是说:
Jev 可以判断风险,
但最终:
text
权限
Policy
Execution
Validation
仍然应该属于 Harness。
这是一个非常重要的工程边界。
8. Jev-as-a-Judge:一个很值得关注的新方向
就在 Jev 发布几天之后,LangChain 又测试了一个非常有意思的方向:
Jev 作为 Agent Evaluator。
今天 Agent Evaluation 大致有两条路线。
第一种:
Code-based Eval
优点:
快、便宜、稳定。
缺点:
只能判断非常确定的东西。
第二种:
LLM-as-a-Judge
优点:
能够理解复杂语义。
缺点:
贵、慢,而且评分本身可能不稳定。
于是 Jev 恰好位于两者之间:
text
Code Eval
   │
   │ deterministic
   │
   ▼
────────────────────
        Jev
────────────────────
   ▲
   │ semantic
   │
LLM-as-Judge
LangChain 在 9 月 20 日发布的一组初步实验中,用 Jev 对 Agent 输出进行评价。
在这组特定测试中,Jev 的平均调用时间约为:
0.44 秒
而且在连续评分任务上,它的方差显著低于测试中的几个生成式 Judge Model。
需要强调的是:
这只是一个规模有限的早期实验,并不能直接证明 Jev 已经全面优于 LLM-as-a-Judge。
但它至少说明了一件事情:
Evaluation 本身,很可能就是 Decision Model 非常适合的一类任务。
9. Jev 生态为什么发展得这么快?
Jev 是 9 月 15 日才正式发布的。
但短短几天时间里,它周围已经迅速出现了一批生态。
LangChain 已经提供 Jev Integration。
Vercel AI Gateway 已经加入 Jev。
社区也很快出现:
- Jev MCP
- Coding Agent Router
- Tool-call Guard
- Agent Reviewer
- Context Compaction
- Claude Code / Codex Router
- n8n Node
- Home Assistant Integration
- Code Review
- Migration Guard
- Semantic Search
等等。
一个社区维护的 awesome-jev 项目在 Jev 发布后几天已经收录了大量相关项目和资料;这些项目成熟度差异很大,其中不少仍然只是实验或 PoC,因此不能把"项目数量"直接等同于生产采用率,但它至少说明:
开发者正在非常积极地寻找 Decision Model 的位置。
而观察这些项目,会发现一个非常明显的规律。
大家很少让 Jev:
text
写文章
写代码
聊天
总结长文
更多是在做:
text
Route
Select
Score
Rank
Judge
Check
Gate
Filter
换句话说:
Jev 目前真正找到 Product-Market Fit 的方向,并不是替代 LLM,而是进入 LLM 周围的控制平面。
10. 这让我想到 Harness
过去我们谈 Agent,注意力往往都集中在:
Model。
但最近一年越来越明显的一件事情是:
决定一个 Agent 能力上限的,已经不只是 Model。
而是:
Harness。
一个真正成熟的 Agent Runtime,需要管理:
text
Context
Memory
Tools
Skills
MCP
Permissions
State
Retry
Observability
Evaluation
Execution
如果从这个视角看 Jev,我认为它最准确的位置其实是:
Decision Plane
可以把未来 Agent Harness 粗略拆成三层。
text
                 Agent Harness

                     State

                       │

              ┌────────▼────────┐
              │                 │
              │ Decision Plane  │
              │       Jev       │
              │                 │
              └────────┬────────┘

                       │

          ┌────────────┴────────────┐
          │                         │
 ┌────────▼────────┐       ┌────────▼────────┐
 │ Reasoning Plane │       │ Execution Plane │
 │                 │       │                 │
 │      LLM        │       │ Tools / MCP     │
 │                 │       │ Code / Browser  │
 └─────────────────┘       └─────────────────┘
Decision Plane 负责:
text
Should?
Which?
How risky?
Continue?
Stop?
Route where?
Reasoning Plane 负责:
text
Why?
How?
Generate what?
Plan what?
Execution Plane 负责:
text
Do it.如果用一句更简单的话概括:
Jev decides. LLM reasons and generates. Harness executes and governs.
我认为这才是 Jev 真正有意思的地方。 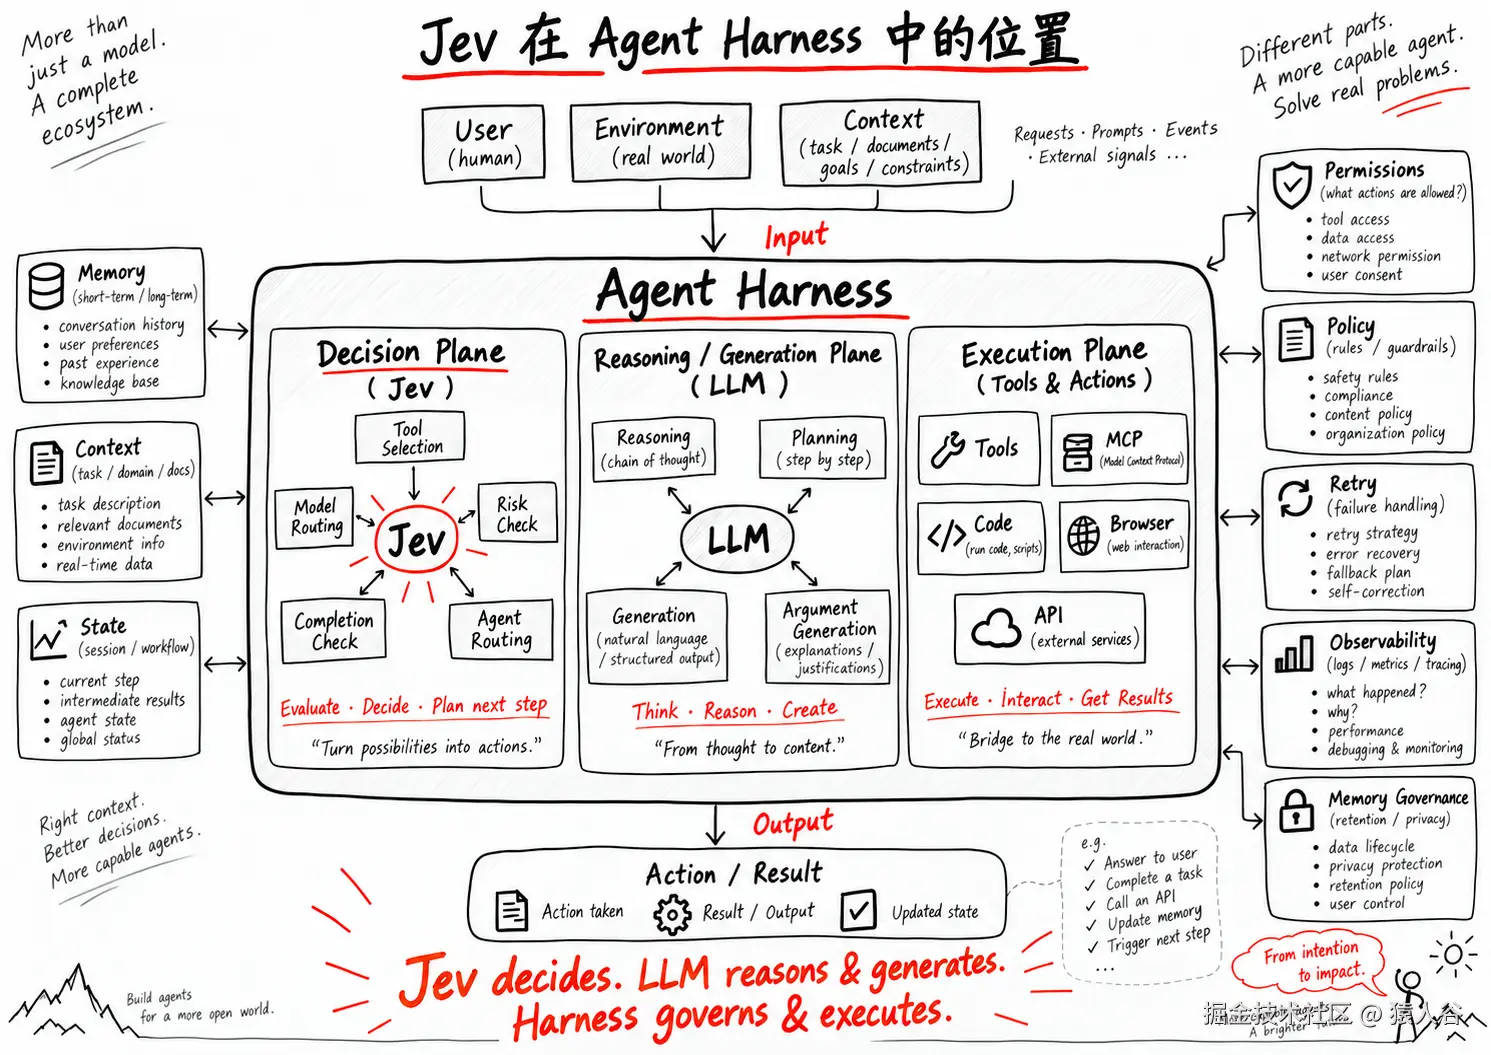
11. Jev 也并不是万能的
任何一个新技术刚出现时,都很容易出现过度解读。
Jev 同样如此。
它至少存在几个非常明显的边界。
首先:
它不是 LLM Replacement
Jev 不适合:
text
写文章
开放式问答
代码生成
复杂推理
长文本总结
自由对话
这些依然是 Generative Model 的优势领域。
第二:
Closed Decision Space 非常重要
Jev 最擅长的是:
text
从已知候选项里做判断而不是:
text
无限开放地创造答案也就是说,它的核心问题是:
Which one?
而不是:
Invent one.
第三:
Confidence 不能被盲目信任
哪怕一个模型声称做了 calibration,也不意味着:
text
confidence > 0.8就天然适合所有业务。
真正落地时仍然应该使用自己的 Production Data:
text
Offline Eval
     ↓
Threshold Calibration
     ↓
Shadow Traffic
     ↓
Production
尤其在:
金融、安全、生产系统变更等高风险场景中,更不能把模型概率直接等同于业务 Policy。
第四:
现在仍然非常早期
截至 2026 年 9 月 20 日,Jev 才正式发布大约五天。
当前看到的大量案例,本质上仍处在:
text
Demo
PoC
Experiment
Early Integration
阶段。
因此现在更合理的态度,并不是马上得出:
"Decision Model 会替代 LLM。"
而是观察:
哪些原本由 LLM 承担的任务,其实根本不需要生成能力?
这个问题可能比 Jev 这个具体产品本身更重要。
12. 我认为 Jev 真正值得关注的是一种新的 AI 分工方式
过去几年 AI Application 的架构很容易变成:
text
Everything
    ↓
   LLM
遇到任何问题,都去问 LLM。
而 Jev 所代表的方向,更像:
text
                     Task

                      │

          ┌───────────┼───────────┐
          │           │           │
       Decision    Reasoning    Execution
          │           │           │
         Jev         LLM         Code
不同类型的问题,由不同类型的计算系统解决。
这其实非常符合传统软件工程思想。
数据库负责存储。
消息队列负责异步通信。
搜索引擎负责检索。
规则引擎负责确定性 Policy。
LLM 负责开放式推理和生成。
Decision Model 负责模糊但结构化的判断。
而 Harness 负责:
把所有这些能力组织起来。
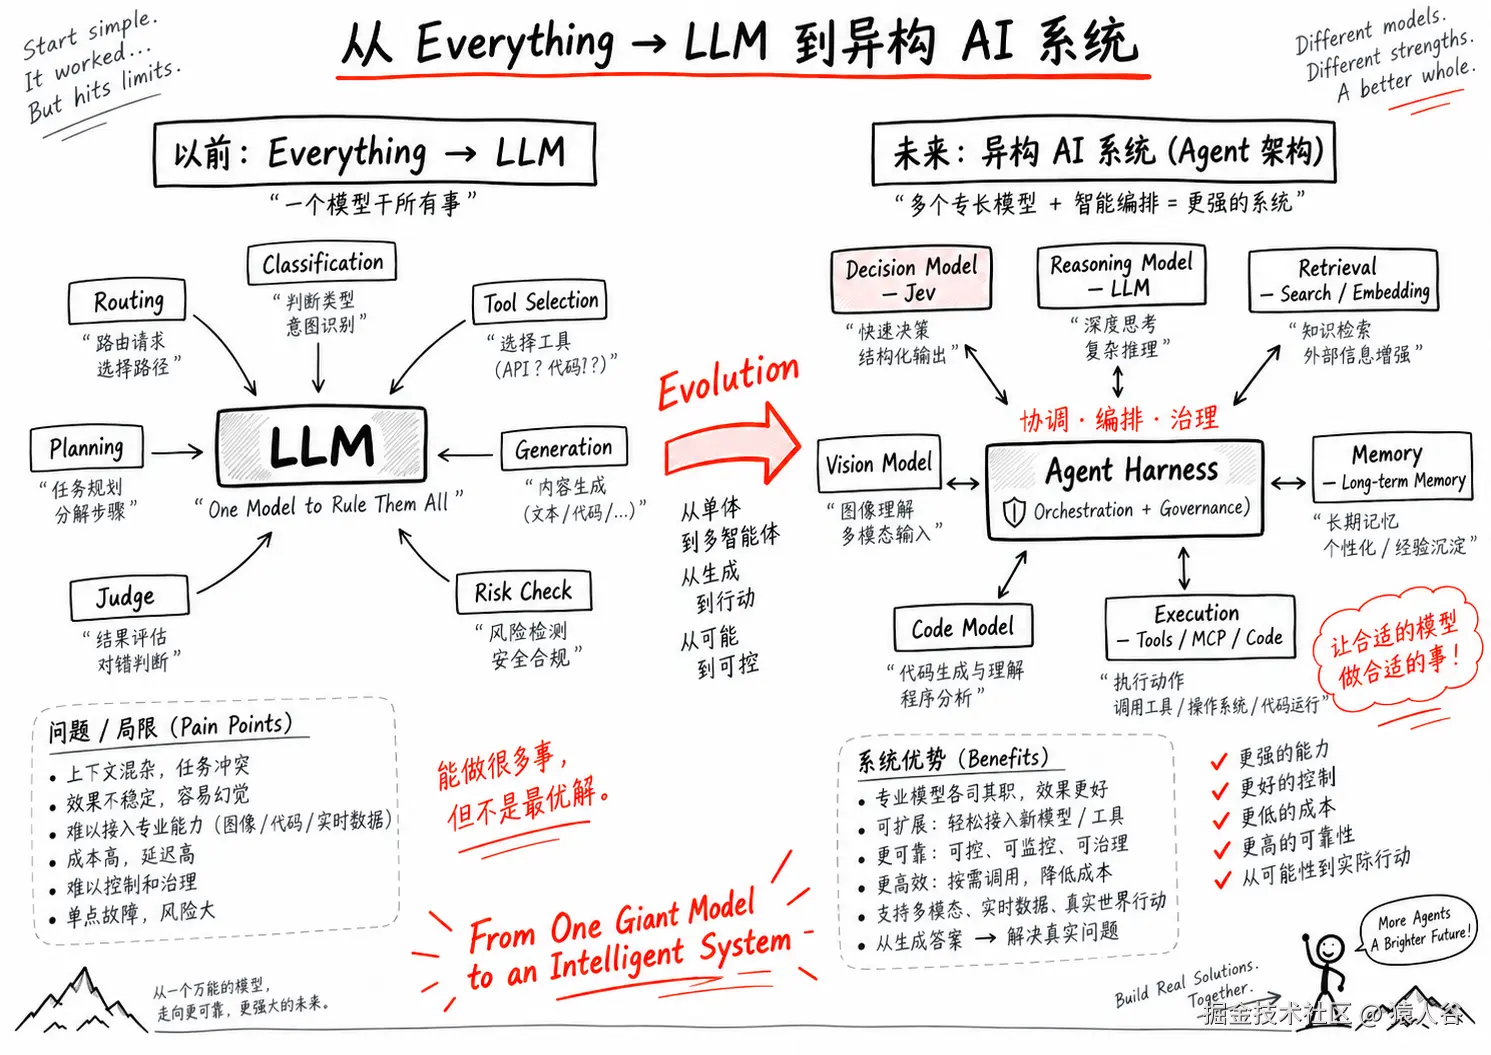
13. 从更长期来看,Agent 可能会越来越像一个"异构计算系统"
今天我们经常讨论:
哪个模型最强?
GPT?
Claude?
Gemini?
DeepSeek?
但未来更有价值的问题可能变成:
这个任务的哪一部分,应该交给哪个模型?
于是一个 Agent 可能同时运行:
text
Small Model
      ↓
Fast Classification

Decision Model
      ↓
Routing / Judge

Reasoning Model
      ↓
Complex Planning

Code Model
      ↓
Programming

Vision Model
      ↓
Visual Understanding

Embedding Model
      ↓
Retrieval
最终构成:
text
                Agent Harness

                     │

      ┌──────────────┼───────────────┐
      │              │               │

 Decision Model  Reasoning Model   Tools

      │              │               │
      └──────────────┼───────────────┘

                     │

                   Action
所以从这个角度看:
Jev 可能并不是一个新的"LLM 竞争者"。
它更像是在提醒我们:
LLM 不应该成为 AI 系统里的 CPU。
或者更准确一点:
并不是所有智能任务,都需要经过 Token Generation。
结语
我最近越来越明显地感受到一个趋势。
AI 工程正在从早期的:
Prompt Engineering
逐渐走向:
Context Engineering
然后进一步进入:
Harness Engineering。
而 Harness Engineering 的一个重要变化就是:
开始把"大模型"拆开来看。
生成是一种能力。
推理是一种能力。
检索是一种能力。
记忆是一种能力。
决策同样是一种能力。
Jev 的出现真正有意思的地方,不是:
"终于出现了一个比 LLM 更快的模型。"
而是它提出了另外一种可能:
我们过去可能让 LLM 做了太多它根本不需要做的事情。
如果这条路线最终成立,未来 Agent 的核心架构可能会逐渐从:
text
Everything → LLM演进成:
text
Decision → Decision Model

Reasoning → Reasoning Model

Generation → Generative Model

Execution → Code & Tools

Governance → Harness
到了那个阶段,我们衡量一个 AI 系统的方式,可能也不会再只是:
"你用了什么大模型?"
而是:
"你是如何组织这些不同类型智能的?"
这或许才是 Jev 给 Agent Engineering 带来的最大启发。
参考资料:
- TypeSafe AI:《Introducing System One Models & Jev》,2026-09-15
- LangChain:《Building a Harness with Jev》,2026-09-17
- LangChain:《Jev-as-a-Judge for Agent Evals》,2026-09-20
- Vercel:《Where does Jev fit in an AI agent loop?》,2026-09-18
- TypeSafe AI Jev Documentation / API / Cookbooks
- awesome-jev Community Ecosystem,访问于 2026-09-20