Jev 模型深度解读:不生成文字的 System One 决策模型
模型 :Jev 1.13(
jev-1.13.0)发布方 :TypeSafe AI
发布日期 :2026 年 9 月 15 日
状态 :Early Access,需申请或通过支持渠道访问
输入/输出 :文本或 JSON 状态 → Choice、Score、Noul 三类结构化概率判断
资料截止日期 :2026 年 9 月 20 日
重要说明:TypeSafe 尚未公开 Jev 的模型参数量、完整网络结构、训练数据组成或同行评审论文。本文将官方事实、厂商 benchmark 与作者分析分开标注。
一句话读懂
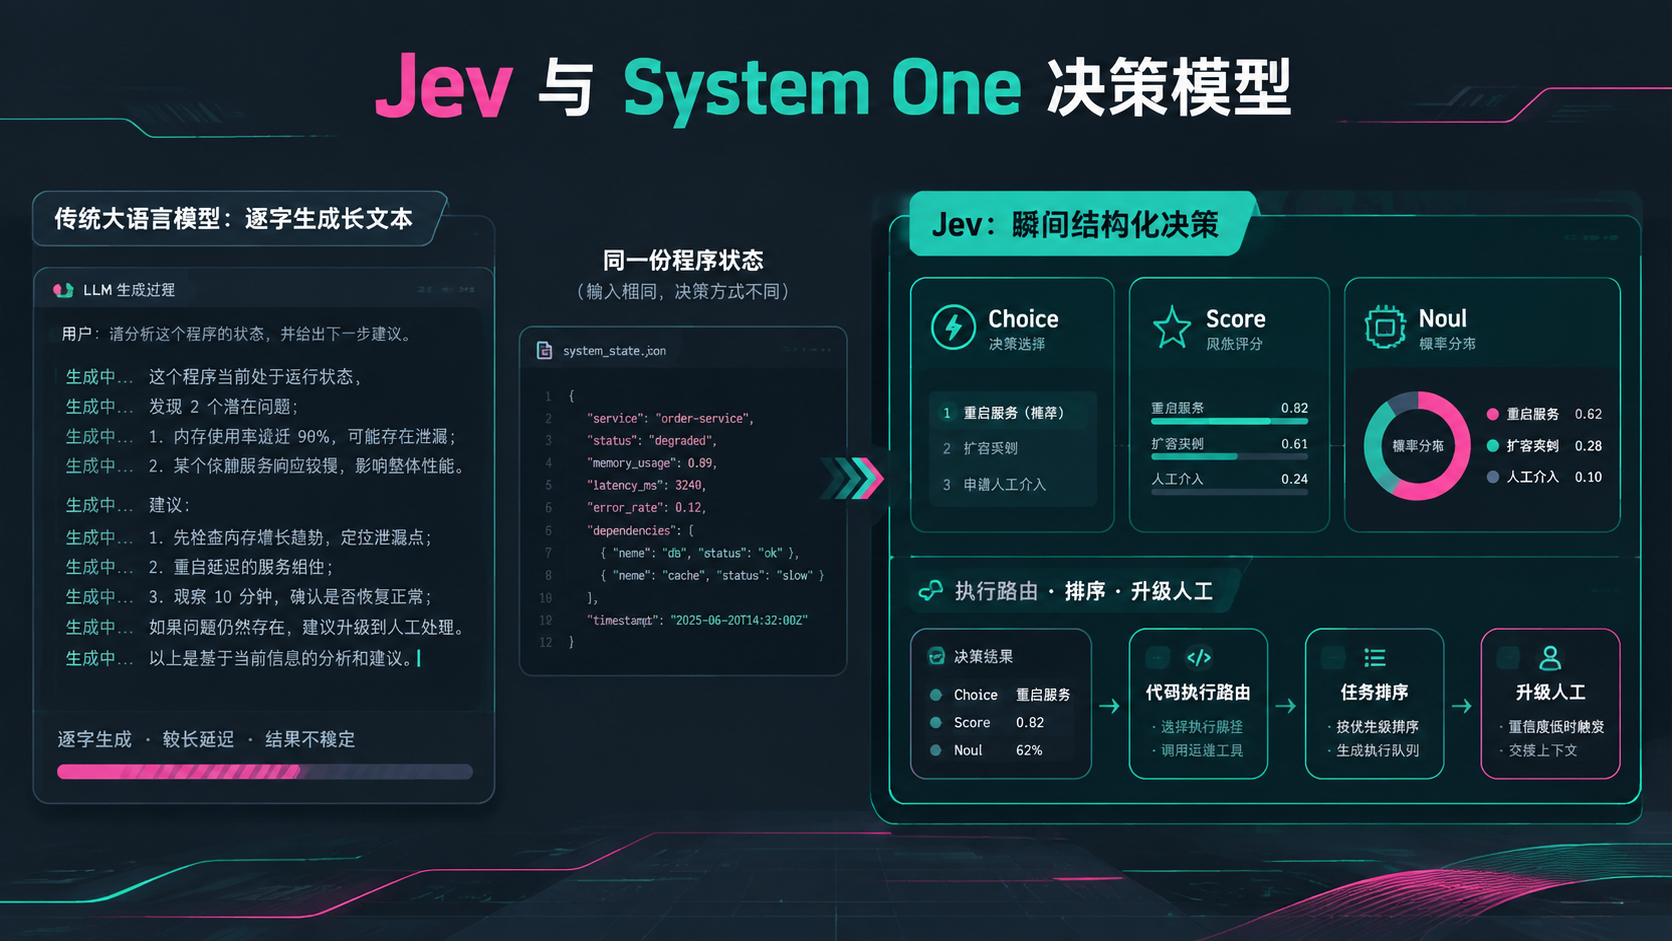
Jev 不是用来聊天或写文章的"小 LLM",而是一个放进程序决策点的低延迟概率判断器:它不生成任意文本,只在开发者预先定义的答案空间中选择、评分或判断真假。
1. Jev 到底是什么?
Jev 是 TypeSafe AI 发布的第一个 System One Model。它接收两部分输入:
state:程序当前知道的状态,可以是文本、JSON 对象或文本数组;questions:开发者预先定义的结构化问题。
它返回:
- 类型确定的答案;
- 每个候选项的概率;
- Choice 和 Score 的 confidence;
- 实际响应模型版本;
- Token 使用量。
一个最小请求如下:
json
{
  "model": "jev-latest",
  "state": "我的 Stripe 集成连续失败三天,正在损失订单,请尽快处理。",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "这条消息是否表达了紧迫性?"
    }
  }
}
返回的不是一段解释,而是:
json
{
  "model": "jev-1.13.0",
  "answers": {
    "is_urgent": {
      "type": "noul",
      "noul": 0.95
    }
  }
}
你的代码再决定:
python
if urgent_probability >= 0.9:
    page_on_call_engineer()
elif urgent_probability >= 0.6:
    queue_for_review()
else:
    normal_queue()
这就是 Jev 的核心思想:模型负责模糊语义判断,代码负责精确规则、权限和动作。
2. 为什么叫 System One?为什么叫 Jev?
TypeSafe 借用了 Daniel Kahneman《思考,快与慢》中的 System 1 / System 2 比喻:
- System 1:快速、直觉式判断;
- System 2:缓慢、需要多步思考。
这里是产品命名和设计隐喻,不代表 Jev 是人类认知系统的科学复刻。
System One Model 适合回答:
- 这张工单应该去哪个部门?
- 这条消息是否紧急?
- 这段话的攻击性处于什么级别?
- 哪个候选工具最适合当前状态?
- 这条引用是否支持原文结论?
它不适合直接完成:
- 写一篇报告;
- 生成代码;
- 复杂数学计算;
- 多步开放规划;
- 给出长篇解释。
"Jev"并不是三个单词的缩写。TypeSafe 表示,这个名称来自经济学家 William Stanley Jevons。团队借用了"杰文斯悖论"的直觉:当智能决策的单位成本大幅下降时,需求可能不降反升。
3. Jev 与传统 LLM 的根本区别
3.1 LLM:开放式生成
传统自回归 LLM 一次生成一个 Token。即使要求 JSON,模型本质上仍在生成字符串:
text
输入 → Token 1 → Token 2 → Token 3 → ...... → 文本/JSON它的优势是通用:
- 能写作;
- 能解释;
- 能生成代码;
- 能做多步推理;
- 能创造之前不存在的内容。
代价是:
- 输出长度带来延迟和费用;
- 需要解析和验证;
- 可能输出 schema 之外的字段;
- 自报"95% 确信"不一定经过概率校准;
- 一个回答可能混入无关解释、拒绝或错误工具参数。
3.2 Jev:闭集并行判断
Jev 不生成开放字符串,而是在预先声明的答案空间上返回概率分布。官方称多道问题会针对同一 state 相互独立、并行评估:
text
               ┌─ Choice:哪个部门?
state ─────────┼─ Score:有多沮丧?
               └─ Noul:是否紧急?
                         ↓
                  一次返回所有结果
因此它天然适合程序中的"模糊 if":
python
if model_says_this_is_probably_a_refund_request:
    ...
3.3 公开到了哪一层?
TypeSafe 官方披露了:
- 一套新的模型架构;
- 并行 sampler;
- Reinforcement Learning for Calibrated Decisions(RLCD);
- System One API 和三个原语;
- workflow eval 方法;
- Jev 1.13 的已知失败模式。
但截至本文日期,并未公开:
- 参数量;
- 网络层结构;
- 基础模型家族;
- 预训练语料规模与来源明细;
- RLCD 的完整损失函数和训练配方;
- 可下载权重;
- 可独立复现实验代码;
- 正式论文。
所以,"Jev 不是 LLM"是 TypeSafe 对模型类别和接口的定位;外部无法仅凭公开材料验证其底层是否完全不含语言模型式组件。可以确定的是,它的训练目标、采样方式和开发接口与聊天模型明显不同。
3.4 RLCD 与"概率校准"
TypeSafe 把后训练方法命名为 Reinforcement Learning for Calibrated Decisions(RLCD):
- RLHF 主要优化人类偏好的生成回答;
- RLVR 主要优化可程序验证的结果;
- RLCD 的目标是同时优化闭集决策和概率,使大量同类预测的概率与真实发生频率相符。
例如,对足够多的可比事件,如果模型给出 0.8 的样本最终约有 80% 成立,才可以称为在该分布上校准良好。这是群体统计性质,不能推出任意一个 0.8 判断一定有 80% 的"可靠保证"。
目前 TypeSafe 没有公开:
- RLCD 的奖励函数和损失公式;
- reliability diagram;
- ECE、Brier Score、NLL 等校准指标;
- 校准训练集和独立测试集;
- 第三方复现实验。
因此"Jev 经过概率校准训练"是官方产品声明;是否在你的真实流量、语言和类别分布上仍然校准,必须自己验证。
4. 三种核心原语:Choice、Score、Noul
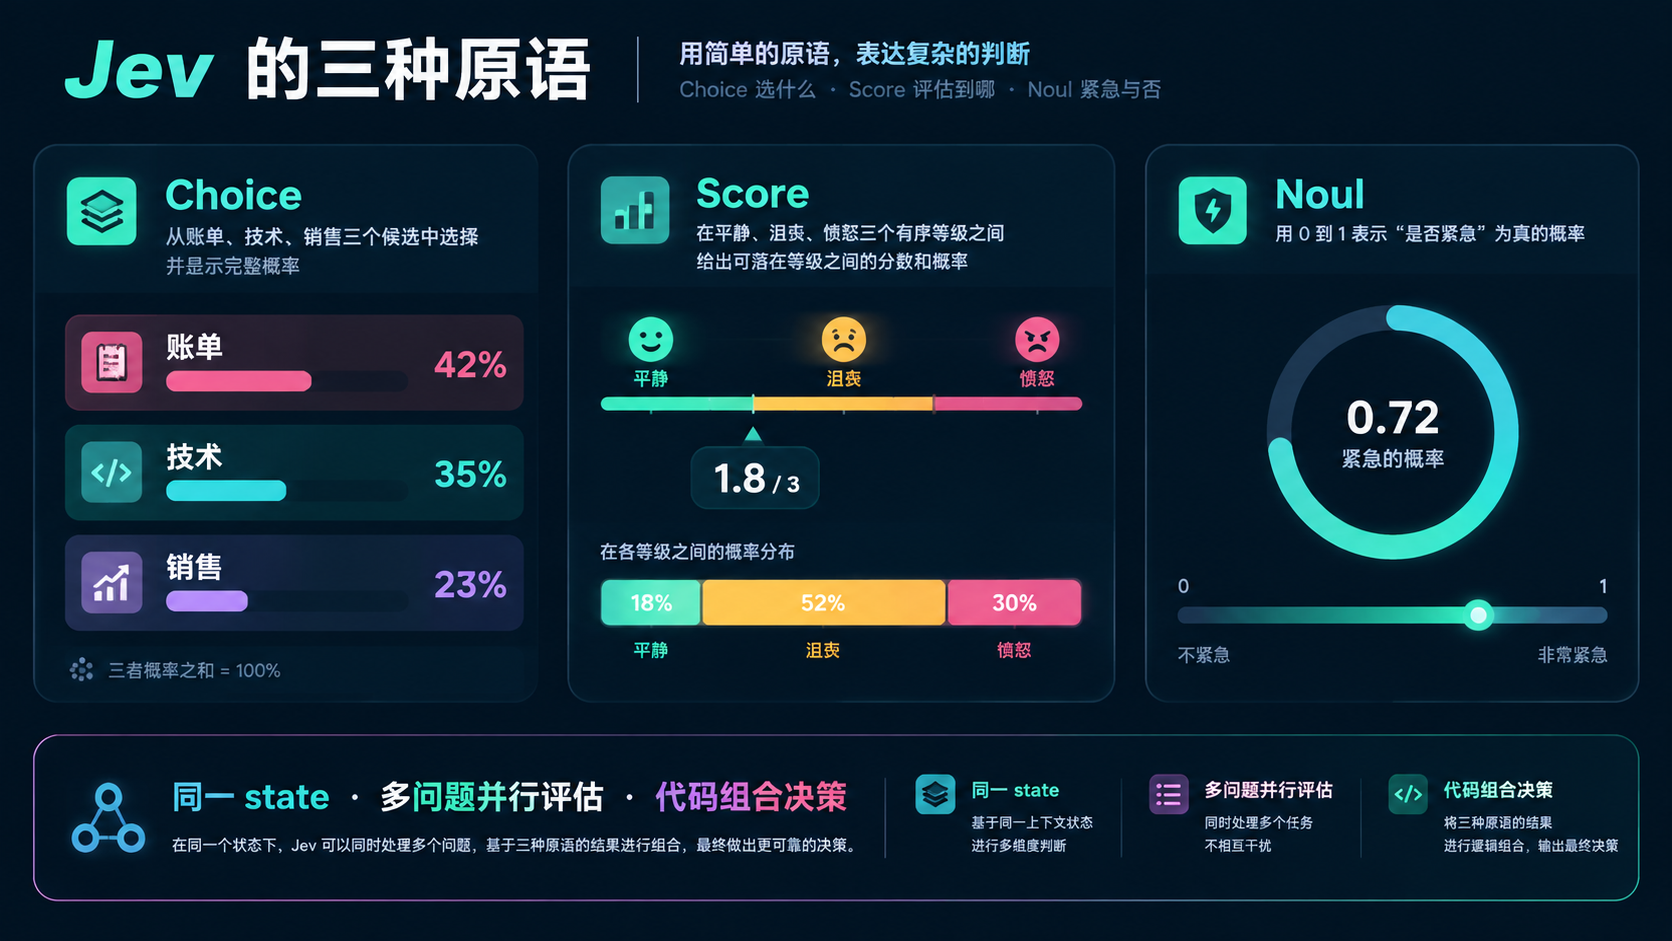
4.1 Choice:在固定候选中选一个
适合无顺序的分类:
json
{
  "type": "choice",
  "instructions": "哪个团队应该处理这张工单?",
  "criteria": {
    "billing": "扣款、发票和退款",
    "technical": "故障、宕机和集成",
    "sales": "价格、升级和新账户",
    "other": "以上均不适用"
  }
}
返回:
json
{
  "type": "choice",
  "choice": "technical",
  "probabilities": {
    "billing": 0.15,
    "technical": 0.85,
    "sales": 0.0,
    "other": 0.0
  },
  "confidence": 0.80
}
注意:
choice是最高概率候选;probabilities是完整分布;confidence描述分布有多集中;- Choice 最多支持 255 个候选;
- 若候选不一定完整,应主动加入
other或none。
4.2 Score:在有序等级上评分
适合严重程度、情绪、质量等有顺序概念:
json
{
  "type": "score",
  "instructions": "客户有多沮丧?",
  "criteria": [
    "平静,只是在陈述事实",
    "沮丧,但仍然礼貌",
    "非常愤怒,使用强烈措辞"
  ]
}
返回值可能是 1.05,因为它是各等级概率的加权结果,不一定是整数:
json
{
  "score": 1.05,
  "legend": {
    "0": "平静",
    "1": "沮丧",
    "2": "非常愤怒"
  },
  "probabilities": {
    "0": 0.0,
    "1": 0.95,
    "2": 0.05
  },
  "confidence": 0.92
}
Score 支持 2---10 个等级。它适合语义等级,不适合反推出精确数值。
4.3 Noul:判断"是否为真"
Noul 是 yes/no 概率:
json
{
  "type": "noul",
  "instructions": "客户是否明确要求退款?"
}
返回:
json
{
  "type": "noul",
  "noul": 0.72
}
0.72 表示模型对"是"的概率判断,不代表:
- 退款申请有 72% 可能被批准;
- 这位客户有 72% 退款资格;
- 结果一定正确。
Noul 不另带 confidence。靠近 0.5 通常表示判断更不明确,但生产阈值必须用自己的数据验证。
5. Confidence 不是正确率
Choice 和 Score 的 confidence 来自候选概率分布的形状:
- 概率集中在一个候选:confidence 高;
- 概率平均摊开:confidence 低。
它回答的是"模型在这些候选之间是否有清晰偏好",不是"这次回答正确的概率已经被保证"。
TypeSafe 文档建议将 confidence 用作第二个决策轴:
python
if answer.confidence < 0.5:
    route_to_human()
elif answer.choice == "read_only_action":
    execute()
elif answer.choice == "money_transfer" and answer.confidence > 0.9:
    ask_user_to_confirm()
else:
    route_to_human()
高风险动作即使 confidence 很高,也不能绕过:
- 身份认证;
- 权限检查;
- 业务硬规则;
- 用户确认;
- 审计;
- 幂等和回滚。
阈值不能直接复制官方示例。正确做法是使用自己的标注集回放,分别测量:
- 误放行;
- 误拦截;
- 人工队列占比;
- 各业务分组的表现;
- 模型升级前后的漂移。
6. 官方演示视频
6.1 并行输出与 LLM 逐字生成
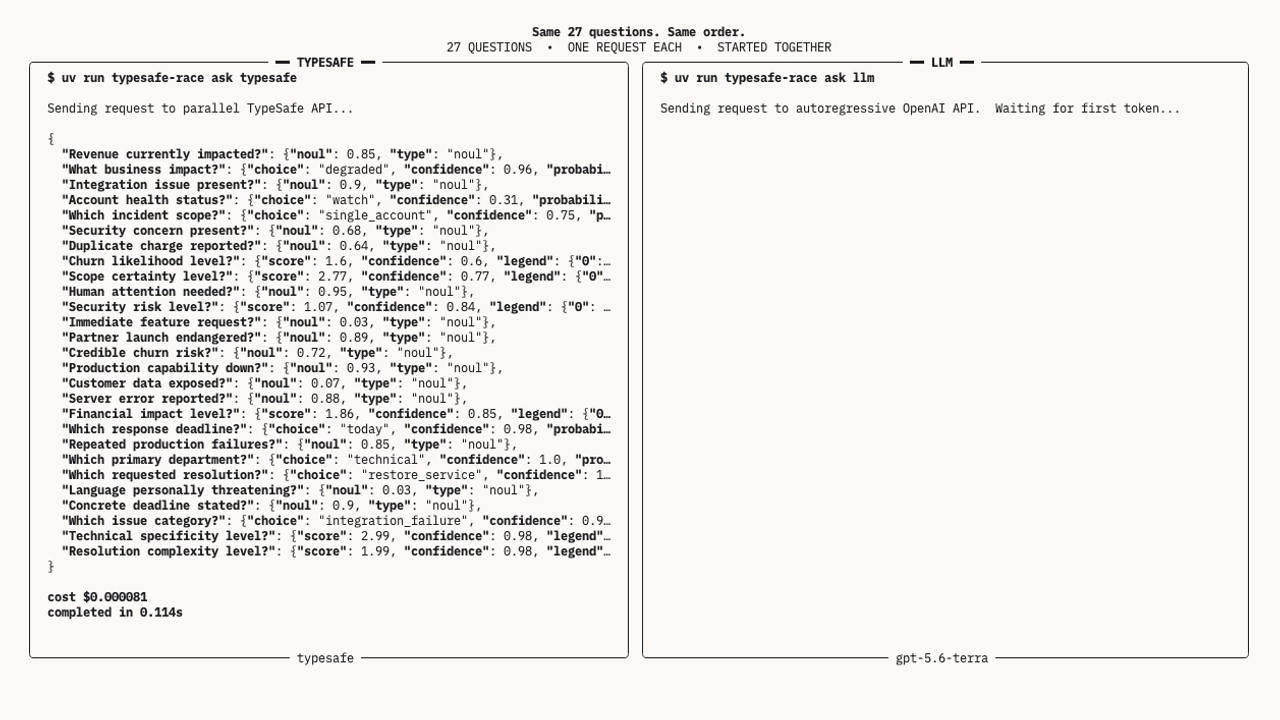
视频来源:TypeSafe AI 官方发布文章,Vimeo ID 1227496082。若 CSDN 编辑器移除 video 标签,可打开官方发布页观看。
官方 side-by-side 演示旨在说明:
- LLM 逐 Token 生成;
- Jev 一次输出多个概率判断;
- 已知答案空间时,不生成解释可以减少延迟和输出成本。
TypeSafe 主动披露了有利条件:
- 输入较短且信息密集;
- 问题 key 为了展示而写得易读;
- Jev 与对比模型只在一个模糊的流失等级上出现分歧;
- 对比使用 GPT-5.6 Terra 默认 reasoning;
- 这不是覆盖全部任务的独立 benchmark。
6.2 Doom:10 次/秒的闭环判断
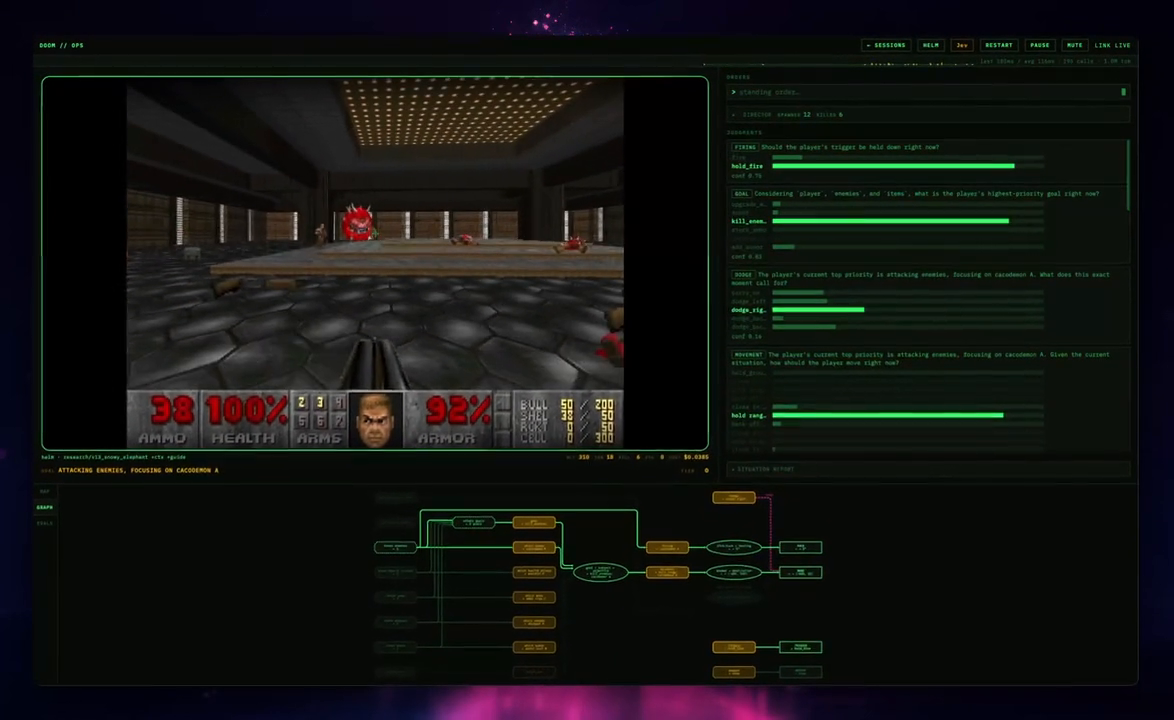
视频来源:TypeSafe AI 官方发布文章,Vimeo ID 1227495732。
这个 Demo 容易被误读为"Jev 看画面打游戏"。实际上官方明确说明:
- 输入是游戏引擎导出的结构化文本状态,不是截图;
- 约每秒调用 10 次;
- 官方估算成本约 7 美元/小时;
- 动作来自预定义集合;
- 传统非 AI Doom bot 可以玩得更好。
它证明的不是 Jev 比游戏 AI 强,而是低延迟、低单次成本的语义模型可以进入实时控制循环。
6.3 Wikiracing:高基数候选选择
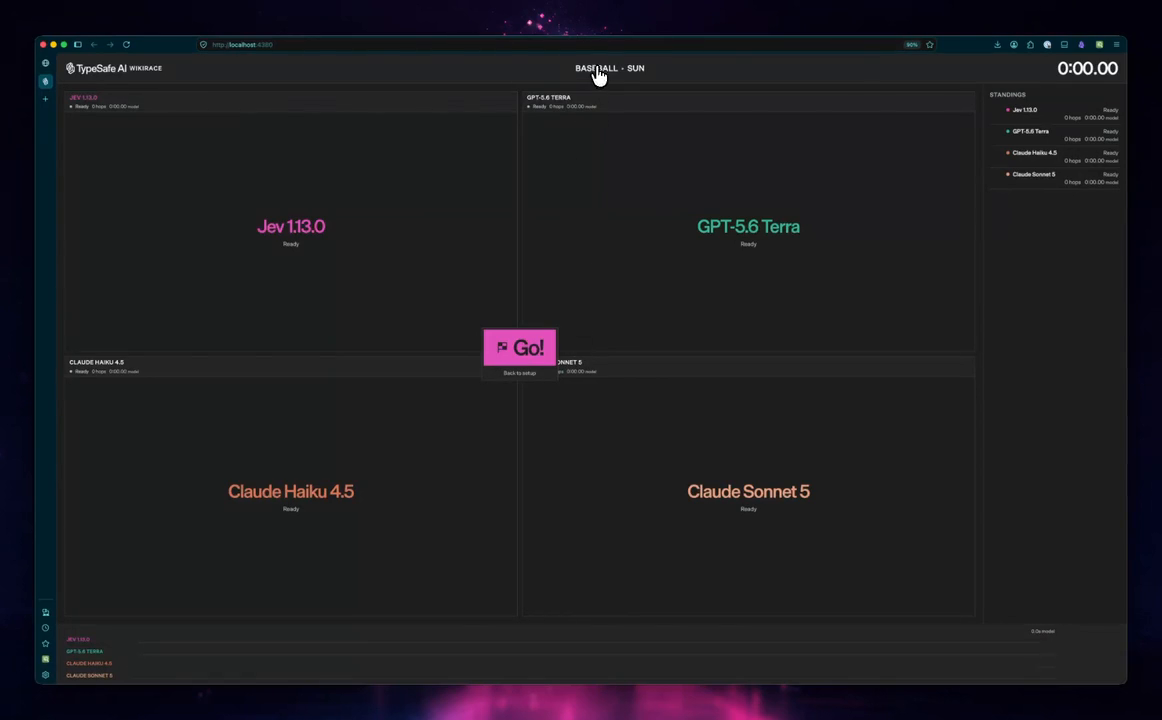
视频来源:TypeSafe AI 官方发布文章,Vimeo ID 1227495711。
Wikiracing 要求模型只沿当前页面真实存在的链接,从起始词条跳到目标词条。价值在于:
- 候选链接可能达到数百或数千;
- Choice 最大 255 项;
- 超过上限时,官方采用"两阶段:独立评分 → 明确选择";
- 模型不能生成一个不存在于候选列表中的链接。
"不能生成非法链接"是类型边界保证;选错真实链接仍然可能发生。
6.4 Browser Use:Jev 做浏览器动作路由
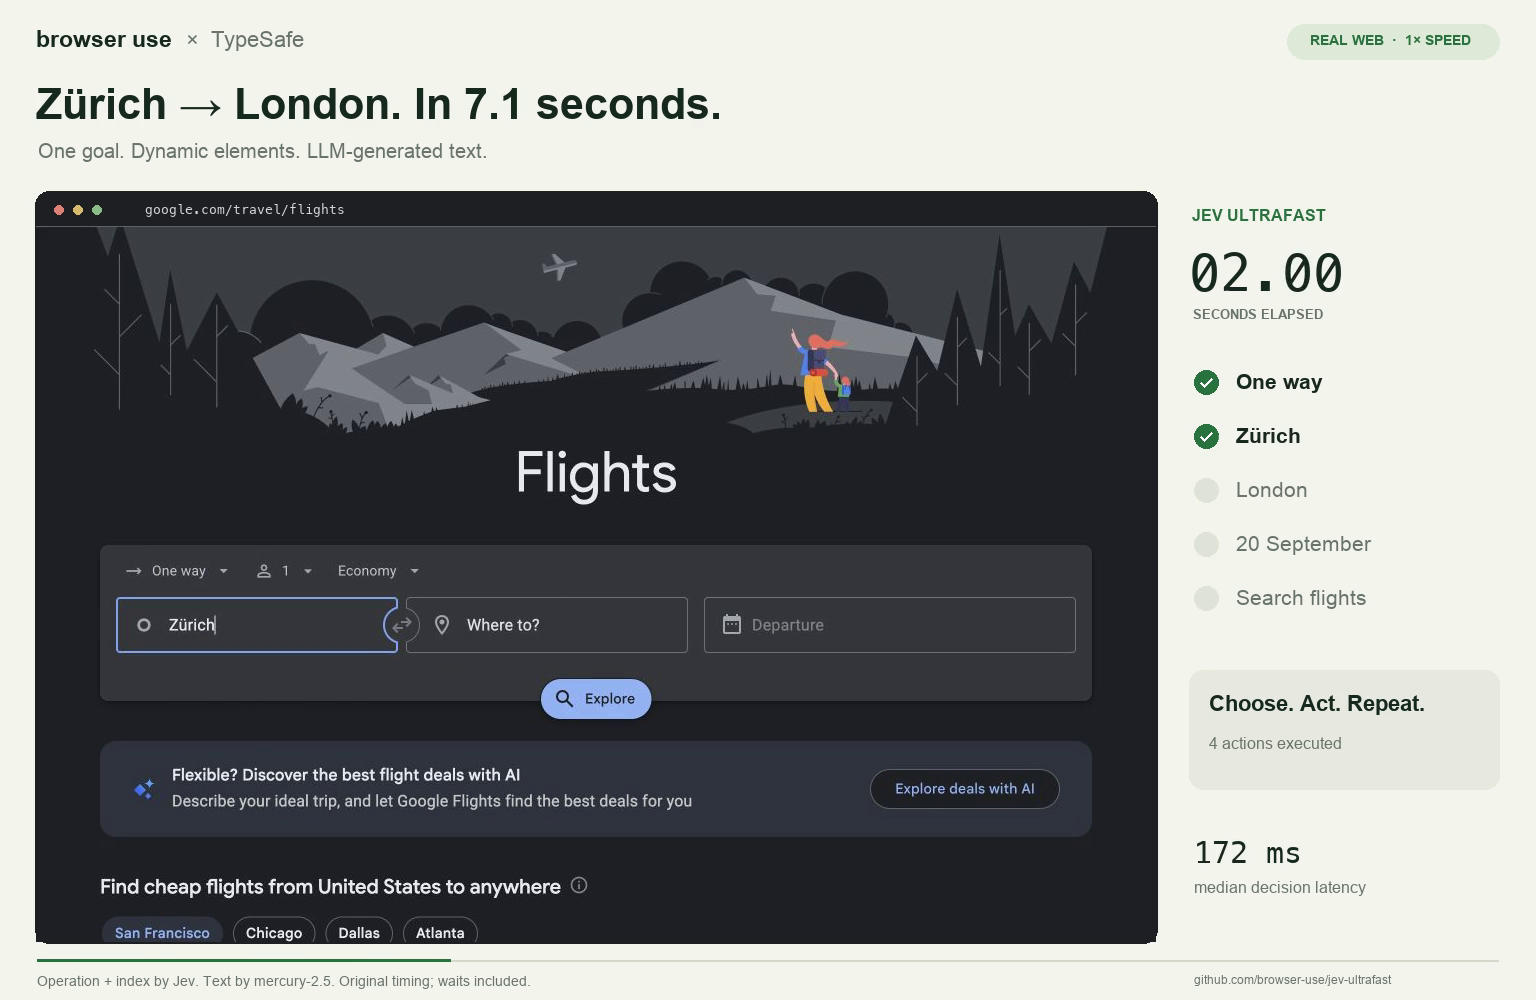
视频来源:Browser Use 的 MIT 开源仓库 browser-use/jev-ultrafast。视频含第三方网页界面,仅作为技术演示引用。
该示例让 Jev 处理:
- 页面可交互元素;
- 当前值;
- 目标;
- 历史动作;
- 下一步选择。
真正需要生成文本时,再调用轻量生成模型。执行器还会检查:
- 页面是否已变化;
- 元素是否被遮挡;
- 目标是否仍是同一个;
DONE后任务是否真的完成。
仓库报告单个 Google Flights 任务的 3 次测试中,中位时间从 9.450 秒降到约 7.092 秒。样本太小,不能推广为通用浏览器 Agent benchmark。
7. 官方 benchmark 怎么看?
7.1 Workflow Intelligence vs. Cost
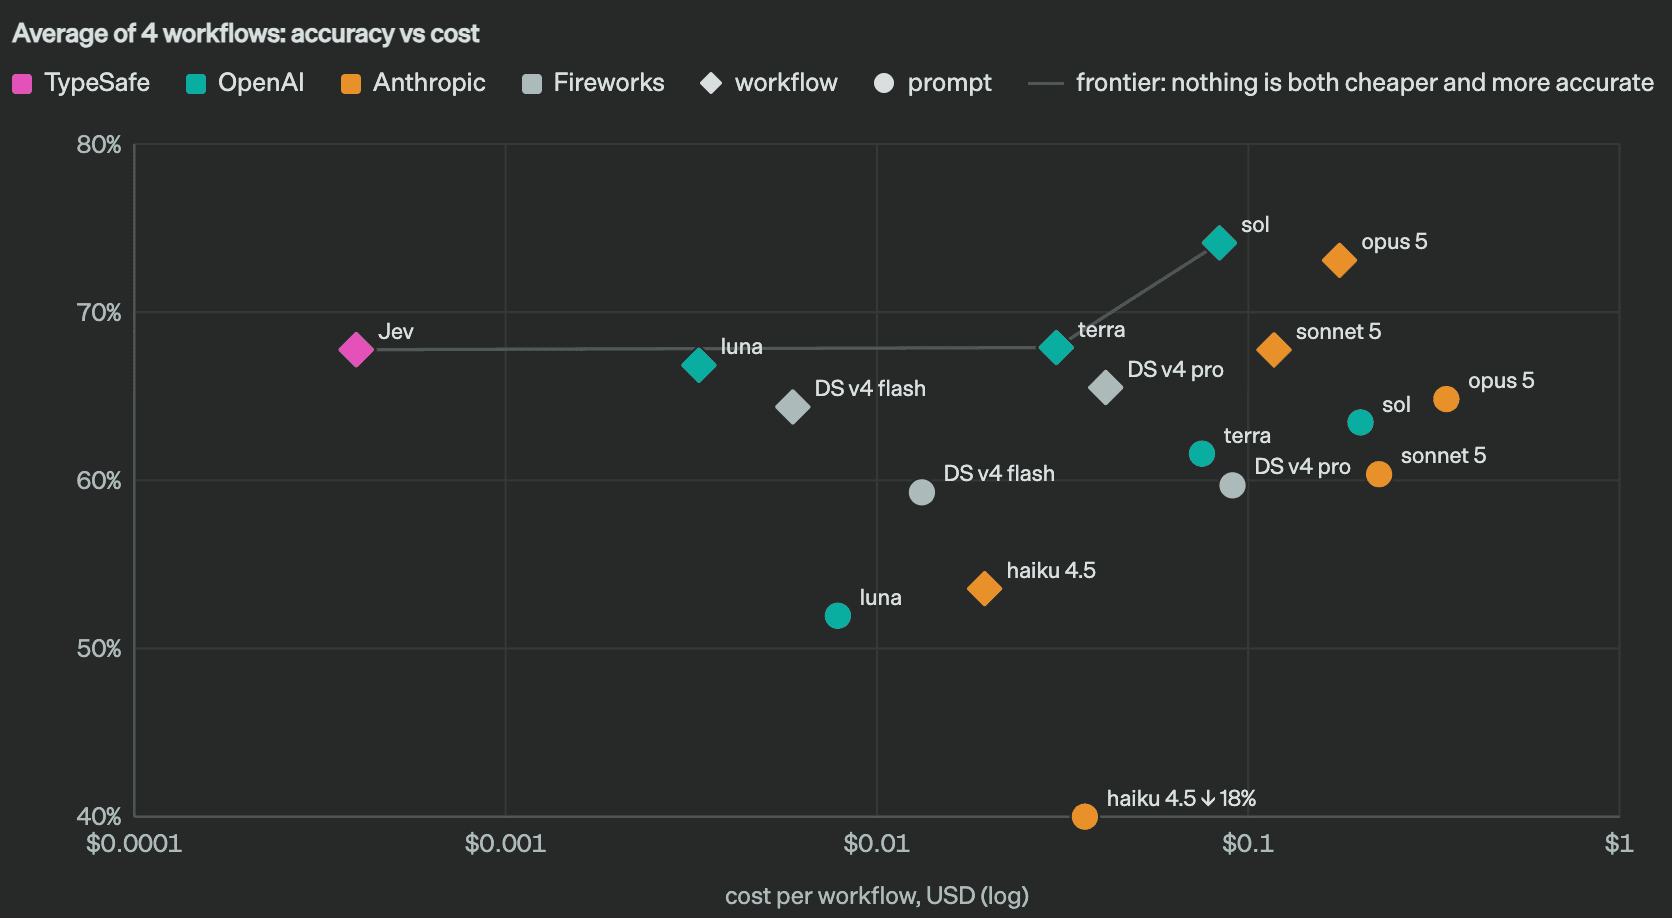
图源:TypeSafe AI 官方发布文章。横轴为单工作流成本(对数),纵轴为四个工作流相对参考模型的平均一致性。
TypeSafe 首页给出的代表性结论是:
- 193.6× faster;
- 444.6× cheaper。
官方也明确说,这两个数字位于真实收益的较高端。
其 workflow eval 方法不是传统分类 ground truth:
- 所有模型运行同一个代码工作流;
- 参考概率来自两个大型外部模型输出的平均;
- 比较模型与参考概率的一致性;
- 同时记录成本和延迟;
- LLM 使用 TypeSafe 的 System One wrapper 生成兼容结构。
局限包括:
- workflow 由 TypeSafe 模型能力团队制作;
- 参考答案不是人类标注事实;
- 使用 OpenAI 和 Anthropic 模型作为参考会引入家族偏差;
- wrapper 为获得概率和统一接口增加了成本、延迟;
- 任务形状天然适合多道闭集判断;
- 尚无第三方独立复现实验。
官方评测页 raw HTML 给出的四项 workflow 等权均值如下。这里的"与参考一致率"是和 GPT-6 Astra、Claude Fable 5.1 high thinking 平均预测的一致程度,不是带人工真值的准确率:
| 模型 | 与参考一致率 | 每 case 成本 | 每 case 时间 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1s |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3s |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9s |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8s |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1s |
| Claude Haiku 4.5 | 53.6% | $0.0195 | 12.5s |
| DeepSeek V4 Flash | 64.4% | $0.0059 | 51.9s |
| DeepSeek V4 Pro | 65.5% | $0.0413 | 86.5s |
Jev 的分任务结果是:
- Security Incidents:61.7%,$0.0001,0.3s;
- Agent Trace Observability:71.6%,$0.0003,0.5s;
- Invoice Processing:61.8%,$0.0011,0.5s;
- Customer Service:76.0%,$0.0001,0.4s。
这组数据说明 Jev 在厂商评测中的优势主要是成本和延迟,并非最高一致率。GPT-5.6 Sol 的 74.1% 比 Jev 高 6.3 个百分点,但成本和时间更高。由于没有人工 ground truth、置信区间和显著性检验,不能把小数点后一位理解成精确排名。
因此正确表述应是:
在 TypeSafe 自建的四个 System One-shaped workflow eval 上,Jev 位于厂商给出的成本---一致性 Pareto 前沿;这不能证明它在所有分类、推理或生成任务上优于 LLM。
7.2 Schema 与工具调用错误图
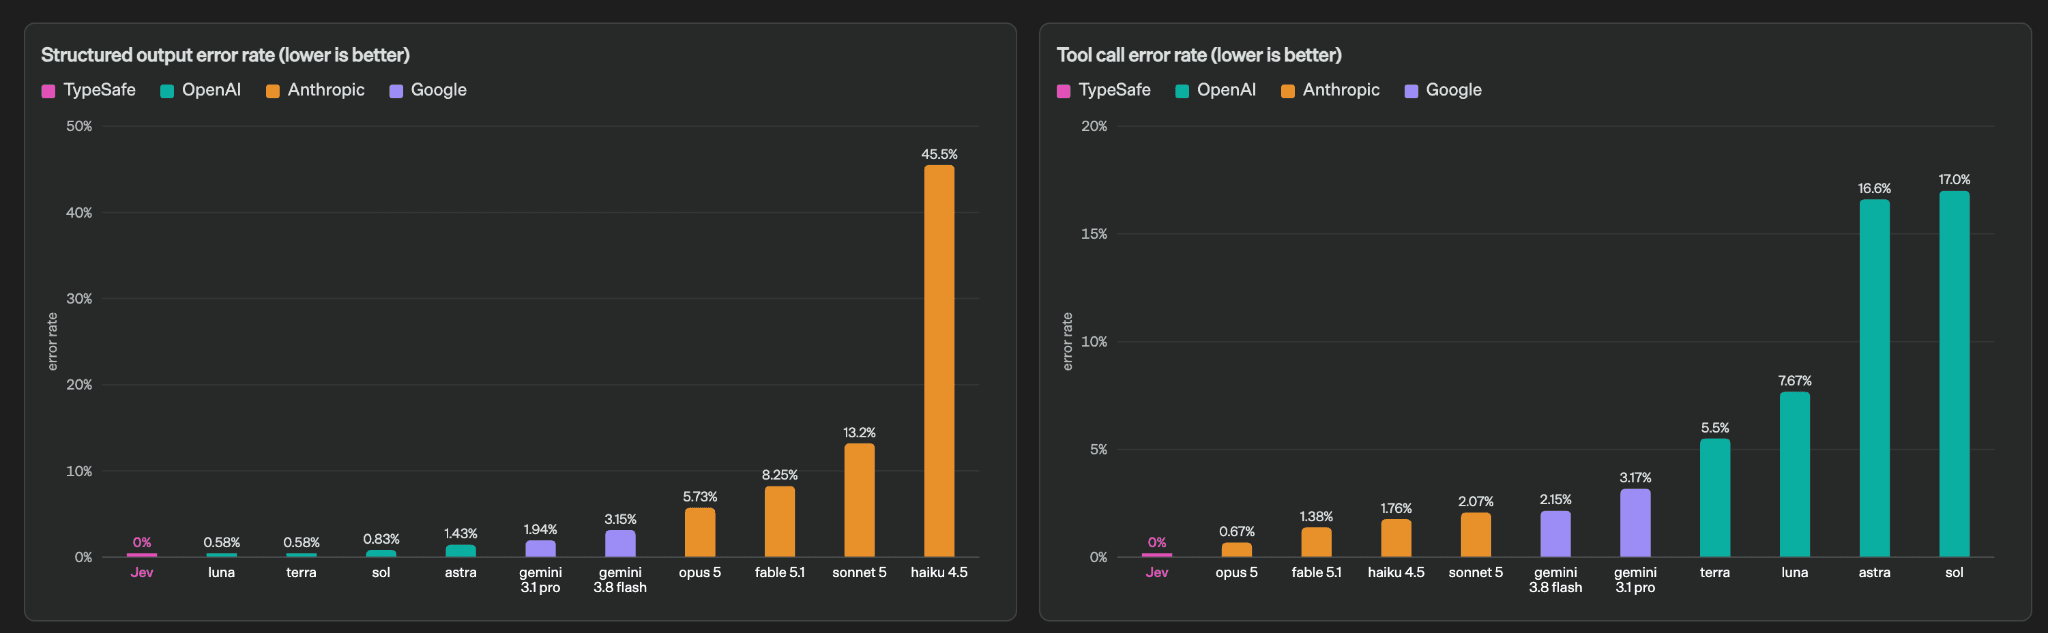
图源:TypeSafe AI 官方发布文章。TypeSafe 的 0% 是结构约束推导值,不是随机抽样得到的语义正确率。
Jev 的答案只能落在开发者声明的类型中,因此:
- Choice 不会返回候选外的字符串;
- Score 不会返回 schema 外的等级;
- Noul 只返回 0---1;
- 返回体不需要从自然语言中恢复字段。
这能保证类型正确,不能保证:
- 分类语义正确;
- 输入没有提示注入;
- 概率适合你的业务分布;
- criteria 本身写对了;
- 自动动作安全。
"Zero hallucinations"如果理解为"永远不会判断错误"就是错误的。更准确的说法是:
Jev 结构上不会生成答案空间之外的值,但仍可能在合法候选中选错。
8. 价格、延迟和上下文
截至 2026 年 9 月 20 日,官方 Models 页面列出:
| 项目 | Jev 1.13 |
|---|---|
| 版本 ID | jev-1.13.0 |
| 稳定别名 | jev-latest |
| 预览别名 | jev-preview,当前同样指向 1.13.0 |
| 输入价格 | 0.042 美元 / 百万 Token |
| 输出价格 | 当前免费 |
| 总上下文 | 每请求 64K Token |
| 额外限制 | state + 最长单个问题不超过 32K |
| Choice 上限 | 255 个候选 |
| Score 上限 | 2---10 个等级 |
| 默认限流 | 250,000 输入 Token/秒,1,200 请求/分钟 |
| 输入模态 | 仅文本;字符串、JSON 或文本数组 |
| 主要语言 | 英文;其他语言可用但官方称效果不等同 |
一个简单成本估算:
text
每次请求输入 1,000 Token
单次输入成本 = 1,000 / 1,000,000 × $0.042
             = $0.000042

100 万次请求输入成本约为 $42
这不包括:
- 网络和应用基础设施;
- 日志、存储和监控;
- 人工审核;
- LLM fallback;
- 供应商企业合同;
- 跨区域网络时延。
TypeSafe 声称端到端延迟通常为 70---500ms。官方评测从美国西海岸笔记本连接当前服务区域,其他地区需要实测。
限流处于动态调整期。生产系统不能把早期访问额度当作永久 SLA。
9. 快速上手
9.1 申请访问并配置密钥
Jev 仍是 early access:
- 在 TypeSafe 官网加入 waitlist;
- 获得访问后进入 console 创建 API Key;
- 只在服务端保存密钥;
- 设置环境变量:
powershell
$env:TYPESAFE_API_KEY = "your-key"不要把密钥写进前端、Git 或博客示例。
9.2 cURL:一次询问三件事
bash
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "My payouts have failed for 3 days. I am losing sales. Help ASAP.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and outages",
          "sales": "Pricing and new accounts",
          "other": "None of the above"
        }
      },
      "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["Calm", "Frustrated", "Very angry"]
      },
      "urgent": {
        "type": "noul",
        "instructions": "Does this need urgent attention?"
      }
    }
  }'
9.3 Python 官方 SDK
要求 Python 3.10+:
bash
pip install typesafe-sdk
python
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

with TypeSafeClient(model="jev-1.13.0") as client:
    response = client.system_one(
        state={"ticket": "I was charged twice. Please fix this today."},
        questions={
            "department": Choice(
                instructions="Which team should handle `ticket`?",
                criteria={
                    "billing": "Charges, invoices, and refunds",
                    "technical": "Bugs, outages, and integrations",
                    "other": "None of the above",
                },
            ),
            "severity": Score(
                instructions="How severe is `ticket`?",
                criteria=["Routine", "Degraded", "Blocking"],
            ),
            "refund": Noul(
                instructions="Does `ticket` request a refund?"
            ),
        },
    )

print(response.choices["department"].choice)
print(response.scores["severity"].score)
print(response.nouls["refund"].noul)
9.4 TypeScript 官方 SDK
要求 Node.js 20+:
bash
npm install @typesafe-ai/sdk
typescript
import { choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient({ model: "jev-1.13.0" });
const result = await client.systemOne({
  state: { ticket: "I cannot log in after changing my password." },
  questions: {
    department: choice("Which team should handle `ticket`?", {
      account: "Login, password, and account security",
      billing: "Charges and refunds",
      technical: "Product bugs",
    }),
    urgent: noul("Does `ticket` need immediate attention?"),
  },
});

console.log(result.answers.department);
console.log(result.answers.urgent);
9.5 本文附带的最小示例
文章包中包含:
text
jev-example/
├── README.md
└── classify_ticket.py
它只使用 Python 标准库,并支持无密钥检查请求:
powershell
cd jev-example
python classify_ticket.py --dry-run
获得 API Key 后:
powershell
$env:TYPESAFE_API_KEY = "your-key"
python classify_ticket.py "My integration has failed for three days. Help ASAP."
示例固定使用 jev-1.13.0,并对 429/529 做指数退避。
10. 同一个客服案例:四种方案怎么选?
输入:
text
My card was charged twice. I need the duplicate refunded today.目标:
- 路由到部门;
- 识别是否紧急;
- 判断是否提出退款意图;
- 决定是否自动退款。
10.1 规则引擎
python
department = "billing" if "charged" in text else "other"
urgent = any(word in text for word in ["today", "ASAP", "urgent"])
refund_requested = "refund" in text
优点:
- 快;
- 便宜;
- 可解释;
- 结果确定。
缺点:
- "钱被扣了两次,希望尽快处理"没有
refund仍可能表达退款意图; - 同义词和否定容易漏掉;
- 规则随语言变化快速膨胀。
但"是否符合退款政策""退款金额""账户权限"仍应交给规则,而不是模型。
10.2 普通分类器
如果标签长期稳定、拥有大量标注数据,训练一个本地分类器通常更合适:
- 单次成本更低;
- 可离线部署;
- 延迟更可控;
- 数据不离开内网。
代价是新增标签、修改定义、跨领域迁移需要重新训练和部署。
10.3 LLM Structured Output
json
{
  "department": "billing",
  "urgent": true,
  "refund_requested": true,
  "explanation": "The customer reports a duplicate charge..."
}
适合:
- 需要解释;
- 需要抽取开放字段;
- 需要复杂政策推理;
- 需要生成回复。
但如果只要三个闭集判断,让生成模型写解释可能浪费延迟和输出 Token。
10.4 Jev
json
{
  "department": {
    "choice": "billing",
    "probabilities": {
      "billing": 0.97,
      "technical": 0.02,
      "other": 0.01
    },
    "confidence": 0.96
  },
  "urgent": {
    "noul": 0.91
  },
  "refund_requested": {
    "noul": 0.99
  }
}这段结果是输出形态示例,不是本文独立调用得到的固定数字。
最终代码仍应这样做:
python
if not authenticated or not policy_allows_refund(order):
    deny_or_review()
elif jev_refund_probability < 0.8:
    ask_customer_to_clarify()
else:
    confirm_with_customer_before_refund()
10.5 对比总结
| 方案 | 最适合 | 优势 | 主要短板 |
|---|---|---|---|
| 规则/代码 | 金额、日期、权限、明确关键词 | 最快、最稳、可证明 | 难覆盖模糊语义 |
| 传统分类器 | 固定标签、大数据量、可训练 | 可本地化、规模成本低 | 需要标注和训练 |
| Jev | 答案空间已知的分类、评分、路由 | 概率、类型固定、低延迟 | 不能生成,复杂推理弱 |
| 轻量 LLM | 短生成、抽取、简单解释 | 灵活,生态成熟 | 概率与 schema 需验证 |
| 前沿 LLM | 开放生成、复杂推理、规划 | 能力最通用 | 延迟和费用高 |
| 人工 | 高风险、低置信度、例外 | 可承担责任和补充背景 | 慢且成本高 |
11. 推荐架构:规则 + Jev + LLM + 人
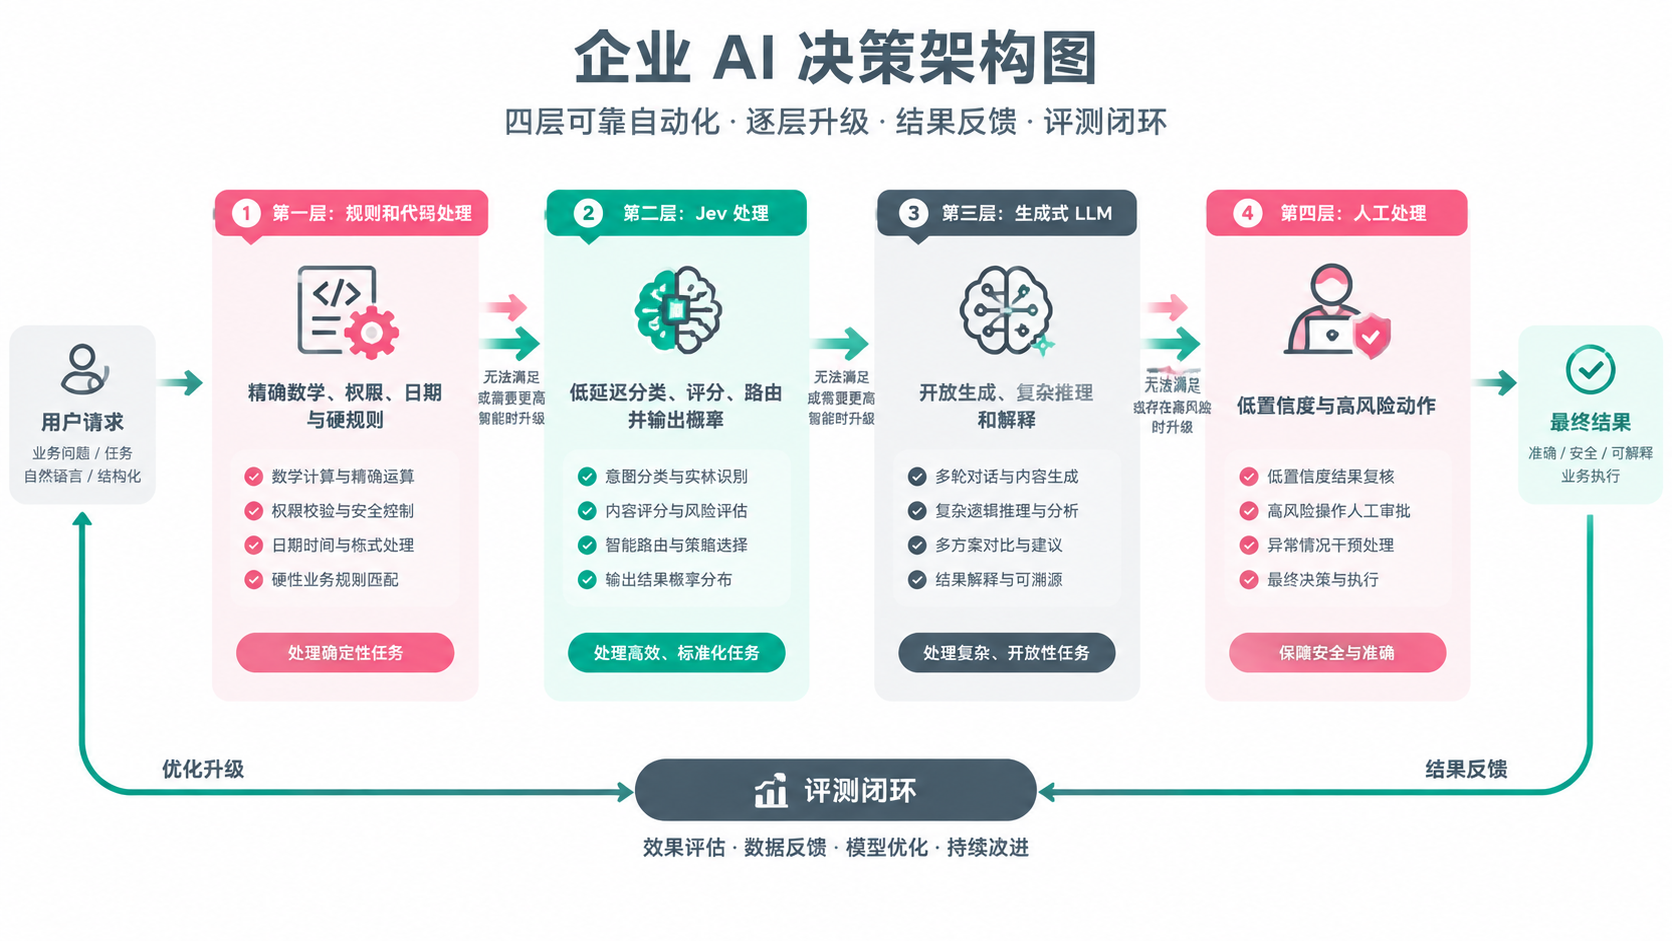
生产系统不应争论"Jev 还是 LLM",而应把任务放到最合适的一层。
第一层:规则和代码
处理:
- 数学;
- 日期;
- 权限;
- 限额;
- schema;
- 幂等;
- 法规硬约束。
第二层:Jev
处理:
- 意图;
- 分类;
- 风险等级;
- 相关性;
- 路由;
- 候选排序;
- 是否需要升级。
第三层:生成式 LLM
处理:
- 生成回复;
- 开放抽取;
- 多步推理;
- 复杂规划;
- 解释;
- 代码生成。
第四层:人工
处理:
- 低置信度;
- 高风险动作;
- 政策例外;
- 责任认定;
- 投诉和申诉。
这比"所有事情都发给一个大模型"更容易控制成本、延迟和风险。
12. Jev 的典型设计模式
12.1 Speculative fan-out
把同一状态可能用到的问题一次问完,即使部分答案最终不会使用:
text
一次请求:
├─ 是不是退款?
├─ 是不是技术问题?
├─ 严重度多高?
├─ 有没有攻击性?
└─ 是否需要人工?
由代码根据主分类选择需要的答案。
官方 cookbook 在 13 个问题的监管简报示例中报告,批量询问比 13 次单独请求约 12.2 倍便宜、10.0 倍更快,答案不变。该数字来自官方特定示例,应在自己的网络和负载下复测。
12.2 Confidence-gated routing
text
高置信度 + 低风险 → 自动执行
中置信度             → 请求确认或补充信息
低置信度/高风险      → 人工或更强模型
12.3 Composite scoring
不要问"这个客户值不值得优先处理"这种复合问题。拆成:
- 业务影响;
- 故障严重度;
- 客户情绪;
- 信息完整度。
再由代码设置权重:
python
priority = (
    0.40 * business_impact
    + 0.35 * severity
    + 0.15 * frustration
    + 0.10 * reproducibility
)
权重变化时改代码,不必重写一个含糊的总 Prompt。
12.4 Cascade
text
规则 → Jev → 小 LLM → 推理模型 → 人大多数简单样本在前面解决,把昂贵模型留给少数难例。
13. Jev 1.13 的已知短板
TypeSafe 官方专门发布了 Jev 1.13 jaggedness,这比只看营销首页更重要。
13.1 过于字面
它可能回答你写出来的问题,而不是你脑中真正想问的问题。边界条件必须明确写入 criteria。
13.2 数学、计数和精确数值
不要让 Jev:
- 数字符;
- 算金额;
- 比较精确数值;
- 从 Score 反推真实数量。
这些工作交给代码。
13.3 日期时间比较
可以让模型从闭集候选中找出月份、日期等组成部分,再由代码组装和比较。不要直接要求判断复杂结算窗口。
13.4 多层间接推理
双重否定、多跳关系和复杂隐含条件会降低准确率。应减少中间层,显式指向 state 中相关字段。
13.5 Context rot
64K 是容量上限,不是"塞得越多越好"。大量无关上下文会分散判断。应先检索和过滤。
13.6 对抗内容
官方承认 Jev 1.13 不会自动把 state 当作恶意数据,提示注入和诱导文本可能改变答案。它不能成为唯一安全边界。
13.7 不保证结构概率恒等式
以下结果不一定相等:
text
P("这是退款请求")
1 - P("这不是退款请求")
Choice 中 yes 的概率
同义问题、否定问题、Noul 和 Choice 是不同询问,不能强行要求概率和为 1。
13.8 不生成内容
如果任务最终需要写回复、代码或说明,就调用生成模型。强行用 Choice 链式拼文字又慢又差。
14. 生产落地清单
请求设计
- 一道问题只包含一个原子判断;
- Choice 有
other/none; - criteria 写清边界案例;
- 只发送相关 state;
- 数学和权限留在代码;
- 批量发送共享 state 的问题。
版本和评测
- 开发期可用
jev-latest; - 生产阈值调好后锁定
jev-1.13.0; - 记录响应中的真实版本;
- 使用自有标注数据;
- 分析误放行、误拦截和人工占比;
- 新版本做影子流量和回归。
可靠性
- 401 直接报告密钥错误;
- 422 修正 schema,不要盲重试;
- 429/529 指数退避并尊重
Retry-After; - 写操作有幂等键;
- 设置超时、fallback 和熔断;
- 记录问题版本、概率、confidence 和最终结果。
安全
- API Key 仅在服务端;
- 敏感字段最小化;
- 高风险动作二次确认;
- 测试提示注入与对抗样本;
- 建立人工申诉;
- 明确数据保留合同。
官方说明不会使用客户请求和响应训练 Jev;这不等于默认不存储。请求仍可能为服务、调试、改进和法律要求被处理、保留,公开政策没有给普通方案一个固定保留天数。企业客户可咨询 Zero Data Retention。具体地域、DPA 和合规要求仍应以合同及 Legal 页面为准。
15. Jev 适合谁?
值得试
- 工单分类与路由;
- 垃圾内容和风险筛查;
- Agent 工具或模型路由;
- RAG 段落相关性、矛盾和注入检查;
- 引用支持度核验;
- 候选技能或动作选择;
- 大规模结构化记录语义判断;
- 需要亚秒响应的闭集决策。
暂时不适合
- 需要看图、听音频或处理视频;
- 中文为主且没有自建评测;
- 必须本地离线部署;
- 答案空间开放;
- 要求解释推理过程;
- 需要精确数学、日期和计数;
- 需要复杂多步规划;
- 不能接受 early access 供应商风险。
16. 我的判断:Jev 真正新在哪里?
Jev 最有价值的部分不是"又一个更便宜的模型",而是迫使开发者重新划分模型和代码的边界:
text
模型:理解模糊语义,输出概率
代码:组合判断,执行硬规则,承担动作
人:处理责任、例外和低置信度
过去我们常让 LLM:
- 读状态;
- 自己决定步骤;
- 生成 JSON;
- 自报 confidence;
- 直接调用工具。
Jev 的设计选择是主动放弃生成自由度,换取:
- 闭集输出;
- 概率分布;
- 低延迟;
- 低输出成本;
- 代码可组合性。
这个方向很值得关注,但当前仍有三项关键不确定性:
- 独立 benchmark:厂商 workflow eval 尚未被充分复现;
- 长期稳定性:早期访问、动态限流和版本迁移仍在变化;
- 模型透明度:架构、训练数据和 RLCD 细节尚未公开。
因此合理态度不是"Jev 将取代 LLM",而是:
在答案空间已知、判断可以原子化、延迟和成本敏感的工作流中,测试 Jev 是否能替代一部分 LLM 调用;其余部分继续使用规则、生成模型和人工。
17. 常见问题
Jev 是小语言模型吗?
TypeSafe 称它为新的 System One Model,不是聊天 LLM。公开资料不足以独立还原底层架构,但接口和训练目标确实针对结构化判断,而非文本生成。
Jev 能生成 JSON 吗?
它不是先生成 JSON 字符串再解析,而是通过 System One API 返回固定结构的答案对象。
"不会幻觉"是真的吗?
若"幻觉"指生成 schema 外的字段或不存在的候选,类型边界可以避免;若指语义永不出错,则不成立。
Noul 是什么缩写?
官方把它定义为 yes/no 概率原语。使用时关注"为真的概率"即可,不必把它当作普通 Boolean。
能处理中文吗?
可以接收 CJK 文本,但官方明确说明英文是主要训练语言、效果最好。中文业务必须单独评测。
能看图片或视频吗?
不能。Doom Demo 输入是文本化结构状态,不是画面。
能私有化部署吗?
公开资料提供的是托管 API 和合作渠道,没有公开可下载权重。企业方案需要向 TypeSafe 咨询。
应该使用 jev-latest 还是固定版本?
试验阶段用 jev-latest 方便;生产阈值完成校准后固定 jev-1.13.0,评测通过后再升级。
参考资料
- TypeSafe AI, Introducing System One Models & Jev:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe Documentation, Introduction:https://docs.typesafe.ai/introduction.md
- TypeSafe Documentation, Quick start:https://docs.typesafe.ai/introduction/quickstart.md
- TypeSafe Documentation, System One:https://docs.typesafe.ai/concepts/system-one.md
- TypeSafe Documentation, Primitives:https://docs.typesafe.ai/primitives.md
- TypeSafe Documentation, Choice:https://docs.typesafe.ai/primitives/choice.md
- TypeSafe Documentation, Score:https://docs.typesafe.ai/primitives/score.md
- TypeSafe Documentation, Noul:https://docs.typesafe.ai/primitives/noul.md
- TypeSafe Documentation, Confidence:https://docs.typesafe.ai/confidence.md
- TypeSafe Documentation, Models:https://docs.typesafe.ai/models.md
- TypeSafe Documentation, API reference:https://docs.typesafe.ai/api.md
- TypeSafe Documentation, Python SDK:https://docs.typesafe.ai/sdk/python.md
- TypeSafe Documentation, JavaScript SDK:https://docs.typesafe.ai/sdk/javascript.md
- TypeSafe Documentation, Jev 1.13 jaggedness:https://docs.typesafe.ai/model-jaggedness/jev-1.13.md
- TypeSafe Documentation, Speculative fan-out:https://docs.typesafe.ai/patterns/fan-out.md
- TypeSafe Documentation, Confidence-gated routing:https://docs.typesafe.ai/patterns/confidence-routing.md
- TypeSafe Documentation, Composite scoring:https://docs.typesafe.ai/patterns/composite-scoring.md
- TypeSafe Cookbook, Parallel questions:https://docs.typesafe.ai/cookbooks/parallel_questions.md
- TypeSafe Cookbook, Classifying RAG passages:https://docs.typesafe.ai/cookbooks/classifying_rag_passages.md
- TypeSafe Cookbook, Double-checking citations:https://docs.typesafe.ai/cookbooks/citation_check.md
- TypeSafe Cookbook, Guardrails for LLMs:https://docs.typesafe.ai/cookbooks/llm_guardrails.md
- LangChain, Building a Harness with Jev:https://www.langchain.com/blog/building-a-harness-with-jev
- Vercel, How to classify, route, and score with Jev and AI SDK:https://vercel.com/kb/guide/typesafe-jev-and-ai-sdk
- Cloudflare Workers AI, Jev (typesafe):https://developers.cloudflare.com/ai/models/typesafe/jev/
- Browser Use, jev-ultrafast:https://github.com/browser-use/jev-ultrafast
- Browser Use, MIT License:https://raw.githubusercontent.com/browser-use/jev-ultrafast/main/LICENSE
- TypeSafe Workflow Evals:https://evals.typesafe.ai/
- TypeSafe Evals, Security Incidents:https://evals.typesafe.ai/security_incidents
- TypeSafe Evals, Agent Trace Observability:https://evals.typesafe.ai/agent_trace_observability
- TypeSafe Evals, Invoice Processing:https://evals.typesafe.ai/invoice_processing
- TypeSafe Evals, Customer Service:https://evals.typesafe.ai/customer_service
- TypeSafe Documentation, Legal:https://docs.typesafe.ai/legal.md
- TypeSafe AI, Privacy Policy:https://typesafe.ai/privacy-policy
- TypeSafe AI, Anti-benchmaxxing:https://typesafe.ai/blog/antibenchmaxxing
- TypeSafe AI GitHub:https://github.com/typesafe-ai