文章目录
- [1. Agent](#1. Agent)
- [2. 基础使用](#2. 基础使用)
- [3. 流式输出](#3. 流式输出)
- [4. ReAct 介绍](#4. ReAct 介绍)
- [5. middleware 中间件使用](#5. middleware 中间件使用)
系列文章:
- 【agent 开发】agent 开发学习 - LangChain(1)
- 【agent 开发】agent 开发学习 - LangChain(2)
- 【agent 开发】agent 开发学习 - LangChain(3)
前置介绍:避免老年人跟不上时代,也是时候开始学习 agent 相关的知识,还是经典的黑马程序员教程开始学习。
1. Agent
前面学习的都是普通的调用链 chain,也就是固定好每一步要做什么,而 Agent 与普通的调用链有着本质的区别,区别在于 谁来决定执行步骤 :调用链是由开发者预先定义好的固定路径,而 Agent 则是由大语言模型(LLM)根据任务动态决定的执行路径。
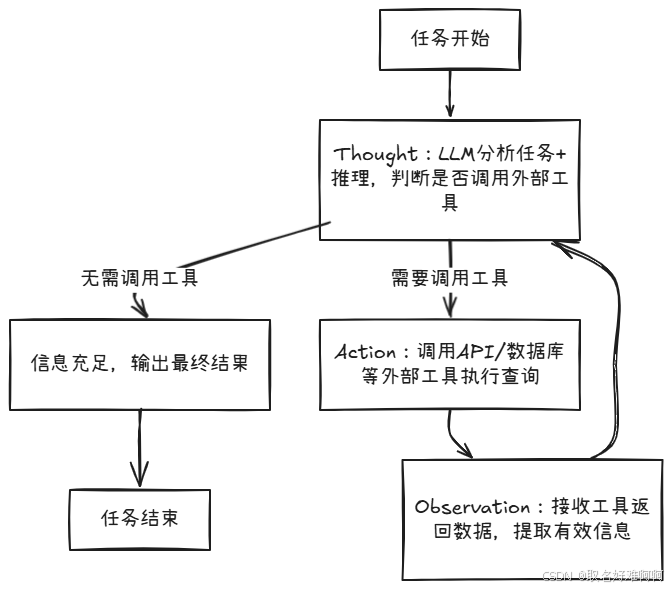
Agent 并不会遵循严格的脚本,而是通过 推理+行动 来自主决定下一步该做什么,然后不断循环 思考 → 行动 → 观察 → 再思考 的过程,直到收集到足够信息并完成任务。
2. 基础使用
Langchain 中通过 create_agent 就可以创建出一个 Agent,同时可以将工具给智能体传入使用的工具,但是在执行代码之前更新下版本:pip install -U langgraph langchain langchain-core langchain-community --force-reinstall,不然会报错 cannot import name 'ExecutionInfo' from 'langgraph.runtime',问 AI 说是版本过低了。
go
from langchain.agents import create_agent
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool


@tool(description="查询天气")
def get_weather() -> str:
    return "晴天"


agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),        # 智能体的大脑LLM
    tools=[get_weather],            # 向智能体提供工具列表
    system_prompt="你是一个聊天助手,可以回答用户问题。",
)

res = agent.invoke(
    {
        "messages": [
            {"role": "user", "content": "明天深圳的天气如何?"},
        ]
    }
)

for msg in res["messages"]:
    print(type(msg).__name__, msg.content)
上面就是整体的代码,下面来看下输出。
go
HumanMessage 明天深圳的天气如何
AIMessage
ToolMessage 晴天
AIMessage 明天深圳的天气是晴天,适合外出活动!记得做好防晒哦!
可以看到,HumanMessage 下面的 AIMessage 是空,也就是说大模型并没有思考回复,只是做了一个决策要用我们提供的工具 get_weather 来判断明天深圳的天气是什么,接下来获取到天气之后再思考返回最终的 AIMessage。
3. 流式输出
go
from langchain.agents import create_agent
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool


@tool(description="获取股价,传入股票名称,返回字符串信息")
def get_price(name: str) -> str:
    return f"股票{name}的价格是20元"


@tool(description="获取股票信息,传入股票名称,返回字符串信息")
def get_info(name: str) -> str:
    return f"股票{name},是一家A股上市公司,专注于IT职业教育。"


agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),
    tools=[get_price, get_info],
    system_prompt="你是一个智能助手,可以回答股票相关问题,记住请告知我思考过程,让我知道你为什么调用某个工具"
)

for chunk in agent.stream(
        {"messages": [{"role": "user", "content": "传智教育股价多少,并介绍一下"}]},
        stream_mode="values"
):
    latest_message = chunk['messages'][-1]

    # 如果有内容, 就打印 AI 返回的回复
    if latest_message.content:
        print(type(latest_message).__name__, latest_message.content)

    try:
        # 打印工具调用情况
        if latest_message.tool_calls:
            print(f"工具调用: {[tc['name'] for tc in latest_message.tool_calls]}")
    except AttributeError as e:
        pass
输出如下:
go
HumanMessage 传智教育股价多少,并介绍一下
工具调用: ['get_price', 'get_info']
ToolMessage 股票传智教育,是一家A股上市公司,专注于IT职业教育。
AIMessage 传智教育的当前股价是20元。这是一家A股上市公司,专注于IT职业教育领域。如果您对该公司或其业务有更多具体问题,可以随时告诉我!
4. ReAct 介绍
ReAct(Reasoning + Acting)是一种让大语言模型(LLM)通过 思考-行动-观察 动态循环实现自主决策的智能体框架,其核心在于交替生成推理步骤与具体行动,并依赖环境反馈持续修正策略,而非仅依赖内部知识完成任务。
核心流程如下:
- 思考(Thought):LLM 分析当前任务,生成可解释的推理步骤,明确下一步行动目标,也就是是否需要调用外部工具来获取更多信息。
- 行动(Action):基于推理结果,调用外部工具(如搜索API、数据库查询)执行具体操作,而非仅依赖模型内部知识。
- 观察(Observation): 获取上面第二步行动的结果,提取出有效信息,也就是获取工具返回值,判断工具是否正常工作,为下一轮大模型思考提供有效的信息。
- 循环迭代: LLM 根据观察结果重新推理,重复上述过程直至任务完成。
上面几个步骤的好处就是:
- 实时调整策略:如果工具返回结果矛盾或缺失(比如说搜索失败),根据观察步骤,Agent 可以立即更换关键词或工具。
- 决策过程比较透明:因为上面的流程比较标准化,所以可以追溯 AI 的每一次思考,决定调用什么工具,依此来去 debug。
- 内外部知识融合:上面的流程里面 AI 身份变成了决策者,很多情况下都是决定要用什么工具,而这些工具可以是我们自己提供,这样我们就可以把一些内部的资料或者一些实时的资料比如天气也返回给 AI,让 AI 额外获得实时查询的能力。
下面来看下演示代码。
go
from langchain.agents import create_agent
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool


@tool(description="获取体重,返回值是整数,单位千克")
def get_weight() -> int:
    return 90


@tool(description="获取身高,返回值是整数,单位厘米")
def get_height() -> int:
    return 172


agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),
    tools=[get_weight, get_height],
    system_prompt="""你是严格遵循ReAct框架的智能体,必须按「思考→行动→观察→再思考」的流程解决问题,
    且**每轮仅能思考并调用1个工具**,禁止单次调用多个工具。
    并告知我你的思考过程,工具的调用原因,按思考、行动、观察三个结构告知我""",
)

for chunk in agent.stream(
    {"messages": [{"role": "user", "content": "计算我的BMI"}]},
    stream_mode="values"
):
    latest_message = chunk['messages'][-1]

    if latest_message.content:
        print(type(latest_message).__name__, latest_message.content)

    try:
        if latest_message.tool_calls:
            print(f"工具调用: { [tc['name'] for tc in latest_message.tool_calls]  }")
    except AttributeError as e:
        pass
然后就是输出情况。
go
HumanMessage 计算我的BMI
AIMessage **思考**:计算BMI需要体重(千克)和身高(厘米)两个数据,当前两者均未知。根据ReAct框架需分步获取,优先获取体重。

**行动**:调用`get_weight`工具获取体重数据。


工具调用: ['get_weight']
ToolMessage 90
AIMessage **观察**:获取到体重为90千克。

**思考**:已获得体重数据,下一步需要获取身高数据才能计算BMI。根据ReAct框架,现在应调用获取身高的工具。

**行动**:调用`get_height`工具获取身高数据。


工具调用: ['get_height']
ToolMessage 172
AIMessage **观察**:获取到身高为172厘米。

**思考**:现在已获得计算BMI所需的全部数据:体重90千克,身高172厘米。根据BMI公式(体重(kg) / (身高(m))²),可直接计算结果,无需进一步调用工具。

**行动**:无工具调用,直接计算并返回结果。

计算过程:
身高转换为米:172 cm = 1.72 m
BMI = 90 / (1.72 × 1.72) ≈ 90 / 2.9584 ≈ 30.4

您的BMI约为30.4,属于肥胖范围(BMI ≥ 30)。
可以看到的是,这里面每一次 AI 调用都是调用一个,那是因为我们在提示词里面强制每次只调用一个工具,方便查看调用过程。
从上面过程也可以看到整体流程大概就是:
- 用户输入问题。
- 模型思考需要获取体重和身高,由于用户没有传,因此从工具列表中先调用
get_weight获取体重。 - 模型调用工具获取到体重,继续新一轮思考,判断出还缺少身高,于是从工具列表中通过
get_height获取身高。 - 模型调用工具获取到身高,最后计算 BMI 返回。
5. middleware 中间件使用
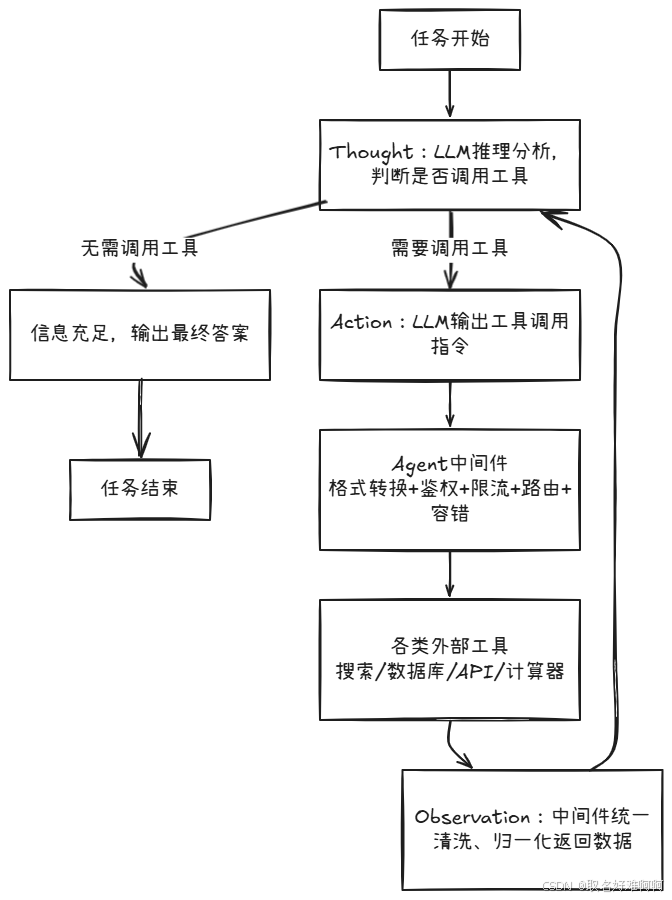
中间件就是夹在 【大模型 LLM(思考层)】 和 【外部工具 / 业务系统(Action 执行层)】 之间的一层软件服务,可以做翻译、调度、管控、适配等工具,其实就相当于拦截器了,一些比较重要的场景如下:
- 日志记录、分析、调试
- 提示词转换,工具选择
- 重试、备用、提前终止等逻辑控制
- 安全防护、个人身份检测
下面是代码的使用,其实整体看起来感觉跟 Java 的 AOP 差不多。
py
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import before_agent, after_agent, before_model, after_model, wrap_model_call, \
    wrap_tool_call
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool
from langgraph.runtime import Runtime


@tool(description="查询天气,传入城市名称字符串,返回字符串天气信息")
def get_weather(city: str) -> str:
    return f"{city}天气:晴天"


"""
1. agent执行前
2. agent执行后
3. model执行前
4. model执行后
5. 工具执行中
6. 模型执行中
"""


@before_agent
def log_before_agent(state: AgentState, runtime: Runtime) -> None:
    # agent执行前会调用这个函数并传入state和runtime两个对象
    print(f"[before agent]agent启动,并附带{len(state['messages'])}消息")


@after_agent
def log_after_agent(state: AgentState, runtime: Runtime) -> None:
    print(f"[after agent]agent结束,并附带{len(state['messages'])}消息")


@before_model
def log_before_model(state: AgentState, runtime: Runtime) -> None:
    print(f"[before_model]模型即将调用,并附带{len(state['messages'])}消息")


@after_model
def log_after_model(state: AgentState, runtime: Runtime) -> None:
    print(f"[after_model]模型调用结束,并附带{len(state['messages'])}消息")


@wrap_model_call
def model_call_hook(request, handler):
    print("模型调用啦")
    return handler(request)


@wrap_tool_call
def monitor_tool(request, handler):
    print(f"工具执行:{request.tool_call['name']}")
    print(f"工具执行传入参数:{request.tool_call['args']}")

    return handler(request)


agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),
    tools=[get_weather],
    middleware=[log_before_agent, log_after_agent, log_before_model, log_after_model, model_call_hook, monitor_tool]
)

res = agent.invoke({"messages": [{"role": "user", "content": "深圳今天的天气如何呀,如何穿衣"}]})
for msg in res["messages"]:
    print(type(msg).__name__, msg.content)
上面我们定义了几个 AOP 方法。
@before_agent:在 Agent 执行前调用这个函数,参数是AgentState和Runtime。@after_agent:在 Agent 执行结束调用这个函数,参数是AgentState和Runtime。@before_model:在 model 执行前调用这个函数,参数是AgentState和Runtime。@after_model:在 model 执行结束调用这个函数,参数是AgentState和Runtime。@wrap_model_call:在模型调用的时候会回调这个方法,参数是request和handler。@wrap_tool_call:在工具调用的时候会回调这个方法,参数是request和handler。
接下来在 create_agent 创建 Agent 的时候将这几个方法作为中间件传进去,运行的时候就会被拦截然后执行对应的逻辑了,下面看下最后的输出结果。
go
[before agent]agent启动,并附带1消息
[before_model]模型即将调用,并附带1消息
模型调用啦
[after_model]模型调用结束,并附带2消息
工具执行:get_weather
工具执行传入参数:{'city': '深圳'}
[before_model]模型即将调用,并附带3消息
模型调用啦
[after_model]模型调用结束,并附带4消息
[after agent]agent结束,并附带4消息
HumanMessage 深圳今天的天气如何呀,如何穿衣
AIMessage
ToolMessage 深圳天气:晴天
AIMessage 深圳今天是晴天,阳光明媚!建议穿着轻便、透气的衣物,比如短袖T恤、薄款长裤或短裤。同时注意防晒,可以戴帽子、太阳镜,并涂抹防晒霜哦!可以看到执行的顺序就是:Agent 开始 -> model1 -> tool -> model2 -> Agent 结束。
如有错误,欢迎指出!!!