✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
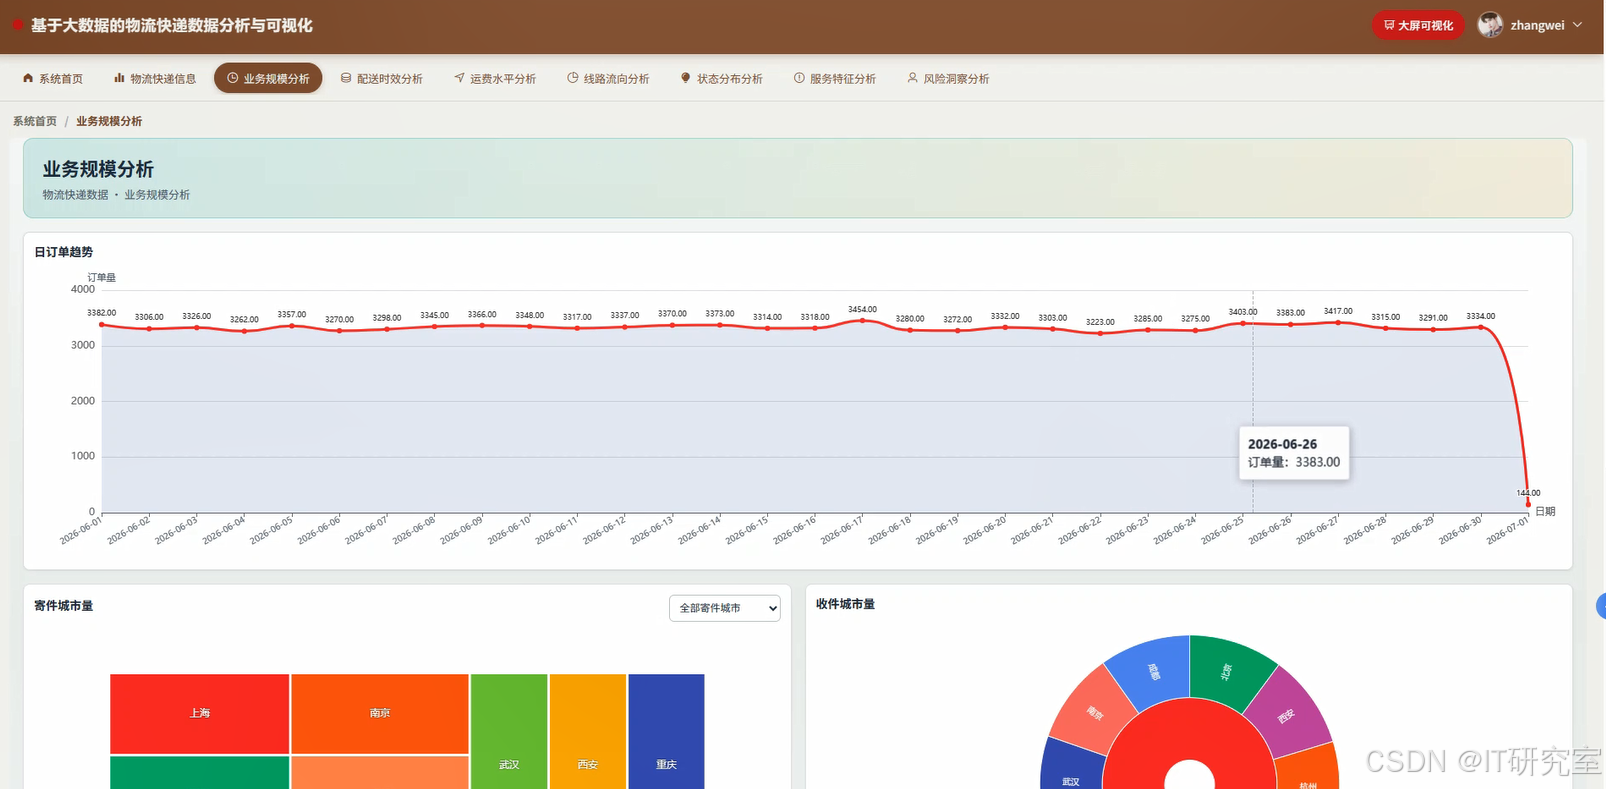
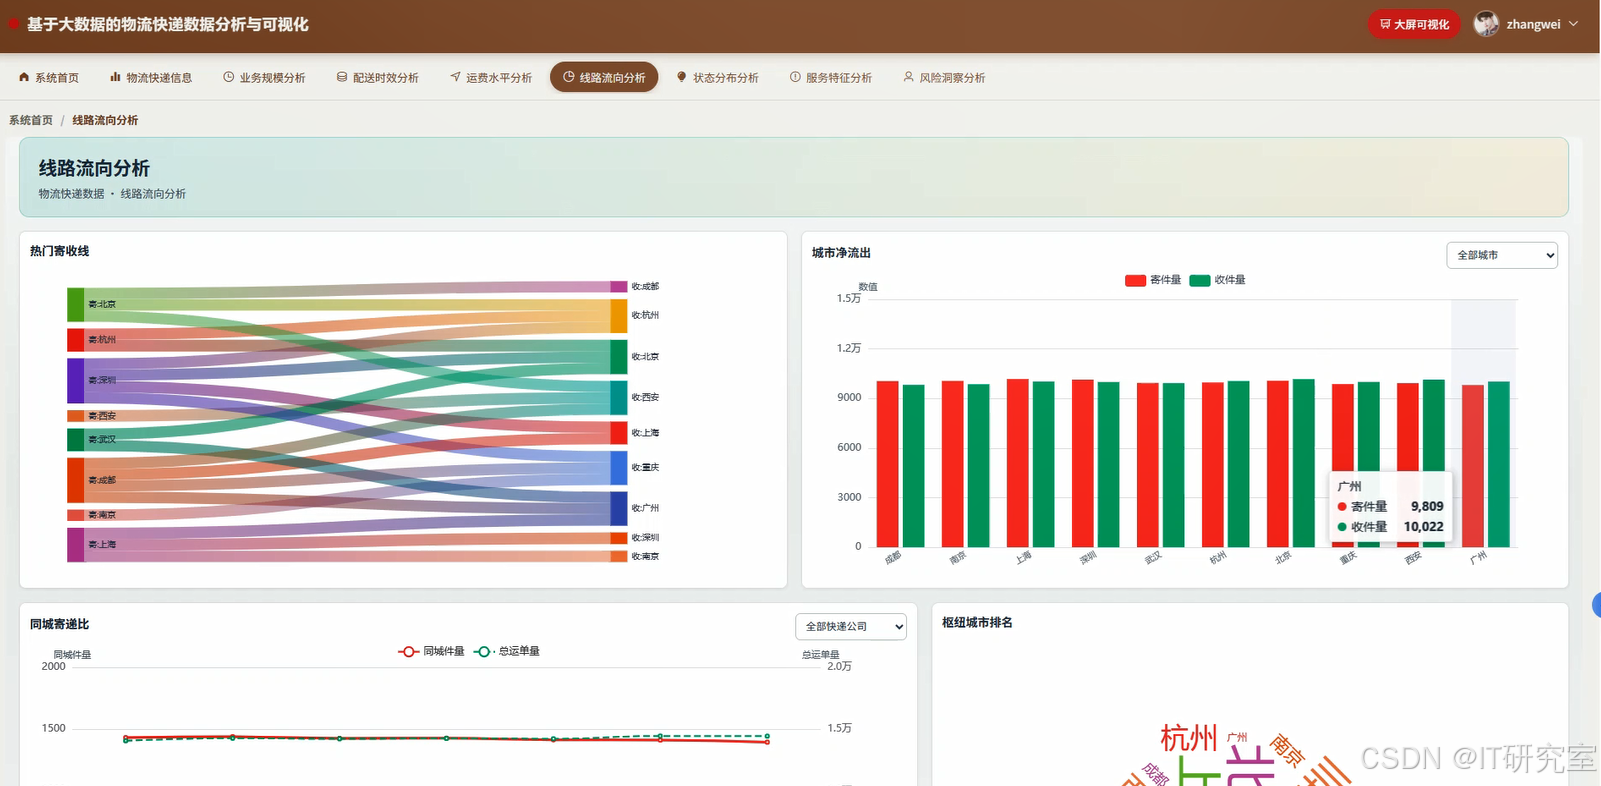
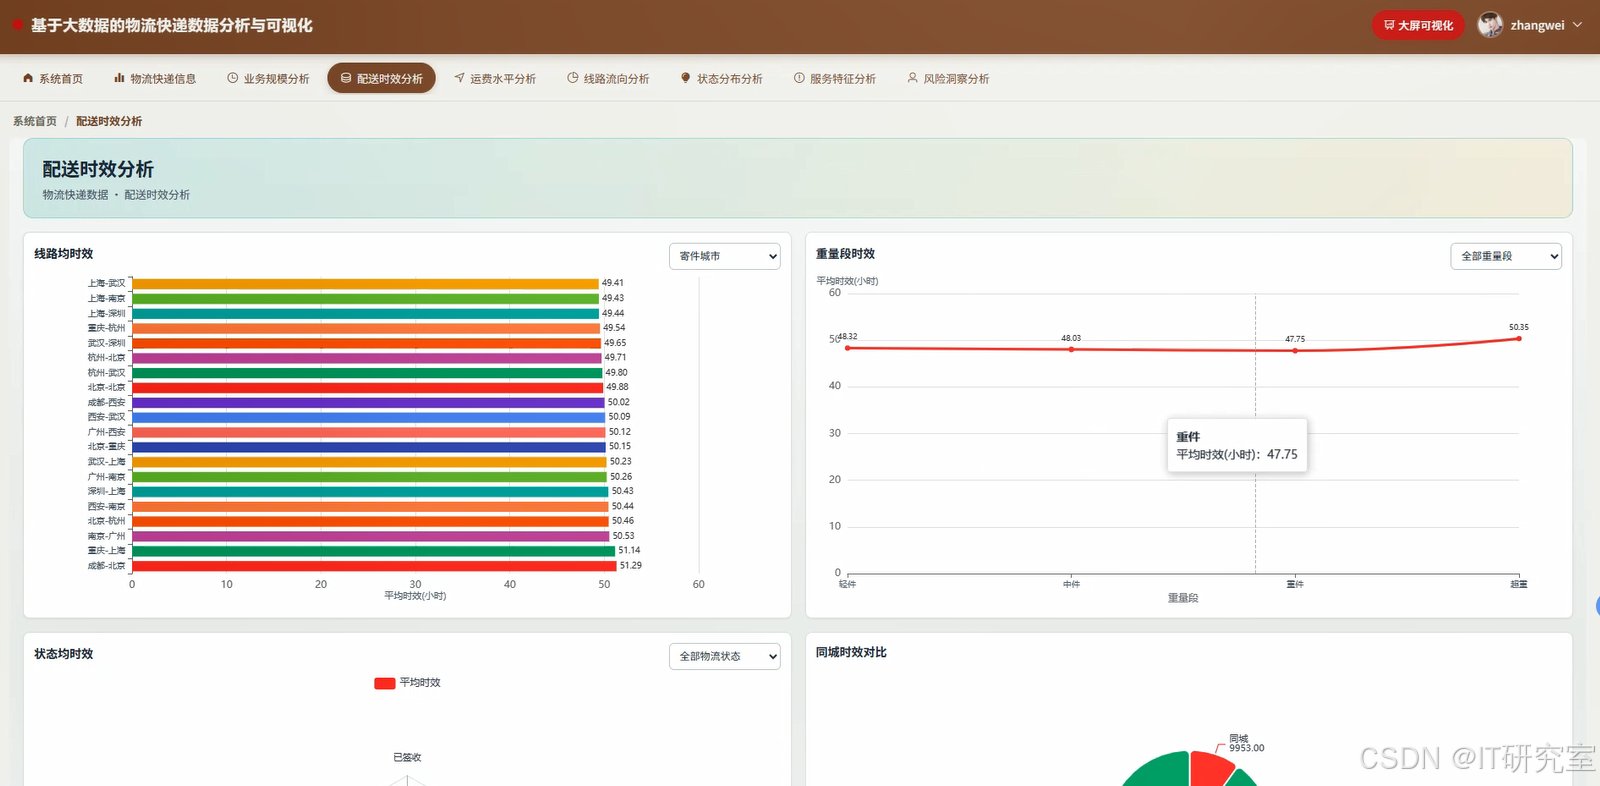
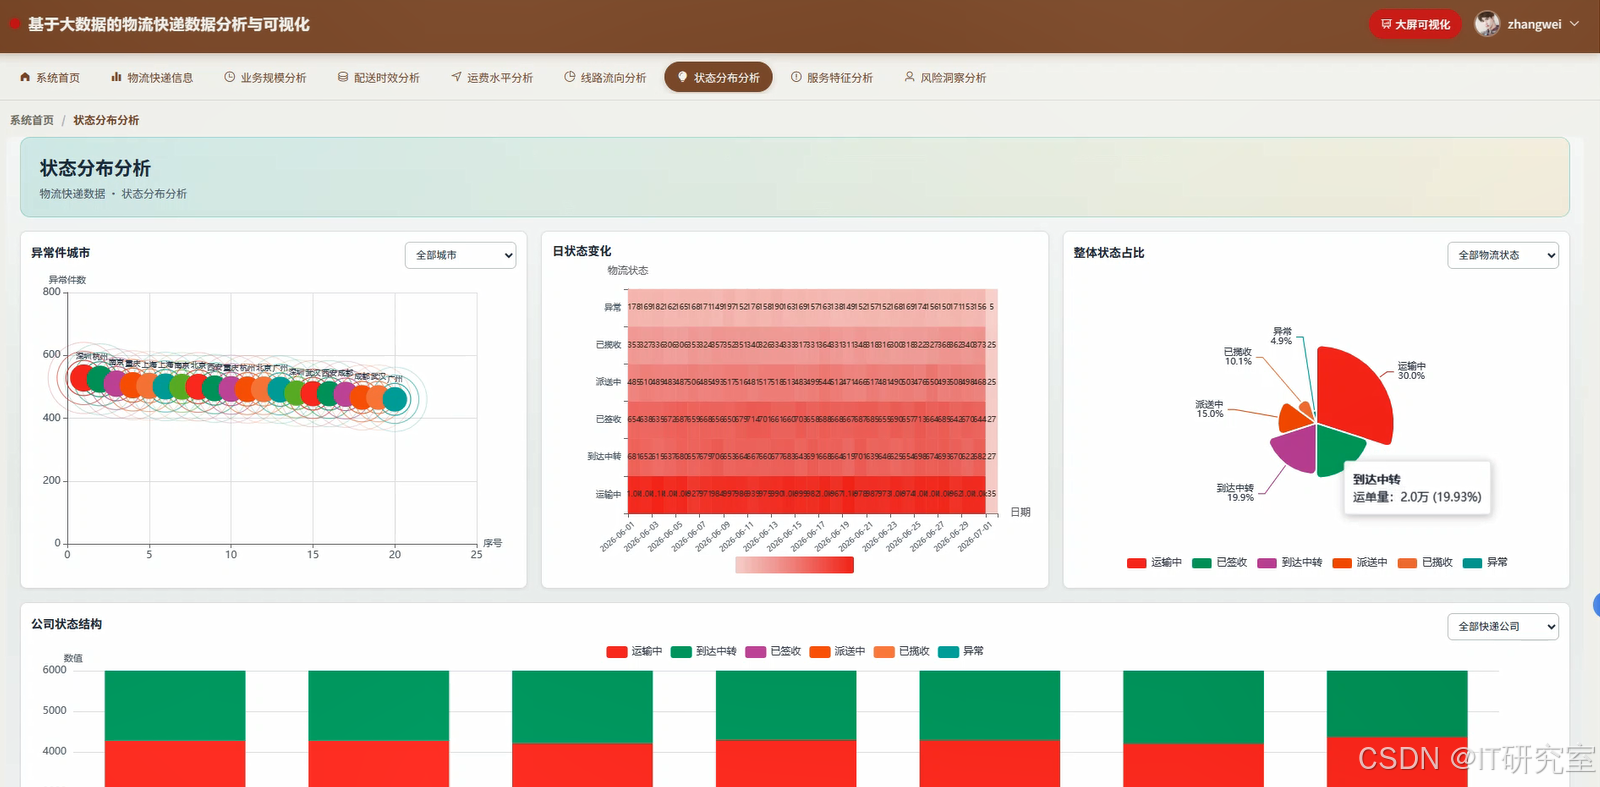
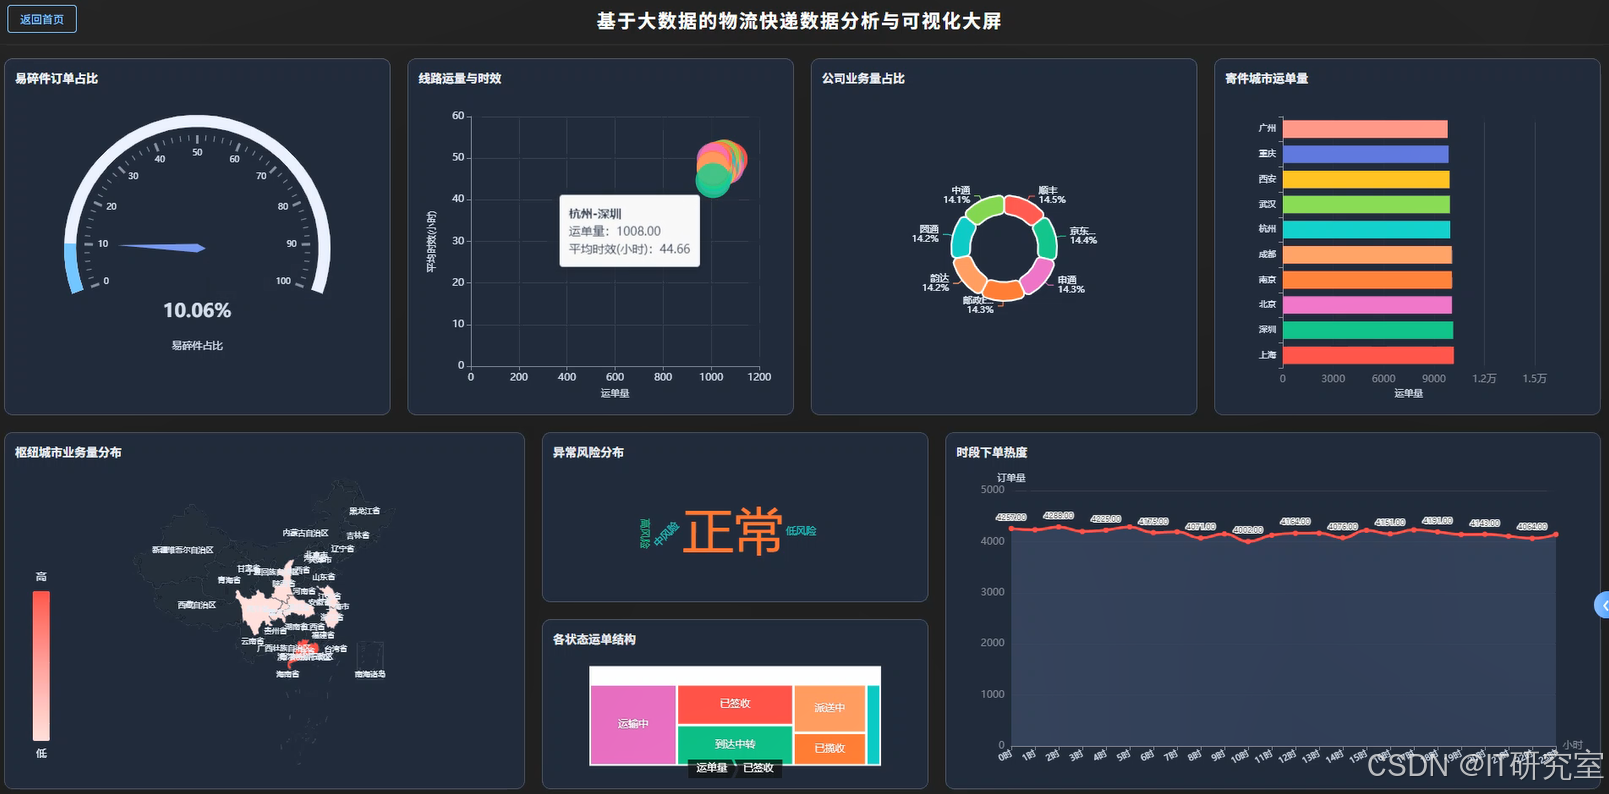
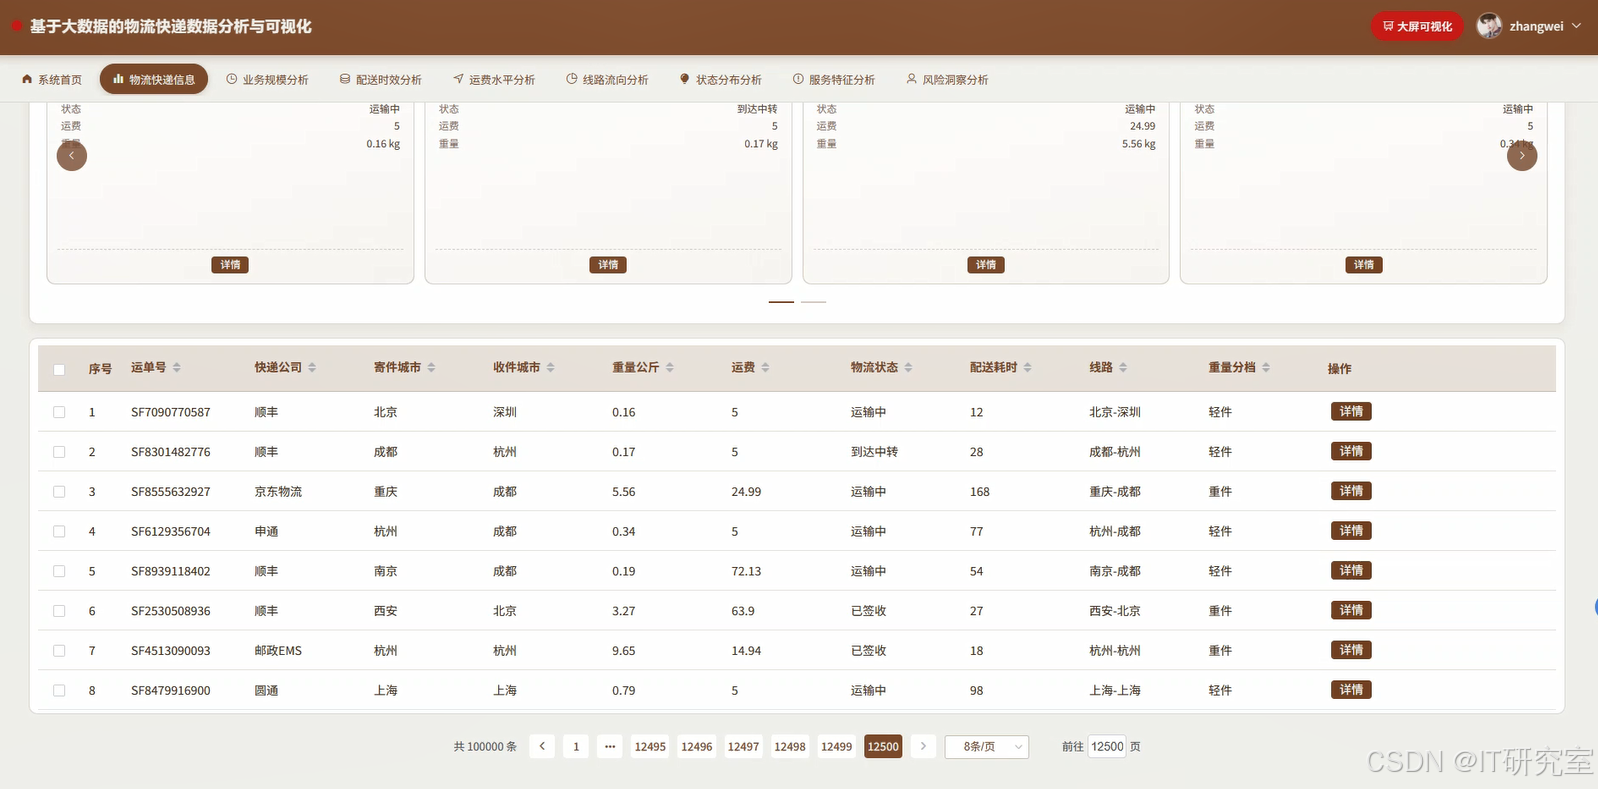
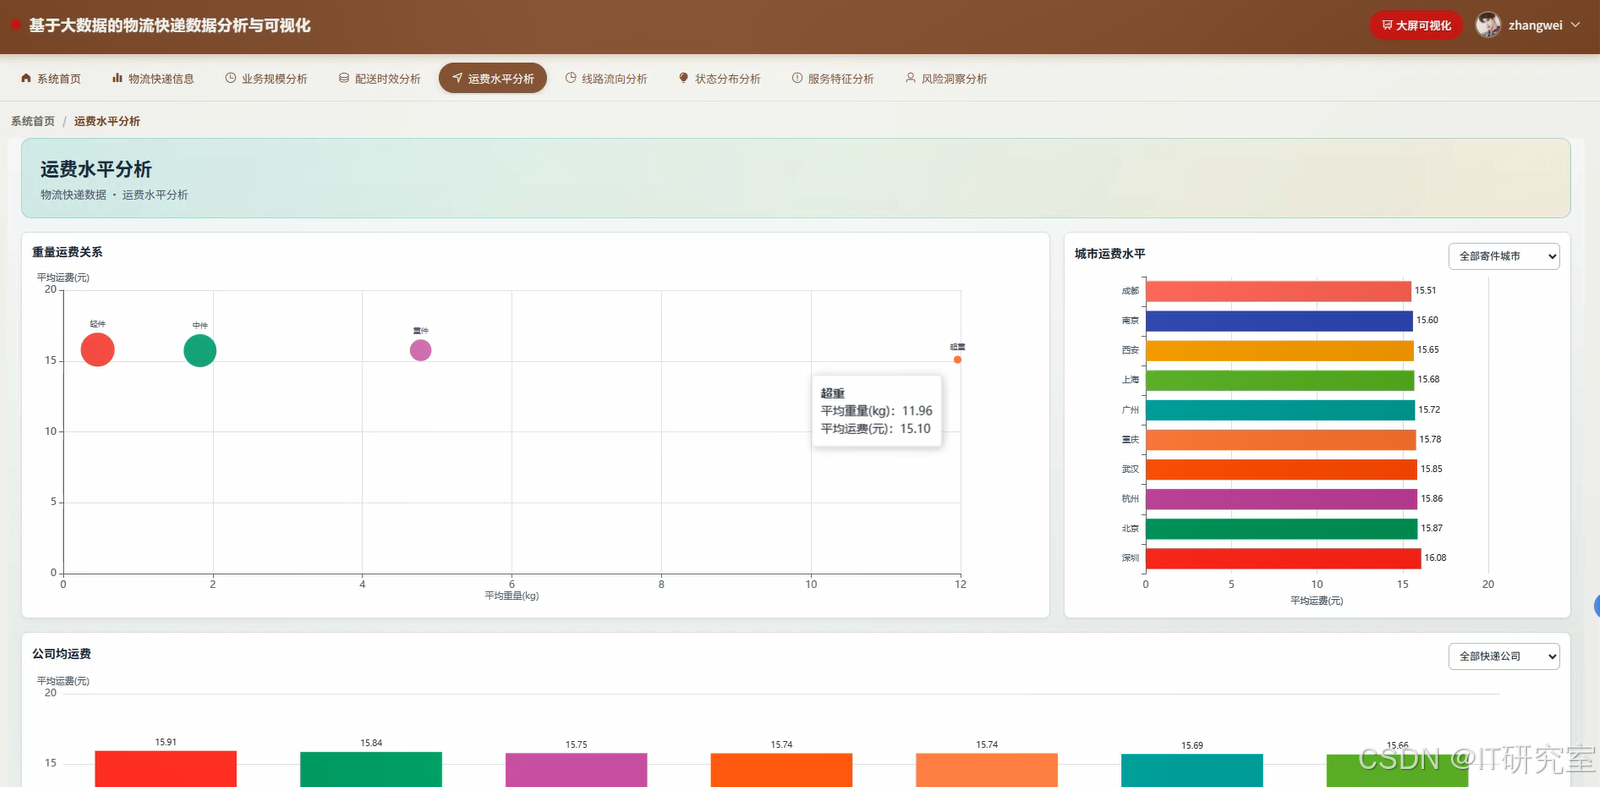
本系统名为《基于大数据的物流快递数据分析与可视化》,是一套面向物流快递业务场景的数据分析平台,主要围绕物流快递信息、业务规模、配送时效、运费水平、线路流向、状态分布、服务特征以及风险洞察等方面展开分析。系统采用 Hadoop 与 Spark 作为大数据处理核心,通过 HDFS 完成数据存储,借助 Spark SQL 与 Pandas、NumPy 完成数据清洗、统计计算与指标加工,后端可基于 Django 或 Spring Boot 实现数据接口与业务逻辑,前端使用 Vue、ElementUI、ECharts、HTML、CSS、JavaScript 与 jQuery 完成图表展示与交互操作,数据库采用 MySQL 存储业务数据与分析结果。系统首页用于展示整体数据概览,物流快递信息模块用于管理快递单相关数据,业务规模分析模块用于观察快递业务量的整体变化,配送时效分析模块用于评估不同线路与不同时间段的配送效率,运费水平分析模块用于比较不同区域与不同业务类型的运费差异,线路流向分析模块用于呈现快递运输的主要流向关系,状态分布分析模块用于统计快递当前所处状态,服务特征分析模块用于归纳物流服务中的典型特征,风险洞察分析模块用于发现异常数据与潜在风险。整个系统围绕物流快递数据展开,从数据存储、数据处理、指标计算到可视化展示形成完整流程,能够帮助使用者更直观地理解物流快递运行情况。
选题背景
物流快递行业这些年发展得很快,快递单量持续增长,包裹从揽收、运输、配送到签收,每一个环节都会产生大量数据。以往很多物流快递相关的毕业设计,更多是做一个信息管理系统,完成快递单的录入、查询、修改和删除,数据量不大,分析也比较浅。现在物流快递业务中积累的数据越来越多,单靠传统方式很难快速看出业务规模的变化、配送时效的波动、运费水平的差异以及线路流向的规律。Hadoop 和 Spark 这类大数据技术,正好适合处理数据量较大、计算过程较复杂的场景,HDFS 可以用来存储物流快递数据,Spark SQL 和 Pandas、NumPy 可以用来做数据清洗与统计分析。计算机专业的大四学生在做毕业设计时,也需要一个既能体现大数据技术,又能结合真实业务场景的题目。基于大数据的物流快递数据分析与可视化,就是在这样的背景下形成的,它把物流快递业务数据作为分析对象,借助大数据技术完成处理与展示,让毕业设计不再停留在简单的信息管理层面。
选题意义
从实际意义来看,这个课题把物流快递业务中产生的数据整理起来,做成业务规模、配送时效、运费水平、线路流向、状态分布、服务特征和风险洞察等分析内容,能够帮助使用者更清楚地了解物流快递的运行情况。对于计算机专业的学生来说,这个课题涉及 Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy、Django 或 Spring Boot、Vue、ECharts、MySQL 等技术,能够把课堂上学到的知识串联起来,也能在数据清洗、指标计算、接口开发和图表展示中锻炼动手能力。从学习角度看,它不是一个停留在理论层面的题目,而是需要真正把数据跑通、把功能做出来、把结果展示出来。这个课题的意义还在于,它让毕业设计更贴近实际业务场景,虽然只是一个毕业设计,功能和分析深度有限,但它提供了一个完整的思路,能够为后续继续学习大数据分析打下基础。整体来说,这个课题既有一定的技术实践价值,也能帮助学生在毕业设计过程中积累数据处理与可视化方面的经验。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的物流快递数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, avg, count, desc, when, round
spark = SparkSession.builder.appName("LogisticsExpressAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
express_df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/logistics/express_info.csv")
express_df.createOrReplaceTempView("express_info")
def business_scale_analysis():
    scale_df = spark.sql("SELECT province, city, COUNT(order_id) AS order_count, SUM(freight) AS total_freight, AVG(freight) AS avg_freight FROM express_info GROUP BY province, city ORDER BY order_count DESC")
    scale_df = scale_df.withColumn("order_level", when(col("order_count") >= 10000, "高").when(col("order_count") >= 5000, "中").otherwise("低"))
    scale_df = scale_df.withColumn("freight_ratio", round(col("total_freight") / col("order_count"), 2))
    scale_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/logistics_db").option("dbtable", "business_scale_result").option("user", "root").option("password", "123456").save()
    result = scale_df.collect()
    return result
def delivery_timeliness_analysis():
    timeliness_df = spark.sql("SELECT route_line, AVG(delivery_hours) AS avg_delivery_hours, MIN(delivery_hours) AS min_delivery_hours, MAX(delivery_hours) AS max_delivery_hours, COUNT(order_id) AS order_count FROM express_info GROUP BY route_line")
    timeliness_df = timeliness_df.withColumn("timeliness_level", when(col("avg_delivery_hours") <= 24, "高效").when(col("avg_delivery_hours") <= 48, "正常").otherwise("延迟"))
    timeliness_df = timeliness_df.withColumn("delay_rate", round(when(col("avg_delivery_hours") > 48, col("order_count") / col("order_count")).otherwise(0), 4))
    timeliness_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/logistics_db").option("dbtable", "delivery_timeliness_result").option("user", "root").option("password", "123456").save()
    result = timeliness_df.collect()
    return result
def risk_insight_analysis():
    risk_df = spark.sql("SELECT order_id, province, city, freight, delivery_hours, status FROM express_info WHERE freight > 100 OR delivery_hours > 72 OR status = '异常'")
    risk_df = risk_df.withColumn("risk_type", when(col("freight") > 100, "运费异常").when(col("delivery_hours") > 72, "时效异常").otherwise("状态异常"))
    risk_df = risk_df.withColumn("risk_score", when(col("risk_type") == "运费异常", 80).when(col("risk_type") == "时效异常", 70).otherwise(60))
    risk_df = risk_df.orderBy(desc("risk_score"))
    risk_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/logistics_db").option("dbtable", "risk_insight_result").option("user", "root").option("password", "123456").save()
    result = risk_df.collect()
    return result
五、系统视频
基于大数据的物流快递数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的物流快递数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇