相关链接
论文原文(arXiv: 2511.08396):https://arxiv.org/abs/2511.08396
开源代码:https://github.com/PlanckChang/EMAformer
会议信息:AAAI 2026,https://aaai.org/Conferences/AAAI-26/
视频讲解:https://space.bilibili.com/51422950?spm_id_from=333.1007.0.0
摘要
多变量时间序列预测(MTSF)在众多领域都至关重要。尽管Transformer架构取得了显著进展,但iTransformer这类模型仍落后于最新的基于MLP的模型,作者把这一差距归因于不稳定的通道间关系(unstable inter-channel relationships)。
为弥合差距,本文提出简单而有效的EMAformer :它用一套辅助嵌入来增强Transformer,类似一副增强能力的"铠甲"。通过引入三个关键归纳偏置------跨轴特异性(cross-axis specificity)、全局稳定性(global stability)、相位敏感性(phase sensitivity),EMAformer在不改动Transformer核心架构的前提下释放其潜力,在12个真实世界基准上取得最先进性能,平均降低MSE约2.73%、MAE约5.15%,显著推进了多变量时间序列预测中基于Transformer方法的实用性。
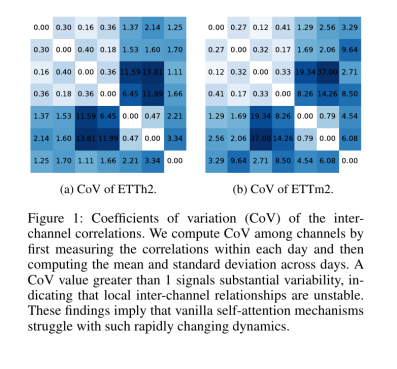
图注: ETTh2与ETTm2上通道相关性的变异系数(CoV)热力图。先按天计算通道间相关性、再跨天求均值与标准差;CoV大于1表示通道关系在时间上波动剧烈、局部关系不稳定。
Q1:这篇论文试图解决什么问题?
核心问题是:多变量时间序列中通道间相关性高度不稳定,导致以变量token化(variate tokenization)为基础、用自注意力显式建模通道关系的Transformer(如iTransformer)难以稳定发挥,如何在不改动Transformer核心架构的前提下,用输入嵌入把这种易变关系"稳住"并补上时间细节。
作者用变异系数CoV刻画通道相关性的波动:在标准基准上,通道相关性的CoV会随时间剧烈摆动,呈现极高数值;CoV大于1即意味着高变异,说明两个通道此刻高度相关、下一刻可能近乎无关,这种波动会误导自注意力机制。相比之下,自然语言里一个词在整句中语义角色稳定、图像里一个图像块保持固定空间上下文,而时间序列的变量却没有这种稳定性。于是自注意力会在"没有预测增益的通道依赖"上空转,造成次优性能。
Q2:有哪些相关研究?
论文围绕token化与嵌入两条线梳理相关工作:
1. **时间token化(temporal tokenization):**把整条多变量序列的一个时间步当作token,ARIMA等统计模型即属此类,所有变量在每个时间步被一起处理;深度模型中Informer等依赖未来步长的自回归机制,时间位置编码(ViT中的位置编码、PatchTST的patch位置编码)用于编码token序列顺序。
2. **变量token化(variate tokenization):**DLinear最早隐式采用,iTransformer通过转置输入矩阵、把每个通道的整条时间序列嵌入为变量token;它把注意力引向变量间关系,却也引出"变量token化下Transformer是否合适"的疑问,本文正是在这一框架内增强Transformer。
3. **面向MTSF的嵌入技术:**更广泛的Transformer社区用嵌入捕捉语义不同的表示,如BERT的句子嵌入;CycleNet在变量token化框架内引入残差周期预测,把周期信息作为外部信息注入MLP。本文把三类辅助嵌入以"铠甲"形式整合进变量token,与标准变量token一起送入Transformer编码器。
Q3:论文如何解决这个问题?
EMAformer的思路是"只增强输入表示、不改网络架构":在变量token嵌入之上叠加三类辅助嵌入,再交给标准Transformer编码器。
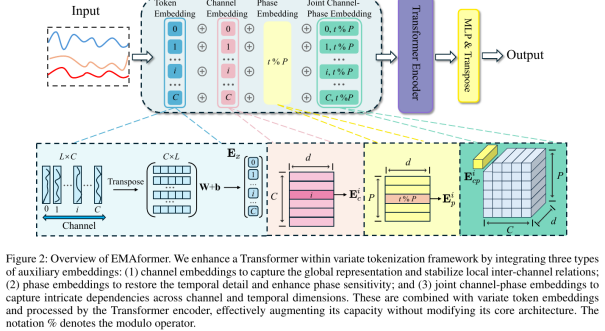
图注: EMAformer整体架构:输入经转置得到变量token嵌入,再叠加token嵌入、通道嵌入、相位嵌入与联合通道-相位嵌入,送入标准Transformer编码器,最后经MLP与转置输出。下方为各嵌入的构造细节。
① 变量token嵌入
沿用iTransformer做法:转置输入矩阵,把每个通道长度为L的时间序列通过线性层嵌入为一个d维变量token,得到通道数C个token。
② 通道嵌入:稳定全局表示
为每个通道引入一个可学习的全局嵌入,通过查表按通道索引取得。它编码每个通道的全局语义属性,在所有时间步共享同一个稳定的全局描述符,对应"全局稳定性"偏置,帮助稳定局部通道关系的波动。
③ 相位嵌入:编码周期相位
相位嵌入是通道不变的,按周期P内的相位位置(t对P取模)查表取得,为每个时间步赋予相同的全局描述符,对应"相位敏感性"。它把周期性相位位置送回Transformer,恢复被变量token压缩掉的时间细节。
④ 联合通道-相位嵌入:跨轴细粒度交互
联合嵌入同时按通道索引i与相位位置(t对P取模)查表,是通道特定、相位索引的三维张量,对应"跨轴特异性"。它让模型学习通道相关的相位模式,捕捉通道与时间两个维度上更细粒度的依赖,弥补通道嵌入(通道特定但时间不变)与相位嵌入(时间变化但通道不变)各自的不足。
⑤ 网络架构
把变量token嵌入与三类辅助嵌入逐元素相加,送入一个标准的多头自注意力Transformer编码器(N层堆叠,前置层归一化),各连接采用残差;最后用一个MLP把隐表示映射为预测长度H的输出并转置回原布局,全程不改动Transformer核心结构。
Q4:论文做了哪些实验?
实验在12个真实世界基准上进行:ETTh1、ETTh2、ETTm1、ETTm2、ECL、Traffic、Weather、Solar以及PEMS03、PEMS04、PEMS07、PEMS08;对比TQNet、TimeXer、CycleNet、iTransformer、TimesNet、PatchTST、Crossformer、DLinear、SCINet共9个基线,评价指标为MSE与MAE。
主结果
EMAformer在20个场景取得最优、3个场景次优,平均MSE降低2.73%、MAE降低5.15%。在通道数超过100的数据集上MAE降低7.57%;在PEMS04与PEMS08上性能增益约10%,通道越多、规模越大优势越明显。
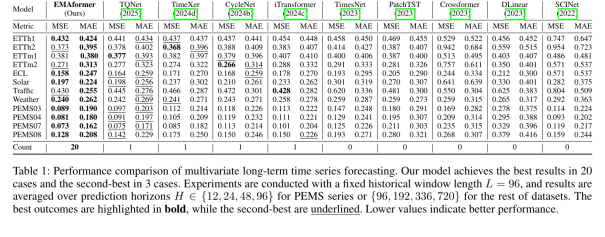
图注: 多变量长期预测性能对比(固定回看L=96),加粗为最优、下划线为次优;Count行统计各模型最优次数,EMAformer合计20次、明显领先。
消融实验
论文对三类嵌入做组合消融,并用雷达图呈现各消融层级在ETT、PEMS、ECL、Solar、Traffic、Weather六组上的相对MAE(经最大-最小归一化,仅用变量token的变体置于中心,越靠外越好)。完整模型始终取得最佳性能,被消融的变体在不同数据集上敏感程度不同,说明三类嵌入共同覆盖了数据的归纳偏置与异质性。
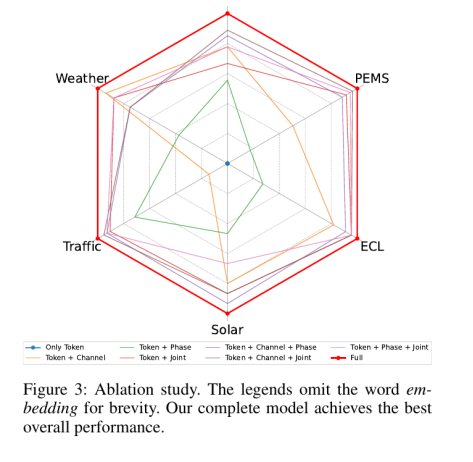
图注: 消融雷达图:Full(红色,完整模型)在六个顶点上整体最靠外,仅token或缺少任一嵌入的变体都更靠内。
注意力熵
论文计算最后一层注意力分数的熵以衡量注意力集中程度。仅用变量token时ETT系列熵接近最大值(约2.81,最大约7),注意力近乎均匀;加入通道嵌入后熵下降、注意力更集中,能更好对齐真正相关的通道;加入完整嵌入(含相位)后熵略升但仍低于原始值,反映模型在捕捉额外的相位信息,而相位嵌入单独仍带来性能提升。
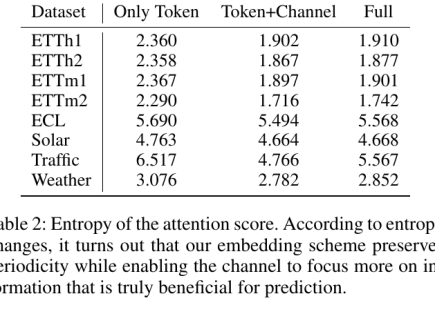
图注: 注意力熵对比:Only Token、Token+Channel与Full三列,加入嵌入后熵整体下降、注意力更聚焦于有效信息。
增强其他Transformer变体
论文把同一套嵌入分别加到Reformer、Informer、Flowformer三种Transformer上:在ECL、Traffic、Weather上,加嵌入后的版本相比原始版本与仅加可逆机制的版本都进一步提升,证明该嵌入策略具有通用性、可增强不同的Transformer架构。
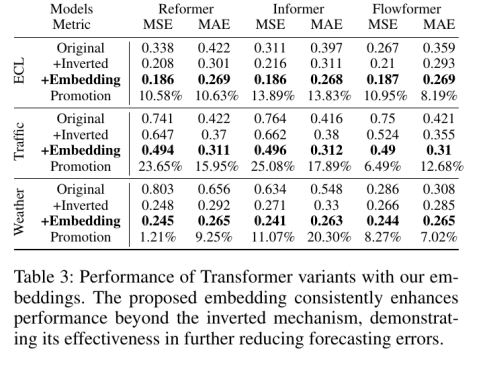
图注: 三种Transformer变体在ECL/Traffic/Weather上的结果:Original为原始、+Inverted为加可逆机制、+Embedding为加本文嵌入,Promotion为相对原始版本的提升百分比。
Transformer与MLP主干对比
为检验"全局模式由嵌入捕获"的说法,论文在不重新调参的情况下把Transformer主干替换为MLP:基于Transformer的版本在几乎所有数据集上一致优于MLP版本,说明Transformer主干不可或缺;而装上嵌入的MLP也能在除PEMS07外的多数数据集上超过最强的现有MLP基线,进一步印证嵌入设计的有效性。
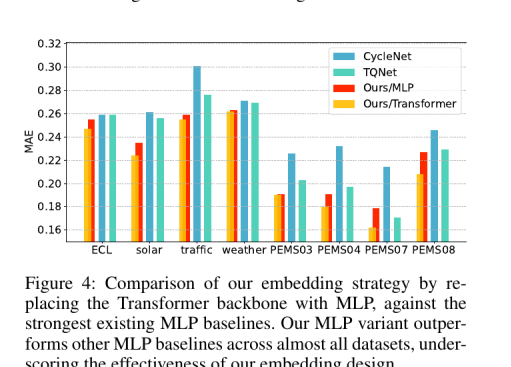
图注: 主干替换对比:Ours/Transformer(红)与Ours/MLP(橙)以及CycleNet、TQNet的MAE,Transformer版本整体更低。
去除历史信息
论文把预归一化后的输入用其均值替换(等价于零输入、消除历史信息):尽管性能自然下降,但EMAformer在多个数据集上仍能匹配甚至超越部分基线,说明嵌入所捕获的数据集级属性与全局关系在极小历史上下文下依然可用。
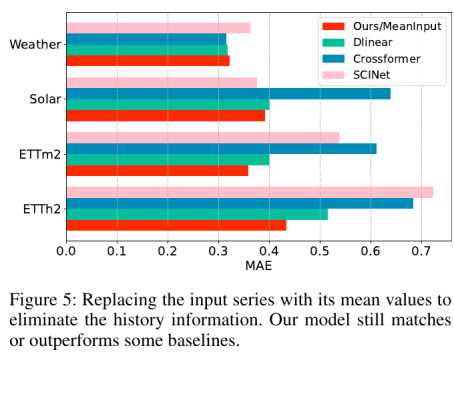
图注: 输入用均值替换消除历史后的MAE对比:Ours/MeanInput(红)仍在多个数据集上匹配或优于DLinear、Crossformer、SCINet。
学习表示可视化
论文用t-SNE把辅助嵌入可视化到二维空间:通道嵌入按通道成簇分布,把相关通道聚到一起、把差异通道分开,并随时间在通道间复用,体现稳定的全局通道关系;相位嵌入与联合通道-相位嵌入沿时间维呈现周期性,联合嵌入还揭示出"日周期嵌套在周周期内"的多周期结构。
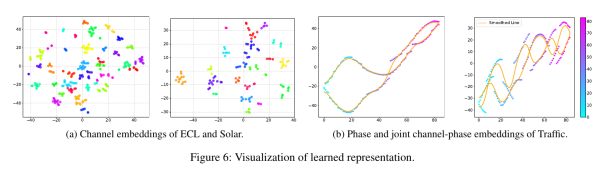
图注: 学习表示可视化:(a)ECL与Solar的通道嵌入;(b)Traffic的相位嵌入与联合通道-相位嵌入,颜色表示到预定义周期中心的相位距离。
日周期与周周期长度
论文考察超参数周期长度P:更长的周期能隐式包含更短周期(周周期可包住日周期),但每个相位可用样本更少、影响学习。按日周期与周周期分别取值的对比显示,二者各有胜负,需结合数据的周期统计选择。
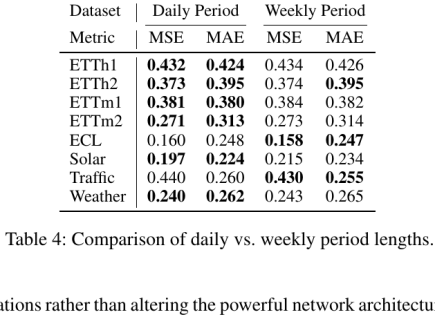
图注: 日周期(Daily Period)与周周期(Weekly Period)的MSE/MAE对比,加粗为该数据集两种周期中更优者。
Q5:有什么可以进一步探索的点?
论文在结论中明确给出了未来方向,也可结合实验进一步延伸:
**1.**探索多周期模式:可视化已显示更复杂的嵌套周期结构,如何自动分解并建模多个周期值得深入;
**2.**引入自适应周期,替代当前固定的周期长度假设,以更好捕捉变化的时间动态;
**3.**研究通道维度上的显式拓扑结构,用以更好地引导注意力机制;
**4.**把该"嵌入铠甲"与LLM等更多架构结合,检验其跨范式的可迁移性。
Q6:总结一下论文的主要内容
EMAformer针对多变量时间序列中通道间相关性高度不稳定 的问题,在不改动Transformer核心架构 的前提下,给变量token叠加通道嵌入、相位嵌入、联合通道-相位嵌入这副"嵌入铠甲",分别对应全局稳定性、相位敏感性与跨轴特异性三个归纳偏置。
在12个基准上,EMAformer在20个场景最优,平均MSE降2.73%、MAE降5.15%,且能一致增强多种Transformer、在无历史信息的极端情形下仍保持一定性能。它给出的核心启示是:当通道关系易变、自注意力难以稳定时,与其改动网络,不如先把输入嵌入中的全局、相位与跨轴信息补齐。