本周值得看
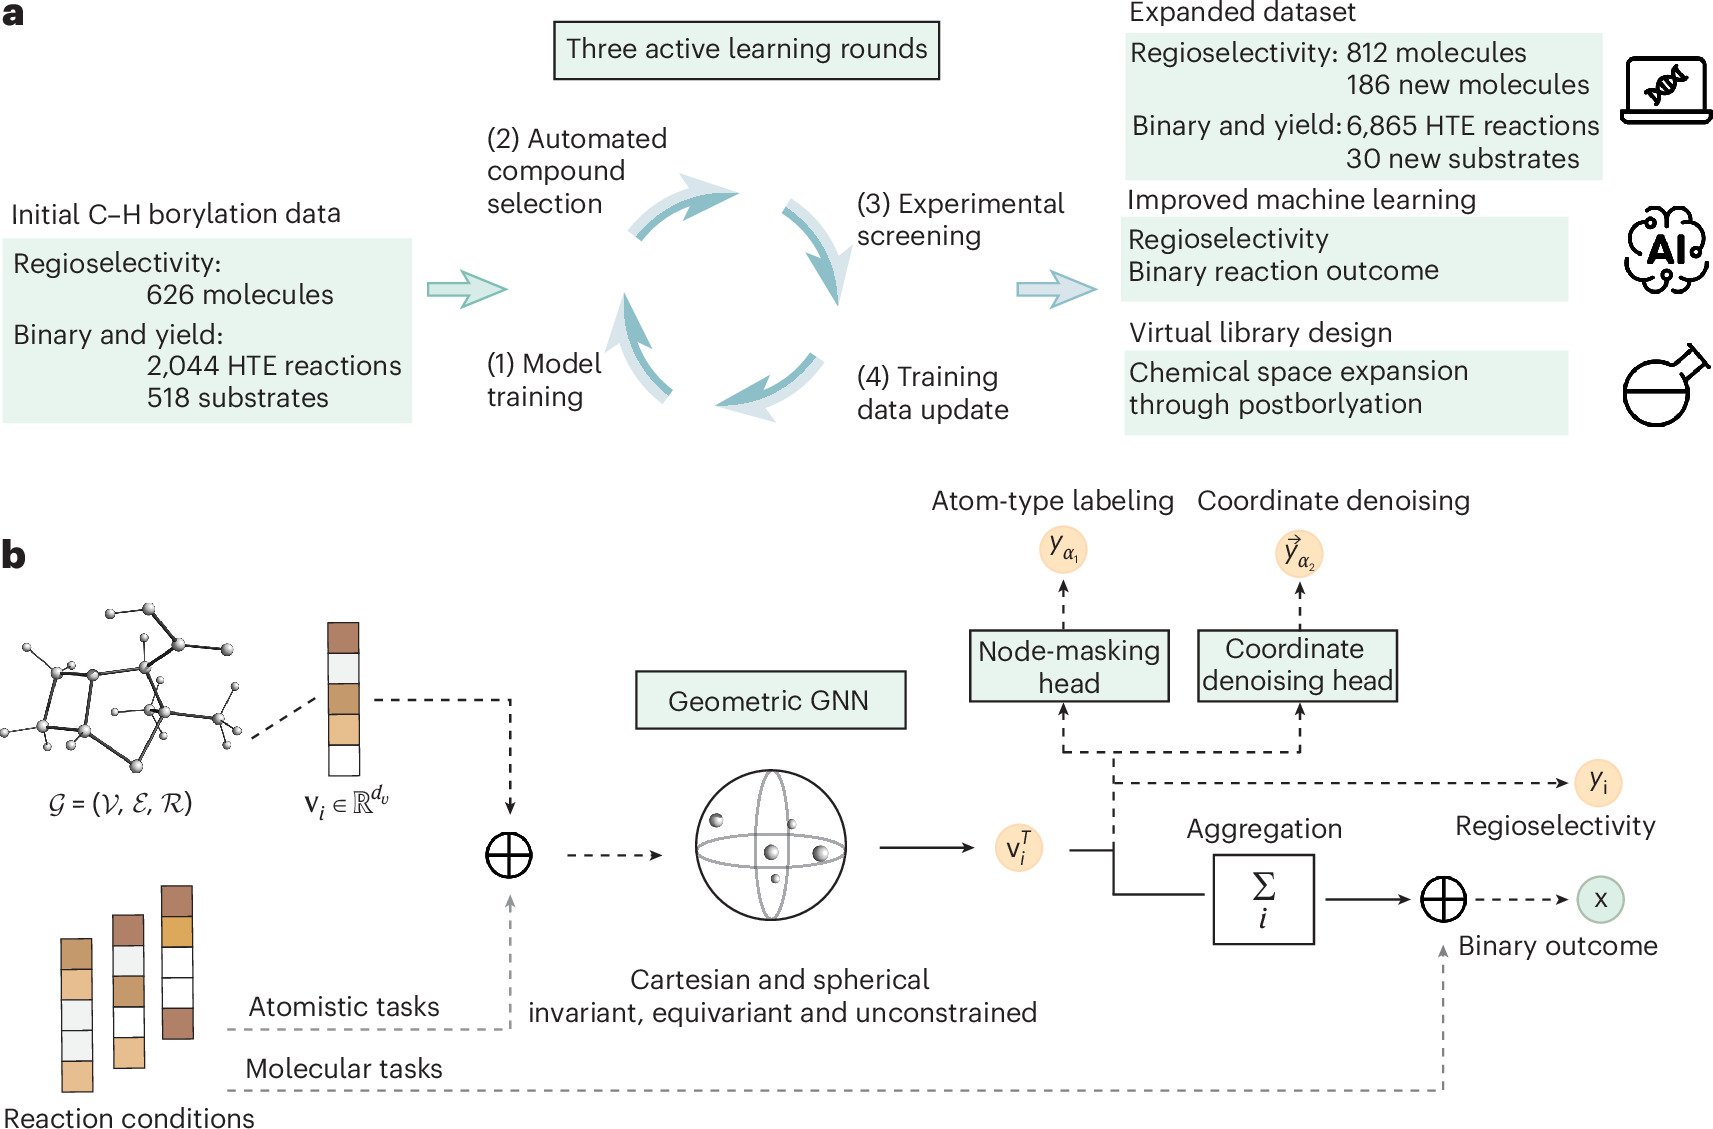
- 主动学习开始决定"下一批化学实验做什么"。 Roche 与 ETH Zurich 把模型选实验、实验回填数据和几何深度学习接成闭环,形成 6,865 条经实验测得的 C--H 硼化反应结果。
- MedGemma 是一组面向医学图像和文本的开放基础模型。 本周的 Nature Medicine 论文显示,医学专门化在分布外视觉问答、胸片分类和 Agent 评测中都优于同尺寸基础模型。
- PDFM 是把人口活动、建成环境和气象等信号压缩成"地点表示"的地理基础模型。 Google Research 公布五组公共卫生合作评估,展示它怎样补上跨境流动和报告滞后带来的信息缺口。
- 跨期补充:Microsoft Quine 将生物学模型、科学工具和实验反馈接成研究流程。 该项目于 9 月 29 日发布,本文补充其工作方式与胰腺癌案例;案例效果仍需独立核验。
技术突破:高影响期刊与正式科研成果
MedGemma:一个底座覆盖医学图像与文本任务
MedGemma 是 Google 基于 Gemma 3 开发的一组医学视觉语言基础模型,包括 4B、27B 多模态版本和 27B 文本版本,目的是让研究团队用较少任务数据适配医学图像与文本应用。该研究于 10 月 6 日发表于 Nature Medicine。与同尺寸 Gemma 3 基础模型相比,MedGemma 在分布外医学视觉问答上提高 2.6%---10% ,胸片发现分类提高 15.5%---18.1%,Agent 评测提高 10.8%;只用 10% 下游数据微调时,医学专门化带来的优势更明显。论文把它定位为可继续微调和适配的医学研发底座。
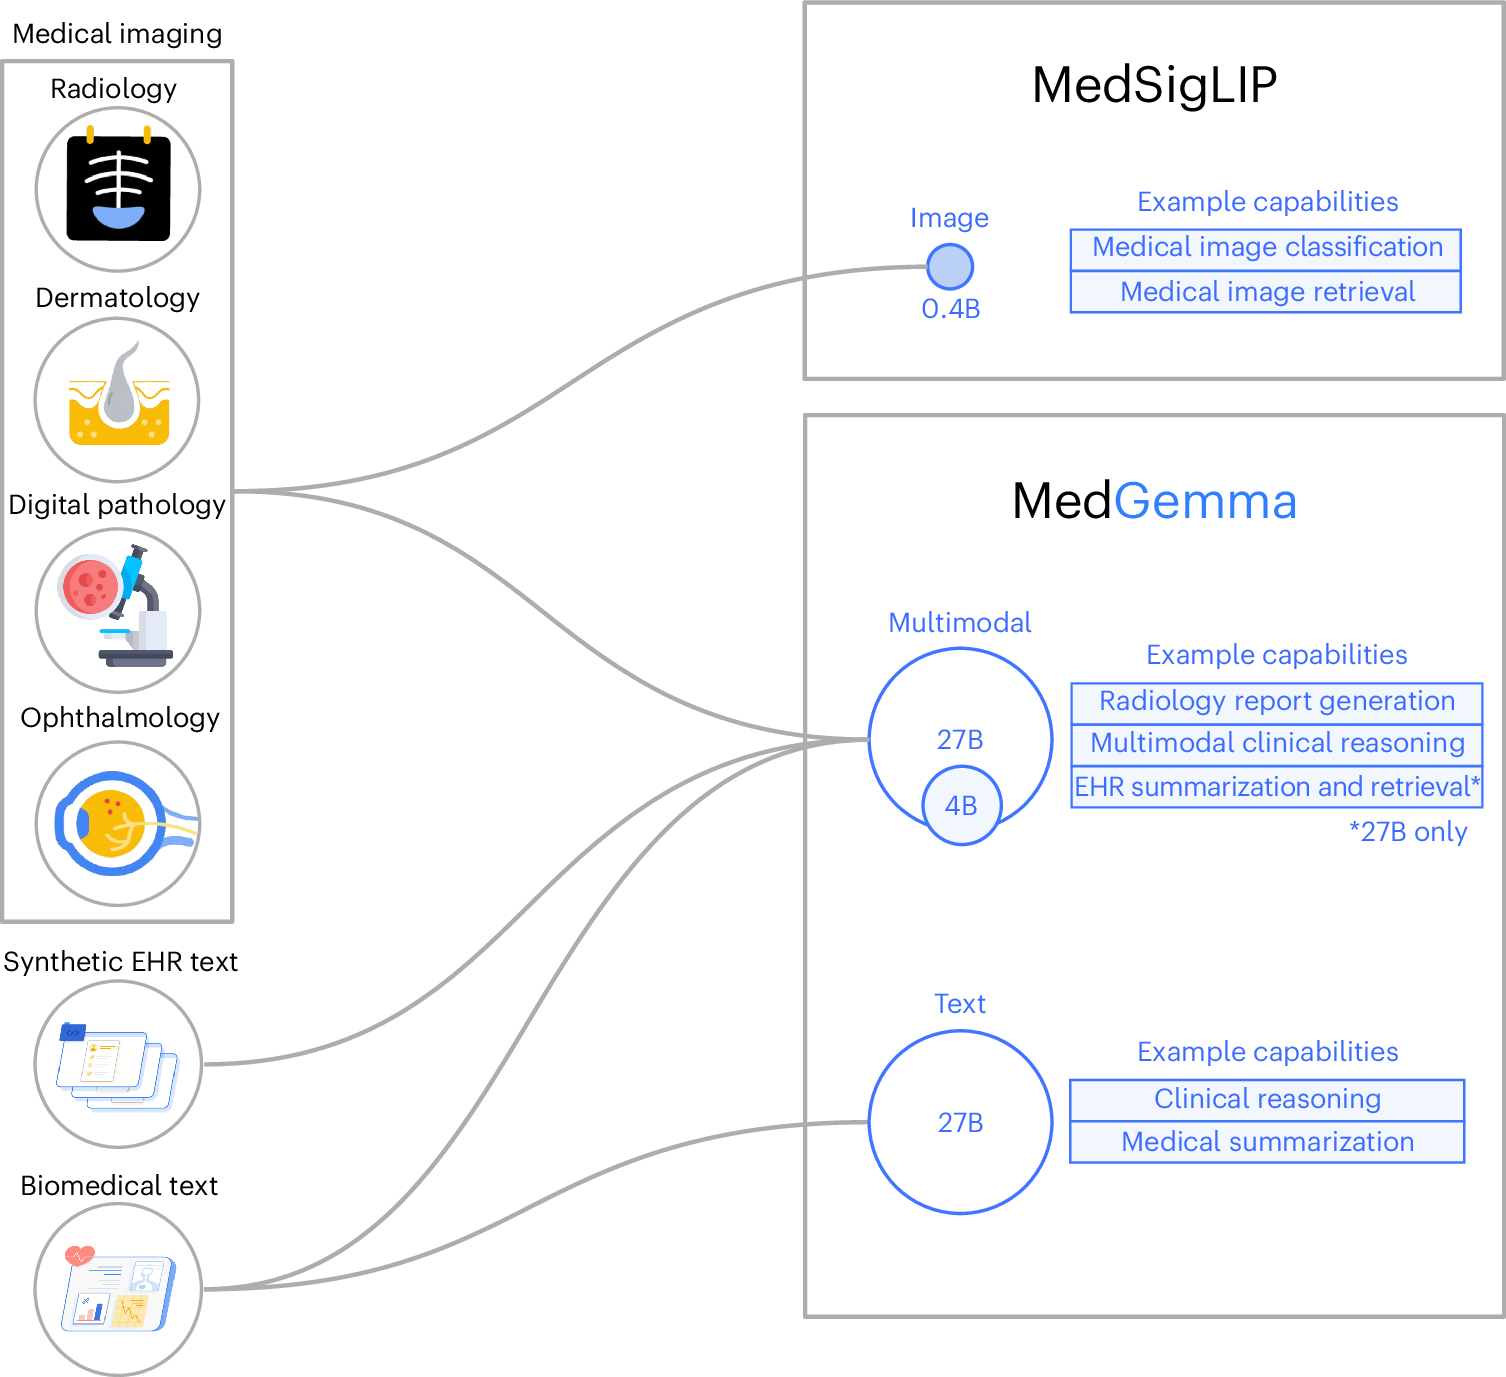
图:左侧是医学图像与文本数据,右侧对应图像编码模型 MedSigLIP,以及 MedGemma 的多模态和文本版本;沿连线可看出各版本接收的信息与任务能力。(来源:Sellergren 等,Nature Medicine,原文图 1;CC BY 4.0)
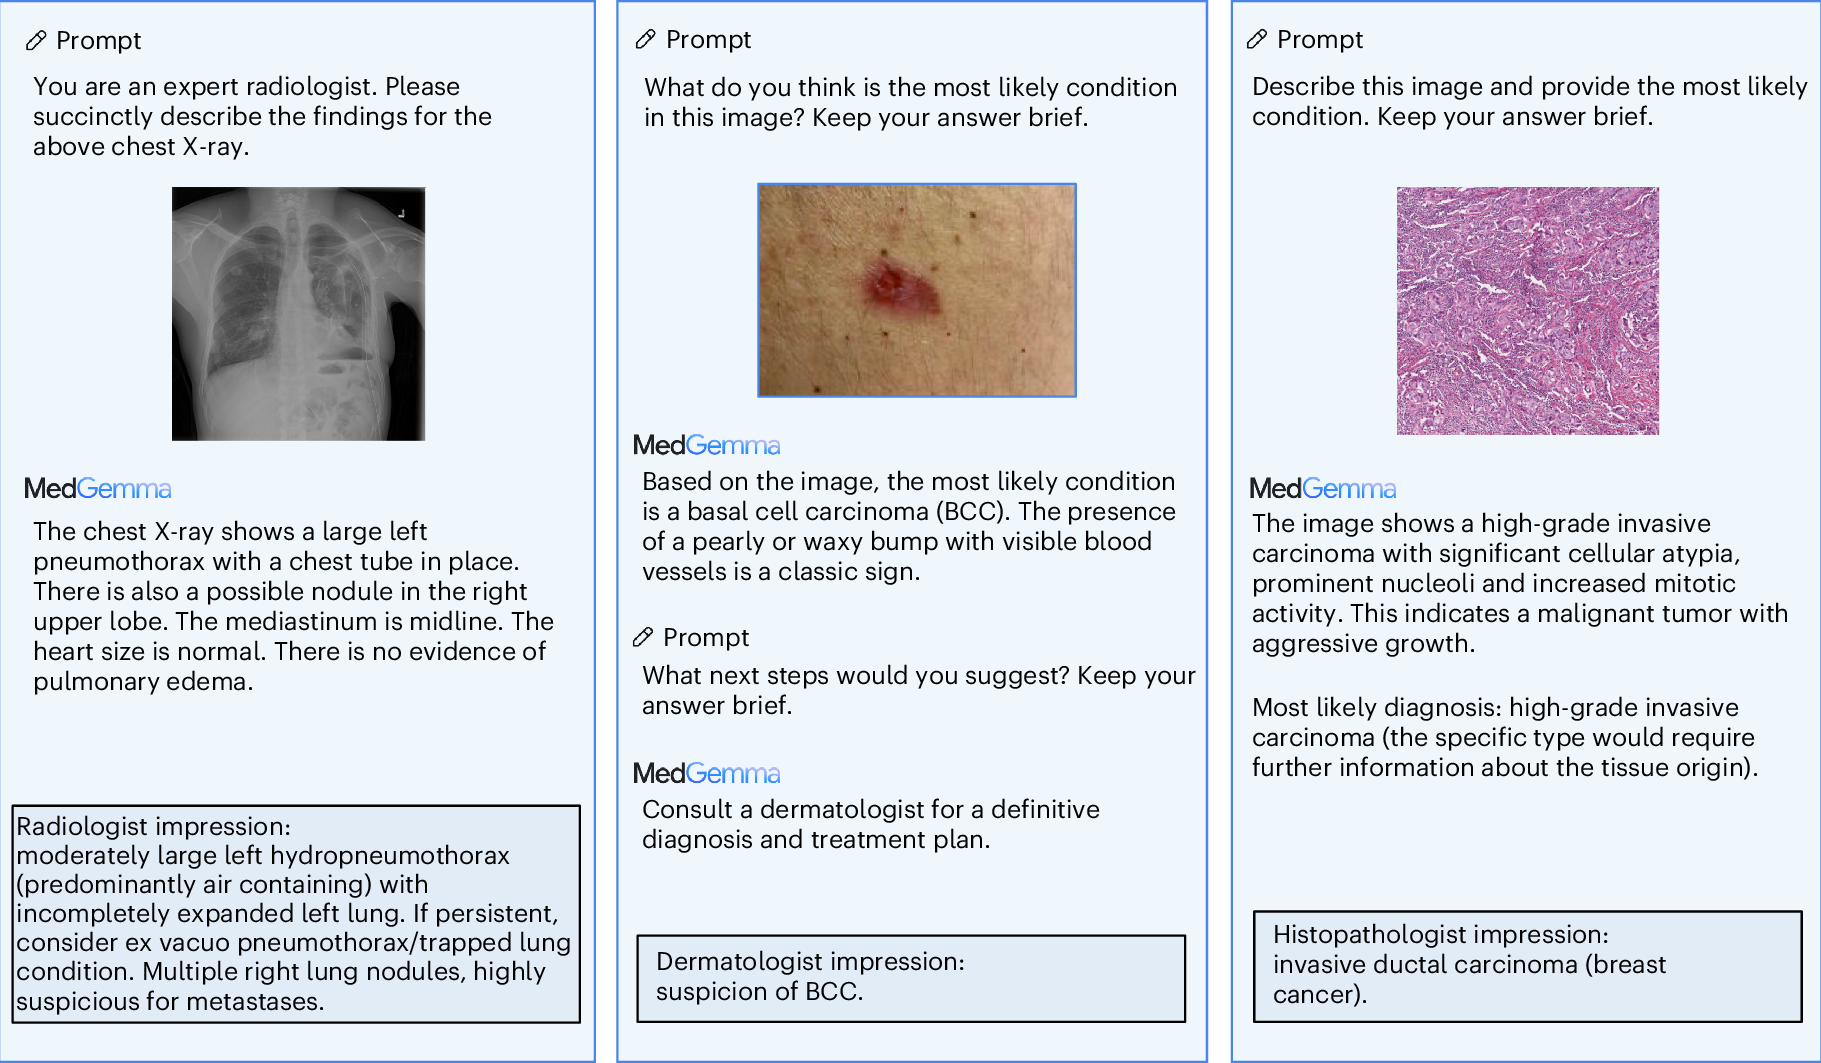
图:三列分别展示胸片、皮肤和组织病理影像的问答。模型回答与临床专家的影像判断并列,帮助理解"图像输入---文本回答"的任务形式;这些示例不等同于整体准确率。(来源:Sellergren 等,Nature Medicine,原文图 2,保留原图医学影像署名)
来源: An open vision-language model for diverse medical applications|Nature Medicine|https://www.nature.com/articles/s41591-026-04626-w|2026-10-06|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Article,开放医学视觉语言基础模型)
Visionary AI:从眼底血管结构提前识别孕期高血压风险
Visionary AI 是一套把超广角眼底影像转成血管拓扑和几何特征的可解释模型,用于在症状出现前预测先兆子痫等孕期高血压疾病。该研究于 10 月 6 日发表于 Nature Biotechnology。研究团队在 1,267 例前瞻性、多族裔妊娠队列中开发模型,先兆子痫预测达到 AUC 0.91、平均精确率 0.81 ;模型不经重新训练转移到独立外部队列后,AUC 为 0.81、平均精确率为 0.68。眼底影像在这里不只提供纹理,母体微血管网络被整理成可追溯的生物学特征,再进入风险分层。
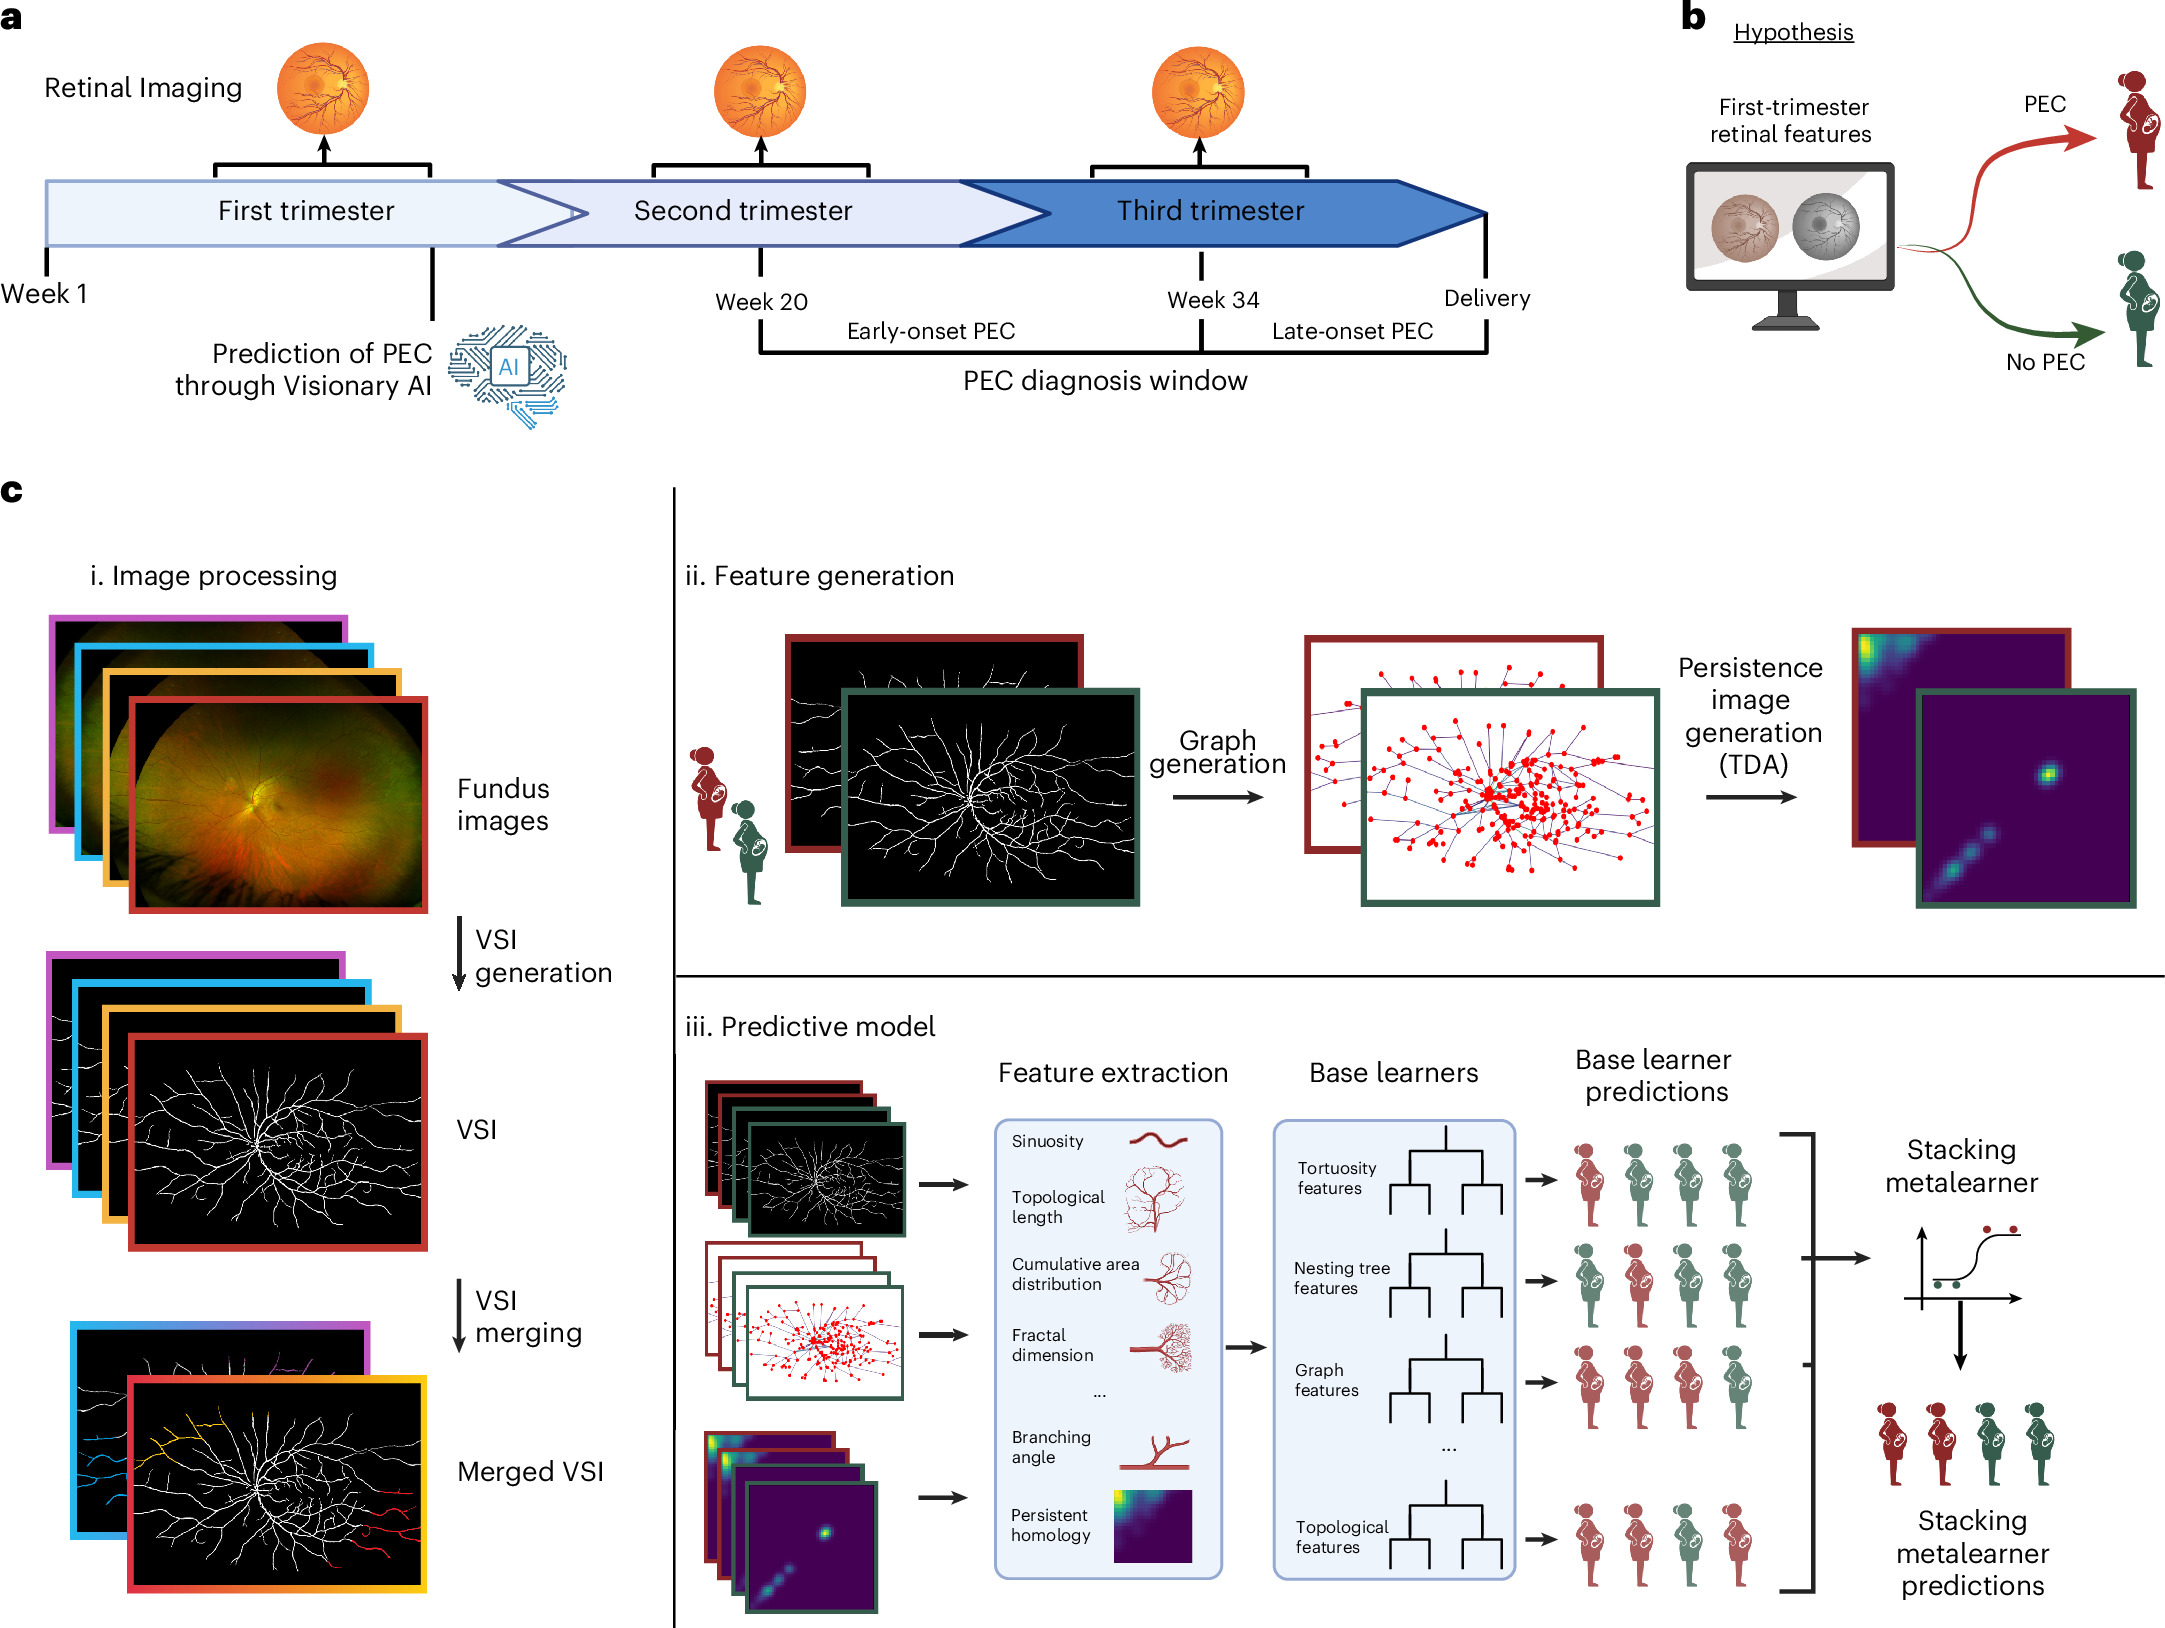
图:上方是孕期眼底采集与结局确认的时间线,下方展示血管分割、拓扑与几何特征提取,以及风险预测。重点看眼底血管结构怎样变成可解释的模型输入。(来源:Bearelly 等,Nature Biotechnology,原文图 1;CC BY-NC-ND 4.0,完整原图)
来源: Decoding systemic vascular health and hypertensive disorders in pregnancy through retinal imaging and Visionary AI|Nature Biotechnology|https://www.nature.com/articles/s41587-026-03303-0|2026-10-06|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Article,前瞻性队列与独立外部验证)
ProFormer:直接从质谱离子特征判断细胞或疾病状态
ProFormer 是一套面向蛋白质组质谱数据的 Transformer 管线,它直接读取肽离子的 MS1 层级特征,减少先用传统软件解释成蛋白丰度表的步骤。该研究于 10 月 5 日发表于 Nature Communications。研究团队把 ProFormer 与 14 类机器学习、卷积网络和视觉 Transformer 架构 比较,并在单细胞蛋白质组、轻度干扰素处理和血浆感染性疾病分类中测试;在区分重症 COVID-19 与其他感染时,模型还能把判断追溯到单条肽。这样一来,高通量质谱信号可以更早进入可解释的机器学习流程,而不必等到完整的蛋白丰度解释完成后再分类。
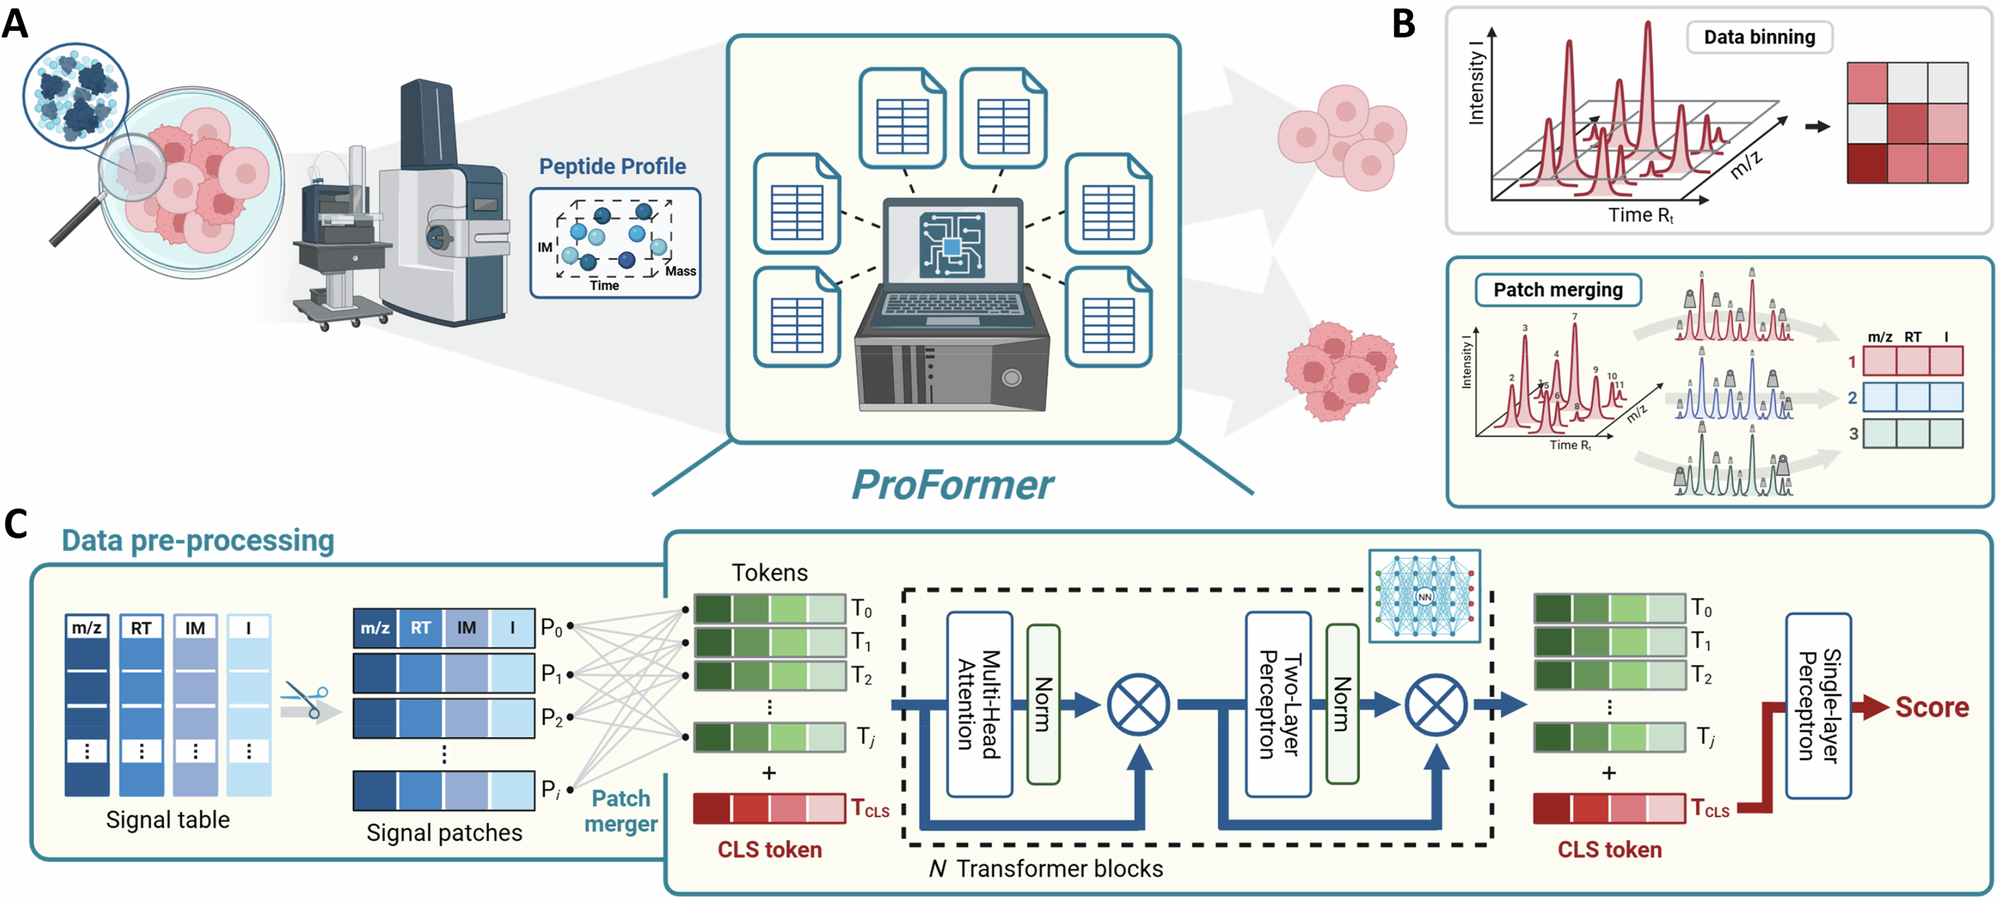
图:上方对比固定网格分箱与可学习的信号聚合,下方展示肽离子特征如何转成模型输入,经过 Transformer 后输出分类得分。这解释了模型怎样从质谱信号直接进入样本分类。(来源:Nature Communications,原文图 1;CC BY 4.0;A---C 面板绘制:Krull, KK(2026),BioRender)
来源: ProFormer: generalizable classification of single-cell and plasma proteomes using deep learning|Nature Communications|https://www.nature.com/articles/s41467-026-78143-2|2026-10-05|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Article,单细胞与血浆蛋白质组分类)
Tangermeme:把基因组深度学习模型学到的调控逻辑拆出来
Tangermeme 是一个开源基因组深度学习解释工具包,用来做序列扰动、特征归因、变异效应分析和调控元件设计,而不是再训练一套新模型。该研究于 10 月 8 日发表于 Nature Methods。工具把不同模型架构与下游解释操作解耦,新增可直接寻找可变长度高归因序列片段的 seqlet 算法;在人类 hg38 第一号染色体的 one-hot 编码测试中,耗时不到 2 秒,约为次快实现的三倍。这层可组合的分析工具把问题从"预测是否准确"推进到了"模型依据了哪些顺式调控模式"。
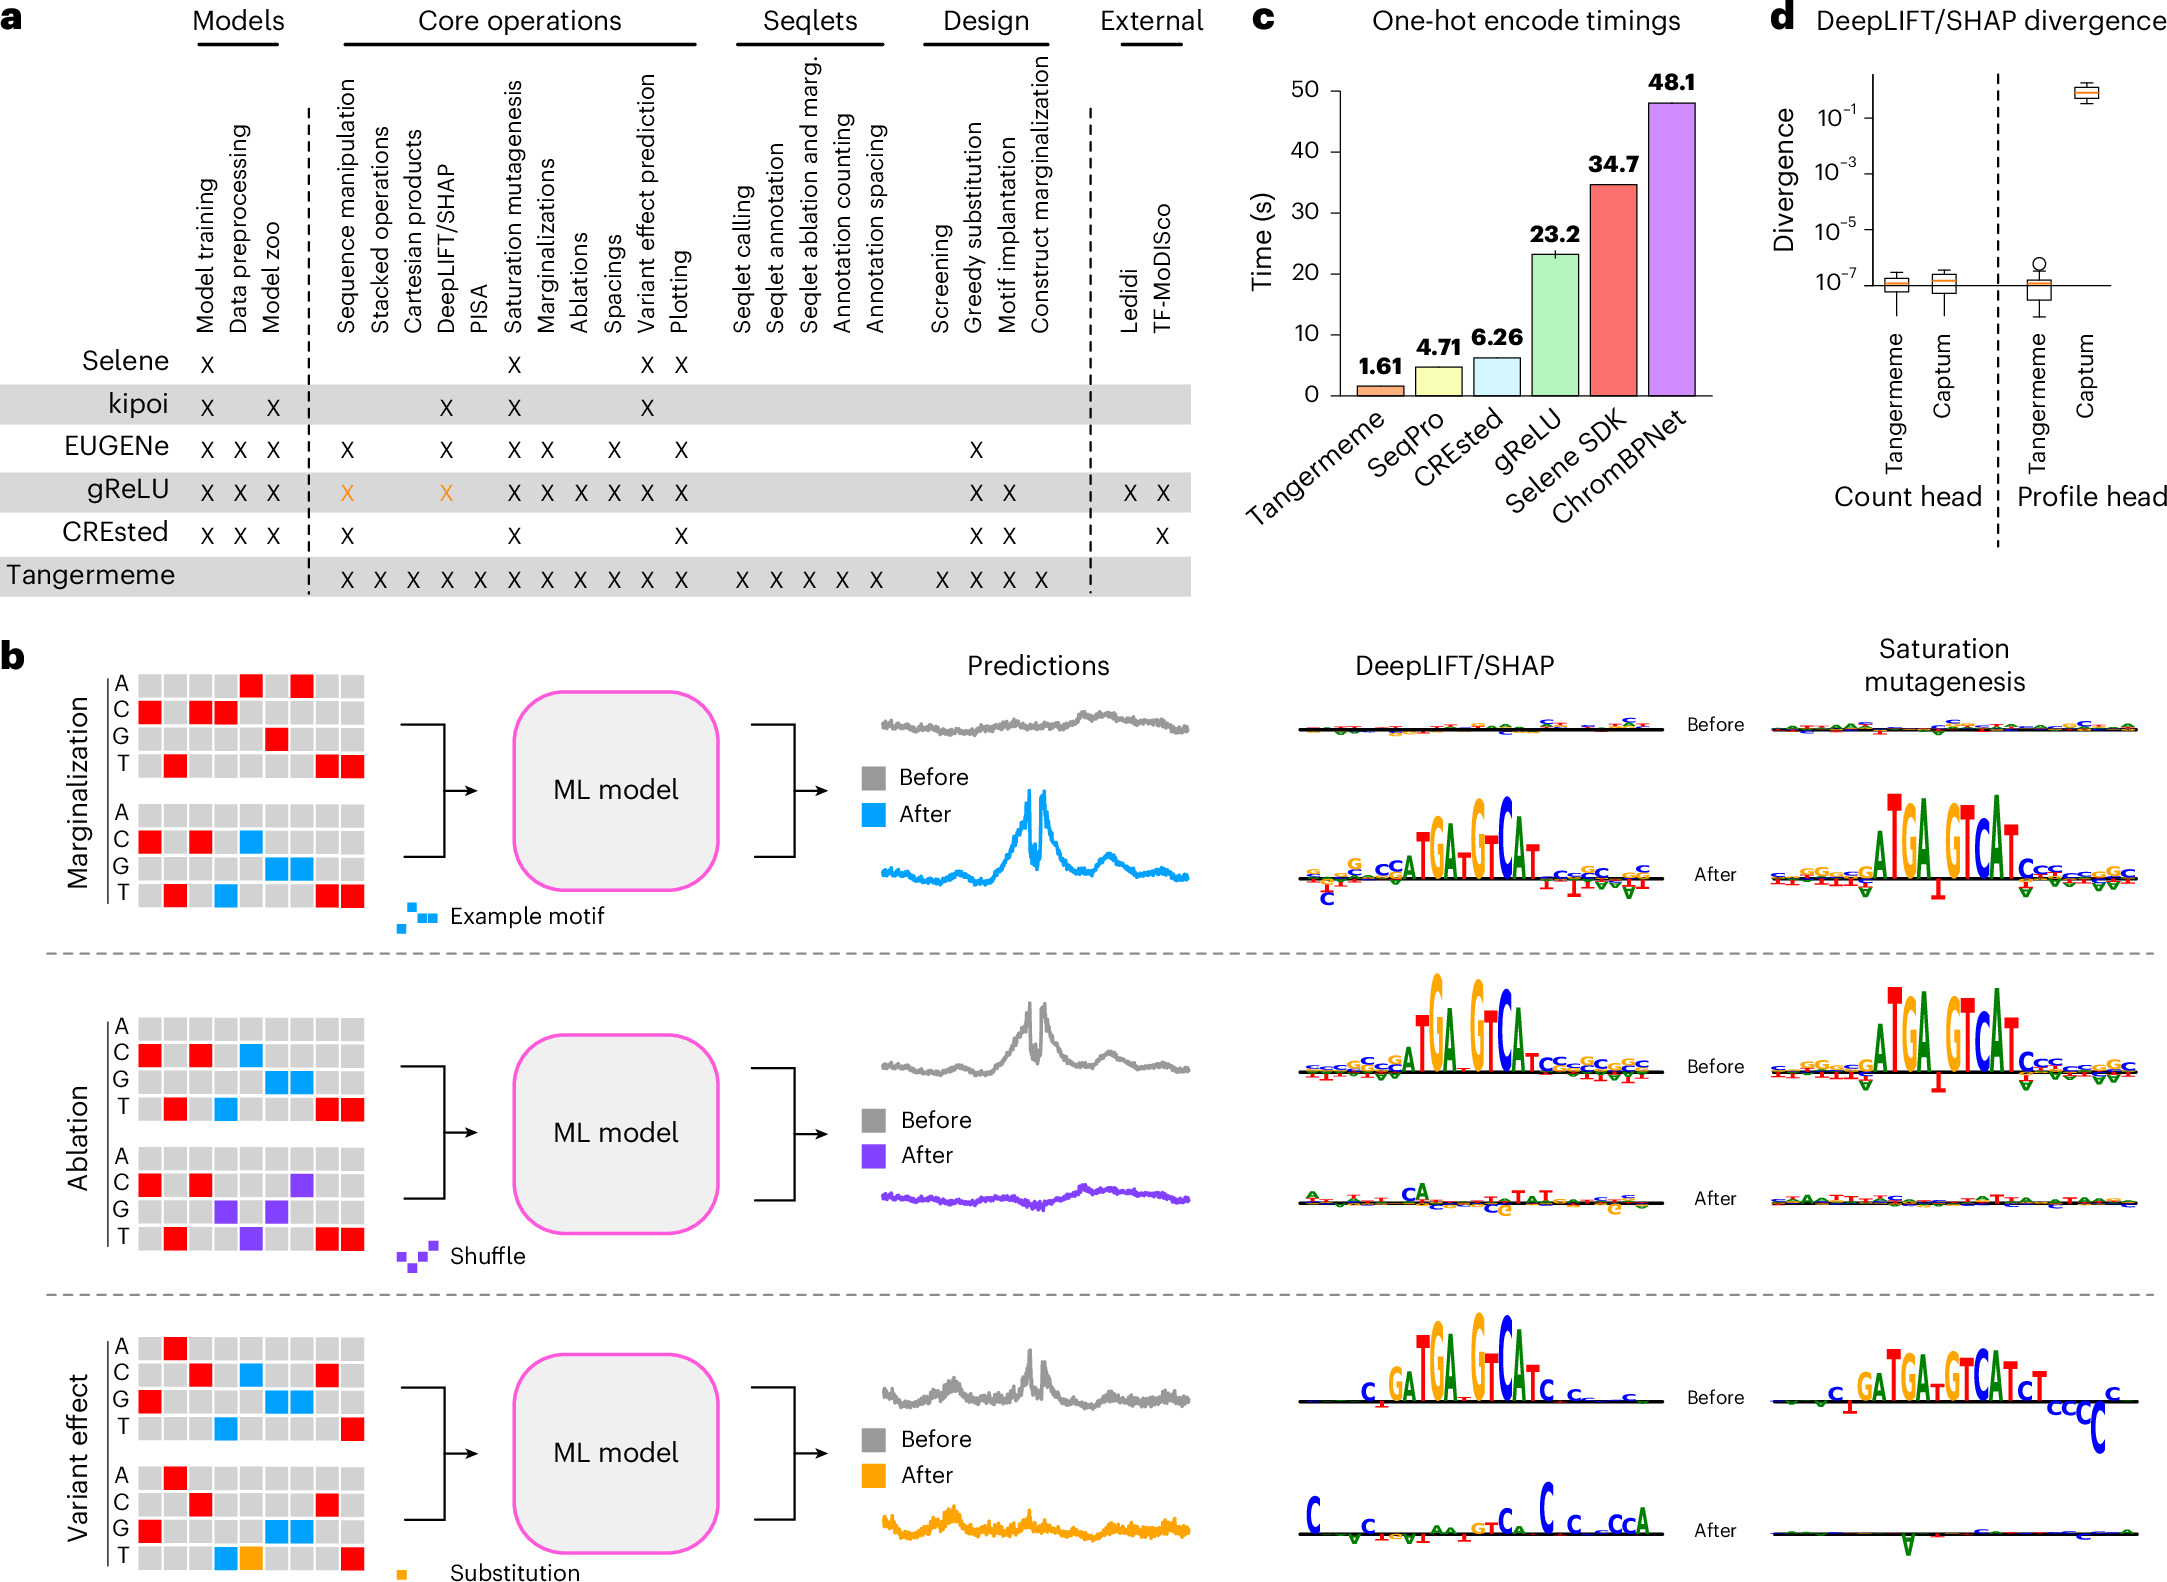
图:中间三行分别示范插入序列模式、打乱目标片段和替换碱基后,模型预测与归因如何改变。右上角的速度比较测量的是 one-hot 编码耗时,区别于下图的 seqlet 提取流程。(来源:Schreiber,Nature Methods,原文图 1;CC BY 4.0)
来源: Tangermeme: a toolkit for understanding cis-regulatory logic using deep learning models|Nature Methods|https://www.nature.com/articles/s41592-026-03254-z|2026-10-08|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议简报(Brief Communication,开源基因组模型解释工具)
主动学习闭环为药物化学补出稀缺反应数据
这套闭环方法由 Roche 与 ETH Zurich 团队开发,让主动学习挑选最值得做的 C--H 硼化实验,再用几何图神经网络预测反应是否发生以及发生在哪个位置。该研究于 10 月 9 日发表于 Nature Computational Science。研究团队通过前瞻性实验建立了 6,865 条二元反应结果、覆盖 812 个底物的数据集,并给出原子层级的区域选择性标注;在含有棘手 N-杂芳基的新底物测试中,模型对所有案例都找到了正确硼化位置。实验预算由模型分配,新增结果再回流到模型,小数据化学里的采样和预测因此接成了一个闭环。
来源: Advancing chemical reaction prediction in data-scarce drug discovery with active and geometric deep learning|Nature Computational Science|https://www.nature.com/articles/s43588-026-01063-0|2026-10-09|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Article,主动学习与前瞻性化学实验)
机器学习辅助定向进化,提高植物 Rubisco 的固碳效率
Rubisco 是植物固定二氧化碳的关键酶,但反应慢、也容易与氧气竞争;这项工作用结构信息蛋白模型 ESM-IF1 选择更值得尝试的突变位点。该研究于 10 月 7 日在线发表于 Science Advances。研究团队先在依赖 Rubisco 的大肠杆菌中筛选突变库,再检查候选酶能否在植物叶绿体中组装,其中 T391I 突变使羧化速率提高 29%、有氧羧化效率提高 43%。结果说明蛋白语言模型可以把定向进化带到天然植物谱系较少探索的序列区域,当前验证落在酶动力学、细菌筛选和叶绿体组装层面。
来源: Machine learning-assisted directed evolution of plant Rubisco|Science Advances|https://www.science.org/doi/10.1126/sciadv.aeh3246|2026-10-07(在线发表)|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Research Article,蛋白模型指导与湿实验验证)
AI 天气模型从其他地区"迁移"出迪拜极端降雨信号
这项环境研究检查 GraphCast、AIFS 和 FuXi 能否预测 2024 年迪拜创纪录暴雨,以及模型究竟从哪里学会这种当地训练数据中几乎没有的事件。该研究于 10 月 7 日发表于 Science Advances。GraphCast 和 AIFS 最长提前 8 天给出有效预报,FuXi 也捕捉到事件但低估了雨量;微调和感受野分析支持一种"跨区域迁移"解释,即模型利用了其他地区动力学相似、强度相当或更高的事件。研究还发现,对全球分布尾部事件的预报仍不稳定,问题不只来自样本不均衡,也与模型优化中的频谱偏差有关。
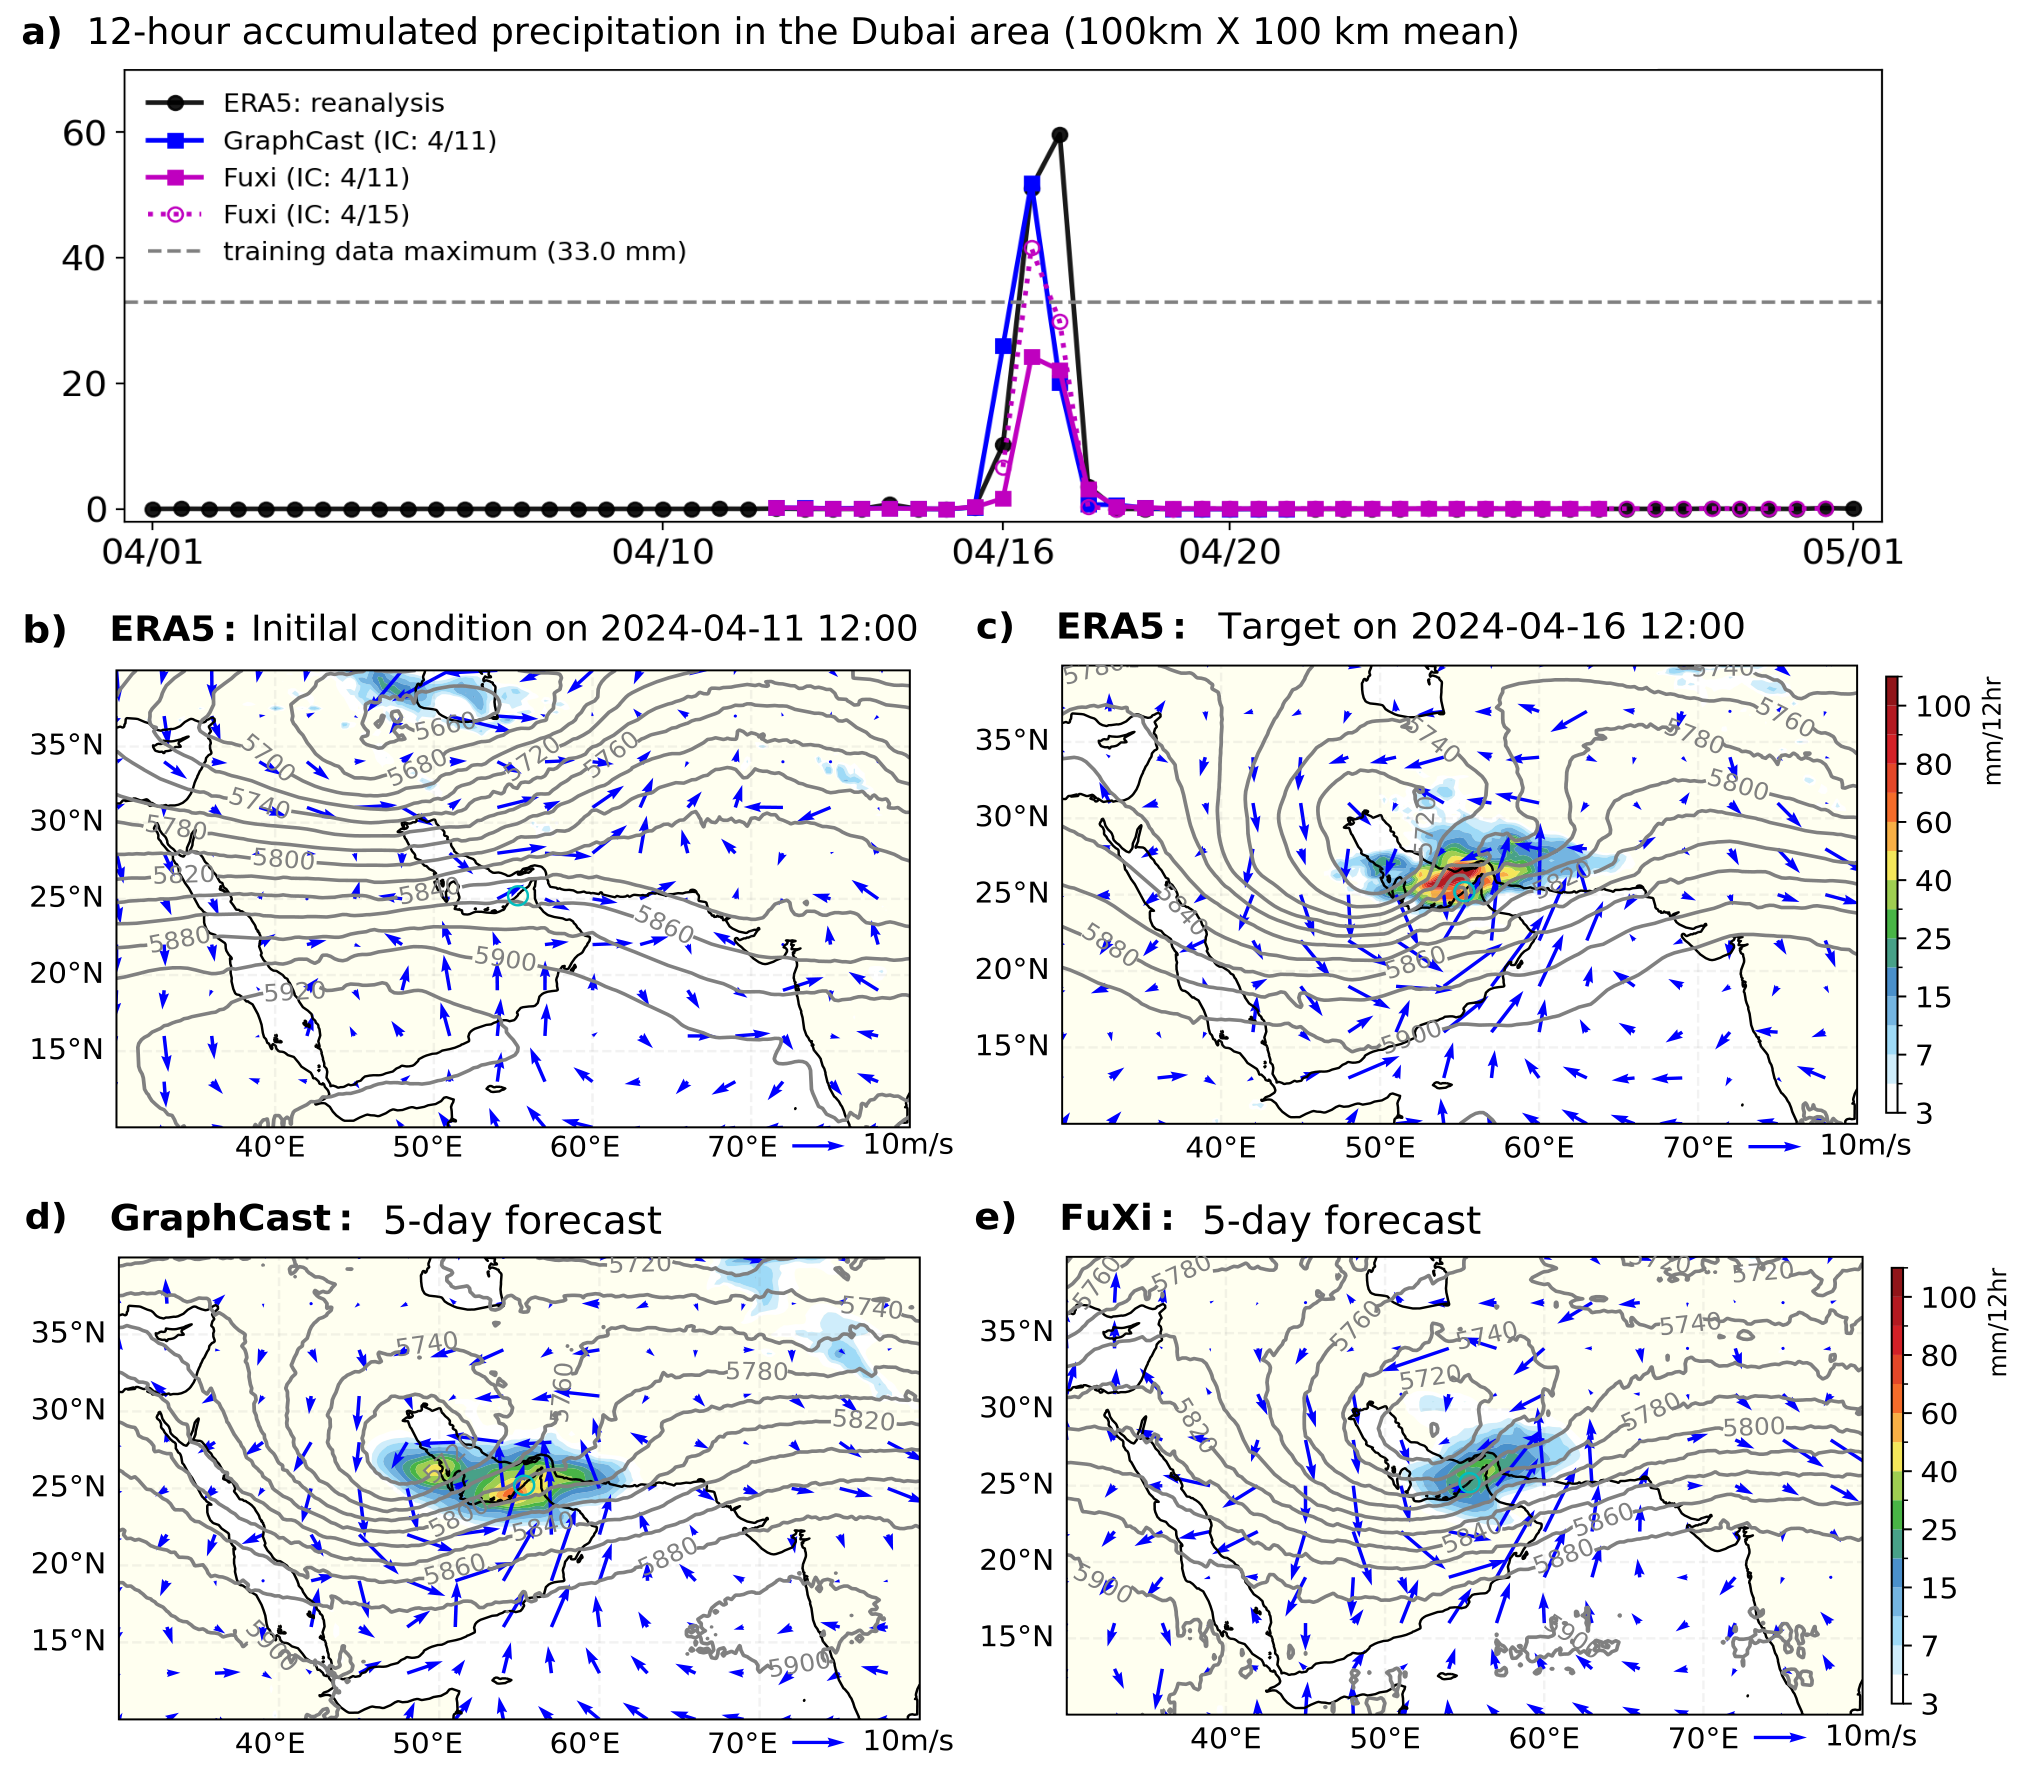
图:上方对比降雨时序,黑线为 ERA5 再分析数据,蓝线与粉线分别为 GraphCast、FuXi 预报;下方对比事件期间的环流、降雨分布与提前五天预报。再分析数据融合观测与模型,用作这里的对照。(来源:作者预印本 v3,图 1)
来源: Predicting regional gray swans via translocation: AI weather models and Dubai's unprecedented 2024 rainfall|Science Advances|https://www.science.org/doi/10.1126/sciadv.ady9406|2026-10-07|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Research Article,极端天气预测机制分析)
通用 LLM 用迭代提示搜索低能晶体组成
这项材料工作把通用 LLM 当作受约束的晶体组成生成器,让模型根据上一轮候选的能量反馈继续提议,而不为具体材料任务重新微调。该研究于 10 月 9 日发表于 npj Computational Materials。以 Elpasolite 无机晶体空间为基准,迭代提示平均找回目标区域内 约 96% 的低能组成,并与专门训练的生成对抗网络、变分自编码器和强化学习模型比较。目前展示的是基于预计算形成能的组成搜索能力,论文没有报告这些候选已经完成实验合成。
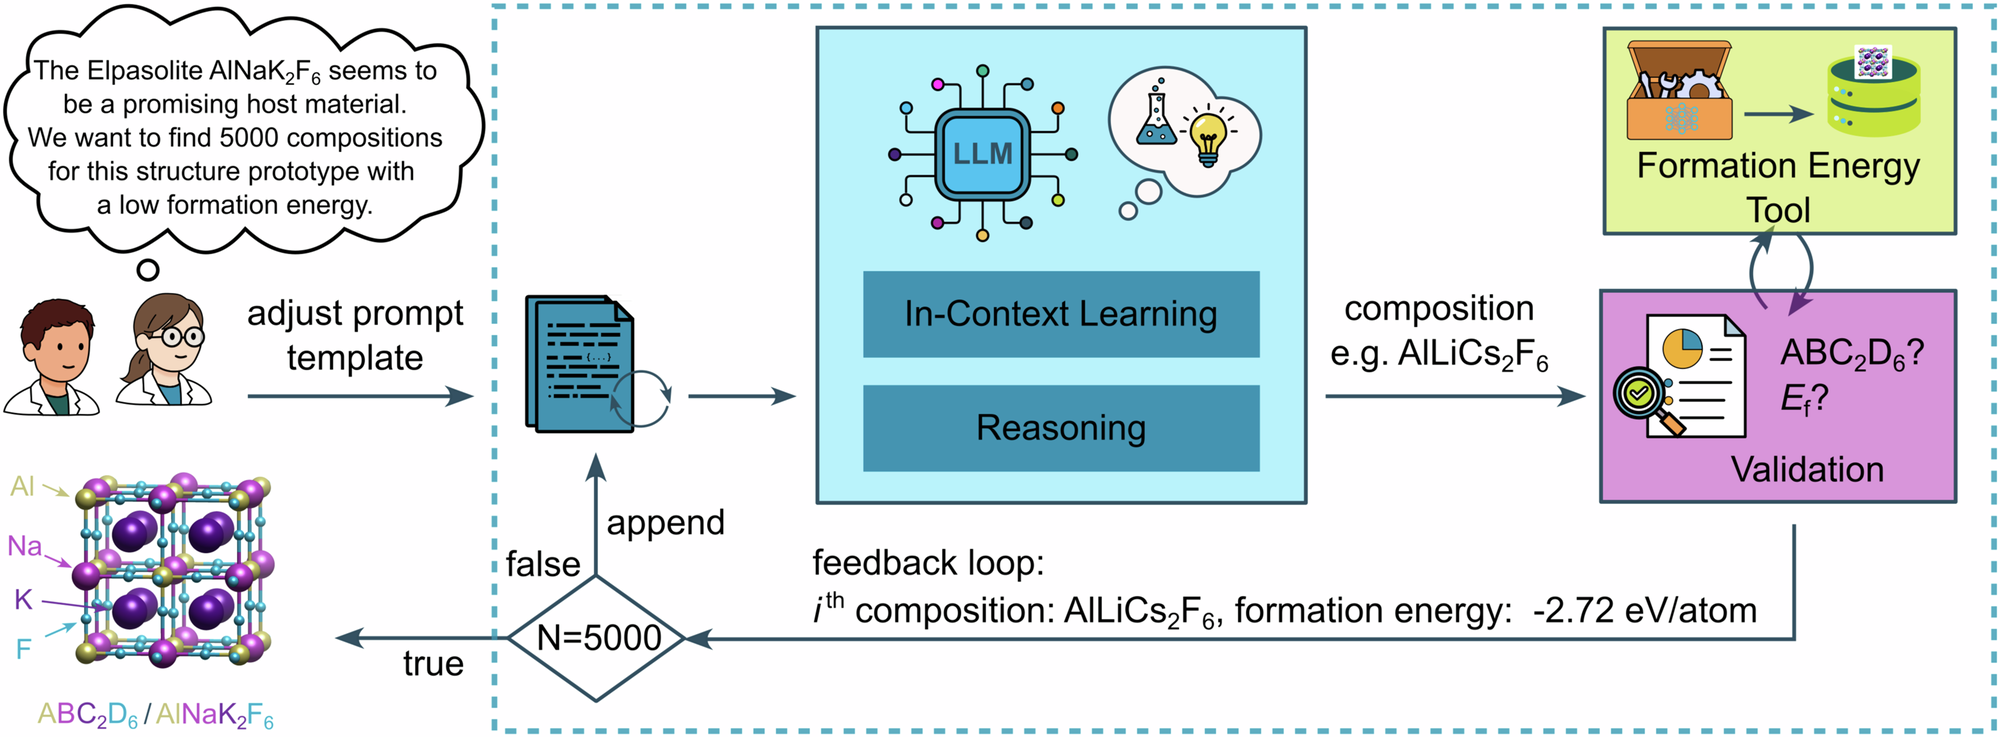
图:模型提出晶体组成后,候选经过有效性检查与形成能评估,结果再写回提示,推动下一轮生成。沿底部反馈箭头观察,搜索如何由一次提案变成连续迭代。(来源:npj Computational Materials,原文图 1)
来源: General-purpose LLMs as constrained crystal composition generators|npj Computational Materials|https://www.nature.com/articles/s41524-026-02339-9|2026-10-09|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议研究论文(Article,材料组成生成计算评测)
行业资讯与应用进展:从研究到落地
Google Earth AI 把"地点表示"接进五类公共卫生任务
Population Dynamics Foundation Model(PDFM)是 Google Earth AI 的地理基础模型,它把隐私保护的搜索趋势、人口流动、建成环境、天气和空气质量压缩成按月更新的地点向量。10 月 6 日,Google Research 公布五个合作方评估,覆盖麻疹疫苗接种、心血管死亡、登革热、产后抑郁和霍乱预警。跨美加边境的 MMR 接种率案例中,加入加拿大一侧信息后,模型解释的变异比例由 16% 提高到 22%;墨西哥登革热案例里,一个月预测在最多 72% 的活跃传播市镇中改善。模型的意义在于让流行病学团队直接复用"地点上下文",不必为每种疾病重新整理全部空间数据管线。
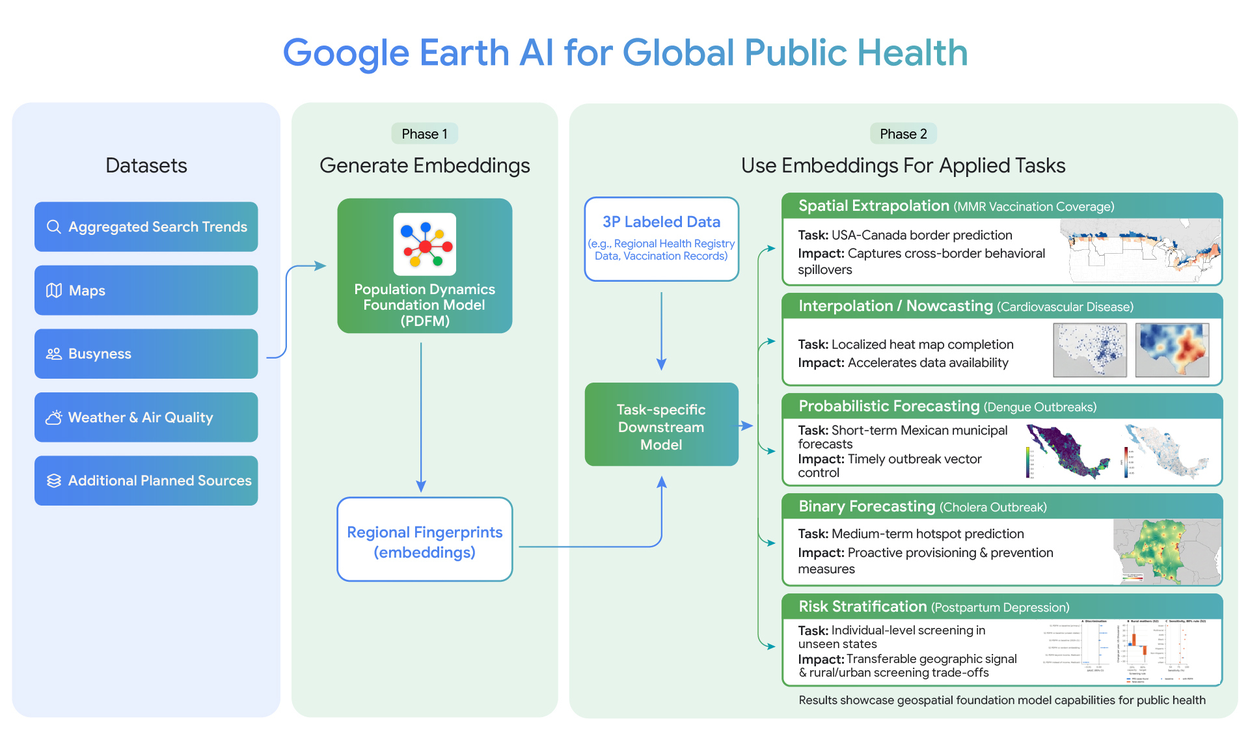
图:PDFM 把人口活动、建成环境和环境信号压缩成地点表示,再接入不同公共卫生任务。(来源:Google Research 原文)
来源: Unlocking Earth AI's planetary geospatial foundation models for global public health|Google Research|https://research.google/blog/earth-ais-planetary-geospatial-foundation-models-for-global-public-health/|2026-10-06|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:公司官方研究博客与合作方案例汇总
Microsoft Quine:将生物学预测与实验反馈接成闭环
Quine 是 Microsoft Research 开发的实验性生物学研究系统,帮助科学家从研究问题走到候选解释、预测和待验证的实验方案。生物学研究常要结合分子、细胞和组织层面的证据,而可做的实验数量有限;Quine 希望先用计算探索更多可能,再把实验资源用于更有信息价值的候选。
系统有两个相互配合的部分。生物学世界模型 学习基因组、蛋白质、化学、细胞状态和成像数据之间的联系,用于表示生物系统状态并预测干预后的变化;这里的"世界模型"是对生物过程的计算表示。工具编排层则协助拆解问题、调用模型和科学工具、查阅文献、比较证据并修订方案。科学家选择方案开展湿实验,也就是对真实生物样本进行测量,再据结果调整下一轮问题。这种流程的价值在于让预测持续接受实验检验。
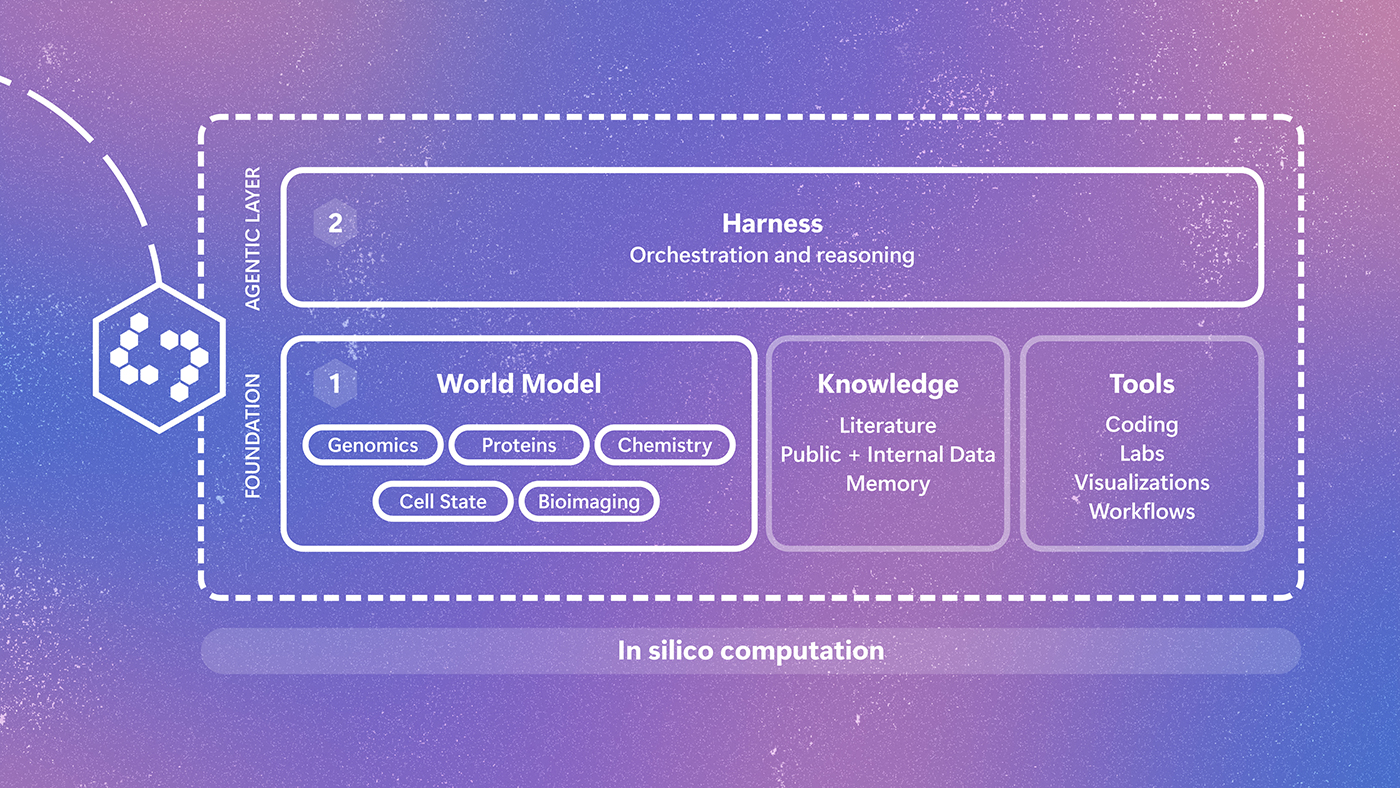
图:沿箭头观察研究问题如何变成待测方案,以及实验测量如何回到科学家,推动下一轮研究。(来源:Microsoft Research 官方公告)
胰腺癌实验案例。 细胞状态可以理解为细胞当前的基因表达与功能模式,既受遗传因素影响,也受周围环境影响。微软与 Broad Institute 的既有研究据此探索细胞状态与药物响应的关系。在胰腺导管腺癌(PDAC)案例中,微软称 Quine 对数千种化合物排序,优先候选在多项湿实验中产生了较大的经典型(classical)向基底样(basal)转录状态变化。这里测量的是细胞状态转变,治疗获益仍需另行验证。公告所述"一个周末"指缩小搜索范围、形成待实验候选的筛选过程。
开放方式与证据边界。 项目现阶段通过 Quine Fellows 与部分研究合作提供有限访问。官网列出的 Fellows 申请期为 2026 年 9 月 29 日至 11 月 2 日,研究期为 2027 年 6 月 7 日至 9 月 24 日,关注蛋白质与酶设计、细胞状态干预及早期治疗研究等方向;获得访问需经过遴选。当前查阅的公告和项目资源页未提供足以独立复现上述 Quine 筛选案例的完整方法、对照与重复实验信息,因此案例效果和效率按企业自述处理。官网所列既有论文可帮助理解研究基础,Quine 新系统的可重复性与跨任务表现仍需后续评估。官方将其限定为研究用途,输出需专家审查和实验验证。
相关资源: 项目主页与 Fellows 计划;研究背景与论文索引。
来源: Introducing Quine: An AI research system designed for the complexity of biology|Microsoft Research|https://www.microsoft.com/en-us/research/blog/introducing-quine-an-ai-research-system-designed-for-the-complexity-of-biology/|2026-09-29|访问日期:2026-10-10(Asia/Shanghai)|来源类型:公司官方研究博客(跨期补充;案例效果与效率为企业自述)
补充来源: Quine 项目主页、Quine: Our Research Journey|Microsoft Research|https://microsoft.github.io/quine/;https://microsoft.github.io/quine/blog/our-research-journey/index.html|页面未统一标注发布日期|访问日期:2026-10-10(Asia/Shanghai)|来源类型:官方项目说明、Fellows 信息与既有研究索引
临床试验 AI 从选点延伸到数据流水线
这组实践来自 AWS 生命科学研讨会,展示药企怎样把预测模型和 AI Agent 放进临床试验规划、选点、数据整理与供应链。10 月 4 日,AWS 汇总 Merck、Bayer、Novartis 等六家机构的流程案例:Merck 与 BCG 建立的 STRIDE 根据历史入组速度、启动时间和零入组风险解释性排序试验中心。Bayer 则把临床、生物标志物、药代和影像数据汇入统一环境,并称自动化 ETL Agent 把一条临床生物标志物流从数月缩短到 2 周。这些结果由 AWS 与参会企业自报,文章没有给出独立对照评估。
来源: Highlights from Clinical Trials at the 2026 AWS Life Sciences Symposium|AWS for Industries|https://aws.amazon.com/blogs/industries/highlights-from-clinical-trials-at-the-2026-aws-life-sciences-symposium/|2026-10-04|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:公司官方行业博客与客户案例汇总(企业自报)
ATUSA 把乳腺超声采集做成标准化自动扫描
ATUSA 是 iSono Health 开发的可穿戴自动 3D 乳腺超声平台,用 AI 控制图像采集并减少手持探头带来的操作者差异。10 月 5 日,NVIDIA 介绍该 FDA-cleared 平台已经在美国多州合作诊所投入使用,每侧乳房约两分钟完成标准化扫描;其采集模型训练于超过 150 万帧超声图像。公司称 3D 扫描相对手持 2D 超声灵敏度高 28%,同时一项由 UC Davis 和 Vanderbilt 牵头、纳入 3,200 人的多中心研究仍在进行。性能数字来自 NVIDIA 与企业披露,正在进行的多中心研究尚未给出结果。
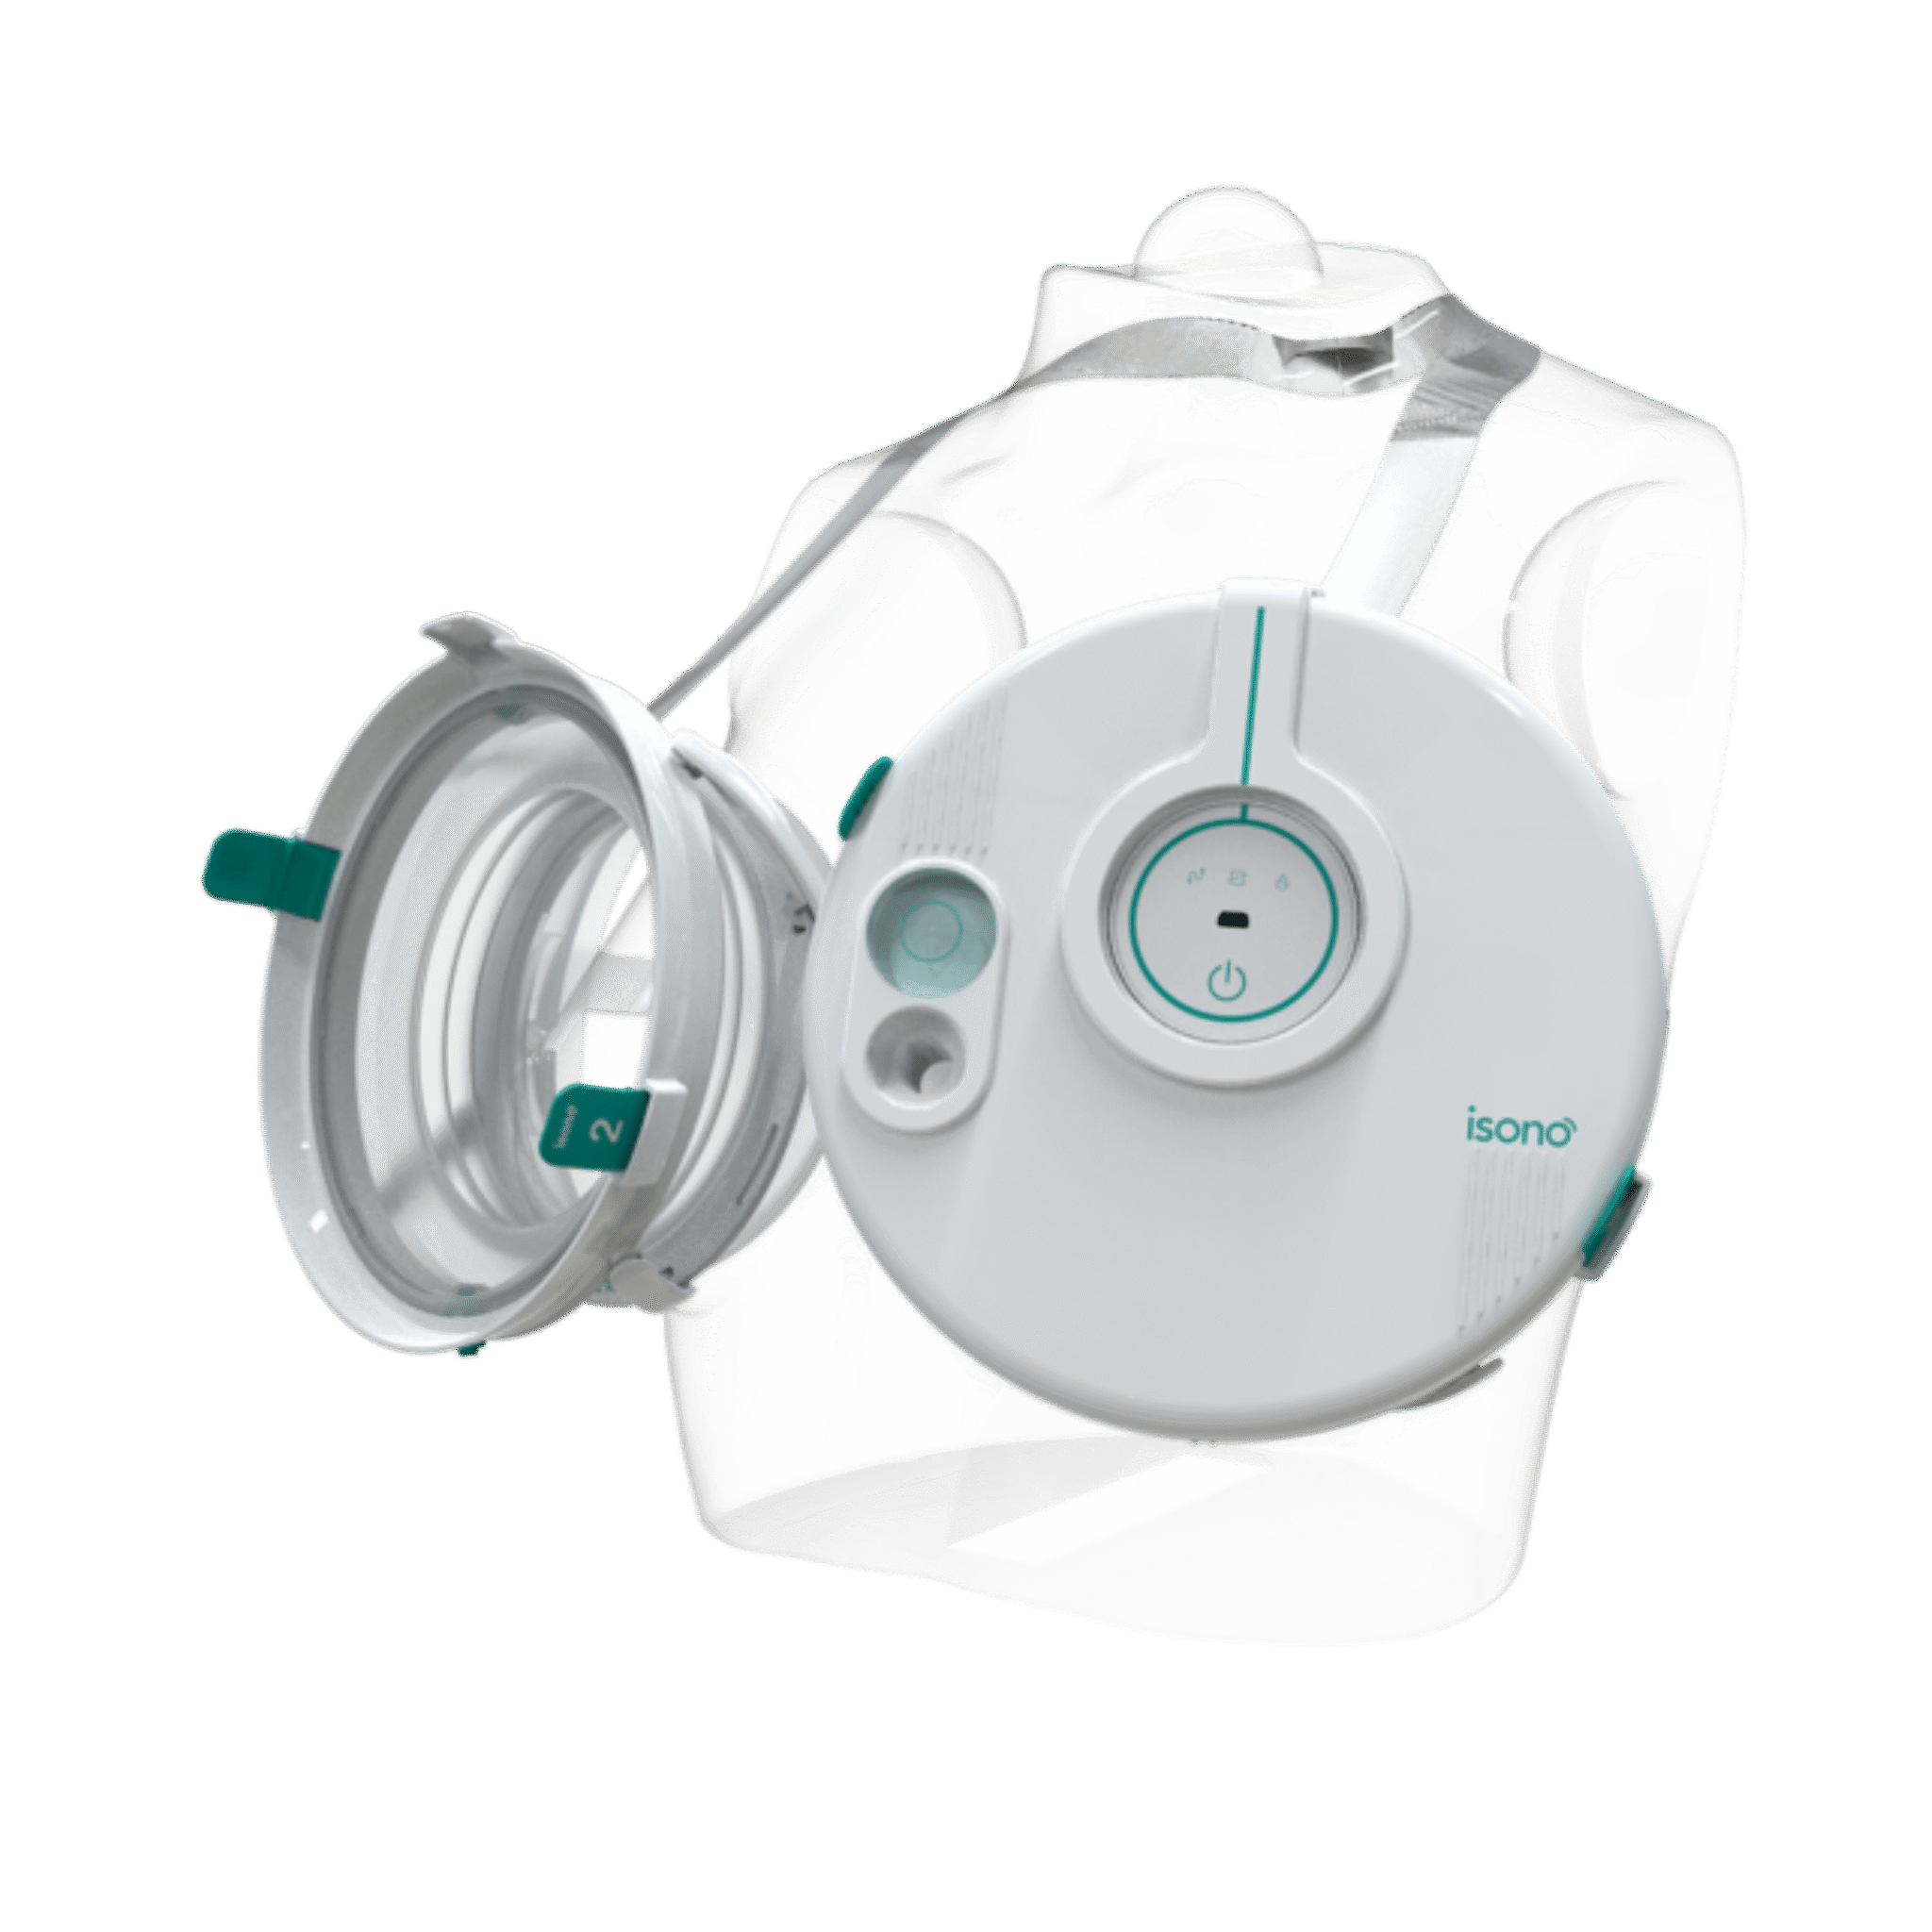
图:ATUSA 的扫描器与可穿戴附件。结合正文观察它怎样固定采集位置,以减少手持探头造成的操作者差异。(来源:iSono Health 官方产品展示)
来源: From Scan to Treatment Plan, AI Helps Close Breast Cancer's Deadliest Gaps|NVIDIA Blog|https://blogs.nvidia.com/blog/ai-breast-cancer-startups/|2026-10-05|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:公司官方客户案例(监管状态与企业自报性能并列)
NVIDIA 承诺五年投入 10 亿美元支持美国科学计算
这项计划是 NVIDIA 面向美国高校、国家实验室、量子计算和政府科研云的资金与基础设施承诺,重点覆盖医疗、能源和材料等科学方向。10 月 8 日,公司宣布未来五年投入价值 10 亿美元的资源,并参与 Genesis Mission 第二阶段中量子计算、聚变、加速器设计和微电子等项目。计划延续 NVIDIA 与美国国家实验室的合作,也把算力、模型和云服务商支持放进同一套科研基础设施安排。公告描述的是未来承诺和合作范围,不是已经完成的投入或科研产出。
来源: NVIDIA Commits $1 Billion to Advance US Science Over the Next Five Years|NVIDIA Newsroom|https://nvidianews.nvidia.com/news/nvidia-commits-1-billion-to-advance-us-science-over-the-next-five-years|2026-10-08|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:公司官方新闻稿(投资承诺与前瞻性声明)
政策动态与专家观点:规则、资金与方向
公共部门和期刊本周关注的共同问题,是怎样准备能训练生物模型的数据、怎样让临床预测代码可复现,以及怎样把实验室自动化的证据延伸到工业尺度。
NIH 启动 Bio Genesis 数据协作,目标是可预测的人体生物模型
Bio Genesis Mission 是 NIH 在美国 Genesis Mission 下推进的生物医学计划,准备把现有数据库、国家级数据基础设施和研究项目整理成适合训练预测性生物模型的资源。10 月 7 日,NIH 宣布与美国能源部、Biohub 等合作,围绕细胞在疾病和干预下的响应建设可标准化、可计算的数据。公告明确指出,现有数据尚未覆盖足够多的细胞类型、干预条件和测量尺度,因此合作同时包括数据标准化与更高通量的细胞测量技术。工作重点由"再建一个模型"前移到怎样获得跨项目一致、可重复使用的训练数据。
来源: NIH joins effort to build SI-ready data for predictive models of human biology|National Institutes of Health|https://www.nih.gov/news-events/news-releases/nih-joins-effort-build-si-ready-data-predictive-models-human-biology|2026-10-07|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:美国政府科研机构新闻稿(跨机构数据与模型计划)
临床预测论文中,真正共享代码的只有约八分之一
这项分析用 LLM 辅助筛查临床诊断和预后模型论文,再人工检查代码仓库是否具备复用条件。该研究于 10 月 9 日发表于 Nature Medicine。研究团队从 3,967 篇符合条件的文章中找到 482 篇共享代码,占 12.2%;在可访问的 380 个仓库里,37.6% 标注依赖,21.6% 锁定依赖版本,只有 3.9% 带测试。作者正在据此开发 TRIPOD-Code 扩展,希望把"代码在哪、如何运行、环境怎样固定"纳入临床预测模型的报告规范。
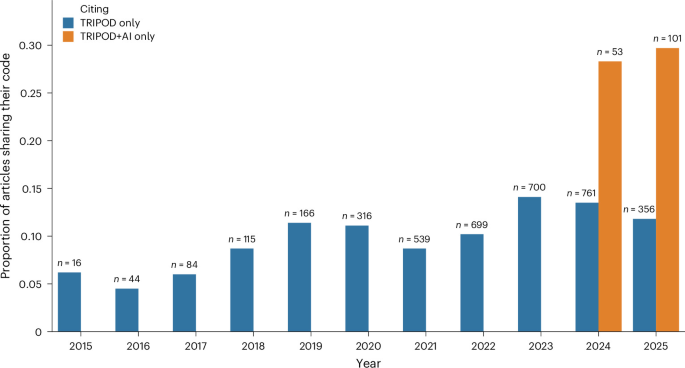
图:3,967 篇临床预测模型论文中,代码共享比例随年份的变化。(来源:Nature Medicine 原文)
来源: AI-assisted scoping review of code sharing in clinical prediction model research|Nature Medicine|https://www.nature.com/articles/s41591-026-04691-1|2026-10-09|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:同行评议范围综述与代码仓库审计(Analysis)
自驱动实验室走向工业,需要一张"尺度感知"的证据地图
"自驱动实验室"指把机器人实验、数据分析和下一轮实验选择连成闭环的自动化研发系统。10 月 8 日,Nature Synthesis 编辑部文章讨论这类系统怎样从实验室候选走向器件和工艺开发,并引用 Xiaonan Wang、Zhihao Wang 提出的尺度感知候选图景。其核心建议是把候选分别标为可进入下一尺度验证、受工业约束排除,或仍需定向实验降低尺度不确定性。这里表达的是期刊与专家对工业化证据组织方式的观点,不是一项新的实验结果或监管要求。
来源: The road to self-driving laboratories in industry|Nature Synthesis|https://www.nature.com/articles/s44160-026-01194-2|2026-10-08|访问时间:2026-10-10 09:33(Asia/Shanghai)|来源类型:期刊编辑观点(Editorial,工业自驱动实验室专题)