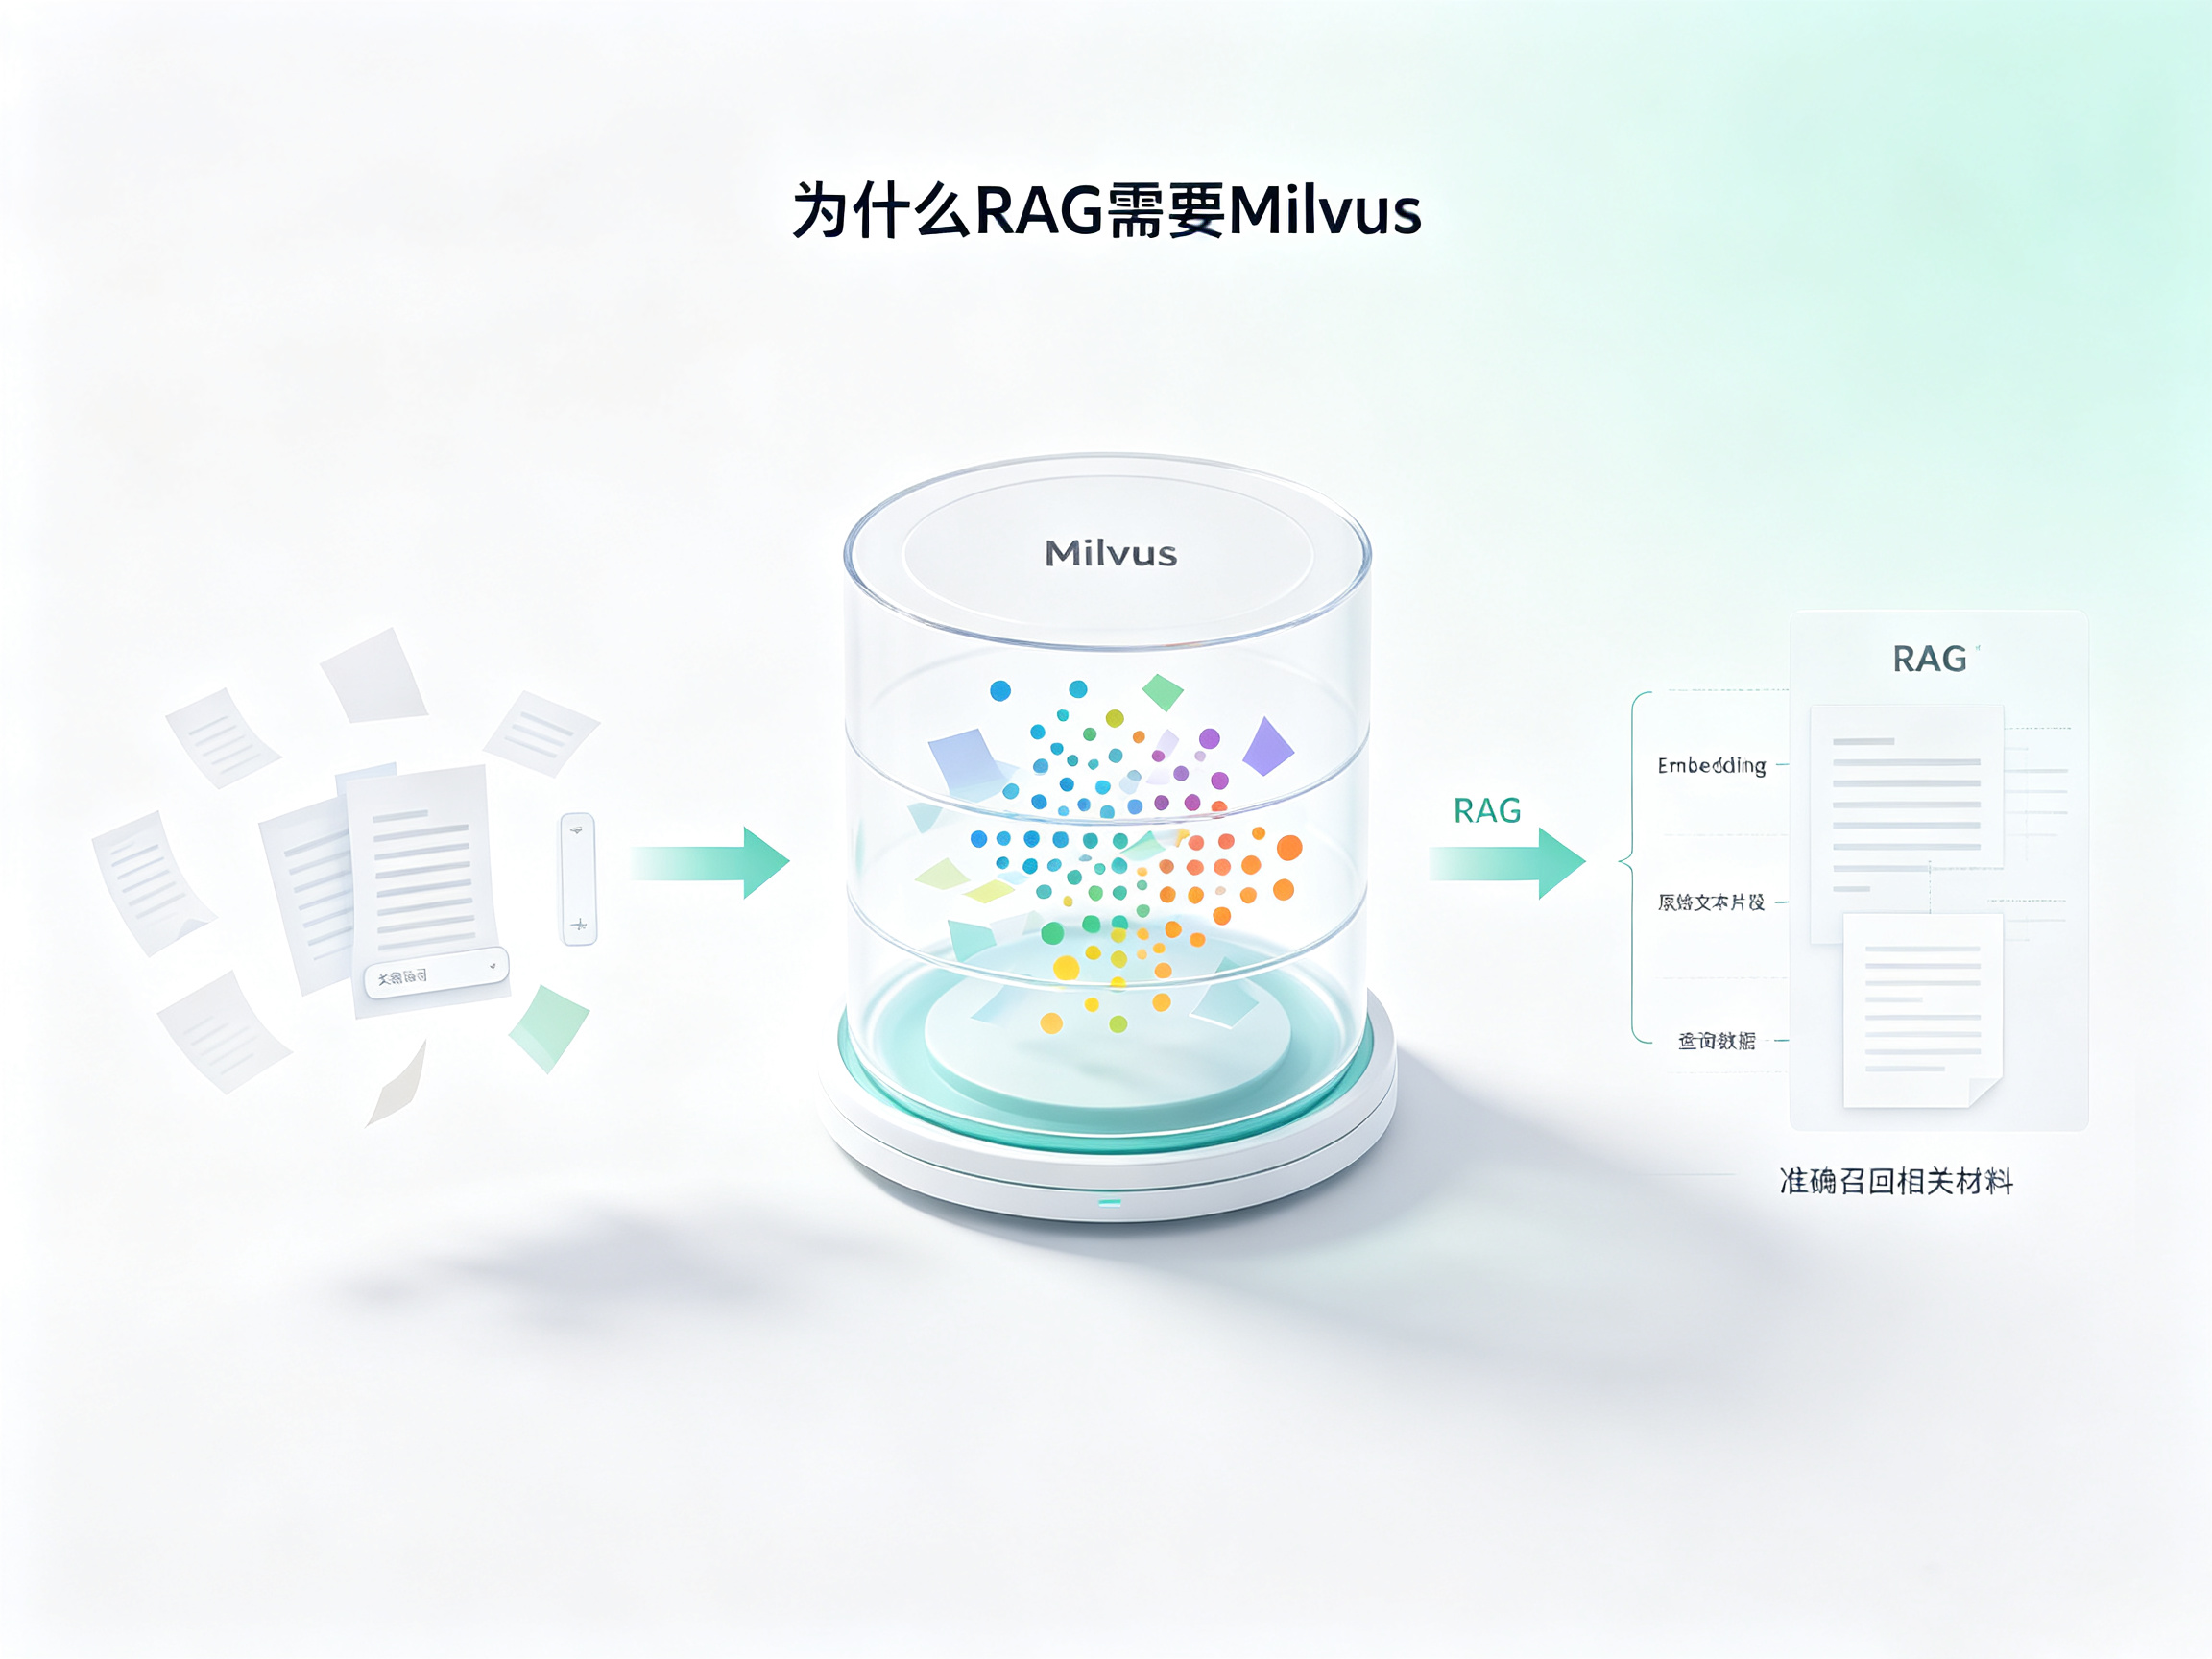
向量数据库解决的是大模型"的核心问题之一:"记不住、检索不准。RAG(检索增强生成)要让模型在回答前先找到相关材料,而相关材料靠语义相似度匹配,关系型数据库和关键词搜索框可能难以胜任这件事。Milvus 这类向量引擎存的是文本经过 Embedding 之后的高维向量,外加原始文本片段与元数据,查询时做近似最近邻搜索。本文从定义、存储结构、工程边界、系统分工、常见误区五个层面,讲清楚向量数据库在 RAG 里到底承担什么角色。
Milvus 是什么
Milvus 脱胎于传统检索系统的能力缺口。早年做相似图片搜索,团队用关系库存特征,再用 SQL 跑距离计算,数据量较大时性能可能受限。后来 FAISS 把向量检索做成独立库,社区在这个基础上补齐了分布式、持久化和多索引管理,Milvus 就是这类开源向量引擎中应用较多的一个。它的职责很窄:把向量收进来建好索引,查询时按相似度吐出最邻近的结果。它不碰业务表单和事务,只负责在高维空间里判断谁离谁近。以 1024 维 float32 向量为例,向量数据占用一定存储空间,普通硬盘放得下,检索速度则交给专门的索引结构。
向量数据库到底存了什么
很多人以为向量库只存一串数字,其实每条记录至少有三部分。第一是向量本身,文本经过 Embedding 模型转成固定维度的稠密数组,维度常见 768 或 1024。第二是原始文本片段,也就是切分后的那段话,检索到了要原样回给大模型当上下文,缺了原文模型只能凭空编。第三是元数据,记录来源文件、部门、时间、权限标签等字段,用于检索后的过滤。查询时系统不挨个算距离,而是用 ANN(近似最近邻)算法在索引上快速定位,HNSW 走图结构,IVF_FLAT 走聚类倒查,牺牲一定精度换取显著的速度提升,P99 延迟可控制在较低水平。向量、原文、元数据,这三样缺一不可。
为什么关系型数据库做不了
关系库擅长精确匹配和范围查询,给它一个订单号它能秒回,给它"意思相近的几段话"它就难以处理。相似度是连续空间里的距离运算,关系库的 B+ 树索引为等值比较设计,对高维向量的近邻查找没有合适结构。有人尝试在 MySQL 里加向量插件,小规模能跑,数据到千万级索引膨胀、查询变慢,扩展性可能受限。向量引擎从一开始按分布式设计,节点可以横向加机器,数据分片存、查询并行算,业务量翻倍加机器就行。一个被低估的事实是:系统上线后成本较高的一步不是买向量库,而是换 Embedding 模型要全量重算重灌,重跑一次可能耗时较长,架构得提前留好重批通道。
三层检索如何分工
单靠向量检索会漏掉精确术语。企业知识里"PO 单""MATNR 物料号"这类缩写,向量相似度不一定认得准,得靠 Elasticsearch 做关键词精确匹配。还有一类问题向量和关键词可能难以处理:A 部门和 B 部门谁归谁管、某个零件装在哪几条产线,这是实体之间的关系,要交给 Neo4j 这类图数据库用 Cypher 查。向量库承接语义层检索,ES 做字面精确匹配,实体关系落到图库。三层各管一段,合起来有助于覆盖更全面的检索需求。召回阶段三路各自返回 Top-K,再用 RRF(倒数排名融合)或 cross-encoder 重排,cross-encoder 把查询和候选句一起送进小模型打分,比直接加分数准,但慢,通常只在精排用十几条。融合策略比单路检索更值得投入,它在很大程度上影响进模型的那几段对不对。
唯一底座与数据串味
有一个误区是把向量库当唯一知识底座。向量库存的是语义切片,既无事务一致性也无权限模型,把它当主数据库用,财务数据和公开文档混在一起,出问题没法回滚。另一个误区更隐蔽:忽略元数据过滤。检索时如果不用部门、密级字段做前置过滤,研发部的设计文档会被销售部的提问召回,跨部门数据串味。工程上的做法是把租户 ID、部门标签写进每条记录的元数据,查询时先按元数据圈定范围,再在圈定范围内做向量近邻。余弦相似度的值域是 -1,1,BM25 是无界分数,两者量纲不同不能直接相加,naive 拼接不等于混合检索,必须走归一化或重排。
向量库解决"像不像",解决不了"连不连"
RAG 需要 Milvus,是因为语义检索通常需要向量引擎,关系库和搜索框可能难以胜任。向量库存的有三样:Embedding 向量、原文片段、元数据,靠 ANN 在毫秒级返回近邻。向量库能判断两段话意思近不近。两件事在业务上是否关联,需要图数据库和关键词引擎补位。把三层看成一个整体,RAG 的回答有助于提升准确性和依据性。
在小艾智能体的技术底座里,这套三层分工可作为参考架构。向量知识库可选用 Milvus,关键词精确匹配可交给 Elasticsearch,实体关系图谱可落到 Neo4j。三者通过动态 Agent 编排系统可串联为工作流,文档上传后先切分,随后向量化写入 Milvus 并建立索引,问答时三路召回再融合,可将沉淀的企业知识转为可引用的回答。文档处理引擎可覆盖 PDF、Word、Excel、图片等格式,BGE-M3(北京智源研究院发布)可将文本转为 1024 维向量写入 Milvus,元数据里带部门和权限标签,有助于降低数据串味的风险。