开篇
之前在搜集二进制恶意样本时,遇到了EMBER数据集。本来以为是一个二进制样本集,了解后才发现是从样本中提取的数据,并不包含原始样本,因此也就没有深入研究。为了满足下好奇心,这次抽时间来学习下,弄明白为什么会有这么一份纯数据集,它存在的目的是什么,用来解决什么问题。
EMBER最初由 Endgame 在 2018 年发布,全称是Endgame Malware BEnchmark for Research,后来 Endgame 被 Elastic 收购,这个项目也随之易主,全称就改成了:Elastic Malware Benchmark for Empowering Researchers。从名字可以看出,它的本质是一份基准数据集。
该数据集主要用于信息安全领域的机器学习研究------即提供一个规模庞大、开放且足够通用,能够涵盖多种典型用例的良性/恶意样本数据集。
在机器学习的计算机视觉领域有 MNIST、CIFAR、ImageNet,语音领域有 TIMIT,情感分析则有 Sentiment140------这些公开基准数据集,是各自领域能"科学地比较、可复现地进步"的前提。一个新方法好不好,大家放在同一个数据集上一跑,高下立判。
而在恶意软件检测领域,直到 2018 年,还没有这样一个公认的、公开的良性/恶意基准数据集。后果就是,各家用各家的私有样本、私有特征、私有切分,论文里报出的 99.x% 之间毫无可比性。
EMBER数据集的根本贡献,就是来填这个坑的,给恶意软件检测,造一个二进制检测机器学习领域的ImageNet。
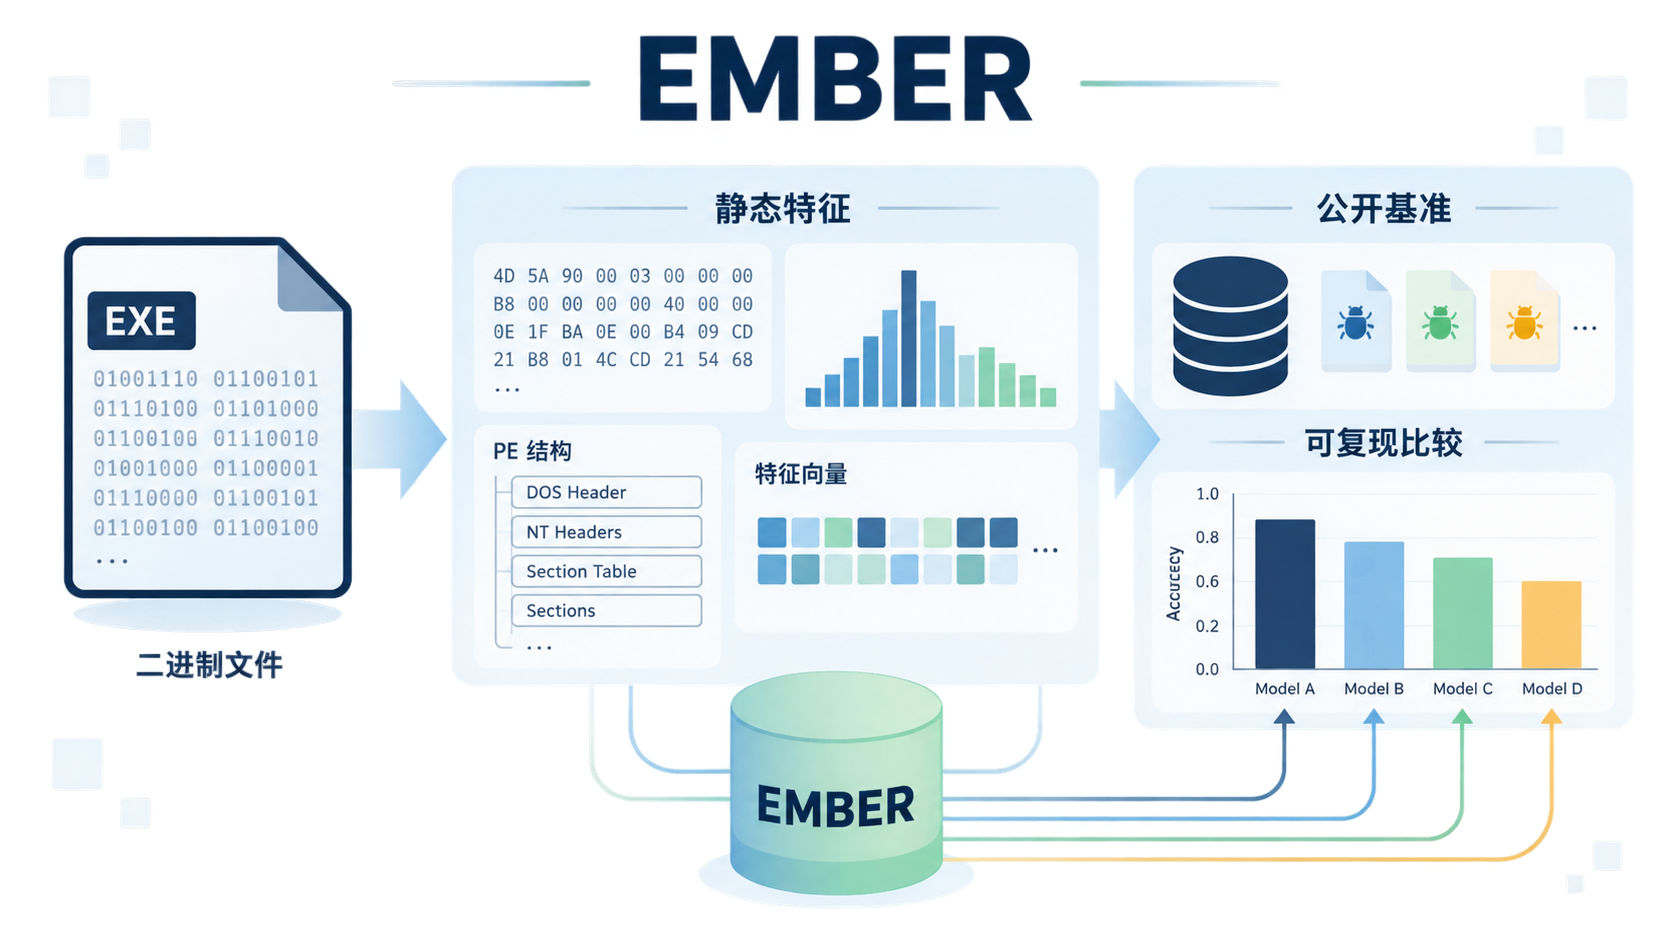
EMBER数据集按发布顺序,共有三个版本,EMBER2017、EMBER2018、EMBER2024,每一个版本都是上一个版本的升级。接下来我们按版本顺序来学习下这个数据集。
EMBER2017
EMBER2017是发布的第一个版本,它面向的问题是:不运行程序,仅根据 Windows PE 文件的静态特征,来判断它是恶意文件还是良性文件。
EMBER2017 包含从 110 万个 Windows PE 文件中提取的特征:
| 数据划分 | 恶意 | 良性 | 未标注 | 合计 |
|---|---|---|---|---|
| 训练集 | 30 万 | 30 万 | 30 万 | 90 万 |
| 测试集 | 10 万 | 10 万 | 0 | 20 万 |
该数据集依据 VirusTotal 多引擎检测结果来选择样本:良性样本没有任何一个引擎报毒,恶意样本需要有超过 40 个引擎报毒。
EMBER2017使用 LIEF二进制解析库来解析 PE 文件,单个样本的所有特征保存成一条JSON Line。特征被分为如下八组,下面是一条真实数据示例:
{ // 一条 EMBER2017 样本记录的开始
  "sha256": "000185977be72c8b007ac347b73ceb1ba3e5e4dae4fe98d4f2ea92250f7f580e", // 原始 PE 文件的 SHA-256 哈希,用作样本唯一标识
  "appeared": "2017-01", // 该文件首次被发现的大致月份
  "label": -1, // 样本标签:0 表示良性,1 表示恶意,-1 表示未标注

  "general": { // 文件的通用静态特征
    "size": 33334, // 文件在磁盘上的实际大小,单位为字节
    "vsize": 45056, // PE 文件加载到内存后的虚拟大小,单位为字节
    "has_debug": 0, // 是否包含调试信息:0 表示没有,1 表示有
    "exports": 0, // 文件导出的函数数量
    "imports": 41, // 文件导入的函数数量
    "has_relocations": 1, // 是否包含重定位信息
    "has_resources": 0, // 是否包含 PE 资源,例如图标、对话框或版本信息
    "has_signature": 0, // 是否包含 Authenticode 数字签名
    "has_tls": 0, // 是否包含线程局部存储 TLS 结构
    "symbols": 0 // 文件中包含的符号数量
  }, // 通用静态特征结束

  "header": { // PE 文件头特征
    "coff": { // COFF File Header 中的字段
      "timestamp": 1365446976, // PE 头中的编译时间戳,采用 Unix 时间戳形式
      "machine": "I386", // 目标处理器架构,这里表示 32 位 x86
      "characteristics": [ // PE 文件的整体属性
        "LARGE_ADDRESS_AWARE", // 程序能够处理较大的虚拟地址空间
        "EXECUTABLE_IMAGE" // 文件是一个可执行映像
      ] // COFF 属性列表结束
   }, // COFF File Header 结束

    "optional": { // PE Optional Header 中的字段
      "subsystem": "WINDOWS_CUI", // 运行子系统,这里表示 Windows 控制台程序
      "dll_characteristics": [ // 与加载安全机制有关的 DLL 属性
        "DYNAMIC_BASE", // 支持地址空间布局随机化 ASLR
        "TERMINAL_SERVER_AWARE" // 程序声明兼容 Windows Terminal Server
      ], // DLL 属性列表结束
      "magic": "PE32", // PE 类型,PE32 表示 32 位可执行文件
      "major_image_version": 1, // 映像主版本号
      "minor_image_version": 2, // 映像次版本号
      "major_linker_version": 11, // 生成该文件的链接器主版本号
      "minor_linker_version": 0, // 生成该文件的链接器次版本号
      "major_operating_system_version": 6, // 所需操作系统主版本号
      "minor_operating_system_version": 0, // 所需操作系统次版本号
      "major_subsystem_version": 6, // 所需子系统主版本号
      "minor_subsystem_version": 0, // 所需子系统次版本号
      "sizeof_code": 3584, // PE 中代码节的总大小
      "sizeof_headers": 1024, // DOS Header、PE Header 和节表的总大小
      "sizeof_heap_commit": 4096 // 程序启动时需要提交的堆空间大小
    } // Optional Header 结束
  }, // PE 文件头特征结束

  "imports": { // 文件的导入表,按 DLL 名称分组
    "KERNEL32.dll": [ // 从 Windows KERNEL32.dll 导入的函数
      "GetTickCount" // 获取系统启动后经过的毫秒数
    ] // KERNEL32.dll 导入函数列表结束
  }, // 导入表结束

  "exports": [], // 文件导出的函数列表;空数组表示没有导出函数

  "section": { // PE 节表信息
    "entry": ".text", // 程序入口点所在节的名称
    "sections": [ // PE 文件包含的所有节
      { // 第一个节的信息
        "name": ".text", // 节名称;.text 通常用于存放可执行代码
        "size": 3584, // 节在磁盘文件中占用的大小
        "entropy": 6.368472139761825, // 节内容的信息熵,较高时可能表示压缩、加密或加壳
        "vsize": 3270, // 节加载到内存后的虚拟大小
        "props": [ // 节的属性和访问权限
          "CNT_CODE", // 表示该节包含程序代码
          "MEM_EXECUTE", // 表示该节具有执行权限
          "MEM_READ" // 表示该节具有读取权限
        ] // 节属性列表结束
      } // 第一个节的信息结束
    ] // PE 节列表结束
  }, // PE 节表信息结束

  "histogram": [3818, 155, ..., 377], // 256维字节直方图;依次统计 0x00 至 0xFF 各字节值出现的次数

  "byteentropy": [0, 0, ..., 2943], // 256维字节---局部熵联合直方图,用于描述字节分布与压缩或加密程度

  "strings": { // 从文件中提取的可打印字符串统计特征
    "numstrings": 170, // 长度至少为 5 的可打印字符串数量
    "avlength": 8.170588235294117, // 可打印字符串的平均长度
    "printabledist": [15, ..., 6], // 96维可打印字符直方图,统计 ASCII 0x20 至 0x7F 的出现次数
    "printables": 1389, // 所有已提取字符串包含的可打印字符总数
    "entropy": 6.259255409240723, // 可打印字符分布的信息熵
    "paths": 0, // 类似 C:\ 的 Windows 文件路径数量
    "urls": 0, // 以 http:// 或 https:// 开头的 URL 数量
    "registry": 0, // 以 HKEY_ 开头的 Windows 注册表键数量
    "MZ": 1 // 字符串 MZ 的出现次数,可能表示文件中嵌入了其他 PE 文件
  } // 字符串统计特征结束
} // 一条 EMBER2017 样本记录结束
特征向量化
有了二进制样本的大量特征了,还需要将这些特征向量化,即把每个特征都转换成有意义的数字表示,才能用于机器学习算法的处理。
对于 JSONL 中的一条记录,EMBER 会先把它解析成字典,再对 8 组特征分别做数值转换、归一化或哈希编码,最后拼接成一个 2351 维向量。
总向量构成如下图所示:
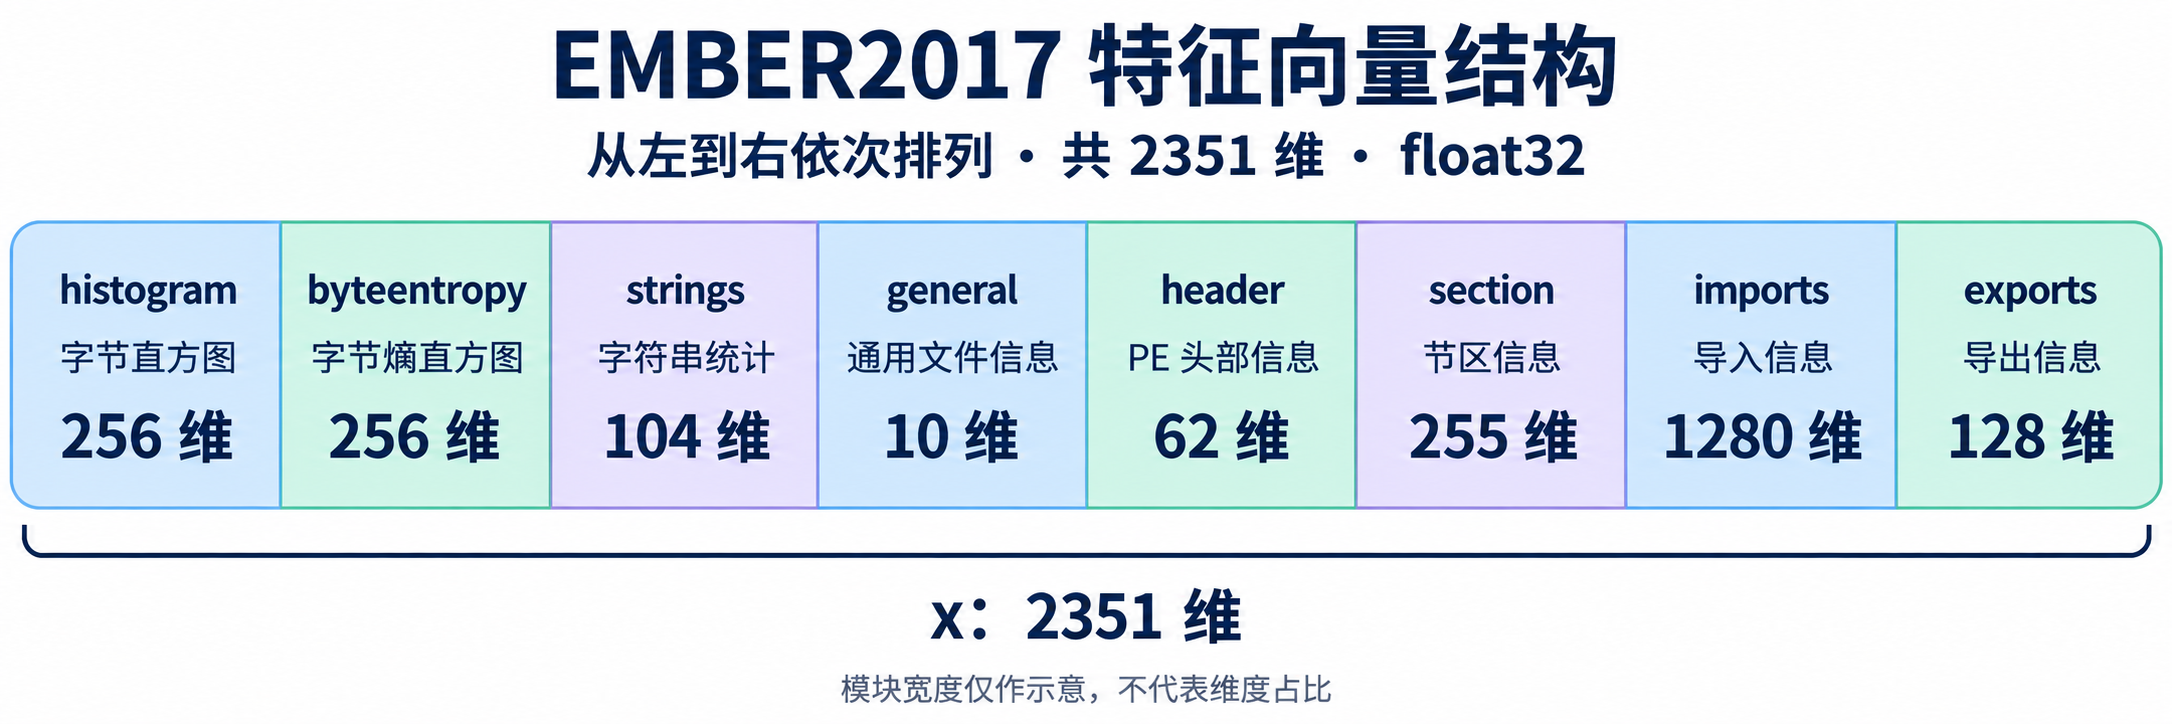
各组特征的具体处理方式如下。
histogram(字节直方图):把计数转换成比例
假设样本的部分 histogram 数据是:
[45521, 13095, 12167, ...]全部计数之和是 3101705,因此该部分数据向量化之后是一个256维的浮点数向量:
第 0 维 = 45521 / 3101705 ≈ 0.01467612
第 1 维 = 13095 / 3101705 ≈ 0.00422187
第 2 维 = 12167 / 3101705 ≈ 0.00392268
byteentropy 采用同样的归一化操作。
strings:部分归一化,部分直接保留
strings 字段里已经是提取好的统计信息。按下面的顺序直接转换为数组:
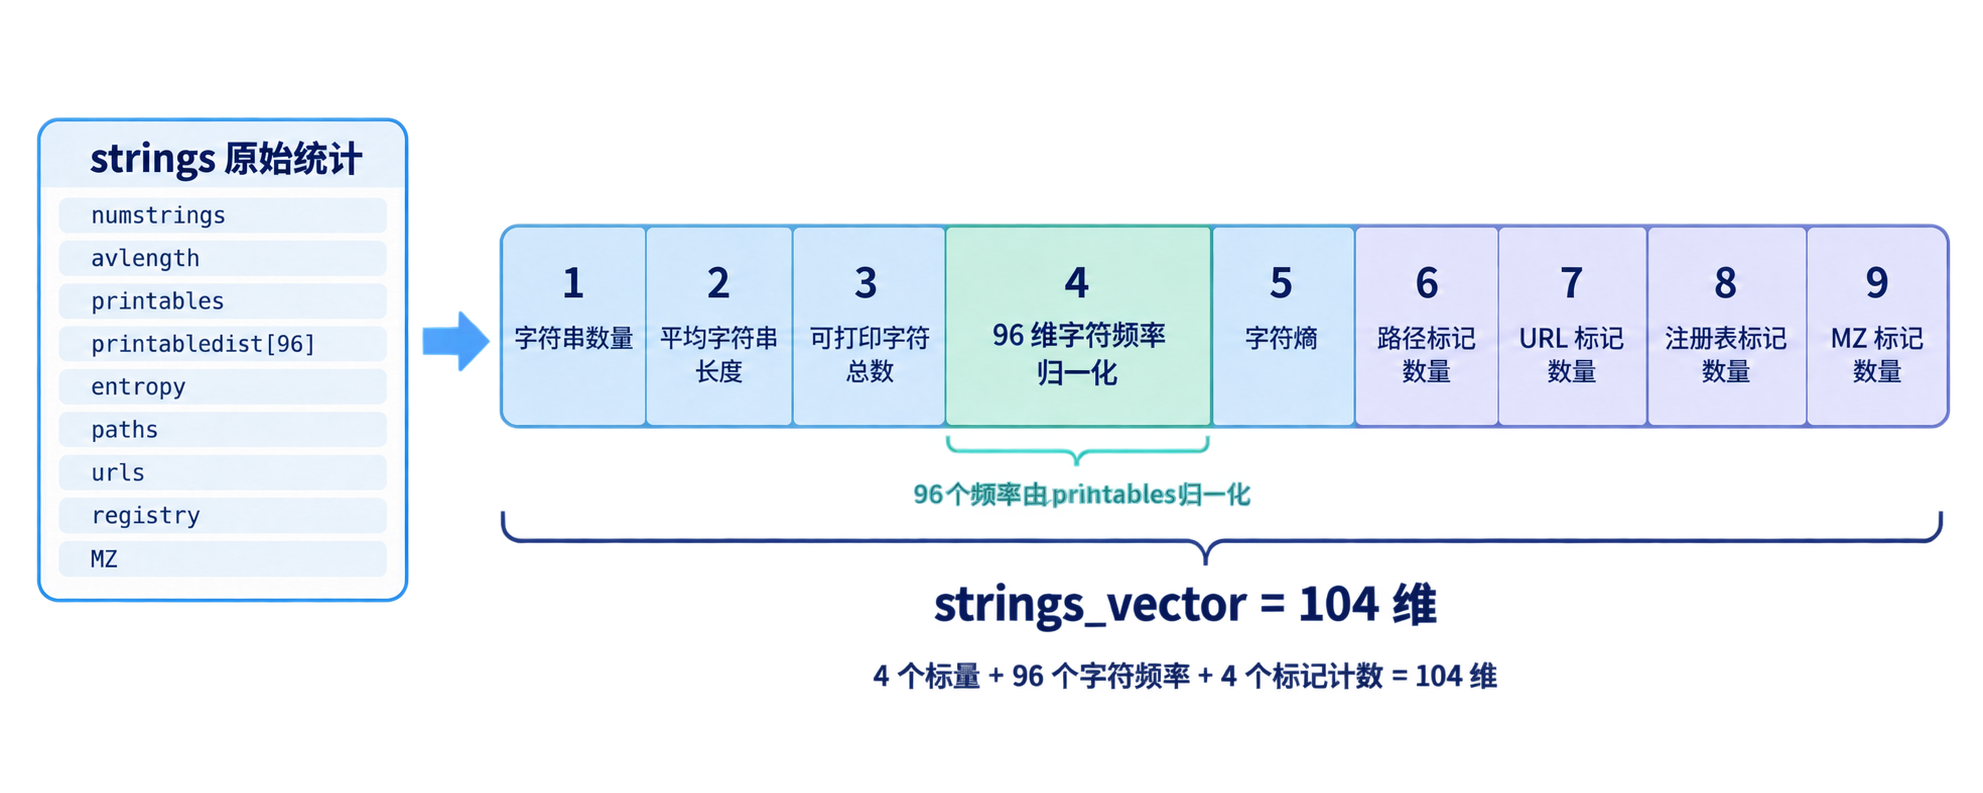
比如:
[14573, 5.97207, 87031,1046/87031, 817/87031, ...,6.56990, 3, 0, 0, 51]其中 96 维字符频率需要除以printables字段值来做归一化,其他统计值直接转换为 float32。
generals:按固定顺序排列数值
general 使用下面的固定顺序:
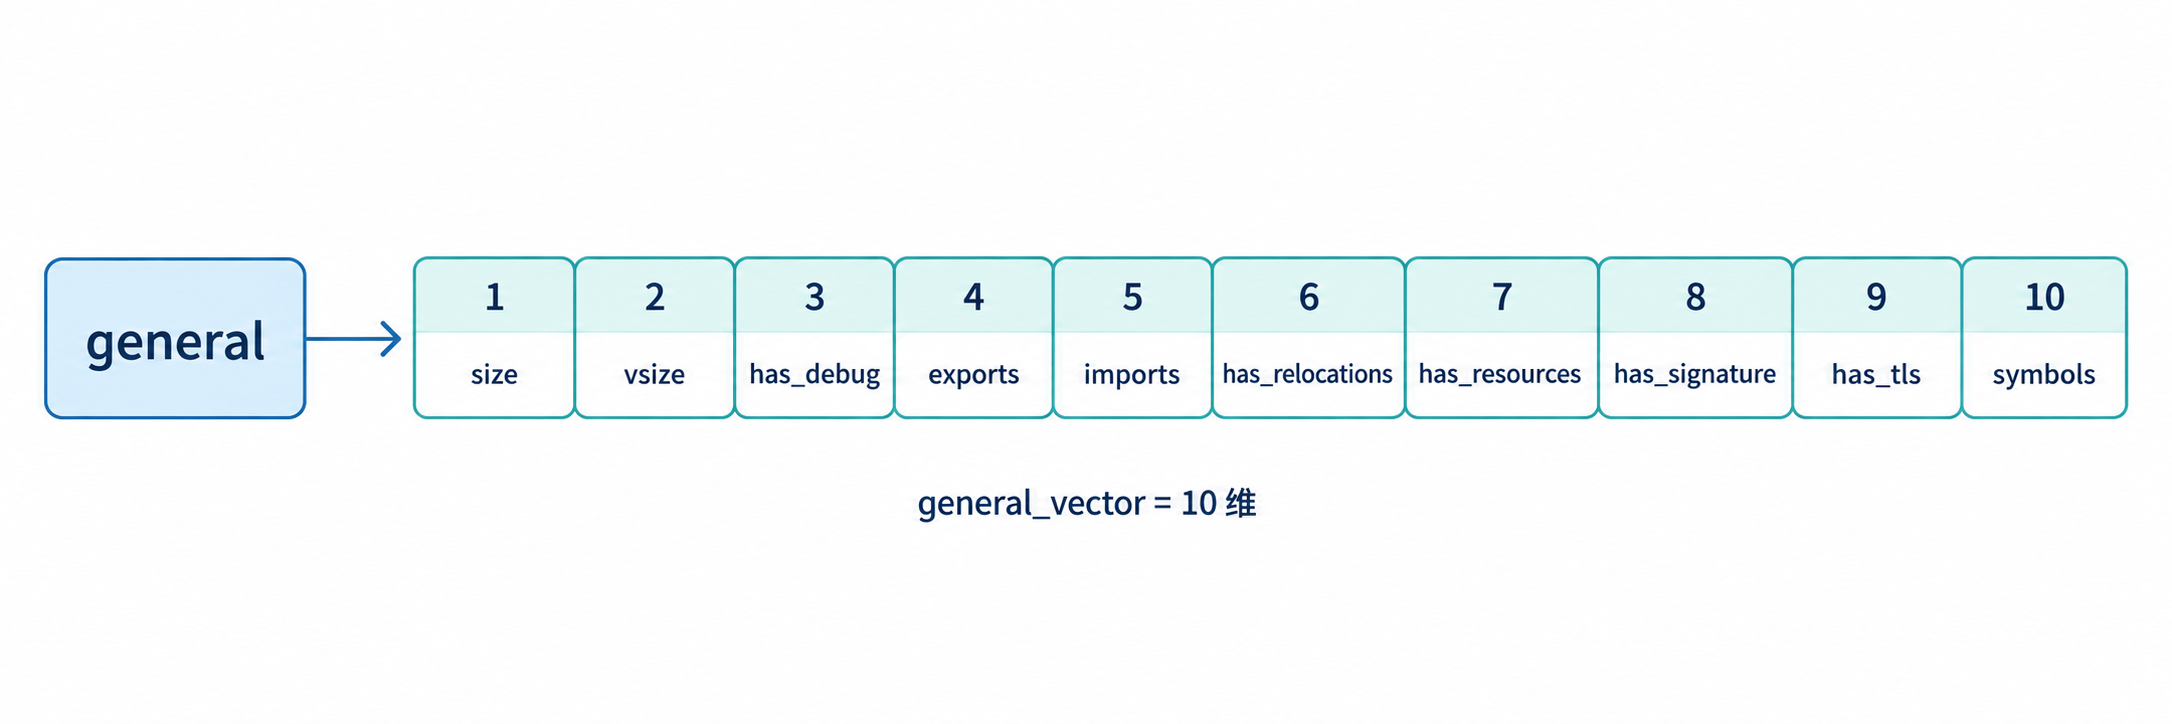
比如:
[3101705, 380928, 0, 0, 156, 0, 1, 0, 0, 0]这里没有做归一化操作,所有特征使用原数值。
imports和exports:使用特征哈希
imports以下面的数据为例:
{
    "KERNEL32.dll": ["SetFileTime", "CompareFileTime"]
}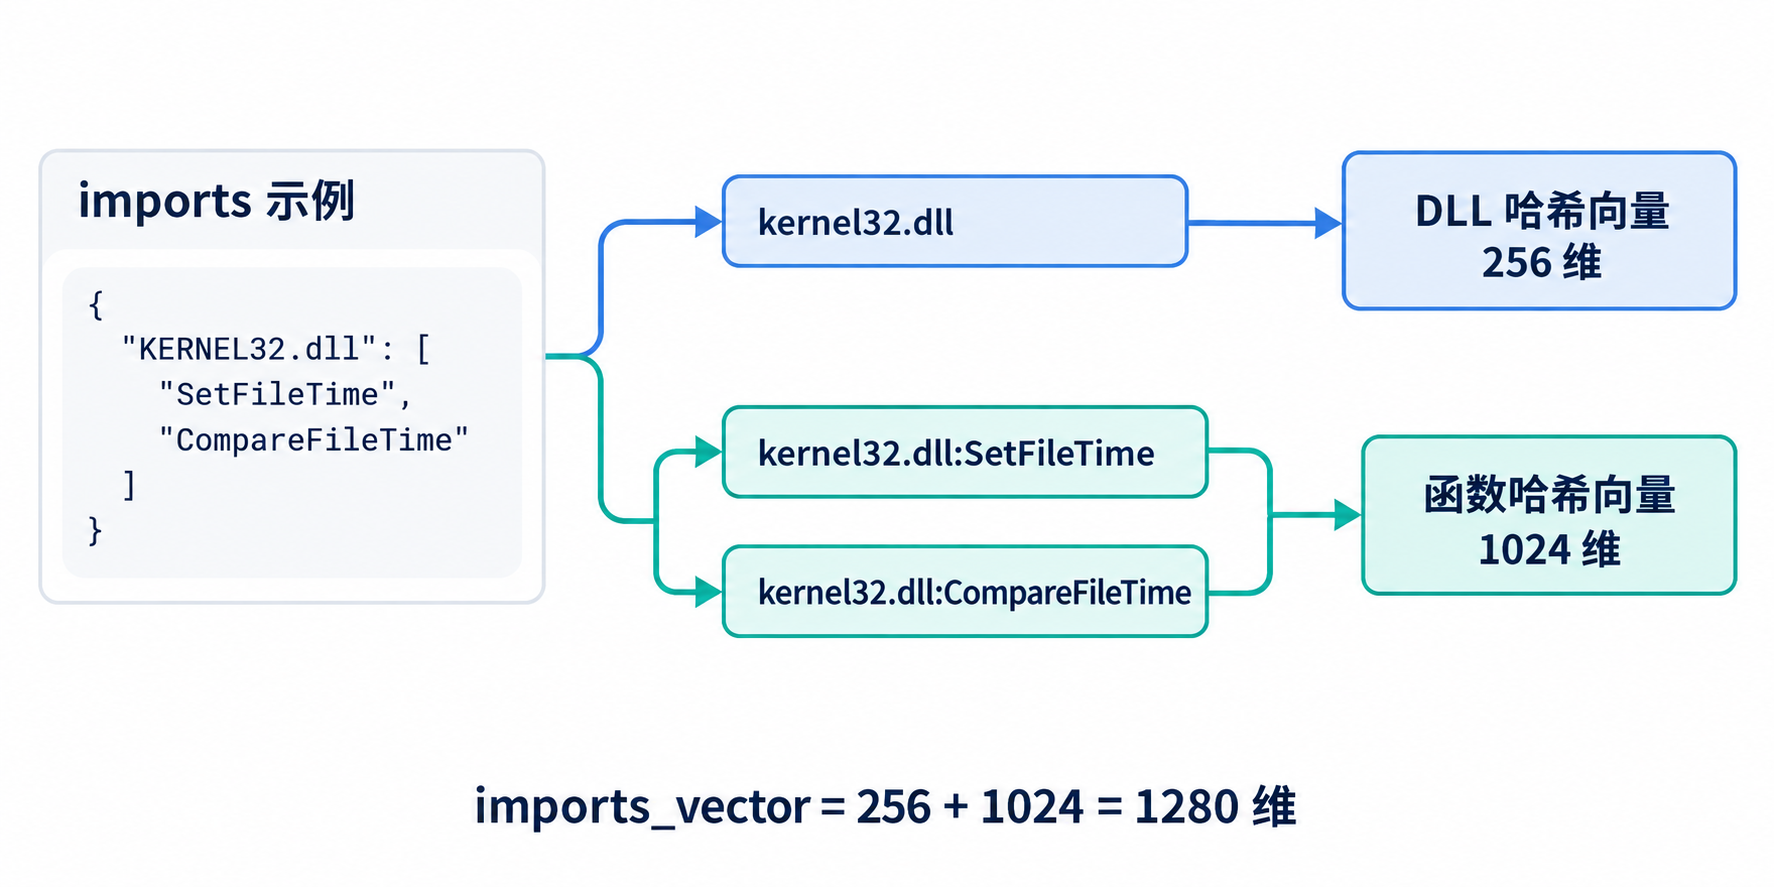
哈希函数为每个名称确定一个位置及正负号,然后向该位置累加 +1 或 -1。不同名称可能落到同一个位置,因此同一个桶里的值会累加或抵消。
比如单独处理 "kernel32.dll" 时,会向 DLL 向量的第 117 个桶贡献 +1。
exports 是128维,用来处理导出函数名,如果文件没有导出函数,则得到全零的128维向量。
header和section:数值与哈希组合
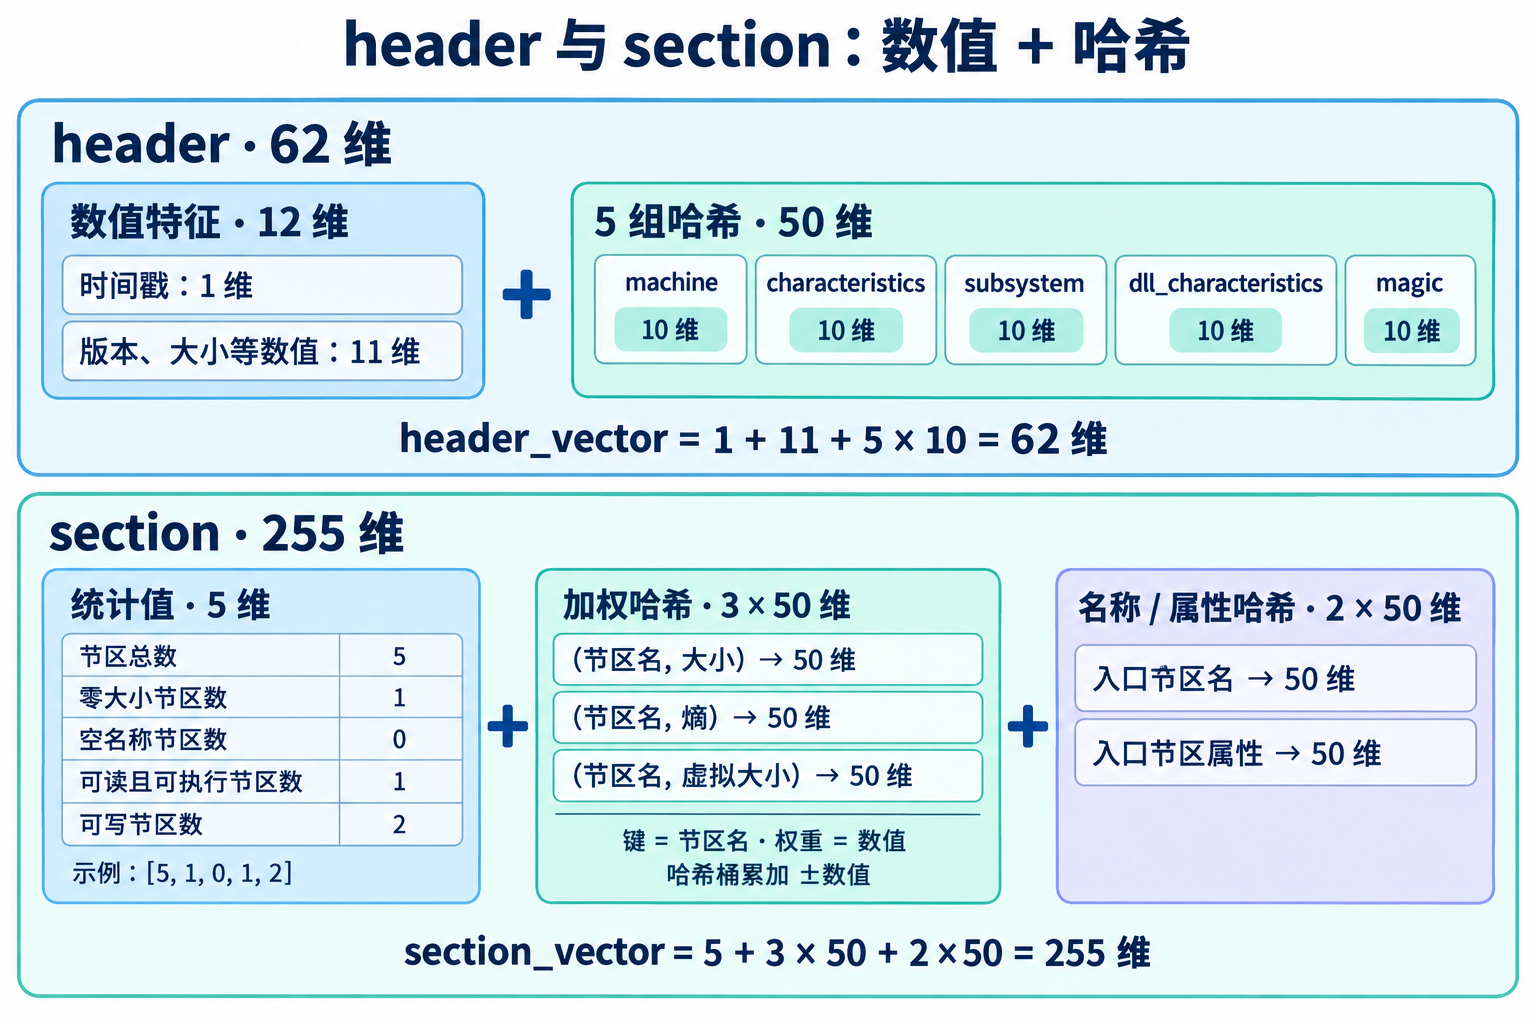
EMBER2018
EMBER2018 不只是"把样本年份换成 2018",它同时调整了数据规模、样本选择、特征定义和附加元数据 。最核心的变化是:样本选择标准更严格、特征从 v1 升级为 v2、向量从 2351 维增加到 2381 维。
| 对比项 | EMBER2017 | EMBER2018 |
|---|---|---|
| PE 样本总数 | 110 万 | 100 万 |
| 训练集 | 90 万 | 80 万 |
| 有标签训练样本 | 60 万 | 60 万 |
| 未标注训练样本 | 30 万 | 20 万 |
| 测试集 | 20 万 | 20 万 |
| 测试集类别 | 10 万良性 + 10 万恶意 | 10 万良性 + 10 万恶意 |
| 特征版本 | v1 | v2 |
| 特征维数 | 2351 | 2381 |
| LIEF 库版本 | 0.8.3 | 0.9.0 |
| 数据目录特征 | 无 | 新增 30 维 |
| 导入序号处理 | 旧方式 | 更新后的处理方式 |
| 样本选择难度 | 标签边界比较清晰 | 刻意选择得更难 |
| 家族元数据 | 原始版本主要是二分类标签,即 benign/malicious | 增加更丰富的 avclass 元数据 |
EMBER2018 的 100 万样本具体为:
训练集 800,000
├── 恶意      300,000
├── 良性      300,000
└── 未标注    200,000

测试集 200,000
├── 恶意      100,000
└── 良性      100,000
也就是总共:
恶意样本:400,000
良性样本:400,000
未标注:  200,000
新增 Data Directories 特征
EMBER2018 特征版本 v2 最大的结构变化,是在header.optional中新增数据目录特征:
"datadirectories": [
  {
    "name": "EXPORT_TABLE",
    "size": 0,
    "virtual_address": 0
  },
  {
    "name": "IMPORT_TABLE",
    "size": 120,
    "virtual_address": 8192
  }
]
EMBER v2 对前 15 个数据目录各提取:
size
virtual_address
因此新增15×2=30个特征维度。
EMBER v1:2351 维
EMBER v2:2351 + 30 = 2381 维
数据目录可以补充"某种 PE 结构是否存在、规模多大、位于哪个 RVA"等信息。例如 CLR Runtime Header 可以帮助识别 .NET PE,Certificate Table 可以反映签名结构。
元数据中增加 AVClass 恶意家族
EMBER2018 的原始 JSONL 元数据中增加了avclass字段,这就把 EMBER 从一个纯二分类基准,变成了也能做多分类家族识别的数据集:
{
  "sha256": "...",
  "appeared": "2018-05",
  "label": 1,
  "avclass": "ramnit" // 基于多引擎检测结果生成的家族共识标签
}
avclass是从VT报告上多个杀毒引擎检测结果聚合出的恶意软件家族名。注意,该字段仅作为元数据存在,不进入官方 2381 维二分类特征向量。
官方同时重新发布了 EMBER2017 v2
发布 EMBER2018 时,官方还使用 v2 特征定义重新处理了 2017 数据集对应的样本。因此实际有三个下载包:
| 数据年份 | 特征版本 |
|---|---|
| EMBER2017 | v1 |
| EMBER2017 | v2 |
| EMBER2018 | v2 |
EMBER2024
EMBER2024 和 EMBER2018 相比是一次大改版,不是简单的数据更新。
不再是纯 PE 数据集
这是最大的变化。EMBER2017/2018 只有 Win32 PE,EMBER2024 覆盖 6 种文件格式,总计约 320 万样本:
| 格式 | 每周采集样本数 | 训练集 | 测试集 |
|---|---|---|---|
| Win32 | 30000 | 1560000 | 360000 |
| Win64 | 10000 | 520000 | 120000 |
| .NET | 5000 | 260000 | 60000 |
| APK | 4000 | 208000 | 48000 |
| 1000 | 52000 | 12000 | |
| ELF | 500 | 26000 | 6000 |
| 合计 | 50500 | 2626000 | 606000 |
数据量比 EMBER2018 大了一个数量级(100 万 → 320 万),全量约 46.7 GB,其中 Win32 训练集单独就有 23.7 GB。
样本来自 VirusTotal,首次上传时间在 2023-09-24 到 2024-12-14 之间。采样方式很规整:每周恰好取 50,500 个文件,各文件格式和恶意/良性数量都有固定配额,前 52 周采集的样本为训练集,后 12 周采集的样本为测试集。
这个设计比 EMBER2018 更严谨------每周配额固定,意味着时间维度上样本分布均匀,做 concept drift(概念漂移)分析时不用再去校正采样偏差。
EMBER2024首创使用了6315 个"逃逸样本"作为Challenge set:上传到 VirusTotal 时被约 70 个 AV 引擎全部漏报,但事后被确认为恶意。
以往所有基于 VT 标签构建的数据集(包括 EMBER2018)都有一个根本性的循环论证问题:标签来自 AV引擎的判断,那么模型学到的上限就是"复现 AV引擎 的判断",AV引擎集体漏掉的东西数据集里根本不存在。 Challenge set 专门把这部分捞出来单独成集,用来测模型在 AV 盲区上的表现。
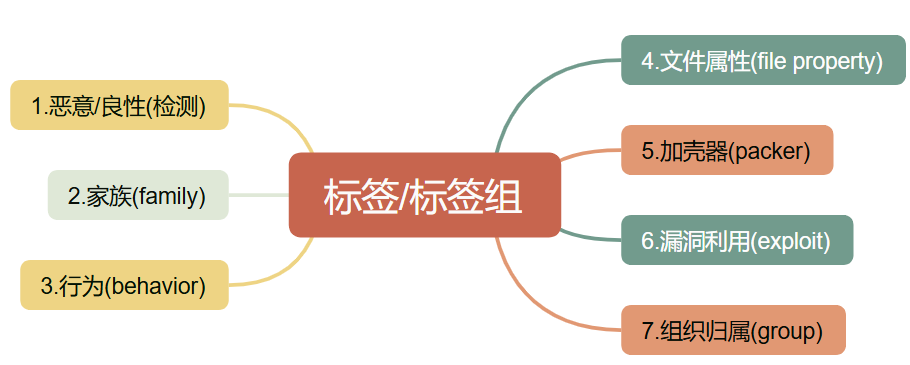
EMBER2024 不再用 AVClass,改用 ClarAVy(AVClass和ClarAVy都是整理多个杀毒软件结果标签的工具,但ClarAVy针对 AV 标签做了更好的共识建模)。
ClarAVy提供了 7 类标签/标签组:
此外,PE样本的特征提取器直接使用pefile库替换掉了LIEF,同时,PE 新增特征组:DOS header、Rich header、Authenticode 签名、PE 解析告警(parsing warnings)。
Rich header 和 parsing warnings 这两个加得很到位------前者能反映编译工具链指纹,后者本身就是强信号(畸形 PE 往往是刻意构造的)。
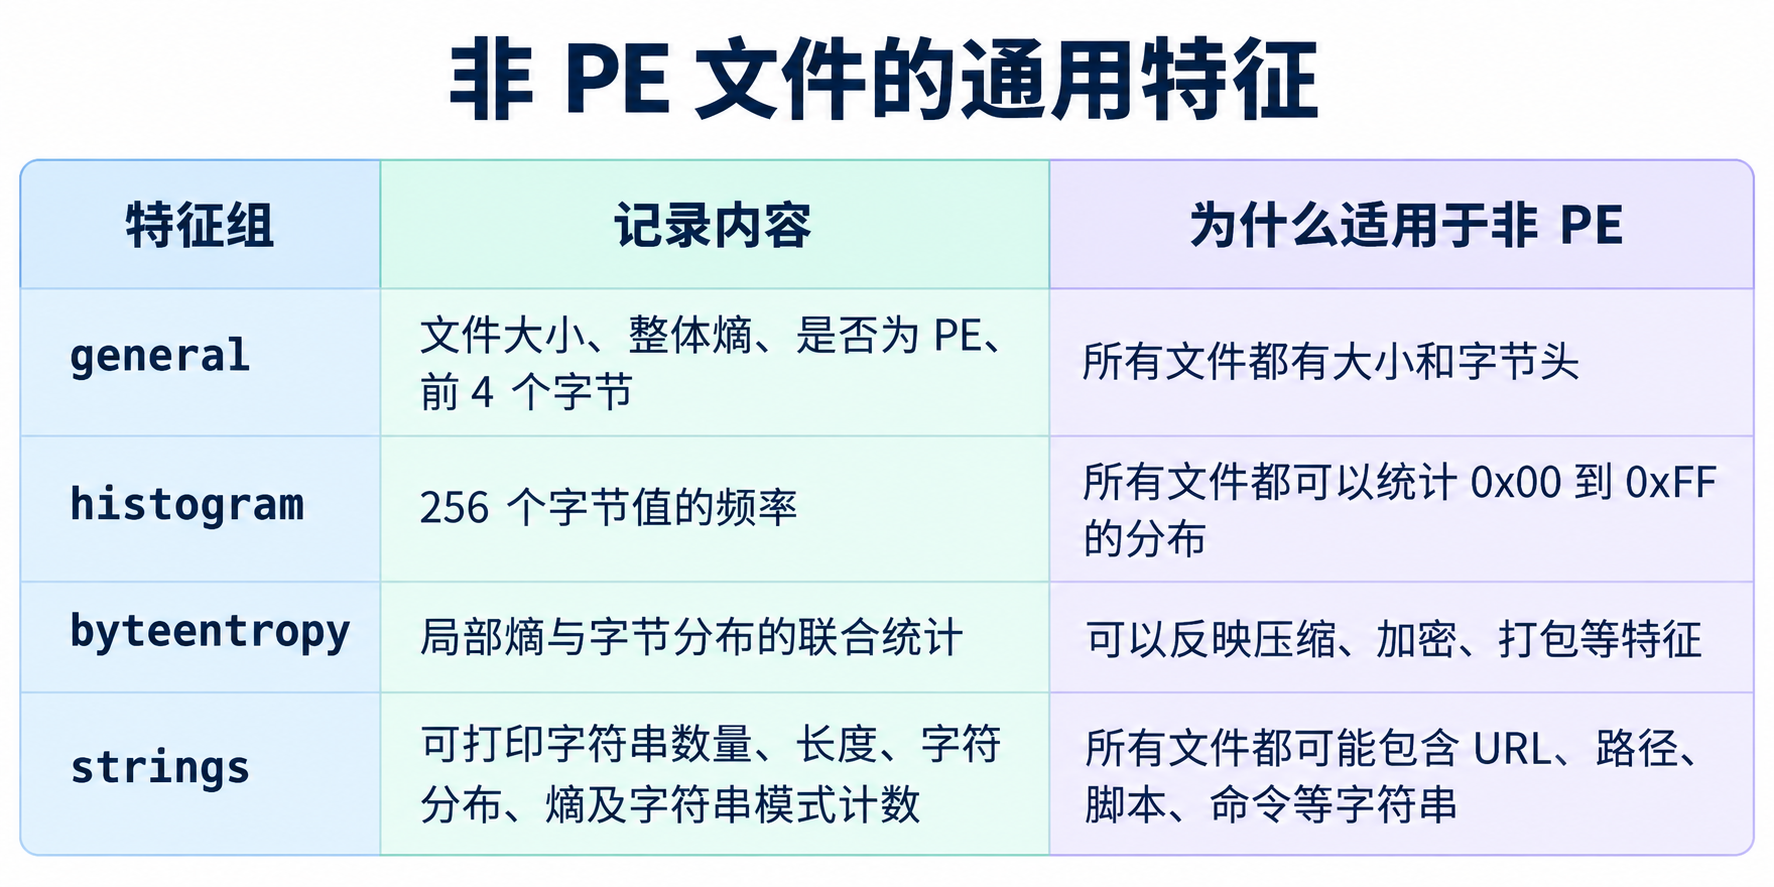
非 PE 格式(APK / ELF / PDF)只使用4个通用特征组:general、histogram、byteentropy、strings。
Win32 / Win64 / .NET / ELF 数据集额外附带 capa 分析结果:capabilities、MITRE ATT&CK TTPs、Malware Behavior Catalogue 映射。
另有一份补充数据集:16356790 个来自数据集恶意样本的函数数据,含原始字节和反汇编。这个对做函数级建模、二进制相似度、或者 LLM-on-assembly 方向的人价值很大。
GBDT
GBDT(Gradient Boosting Decision Tree,梯度提升决策树)就是使用决策树作为基础模型的 GBM(Gradient Boosting Machine,梯度提升机)可以理解成一个"不断改错的决策树团队",由多颗深度较小的决策树串联而成。
一棵决策树会根据特征不断提问,例如:
- 文件的整体熵是否较高?
- 是否导入了可疑函数?
- 是否存在异常节区?
- 文件是否带有数字签名?
最后,决策树给出一个判断结果。但一棵树的能力有限,因此 GBDT 会连续训练许多棵树。
第一棵树先做一个比较粗略的判断;第二棵树重点检查第一棵树判断不准的样本;第三棵树继续修正前面留下的问题。最终结果是所有树的结果逐步累加:
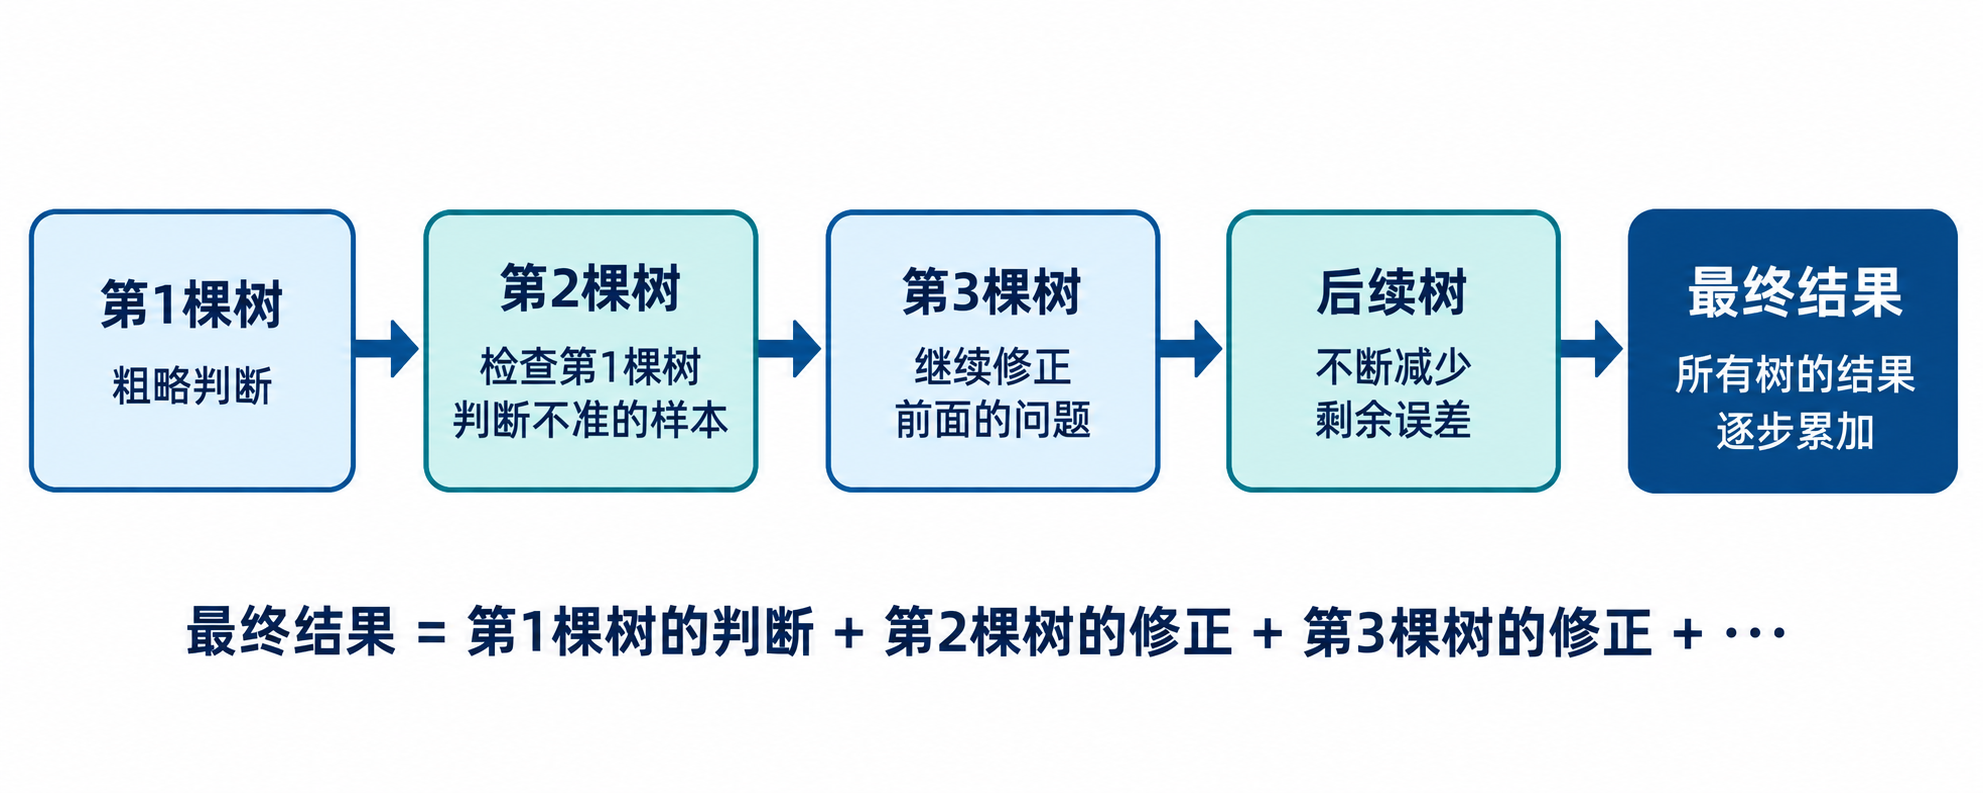
在分类任务中,GBM 会把最终分数转换成概率。例如,模型输出恶意概率为 0.97,就可以判定为恶意文件。
EMBER使用的LightGBM(Light Gradient Boosting Machine)是 GBDT算法 的一种高效实现。它没有改变"多棵树逐步改错"的基本思想,而是让训练过程更快、占用内存更少。
LightGBM 适合 EMBER,主要是因为 EMBER 的特征类型比较多。树模型可以直接学习"某个特征是否超过阈值"以及"多个特征组合出现时是否可疑",不需要假设特征和结果之间是简单的线性关系。
总结
EMBER 的核心价值在于它通过字节统计、字符串、导入函数、节区结构等多组互补特征,取得了较好的恶意文件识别效果。在合适的数据划分和阈值设置下,EMBER 能够在保持较高检出率的同时,将误报率控制在较低水平。对于安全产品来说,这种平衡非常重要。
与直接处理原始字节的端到端模型相比,EMBER 的特征工程和 GBDT 结构更容易分析误报原因、调整检测阈值和进行模型更新,因此在实际部署中更容易保持稳定的检测效果。当然,EMBER 并不能在所有场景下都绝对优于端到端模型,其性能还会受到数据分布、标签质量、时间变化和阈值选择的影响。
未来,EMBER 类方法可以进一步融合动态行为、调用序列和威胁情报,提升对新型样本的检出能力。