文章目录
- [1. 概述](#1. 概述)
-
- [1.1 是什么?](#1.1 是什么?)
- [1.2 基本原理](#1.2 基本原理)
- [1.3 使用场景](#1.3 使用场景)
- [1.4 VS 子问题](#1.4 VS 子问题)
- [2. 案例演示](#2. 案例演示)
-
- [2.1 准备语料](#2.1 准备语料)
- [2.2 公共配置(阿里云百炼)](#2.2 公共配置(阿里云百炼))
- [2.3 构建查询引擎](#2.3 构建查询引擎)
- [2.4 对照:普通单次检索](#2.4 对照:普通单次检索)
- [2.5 构建 StepDecomposeQueryTransform](#2.5 构建 StepDecomposeQueryTransform)
- [2.6 构建 MultiStepQueryEngine](#2.6 构建 MultiStepQueryEngine)
- [2.7 Self-Ask:逐轮追问](#2.7 Self-Ask:逐轮追问)
1. 概述
1.1 是什么?
Self-Ask 是一种多步推理 RAG/Agent 策略:大模型不直接回答用户原始问题,而是自己不断向自己提出子问题,逐个检索外部工具获取子问题答案,把问答记录保存到推理历史,直到信息足够,再输出最终答案。
论文:Self-Ask: A Language Model Framework for Question Answering with Self-Generated Queries
1.2 基本原理
普通 RAG:用户 1 个问题 → 一次检索 → 直接回答。
Self-Ask RAG 执行流程:
- 用户输入:提出一个复杂问题(后一问依赖前一答的多跳问题)
- 问题检索:先对知识库做一次初始检索
- LLM 判断:当前信息足以回答原始问题吗?
- 信息不足 → 循环体 (每轮三步):
- 自问:·LLM· 结合【原问题 + 推理历史】生成下一个子问题
- 自答:调用检索工具查询该子问题,拿到答案
- 存历史:将【子问题 + 子答案】追加进推理历史
- 带着历史再次思考,回到第
3步继续判断
- 信息充足 → 停止 :
LLM输出None,结束循环 - 合成答案:基于全部问答历史,对原始问题合成最终回答
#mermaid-svg-ljBsLcaCz9wJTge4{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-ljBsLcaCz9wJTge4 .error-icon{fill:#552222;}#mermaid-svg-ljBsLcaCz9wJTge4 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-ljBsLcaCz9wJTge4 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-ljBsLcaCz9wJTge4 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-ljBsLcaCz9wJTge4 .marker.cross{stroke:#333333;}#mermaid-svg-ljBsLcaCz9wJTge4 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-ljBsLcaCz9wJTge4 p{margin:0;}#mermaid-svg-ljBsLcaCz9wJTge4 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 .cluster-label text{fill:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 .cluster-label span{color:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 .cluster-label span p{background-color:transparent;}#mermaid-svg-ljBsLcaCz9wJTge4 .label text,#mermaid-svg-ljBsLcaCz9wJTge4 span{fill:#333;color:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 .node rect,#mermaid-svg-ljBsLcaCz9wJTge4 .node circle,#mermaid-svg-ljBsLcaCz9wJTge4 .node ellipse,#mermaid-svg-ljBsLcaCz9wJTge4 .node polygon,#mermaid-svg-ljBsLcaCz9wJTge4 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-ljBsLcaCz9wJTge4 .rough-node .label text,#mermaid-svg-ljBsLcaCz9wJTge4 .node .label text,#mermaid-svg-ljBsLcaCz9wJTge4 .image-shape .label,#mermaid-svg-ljBsLcaCz9wJTge4 .icon-shape .label{text-anchor:middle;}#mermaid-svg-ljBsLcaCz9wJTge4 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-ljBsLcaCz9wJTge4 .rough-node .label,#mermaid-svg-ljBsLcaCz9wJTge4 .node .label,#mermaid-svg-ljBsLcaCz9wJTge4 .image-shape .label,#mermaid-svg-ljBsLcaCz9wJTge4 .icon-shape .label{text-align:center;}#mermaid-svg-ljBsLcaCz9wJTge4 .node.clickable{cursor:pointer;}#mermaid-svg-ljBsLcaCz9wJTge4 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-ljBsLcaCz9wJTge4 .arrowheadPath{fill:#333333;}#mermaid-svg-ljBsLcaCz9wJTge4 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-ljBsLcaCz9wJTge4 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-ljBsLcaCz9wJTge4 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-ljBsLcaCz9wJTge4 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-ljBsLcaCz9wJTge4 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-ljBsLcaCz9wJTge4 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-ljBsLcaCz9wJTge4 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-ljBsLcaCz9wJTge4 .cluster text{fill:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 .cluster span{color:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-ljBsLcaCz9wJTge4 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-ljBsLcaCz9wJTge4 rect.text{fill:none;stroke-width:0;}#mermaid-svg-ljBsLcaCz9wJTge4 .icon-shape,#mermaid-svg-ljBsLcaCz9wJTge4 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-ljBsLcaCz9wJTge4 .icon-shape p,#mermaid-svg-ljBsLcaCz9wJTge4 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-ljBsLcaCz9wJTge4 .icon-shape .label rect,#mermaid-svg-ljBsLcaCz9wJTge4 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-ljBsLcaCz9wJTge4 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-ljBsLcaCz9wJTge4 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-ljBsLcaCz9wJTge4 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 信息不足
带着历史再次思考
信息充足 输出 None
用户输入
问题检索
LLM 判断:当前信息足以回答吗?
① 自问:LLM 生成子问题
② 自答:调用检索工具查询子问题
③ 子问题+子答案 存入推理历史
合成最终答案
基于全部问答历史
1.3 使用场景
适用:
- ✅ 串行多跳问题:第二问的前提是第一答;
- ✅ 需要逐步缩小范围的探查式问题(先定位对象,再查对象属性);
示例:
- 澳网冠军的大满贯数?
- 作者创办的公司被谁收购?收购方后来怎么样了?
不适用:
- ❌ 子问题相互独立的对比类问题;
- ❌ 单次检索就能答的普通问题;
- ❌ 高并发/低延迟场景。
1.4 VS 子问题
两者同属 Query Decomposition 大家族,分界线一句话:拿到第一个子问题的答案之前,能写出第二个子问题吗?
| 维度 | 子问题 SubQuestion | 多步转换 Self-Ask |
|---|---|---|
| 规划时机 | 一次全部规划好(1 次 LLM 出完整清单) | 边走边规划(每轮生成下一问) |
| 子问题关系 | 相互独立 | 串行依赖(链式) |
| 执行模式 | fan-out 并行 | 串行链式 |
| 看不看中间结果 | 完全不看 | 每轮答案回灌(灵魂机制) |
| 停止条件 | 清单执行完即止 | None / num_steps / stop_fn |
| 延迟 | ≈ 最慢一路(并行) | 所有轮次累加 |
| 典型失败 | 规划偏差、拆出冗余 | 误差传播(第一步答偏后面全歪) |
| LlamaIndex 组件 | SubQuestionQueryEngine | MultiStepQueryEngine |
2. 案例演示
面对后一问依赖前一答 的串行多跳问题,单次检索无能为力,需要采取 Self-Ask 的解法。
先导入全部包和类:
python
from pathlib import Path
from time import time

from dotenv import load_dotenv
import os

from llama_index.core import Settings, SimpleDirectoryReader, VectorStoreIndex
from llama_index.core.indices.query.query_transform.base import (
    StepDecomposeQueryTransform,
)
from llama_index.core.query_engine import MultiStepQueryEngine
from llama_index.llms.openai_like import OpenAILike
2.1 准备语料
4 个 Markdown 文件:
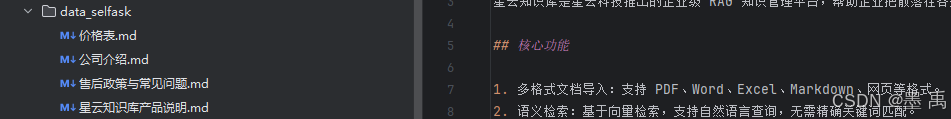
信息分散在不同文件里,形成天然的跨文档跳转链:
- 「公司介绍」只说有星云知识库这个产品但不提价格;
- 「产品说明」只讲价格但不会自称「星云科技推出的知识管理平台」
所以像「星云科技推出的知识管理平台的专业版一年多少钱」这种问题,第一跳必须先定位出产品名(跨文件 1→2),才能查到价格,正是「后一问依赖前一答」的串行多跳场景。
2.2 公共配置(阿里云百炼)
python
PROJECT_ROOT = Path(__file__).resolve().parent.parent
load_dotenv(PROJECT_ROOT / ".env")
api_key = os.environ["DASHSCOPE_API_KEY"]
API_BASE = "https://ws-jfb8j8mx0n7e2k6a.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"

llm = OpenAILike(
    model="qwen-plus",
    api_key=api_key,
    api_base=API_BASE,
    is_chat_model=True,
    timeout=180.0,   # 专属端点偶发慢响应,默认 60s 会超时
    max_retries=2,
)
# 建向量索引需要 embedding(分解/合成都走 llm,检索向量化走 embed_model)
from llama_index.embeddings.openai_like import OpenAILikeEmbedding

Settings.embed_model = OpenAILikeEmbedding(
    model_name="text-embedding-v3",
    api_key=api_key,
    api_base=API_BASE,
)
Settings.llm = llm
2.3 构建查询引擎
加载文档 + 建索引:
python
documents = SimpleDirectoryReader(str(PROJECT_ROOT / "data_selfask")).load_data()
index = VectorStoreIndex.from_documents(documents)
一个普通查询引擎:
python
plain_engine = index.as_query_engine(similarity_top_k=1)
top_k=1一次只检索一个节点,是为了更容易复现问题!
2.4 对照:普通单次检索
python
QUESTION = "星云科技推出的知识管理平台的专业版一年多少钱?"

print("=" * 70)
print(f"多跳问题:{QUESTION}")
t0 = time()
resp0 = plain_engine.query(QUESTION)
print(f"\n[对照] 普通单次检索({time() - t0:.1f}s,1 次合成调用):")
print(f"  {str(resp0)[:150]}")
【预期】答案不完整或不落地:
- 召回公司介绍/产品说明 → 知道产品但查不到价格;
- 召回价格表 → 有价格但不知道是哪家产品的。
输出示例:
python
多跳问题:星云科技推出的知识管理平台的专业版一年多少钱?

[对照] 普通单次检索 top_k=1(1.9s,1 次合成调用):
  文档中未提及星云科技知识管理平台"专业版"的具体定价信息,也未说明"专业版"这一版本名称。仅说明 SaaS 版为按年订阅、开通即用,但未给出价格。
2.5 构建 StepDecomposeQueryTransform
多步迭代式查询转换器 (StepDecomposeQueryTransform)核心参数:
llm:用于生成查询的大模型实例。step_decompose_query_prompt:verbose:分步拆解提示词模板。不传则使用默认内置。- 是否打印调试日志。
python
step_decompose = StepDecomposeQueryTransform(
    llm=llm,
    step_decompose_query_prompt=PromptTemplate(STEP_DECOMPOSE_ZH_TMPL),
    verbose=True,
)
2.6 构建 MultiStepQueryEngine
多步查询引擎(MultiStepQueryEngine)和 StepDecomposeQueryTransform 成对使用,实现串行多跳 RAG。
核心参数:
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
query_engine |
BaseQueryEngine |
必填 | 底层基础查询引擎。每一轮生成的子查询,都会交给这个引擎执行检索+问答。可以是RetrieverQueryEngine。 |
query_transform |
StepDecomposeQueryTransform |
必填 | 分步查询转换器,就是前面分析的类。负责接收prev_reasoning、index_summary,调用LLM生成下一轮子查询。 |
response_synthesizer |
Optional[BaseSynthesizer] |
None | 最终答案合成器。 不传时自动创建默认synthesizer,作用:把多轮所有子QA信息汇总,基于原始用户问题生成最终回答。 |
num_steps |
Optional[int] |
3 | 最大迭代轮数,防止无限循环 。 当early_stopping=False时,该参数必须填写,否则抛异常。 |
early_stopping |
bool |
True | 是否开启提前终止。 True:优先用stop_fn判断是否停止;False:强制跑满num_steps轮。 |
index_summary |
str |
"None" |
知识库/索引摘要。会放进metadata传给StepDecomposeQueryTransform,作为prompt里context_str,告诉LLM知识库有什么内容。 |
stop_fn |
Optional[Callable[[Dict], bool]] |
None | 自定义停止判断函数,入参是字典,返回bool。 不传则使用default_stop_fn(默认逻辑:判断生成的子query是不是"None",和前面prompt约定匹配)。 |
构建示例:
python
multi_engine = MultiStepQueryEngine(
    plain_engine,
    query_transform=step_decompose,
    num_steps=3,
)
2.7 Self-Ask:逐轮追问
执行查询:
python
print("=" * 70)
print("Self-Ask 多步追问(verbose 会打印每轮生成的新问题):")
t0 = time()
response = multi_engine.query(QUESTION)
print("=" * 70)
print(f"最终答案({time() - t0:.1f}s):\n{response}")
输出结果:
python
Self-Ask 多步追问(verbose 会打印每轮生成的新问题):
> Current query: 星云科技推出的知识管理平台一年多少钱?
> New query: 星云科技推出的知识管理平台的名称是什么?
> Current query: 星云科技推出的知识管理平台一年多少钱?
> New query: 星云知识库的定价信息是什么?
> Current query: 星云科技推出的知识管理平台一年多少钱?
> New query: 星云知识库的SaaS版按年订阅的具体价格是多少?
======================================================================
最终答案(6.4s):
星云科技推出的知识管理平台(即星云知识库)SaaS版按年订阅,具体价格如下:
- 标准版:9.8万元/年;
- 专业版:19.8万元/年;
- 旗舰版:按需定制,无固定价格。