👋 欢迎阅读
🔥 愿旖旎 · 个人主页
📘学习专栏: 《算法专栏》《LangChain学习》《贪心算法》
🌄 钱塘江上潮信来,今日方知我是我
✨当前学习内容 : 《LangGraph》
📑 目录
-
[二、LangGraph 持久化(Persistence)](#二、LangGraph 持久化(Persistence))
一、前置讲解
在进入正文前,先花 10 秒了解本篇会反复用到的核心概念,带着印象去读正文,学习效率更高。
🧠 前置知识一:持久化(Persistence)
把 AI 应用的状态 存下来,重启、宕机 之后还能接着上次继续,而不是从头开始。
💾 前置知识二:检查点(Checkpoint)
线程在某一时刻的状态快照 :记着状态值 、下一步要执行的节点 ,可以回滚 与重放。
🧵 前置知识三:线程(Thread)与 thread_id
一个 thread_id 就是一次独立会话的身份证 ,不同线程的状态互不干扰。
🗄️ 前置知识四:存储(Store)与命名空间(Namespace)
跨会话的长期记忆仓库 ,用命名空间(元组)按用户、按类型把记忆分门别类放好。
⏪ 前置知识五:时间旅行(重放与更新状态)
拿到历史 config 就能从过去某一步重新执行 ,也能改掉那一步的状态再跑一遍。
二、LangGraph 持久化(Persistence)
2.1 什么是持久化能力?
简单来说,在 LangGraph 中持久化能力 指的是把 AI 应用 的状态 (如对话历史 、中间结果 、用户信息 等)保存 下来,即使程序重启 或系统宕机 ,也能恢复 之前的状态,让 AI"记住"之前发生过的一切。
第一个场景很好理解:你今天和智能助手 聊了很多重要信息,关掉应用、明天重新打开时,你当然希望它还记得你说过的话 ------这就是 AI 应用需要持久化的第一个原因。
再看第二个场景:假设有一个助手,它可以搜索网络。
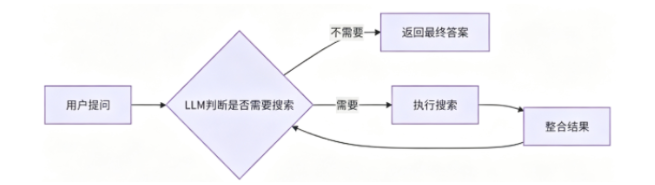
没有持久化时,整个流程是这样的:
| 步骤 | 发生的事 |
|---|---|
| 1 | 用户问:"今天的天气怎么样?" |
| 2 | 助手 调用搜索工具,得到答案:"今天晴天,25 度。" |
| 3 | 程序崩溃重启 |
| 4 | 用户再问:"那我需要带伞吗?" |
| 5 | 助手 没有之前的上下文 ,可能又去调用搜索工具 ,而不是基于"今天晴天"这个上下文回答"不需要" |
有持久化时,同样的流程会变成:
| 步骤 | 发生的事 |
|---|---|
| 1 | 用户问:"今天的天气怎么样?" |
| 2 | 助手 调用搜索工具 ,得到"今天晴天,25 度"(这个状态 ,包括对话历史 和工具调用结果 ,被自动保存) |
| 3 | 程序崩溃重启 |
| 4 | 用户 再问:"那我需要带伞吗?"(与之前在同一会话下) |
| 5 | LangGraph 加载之前保存的状态 ,状态里记录了"今天晴天" |
| 6 | 助手 看到上下文 是晴天,直接回答:"今天是晴天,您不需要带伞。"(无需再次调用搜索工具) |
💡 两边的差别不在"能不能搜",而在状态有没有被存下来 :没持久化时,崩溃重启等于失忆 ,只能靠再搜一次来补救;有持久化时,重启后加载状态就能接着上下文往下答。
2.2 持久化能力的两种表现
| 类型 | 作用 | |
|---|---|---|
| 线程级(单对话)持久化 | 自动保存工作流执行过程中的状态快照 ,维持单次会话 的完整上下文 | |
| 跨会话持久化 | 通过存储(Store) 保存用户信息 、偏好设置 等长期数据 ,实现不同对话间 信息的持久化共享 |
关于线程级持久化,有两个概念容易混,先在这里说清:
| 易混点 | 说明 |
|---|---|
| "线程"≠ 操作系统线程 | 操作系统线程 是进程内的执行单元 ,是操作系统调度的最小单位 ;而这里的线程(Thread) 表示聊天过程中的单次会话 的持久化信息(相当于 AI 开一个新对话),用来隔离不同的聊天会话 ,两者概念完全独立 |
| "状态快照"≠ 之前学的 State | 这里的状态 包含了所有必要的上下文信息 ,比如:已经调用过哪些工具 、用户的输入 、聊天历史 、下一步要执行的节点等等 |
关于跨会话持久化 ,举个例子就很直观:把用户基本情况 (比如有高血压病史 )存进 Store,那么后续无论何时何地、无论新开几个会话窗口 ,都能基于这条用户基本信息来生成结果。
2.3 线程级持久化
2.3.1 线程级持久化是怎么工作的?
当我们开始执行工作流 ,过程中可能发生崩溃或重启导致的中断 等异常情况。根据 LangGraph 的持久化机制 ,线程级持久化 能够自动保存 工作流执行过程中的状态快照 ,维持单次会话 的完整上下文 ------工作流执行到某一步时,它会自动保存当前步骤的状态快照 ,这个状态 包含所有必要的上下文信息(调用过哪些工具、用户输入、聊天历史、下一步要执行的节点等)。
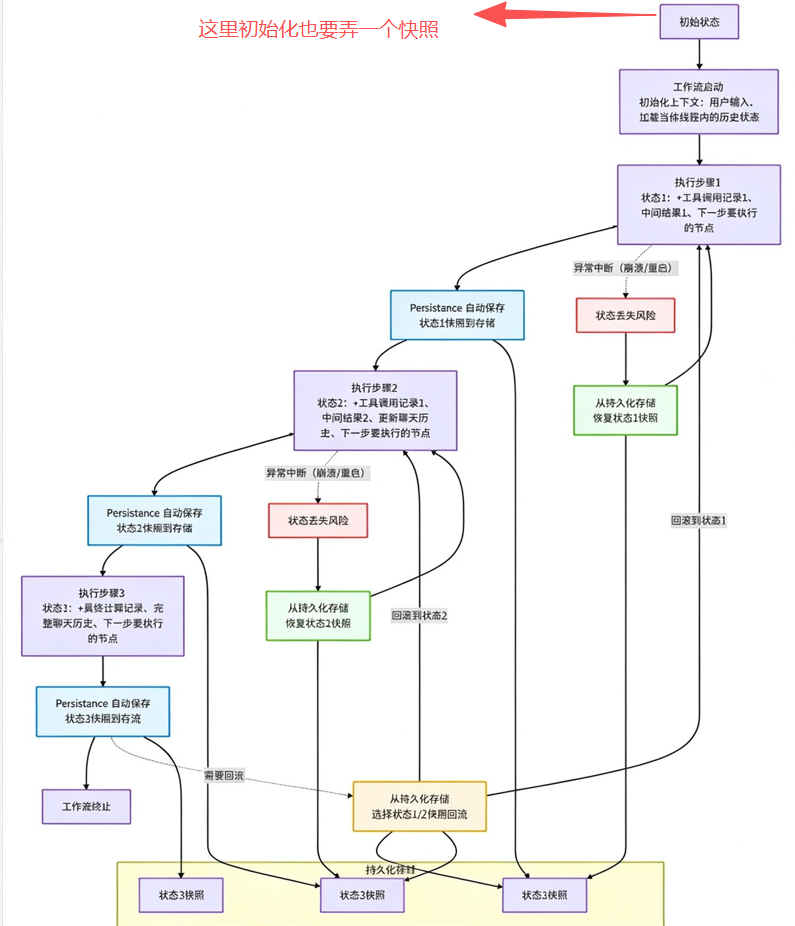
线程级持久化机制确保了下面三件事:
| 保障 | 说明 |
|---|---|
| 状态不丢失 | 即使应用崩溃、重启 ,或长时间流程被中断 ,恢复时也能从上次停止的地方继续执行 ,而不是从头开始 |
| 支持长时间运行的任务 | 需要与用户多轮交互 (如多步对话助手 )或处理耗时极长 的流程(如等待外部 API 回调)时,持久化必不可少 |
| 检查点和回滚 | 可以把状态保存到某个时间点(检查点) ,并在需要时回滚到该状态 |
LangGraph 的线程级持久化 是其核心功能,它通过**【线程】** 和**【检查点】**这两个核心部分来实现。
2.3.2 Threads(线程)
在 LangGraph 中,Thread 代表一个独立的工作流执行会话 。可以把它想象成【与某个用户的一次完整对话历史 】或【处理某个特定任务的一次完整执行过程】。
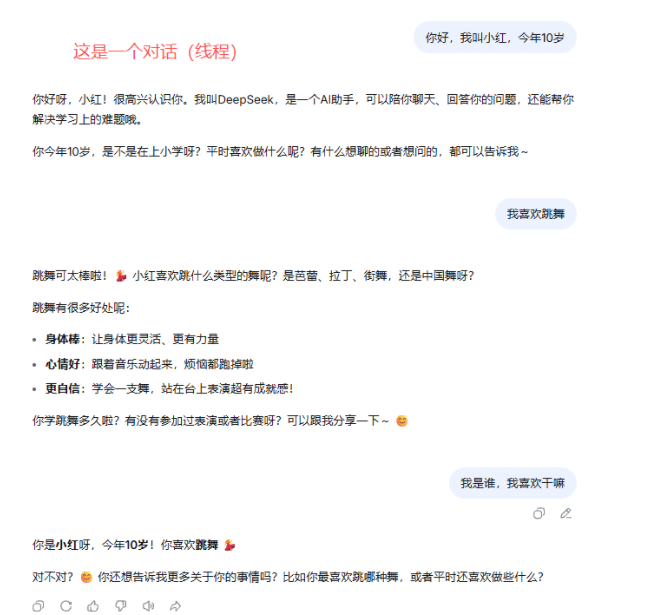
Thread 的关键特性:
| 特性 | 说明 |
|---|---|
| 隔离性 | 每个 Thread 都完全独立 ,它们的状态互不干扰 |
| 持久化单元 | Thread 是状态持久化 的基本单位 |
| 标识符 | 通过唯一的 thread_id 来识别 |
2.3.3 Checkpoints(检查点)
Checkpoint 是 Thread 在特定时刻的**【状态快照】** ,它记录了工作流 执行到某个节点 时的完整状态 。例如在一次会话中,每一次用户输入 和对话结束 后,都可以保存一个最新的**【状态快照】**。
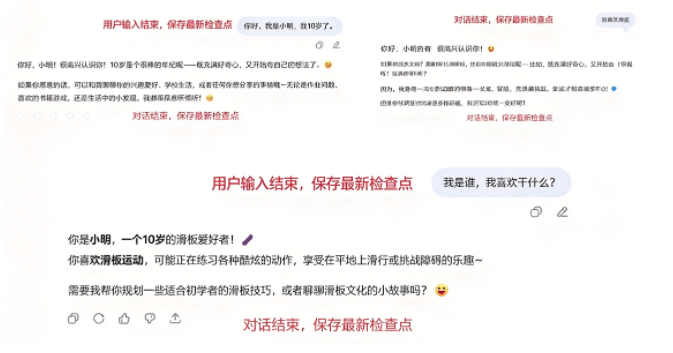
Checkpoint 的关键特性之一是"状态快照(StateSnapshot)" :保存了工作流 在某个时间点 的完整状态 ,包含**【状态值】** 、【下一步要执行的节点】 、【与此检查点关联的配置】 和**【与此检查点关联的元数据】**等信息。
python
StateSnapshot(
# 当前状态值(如:对话消息列表)
values={'messages': [用户消息, AI回复, 用户消息...]},
# 接下来要执行的节点
next=('generate_response',),
# 配置信息(用于定位和恢复这个检查点)
config={'configurable': {'thread_id': '123', 'checkpoint_id': 'abc'}},
# 元数据(步骤号、来源、写入信息等)
metadata={'step': 2, 'source': 'loop', 'writes': {...}},
# 父检查点(形成链表,指向上一个 StateSnapshot 的 config)
parent_config={'configurable': {'thread_id': '123', 'checkpoint_id': 'def...'}},
# 创建时间
created_at=''
)StateSnapshot 的字段可以这样记:
| 字段 | 含义 |
|---|---|
values |
当前状态值(如对话消息列表) |
next |
接下来要执行的节点(元组;为空表示流程已结束) |
config |
配置信息 (含 thread_id、checkpoint_id),用于定位和恢复这个检查点 |
metadata |
元数据(步骤号、来源、写入信息等) |
parent_config |
父检查点 的 config,形成链表指向上一个快照 |
created_at |
快照创建时间 |
第二个关键特性是"版本历史与可恢复点" :一个 Thread 可以有多个 Checkpoints ,形成执行历史 ,使得同一个会话 的历史状态 可以从任意 Checkpoint 追溯 和访问。
2.4 线程级持久化实战
2.4.1 步骤一:配置 checkpointer 持久化存储
在定义图 时,我们需要指定 checkpointer 。LangGraph 支持多种 checkpointer 的定义方式:
| 方式 | 写法 | 适用场景 |
|---|---|---|
| 方式 1:内存存储 | InMemorySaver() |
开发和测试 :状态保存在程序内存 中,程序重启后状态会丢失 |
| 方式 2:Postgres 存储库 | 独立的、可安装的检查点存储库 | 生产环境 或需要状态持久化的场景 |
方式 1 的代码最简单:
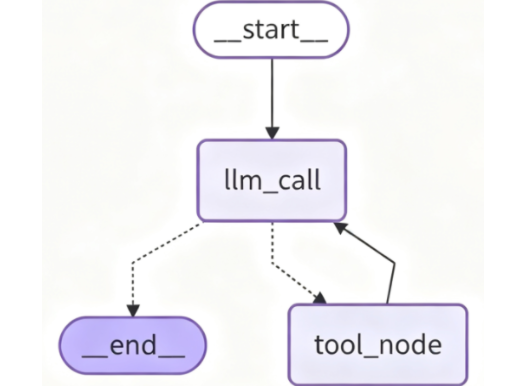
python
from langgraph.checkpoint.memory import InMemorySaver
# 定义存储方式
checkpointer = InMemorySaver()
# 用 checkpointer 编译图
agent = agent_builder.compile(checkpointer=checkpointer)💡 LangGraph 提供了几个检查点存储实现 ,所有这些都通过独立的、可安装的库实现,所以方式 2 需要额外安装对应的库(本篇不展开)。
2.4.2 步骤二:使用 Thread 执行
编译好图、准备运行 时,我们需要通过一个 Thread ID 来标识这次执行:
| 情况 | LangGraph 的行为 |
|---|---|
| Thread ID 不存在 | 创建一个新的 Thread ,从初始状态开始执行 |
| Thread ID 已存在 | 从 Checkpointer 中加载该 Thread 最后一次保存的状态 ,并从这个状态继续执行 |
代码示例:
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage
from langchain_core.tools import tool
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import MessagesState
from langgraph.prebuilt import ToolNode, tools_condition
from langgraph.checkpoint.memory import InMemorySaver


# ---------- 1. 定义工具 ----------
@tool
def get_weather(city: str) -> str:
    """查询指定城市的天气"""
    return f"{city}今天晴,气温 18~26 度。"


tools = [get_weather]  # 包装进列表


# ---------- 2. 定义模型并绑定工具 ----------
model = init_chat_model(model="deepseek-chat", model_provider="deepseek")
model_with_tools = model.bind_tools(tools)


# ---------- 3. 自定义状态(MessagesState + 额外字段 llm_calls)----------
# MessagesState 是 LangGraph 提供的【状态模板】,它内部自带了 messages 字段:
#     class MessagesState(TypedDict):
#         messages: Annotated[list[AnyMessage], add_messages]
#                        ↑字段名                    ↑合并规则:追加(不是覆盖)
class AgentState(MessagesState):
    llm_calls: int      # 额外加一个字段:跟踪 LLM 调用次数


# ---------- 4. 定义模型节点 ----------
def llm_call(state: AgentState):
    """模型节点:让 LLM 决定是否调用工具,并累计调用次数"""
    return {
        # 读取:state["messages"] 取出已有的全部消息(历史对话)
        # 写入:用 "messages" 作为 key 返回,新消息会按 add_messages 规则【追加】
        "messages": [model_with_tools.invoke(state["messages"])],
        "llm_calls": state.get("llm_calls", 0) + 1,   # 累计 LLM 调用次数
    }


# ---------- 5. 构建 Agent 图 ----------
builder = StateGraph(AgentState)
builder.add_node("llm_call", llm_call)
builder.add_node("tools", ToolNode(tools))     # 预构建的工具节点

builder.add_edge(START, "llm_call")
# tools_condition:内置条件函数 ------ 模型要调工具就去 tools,否则去 END
builder.add_conditional_edges("llm_call", tools_condition)
# 工具执行完再回到模型,形成循环
builder.add_edge("tools", "llm_call")

agent_builder = builder


# ---------- 6. 使用 InMemorySaver(内存检查点,程序结束即消失)----------
checkpointer = InMemorySaver()

# 编译图,挂上检查点(支持多轮记忆)
agent = agent_builder.compile(checkpointer=checkpointer)

# 第一次执行,创建一个新的 Thread (thread_id="1")
config = {"configurable": {"thread_id": "1"}}
result1 = agent.invoke(
    {"messages": [HumanMessage(content="今天厦门的天气如何?")]},
    config,
)

# result1["messages"] 读的是状态里的 messages 字段(完整对话历史)
for m in result1["messages"]:
    m.pretty_print()

# 第二次执行:同一个 thread_id → 检查点里存着上一轮的消息,模型能"记得"
result2 = agent.invoke(
    {"messages": [HumanMessage(content="我们刚才聊什么了")]},
    config,
)
for m in result2["messages"]:
    m.pretty_print()
运行结果:
#第一次打印
================================ Human Message =================================
今天厦门的天气如何?
================================== Ai Message ==================================
Tool Calls:
get_weather (call_00_CBGQs2Zlf6bblh8G2wUJ1568)
Call ID: call_00_CBGQs2Zlf6bblh8G2wUJ1568
Args:
city: 厦门
================================= Tool Message =================================
Name: get_weather
厦门今天晴,气温 18~26 度。
================================== Ai Message ==================================
今天厦门天气晴朗,气温在 18~26 度之间,比较舒适,适合外出活动。☀️
#第二次打印
================================ Human Message =================================
今天厦门的天气如何?
================================== Ai Message ==================================
Tool Calls:
get_weather (call_00_CBGQs2Zlf6bblh8G2wUJ1568)
Call ID: call_00_CBGQs2Zlf6bblh8G2wUJ1568
Args:
city: 厦门
================================= Tool Message =================================
Name: get_weather
厦门今天晴,气温 18~26 度。
================================== Ai Message ==================================
今天厦门天气晴朗,气温在 18~26 度之间,比较舒适,适合外出活动。☀️
================================ Human Message =================================
我们刚才聊什么了
================================== Ai Message ==================================
我们刚才聊的是天气。你问了今天厦门的天气情况,我帮你查询后告诉你:厦门今天晴,气温 18~26 度,天气比较舒适,适合外出活动。☀️💡 关键点在于两次
invoke用的是同一个config(也就是同一个thread_id="1")。第二次调用时 LangGraph 先把上一次的完整消息历史 从检查点里加载回来,再把你新说的话接上去,所以模型能回答"我们刚才聊的是天气"。如果第二次换一个thread_id,它就完全不认识你了 ------这正是 3.1 节要讲的跨会话丢信息问题。
2.5 其他使用方法
下面四个方法都建立在同一个前提上:图必须挂了 checkpointer。
2.5.1 获取最新快照
用 get_state(config) 可以获取编译后的图 的最新状态快照 。分别看执行前 与执行后:
代码示例:
python
# ---------- 6. 使用 InMemorySaver(内存检查点,程序结束即消失)----------
checkpointer = InMemorySaver()
# 编译图,挂上检查点(支持多轮记忆)
agent = agent_builder.compile(checkpointer=checkpointer)
# 第一次执行,创建一个新的 Thread (thread_id="1")
config = {"configurable": {"thread_id": "1"}}
# get_state:获取当前线程的【状态快照】(调用前,应该是空的)
print("=" * 30, "调用前的状态快照", "=" * 30)
snapshot = agent.get_state(config)
print(snapshot)
result1 = agent.invoke(
{"messages": [HumanMessage(content="今天厦门的天气如何?")]},
config,
)
for m in result1["messages"]:
m.pretty_print()
# get_state:再次获取状态快照(调用后,已经存了消息)
print("=" * 30, "调用后的状态快照", "=" * 30)
snapshot = agent.get_state(config)
print(snapshot)运行结果:
============================== 调用前的状态快照 ==============================
StateSnapshot(values={}, next=(), config={'configurable': {'thread_id': '1'}}, metadata=None, created_at=None, parent_config=None, tasks=(), interrupts=())
================================ Human Message =================================
今天厦门的天气如何?
================================== Ai Message ==================================
Tool Calls:
get_weather (call_00_74FG6LtV0bSQoUA9cRmK0813)
Call ID: call_00_74FG6LtV0bSQoUA9cRmK0813
Args:
city: 厦门
================================= Tool Message =================================
Name: get_weather
厦门今天晴,气温 18~26 度。
================================== Ai Message ==================================
今天厦门天气晴朗,气温在 18~26 度之间,比较舒适,适合外出活动。
============================== 调用后的状态快照 ==============================
StateSnapshot(values={'messages': [HumanMessage(content='今天厦门的天气如何?',💡 对比两次输出:调用前
values={}、next=(),说明这个线程还没有任何状态 ;调用后values里已经有messages列表了,metadata、created_at、parent_config也都填上了------这就是检查点在保存的直接证据。
2.5.2 获取快照历史记录
调用 get_state_history(config) 可以拿到给定线程 的完整执行历史 ,它返回与该线程 ID 关联的 StateSnapshot 对象列表。
代码示例:
python
# ---------- 7. 查看状态【历史记录】----------
# 【区别】
# get_state(config) → 只看【当前最新】的一条快照
# get_state_history(config) → 返回【整个线程的所有历史快照】(可迭代,最新的在最前)
# 每次图执行一步(走一个节点)都会产生一个检查点,历史里就多一条记录
print("=" * 30, "状态历史记录", "=" * 30)
history = list(agent.get_state_history(config))
print(f"共 {len(history)} 条历史快照\n")
for i, snap in enumerate(history):
print(f"--- 第 {i+1} 条(越靠前越新)---")
print(f" next(下一步节点): {snap.next}")运行结果:
============================== 状态历史记录 ==============================
共 5 条历史快照
--- 第 1 条(越靠前越新)---
next(下一步节点): ()
--- 第 2 条(越靠前越新)---
next(下一步节点): ('llm_call',)
--- 第 3 条(越靠前越新)---
next(下一步节点): ('tools',)
--- 第 4 条(越靠前越新)---
next(下一步节点): ('llm_call',)
--- 第 5 条(越靠前越新)---
next(下一步节点): ('__start__',)💡 一次"提问 → 调工具 → 回答"的完整流程,历史里就有 5 条 快照(从
__start__到结束),越靠前越新 。每一行的next就是"如果从这一刻继续跑,下一步该走哪个节点"。
2.5.3 重放(时间旅行)
如果用一个 thread_id 加一个 checkpoint_id (检查点标识符 ,指代线程内的特定检查点 )来调用图,那么**checkpoint_id** 之后的步骤会被重新执行。整体流程是:
-
先执行一次完整流程 ,拿到完整历史记录;
-
保存中间某一次快照 ,并重新执行该快照之后的步骤;
-
再取第二次调用后的完整历史记录 ,验证重放是否成功。
代码示例:
python
#接着上面的代码

# ---------- 7. 查看状态【历史记录】----------
print("-" * 80)
print("第一次执行历史:")
to_replay = None
for state in agent.get_state_history(config):
    print(
        "消息数: ", len(state.values["messages"]),
        "下一节点: ", state.next)
    # 找到"调用工具前"的那个状态(此时消息数为 2:用户提问 + 模型要调工具的回复)
    if len(state.values["messages"]) == 2:
        to_replay = state
print("-" * 80)


# ---------- 8. 时间旅行:从历史检查点【重放】执行 ----------
# 原理:把历史某个快照的 config 传给 invoke,图就从那一刻【重新开始执行】
print(f"从 {to_replay.next} 节点开始重新执行,重放配置:{to_replay.config}")
result2 = agent.invoke(None, config=to_replay.config)   # 从该检查点重放
print("-" * 80)

print("第二次执行历史(重放后):")
for state in agent.get_state_history(config):
    print(
        "消息数: ", len(state.values["messages"]),
        "下一节点: ", state.next)
print("-" * 80)
运行结果:
--------------------------------------------------------------------------------
第一次执行历史:
消息数:  4 下一节点:  ()
消息数:  3 下一节点:  ('llm_call',)
消息数:  2 下一节点:  ('tools',)
消息数:  1 下一节点:  ('llm_call',)
消息数:  0 下一节点:  ('__start__',)
--------------------------------------------------------------------------------
从 ('tools',) 节点开始重新执行,重放配置:{'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f1be374-3f0d-6399-8001-04e5ee0f16c3'}}
--------------------------------------------------------------------------------
第二次执行历史(重放后):
消息数:  4 下一节点:  ()
消息数:  3 下一节点:  ('llm_call',)
消息数:  2 下一节点:  ('tools',)
消息数:  4 下一节点:  ()
消息数:  3 下一节点:  ('llm_call',)
消息数:  2 下一节点:  ('tools',)
消息数:  1 下一节点:  ('llm_call',)
消息数:  0 下一节点:  ('__start__',)
--------------------------------------------------------------------------------
💡 要点:这个物理结构是栈,但是逻辑结构是链表。 从执行结果也能看出来:重放没有覆盖 原来的历史,而是新增 了一串(第二次历史里前 3 条是重放产生的,后面才是第一次执行留下的)。另外
invoke(None, config=...)的第一个参数传None,意思是"不给新输入,直接从那个检查点接着跑"。
2.5.4 更新状态
我们还可以编辑图状态 ,用 update_state() 方法做到。下面把用户的输入 换成其他搜索内容:
-
先执行一次完整流程 ,拿到完整历史记录;
-
保存第一次调用 LLM 前 的步骤快照 ,修改用户输入 来更新快照 ,并重新执行 更新后的快照步骤。
代码示例:
python
# ---------- 7. 第一次执行 ----------
result1 = agent.invoke(
    {"messages": [HumanMessage(content="今天厦门的天气如何?")]},
    config,
)

print("-" * 80)
print("第一次执行历史:")
selected_state = None
for state in agent.get_state_history(config):
    print(
        "消息数: ", len(state.values["messages"]),
        "下一节点: ", state.next)
    # 找到"调用 LLM 前"的步骤(消息数为 1,下一节点是 llm_call)
    if len(state.values["messages"]) == 1:
        selected_state = state
print("-" * 80)


# ---------- 8. 更新历史状态:把用户输入改掉 ----------
# update_state(config, 新值):根据指定检查点,【修改】那一步的状态
# Overwrite:绕过 reducer,直接替换(而不是追加)
print(f"更新前配置:{selected_state.config}")


new_config = agent.update_state(
    selected_state.config,
    {"messages":Overwrite([HumanMessage(content="今天北京的天气如何")])}
)
print("-" * 80)
print(f"更新后配置:{new_config}")


# ---------- 9. 从更新后的状态【重放】执行 ----------
result2 = agent.invoke(None, config=new_config)
for message in result2["messages"]:
    message.pretty_print()
运行结果:
--------------------------------------------------------------------------------
第一次执行历史:
消息数:  4 下一节点:  ()
消息数:  3 下一节点:  ('llm_call',)
消息数:  2 下一节点:  ('tools',)
消息数:  1 下一节点:  ('llm_call',)
消息数:  0 下一节点:  ('__start__',)
--------------------------------------------------------------------------------
更新前配置:{'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f1be3df-963a-6775-8000-7435bc76596b'}}
--------------------------------------------------------------------------------
更新后配置:{'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f1be3df-ad58-6762-8001-101647ec7fa0'}}
================================ Human Message =================================

今天北京的天气如何?
================================== Ai Message ==================================
Tool Calls:
  get_weather (call_00_VLfALCRuA65EDwb5iuqI2476)
 Call ID: call_00_VLfALCRuA65EDwb5iuqI2476
  Args:
    city: 北京
================================= Tool Message =================================
Name: get_weather

北京今天晴,气温 18~26 度。
================================== Ai Message ==================================

今天北京的天气是**晴天**,气温在 **18~26 度**之间。☀️

天气不错,适合外出活动,不过早晚温差有点大,建议带一件薄外套哦。
💡
update_state返回的是一个新的 config (注意checkpoint_id变了),这个新 config 就指向"改过之后 "的那个检查点。为什么要Overwrite:messages这个键挂着add_messages这个 reducer,如果直接传{"messages": [新消息]},新消息会被追加 进去,变成"厦门 + 北京"两条提问;用Overwrite才能把消息列表整体替换掉,让流程从"北京"这一问重新开始。
三、跨会话持久化(Store)
3.1 Checkpoint 的局限性
3.1.1 跨会话信息丢失
想象一个多会话的 AI 助手场景 :星期一 ,用户首次对话 ;星期二 ,用户开启一个新对话。
代码示例:
python
# 星期一,用户首次对话
# thread_id = "day_1":开启一个独立的会话线程
config1 = {"configurable": {"thread_id": "day_1"}}
result1 = graph.invoke(
    {"messages": [HumanMessage(content="我爱吃汉堡,推荐一家餐厅")]},
    config1,
)

# 星期二,用户开启一个新对话
# thread_id = "day_2":换了一个线程,与 day_1 完全隔离
config2 = {"configurable": {"thread_id": "day_2"}}
result2 = graph.invoke(
    {"messages": [HumanMessage(content="我爱吃什么?")]},
    config2,
)
result2["messages"][-1].pretty_print()
运行结果:
我不知道你具体喜欢吃什么,但可以根据一些常见的食物类型来猜测。比如,有些人喜欢甜食,如蛋糕和冰淇淋;有些人喜欢咸食,如薯条和披萨;还有些人喜欢健康的食物,如沙拉和水果。你可以告诉我你喜欢的食物类型,我可以给你一些推荐!问题出现 :AI 不记得用户喜欢汉堡 !每次对话都要"重新认识"。
3.1.2 现实世界的需求:从"单次对话"到"终身服务"
以一个智能客服系统为例,它的实际业务需求包括:
| 业务需求 | 说明 |
|---|---|
| 识别 VIP 客户 | 优先服务重要客户 |
| 避免重复询问 | 不问已经问过的问题 |
| 基于历史投诉优化服务 | 参考用户过去的投诉记录 |
仅是检查点无法满足这些需求:
代码示例:
# 编译图,挂上内存检查点(InMemorySaver:程序结束即消失,仅用于演示)
graph = builder.compile(checkpointer=InMemorySaver())

# 第一次投诉:thread_id = "query_1"
# 智能客服在一个独立线程中处理,过程包括:
#   - 搜集用户信息
#   - 了解用户问题与需求
#   - 处理问题
config1 = {"configurable": {"thread_id": "query_1"}}
result1 = graph.invoke(
    {"messages": [HumanMessage(content="我的账户被冻结了")]},
    config1,
)

# 10 天后,用户第二次投诉:thread_id = "query_2"
# 由于换了一个新的 thread_id,检查点完全隔离,
# 智能客服读不到 query_1 的任何历史,因此无法准确解决问题,
# 只能再次从头了解前因后果。
config2 = {"configurable": {"thread_id": "query_2"}}
result2 = graph.invoke(
    {"messages": [HumanMessage(content="我的账户又被冻结了")]},
    config2,
)要满足共享状态 的需求(如精准识别客户 、保留 VIP 客户关键历史记录 ),就需要引入 Store。
3.2 解决方案:引入 Store
Store 像是一个长期记忆仓库 ,支持我们在执行过程 中保存用户信息 、偏好设置 等长期数据 ,以实现不同对话间 信息的持久化共享。
3.2.1 存储 vs 检查点
| 概念 | 保存什么 | 类比 |
|---|---|---|
| 检查点(Checkpoint) | 状态变化历史 | 时间线 |
| 存储(Store) | 结构化知识 | 数据库 |
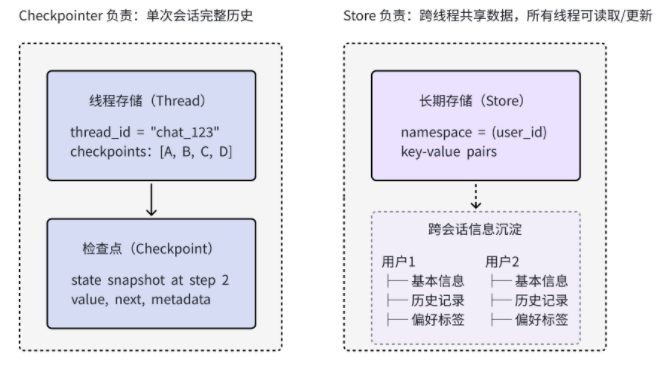
实际上,使用 Checkpoint + Store 模式才能够真正实现:
| 能力 | 由谁提供 |
|---|---|
| 单次会话内的状态恢复与时间旅行 | Checkpoint 保存状态变化历史 ,支持中断恢复 、回滚 、重放 |
| 跨会话的长期记忆与个性化共享 | Store 保存用户信息 、偏好设置 、历史记录 等结构化知识 ,在不同 Thread 之间共享 |
| 完整的持久化能力 | 两者结合,让 AI 应用 既能"记住这次对话 ",又能"记住这个用户" |
这样才能支撑智能客服 、多会话助手等复杂场景。
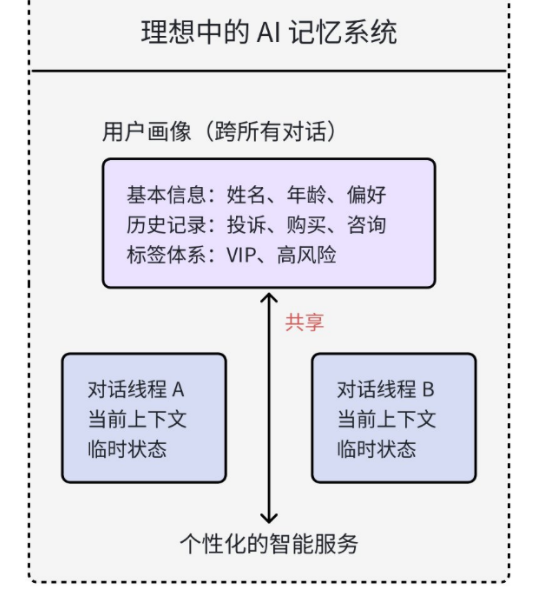
3.2.2 引入 Store 后,AI 应用架构的范式转变
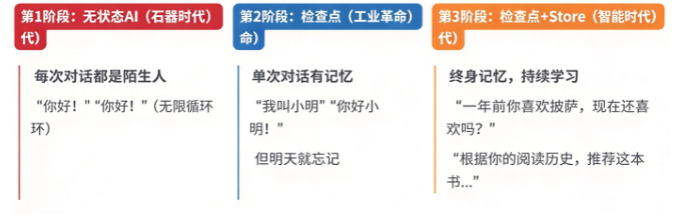
Store 的引入,真正做到了三个转变:
| 从 | 到 |
|---|---|
| 关注单次交互 | 关注用户生命周期 |
| 处理当前请求 | 利用历史数据 |
| 通用回复 | 深度个性化 |
3.3 跨会话持久化实战
要想使用 Store ,需要先创建一个存储实例 ,它同样有**【内存级存储】** 与**【存储库存储】**两种方式:
代码示例:
python
# 从 LangGraph 的内存存储模块导入 InMemoryStore
from langgraph.store.memory import InMemoryStore

# 创建一个内存存储实例
store = InMemoryStore()
接着像以前一样,把 Checkpoints 和 Store 一起传给 compile 即可:
代码示例:
python
graph = builder.compile(checkpointer=checkpointer, store=store)3.3.1 内存存储与命名空间
Store 本身是通过 Namespace 区分不同数据的。在 LangGraph 中提供一个简单的内存实现 InMemoryStore 。想要进行存储 ,需要先定义命名空间 :为了区分不同用户 的记忆 ,需要一个"命名空间 "------这就像在数据库 里为每个用户 创建一个独立的文件夹 。命名空间 用于组织记忆 ,通常按业务逻辑 划分,一般用元组来定义:
# 使用元组 —— 层次清晰,易于扩展
namespace1 = ("user_123", "preferences", "food")      # 用户食物偏好
namespace2 = ("user_123", "preferences", "music")     # 用户音乐偏好
namespace3 = ("user_123", "conversations", "2025-05") # 用户某月的对话历史

# 使用字符串 —— 扁平且易混淆
namespace4 = "user_123_preferences_food"              # 需要解析,容易出错
namespace5 = "user_123_preferences_music"
namespace6 = "user_123_conversations_2024"| 写法 | 优点 | 缺点 |
|---|---|---|
| 元组(推荐) | 层次清晰 ,易于扩展 | 拼错层级时不易察觉 |
| 字符串 | 写法扁平 | 需要解析,容易出错、易混淆 |
当在对话中获取到用户 的重要信息 时,用 store.put() 方法把记忆 保存到存储中的命名空间:
| 参数 | 说明 |
|---|---|
namespace |
决定这条记忆 属于谁 、是什么类型 |
memory_id |
这条记忆条目 的唯一键 |
memory_content |
记忆 的具体内容,一个字典 |
# put(namespace, key, value)
#   - namespace:命名空间,必须是元组,用于隔离不同用户或应用
#                例如 ("users", "user_123") 或 ("memories", "chat")
#   - key      :条目标识,字符串,类似字典的键
#   - value    :要保存的内容,通常是一个字典(也可为其他可序列化类型)
store.put(namespace, memory_id, memory_content)
完整代码:
python
from langgraph.store.memory import InMemoryStore
import uuid       # 用于生成唯一 ID


# ---------- 1. 导入并创建存储 ----------
store = InMemoryStore()


# ---------- 2. 定义命名空间 (Namespace) ----------
# 命名空间用于组织记忆,通常按业务逻辑划分,例如按用户。
# 这里我们用一个元组 (用户ID, 记忆类型)
user_id = "user_123"
namespace = (user_id, "preferences")     # 用户 user_123 的偏好记忆


# ---------- 3. 存入一条记忆 (Memory) ----------
# 每条记忆需要一个唯一的 memory_id 和一个 value(通常是字典)
memory_id = str(uuid.uuid4())            # 生成唯一 ID,如 "abc-123-def-456"
memory_value = {"favorite_food": "汉堡", "allergy": "花粉"}

store.put(namespace, memory_id, memory_value)
print("记忆已存入!")


# ---------- 4. 读取记忆 ----------
# 可以搜索某个命名空间下的所有记忆
all_memories = store.search(namespace)
for mem in all_memories:
    print(mem.dict())                    # 记忆对象转成字典查看
运行结果:
记忆已存入!
{'namespace': ['user_123', 'preferences'], 'key': '9f478fa0-fde8-4015-bac1-b5c028b5d697', 'value': {'favorite_food': '汉堡', 'allergy': '花粉'}, 'created_at': '2026-10-04T08:37:34.792960+00:00', 'updated_at': '2026-10-04T08:37:34.792960+00:00', 'score': None}
3.3.2 在 LangGraph 中使用 Store
由于要加入 Store ,需要在合适的地方 加入与存储关键信息 相关的代码 。例如,可以在每次调用 LLM 前先做信息收集 ,再带着收集到的共享信息 去调用 LLM。
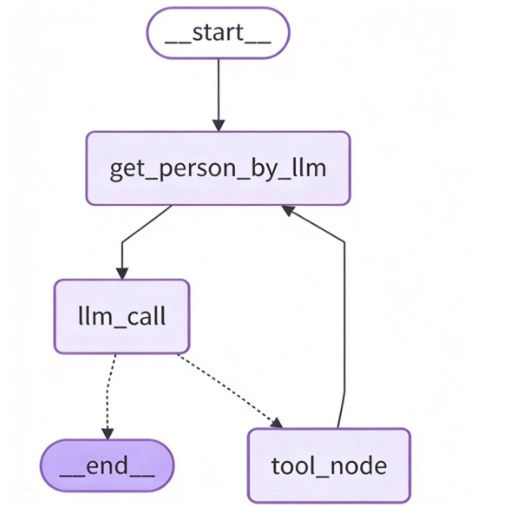
这样,两部分信息 会被收集:一是用户发的消息 ;二是通过工具调用返回的结果信息。
在编译图 时,直接添加编译参数 store:
代码示例:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

# 用 checkpointer + store 编译图
agent = agent_builder.compile(checkpointer=checkpointer, store=store)这样,在任何一个节点 的函数中,都可以通过注入 store 参数 来访问这个全局存储。
新增提取用户信息节点 :在这个节点中,需要根据【用户发的消息 】和【工具调用返回的结果 】来采集要收集的信息 ,并用 Store 存起来。两个关键设计:
| 设计点 | 说明 |
|---|---|
| 怎么拿到 Store | 任何节点函数 ,如果需要访问 Store ,可以在参数中声明 store: BaseStore 和 config: RunnableConfig |
| 怎么提取信息 | 可以通过 LLM 提取用户信息 ,因此定义结构化返回很有必要 |
完整代码:
python
import uuid
import operator
from typing import Optional

from langchain.chat_models import init_chat_model
from langchain_core.runnables import RunnableConfig
from langchain_tavily import TavilySearch
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.store.base import BaseStore
from langgraph.store.memory import InMemoryStore
from pydantic import BaseModel, Field
from typing_extensions import TypedDict, Annotated
from langchain_core.messages import AnyMessage, HumanMessage, SystemMessage, ToolMessage


# ---------- 步骤 1: 定义工具和模型 ----------
search = TavilySearch(max_results=4)
tools = [search]

model = init_chat_model(model="deepseek-chat", model_provider="deepseek", temperature=0)
model_with_tools = model.bind_tools(tools)


# ---------- 步骤 2: 定义状态 ----------
class MessagesState(TypedDict):
    messages: Annotated[list[AnyMessage], operator.add]
    llm_calls: int


# ---------- 步骤 3: 新增提取信息节点 ----------
class Person(BaseModel):
    """一个人的信息。"""
    name: Optional[str] = Field(default=None, description="这个人的名字")
    height_in_meters: Optional[str] = Field(default=None, description="以米为单位的高度")
    favourite_food: Optional[list[str]] = Field(default=None, description="最喜欢的食物列表")


model_with_structured = model.with_structured_output(Person)


def get_person_by_llm(state: MessagesState, config: RunnableConfig, *, store: BaseStore):
    """通过 LLM 提取用户信息"""
    # 1. 先提取
    people_info = model_with_structured.invoke(
        [
            SystemMessage(
                content="你是一个提取信息的专家,只从文本中提取我的相关信息,不能提取别人的信息。如果你不知道要提取的属性的值,属性值返回null。"
            )
        ]
        + state["messages"][-3:]
    )

    # 2. 再保存
    user_id = config["configurable"]["user_id"]

    namespace1 = (user_id, "info")
    store.put(
        namespace1,
        str(uuid.uuid4()),
        {"name": people_info.name, "height": people_info.height_in_meters},
    )

    namespace2 = (user_id, "preferences")
    store.put(
        namespace2,
        str(uuid.uuid4()),
        {"favourite_food": people_info.favourite_food},
    )

    return {"llm_calls": state.get("llm_calls", 0) + 1}


# ---------- 步骤 4: 模型调用节点 ----------
def llm_call(state: MessagesState, config: RunnableConfig, *, store: BaseStore):
    """LLM 决定是否调用工具"""
    # 搜索用户信息(按命名空间精确搜索)
    user_id = config["configurable"]["user_id"]
    namespace1 = (user_id, "info")
    namespace2 = (user_id, "preferences")

    info_result = store.search(namespace1)
    pref_result = store.search(namespace2)

    return {
        "messages": [
            model_with_tools.invoke(
                [
                    SystemMessage(
                        content="你是一个乐于助人的助手,支持调用工具进行搜索。"
                        "查询 LLM 前可参考以下信息:"
                        f"1. 用户基本情况:{info_result[0].value} "
                        f"2. 用户偏好情况:{pref_result[0].value}"
                    )
                ]
                + state["messages"]
            )
        ],
        "llm_calls": state.get("llm_calls", 0) + 1,
    }


# ---------- 步骤 5: 定义工具节点 ----------
tools_by_name = {tool.name: tool for tool in tools}


def tool_node(state: dict):
    """执行工具调用"""
    result = []
    for tool_call in state["messages"][-1].tool_calls:
        tool = tools_by_name[tool_call["name"]]
        observation = tool.invoke(tool_call["args"])
        result.append(ToolMessage(content=observation, tool_call_id=tool_call["id"]))
    return {"messages": result}


# ---------- 步骤 6: 构建图 ----------
def should_continue(state: MessagesState):
    """根据 LLM 是否调用工具,决定继续循环还是停止"""
    messages = state["messages"]
    last_message = messages[-1]
    if last_message.tool_calls:
        return "tool_node"
    return END


agent_builder = StateGraph(MessagesState)
agent_builder.add_node("llm_call", llm_call)
agent_builder.add_node("tool_node", tool_node)
agent_builder.add_node("get_person_by_llm", get_person_by_llm)

agent_builder.add_edge(START, "get_person_by_llm")
agent_builder.add_edge("get_person_by_llm", "llm_call")
agent_builder.add_conditional_edges(
    "llm_call",
    should_continue,
    ["tool_node", END],
)
agent_builder.add_edge("tool_node", "get_person_by_llm")


# ---------- 步骤 7: 编译(挂检查点 + 存储)----------
checkpointer = InMemorySaver()
store = InMemoryStore()          # ← 没有嵌入模型(无 index)

agent = agent_builder.compile(checkpointer=checkpointer, store=store)


# ---------- 步骤 8: 测试 ----------
config = {"configurable": {"thread_id": "1", "user_id": "user_123"}}

result1 = agent.invoke(
    {"messages": [HumanMessage(content="我叫小明,身高1米75,最喜欢吃汉堡和披萨")]},
    config,
)
print("=" * 30, "第一次执行", "=" * 30)
for m in result1["messages"]:
    m.pretty_print()

print("=" * 30, "Store 中已存的记忆", "=" * 30)
for ns in [("user_123", "info"), ("user_123", "preferences")]:
    print(f"命名空间 {ns}:")
    for mem in store.search(ns):
        print("   ", mem.value)
运行结果:
============================== 第一次执行 ==============================
================================ Human Message =================================

我叫小明,身高1米75,最喜欢吃汉堡和披萨
================================== Ai Message ==================================

你好,小明!很高兴认识你 😊

我记住了你的信息:
- **身高**:1.75 米
- **最喜欢的食物**:汉堡 🍔 和披萨 🍕

有什么我可以帮你的吗?比如:
- 推荐适合你身高的穿搭建议
- 找找附近好吃的汉堡店或披萨店
- 计算一下你的理想体重范围
- 或者其他任何问题

随时告诉我!
============================== Store 中已存的记忆 ==============================
命名空间 ('user_123', 'info'):
    {'name': '小明', 'height': '1.75'}
命名空间 ('user_123', 'preferences'):
    {'favourite_food': ['汉堡', '披萨']}
💡 图的循环值得注意:
get_person_by_llm(提取并存记忆 )→llm_call(读记忆再回答 )→ 需要工具就tool_node→ 再回到get_person_by_llm。也就是说,每一轮都会重新提取一次用户信息 ,这让记忆能随着对话不断累积更新 。另外config里除了thread_id还多了一个user_id------线程用来隔离会话,user_id用来跨会话认人,二者分工不同。
3.3.3 语义搜索
Store 的强大之处在于它支持语义搜索 ,而不仅仅是精确匹配 ------这意味着我们可以用自然语言问题 来查找相关记忆。
代码示例:
python
# ---------- 步骤 4: 更新模型调用节点(把共享的用户信息加到提示词)----------
def llm_call(state: MessagesState, config: RunnableConfig, *, store: BaseStore):
    """LLM 决定是否调用工具"""
    user_id = config["configurable"]["user_id"]

    # ========== ① 旧写法:按命名空间【精确】搜索 ==========
    # namespace1 = (user_id, "info")
    # namespace2 = (user_id, "preferences")
    #
    # info_result = store.search(namespace1)
    # pref_result = store.search(namespace2)
    #
    # return {
    #     "messages": [
    #         model_with_tools.invoke(
    #             [
    #                 SystemMessage(
    #                     content=f"你是一个乐于助人的助手,支持调用工具进行搜索。"
    #                     f"查询 LLM 前可参考以下信息:"
    #                     f"1. 用户基本情况:{info_result[0].value} "
    #                     f"2. 用户偏好情况:{pref_result[0].value}"
    #                 )
    #             ]
    #             + state["messages"]
    #         )
    #     ],
    #     "llm_calls": state.get('llm_calls', 0) + 1,
    # }

    # ========== ② 新写法:在 Store 中进行【语义搜索】 ==========
    # 这里直接在 user_id 维度下通过语义去找(namespace 只到 user_id 一层)
    namespace = (user_id,)

    # query:按语义找最相关的记忆;limit:最多返回几条
    info_result = store.search(namespace, query="用户基本信息", limit=2)
    pref_result = store.search(namespace, query="用户偏好信息", limit=2)

    return {
        "messages": [
            model_with_tools.invoke(
                [
                    SystemMessage(
                        content="你是一个乐于助人的助手,支持调用工具进行搜索。"
                        "查询 LLM 前可参考以下信息:"
                        f"1. 用户基本情况:{[m.value for m in info_result]} "
                        f"2. 用户偏好情况:{[m.value for m in pref_result]}"
                    )
                ]
                + state["messages"]
            )
        ],
        "llm_calls": state.get("llm_calls", 0) + 1,
    }
Store 要开启语义搜索,必须带上向量索引,两种 Store 的差别如下:
# ========== ① 旧写法:不带向量索引的 Store ==========
# 只支持按 namespace 列出记忆,不支持语义搜索(query 参数无效)
# store = InMemoryStore()

# ========== ② 新写法:带【本地嵌入模型】的 Store(支持语义搜索) ==========
store = InMemoryStore(
    index={
        "embed": FastEmbed(),   # 本地部署的嵌入模型(不需要 key)
        "dims": 512,            # 维度必须与嵌入模型一致(bge-small-zh = 512)
        "fields": ["$"],        # 对 value 中的所有字段进行嵌入
    }
)| 配置项 | 作用 |
|---|---|
embed |
用哪个嵌入模型 把记忆转成向量(这里是上一篇文章封装的本地嵌入类,不需要 key) |
dims |
向量维度 ,必须与嵌入模型一致 (bge-small-zh 是 512) |
fields |
对 value 里的哪些字段 做嵌入,["$"] 表示所有字段 |
💡 语义搜索和精确搜索的区别值得记牢:精确搜索 是"把
(user_123, "info")这个文件夹里的条目录出来",语义搜索 则是"在(user_123,)这一层下,按语义 找出跟'用户基本信息'最像的条目"。所以语义搜索要求命名空间放宽到更上一层 ,让不同子类别的记忆一起参与比对------这也是为什么新写法的namespace只到user_id一层。
四、复盘(附答案)
💡 思考题
-
持久化解决的核心问题是什么?没有持久化时,"用户问完天气、程序崩溃、用户再问要不要带伞"会发生什么?
-
线程级持久化和跨会话持久化分别解决什么问题?各自对应哪种存储?
-
LangGraph 里的"线程(Thread)"和操作系统的"线程"是一回事吗?"状态快照"和我们前面学的 State 是同一个东西吗?
-
StateSnapshot里next和parent_config分别是什么?为什么说"物理结构是栈、逻辑结构是链表"? -
get_state、get_state_history、重放、update_state四个用法各解决什么问题?update_state时为什么常要配Overwrite? -
为什么只有 Checkpoint 不够,还需要 Store?Store 的命名空间为什么要用元组?语义搜索对 Store 有什么额外要求?
📝 答案
-
核心问题是状态会不会丢 :把 AI 应用的状态 (对话历史、中间结果、用户信息)保存 下来,程序重启或宕机 后能恢复 并接着跑 。没有持久化时,崩溃重启等于失忆 ------用户再问"要不要带伞",助手没有之前的上下文 ,很可能再调一次搜索工具,而不是基于"今天晴天"直接回答"不需要"。
-
线程级持久化 解决单次会话内的上下文连续 :自动保存工作流执行过程的状态快照 ,支持中断恢复、回滚、重放 ,对应场景二,靠 Checkpointer (如
InMemorySaver)。跨会话持久化 解决用户级别的长期记忆 :保存用户信息、偏好设置 等长期数据,在不同对话间共享 ,对应场景一,靠 Store。 -
不是一回事 。操作系统的线程 是进程内的执行单元 ,是操作系统调度的最小单位 ;而这里的 Thread 表示聊天过程中的单次会话 的持久化信息,作用是隔离不同的聊天会话 ,两者概念完全独立 。"状态快照"也不等于 State :快照里的状态 包含所有必要的上下文信息 ------调用过哪些工具、用户输入、聊天历史、下一步要执行的节点等。
-
next是下一步要执行的节点 (元组,为空说明流程已结束),parent_config是父检查点的 config ,把一个个快照串成链表 ,因此历史可以从任意检查点追溯 。说"物理结构是栈、逻辑结构是链表 ",是因为新快照压在栈顶 、越靠前越新,但每个快照又能通过parent_config回溯到上一个 ------重放时也是新增一串快照,而不是覆盖旧的。 -
get_state看当前最新 的一条快照(执行前values={}、next=(),执行后已有消息);get_state_history拿整个线程的全部历史快照 (可迭代、最新的在最前),一次完整流程会有 5 条;重放 是拿历史某个快照的config传给invoke,让图从那一刻重新执行 (invoke(None, config=...)表示不给新输入);update_state是直接改掉 某一步的状态,改完返回新的 config (checkpoint_id变了)。用Overwrite是因为messages挂着add_messagesreducer,直接传新值会被追加 (变成"西安 + 北京"两条提问),只有Overwrite才能把消息列表整体替换。 -
因为 Checkpoint 是按线程隔离的 :换一个
thread_id(比如 10 天后用户第二次投诉)就读不到上一次的任何历史,智能客服每次都要重新问一遍 前因后果。Store 是跨线程的长期记忆仓库 ,才能做到识别 VIP、保留关键历史、深度个性化 。命名空间用元组 是为了层次清晰、易于扩展 (("user_123", "preferences", "food")),字符串形式需要解析、容易出错 。语义搜索 要求 Store 带向量索引 :要配置embed(嵌入模型)、dims(维度必须与模型一致,bge-small-zh为 512 )、fields(对哪些字段嵌入,["$"]表示全部),否则query参数无效,只能按命名空间精确列出。
🎯 闭幕
如果本文对你有帮助,欢迎:
👍 点赞 | ⭐ 收藏 | 👤 关注作者 | 💬 留言交流你的疑问或补充
你的每一次互动都是我继续更新的动力,我们下一篇见!🚀