你搭过一个 planner 交给 coder、coder 再交给 reviewer 的多智能体流水线。每一棒的交接方式只有一种:前一个模型把自己想到的东西,翻译成一串 token;后一个模型再把这串 token 读回去。
这个翻译动作的代价,比大多数人以为的高得多。高维的内部表征被压成一条线性字符串,能装下的信息少得可怜;而且每翻译一次就要等一遍逐 token 解码。清华 NICS-EFC 实验室、上海 AI Lab 和无问芯穹的一篇 ICLR 2026 论文给了一个很直接的回答:别翻译了,把 KV-Cache 直接递过去。
结果是准确率提升 6.4--14.2 个百分点,延迟平均快 2.5 倍。但真正的看点在最后一节------这篇论文自己承认的限制,决定了它今天能不能进你的系统。
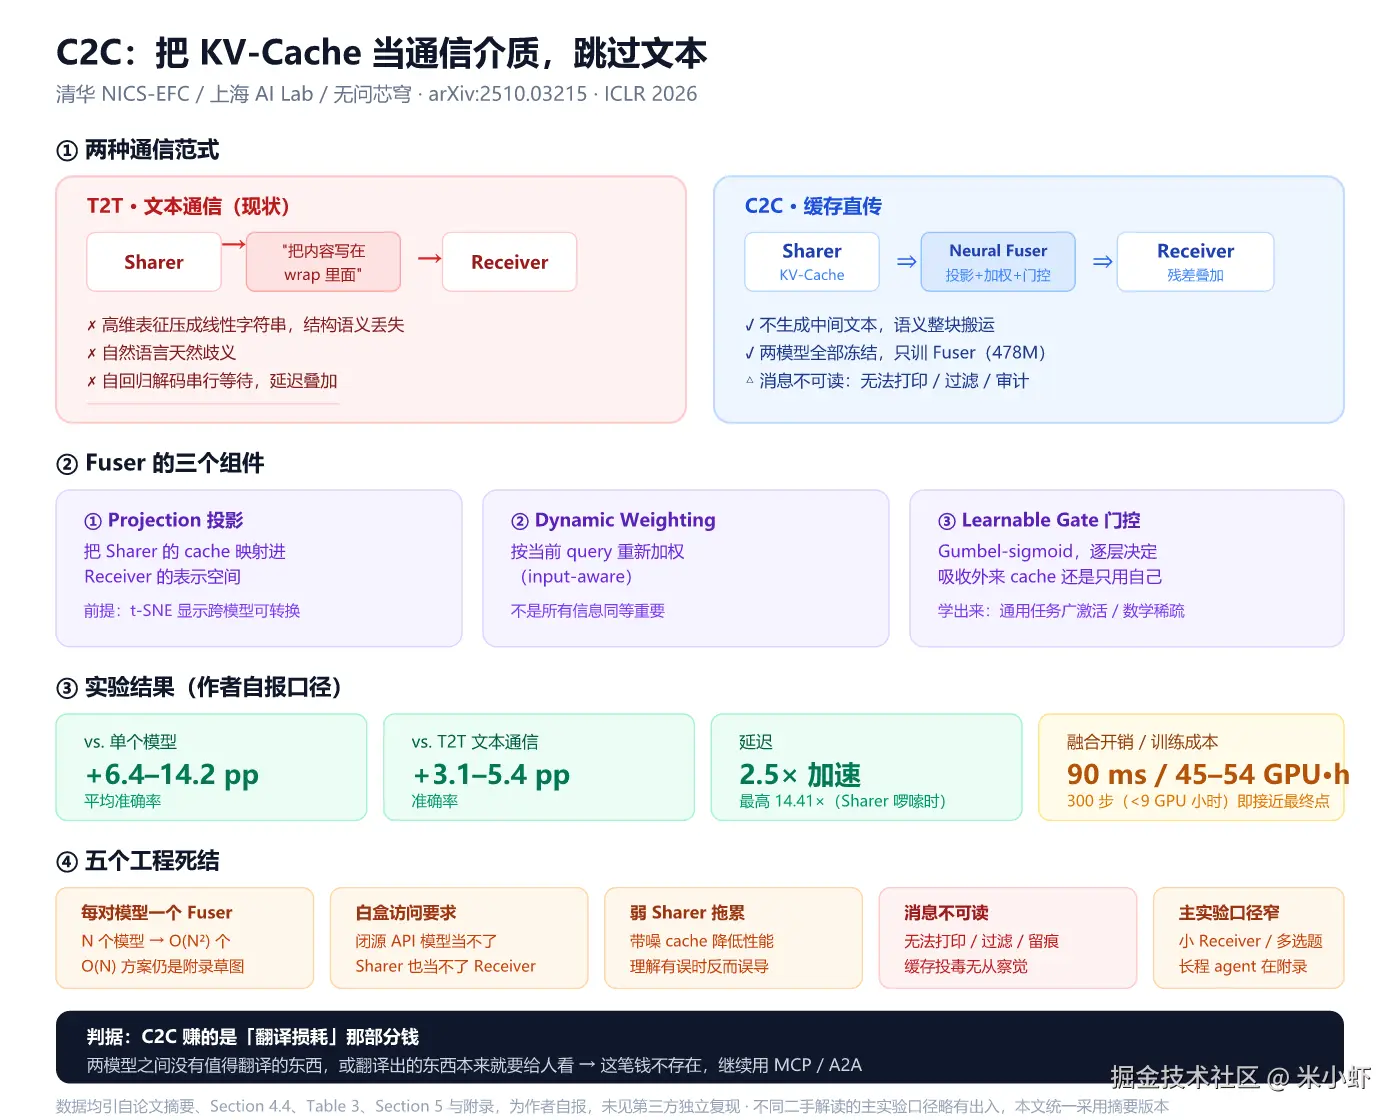
一、文本通信(T2T)的三笔账
论文把现有的多模型协作接口统一叫作 Text-to-Text(T2T):模型 A 解码出文本,模型 B 把它当输入读进去。作者拆解出三笔成本,每一笔都是机制性的,不是调参能绕过的。
第一笔:带宽。 一个模型处理 prompt 时,内部是高维状态铺在几十层的注意力里------包含歧义、部分结论、还没说出口的犹豫。要传给另一个模型,必须压成一条线性 token 序列。压不进去的部分就直接没了,接收方只能从字面重建含义,拿不到发送方的真实内部状态。
论文 Figure 2 给了个特别直观的例子:一个 Coder 模型告诉 Writer 模型"把内容写在 wrap 里面"。这里的 <p> 是段落分隔符,但它的结构语义在文本里丢失了------Writer 把它当成字面单词,把内容插错了位置。这种信息在文本通道里根本无法编码。
第二笔:歧义。 自然语言天然模糊,成语、指代不清、含糊表述随处可见。有人指望 MCP、A2A 这类协议能解决------但协议只能标准化消息的模板,模板管不住开放域协作里那些灵活的东西。刚性模板和灵活协作之间存在结构性矛盾。
第三笔:延迟。 这是最容易被量化的。生成是自回归的:源模型必须一个 token 一个 token 地把话说完,下一个模型才能开始。在三四棒的链路里,这些串行生成步骤直接叠加。对一条欺诈分诊流水线或者一个多步规划 agent 来说,这个逐 token 交接往往是端到端延迟的主要贡献者,也是账单里不小的一块。
| 成本 | 本质 | 能否靠调参绕过 |
|---|---|---|
| 信息瓶颈 | 高维表征 → 线性字符串的有损压缩 | 不能,是介质本身的性质 |
| 歧义 | 自然语言的多义性 | 部分缓解,协议只能管模板 |
| 延迟 | 自回归解码的串行性 | 不能,除非不生成 |
二、先别急着设计网络:两个 Oracle 实验
这篇论文方法论上最值得学的一步,是它在设计 Fuser 之前,先用两组"神谕实验"(oracle experiment)验证前提。很多工作直接上结构,结果说不清收益来自哪里。
Oracle 1------语义增强有益吗? 在不增加序列长度(也就是不增加要处理的 token 数)的前提下,让 KV-Cache 里的语义变得更"丰富",回答质量会不会变好?
会。这说明 KV-Cache 本身可以承载更多有效语义,而不只是"计算的副产品"。
Oracle 2------跨模型可转换吗? 一个模型的 KV-Cache,另一个模型能用吗?
作者用 t-SNE 可视化:不同模型的原始 cache 确实住在表示空间的不同"街区"里,但一个简单的投影就能把其中一个映射进另一个的邻域。不是完全重合,但足够接近,值得往下做。
两组前提都站住了,才进入网络设计。这个顺序解释了后面为什么门控是必需的------因为 Oracle 1 的结果本身是逐层不同的(论文 Figure 4),而门控正是从这条观察里长出来的,不是拍脑袋加的装饰。
三、C2C 的机制:三个组件 + 两个对齐
C2C 有两个角色:Sharer(分享方) 和 Receiver(接收方)。Sharer 把自己的 KV-Cache 交给 Receiver,Receiver 基于此继续计算。全程不生成任何中间文本。
3.1 先对齐:两个模型说的不是同一种"语言"
两个障碍摆在前面:
- tokenizer 不同 ------ Qwen 和 Llama 切出来的 token 序列对不上
- 层数不同 ------ 32 层的模型和 40 层的模型,第 10 层不代表同一个深度
论文的解法是两个启发式规则:
markdown
token 对齐:maximal-coverage token mapping
            找能覆盖最大范围的 token 映射关系

层对齐:terminal alignment(末端对齐)
            不从第 1 层往前配,而是从输出侧往回配
            ┌─ Sharer:   L-3  L-2  L-1   L    ← 输出
            │                ↕    ↕    ↕   ↕
            └─ Receiver: M-3  M-2  M-1   M    ← 输出
末端对齐的理由很朴素:靠近输出的层语义更"成型",比靠近输入的层更容易匹配。
作者明确说这是工程近似,不是被证明的最优方法 。而且因为映射后的 cache 只覆盖 Receiver 表示空间的一部分,所以 C2C 选择叠加 而不是替换------保住 Receiver 自己的理解。
3.2 Fuser:投影 → 动态加权 → 门控
css
Sharer KV-Cache
      │
      ▼
┌───────────────┐
│ ① Projection  │  把 Sharer 的 cache 投到 Receiver 的表示空间
└───────────────┘
      │
      ▼
┌───────────────┐
│ ② Dynamic     │  根据当前 query 重新加权(input-aware)
│    Weighting  │  不是所有信息对当前问题都同等重要
└───────────────┘
      │
      ▼
┌───────────────┐
│ ③ Learnable   │  Gumbel-sigmoid,逐层决定:
│    Gate       │  这一层吸收外来 cache,还是只用自己原来的
└───────────────┘
      │
      ▼  残差相加(不是替换)
Receiver KV-Cache(已增强)
一句话点破它和已知事物的关系 :这就是"往冻结网络里注入外部信息"那一族手法的又一个实例------和 Adapter、LoRA 的思路同宗,区别只在于注入的位置是激活(KV-Cache)而不是权重。所以那两个关键设计(残差相加保住原有能力、可学习门控控制注入强度)不是 C2C 独创,是从这一族里继承来的成熟模板。
训练方式很克制:两个 LLM 全部冻结,只训练 Fuser ,用标准的 next-token prediction loss,让 Receiver 在融合后的 cache 条件下预测答案。Fuser 参数量 478M。
3.3 门控学到了什么
这部分是全文我最喜欢的工程细节。训练完去看门控的选择,发现:
- 通用任务 (MMLU、ARC 等)→ 偏好广泛激活,很多层都吸收
- 专用任务 (GSM8K 这类数学)→ 偏好稀疏选择,只让少数特定层吸收
也就是说,"哪一层该听对方"不是一个人拍的超参,是数据学出来的,而且因任务而异。这也侧面印证了 Oracle 1 那个"逐层不同"的观察。
四、结果:不只是"更快"
主实验覆盖 OpenBookQA、ARC-Challenge、MMLU-Redux、C-Eval,另有 LongBenchV1 测长上下文、GSM8K 测数学。训练数据是 OpenHermes-2.5(500k 样本)加 LongBench-E。
| 对比项 | 结果 |
|---|---|
| vs. 单个模型 | 平均准确率高 6.4--14.2 个百分点 |
| vs. T2T 文本通信 | 高 3.1--5.4 个百分点 |
| 延迟 | 平均 2.5× 加速(Sharer 特别啰嗦时最高 14.41×) |
| 融合开销 | 每次回答时混合两个 cache 耗时 90 ms |
三个消融数据说明收益不是白来的:
| 消融 | 增益 |
|---|---|
| 残差融合(相对于直接投影丢弃 Receiver 自己的 cache) | +24.18% |
| 加门控(相对于无门控融合) | +3.07% |
对照组设计得相当干净。在同样的训练预算下,C2C 还打赢了两个很容易想到的替代解释:
- 打赢"不给 Sharer、直接训 Receiver" ------ 说明收益不是来自多训了一会儿
- 打赢"同一个模型既当 Sharer 又当 Receiver" ------ 说明收益不是来自多出来的参数
- 而且 C2C 用的可训练权重更少(478M,对比 596M 和 529M)
三条加起来,基本排除了"容量增加"和"训练集过拟合"这两个最常见的假阳性来源。收益确实来自异构 Sharer 贡献的互补语义。
另外两个有意思的发现:
有效秩(effective rank)提升。 融合后 Receiver 的 KV-Cache 有效秩变高了,意味着它字面意义上包含了更多有用的语义维度。这给"信息确实传过去了"提供了除准确率之外的第二个证据。
Sharer 可以是不听话的 base 模型。 只要内部语义理解够强,即使指令跟随能力差也能当 Sharer。这说明核心能力和指令遵循是可以分开传输的------这点对用开源 base 模型做专家模块很有启发。
五、理想丰满,现实骨感:五个工程死结
这一节决定了这篇文章值不值得读,也是论文作者自己在 Section 5 和附录里承认的边界。
死结 1:每一对模型都要训练一个 Fuser
Fuser 不属于某个模型,它属于某一对模型。换一个 Sharer,或者换一个 Receiver,就要重新训练。
规模化的账很难看:N 个模型两两通信需要 O(N²) 个 Fuser。作者在附录里试过共享 projector 和多 Sharer 的方案,能把成本往 O(N) 压,但那部分明确是草图,不是主结果。
训练成本本身不算离谱------300 步(不到 9 GPU 小时)就能接近最终 checkpoint,完整一轮约 45--54 GPU 小时。但这是"一对"的成本,乘以 N² 就是另一回事了。
死结 2:白盒访问要求把闭源 API 模型挡在门外
C2C 需要读取两个模型的内部 KV-Cache。这意味着:
- 你没法让 GPT-6 Astra 或 Claude 当 Sharer
- 你也没法让它们当 Receiver
- 整个方案只在你能拿到权重、能改推理代码的模型上成立
这是它和文本通信最根本的 trade-off。文本是通用接口 ,任何两个模型都能说;cache 是专用接口 ,快且高保真,但要求双方都敞开内部。C2C 换来的效率,正是以放弃通用性为代价买来的------不是免费午餐。
死结 3:弱的 Sharer 会拖累强的 Receiver
多模型系统里这条规律对 T2T 和 C2C 同样成立:Sharer 的语义质量直接决定 Receiver 的表现。如果一个明显更弱的模型提供带噪的 cache,性能会下降。
论文还记了一个更隐蔽的失败模式:在某些情况下 Sharer 的上下文理解本身是错的,会把 Receiver 误导到错误答案。这一点在文本通信里至少还能靠人眼抽查发现,在 cache 通信里------见死结 4。
死结 4:消息不可读,调试、审计、拦截全部失效
这是最容易被忽略、但工程上最致命的一条。
传文本时,中间件能打印、能过滤、能审计、能在发现问题时拦截。传 KV-Cache 时:
- 你看不到 Sharer "说"了什么
- 你没法在链路上加内容安全过滤
- 出问题时没有日志可读
- 攻击面变了:如果 Sharer 的 cache 被投毒,Receiver 无法察觉
有意思的是,这同时是一个隐私卖点------传 cache 不暴露可读的思维过程,云边协作时可以只传"精炼过的"cache 片段而不传原始文本。同一个性质,在隐私场景是优势,在可观测性场景是灾难。
把它和最近这半年的几条线放在一起看会更清楚:CoT 不忠实、Plan Injection 可以绕过 monitor、循环深度把推理推进潜空间。"内部状态不可读"这件事正在从不同方向同时逼近工程实践,C2C 只是把这个问题从单模型推到了多模型。
死结 5:主实验的口径比标题窄
论文摘要给的 6.4--14.2% 很漂亮,但要看清它是在什么条件下测的:
| 维度 | 主实验的实际设置 |
|---|---|
| Receiver 规模 | 小模型为主 |
| 任务形式 | 多选题 |
| 解码方式 | greedy decoding |
| 答案长度 | 最多 64 token |
| 长程 agent | 附录 case study,不在主表 |
也就是说,"长程 agent 场景的收益"目前主要是定性展示,不是主表里的量化结论。如果你打算把它用在真实的多步 agent 流水线上,这个 gap 需要你自己补测。
另外两条:token 对齐和层对齐是启发式规则不是最优解(作者明说);架构差异极大时的鲁棒性还需要更系统的验证。
还有一个略显矛盾的地方:作者试出了更强的 Fuser(C2C-C,能进一步缩小强 Sharer 与弱 Receiver 的差距),但没有把它作为主结果发布,理由是这篇工作的重点是提出 C2C 范式本身。所以你看到的数字不是这个思路的上限。
六、什么场景赚,什么场景亏
判据不是"模型多不多",而是这条边上是不是真的有"翻译损耗"。
| 场景 | 判断 | 理由 |
|---|---|---|
| 小 Receiver + 强/互补 Sharer | 赚,且是甜蜜点 | Receiver 越小、和 Sharer 知识重叠越少,增益越大 |
| 强 Receiver + 相似 Sharer | 亏 | 收益递减,Receiver 越大知识重叠越多 |
| 链路上每一棒都要等前一棒说完 | 赚 | 2.5× 延迟收益直接兑现(Sharer 啰嗦时到 14.41×) |
| Sharer 的输出本来就要给用户看 | 不赚 | 那部分文本反正是要生成的,C2C 省不掉 |
| 传的是工具调用 / 要给人读的消息 | 不适用 | MCP、A2A 仍然是对的 |
| 任一环节是闭源 API 模型 | 不适用 | 白盒要求 |
| 需要审计、合规留痕 | 谨慎 | 消息不可读 |
| 一次性短任务 | 不划算 | 训练 Fuser 的成本摊不开 |
一句话判据:C2C 赚的是"翻译损耗"那部分钱。如果两个模型之间没有值得翻译的东西,或者翻译出来的东西本来就要给人看,这笔钱就不存在。
七、选型决策树
scss
你的多模型链路上,两个模型之间在传什么?
│
├─ 工具调用 / 要给人读的消息 ────────────► 用 MCP / A2A,别考虑 C2C
│
├─ 纯中间推理结果,没人要看 ──────────┐
│                                      │
│  两个模型都能拿到权重和内部 cache 吗?│
│  │                                   │
│  ├─ 否(有闭源 API)────────────────► 继续用文本,C2C 不适用
│  │
│  └─ 是 ──┬─ Receiver 明显弱于/不同于 Sharer?
│          │   ├─ 是 ──► 值得试(甜蜜点)
│          │   └─ 否 ──► 收益递减,先测再决定
│          │
│          └─ 这条链路要跑多少次?
│              ├─ 高频固定组合 ──► 训练 Fuser 成本可摊薄,值得
│              └─ 低频或组合常变 ──► O(N²) 训练成本吃不消,观望
三条实践建议:
- 先测 Oracle 1 再决定投入。 拿你自己的两个模型,在不增加 token 的前提下试试让 Receiver 的 cache 变"丰富",看质量有没有提升。这一步几乎不花钱,但能提前判断 C2C 在你这对模型上有没有戏。
- 先用 300 步版本。 论文说 300 步(<9 GPU 小时)就能接近最终 checkpoint。别一上来就跑满 45--54 小时。
- 保留文本旁路。 哪怕上了 C2C,也要留一条能打印文本的通道用于调试和审计------死结 4 迟早会咬你。
八、我的判断
C2C 不是"替代 MCP / A2A",而是往栈里加了一层。 分层关系大概是这样:
arduino
┌─────────────────────────────────────────┐
│ 语义层(新):C2C ------ KV-Cache 直传      │  高带宽 / 低延迟 / 不可读 / 需白盒
│ 适用:两个你都握有权重的模型之间传"理解" │
├─────────────────────────────────────────┤
│ 协议层:MCP / A2A ------ 结构化文本          │  通用 / 可读 / 可审计 / 跨厂商
│ 适用:工具调用、跨组织、要留痕的场合      │
└─────────────────────────────────────────┘
判断一:这篇论文真正的价值不是那 2.5×,而是它证明了"KV-Cache 可以当通信介质"。 数字会随实现变化,但"模型的内部状态能被另一个模型直接使用"这个事实,会改变我们对多模型系统设计的想象边界。
判断二:落地瓶颈不在算法,在工具链。 现在没有生产级 API 可以调。真正决定它能否进入你的技术栈的,是 vLLM / SGLang 这类推理框架什么时候把"跨模型 cache 注入"做成一个可配置项。
判断三:最该警惕的是可观测性的倒退。 多智能体本来就已经很难调试了------9 月那批关于 CoT 不忠实和 Plan Injection 的研究都在说同一件事。C2C 让链路上的一段彻底变成黑盒。在你解决"怎么观测不可读的通信"之前,不要把它放进需要担责的生产链路。
下一个值得盯的信号:附录里那个 O(N) 的统一潜在空间方案会不会成为正篇。如果 "一个 Fuser 服务多对模型" 成立,规模化这个最大障碍就被拆掉了,那时候 C2C 才从"研究"变成"架构选项"。
在那之前------按论文自己的定位------把它当成一个有前途的编译器优化来读,而不是一个可以迁移的框架。
参考
- 论文 :Fu, T., Min, Z., Zhang, H., Yan, J., Dai, G., Ouyang, W., Wang, Y. Cache-to-Cache: Direct Semantic Communication Between Large Language Models. arXiv:2510.03215(2025-10-03),ICLR 2026 收录。清华 NICS-EFC 实验室 / 上海 AI Lab / 无问芯穹 Infinigence AI。
- 代码 :github.com/thu-nics/C2...
- ICLR 页面 :openreview.net/forum?id=Le...
数据口径说明 :6.4--14.2%(对比单模型)与 3.1--5.4%(对比 T2T)取自论文摘要;不同二手解读给出的主实验口径略有出入(另有 8.5--10.5% 与 3.0--5.0% 的表述),本文统一采用摘要版本。消融数字(+24.18% / +3.07%)、可训练权重对比(478M / 596M / 529M)、90 ms 融合开销、300 步与 45--54 GPU 小时训练成本均引自论文 Section 4.4、Table 3 与 Appendix A.4.5。弱 Sharer 拖累、O(N²) 扩展、C2C-C 未作主结果发布、主实验口径限制均出自论文 Section 5 与附录。本文所有实验数字均为作者自报,未见第三方独立复现。