文章目录
初步
patsy是Python中描述和构建统计模型的库,可以将类似R语言公式的字符串,翻译成构建模型需要的矩阵,是 statsmodels等统计库的底层核心依赖。正常pip安装
pip install patsy简单示例如下
python
import numpy as np
from patsy import dmatrices
data = {"x1":np.random.rand(10), "x2":np.random.rand(10), 'y':np.random.rand(10)}
y, X = dmatrices("y ~ x1 + x2", data)
【dmatrices】是patsy中的核心函数,用于构建响应变量矩阵 y y y和特征设计矩阵 x x x,其输入参数中,第一项是patsy的统计语法,第二项是支持字典索引的数据包。
y ~ x1+x2是patsy实现的Wilkinson-Rogers(WR) 语法,其中y, x1, x2来自data的key。
这条语句构建了 y = β 0 + β 1 x 1 + β 2 x 2 y=\beta_0+\beta_1x_1+\beta_2x_2 y=β0+β1x1+β2x2的数学模型,该问题写成矩阵形式即为
y = 1 x 1 x 2 β 0 β 1 β 2 y=\begin{bmatrix}1&x_1&x_2\end{bmatrix}\begin{bmatrix} \beta_0\\ \beta_1 \\ \beta_2 \end{bmatrix} y=1x1x2 β0β1β2
而dmatrices的输出项,即为左侧的 y y y和右侧的 1 x 1 x 2 \begin{bmatrix}1&x_1&x_2\end{bmatrix} 1x1x2矩阵。
就 y ∼ x 1 + x 2 y\sim x_1+x_2 y∼x1+x2这个模型而言,其生成的 y y y矩阵与输入的 y y y是相同的,更多时候,我们关注的是 ∼ \sim ∼右侧模型的矩阵化,为此patsy提供了另一个高频函数【dmatrix】
python
from patsy import dmatrix
dmatrix("x1+x2", data)
patsy语法
patsy语法中的运算符及其含义如下表所示。
| 运算符 | 示例 | 模型 |
|---|---|---|
~ |
y~x1 |
$y=\beta_0+\beta_1x_1 |
+ |
y~x1+x2 |
$y=\beta_0+\beta_1x_1+\beta_2x_2 |
: |
y~x1:x2 |
$y=\beta_0+\beta_1(x_1x_2) |
/ |
y~x1/x2 |
$y-\beta_0+\beta_1x_1+\beta_2(x_1x_2) |
* |
y~x1*x2 |
$y=\beta_0+\beta_1x_1+\beta_2x_2+\beta_3(x_1x_2) |
** |
y~(x1+x2)**2 |
$y=\beta_0+\beta_1x_1+\beta_2x_2+\beta_3x_1x_2 |
需要注意的是,WR语法默认包含截距项 β 0 \beta_0 β0,如想移除该项,只需减1即可,例如x1-1。
从上表可知,WR语法中,最基础的运算就是+, :,分别用于变量的主效应和纯交互作用,但全交互作用*的使用频率可能比:更高。
函数
在patsy的语法字符串中,可以识别Numpy函数,从而对数据做预处理,例如dmatrix("np.exp(x1)", data),那么输出结果为 1 , e x 1 1, e^{x_1} 1,ex1。
此外,patsy的语法表达式中还内置了一些方法,用于构建非线性基函数或平滑想,比如B样条函数
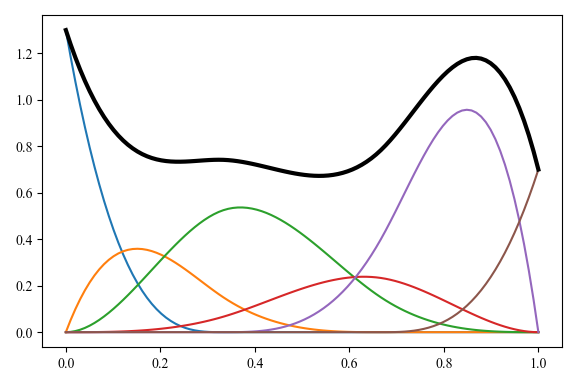
python
x = np.linspace(0., 1., 100)
y = dmatrix("bs(x, df=6, degree=3, include_intercept=True) - 1", {"x": x})
b = np.array([1.3, 0.6, 0.9, 0.4, 1.6, 0.7])

import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = 'Times New Roman'

plt.plot(x, y*b)
plt.plot(x, np.dot(y, b), color='k', linewidth=3);
plt.show()
patsy内置函数包括
| 函数名 | 中文名称 | 关键参数 | 核心特点 | 典型适用场景 |
|---|---|---|---|---|
| poly | 正交多项式(Orthogonal Polynomials) | degree | 使用全局多项式,通过正交化消除了高阶多项式常见的多重共线性问题;曲线形状受全局数据影响。 | 变量间存在相对简单、平滑的全局非线性趋势(如抛物线、S型)。 |
| bs | B样条(B-splines) | df, knots, degree | 局部控制能力强,改变一个节点只影响局部曲线;但在数据边界处容易产生较大的方差(边界不稳定)。 | 通用的连续变量非线性拟合,对局部变化敏感的数据。 |
| cr | 立方回归样条(Cubic Regression Splines) | df, knots | 在边界处比 bs 更稳定,计算效率通常更高;默认使用惩罚平滑(类似R的mgcv包),是 bs 的极佳替代品。 | 通用的连续变量非线性拟合,特别是当数据在边界处稀疏或 bs 表现不佳时(首选推荐)。 |
| cc | 循环立方样条(Cyclic Cubic Splines) | df, knots | 强制要求样条在周期的起点和终点处不仅函数值相等,其一阶和二阶导数也完全连续(无缝衔接)。 | 具有周期性/循环性质的变量。如:一天中的小时、一年中的月份、角度(0-360度)。 |
| te | 张量积样条(Tensor Product Splines) | df | 将一维样条基通过张量积扩展到多维空间,用于捕捉多个连续变量联合的非线性影响 | 两个或多个连续变量对目标变量存在非可加的、联合的非线性交互作用。 |
参数中,df为自由度,knots为节点,degree为阶数。