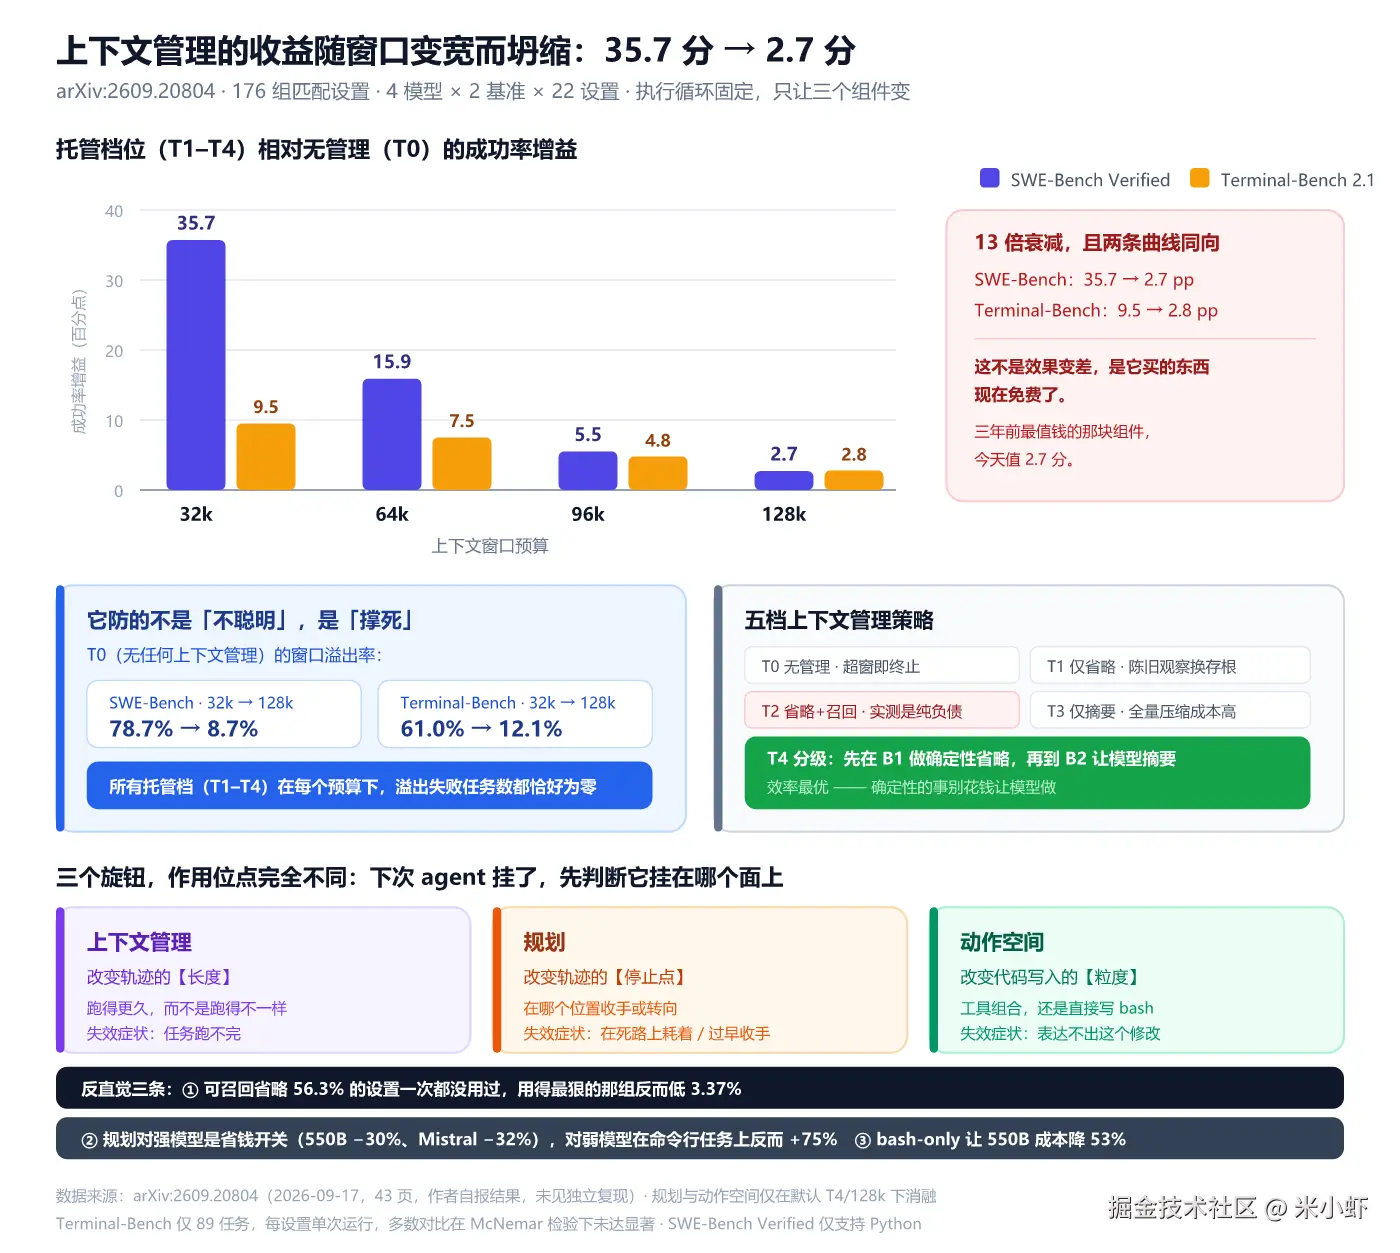
上下文窗口从 32k 涨到 128k 之后,同一套上下文管理策略在 SWE-Bench Verified 上的收益从 35.7 个百分点 掉到 2.7 个百分点------整整 13 倍。
这篇论文最狠的地方不是这个数字本身,而是作者同时给出了原因:这套策略从来不是在让 agent 变聪明,它只是在防止 agent 撑死。 一旦窗口够大、撑不死了,它带来的收益就归零了。
于是产生一个工程上很麻烦的结论:harness 设计决策不是一次性的设计文档,它有一个和模型升级绑定的保质期。
一、这个实验为什么值得单独讲一次
Agent 工程里有个长期没人认真做的事:我们把 harness(包在模型外面的那一层:规划、工具、上下文管理)当成一个整体来评。
后果是,一个 benchmark 分数涨了,你不知道该归功于哪个设计决策;分数掉了,你也不知道该改哪一行。大部分团队的做法是抄一套开源 harness,然后靠直觉和口碑往上加东西------加个规划模块、加个上下文压缩、加十几个预定义工具。加完之后分数变了,但没人知道是哪一个加对了。
9 月 17 日挂到 arXiv 上的这篇论文(arXiv:2609.20804,43 页)做了一件朴素但稀缺的事:把执行循环固定死,只让三个组件变,然后做全排列对照。
css
   固定不变                        三个变量
┌──────────────────┐      ┌──────────────────────────────┐
│  执行循环 loop    │      │  ① 规划 planning             │
│  最大步数 300     │      │     开 / 关                  │
│  温度 0 / top-p 0.95│    ├──────────────────────────────┤
│  输出上限 16,384  │      │  ② 动作空间 action space      │
│  工具结果截断 24k │      │     预定义工具 / 纯 bash      │
│  软/硬阈值 .6/.85 │      ├──────────────────────────────┤
│  卡死 5 提醒/8 终止│      │  ③ 上下文管理 context mgmt    │
└──────────────────┘      │     T0 / T1 / T2 / T3 / T4    │
                          └──────────────────────────────┘
                                       ×
                          窗口预算 32k / 64k / 96k / 128k
规模是这样凑出来的:
| 维度 | 取值 | 数量 |
|---|---|---|
| 模型 | Nemotron-3 30B / 120B / 550B、Mistral-Medium-3.5-128B | 4 |
| 基准 | SWE-Bench Verified(500 任务)、Terminal-Bench 2.1(89 任务) | 2 |
| 设置 | 上下文管理 5 档 × 4 预算 + 规划/动作空间消融 | 22 |
| 合计 | 176 组匹配设置 |
上下文管理的五档是这么分的:
| 档位 | 机制组合 | 说明 |
|---|---|---|
| T0 | 无 | 不做任何跨轮次压缩,超窗即终止 |
| T1 | 仅省略 | 把陈旧的工具观察替换成短存根,原始内容丢弃 |
| T2 | 省略 + 召回 | 省略的内容外部存储,可用 recall_event 取回 |
| T3 | 仅摘要 | 把中间区域折叠成滚动摘要,不省略 |
| T4 | 三者分级 | 先在阈值 B1 做省略,再到阈值 B2 做摘要 |
先把这张表记住,后面每个结论都要回到这里。
二、那条 13 倍的衰减曲线
论文的主结果是一张很直白的图:托管档位(T1--T4)相对无管理(T0)的成功率差距,随着窗口预算变宽而坍缩。
| 窗口预算 | SWE-Bench Verified 增益 | Terminal-Bench 2.1 增益 |
|---|---|---|
| 32k | 35.7 pp | 9.5 pp |
| 64k | 15.9 pp | 7.5 pp |
| 96k | 5.5 pp | 4.8 pp |
| 128k | 2.7 pp | 2.8 pp |
两个基准的趋势完全一致,但幅度差了一个数量级------这点后面会解释。
如果你在 2024 年做了一套上下文管理(那时候 32k 还是奢侈配置),它当时可能是你系统里最值钱的一块。到今天窗口普遍 128k 起,同一套东西值 2.7 分。
这不是"效果变差了",是"它原本买的那样东西现在免费了"。
三、为什么衰减:它不是在变聪明,是在防撑死
作者的解释有硬数据支撑。他们统计了 T0(完全不做上下文管理)的窗口溢出率:
| 基准 | 32k 时的溢出率 | 128k 时的溢出率 |
|---|---|---|
| SWE-Bench Verified | 78.7% | 8.7% |
| Terminal-Bench 2.1 | 61.0% | 12.1% |
再看另一半:所有托管档位(T1--T4)在每一个预算下,因溢出而失败的任务数都恰好是零。
把这两组数字摆在一起,机制就清楚了:
erlang
   32k 环境                              128k 环境
┌────────────────────────┐        ┌────────────────────────┐
│ T0:78.7% 的任务撑死   │        │ T0:8.7% 的任务撑死    │
│ T1--T4:0 个任务撑死    │        │ T1--T4:0 个任务撑死    │
│                        │        │                        │
│ 差值 35.7 pp           │        │ 差值 2.7 pp            │
│ ↑ 几乎全部来自"没死"   │        │ ↑ 只剩"没死"的那 8.7%  │
└────────────────────────┘        └────────────────────────┘
用一个粗糙但够用的近似就能理解整条曲线:
上下文管理的收益 ≈ 溢出失败率 × 单个溢出任务的期望损失
溢出率从 78.7% 掉到 8.7%,收益就该掉到原来的 1/9 左右------实测掉到 1/13,量级吻合。剩下的那 2.7 分,就是"防止那 8.7% 撑死"的残余价值。
Terminal-Bench 的增益整体低一个数量级,也能用同一个公式解释:它的任务是命令行为主,单轮上下文压力本来就小,T0 在 32k 下的溢出率也只有 61%,而且溢出后损失的任务价值相对更低。
这一节是全文最重要的一节。 因为它把"要不要做上下文管理"这个问题,从"哪个策略更高级"的美学判断,变成了一个可以直接测的工程判断------见第七节。
四、三个旋钮,三种完全不同的机制
论文最值钱的部分是轨迹层分析。作者没有停在分数上,而是去看了 agent 实际走过的路径,给出了三个旋钮各自的作用位点:
   旋钮                 它改变的是
┌─────────────────┬──────────────────────────────────┐
│ 上下文管理       │ 轨迹的【长度】                    │
│                 │ 跑得更久,而不是跑得不一样          │
├─────────────────┼──────────────────────────────────┤
│ 规划             │ 轨迹的【停止点】                  │
│                 │ 在哪个位置收手 / 转向              │
├─────────────────┼──────────────────────────────────┤
│ 动作空间         │ 代码写入的【粒度】                │
│                 │ 用工具组合,还是直接写 bash        │
└─────────────────┴──────────────────────────────────┘
这是我见过对 harness 最干净的一个心智模型,因为它把三个经常被混为一谈的东西分到了三个不同的失败面上:
- 上下文管理失效 → 任务跑不完(长度问题)
- 规划失效 → 任务停错地方(停止点问题:要么在死路上耗着,要么过早收手)
- 动作空间失效 → 改不动代码(粒度问题:工具组合表达不出这个修改)
下次你的 agent 挂了,先问它挂在哪个面上。这三个面对应的修法完全不同,混着调会互相掩盖。
五、四条反直觉的实测结论
5.1 可召回的省略(T2)是纯负债
很多 harness 会做一件事:把省略掉的内容存到外部,允许 agent 后面用 recall_event 取回来。理由是"万一到时候需要呢"。
实测结果:
| 指标 | 数值 |
|---|---|
64 个 T2/T4 设置中从未调用 recall_event 的比例 |
36 / 64(56.3%) |
| 平均调用次数 @32k | 0.540 次/任务 |
| 平均调用次数 @64k | 0.069 次/任务 |
| 平均调用次数 @128k | 0.007 次/任务 |
| 调用最频繁的那组配置(30B / Terminal-Bench / 32k / T2) | 4.326 次/任务,但准确率比 T1 低 3.37% |
超过一半的设置一次都没用过它;用得最狠的那组反而比不做召回的版本更差。
这个结果很符合直觉之外的另一层逻辑:召回机制存在的意义是"agent 意识到自己缺信息",而它意识不到------它只会按当前上下文里有的东西继续往下走。你给了一个它不会按的门铃。
5.2 规划对强模型不是"更准",是"更省"
| 场景 | 开启规划的效果 |
|---|---|
| 550B / SWE-Bench | 成本 −30%,准确率几乎不变 |
| Mistral-3.5 / SWE-Bench | 成本 −32%,准确率几乎不变 |
| 120B / Terminal-Bench | 成本 −26% |
| 30B / Terminal-Bench | 成本 +75% |
同一句话可以拆成两半说:
- 对弱模型,规划是脚手架------它直接把准确率抬上去。
- 对强模型,规划是省钱开关------模型本来就知道该干什么,规划的价值在于别让它去探索死路。
- 对弱模型在命令行为主的任务上,规划反而更贵(+75%)------它写不出有用的计划,还多花了一轮 token。
5.3 工具面可能是你为"没在用的那个模型"交的税
| 场景 | bash-only 的效果 |
|---|---|
| 550B / SWE-Bench | 成本 −53% |
| 550B / Terminal-Bench | 成本 −30% |
原文的表述很直白:预定义工具帮助的是命令行能力弱的模型 ;对 shell 已经很熟的模型,纯 bash 接口跑得一样好,成本低一大截,在命令行为主的任务上差距最大。
换句话说:你精心设计的那套工具面,很可能是在给一个你并没有在用的模型做拐杖,而你在每一轮都为这根拐杖付 token。
5.4 分层顺序:先确定性省略,再让模型做摘要
五档策略里效率最高的是 T4:先按规则把能确定丢弃的东西丢掉(陈旧工具观察、重复内容),再让模型去压缩剩下的部分。
原因是成本结构------确定性的事别花钱让模型做。如果你直接上 T3(全量摘要),等于让模型去压缩一堆本来可以直接扔掉的内容,为每个 token 付两次钱。
5.5 顺手把成本账摊开:同一个任务,四个模型能差 100 倍
论文用的是 OpenRouter 的公开定价,值得原样抄下来当标尺:
| 模型 | 输入 / 输出(每百万 token) | SWE-Bench 单任务成本区间 |
|---|---|---|
| Nemotron-3 30B | 0.05/0.20 | 0.04--0.11 |
| Nemotron-3 120B | 0.08/0.45 | 0.05--0.39 |
| Nemotron-3 550B | 0.50/2.20 | 0.26--2.70 |
| Mistral-Medium-3.5-128B | 1.50/7.50 | 0.87--4.65 |
Terminal-Bench 上区间类似(30B 0.02--0.15,Mistral 0.76--4.16)。
请注意区间的宽度,而不只是端点。 同一个模型、同一个基准,最贵设置和最便宜设置之间差了 7--12 倍(30B 在 Terminal-Bench 上是 7.5 倍)。差距的来源就是那三个旋钮。
换句话说:在换模型之前,先把旋钮拨对,可能比换模型便宜得多。 一个 550B 用 bash-only(−53%)之后的成本,低于一个默认配置的 550B 的一半------这比"等下一代模型降价"要可控得多。
六、六个工程死结(该泼的冷水)
这篇论文结论很硬,但边界也很清楚,而且有几条是作者自己写进 Limitations 的。
1. 规划和动作空间只在一个点上做了消融。 这两个旋钮的全部实验都是在默认配置(T4 / 128k)下跑的。而 128k 恰恰是上下文管理最不重要的那一端。 也就是说,"规划的价值随模型强度变化"这个结论,是在上下文几乎不构成约束的条件下测出来的------规划 × 预算的交互项,这篇论文没有测。 如果你在 32k 环境下跑,规划的作用可能和这里报告的完全不同。
2. "模型强度"这个自变量被混淆了。 四个模型里有三个来自同一家族(Nemotron-3 的 30B / 120B / 550B),第四个是 Mistral-Medium-3.5-128B。这意味着"强度梯度"实际上主要是"同一套后训练配方下的尺寸梯度"。尺寸差不多的模型如果训练配方、工具接口暴露度、原生 shell 熟练度不同,趋势可能不成立。作者自己也点明了这一点。
3. 每组设置每个任务只跑了一次。 没有方差估计。加上 Terminal-Bench 只有 89 个任务,相当多对比在配对 McNemar 检验下并不显著 ------论文的结论依赖的是"跨模型和预算方向一致",而不是单个单元显著。这是诚实的做法,但也意味着单个数字不要抠得太细,看趋势。
4. 动作空间是一个捆绑干预。 切换"预定义工具 → bash-only"时,同时变了四样东西:工具可用性、接口提示词、文件状态跟踪、自动诊断。所以"工具面"带来的收益无法归因到其中任何一项。 你没法从这篇论文推出"去掉文件状态跟踪会怎样"。
5. SWE-Bench Verified 只支持 Python。 结论迁移到其他语言生态前需要重新验证。
6. 没有公开代码仓库。 上下文管理用的是单一阈值策略(0.6 / 0.85)和固定压缩比,没有做阈值敏感性分析。你抄过去的时候,这两个数大概率要按自己的任务重调。
另外提醒一句:这些是作者自报结果,目前未见独立复现。 论文 9 月 17 日挂出,一天内上了 Hacker News 首页(194 分),说明这个问题确实缺测量------但缺测量不等于这篇就测对了。
七、今天下午就能做的四件事
① 先测溢出率,再决定要不要做上下文管理。
markdown
1. 关掉你的上下文管理,用你的真实任务跑一遍
2. 统计因上下文超限而失败的任务占比
3. 如果这个比例接近 0 → 你的上下文管理最多值 2-3 分,别在上面花时间
如果超过 50% → 它是你系统里最值钱的组件,值得认真做这一步成本极低,但它决定你接下来一个月往哪儿投入。大多数人从来没测过这个数。
② 分级顺序固定成:确定性省略 → LLM 摘要;不做可召回。
别做 recall_event。56.3% 的设置一次都没用过它,用得最多的那组反而更差。如果你已经有这套机制,去看看它的实际调用日志------大概率是零。
③ 给 harness 设计文档加一个元数据字段:测量时的上下文预算。
这是这篇论文最直接的工程启示。任何一条"我们 agent 的最佳实践"都应该带上它被测量时的窗口大小,因为换模型的时候它会失效,而且失效得很安静------不会报错,只是分数悄悄掉。
建议定个规矩:每次升级底层模型,重测上下文管理这一项。 不用全量重测,只测 T0 溢出率加上托管档的增益差,几十分之一的成本。
④ 如果你用的是强模型,试一次 bash-only 和关掉规划,然后只看成本。
准确率大概率不动(这正是论文说的),但成本可能掉 30%--53%。这类实验唯一需要注意的是别只测准确率------如果只看准确率,你会得到"没区别"的错误结论,然后继续为那根拐杖付钱。
八、四条判断
-
harness 决策有保质期,而且保质期由模型决定,不由你决定。 三年前最值钱的那块(上下文管理),今天值 2.7 分。这不是贬低它,是说它需要和模型升级绑定的复测节奏,而不是一次性的设计文档。
-
判断一个 harness 组件值不值,先问它防的是哪种失败,再看这种失败在你的环境里还有多少。 上下文管理防的是"撑死",撑死率归零它就归零。这个思路对任何组件都适用------先定位失败面,再算存量。
-
"强模型 + 精简 harness"是被低估的组合。 规划对强模型是省钱开关,工具面对 shell 熟的模型是拐杖。多数 harness 是为它下面那个模型设计的,而在每一轮为此付费。
-
最该被记住的是那个三分法:长度 / 停止点 / 粒度。 下次 agent 挂了,别急着调 prompt,先判断它挂在哪个面上------这三个面的修法完全不同,混着调只会互相掩盖。
最后一句:如果你的团队里有一份《我们 agent 的最佳实践》文档,去翻一下它有没有写"这些数字是在多大的上下文窗口下测的"。 大概率没有。而这一周多出来的这几十分,就是那行缺失的元数据。
数据来源与说明
- 主论文:An Empirical Study of Harness Design for Coding Agents,arXiv:2609.20804,2026 年 9 月 17 日提交,43 页,作者 Run-Ze Fan 等 9 人。本文所有实验数字均取自该论文正文、表 2--4 及图 3。
- 模型定价为论文采用的 OpenRouter 每百万 token 价格:Nemotron-3-30B 0.05/0.20、120B 0.08/0.45、550B 0.50/2.20、Mistral-Medium-3.5 1.50/7.50。
- 论文未公开代码仓库;上下文管理使用阈值 0.6 / 0.85 与固定压缩比,未做阈值敏感性分析。
- 局限性与统计功效说明(每设置单次运行、Terminal-Bench 89 任务、McNemar 多数对比不显著、动作空间为捆绑干预、SWE-Bench Verified 仅 Python)均出自论文 Limitations 章节。
- 本文未复现实验;结论为对论文自报结果的解读,未见第三方独立复现。