MobileSAMv2: Faster Segment Anything to Everything --- 方法详解与代表性实验结果
论文:arXiv:2312.09579v1 cs.CV,2023.12.15
作者:Chaoning Zhang 等(Kyung Hee University / Nota Inc.)
MobileSAMv2 提出两阶段高效分割一切(SegEvery)框架:先用类无关目标检测器生成≤320个框提示,再批量输入SAM解码器。相比原版网格撒点(4096点×3mask),提示数降为1/40,解码耗时从6400ms降至50ms,整体提速超16倍;在零样本目标提议任务中性能持平甚至更优(59.3% vs 59.2%),且无需冗余过滤。该方法兼顾速度与精度,与轻量编码器兼容,实现高效、精准的"分割一切"。
一、要解决什么问题
SAM 有两个任务:
- SegAny (分割任意一个物体):给一个点/框提示,分割单个目标。瓶颈在图像编码器(632M 参数,约 450ms),解码器很轻(约 4ms)。→ MobileSAM(v1)用解耦知识蒸馏解决这个。
- SegEvery (分割一切物体):分割图中所有东西。瓶颈转移到了 mask 解码器------因为要对图像做网格搜索(grid-search)撒点提示:官方 demo 用 32×32 点(解码器约 1600ms),零样本目标提议用 64×64 点(解码器约 6400ms)。
MobileSAMv2 的目标:让 SegEvery 变快。 它的思路与 v1 正交:不去动图像编码器,而是改造"提示的采样策略"。
二、核心洞察
原版 SegEvery 的流程是:先大量生成 mask(冗余),再过滤出有效的。具体做法:
- 在图上撒 64×64 = 4096 个前景点提示;
- 每个点让解码器输出 3 个不同粒度的 mask(multi-mask 模式,共 12288 个);
- 在高维 mask 空间做去重过滤(这一步在 GPU 上甚至比生成 mask 还慢,因为高维 mask 的内存访问和删除操作很耗时)。
作者的直觉:既然大多数提示是冗余的,为什么不让解码器只处理有效提示? 这样既省了 mask 生成时间,也完全省去了 mask 过滤步骤。
三、方法框架:两阶段流水线
输入图像
   │
   ├── 阶段1:Object-aware Prompt Sampling(目标感知提示采样)
   │        YOLOv8 检测 → NMS 过滤重叠框 → 得到 ≤320 个有效框提示
   │
   └── 阶段2:Prompt-guided Mask Decoding(提示引导的 mask 解码)
            以"提示数"为 batch 批量送入 SAM 解码器 → 直接输出最终 mask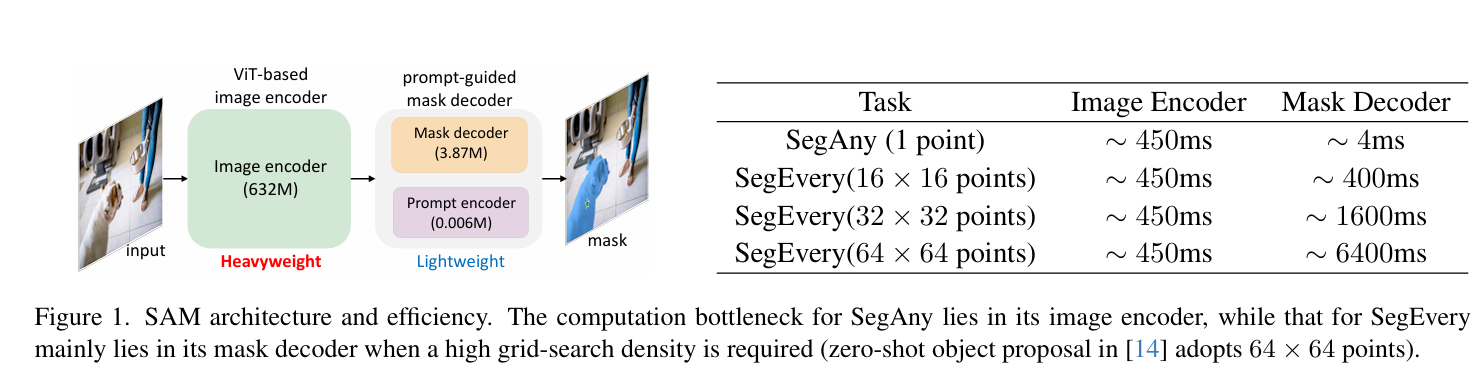
阶段 1:目标感知提示采样(核心创新)
① 用目标检测做"目标发现"(object discovery)
"某个区域是否有物体"这个问题,现代目标检测器已经解决得很好。作者选用 YOLOv8 (实时检测的事实标准),去掉分类头,只保留框回归能力,当作类无关(class-agnostic)的目标发现器。
为防止模型过拟合到特定领域,检测器在 SA-1B 数据集的一个子集 上训练:先用框+mask 双监督训练,再仅用框损失微调(这也便于与 prompt-free 方法公平对比)。
② NMS 预过滤
检测器会输出大量重叠框,先用标准 NMS 过滤,再取剩余框。
③ 关键点设计:用"框"而不是"中心点"做提示
过滤后的框有两种用法:取中心点作为点提示,或直接用整个框做提示。作者选择了框提示,理由有三:
- 中心点假设不总成立:"框中心落在物体上"大多数情况下成立但并非总是;
- 点提示有歧义:一个点的信息太少,SAM 需要为每个点预测 3 个输出 mask(大/中/小粒度)来解决歧义,这又重新引入了 mask 过滤的负担;
- 框提示信息量大、歧义小:可以关掉 multi-mask 模式(每个提示只出 1 个 mask),且实验发现框提示能"免费"带来显著的性能提升(Table 3:单 mask 模式下 59.3% vs 点提示 53.6%)。
④ 提示数量收敛于 320
消融实验(Table 7)显示:提示数从 64 增加到 320,性能持续提升;超过 320 后饱和。因此默认最大提示数设为 320------对比原版的 4096 个点 × 3 = 12288 个 mask,提示数量下降了约一个数量级。
阶段 2:批量提示引导解码
沿用 SAM 原版解码器(双流注意力交互图像 embedding 与提示 token),但 batch 的概念从"图像数"变为"提示数",把所有框提示一次性批量送入解码器。
关键区别:
- 原版:提示多而冗余 → 需要 multi-mask + 高维 mask 过滤;
- v2:提示全部有效 → 保留所有生成的 mask,无需任何后过滤。
1. "Without additional prior knowledge" ------ 为什么说"没有额外先验"?
回顾上下文:YOLOv8 检测器会输出大量互相重叠的框 ,必须先经过 NMS(非极大值抑制)过滤,才能当作有效提示。但 NMS 只解决了"框与框重叠"的问题------过滤后剩下的每个框,我们知道它"大概率框住了一个物体",但框内部哪个点真正落在物体上、是前景,NMS 并没有告诉我们任何信息。
也就是说,此时手里只有几何坐标信息(框的位置),没有任何关于物体形状、轮廓、像素的先验。所以要从中"推导"出一个前景点,只能做假设。
四、为什么优于 Prompt-free 路线(FastSAM)
FastSAM 用 YOLOv8-seg 的 protonet 直接生成 mask(mask 系数与 mask 原型做 32 维点积),完全绕过提示。问题在于:SAM 的解码器用双流注意力让 mask token 与图像 embedding 充分交互 后再点积,这是 mask 边界精细的关键;而 FastSAM 的系数与原型之间没有这种显式交互,导致边界质量差(Figure 2)。定量上 FastSAM 仅 49.6%,且倾向于过度分割(over-segment)。MobileSAMv2 保留了 prompt-aware 机制来保证质量,同时用目标感知采样解决速度问题。
五、代表性实验结果
1. 效率对比(Table 2,mask 解码器耗时)
| 采样策略 | Prompt 编码 | Mask 解码 | 总计 |
|---|---|---|---|
| 网格搜索 32×32(1024 点) | 16ms | 1600ms | 1616ms |
| 网格搜索 64×64(4096 点) | 64ms | 6400ms | 6464ms |
| 目标感知采样(≤320 框) | 47ms | 50ms | 97ms |
解码器整体提速至少 16 倍(6464ms → 97ms)。
2. 零样本目标提议性能(LVIS,mask AR@1000,Table 3)
| 方法 | multi-mask | all | small | med. | large |
|---|---|---|---|---|---|
| SAM(64×64 = 4096 点) | true(×3) | 59.2 | 46.6 | 78.7 | 82.4 |
| SAM(32×32 = 1024 点) | true(×3) | 57.2 | 42.9 | 79.2 | 83.6 |
| SAM(16×16 = 256 点) | true(×3) | 40.0 | 19.4 | 71.3 | 79.1 |
| MobileSAMv2(max 320 点) | true(×3) | 55.7 | 40.6 | 78.6 | 84.6 |
| MobileSAMv2(max 320 点) | false(×1) | 53.6 | 44.0 | 70.4 | 66.6 |
| MobileSAMv2(max 320 框) | false(×1) | 59.3 | 47.9 | 77.1 | 79.9 |
| MobileSAMv2(max 256 框) | false(×1) | 58.5 | 46.7 | 77.1 | 79.1 |
用约 1/40 的计算量(320 框 ×1 mask vs 4096 点 ×3 mask)达到持平甚至更优的性能(59.3% vs 59.2%),small 物体上反超(47.9 vs 46.6)。
3. 不同 K 值下的 mask AR 对比(Table 4)
| 指标 | SAM(4096 点,×3) | MobileSAMv2(框,×1) | 提升 |
|---|---|---|---|
| mask AR@1000 | 59.2 | 59.3 | +0.1 |
| mask AR@100 | 44.8 | 50.6 | +5.8 |
| mask AR@10 | 12.6 | 17.6 | +5.0 |
| 平均(K=10~1000) | 38.9 | 42.5 | +3.6 |
K 越小(指标越严格),优势越大。
4. 与蒸馏图像编码器的兼容性(Table 5)
| 图像编码器 | All | small | med. | large |
|---|---|---|---|---|
| ViT-H(原版) | 59.3 | 47.9 | 77.1 | 79.9 |
| TinyViT | 51.1 | 38.9 | 69.9 | 73.4 |
| EfficientViT-L2 | 56.3 | 44.7 | 74.1 | 78.1 |
EfficientViT-L2 推理约 20ms(vs ViT-H 400ms+),性能仅降 3 个百分点,仍大幅领先 FastSAM。
5. Prompt-free vs Prompt-aware(Table 6)
| 策略 | 方法 | All | small | med. | large |
|---|---|---|---|---|---|
| Prompt-free | FastSAM | 49.6 | 36.2 | 69.4 | 77.1 |
| Prompt-aware | SAM(最优设置) | 59.2 | 46.4 | 78.7 | 82.4 |
| Prompt-aware | MobileSAMv2(ViT-H) | 59.3 | 47.9 | 77.1 | 79.9 |
| Prompt-aware | MobileSAMv2(EfficientViT-L2) | 56.3 | 44.7 | 74.1 | 78.1 |
6. 最大提示数消融(Table 7,mask AR@1000)
| max # prompts | all | small | med. | large |
|---|---|---|---|---|
| 384 | 59.3 | 47.9 | 77.1 | 79.9 |
| 320 | 59.3 | 47.9 | 77.1 | 79.9 |
| 256 | 58.5 | 46.7 | 77.1 | 79.1 |
| 192 | 56.6 | 44.2 | 76.0 | 78.8 |
| 128 | 53.6 | 40.2 | 74.6 | 77.7 |
| 64 | 44.8 | 29.2 | 68.3 | 75.4 |
320 之后性能饱和,故默认取 320。
六、一句话总结
MobileSAMv2 把 SegEvery 从"网格撒点 → 海量生成 → 缓慢过滤"的暴力范式,转变为"检测器先发现物体 → 框提示批量解码 → 免过滤直出结果"的精准范式,用 1/40 的解码开销做到了持平甚至更优的性能,并与 MobileSAM 的轻量编码器天然兼容,共同构成高效的 SegAny + SegEvery 统一框架。