为什么我加了 @Volatile,结果还是不对?
你都没懂 @Volatile 什么意思,能对就有鬼了!
各位 Kotlin 爱好者们,早上好,我们先来看
一个看似不该出现的 Bug
简单的计数器:
kotlin
@Volatile var processedEventCount: Long = 0L64 个工作线程并发运行,结果,一定是不对的。
如果是你写下这段代码,你也一定很困惑:
"字段已经加了
@Volatile。每次读写不都会绕过 CPU 缓存,直接刷到主内存吗?写入怎么还会丢?"
这句话里对缓存的理解本身就不准确。
不过,丢失更新的直接原因,是 JVM 并发里一个常见的误解:可见性和互斥是两种不同的保证 ,@Volatile 并不提供后者。
- 可见性:一个线程写入值之后,其他线程能否看到它,还是继续读到旧值?
- 互斥:一串操作,也就是临界区,能否从头到尾执行完,中间不被其他线程的操作穿插?
理解工具时,要把这两种保证分开看。
工具用重了,会付出不必要的加锁成本;用轻了,可能悄悄丢数据。普通测试未必能发现这种问题,并发负载上来之后才会暴露。
下面逐一看看这四种工具的工作方式和适用边界,最后会给出选择流程和速查表。
先分清两条坐标轴
与其笼统地说"线程安全",不如分别看每个工具提供了怎样的可见性和互斥保证:
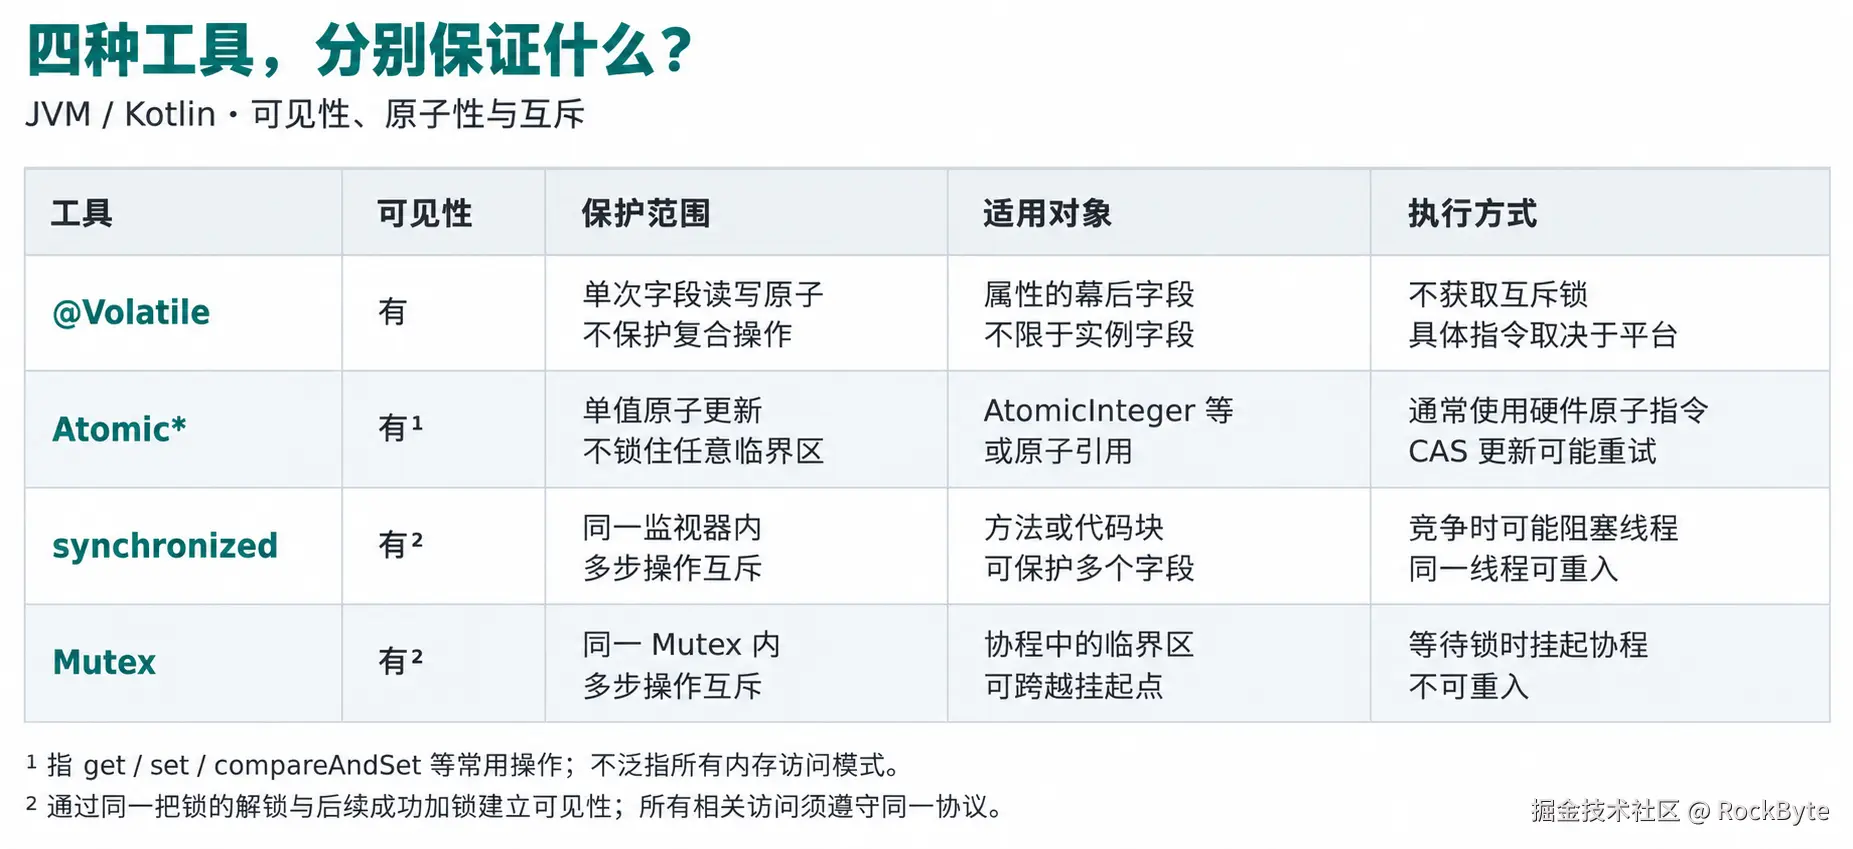
count++ 需要的是一次读---改---写整体的原子性。
从使用效果上看,可以把它理解为保护一个很小的临界区,但原子操作不一定通过互斥锁实现。
接下来要考虑的是:临界区有多大,保护它需要付出多少成本?先选能满足不变量的最小工具。
@Volatile:看得见,不等于锁得住
在 Kotlin 中,@Volatile 标记的是属性的 backing field(幕后字段),不能用于局部变量:
kotlin
class Worker {
    @Volatile var running: Boolean = true // valid

    fun runLoop() {
        // @Volatile var step = 0 // compile error: not applicable to local variables
    }
}
它为什么存在?
CPU 缓存、写缓冲区和编译器优化,让跨线程读写不能仅凭代码顺序来判断可见性。@Volatile 通过内存模型建立 happens-before 关系:对同一个 volatile 字段的写入,happens-before 后续读取。写线程在这次写入之前的操作,也能通过这条关系对读线程可见。
这里不能理解成"每次都绕过缓存"或"每次读取都强制作废缓存"。
具体指令和缓存行为取决于平台。我们依赖的是内存模型的保证,而它并没有把一次读取与后续写入之间的所有操作合成一个原子操作。
复合操作的问题恰好就出在这个间隙。count++ 可以用下面的概念性指令来表示,这不是固定的实际编译结果:
text
LOAD   reg0, [count]   // read into a register
ADD    reg0, 1         // modify in the register
STORE  [count], reg0   // write back
假设 count = 5,两个线程都读到了 5,分别加到 6,然后都把 6 写回去。执行了两次自增,计数器却只增加了 1。
@Volatile 保证单次字段读写的原子性和相应的可见性,却没有承诺这三步整体原子。这就是前面那个计数器丢失更新的原因:
kotlin
class IngestionTracker {
    // SAFE --- single read, single write, no compound operation
    @Volatile var isTerminated: Boolean = false

    // BROKEN --- read-modify-write across threads loses updates
    @Volatile var totalPacketsReceived: Long = 0L

    fun recordPacket() {
        totalPacketsReceived++ // race condition
    }

    fun shutdown() {
        isTerminated = true // fine --- a single atomic write
    }
}
可以把
@Volatile想成一扇玻璃窗:它解决了"看见"的问题,却拦不住两个人同时伸手进去拿同一件东西。
由此还会遇到三个坑。
首先是累加器:把 @Volatile 用在计数器或 ID 生成器上,以为它和简单标志位一样安全。
其次是引用与对象内容:@Volatile var config: ConfigObject? = null 可以安全发布引用及发布前已完成的初始化,但不会自动保护 ConfigObject 发布之后的内部可变状态。
还有一个容易漏掉的细节:普通写入确实可以"搭便车"。JMM 的 happens-before 具有传递性,所以程序顺序中发生在 volatile 写入之前的普通写入,可以一起发布。这也是正确实现的双重检查锁能够安全发布对象的依据。
但读取线程必须先读取同一个 volatile 字段,建立相应的 happens-before 关系。如果它通过另一条路径直接访问旁边的普通字段,没有读取这个 volatile 字段,也没有其他同步关系,就不能获得这项可见性保证。
Atomic:一条单通道闸机
java.util.concurrent.atomic 中的 AtomicInteger、AtomicLong、AtomicBoolean、AtomicReference<T>,补上了 @Volatile 无法保证复合操作原子性的缺口。
不过,每次原子操作直接保护的是一个变量。
理解它们可以从 CAS(Compare-And-Swap,比较并交换)开始。compareAndSet(expected, new) 会原子地检查当前值是否与预期匹配:匹配就更新,否则保持原值并返回 false。
具体可能使用硬件 CAS 或其他平台原语,不能一概说成所有平台上都是一条指令。
incrementAndGet() 的语义可以用下面的 CAS 重试循环说明,实际实现也可能直接使用原子加法指令:
kotlin
// conceptually, this is what incrementAndGet() does
fun AtomicInteger.customIncrementAndGet(): Int {
    while (true) {
        val current = this.get()
        val next = current + 1
        if (this.compareAndSet(current, next)) {
            return next // nobody interleaved --- success
        }
        // somebody else won the race --- reload and retry
    }
}
val sequence = AtomicInteger(0)

val prior = sequence.getAndIncrement() // returns 0, field becomes 1
val post  = sequence.incrementAndGet() // field becomes 2, returns 2
这种 CAS 循环不靠阻塞线程来等待锁。发生竞争时,它会重新读取并重试。但多个独立原子操作不会自动组成一个原子事务。
下面就是经典的 check-then-act,也就是"先检查,再操作":
kotlin
class UnsafeLedger {
    val balance = AtomicInteger(100)
    val transactionCount = AtomicInteger(0)

    fun debit(amount: Int): Boolean {
        if (balance.get() >= amount) {        // Thread A passes the check
            // <-- Thread B can drain balance right here
            balance.addAndGet(-amount)        // Thread A now drives balance negative
            transactionCount.incrementAndGet()
            return true
        }
        return false
    }
}
每次访问 balance、每次更新 transactionCount,各自都是原子的,但检查余额和扣款之间仍然允许别的线程插入操作。
"余额不能扣成负数"首先是
balance自身的检查与更新需要保持一致,并不是两个字段之间的不变量。即使删掉transactionCount,这个 Bug 也存在;如果还要求余额和交易次数同步变化,就需要额外保护它们的整体一致性。
可以把 Atomic* 想成一个单通道闸机:它能处理好眼前这一次通行,却不知道球场另一侧还有一个闸机。
另外三个常见问题是:
- 先检查再设置:
if (ref.get() == expected) ref.set(newVal)存在竞态。需要匹配预期引用后再替换时,应使用ref.compareAndSet(expected, newVal)。对AtomicReference来说,这里比较的是引用身份,相当于 Kotlin 的===,不是==的结构相等。 - CAS 反复重试:几百个线程同时更新一个
AtomicLong,可能把大量 CPU 时间花在失败重试上。统计型累加可以考虑把更新分散到内部多个 cell 的LongAdder,但它的sum()不是并发更新下的原子快照,不能直接代替序号生成器或严格余额控制。 - 引用和引用指向的对象:
AtomicReference<T>保护的是引用,不会自动保护T发布之后的内部可变状态。
如果需求是"基于当前值算出新值",而不只是"仍等于 X 才替换",通常不必手写上面的重试循环。
updateAndGet { current -> transform(current) } 和 getAndUpdate { ... } 已经提供了这种原子更新:
kotlin
val ref = AtomicReference(Config(retries = 3))
ref.updateAndGet { current -> current.copy(retries = current.retries + 1) }
更新函数可能因竞争而重复执行,因此不能在里面顺便发送消息或扣一次外部账款。
synchronized 和 Mutex
这两个工具都能保护包含多个步骤的临界区,差别主要在等待时占用什么。
synchronized 依赖 JVM 的 monitor,也就是监视器锁:
kotlin
class ThreadSafeLedger {
    private val monitor = Any()
    private var balance = 100
    private var transactionCount = 0

    fun debit(amount: Int): Boolean {
        synchronized(monitor) { // visibility + exclusion, together
            if (balance >= amount) {
                balance -= amount
                transactionCount++
                return true
            }
            return false
        }
    }
}
进入代码块时获取监视器,退出时释放。同一个监视器上的解锁,happens-before 后续成功加锁,因此遵守同一加锁协议的线程既能互斥,也能获得可见性。
这里同样不该理解成"进入时清空所有缓存,退出时把所有寄存器刷回内存"。没有竞争时,JVM 可以走成本较低的加锁路径;发生竞争时,线程可能先自旋,再阻塞等待,具体取决于运行时实现,不是每次都固定发生两次内核上下文切换。
协程会让阻塞等待的成本更明显。协程不独占线程,许多协程会复用 dispatcher 的少量线程。如果线程被阻塞在锁上,就不能执行其他排队的协程;这种等待积累起来,可能造成 dispatcher 饥饿,连带卡住应用中的其他工作。
同时,不能让线程所属的锁跨越协程挂起点:协程恢复时可能已经换了线程。kotlinx.coroutines.sync.Mutex 就是面向协程提供的互斥工具,等待获取锁时可以挂起协程,把线程让出来:
kotlin
class SecureDataRepository(private val remoteApi: RemoteApi) {
    private val cache = mutableMapOf<String, String>()
    private val mutex = Mutex()

    // WRONG --- Kotlin's synchronized() intrinsic rejects this at compile time:
    // "Suspension functions can only be called within coroutine body"
    // fun brokenSyncGet(key: String): String {
    //     synchronized(this) {
    //         val fresh = remoteApi.fetchData(key) // suspend call inside a monitor
    //         ...
    //     }
    // }

    // CORRECT --- the coroutine suspends, the thread is freed
    suspend fun safeGet(key: String): String {
        mutex.withLock {
            cache[key]?.let { return it }
            val fresh = remoteApi.fetchData(key) // thread is free to do other work while this awaits
            cache[key] = fresh
            return fresh
        }
    }
}

interface RemoteApi {
    suspend fun fetchData(key: String): String
}
Kotlin 会诊断 synchronized 临界区中的挂起调用。不过,上面注释里的 brokenSyncGet 本身也不是 suspend 函数,所以它引用的报错不能单独证明监视器检查的行为。
ReentrantLock 的普通 lock() / unlock() 调用没有同样的语言级保护。把 lock.lock(); suspendCall(); lock.unlock() 写在挂起函数里,并不能保证安全:除了阻塞等待,恢复到其他线程后解锁还可能违反锁的线程所有权。不要依赖编译器替你发现所有问题,要检查任何跨越挂起点的线程锁。
可以把
synchronized的竞争等待想成工作人员坐在原地等门开;协程Mutex则像取号排队,等待期间把工作人员,也就是线程,让给别的任务。
反过来还有一个坑:JVM 监视器可以重入,已经持锁的线程能够再次进入;Mutex 不可重入。
下面的协程再次获取自己持有的锁,会一直等待,直到被取消等外部事件打断:
kotlin
class IncidentDemo {
    private val mutex = Mutex()

    suspend fun outerProcess() {
        mutex.withLock {
            innerProcess() // deadlock --- waits on a lock it already holds
        }
    }

    suspend fun innerProcess() {
        mutex.withLock { /* ... */ }
    }
}
可以把加锁放在公开 API 边界,再把受保护的逻辑拆成不重复加锁的私有辅助函数:
kotlin
suspend fun outerProcess() = mutex.withLock { doOuterWork() }
suspend fun innerProcess() = mutex.withLock { doInnerWork() }
private fun doOuterWork() { doInnerWork() /* no lock here */ }
private fun doInnerWork() { /* ... */ }
怎么选
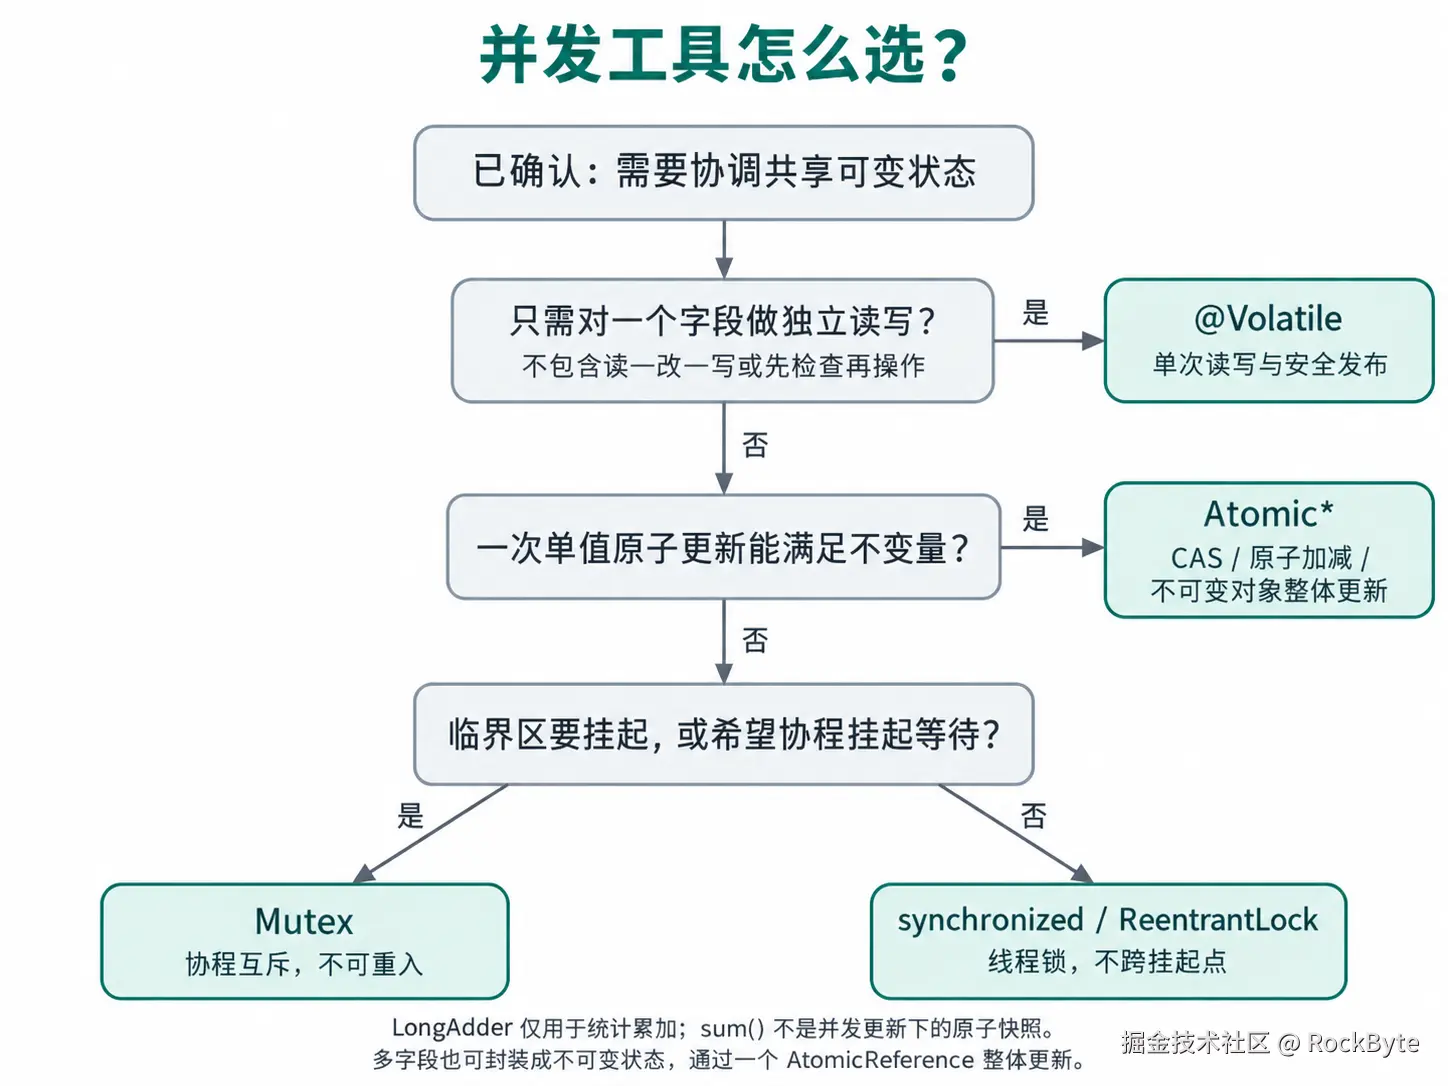
把四个工具的边界理清之后,通常可以先问两个问题:状态是不是单个变量?临界区需不需要跨越挂起点?
竞争付出成本
正确性只回答了一半问题。另一半是,当线程真的开始争抢同一份状态时,这些工具各自需要付出什么:
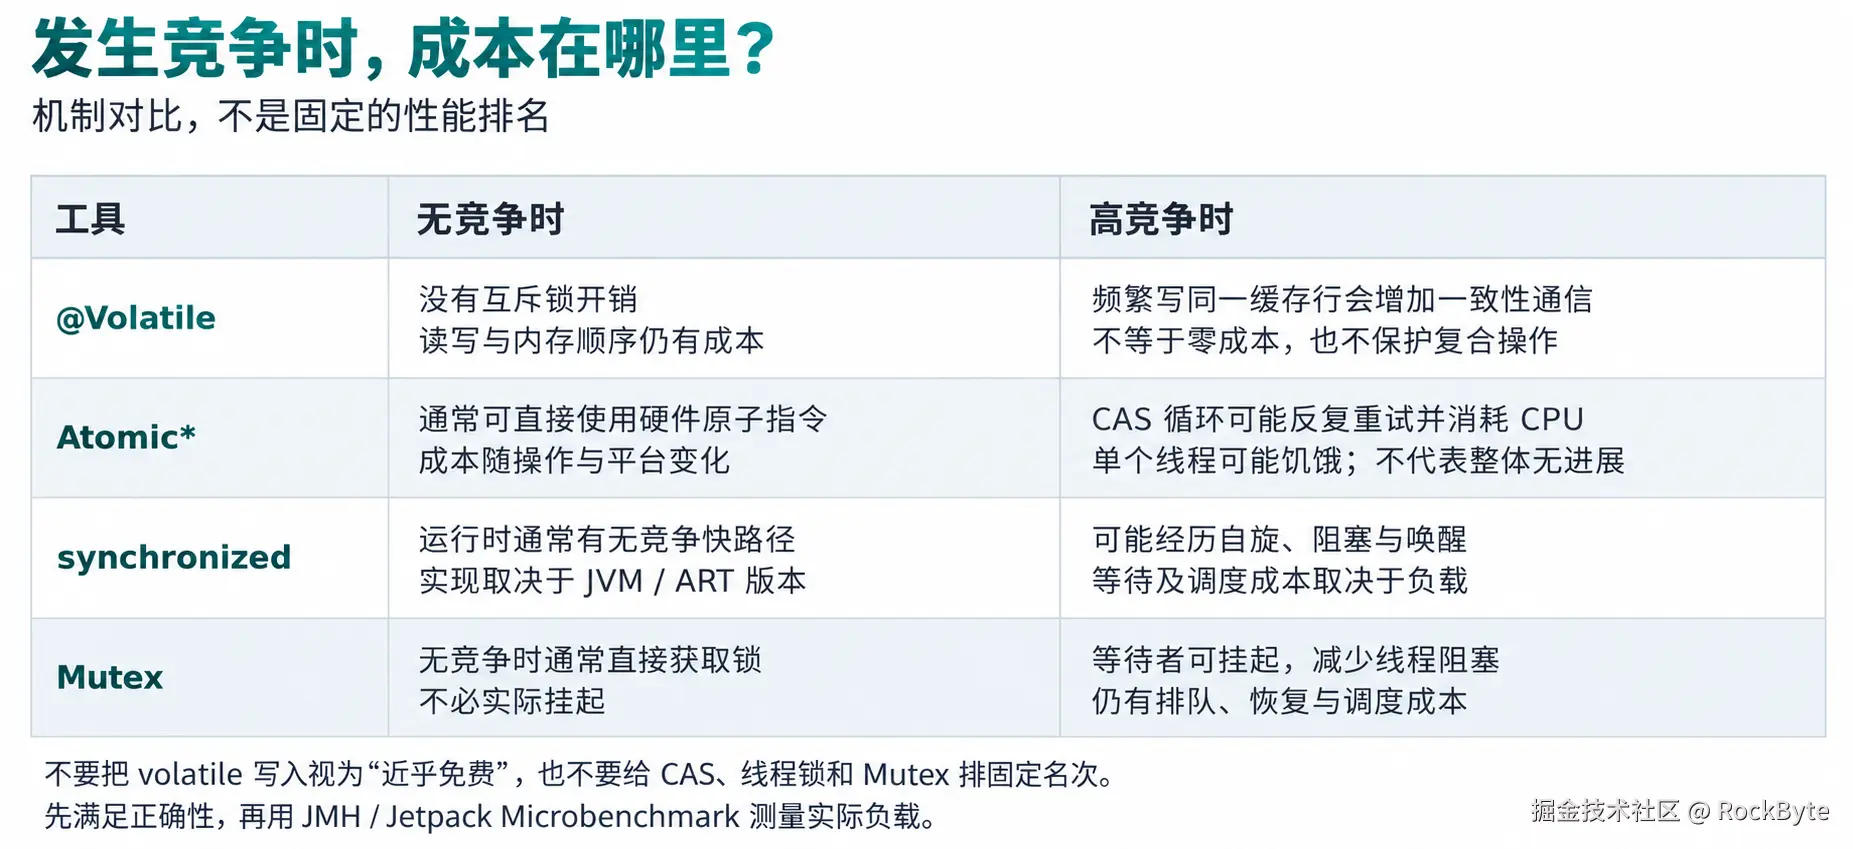
@Volatile 不使用软件锁,不等于竞争时没有成本。同一个 volatile 字段被频繁并发写入,仍然会带来跨核心的缓存一致性通信。在采用 MESI 等协议的机器上,对缓存行取得写权限会影响其他核心持有的副本。即使没有阻塞,竞争也可能让写入变慢。
所以,选能满足不变量的最轻工具。过度加锁可能造成只有负载上来之后才显现的吞吐量问题;加锁不足则可能破坏正确性。两者都需要在实际负载下验证。
都绕不开的坑
- 局部安全不等于整体安全。Service A 用
AtomicReference或synchronized保护状态,如果 Service B 仍然通过未同步的路径修改同一份数据,整体仍不安全。 - 同步必须形成完整的配对关系。写入时使用
synchronized,读取时直接访问普通字段,如果没有其他 happens-before 关系,仍然存在数据竞争。不能只保护一侧。 - 测试未复现,不代表没有竞态。小负载很难碰到特定的线程交错,这也是原作者的计数器直到 64 个线程压测时才暴露问题的原因。可以使用
jcstress或专门的多线程压力测试;协程逻辑则可以借助测试调度器控制挂起点的执行顺序。
Android 上还要考虑什么
上面的原则适用于 JVM 并发。Android 还多了自己的运行条件:常见的是 ART 而非 HotSpot、ARM 而非 x86,还有电池、温控,以及不能长时间阻塞的 UI 线程。
模拟器跑通了,真机未必没问题。 x86 的硬件内存顺序相对较强,一些缺少同步的问题可能不容易暴露。ARM 的内存顺序更弱,同样的代码可能出现不同表现。不过,硬件内存顺序不能替代 JVM 的同步要求,编译器优化也会影响结果。
如果 Bug 只在部分用户手机上出现,不要仅凭一次 x86 模拟器测试就排除可见性问题。应当在真实 ARM 设备上验证,最好覆盖不止一种芯片;通过测试也不能证明不存在竞态。
主线程上的锁竞争可能造成卡顿和 ANR。 服务器上的锁等待通常表现为延迟,Android 主线程被阻塞,则会直接影响绘制和输入响应。阻塞几帧就是卡顿。
如果后台线程正持锁做 I/O,就不要让主线程通过 synchronized、ReentrantLock.lock(),或 runBlocking 包裹的 Mutex 等待它,否则后台操作的延迟会直接传到 UI。
StrictMode 可以帮助发现主线程上的磁盘和网络访问,但不能据此排除等待其他线程持有监视器的问题。要检查从 onCreate、onResume、adapter 绑定和观察者回调进入的加锁路径。可能运行在 Dispatchers.Main 上的协程,可以优先考虑 Mutex,因为等待锁时挂起协程不会占住 UI 线程。
Compose Snapshot 有自己的并发语义。 mutableStateOf 看起来像普通字段,背后却是 Snapshot 系统。多个线程执行复合读写,仍然可能丢失更新;独立可变快照在应用时也可能发生冲突。
对常见 UI 代码,把状态写入集中在主线程是一种容易理解的约定:后台照常使用协程、Atomic* 或 Mutex 处理工作,再切到主 dispatcher 发布结果。这样能减少并发状态修改的复杂度,但它是一种设计选择,不是 Compose 的硬性限制。
Mutex 还要考虑协程取消。 synchronized 不认识协程取消,线程要么取得监视器,要么继续等待。Mutex.withLock 在等待获取锁时可以取消,这通常符合需求:ViewModel 的 scope 已经取消,就没必要继续排队。
持锁期间,如果代码在挂起点等位置响应取消并抛出 CancellationException,withLock 仍会通过 finally 释放锁,但保护块后面的普通语句会被跳过。清理应该放进锁体内的 try/finally:
kotlin
suspend fun updateCache(key: String, value: String) {
    mutex.withLock {
        try {
            cache[key] = value推倒
            writeThroughToDisk(key, value) // may suspend, may get cancelled mid-way
        } finally {
            // guaranteed to run even on cancellation, still holding the lock
            markDirtyFlagCleared(key)
        }
    }
}这段示例展示的是清理代码的执行位置。markDirtyFlagCleared 是否应该在写盘失败时清除标志,取决于业务语义;如果 dirty 标志表示尚未落盘,失败或取消时就不能直接清除。取消也是协作式的,并非发出取消请求后立即打断任意指令。
正确性测试发现不了伪共享。 两个线程即便更新的是不同的 @Volatile 字段,只要它们落在同一个 CPU 缓存行上,也可能互相影响性能。一个字段的写入会影响另一个核心对整行的缓存,尽管逻辑上它们并不共享状态。
这种问题可能表现为难以解释的吞吐量下降,也容易被误认为 GC 停顿或热降频。对于高频、独立更新的计数器,可以考虑隔开字段布局;适合统计累加的场景也可以考虑 LongAdder,其分散更新的实现有助于降低竞争和伪共享影响。
CAS 重试消耗的不只是 CPU,还有电量。 在服务器上,失败重试浪费计算资源;在手机上,它还会增加耗电和发热。持续负载可能触发温控降频,让整体运行更慢,看起来就像"这台手机性能不行"。
这也是移动端在高竞争场景下考虑 LongAdder、分片,或直接减少写入者数量的理由。具体是否划算,仍然要测量。
这些锁本身不能跨进程共享。 Android 应用可能有 :remote 服务或运行在其他进程的 ContentProvider。一个进程里的 JVM 监视器或 Mutex,不会自动变成另一个进程也参与的锁。
共享文件和数据库需要合适的进程间协调,例如文件锁、集中到 ContentProvider 的受控访问,或 SQLite 事务和锁机制。ContentProvider 本身不会自动把任意一组调用变成事务;也不能给 SharedPreferences 外面套一把 JVM 锁,就认为它支持多进程一致访问。
性能结论要测,不要猜。 前面的竞争分析可以作为理解成本的参考,但 ART 与 HotSpot 的编译策略、运行时开销和优化不同,不能直接搬用某个平台上的性能排序。
在依据"原子操作比 synchronized 便宜"做优化之前,先测量。纯 JVM 逻辑可以用 JMH,涉及 Android 环境和 framework API 的代码可以用 Jetpack Microbenchmark。手写 System.nanoTime() 循环容易受 JIT 预热、GC 时机等因素干扰。
真机上的锁竞争还可以结合 Perfetto 查看线程状态和等待时间。这样才能把"感觉慢"具体到"这个线程为了等图像解码器持有的监视器,等待了 40ms"这样的证据。
UI 仪器测试也不能替代并发测试。 Espresso 和 Compose UI 测试会通过各自的空闲同步机制等待应用进入可操作状态,这有助于稳定 UI 测试,却可能避开某些会触发竞态的交错。不是所有后台任务都自动纳入这些机制,测试通过也不能证明并发正确。
对于真实并发路径,要补专门的压力测试,避免只在 UI 测试等待空闲之后才检查结果。对于协程挂起点之间的逻辑交错,可以用 kotlinx-coroutines-test 的调度器构造执行顺序;涉及多个 CPU 线程的竞态仍要使用真实并行测试。
速查表
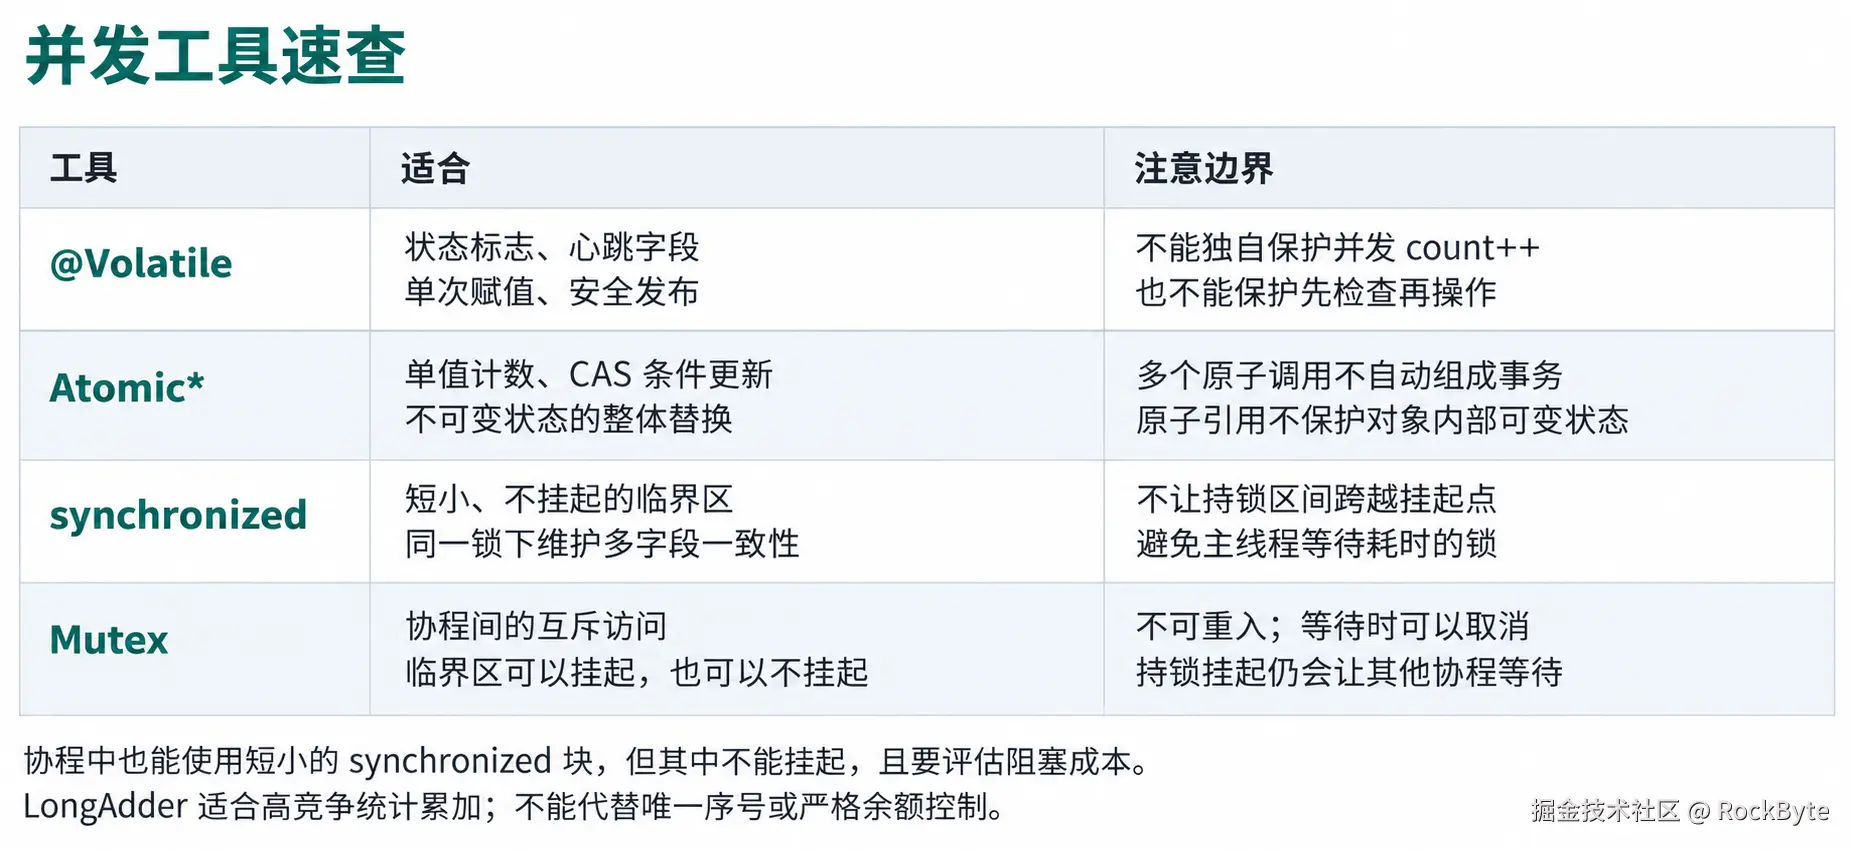
常见问题
到处用 synchronized,是不是就不用考虑这些了?
前提是所有访问都遵守同一把锁,而且等待和临界区工作不会造成不可接受的阻塞。synchronized 可以保护普通临界区,但不能安全地跨越协程挂起点。主线程上有竞争或耗时的临界区可能造成卡顿,严重时触发 ANR。需要跨挂起点保护状态时,应当使用 Mutex 等适合协程的机制。
AtomicInteger 一定比 synchronized 快吗?
不一定。低到中等竞争时,它常常很合适;高竞争、多写入者下,重试消耗的 CPU,乃至手机电量,可能抵消收益。"无锁一定更快"不是可靠结论,应该用 JMH 或 Jetpack Microbenchmark 测量具体场景。
为什么加了一行 Log.d(),竞态就不复现了?
这类现象常被称为 Heisenbug:观察行为改变了问题的表现。日志带来的延迟,有时还有实现内部的同步,会改变线程交错,掩盖竞态。这是排查并发问题的线索,不能证明代码没问题。去掉日志,再用针对性的压力测试复现。
字段只在 synchronized 块中访问,还要加 @Volatile 吗?
如果每次读写都使用同一个监视器,就不需要额外加 @Volatile,锁已经提供可见性保证。重复添加通常多余,也值得检查是不是还有其他路径在不加锁地访问字段,那可能才是问题所在。
把 withLock() 换成 tryLock(),Mutex 就能重入吗?
不能。不可重入是 Mutex 本身的属性,与使用哪个获取方法无关。锁已被持有时,无 owner 的 tryLock() 会返回 false;如果传入与当前持有者相同的 owner token,则会抛异常,参见 tryLock 文档。
译注:原文建议通过追踪协程
Job自行实现可重入锁,这不是通用安全方案,Job也不能简单视为可重入锁的执行所有者标识。更稳妥的是像前文一样调整调用结构,避免受保护的逻辑再次获取同一把锁。参见 Mutex 文档。
什么现象最像并发 Bug?
负载上来才复现,单独运行却正常;每次表现不一样;加日志或调试器之后,问题改变甚至消失。这些都是时序敏感问题的线索,可以用 jcstress 或专门的压力测试追查,而不只是单步调试。不过,不能据此断言"稳定复现的一定是算法错误",并发 Bug 在特定条件下也可能稳定复现。
模拟器上没问题,还需要关心 ARM 的内存模型吗?
需要。x86 模拟器上跑通,不能作为并发正确性的证明。应当结合内存模型分析,并在实际 ARM 设备上验证。
一点想法
开头那个问题,出在把可见性当成了互斥,而不是 JVM 缺陷或 Kotlin 的特殊陷阱。分清这两种保证之后,四个工具就对应到具体问题上:你究竟在保护什么,保护它时需要让谁等待?
下次写下 @Volatile、拿起一个 Atomic*,或习惯性地包一层 synchronized 之前,先把这个问题想清楚。许多并发 Bug,都来自工具实际提供的保证与工程师以为它提供的保证之间的差距。知道该检查什么之后,这种差距就更容易被发现。
如果你遇到过不属于上述典型情形的竞态,或一次看起来显而易见的修复反而先把线上问题弄得更糟,那些经历值得继续分析。并发 Bug 很少原样重演,但背后的模式会在不同代码库中反复出现。交流这些经验,总比每个人重新踩一遍坑要好。