摘要
把《民法典》总则编丢进默认配置的知识库(固定 500 字切块+向量 Top-5),点查很稳,翻车的是"总结第五章"这类结构题------核心块漏召回,Top-5 里一半是别章噪音。病根在向量化之前:块被切走时,目录身份、指代语境、结构归属全留在了原地。本文逐条复现这些损伤,用目录链前置和长上下文重排修回去,最后把同一份文档交给 ChatDOC 庖丁解文------同一组九问,九问九过,答案还能划词高亮回原文。
一、问题复现:同一份《民法典》,三类问题答不全
做知识库的人迟早会碰上法规类文档:规章制度、合规要求、行业标准 ,结构和法条一样是章-节-条三层,条文里还夹着长列表和"前款"式指代。这类文档结构密度高 ,是检验检索质量最硬的场景之一。
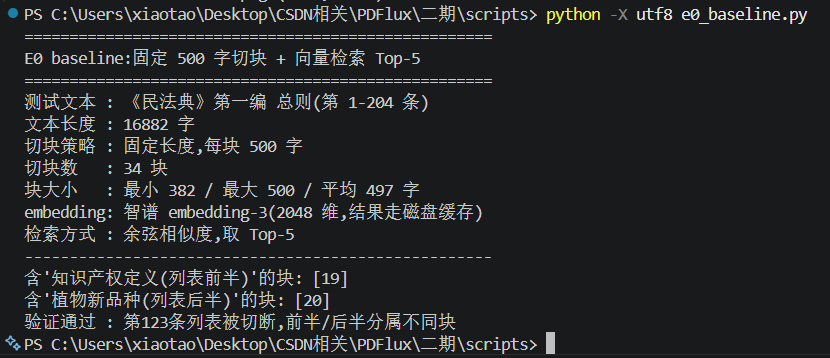
测试文本我选了《民法典》第一编"总则":204 条,约 1.7 万字,10 章,第 123 条还带一个八项长列表。
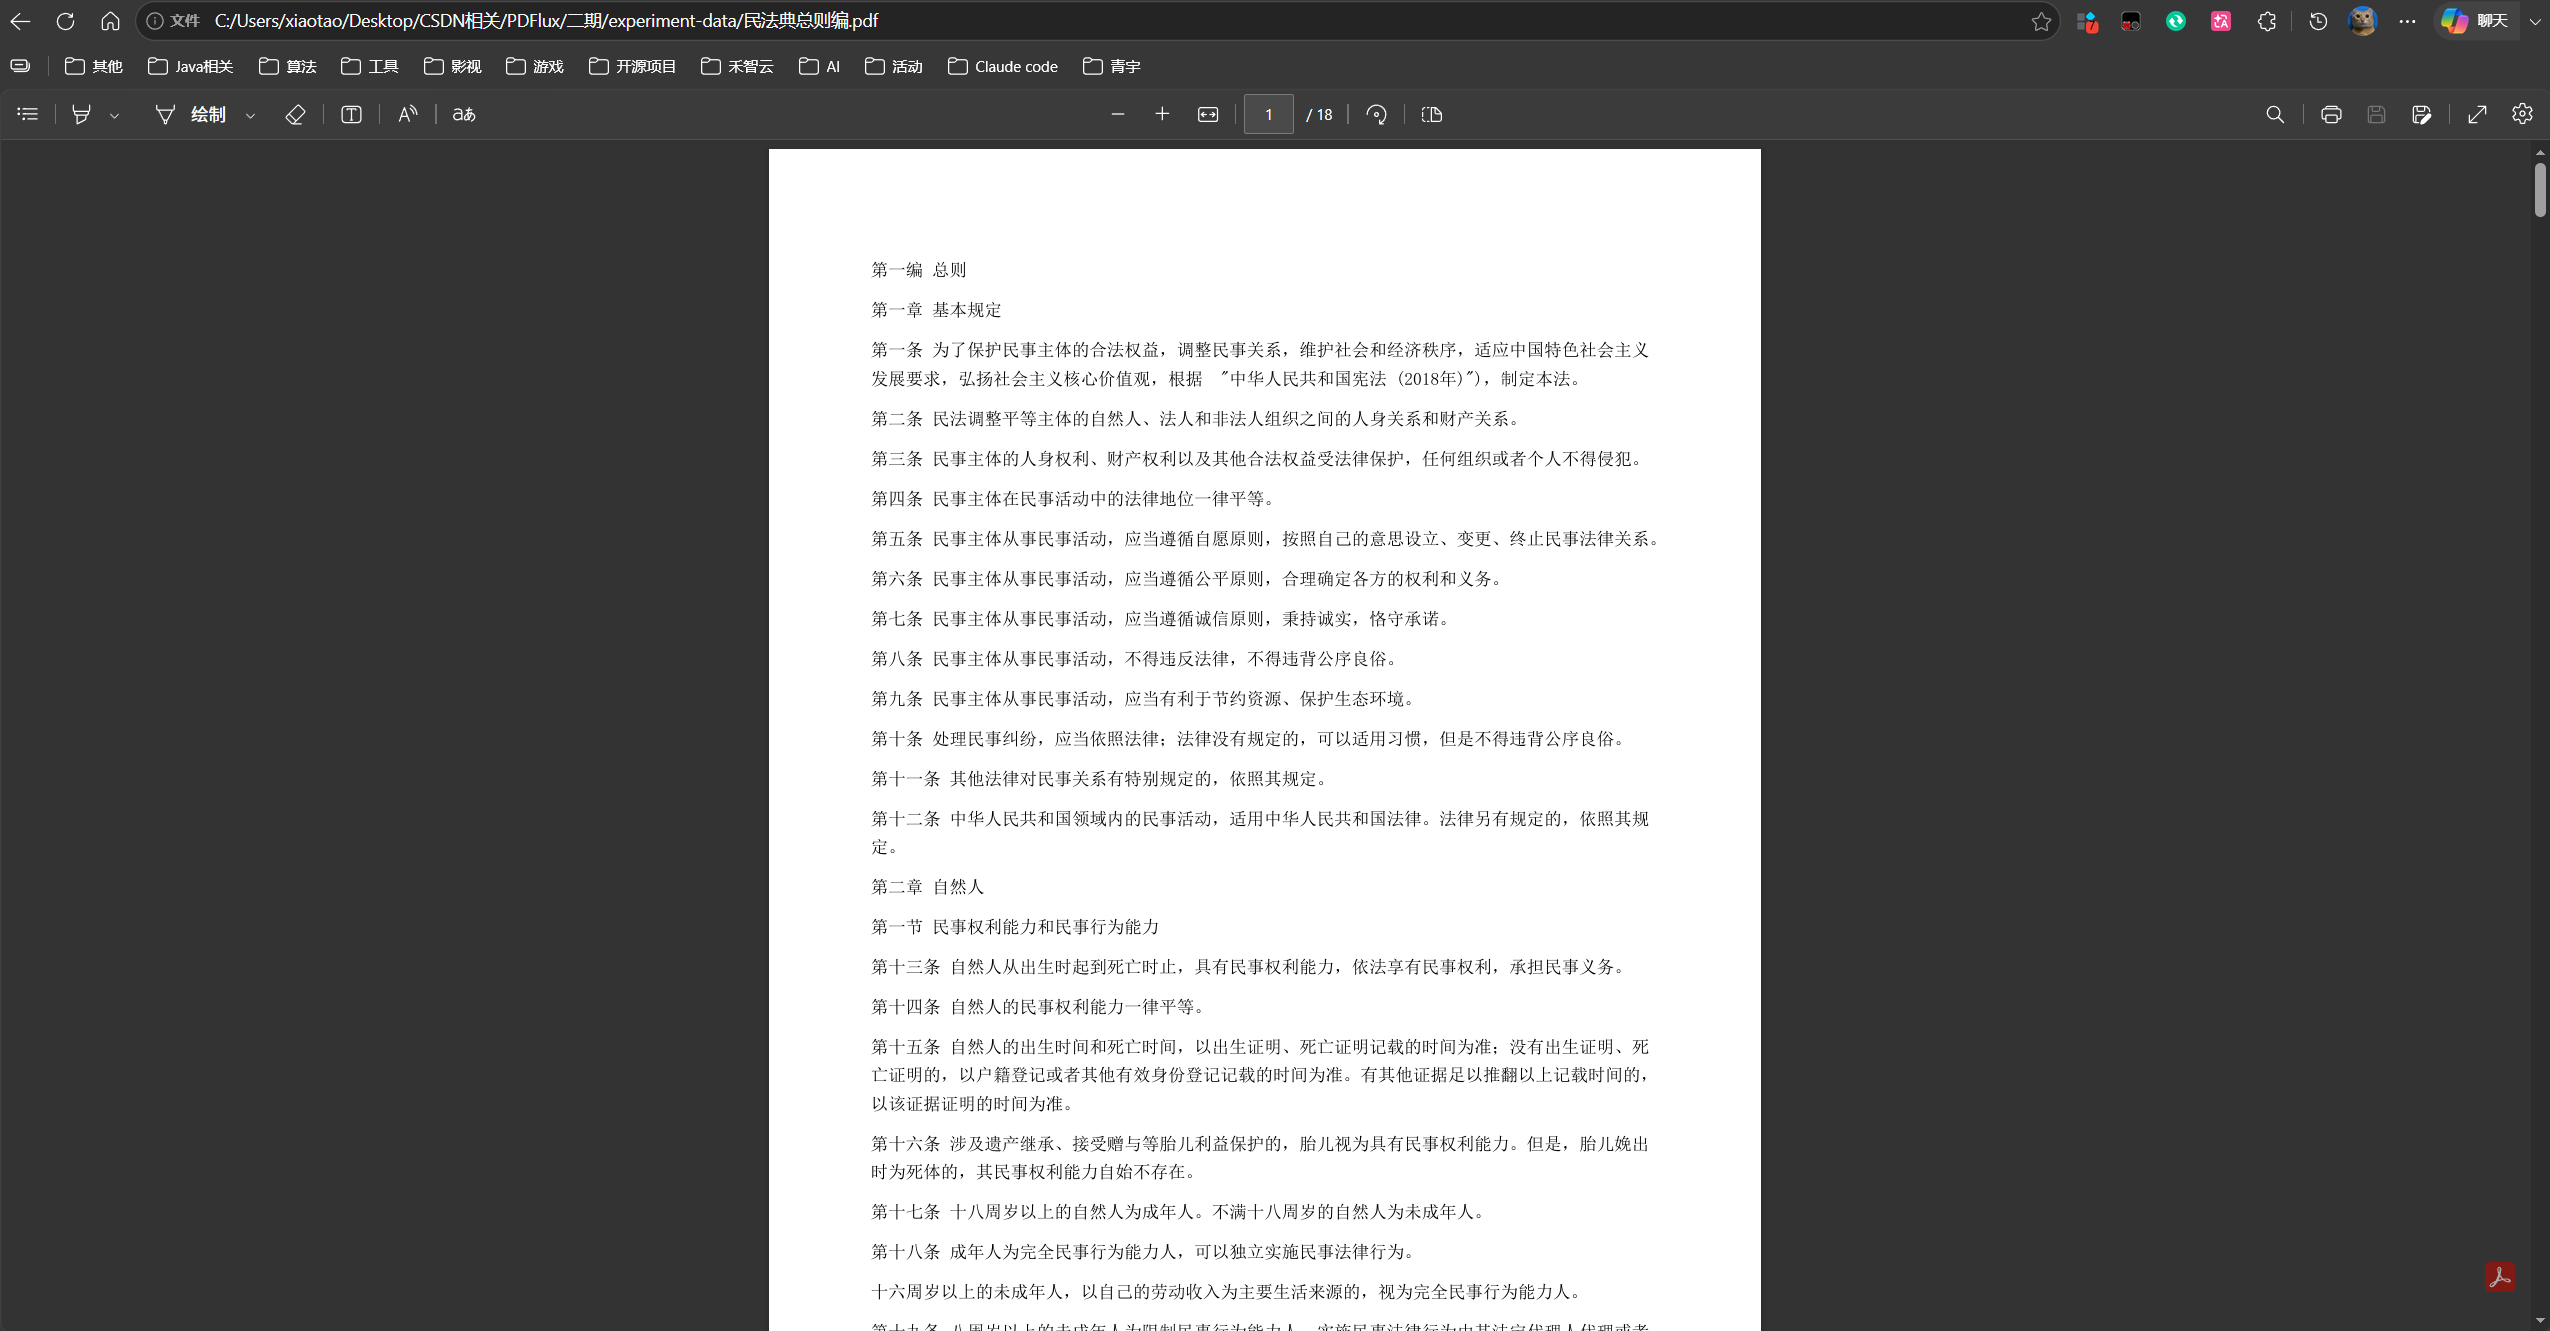
基线是教程级的默认配置:固定 500 字切块(实测切成 34 块)、embedding 用智谱 embedding-3(2048 维)、向量检索取 Top-5、生成用 Qwen3.8-27B。没有重排,没有邻块扩展,不带任何目录信息。这不是刻意搭的稻草人------绝大多数自建知识库的第一版,长得都和这个差不多。
测试集一共九问:列举完整性 3 问(如"知识产权的客体有哪些")、指代理解 2 问(追问"前款"指什么)、结构导航 2 问("总结第五章"、"第六章第三节规定了什么")、单条款事实 1 问(对照)、陷阱题 1 问(文档里根本没有的规定,看它会不会编)。
结果分成两半。列举题、指代题、事实题全部答对;两道结构题全翻。
总结第五章民事权利的主要内容:第五章主体在第 109~132 条,横跨块 18/19/20。检索 Top-5 里,装着第 110~123 条主体的块 19 压根没出现,反倒是块 0、块 1------第一章"基本规定"的内容------挤了进来:
| 排名 | 块号 | 相似度 | 实际所属 |
|---|---|---|---|
| 1 | 18 | 0.639 | 第五章(开头部分) |
| 2 | 25 | 0.630 | 第六章 ✗ |
| 3 | 1 | 0.611 | 第一章 ✗ |
| 4 | 20 | 0.592 | 第五章(末尾部分) |
| 5 | 0 | 0.580 | 第一章 ✗ |
Top-5 纯度只有 2/5。生成模型拿到的素材本身就是错的:回答里物权、债权的定义整段缺席,"知识产权"只剩残段里几个名词的影子。熟悉民法典的人一眼看出这份总结不及格;但如果提问的人不了解原文,这个答案看着还挺像回事------这才是最危险的地方。
**第六章第三节规定了什么?条文范围是多少?**更彻底:第三节的核心块 22/23/24 全部漏召回,Top-5 里四块来自其他章,只有一块勉强沾边。
同一份文档、同一个 embedding、同一个生成模型,为什么点查稳如老狗、总结题一溃千里?问题不在模型,在切块。
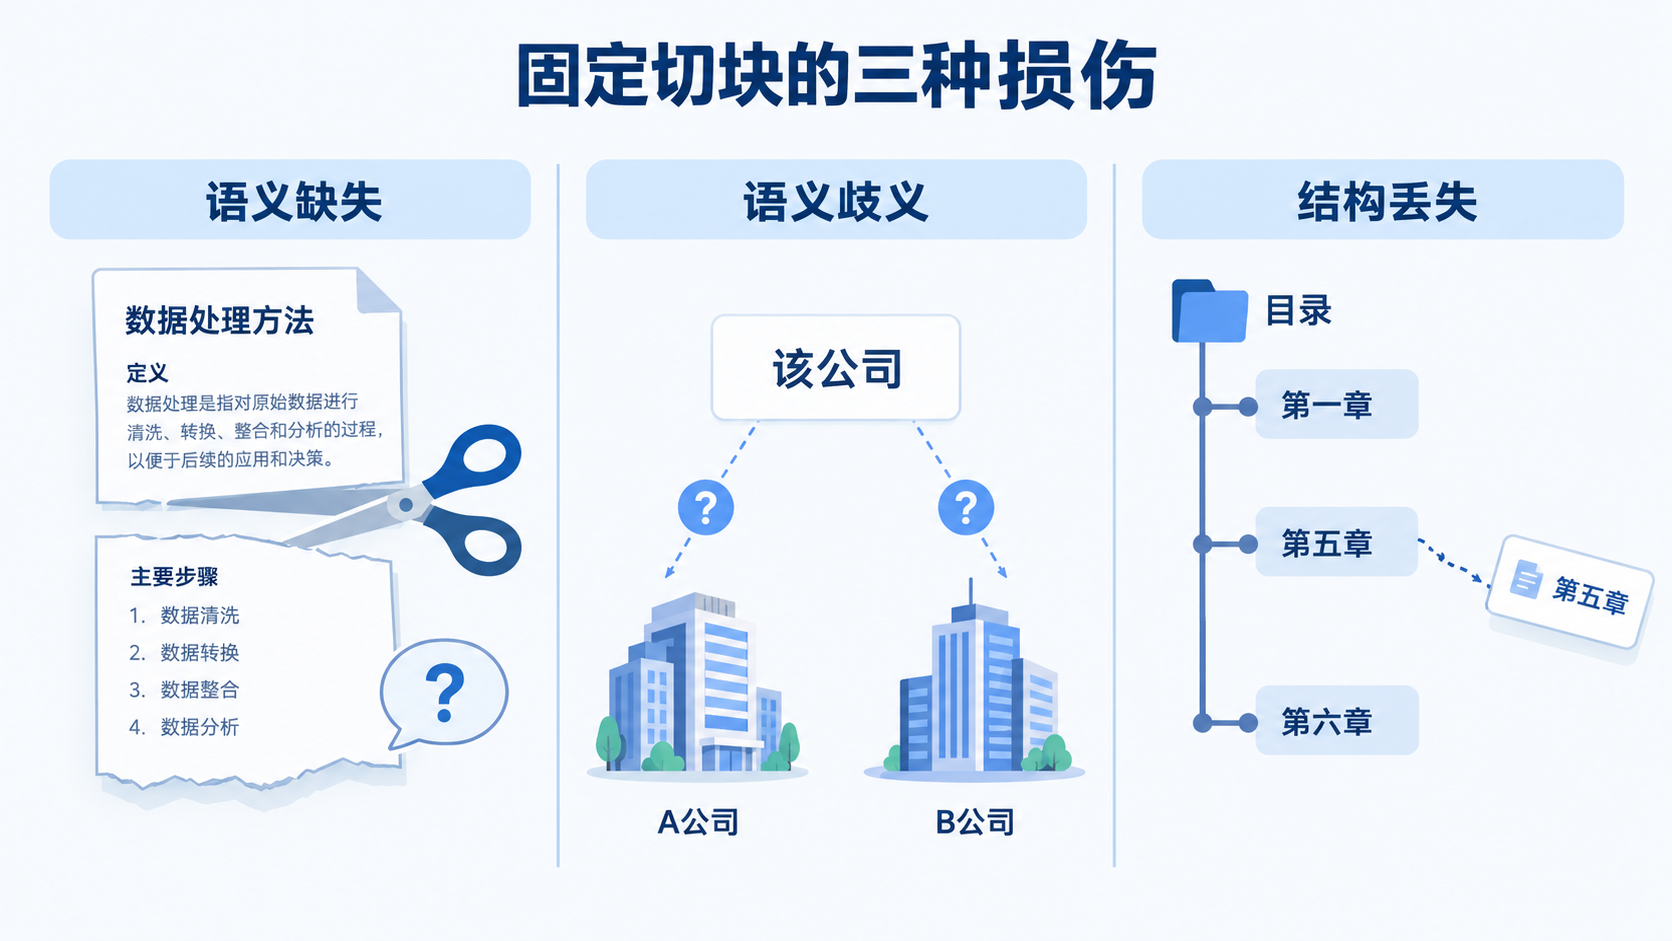
二、原因分析:固定切块的三种损伤
2.1 检索链路:损伤发生在向量化之前
先把 RAG 的检索段拆开,一共四步:
- 切分:把整篇文档切成小块(chunk);
- 向量化:每个块压缩成一个向量;
- 召回:问题也变成向量,和所有块向量比相似度,取最像的 Top-k;
- 重排:对召回的候选精排,把真正相关的往前挪。
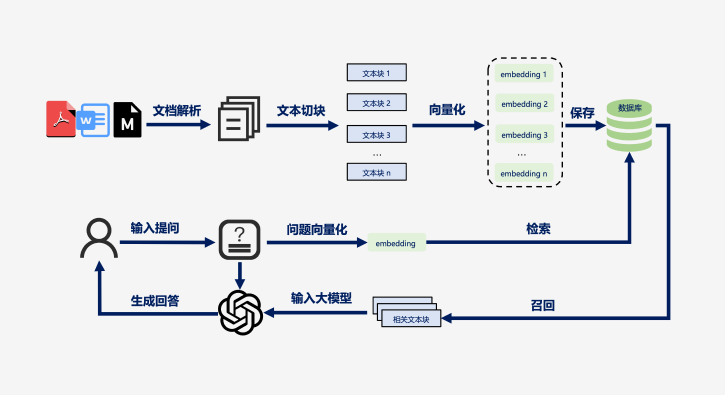
后面的大模型只看精排后的几个块作答。这条链路上,向量化是有损压缩,而且是单行道------块里没有的信息,召回和重排都变不出来。所以检索质量的分歧,从第一步切分就埋下了。
"上下文检索"要解决的正是这里的问题:块在被切离原文的那一刻,丢掉了三样东西:完整的语义、指代的语境、结构上的归属。
2.2 语义缺失:被切断的列表,和一次没有发生的翻车
案例是这样的:第 123 条列举知识产权的八项客体,切块从列表中间切下去,含后几项的块离开了条文定义,单独看不知所云,于是检索失败。
我的实测里,这条列表被切断,块 19、块 20 在列举项中间分家,块 20 开头直接就是"(三)商标;(四)地理标志......"。然后我问"根据知识产权的定义,哪些对象可以享有专有的权利",块 20 排名第二,稳稳进 Top-5,八项客体全部答出。没翻车。
| 排名 | 块号 | 相似度 | 含列表后半 |
|---|---|---|---|
| 1 | 19 | 0.530 | 否 |
| 2 | 20 | 0.442 | 是 |
| 3 | 18 | 0.408 | 否 |
| 4 | 10 | 0.398 | 否 |
| 5 | 1 | 0.380 | 否 |
原因不难理解:列表各项语义高度同族,都是**知识产权**客体名词,定义句虽然被切掉了,列表本身的词向量依然和问题强相关,主流 embedding 对此有容错。
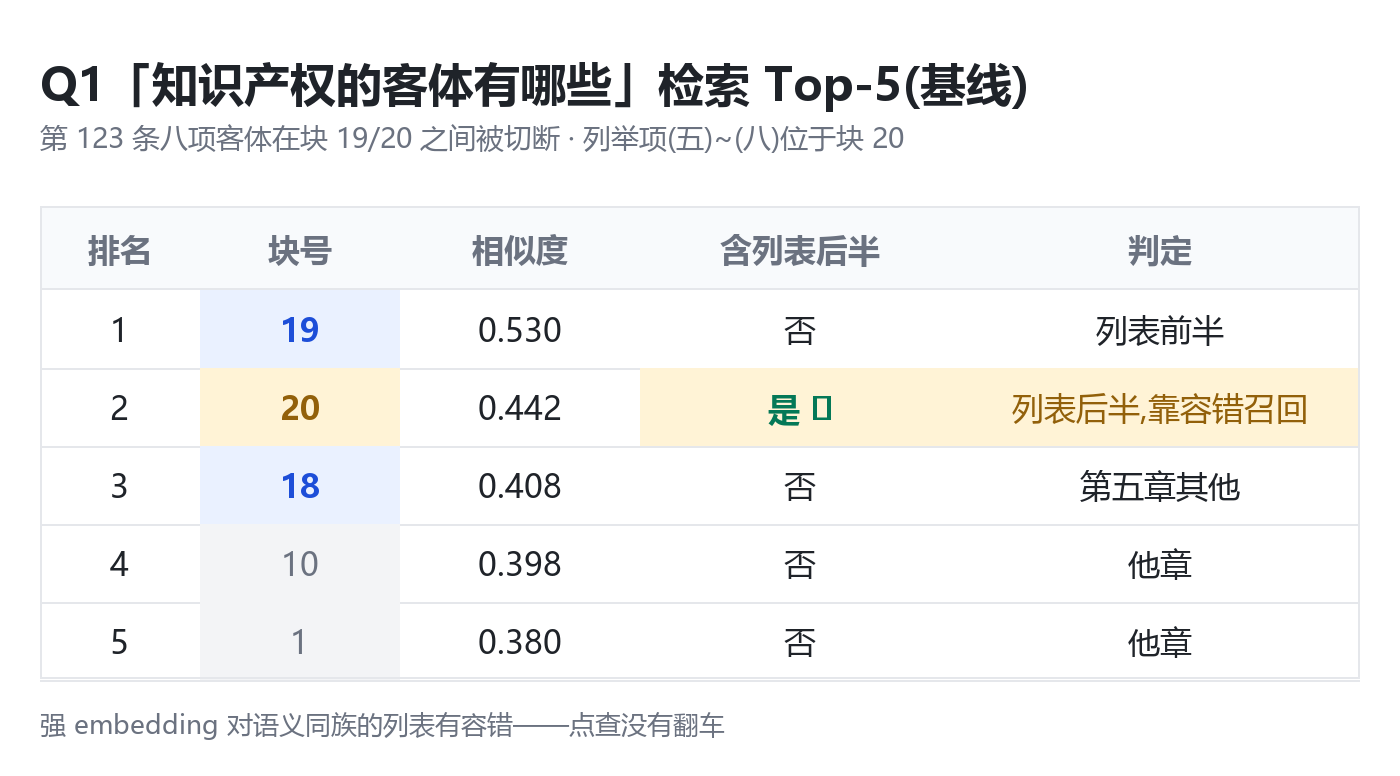
实话说,语义缺失这种损伤,在强 embedding 下并没有官方示例暗示的那么绝对 。但这个容错有条件------列表项语义同族才成立。换成各项语义分化的长列表(财务报表科目、参数表、费率表),切断后照样漏。结论是:三种损伤里,语义缺失最依赖运气,不是最先致命的那个。
2.3 语义歧义:"前款"还在,身份没了
歧义案例出自募集说明书:前后两段各有一个"公司",指代不同主体,切块后指代断裂,检索把不相关的块拉了进来。我照这个思路扫描了总则编,全文 5 处"前款"(第 21、36、42、174 条),全部是条内引用,"前款"和被指的那一款都在同一个块里,没有发生跨块断裂。这个损伤在法律文本上不显形,如实记录;它更容易出现在募集说明书这种叙述松散的文档里。
但扫描过程中撞见了另一个东西:块 20 这个"孤儿块 "。它开头没有任何题头,直接就是列表中部。单独看这一块,没人知道它属于哪条哪章------向量只认识"**商标、**地理标志、商业秘密"这些词,不知道它们身份是什么、归属在哪。这就是歧义损伤的另一种形态:身份不明。
有意思的是后续。我把块 20 的原文直接丢给生成模型,问它这段话出自哪里,它一口报出:"这是《民法典》总则编第五章、第一百二十三条,知识产权客体的第三到第八项"------民法典是公开知名文本,模型训练时背过,参数记忆替检索兜了底。
这恰恰值得警惕。企业私有文档------合同、制度、内部研报------模型从来没见过,没有记忆可依赖,孤儿块的身份不明会完全显形;退一步,就算文档公开,依赖记忆还有版本风险:法条一修订、制度一更新,记忆就成了过期引用。所以工程上不能赌记忆,得把身份写回块里。这也是后面修复方案的出发点。
2.4 结构丢失:总结题全军覆没的真正原因
回到那个核心疑问:为什么点查稳、结构题崩?因为两类问题要的东西不一样。
点查要的是内容 :问题和块在词义上同族,embedding 能对上。结构题要的是归属:"总结第五章"问的不是哪一块谈论过"民事权利",而是哪些块属于第五章。可固定切块里,"属于第五章"这个信息物理上不存在------块 19 是第 110~123 条的条文正文,通篇没有一个"第五章"字样;块 0、块 1 倒是"谈论"民事权利概念(第一章基本规定),和问题词面一拍即合,于是冒名顶替混进 Top-5。
embedding 没有错,它忠实执行了"语义相似";错的是我们递给它的素材里,结构信息已经没了。这是三种损伤里最致命的一种:它不靠运气,结构题一问一个准------两道结构题全翻,就是明证。
三、修复思路:上下文检索的两件武器
庖丁把这个方案叫**"上下文检索"**,自研 了两个模块:目录结构模型 在切分阶段识别章节目录树、给文本块保留全局结构;长上下文重排模型在重排阶段把连续文本块拼接起来整体判断,恢复被切块打断的语义连贯。本章先用最简版本在民法典上复现这两件武器的效果,再对照官方的工程实现。在那之前,先说清楚一条看似更直觉的路为什么不走。
3.1 朴素补全:让大模型给每块补上下文,为什么不选
上下文检索有一个直觉版本:每个块交给大模型,让它生成一段这块在全文中的位置的说明,前置进块再向量化。这个思路(Anthropic 的 Contextual Retrieval 即此)确实有效,但有三个现实问题。
一是成本。34 块就是 34 次调用,看着不多;换成几百万字的文档库就是成千上万次,而且每次重建索引都要全部重来。二是长文档下前置说明本身吃上下文窗口,token 消耗陡增。三是最关键的------补错。模型对私有文档没有先验,生成的定位说明可能"看似合理、实则错位",一段错误的上下文比没有上下文更糟。
补错值得多说一句,因为它最隐蔽。我拿块 20 让生成模型"补一段位置说明",它写得有模有样------毕竟民法典它见过;可若换成一份从未公开的内部制度,模型面对"(三)商标;(四)地理标志......"这样的残段,只能靠猜:猜它属于定义条款、猜它挂在某一节下。猜对是运气,猜错就是给块发了一张假身份证,而且这张假证比没有证更糟------检索会拿着错误的结构信息把整章的块都排错位。
这不是我的臆想,庖丁官方实测过同样的事:用 Anthropic 的补全方法处理民法典那个残段,模型把出处写成"第一章《基本规定》"------实际是第五章《民事权利》;换成保险监管办法,第二节的条文又被补到第一节头上。长文档场景更直接:他们拿一份募集说明书测试,500k tokens 的长度超出模型 200k 的输入上限,方法本身就没法用。生成式的上下文,质量上限取决于模型对文档的先验;而结构化解析的上限,只取决于文档本身干不干净。
我的测试文档自己就带着权威上下文:目录。法律、财报、标准、论文,专业文档几乎都有结构化目录,那是作者亲手写的、不会出错的上下文来源。所以修复走结构化解析路线:从文档自身提取目录链,而不是让模型猜。
3.2 目录链前置:给每个块一张身份证
做法分三步:扫描全文的章、节、条标题;为每个块记录它起始位置所处的层级路径;把路径拼接成目录链前缀,加在块的最前面,再重新向量化、重新检索。核心逻辑十来行就能跑(简化示意,完整脚本见文末脚本包):
plain
HEADING = re.compile(r"^(第[零一二三四五六七八九十百]+[章节条])")

def build_prefixes(text, size):
    """逐行扫描全文;每越过一个块边界,记下当时的章/节/条路径。"""
    path, prefixes, pos = {}, [], 0
    for line in text.splitlines():
        pos += len(line) + 1
        if m := HEADING.match(line.strip()):
            kind = m.group(1)[-1]                  # 章 / 节 / 条
            if kind == "章":
                path = {"章": line.strip()}        # 整行含标题,如"第五章 民事权利"
            else:
                path.pop("条", None)               # 换节/换条后,旧条号作废
                path[kind] = m.group(1) if kind == "条" else line.strip()
        while len(prefixes) * size < pos:
            prefixes.append(dict(path))            # 块起点的目录快照
    return prefixes

snapshots = build_prefixes(text, 500)
enriched = ["《中华人民共和国民法典》第一编 总则"
            + "".join(f" > {s[k]}" for k in ("章", "节", "条") if k in s)
            + "\n" + chunk
            for s, chunk in zip(snapshots, chunks)]
修复后,那个身份不明的孤儿块变成了这样:
plain
《中华人民共和国民法典》第一编 总则 > 第五章 民事权利 > 第一百二十三条
(三)商标;
(四)地理标志;
(五)商业秘密;
(六)集成电路布图设计;
(七)植物新品种;
(八)法律规定的其他客体。
没有人认识的残段,现在胸口挂着完整的身份牌。
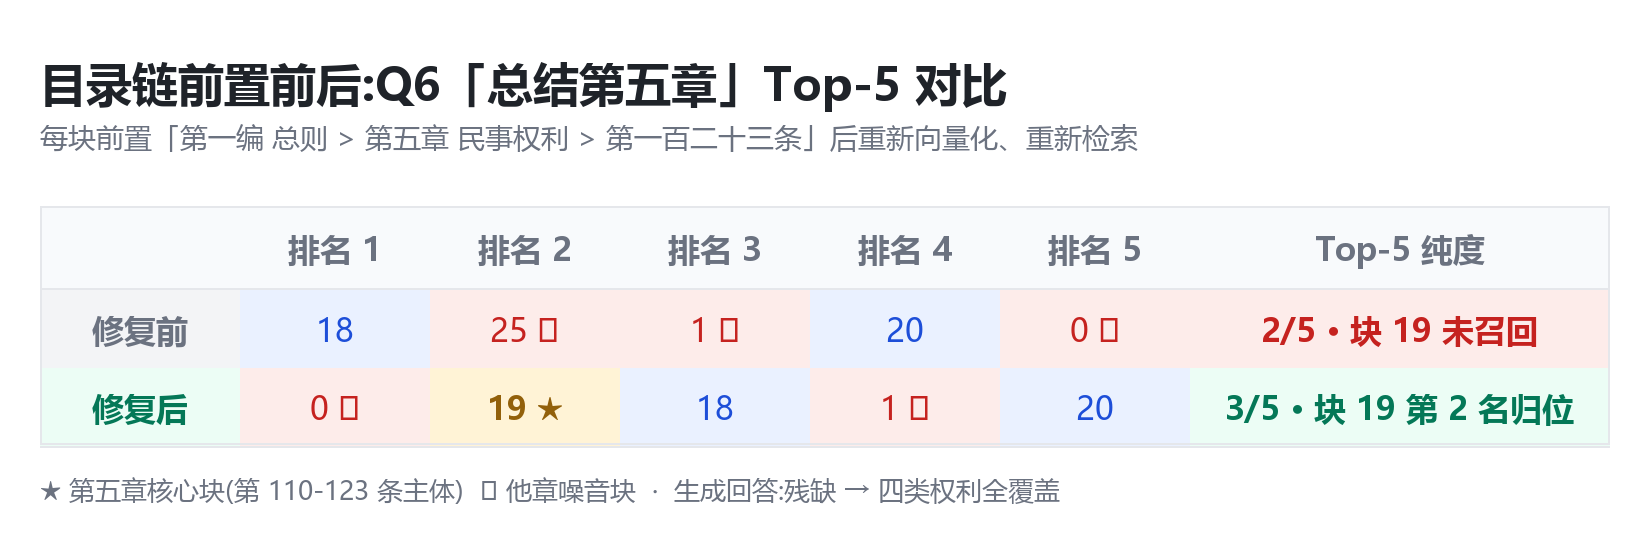
再跑那道翻车的结构题"总结第五章民事权利的主要内容":
| Top-5(按排名) | 第五章纯度 | |
|---|---|---|
| 修复前 | 18 / 25✗ / 1✗ / 20 / 0✗ | 2/5,块 19 漏召回 |
| 修复后 | 0✗ / 19 / 18 / 1✗ / 20 | 3/5,块 19 第 2 名归位 |
三个变化:装着第 110~123 条主体的块 19 从**"未召回"**跳到第 2 名;生成模型的回答从残缺变完整------人身权利、物权债权、知识产权、继承权与投资性权利四大块全覆盖,物权、债权的定义回来了;点查类问题无回归,块 20 依旧稳居第 2,修复没有伤到原来的强项。
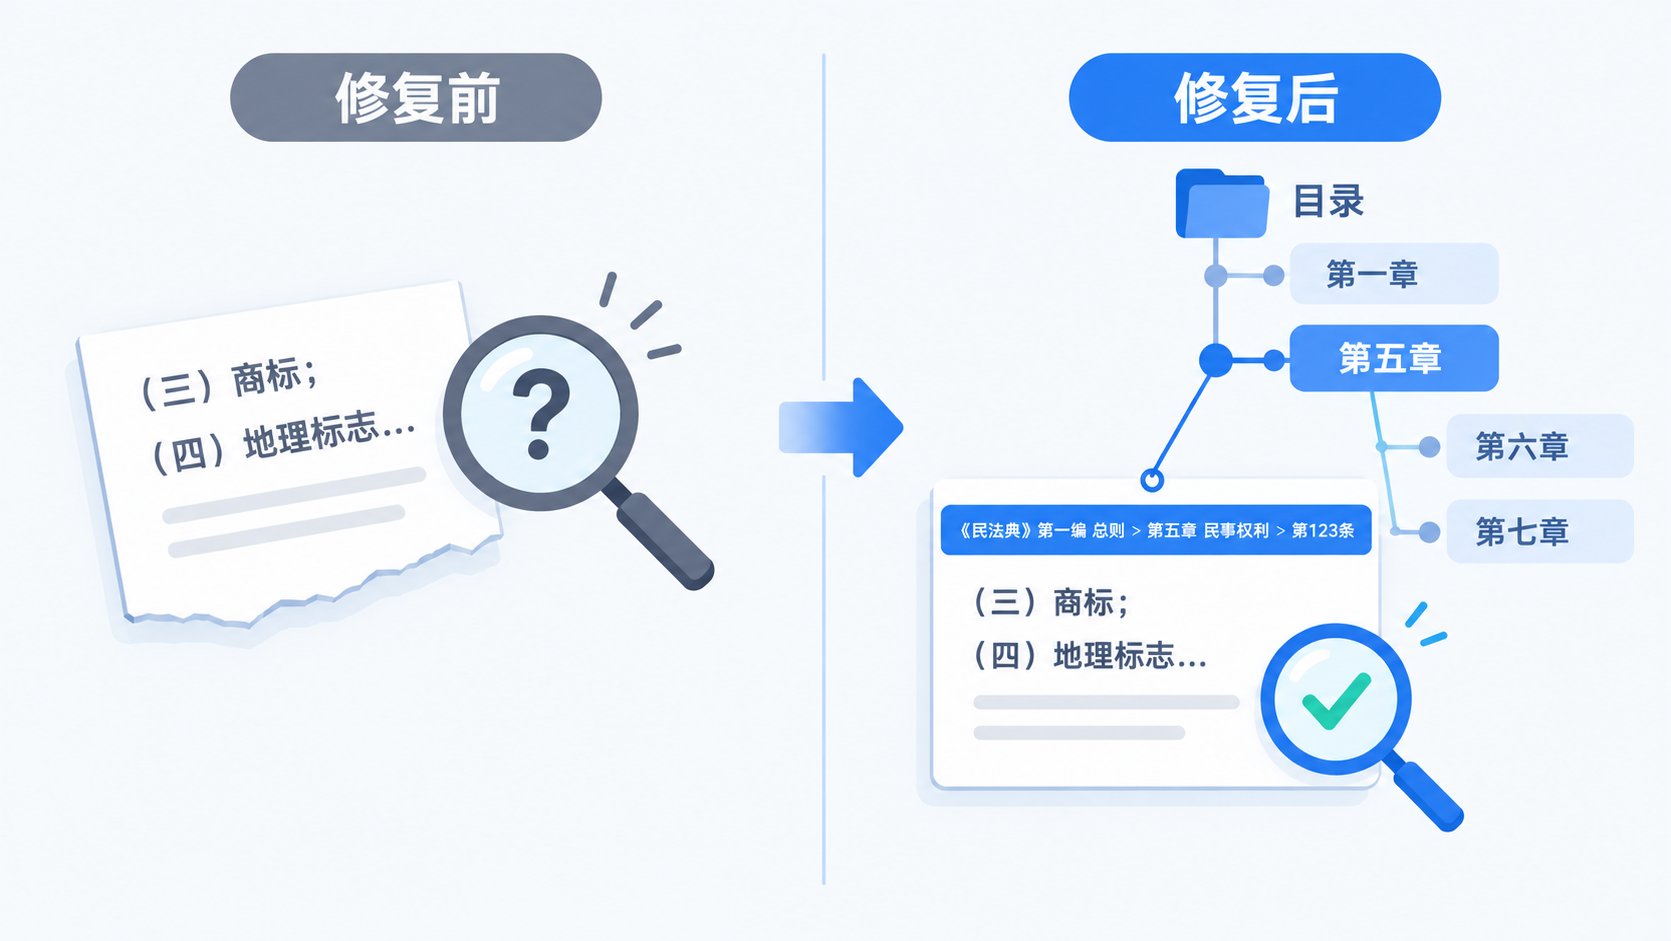
顺带说说这套做法的工业化版本。庖丁训练了专门的目录结构模型,在解析阶段识别整棵章节目录树,切块时只在同一目录分支内切------不同节的内容绝不进同一个块,切完再给每块前置目录链。我的三行正则能对付格式规整的法律文本,他们的模型要对付的是目录散落在图文之间、没有规整格式的真实文档------这大概就是原理验证 和产品之间的距离。
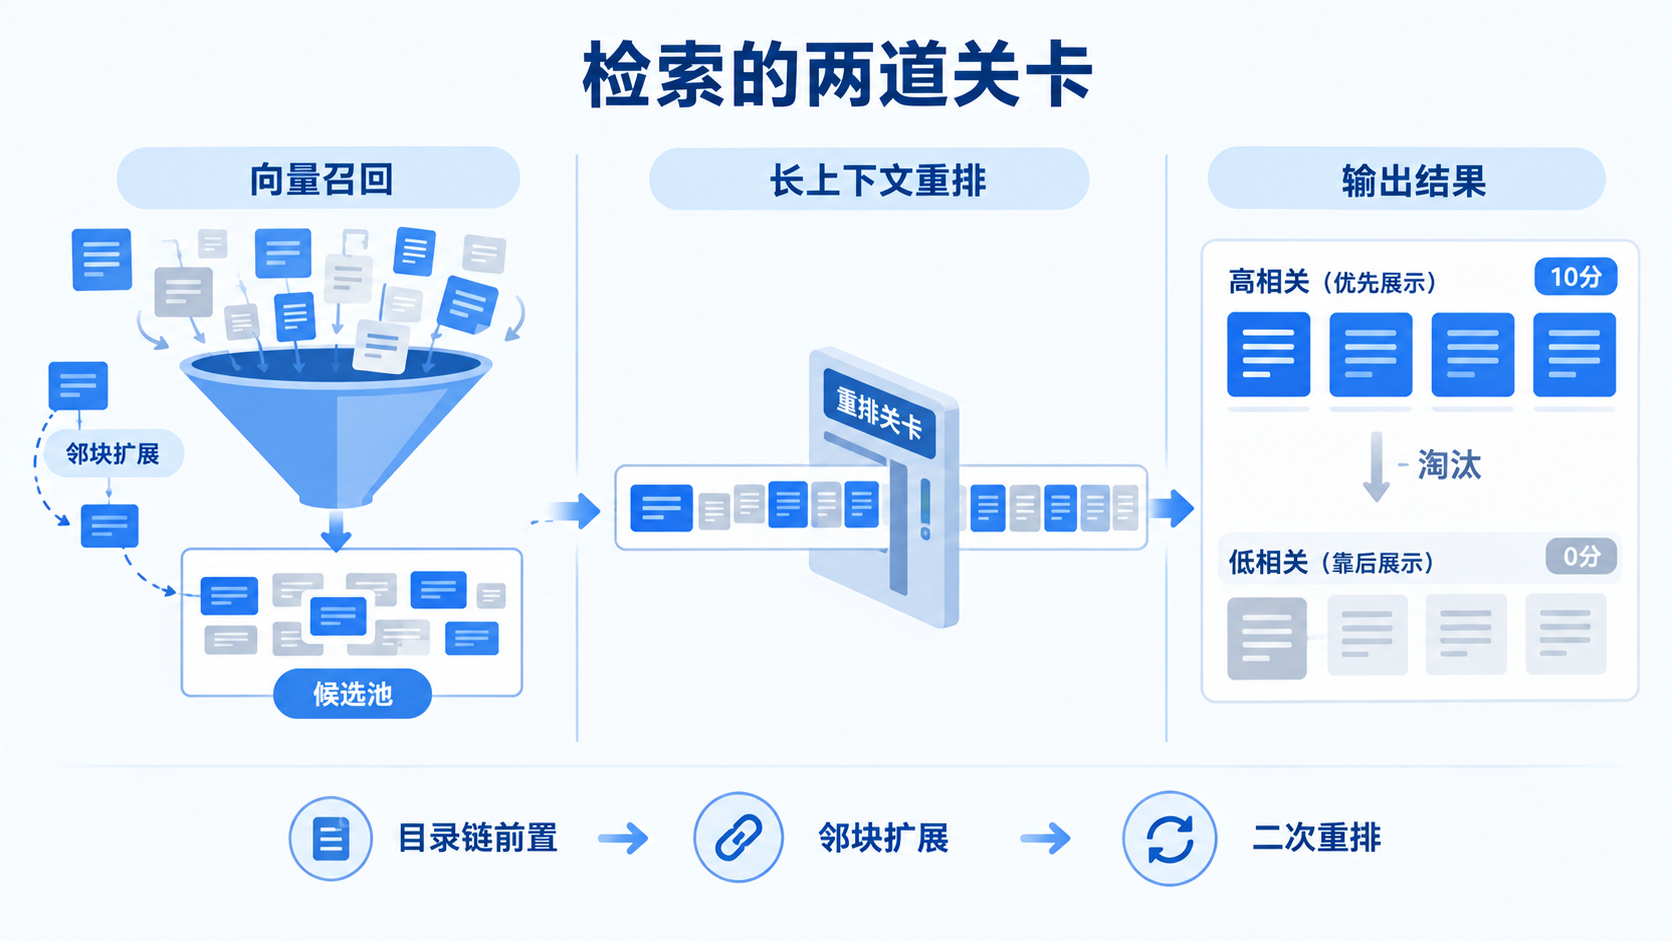
也要如实交代另一面:纯度只到 3/5,块 0、块 1 还在前五。目录链解决的是"该来的块能不能被召回"------给块一张可检索的身份证;但"不该来的块挡不挡得住",它管不了。这活儿得交给第二道关卡。
3.3 长上下文重排:检索的第二道关卡
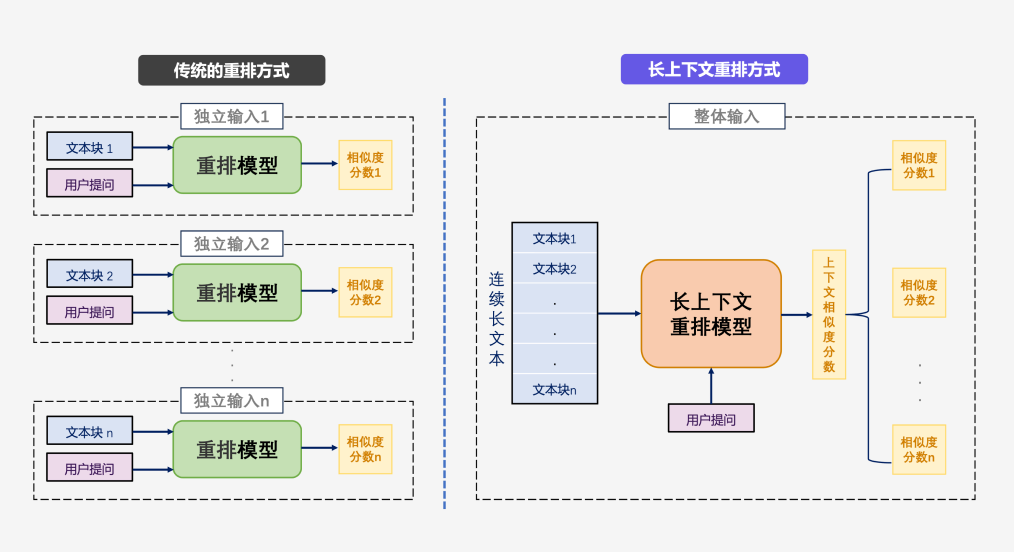
理想分工是:召回模块宁滥勿缺地把候选捞进池子,重排模块去伪存真地精排。传统重排是逐块独立打分------"这个块和问题相关吗";长上下文重排则把候选块按原文顺序拼接后整体判断,块与块之间的连续性、上下文流都参与打分。庖丁的"二次重排"就是这个思路的产品化。
落到操作上,差别就在输入的形态:方式 A 每次只喂问题+单个片段,输出一个 0-10 的相关性分,n 个块问 n 遍;方式 B 把候选片段按原文顺序拼成一段、一次输入,要求对每个片段输出评分。输入从"孤岛+问题"变成"连续长文+问题"------模型看到的不再是碎片,而是还原出大半的原文语境。
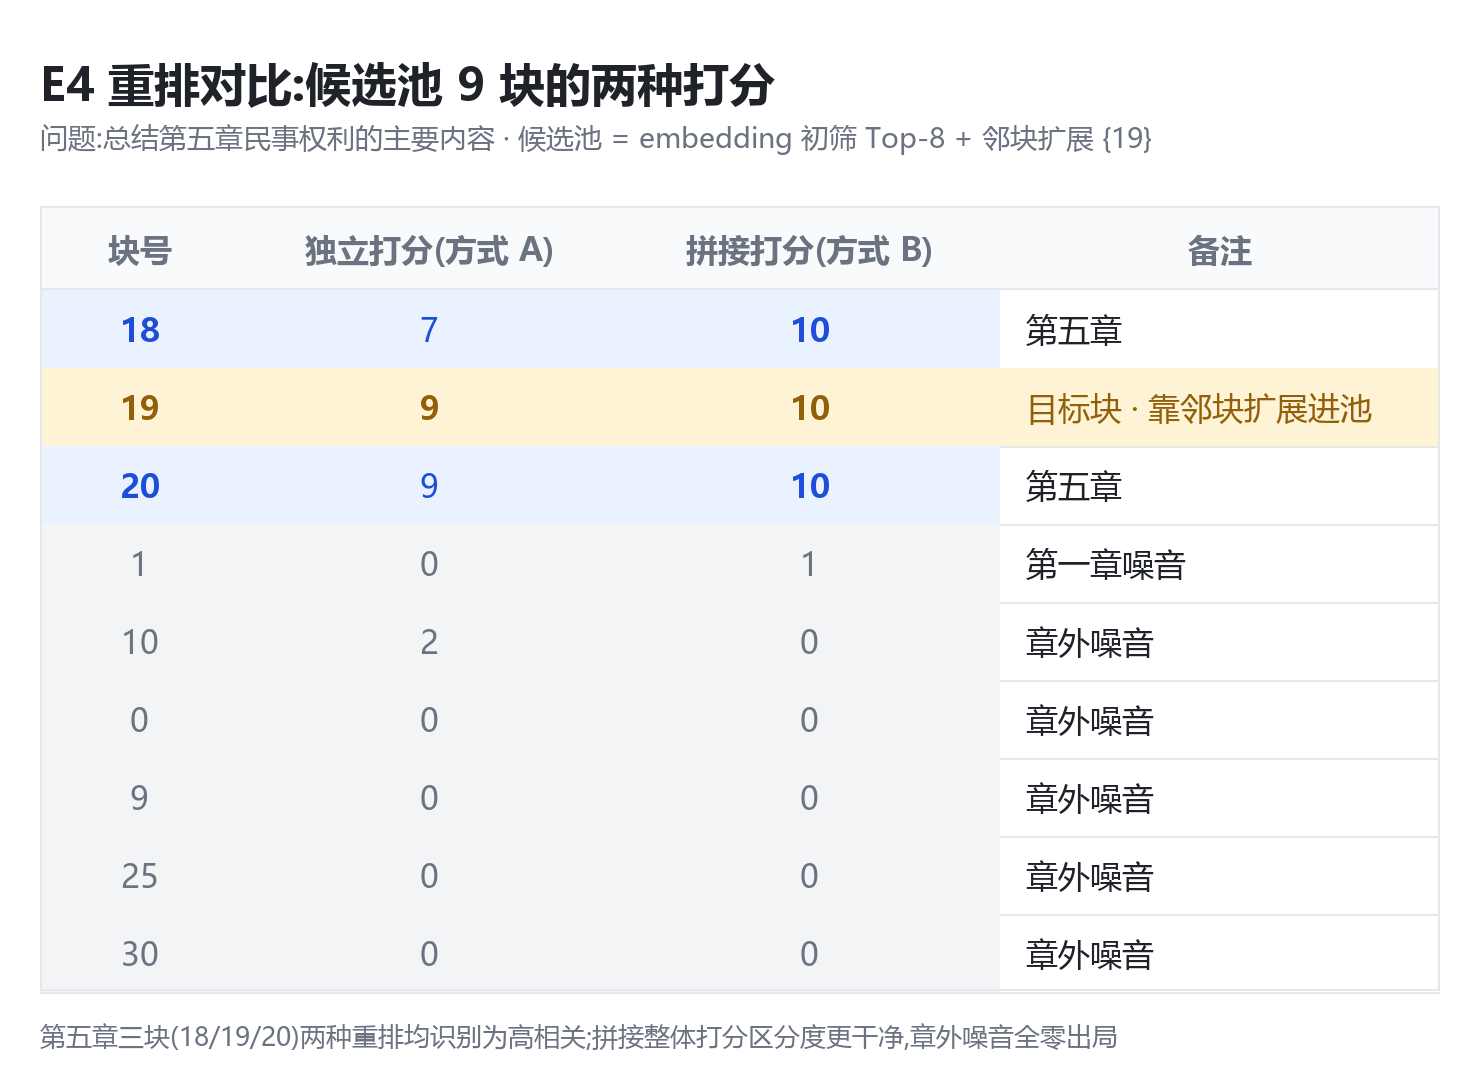
实测拿 Q6 当战场,目标就是那块被初筛漏掉的块 19。候选池由两部分组成:embedding 初筛 Top-8,加上邻块扩展(块 18 的邻居块 19 一并带入),共 9 块。两种重排各跑一遍:
| 块号 | 独立打分 | 拼接打分 | 备注 |
|---|---|---|---|
| 18 | 7 | 10 | 第五章 |
| 19 | 9 | 10 | 目标块,靠邻块扩展进池 |
| 20 | 9 | 10 | 第五章 |
| 1 | 0 | 1 | 第一章噪音 |
| 0 / 9 / 10 / 25 / 30 | 0~2 | 0 | 章外噪音 |
两个结论。其一,两种重排都准确认出了块 19------独立打分 9 分池内第一,拼接打分 10 分;同时把章外噪音全部打到 0~2 分清出场。重排确实是检索链路的第二道救生员,而且拼接整体打分的区分度更干净:第五章三块齐满分,章外几乎全零。
其二更关键:注意块 19 是怎么进池的------不是 embedding 召回的,是邻块扩展带进来的。重排再准,也只能在候选池里挑;召回策略决定重排的上限。这就是官方做 Overlap Chunk 的原因:按每 800 个 token 切块、相邻块重叠 400 个 token------重叠让相邻块的相似分数更接近,更容易被一起召回;连续块进池后按原文顺序拼接,喂给长上下文重排模型,被切块打碎的"镜子"在这一步重新拼回来。先把该来的块弄进池,重排才有得挑。目录链、邻块扩展、重排,三件事是一套组合拳。
3.4 官方提升数据是怎么测的
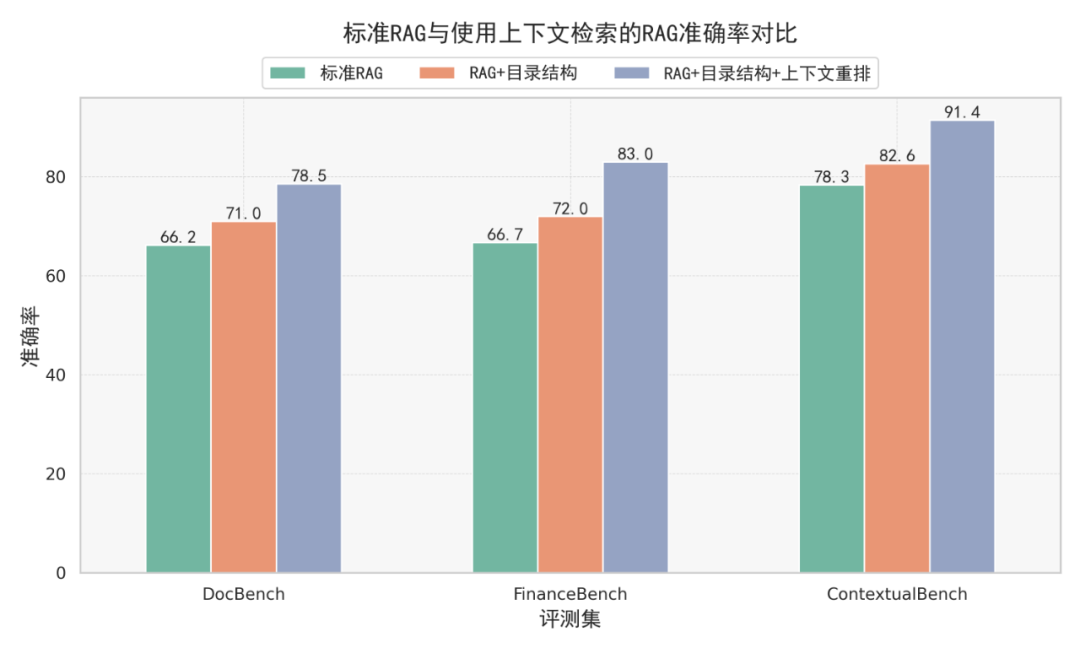
庖丁官方实验数据:评测覆盖金融、学术、政务、法律四个领域的 342 份文档、1495 个问题,用 GPT-4 按统一量规评分,并与人工评分对齐(两位标注员的一致性分别为 97% 和 94%)。结果:相比固定长度切块,目录结构分块让问答准确率平均提升 4.8 个百分点;叠加上下文重排后,提升扩大到 13.9 个百分点;在问题更复杂的金融基准 FinanceBench 上,重排的优势被进一步放大,达到 16.3 个百分点。
官方测的是体系级指标,我这次测的是单题因果链:结构题从核心块漏召回+半数噪音 ,修到块 19 第 2 名召回+回答全覆盖,再叠加重排把噪音清场。一个讲平均效果,一个讲作用机理,方向完全一致。
四、成品验证:同一份文档,交给 ChatDOC
4.1 ChatDOC:面向专业文档的问答底座
前面三节的每件修复------目录链、邻块扩展、长上下文重排------单独看都不难,难的是把它们组合成对各类文档都稳的默认能力。自建当然可行,本文的脚本就是证明;但换一批表格更多的文档、双栏排版的论文、扫描版合同,每个环节都要重新适配。成品产品的价值正在这里。
ChatDOC 庖丁解文是庖丁科技旗下的专业知识 AI 问答助手。庖丁科技在文档智能方向深耕多年,ChatDOC 可以理解为把这套家底做成了"专而深"的问答底座:不做通用闲聊,专注法规、财报、研报、论文、标准这类专业文档的问答。它的检索层恰好是本文这套思路的产品化------结构化解析识别目录与表格、切块时保留结构上下文、召回后做二次重排,答案附带划词溯源。
对这次实验来说,它是一个理想的参照答案:同一份文档、同一组问题,上下文检索做对了,体验应该长什么样。
4.2 同题对比:两道结构题的翻身仗
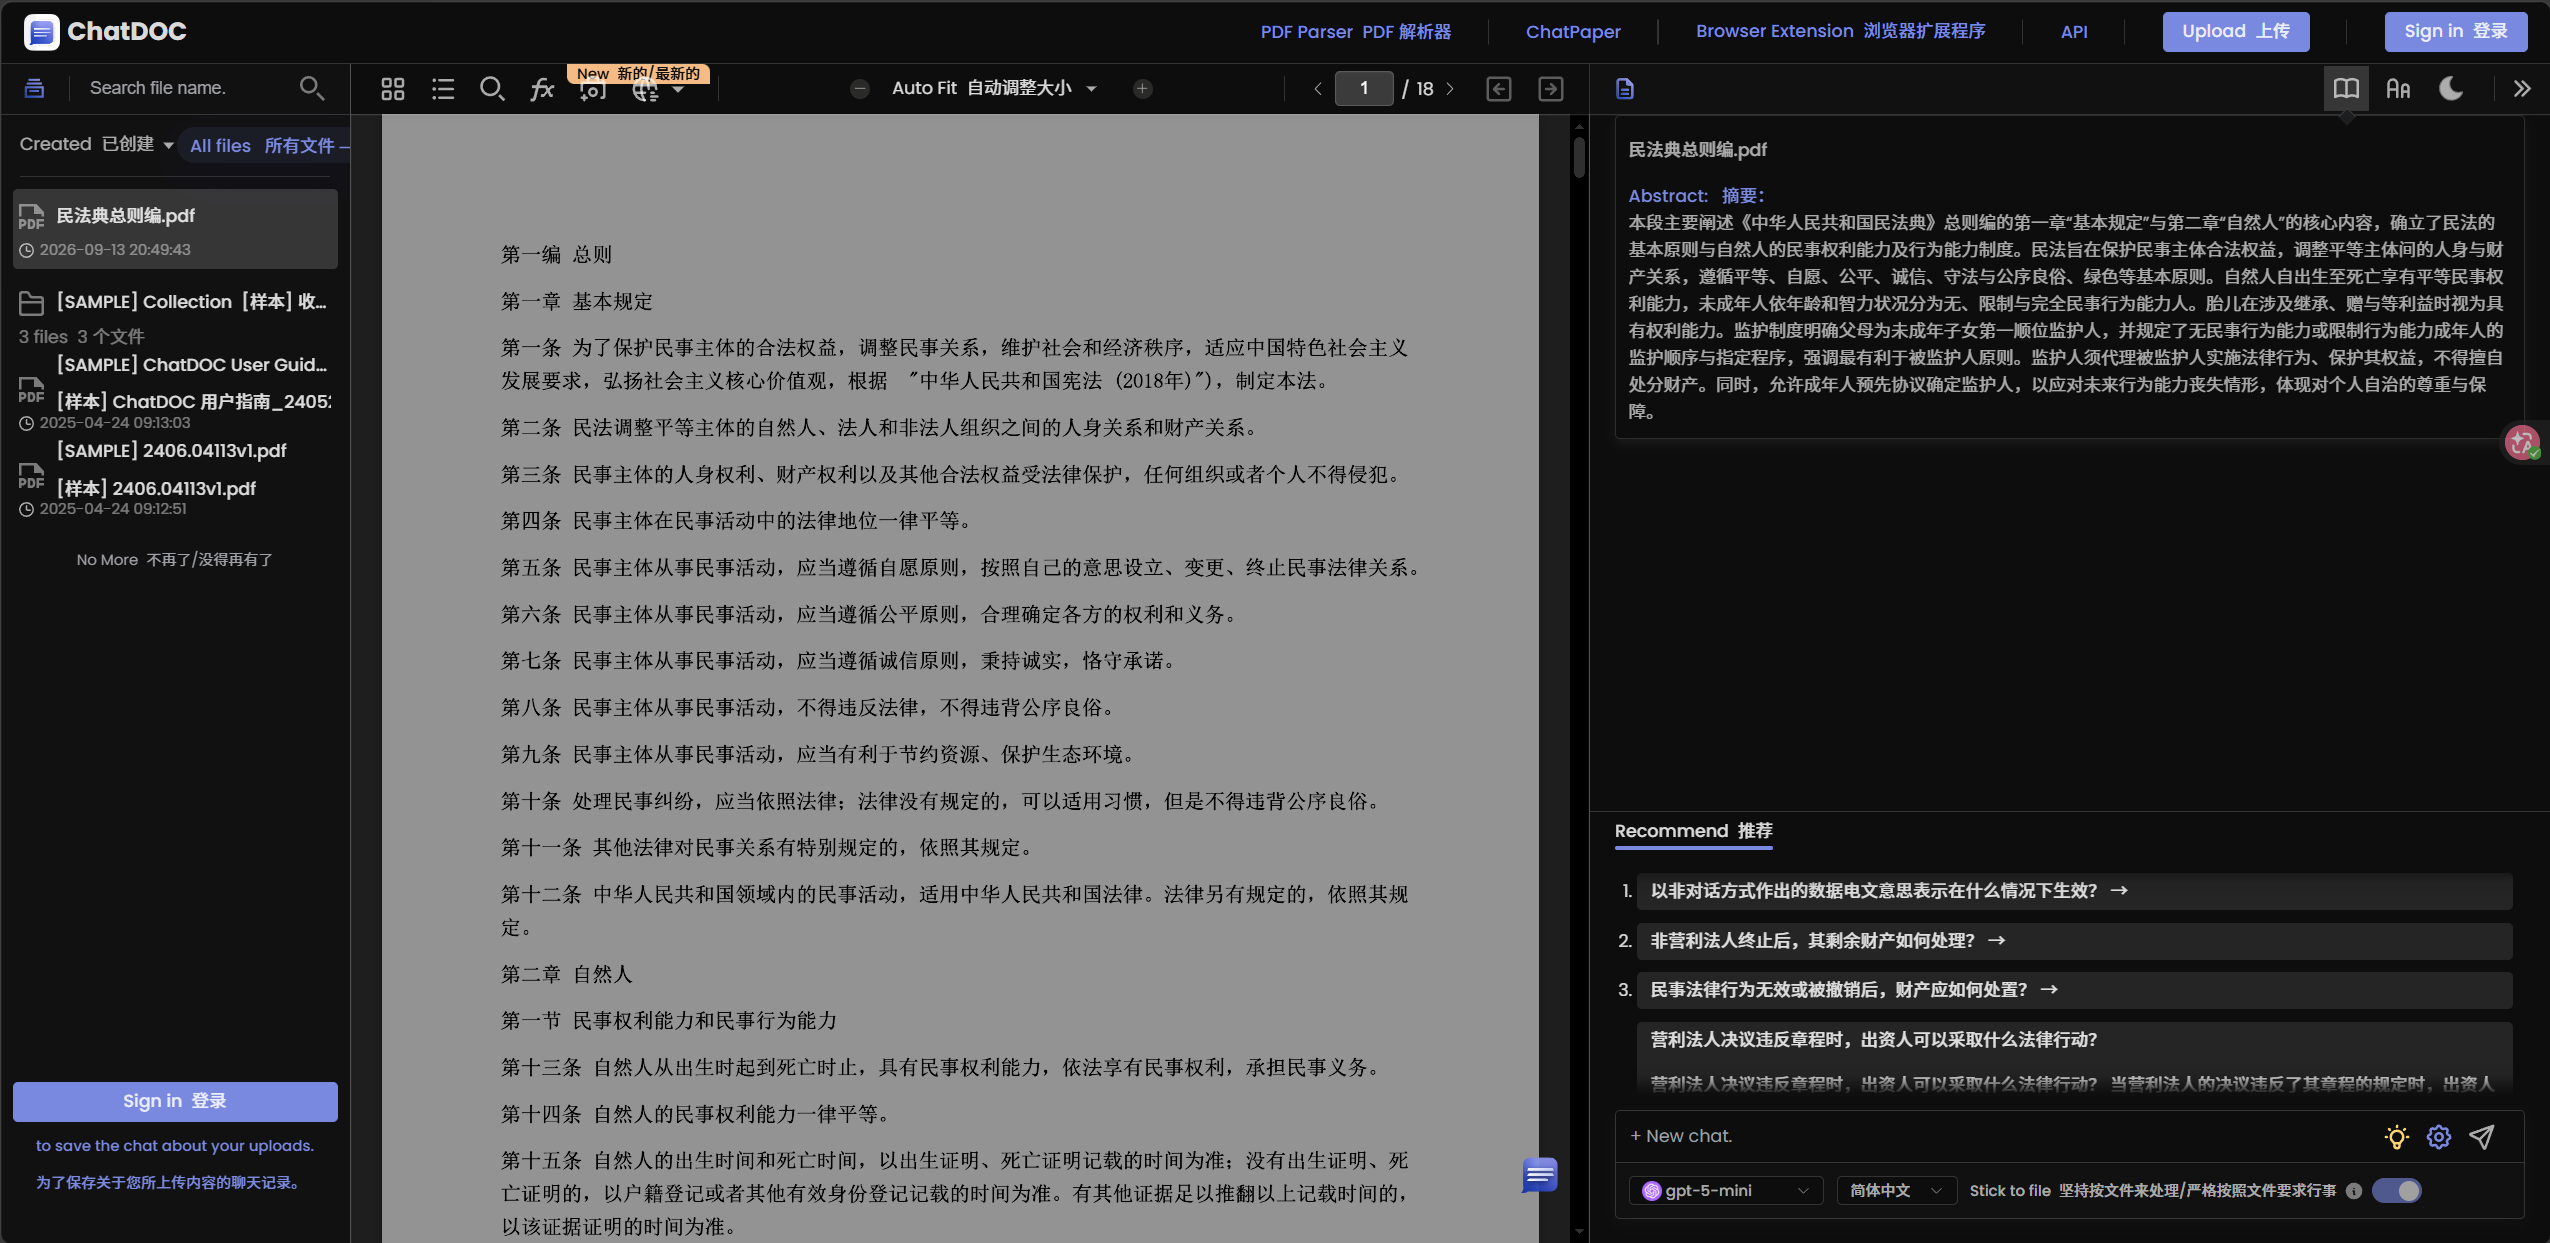
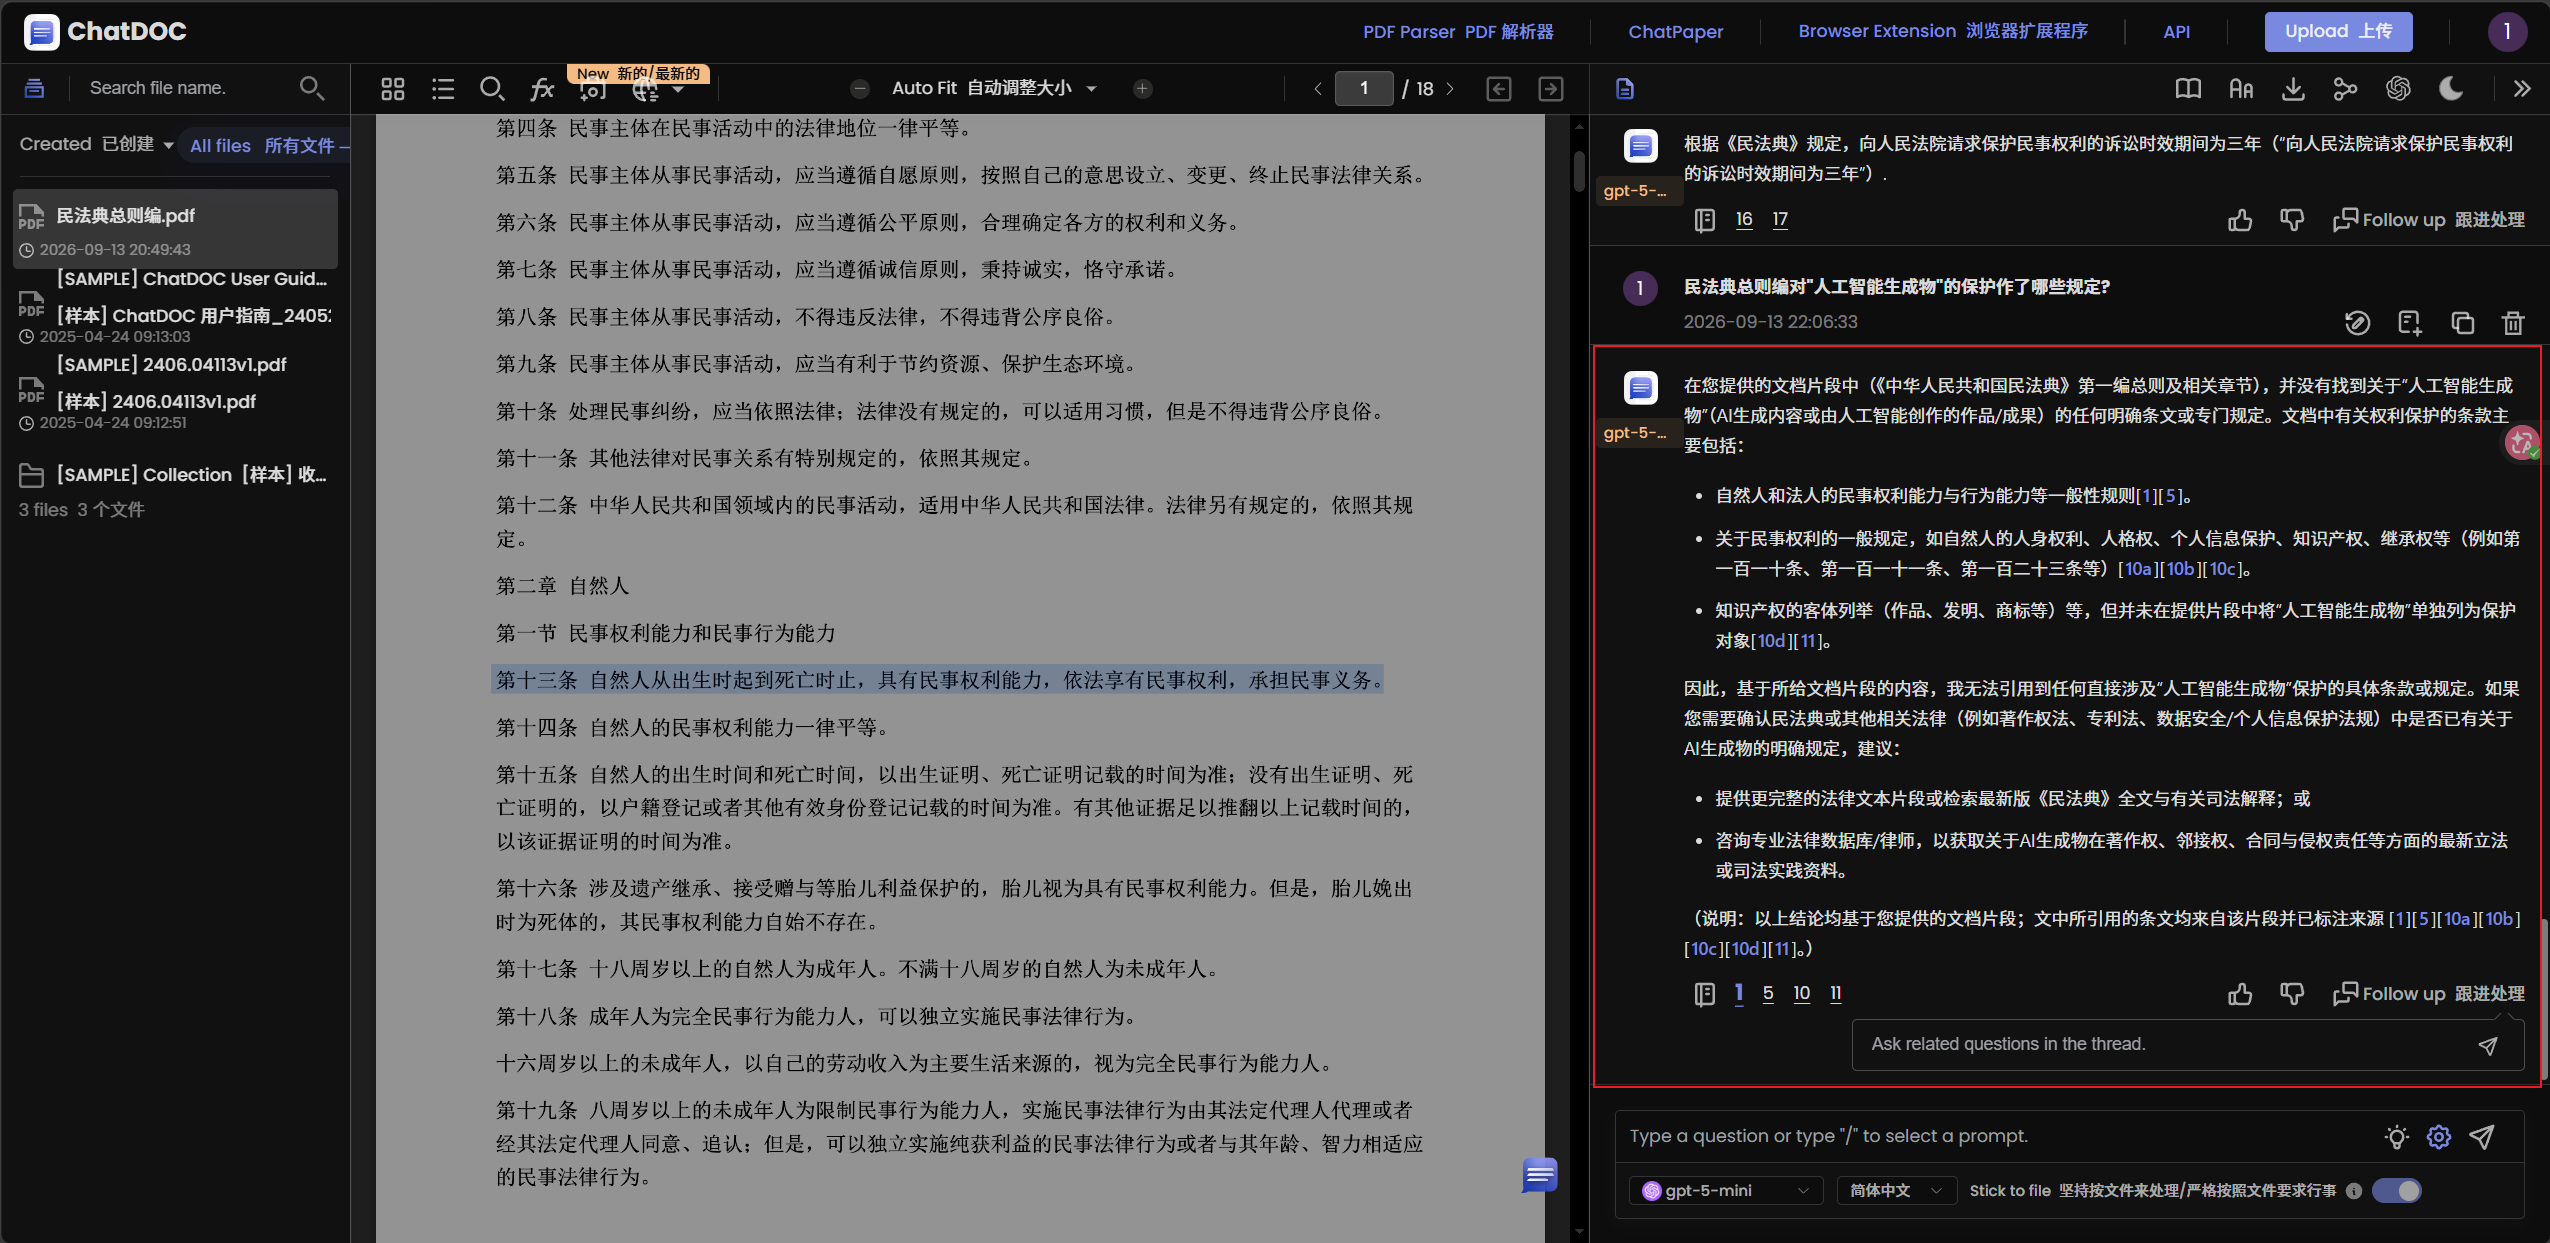
实测方式很朴素:同一份总则编 PDF(与基线完全同源,18 页)上传 ChatDOC,九个问题原题照抄。结果九问九过:
| # | 问题 | 类型 | 基线 | ChatDOC |
|---|---|---|---|---|
| Q1 | 知识产权的客体(8 项) | 列举 | ✅ | ✅ |
| Q2 | 委托代理终止情形(5 项) | 列举 | 未单测 | ✅ 给出第 173 条 |
| Q3 | 法定代理终止情形(4 项) | 列举 | 未单测 | ✅ 给出第 175 条 |
| Q4 | "前款"指的是什么规定 | 指代 | 未单测 | ✅ 准确展开第 21 条第 1 款 |
| Q5 | "前款规定的人"指哪些人 | 指代 | 未单测 | ✅ 准确展开 |
| Q6 | 总结第五章主要内容 | 结构 | ❌ | ✅ 覆盖 109~132 条,无漏无混 |
| Q7 | 第六章第三节规定了什么 | 结构 | ❌ | ✅ 准确给出效力规则,143~157 条 |
| Q8 | 诉讼时效几年 | 对照 | 未单测 | ✅ 三年 |
| Q9 | AI 生成物的规定(陷阱) | 陷阱 | 未单测 | ✅ 如实回答没有找到 |
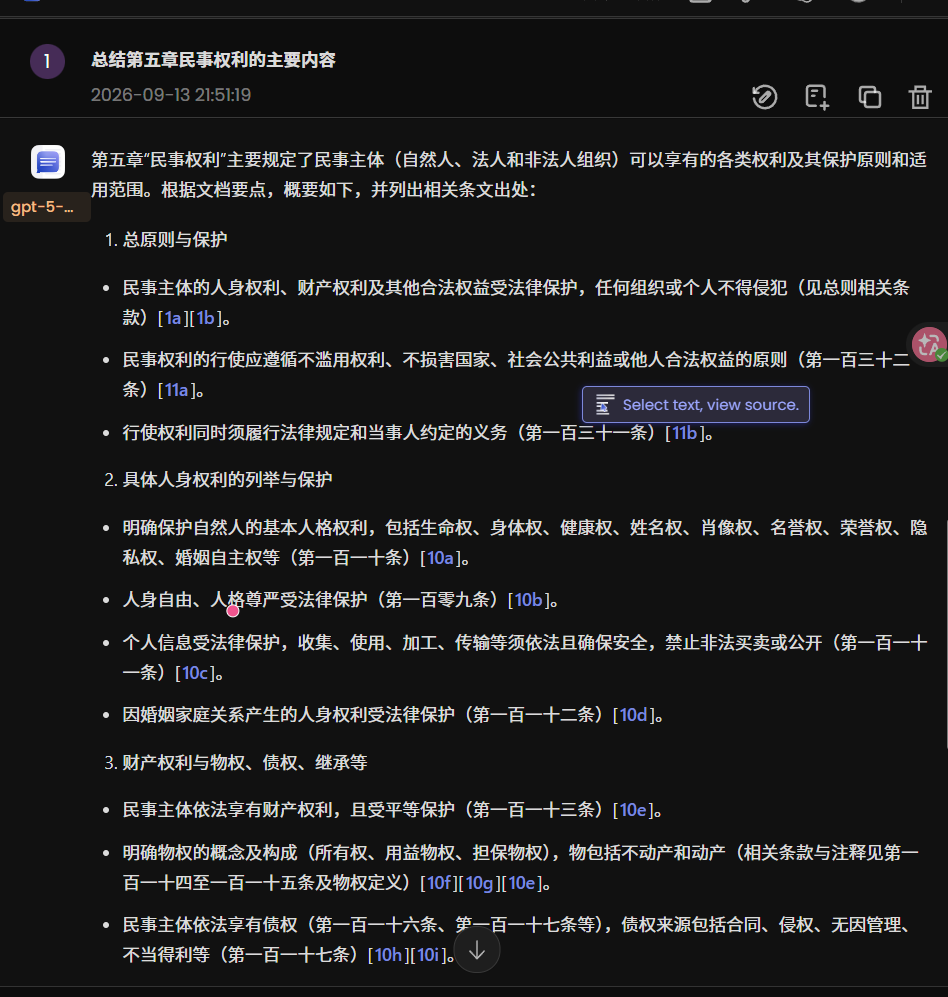
重点看三行。Q6:覆盖第 109~132 条,四大块齐全,没有漏块,也没有他章内容混入------对照基线的"块 19 漏召回+Top-5 一半噪音+回答残缺",同一道题两种命运。Q7:准确答出"第三节 民事法律行为的效力,第 143~157 条",还把有效要件、无效、可撤销、效力待定分了组------基线里这块三连全漏。Q9 陷阱题:如实说文档里没有"人工智能生成物"的规定,只指出第 127 条沾了个边(数据、网络虚拟财产),建议去著作权法等专门立法里找------没有编造条文,这个"知道自己不知道"在专业场景里比答对更值钱。
4.3 划词溯源:答案必须点得回原文
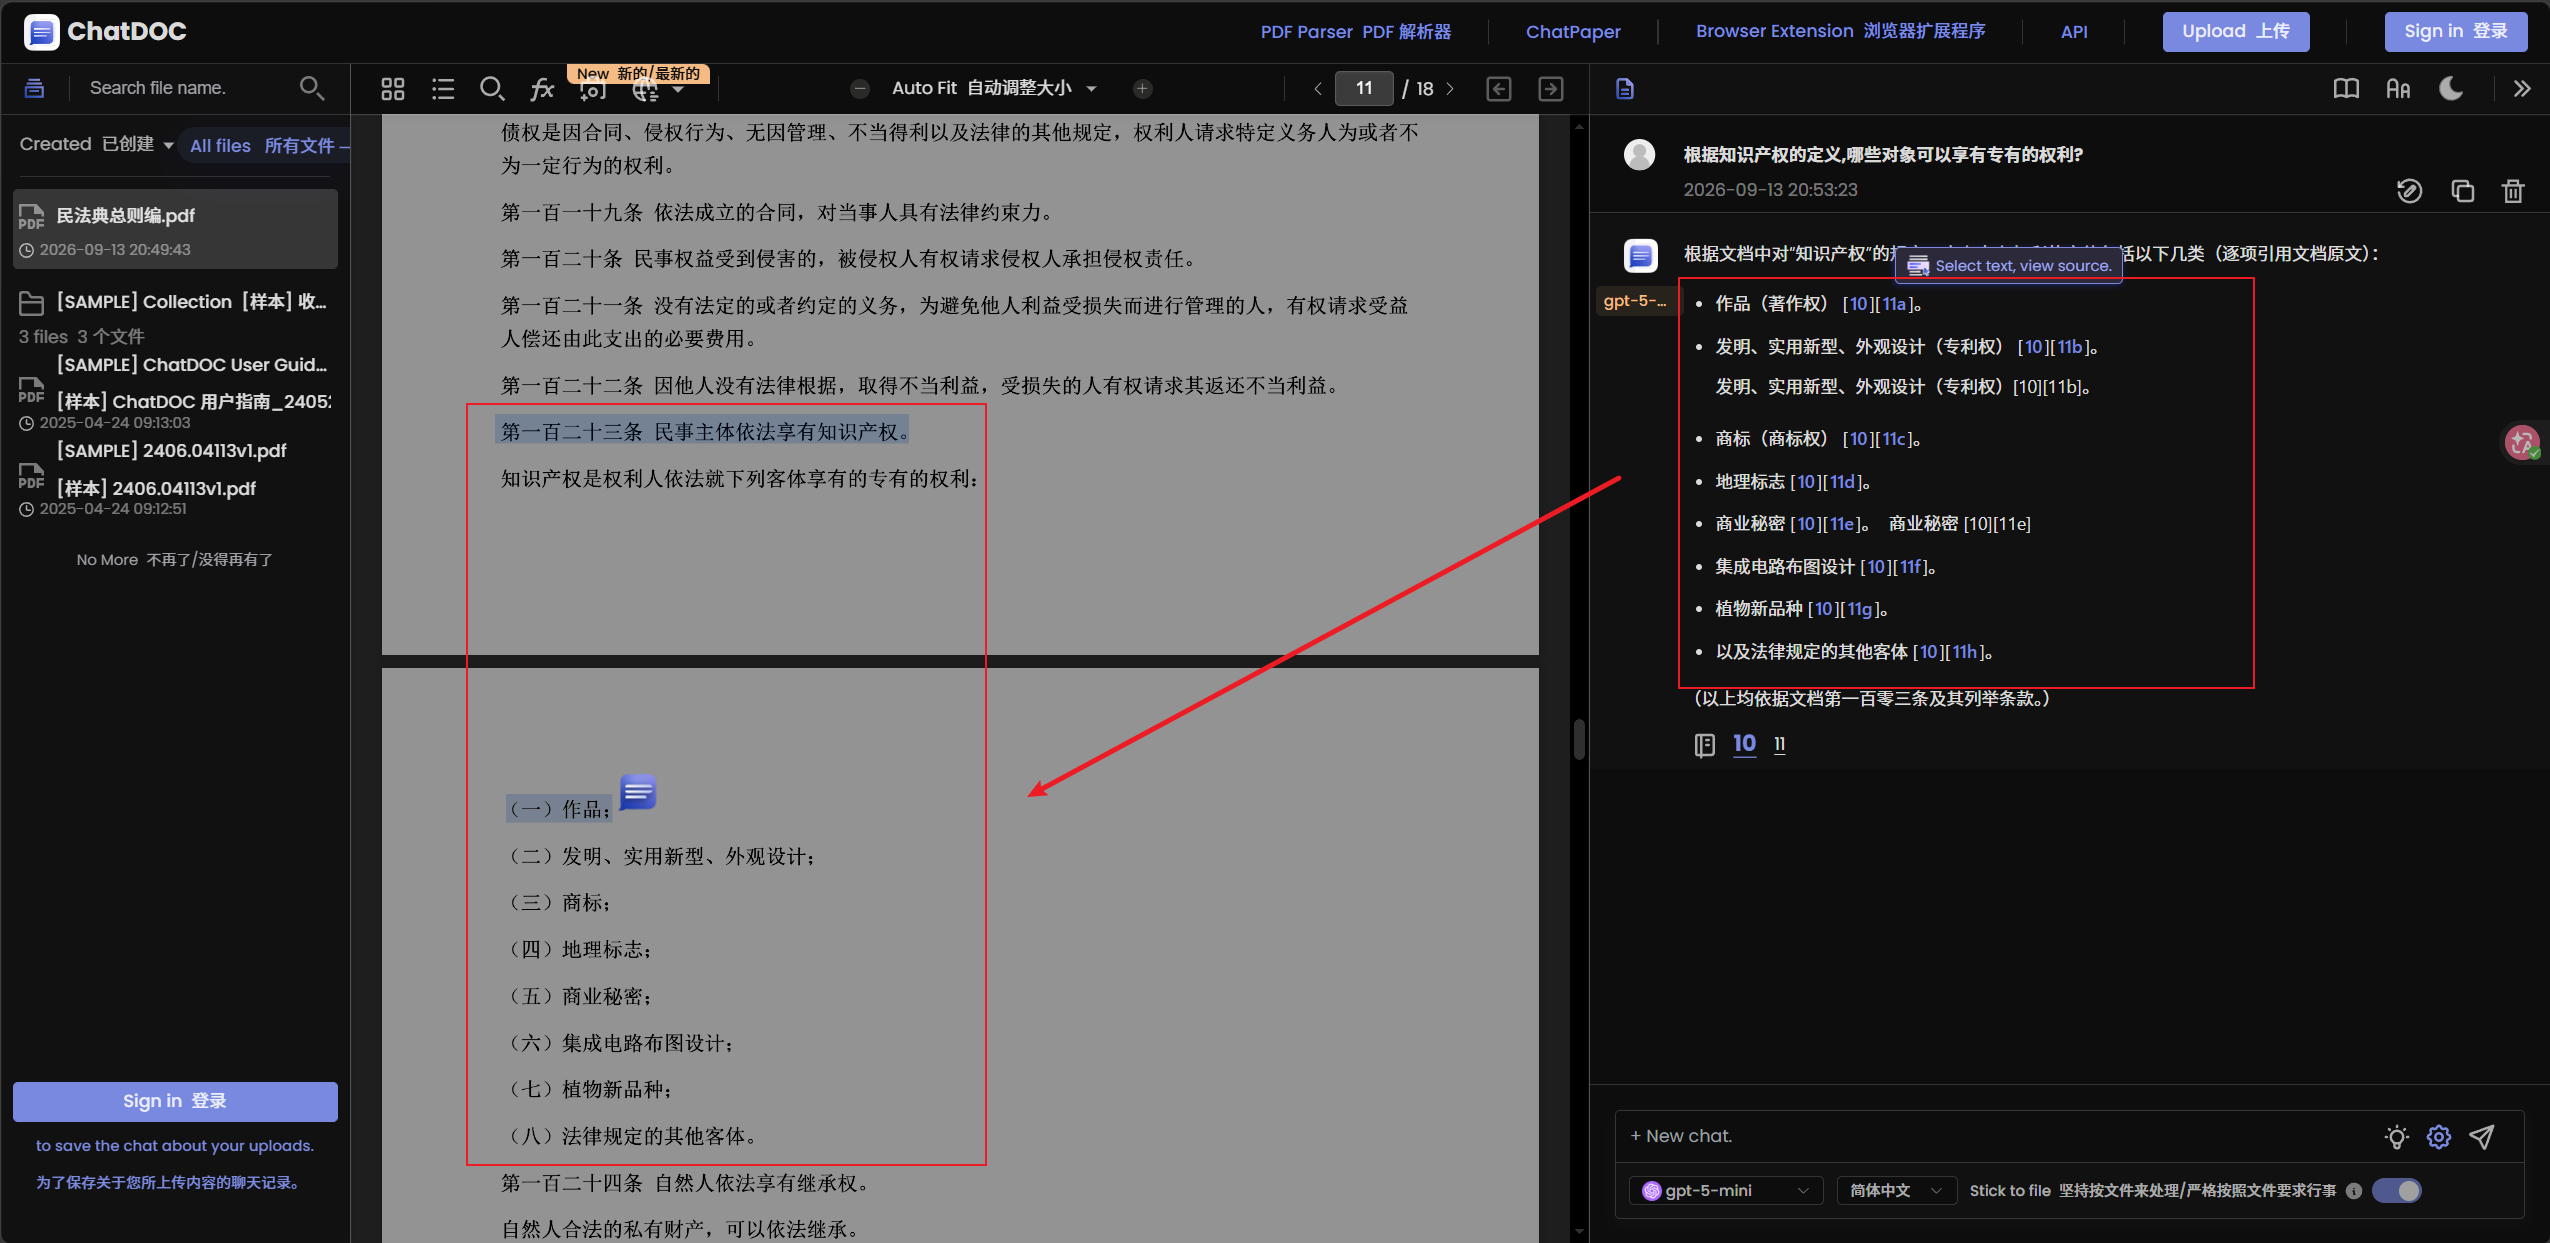
ChatDOC 的答案形态是:每个要点后带引用标注,划词高亮,点击直接跳到 PDF 原文位置,条文号也主动给出。
为什么这个形态重要?专业场景的答案不是看完就完,是要核验的。"第 123 条说了什么"最终要回到第 123 条原文确认,而不是信转述。
实测里有个小插曲,恰好给这个论点当了注脚。Q1 的答案八项全对,引用高亮也准确定位到第 123 条的列举原文;但结尾的汇总句把条文号写成了"第一百零三条"------正确是第一百二十三条,转述层的一个小瑕疵。点开溯源,高亮落的确实是第 123 条原文,内容一字不差。这个小瑕疵反而让我更确认这套交互的价值 :判断答案的最终依据是"能不能点回原文",而不是模型嘴里的编号。溯源通道在,转述错了当场就能抓住;没有溯源,错编号会一路带进结论里。
4.4 试用与接入
ChatDOC 网页端开箱即用,上传文档就能提问,本文九个问题用免费额度就能全部复现。适合的读者画像很具体:法务与合规团队查法规合同、金融研究员翻财报和募集说明书、咨询与研究岗位对付长报告和论文。团队场景有企业版,也提供 API,可以把这套带溯源的检索问答接进自己的系统。
**一个建议:**拿你手头的私有文档去试。公开文档有模型记忆兜底,损伤会被掩盖;私有文档没有这层运气,才是检验上下文检索成色的照妖镜。
五、实践方案:切分质量自查清单
前四节把因果链走完了,落回多数读者的处境:手边已经有一个知识库,答不全的问题时有时无,不知道病根在哪。其实不用大动干戈,先做个体检。下面这份清单不需要改架构,拿现成的库就能跑:切块结果导出来、检索接口开着,对照检查即可。每一条都对应前文的一种损伤或一件武器,查出来缺什么,处方就在右边一栏。
| 序号 | 检查项 | 怎么做 | 对应问题 |
|---|---|---|---|
| 1 | 抽块验身份 | 随机抽 10 个块,遮住来源问同事"这是哪一章的内容",答不上来的块,embedding 一样懵 | 身份不明 → 目录链前置 |
| 2 | 长列表与表格 | 检查是否被拦腰切断;切断后两半能否独立命中 | 语义缺失 |
| 3 | 指代同块 | 扫"前款/上述/该方/本条"类词,确认指代与被指内容未被切开 | 语义歧义 |
| 4 | 结构题自测 | 挑 3 个"总结第 X 章"式问题,人工核对核心块是否被召回、Top-k 有无他章噪音 | 结构丢失 |
| 5 | 邻块扩展 | Overlap 或邻块扩展开了没有------它决定重排的上限 | 召回范围 |
| 6 | 重排在不在 | 候选池交给大模型整体判分,噪音应被打到接近零分 | 排序质量 |
选知识库或 RAG 产品时,同样四问:解析能不能识别目录结构、还原表格;切分是固定长度一刀切,还是结构感知+Overlap;检索有没有上下文增强与二次重排;答案能不能高亮溯源回原文。四个问题对应本文的全部分析。
自建还是用成品?自建可控、可深度调优,代价是上面每一步都要自己做且做对;成品(如 ChatDOC)把这些工程决策做成了默认值。我的建议:先用自建基线把问题复现一遍,搞清楚每段链路的因果,再决定哪一段自己握着、哪一段交给产品。
六、总结:检索的上限,在切块时就定了
这次实测下来,最深的体会是:
检索的上限不是 embedding 决定的,是切分决定的。向量化是单行道,块里没有的上下文,召回和重排都变不出来。
三种损伤里,语义缺失靠 embedding 容错、语义歧义靠模型记忆兜底------但这两个"兜底"在私有文档上都会失效;结构丢失则不靠运气,结构题一问一个准,最先在真实使用中暴露。修复是一套组合拳:目录链前置管"块的身份",决定哪些块能被召回;邻块扩展把该来的块送进候选池;长上下文重排管"快的相关性",决定最终排序。官方 13.9% 的体系级提升,就是这套组合拳的累计效果。
往上一层看,智能体负责问,检索层负责找得全;找不全,再强的生成模型也只能就着残缺的素材编故事。所谓上下文检索,说穿了就是一句话:让每个块带着自己的出身去找工作,而不是赤条条地被向量打量。
下次知识库答不全,先别急着换 embedding------随机抽两个块出来,看看它的身份证还在不在。