文章目录
- [1. Ubuntu22.04 安装在RTX5090机子上各种问题汇总](#1. Ubuntu22.04 安装在RTX5090机子上各种问题汇总)
-
- [1.1 解决安装时黑屏问题](#1.1 解决安装时黑屏问题)
- [1.2 各类分区大小分配](#1.2 各类分区大小分配)
- [1.3 解决GRUB错误](#1.3 解决GRUB错误)
- [1.4 禁用 nouveau及安装显卡驱动](#1.4 禁用 nouveau及安装显卡驱动)
- [2. 安装显卡驱动](#2. 安装显卡驱动)
-
- [2.1 查看当前显卡驱动适合哪个版本的官方驱动](#2.1 查看当前显卡驱动适合哪个版本的官方驱动)
- [2.2 apt install 安装显卡驱动](#2.2 apt install 安装显卡驱动)
- [2.3 配置 GRUB 参数(防止重启黑屏)](#2.3 配置 GRUB 参数(防止重启黑屏))
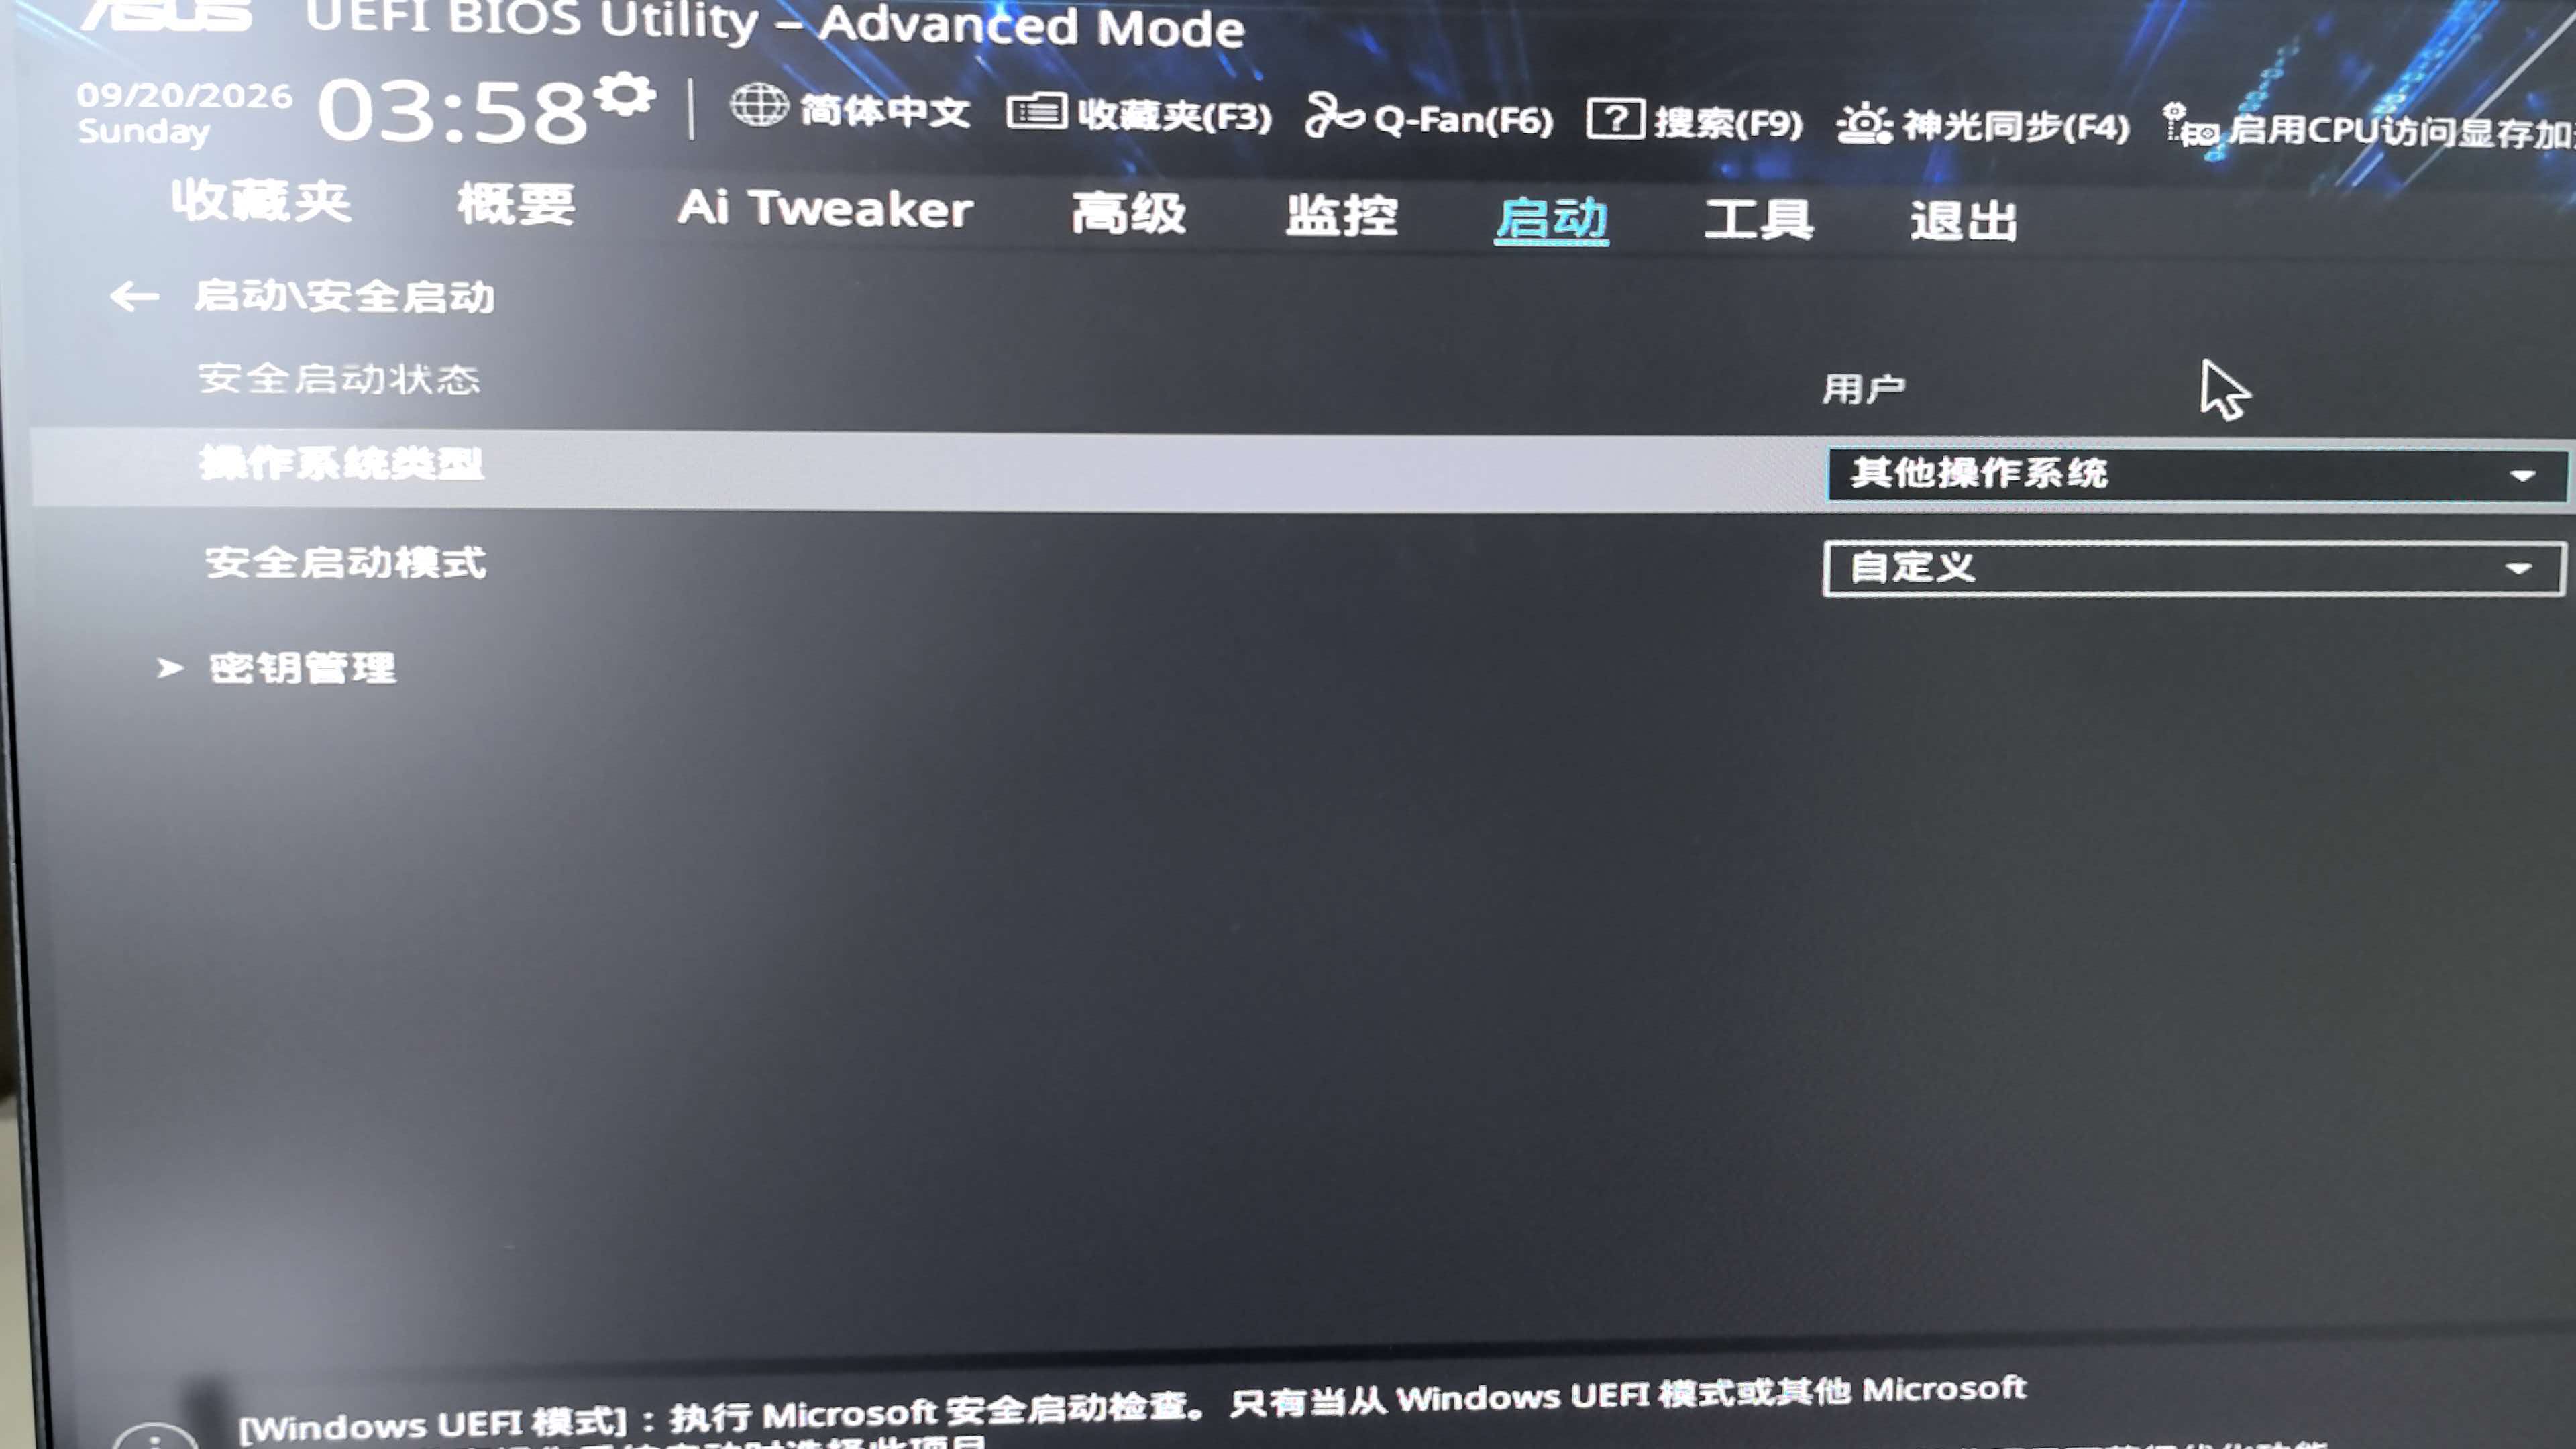
- [2.4 重启时再次确认BIOS 中必须关闭 Secure Boot](#2.4 重启时再次确认BIOS 中必须关闭 Secure Boot)
- [3. ubuntu系统设置和基础深度学习开发环境部署](#3. ubuntu系统设置和基础深度学习开发环境部署)
-
- [3.1 conda虚拟环境中的依赖库安装命令](#3.1 conda虚拟环境中的依赖库安装命令)
- [3.2 搜狗拼音输入法能输入中文标点但无法输入汉字](#3.2 搜狗拼音输入法能输入中文标点但无法输入汉字)
- [4. 模型下载与部署](#4. 模型下载与部署)
-
- [4.1 DeepSeek-R1-Distill-Qwen-14模型下载](#4.1 DeepSeek-R1-Distill-Qwen-14模型下载)
- [4.2 后台管理ollama提取模型](#4.2 后台管理ollama提取模型)
- [4.3 配置ollama环境变量(重要)](#4.3 配置ollama环境变量(重要))
- [5. 前端web交互ollamawebui](#5. 前端web交互ollamawebui)
-
- [5.1 安装ollamawebui](#5.1 安装ollamawebui)
- [5.2 配置 Ollama 服务地址(IP)](#5.2 配置 Ollama 服务地址(IP))
- [5.3 调用本地 JS/CSS 文件](#5.3 调用本地 JS/CSS 文件)
- [5.4 启动web服务](#5.4 启动web服务)
- [5.5 修改界面](#5.5 修改界面)
- [5.6 解决前端偶发死循环和思考过程与正式回答无法区分问题](#5.6 解决前端偶发死循环和思考过程与正式回答无法区分问题)
- [6. deepseek训练数据集的制作](#6. deepseek训练数据集的制作)
-
- [6.1 训练数据预处理](#6.1 训练数据预处理)
- [6.2 一问一答训练数据的生成](#6.2 一问一答训练数据的生成)
- [6.3 连续问答训练数据的生成](#6.3 连续问答训练数据的生成)
- [6.4 合并所有训练数据](#6.4 合并所有训练数据)
- [7. 训练模型](#7. 训练模型)
- [8. 在不合并模型的情况下先测试训练后的模型权重](#8. 在不合并模型的情况下先测试训练后的模型权重)
- [9. 合并原始模型与训练后的模型权重](#9. 合并原始模型与训练后的模型权重)
- [10. 合并后的模型被ollama提取](#10. 合并后的模型被ollama提取)
-
- [10.1 Modelfile文件添加模板等参数](#10.1 Modelfile文件添加模板等参数)
- [10.2 强制ollama使用自定义模板](#10.2 强制ollama使用自定义模板)
- [10.3 使用原始模型的配置文件](#10.3 使用原始模型的配置文件)
- [10.4 最后再用ollama提取模型](#10.4 最后再用ollama提取模型)
- [11. 其他常用命令如下](#11. 其他常用命令如下)
1. Ubuntu22.04 安装在RTX5090机子上各种问题汇总
1.1 解决安装时黑屏问题
(1) 制作ubuntu22.04启动优盘后进入启动界面,选项选择第一个但不要进去。
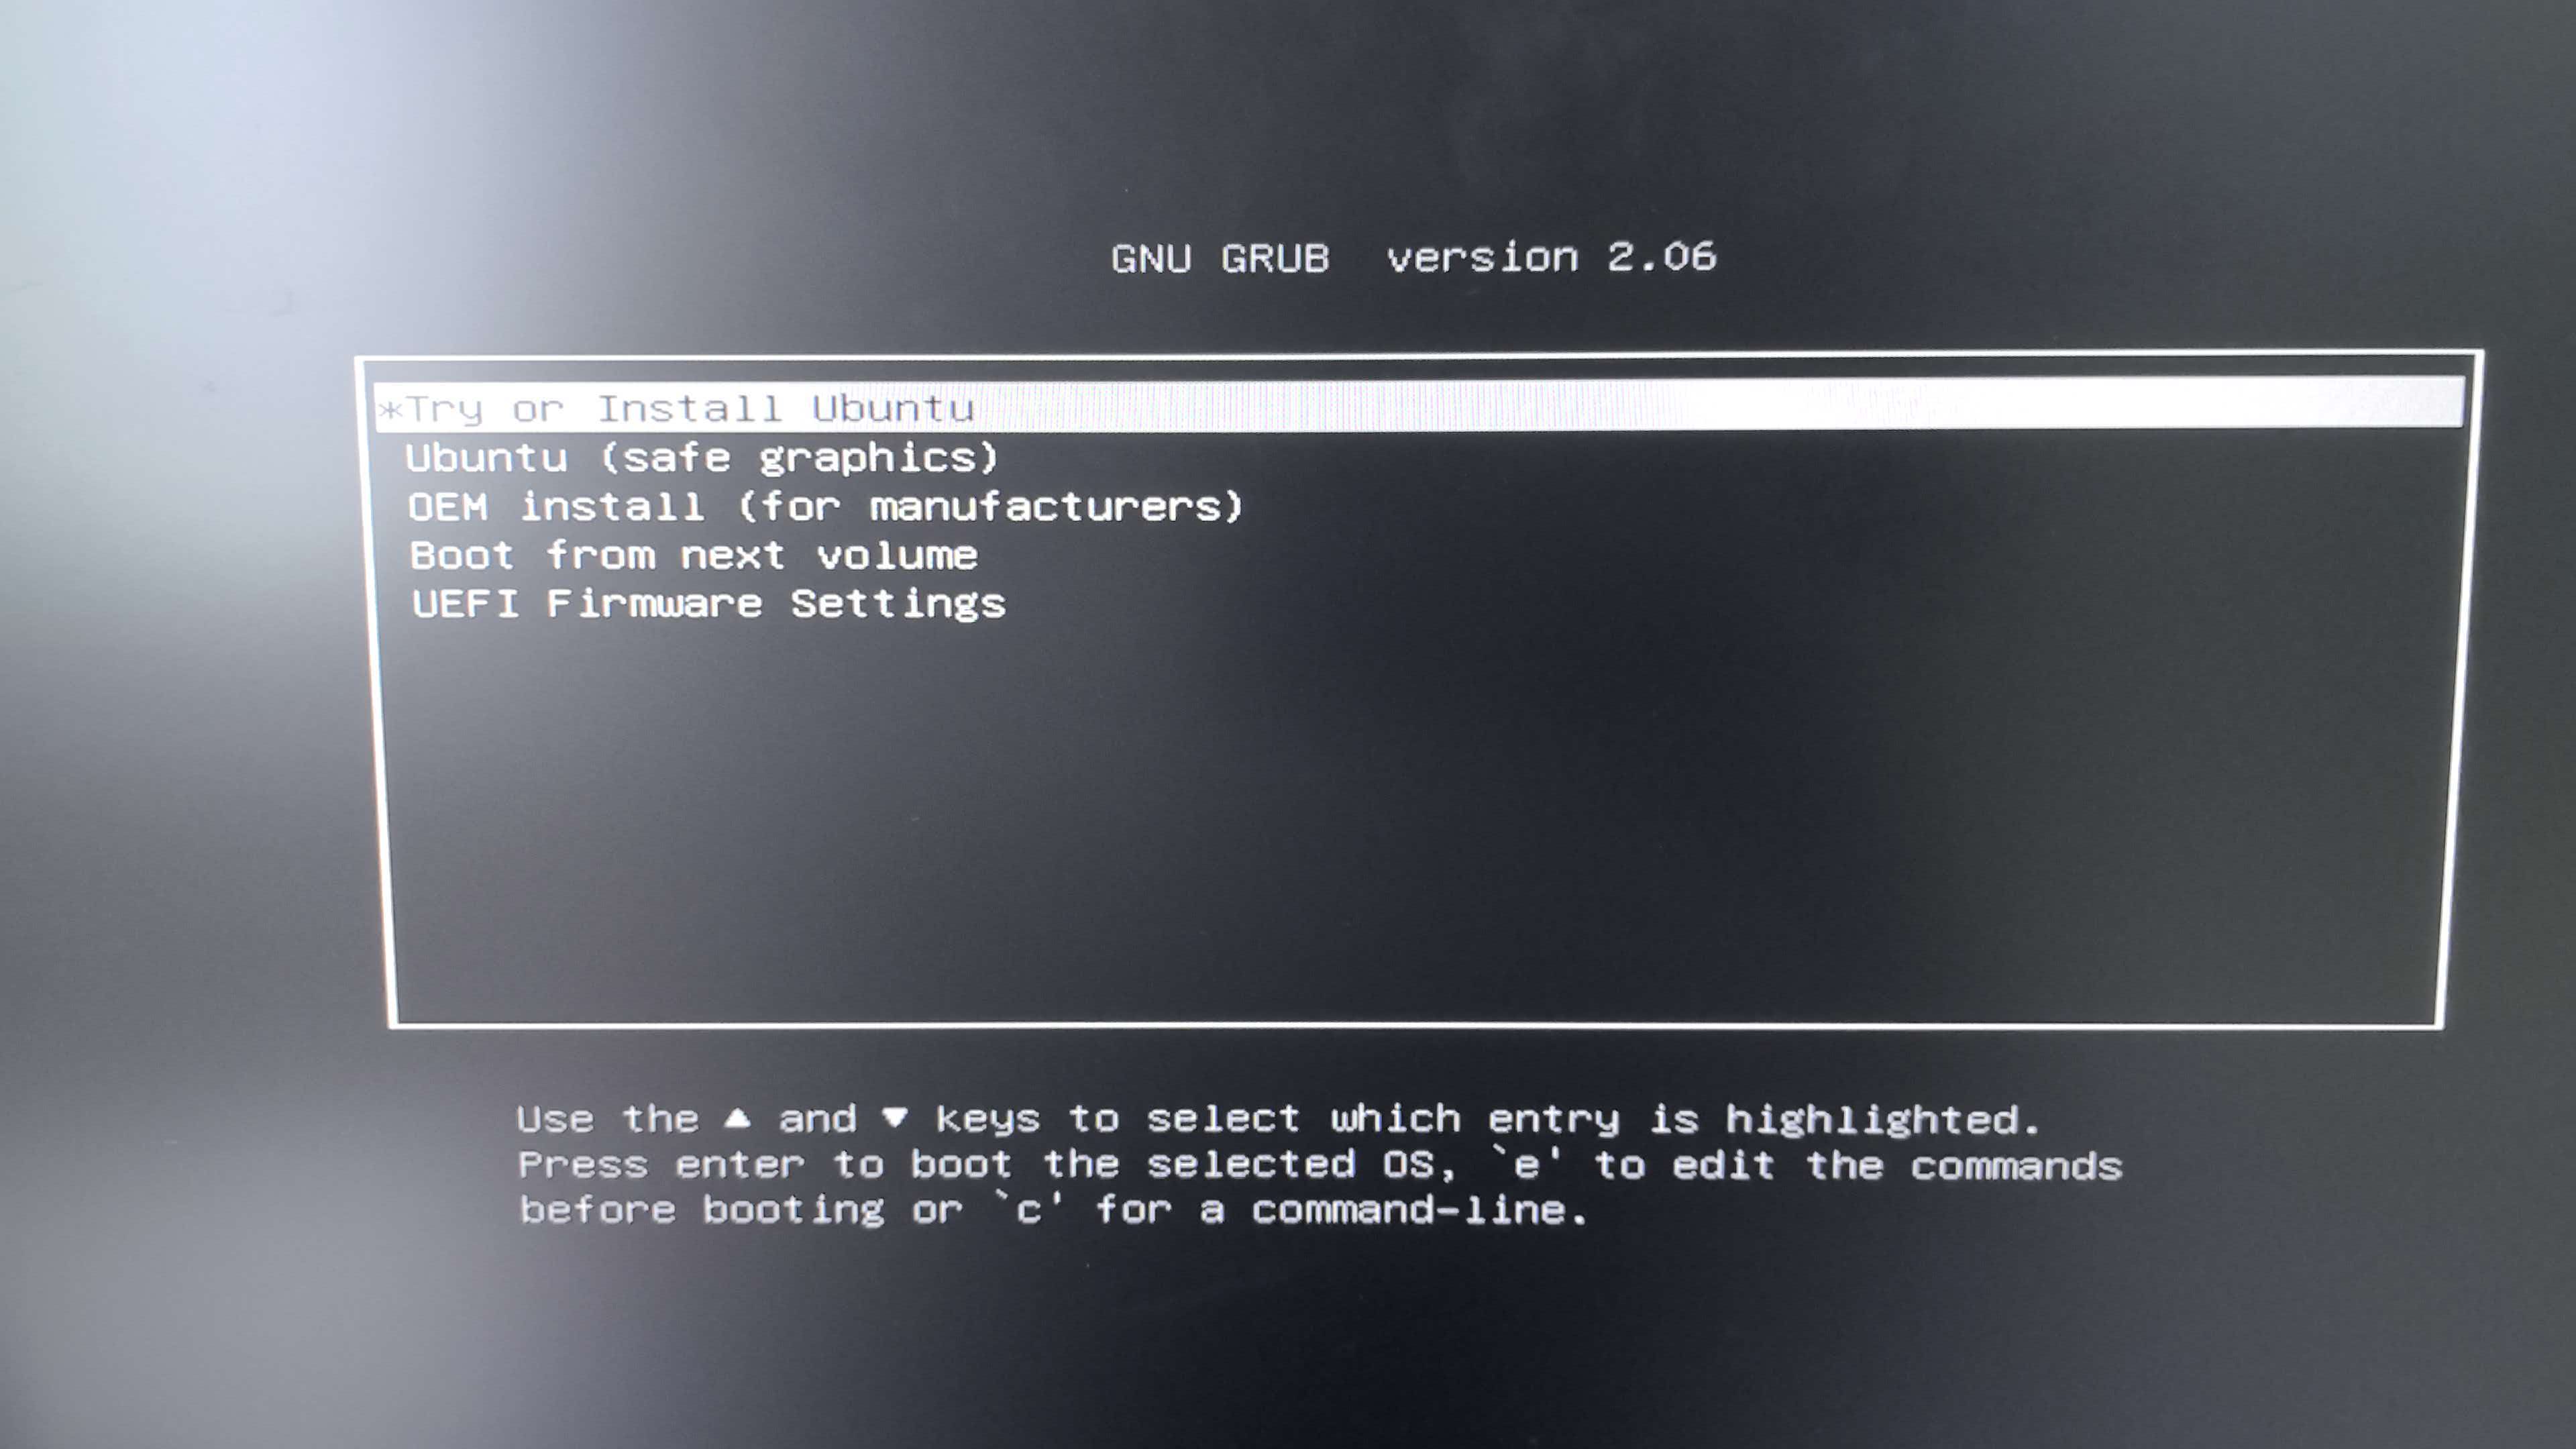
(2)键盘按"e"键,进入编辑模型。
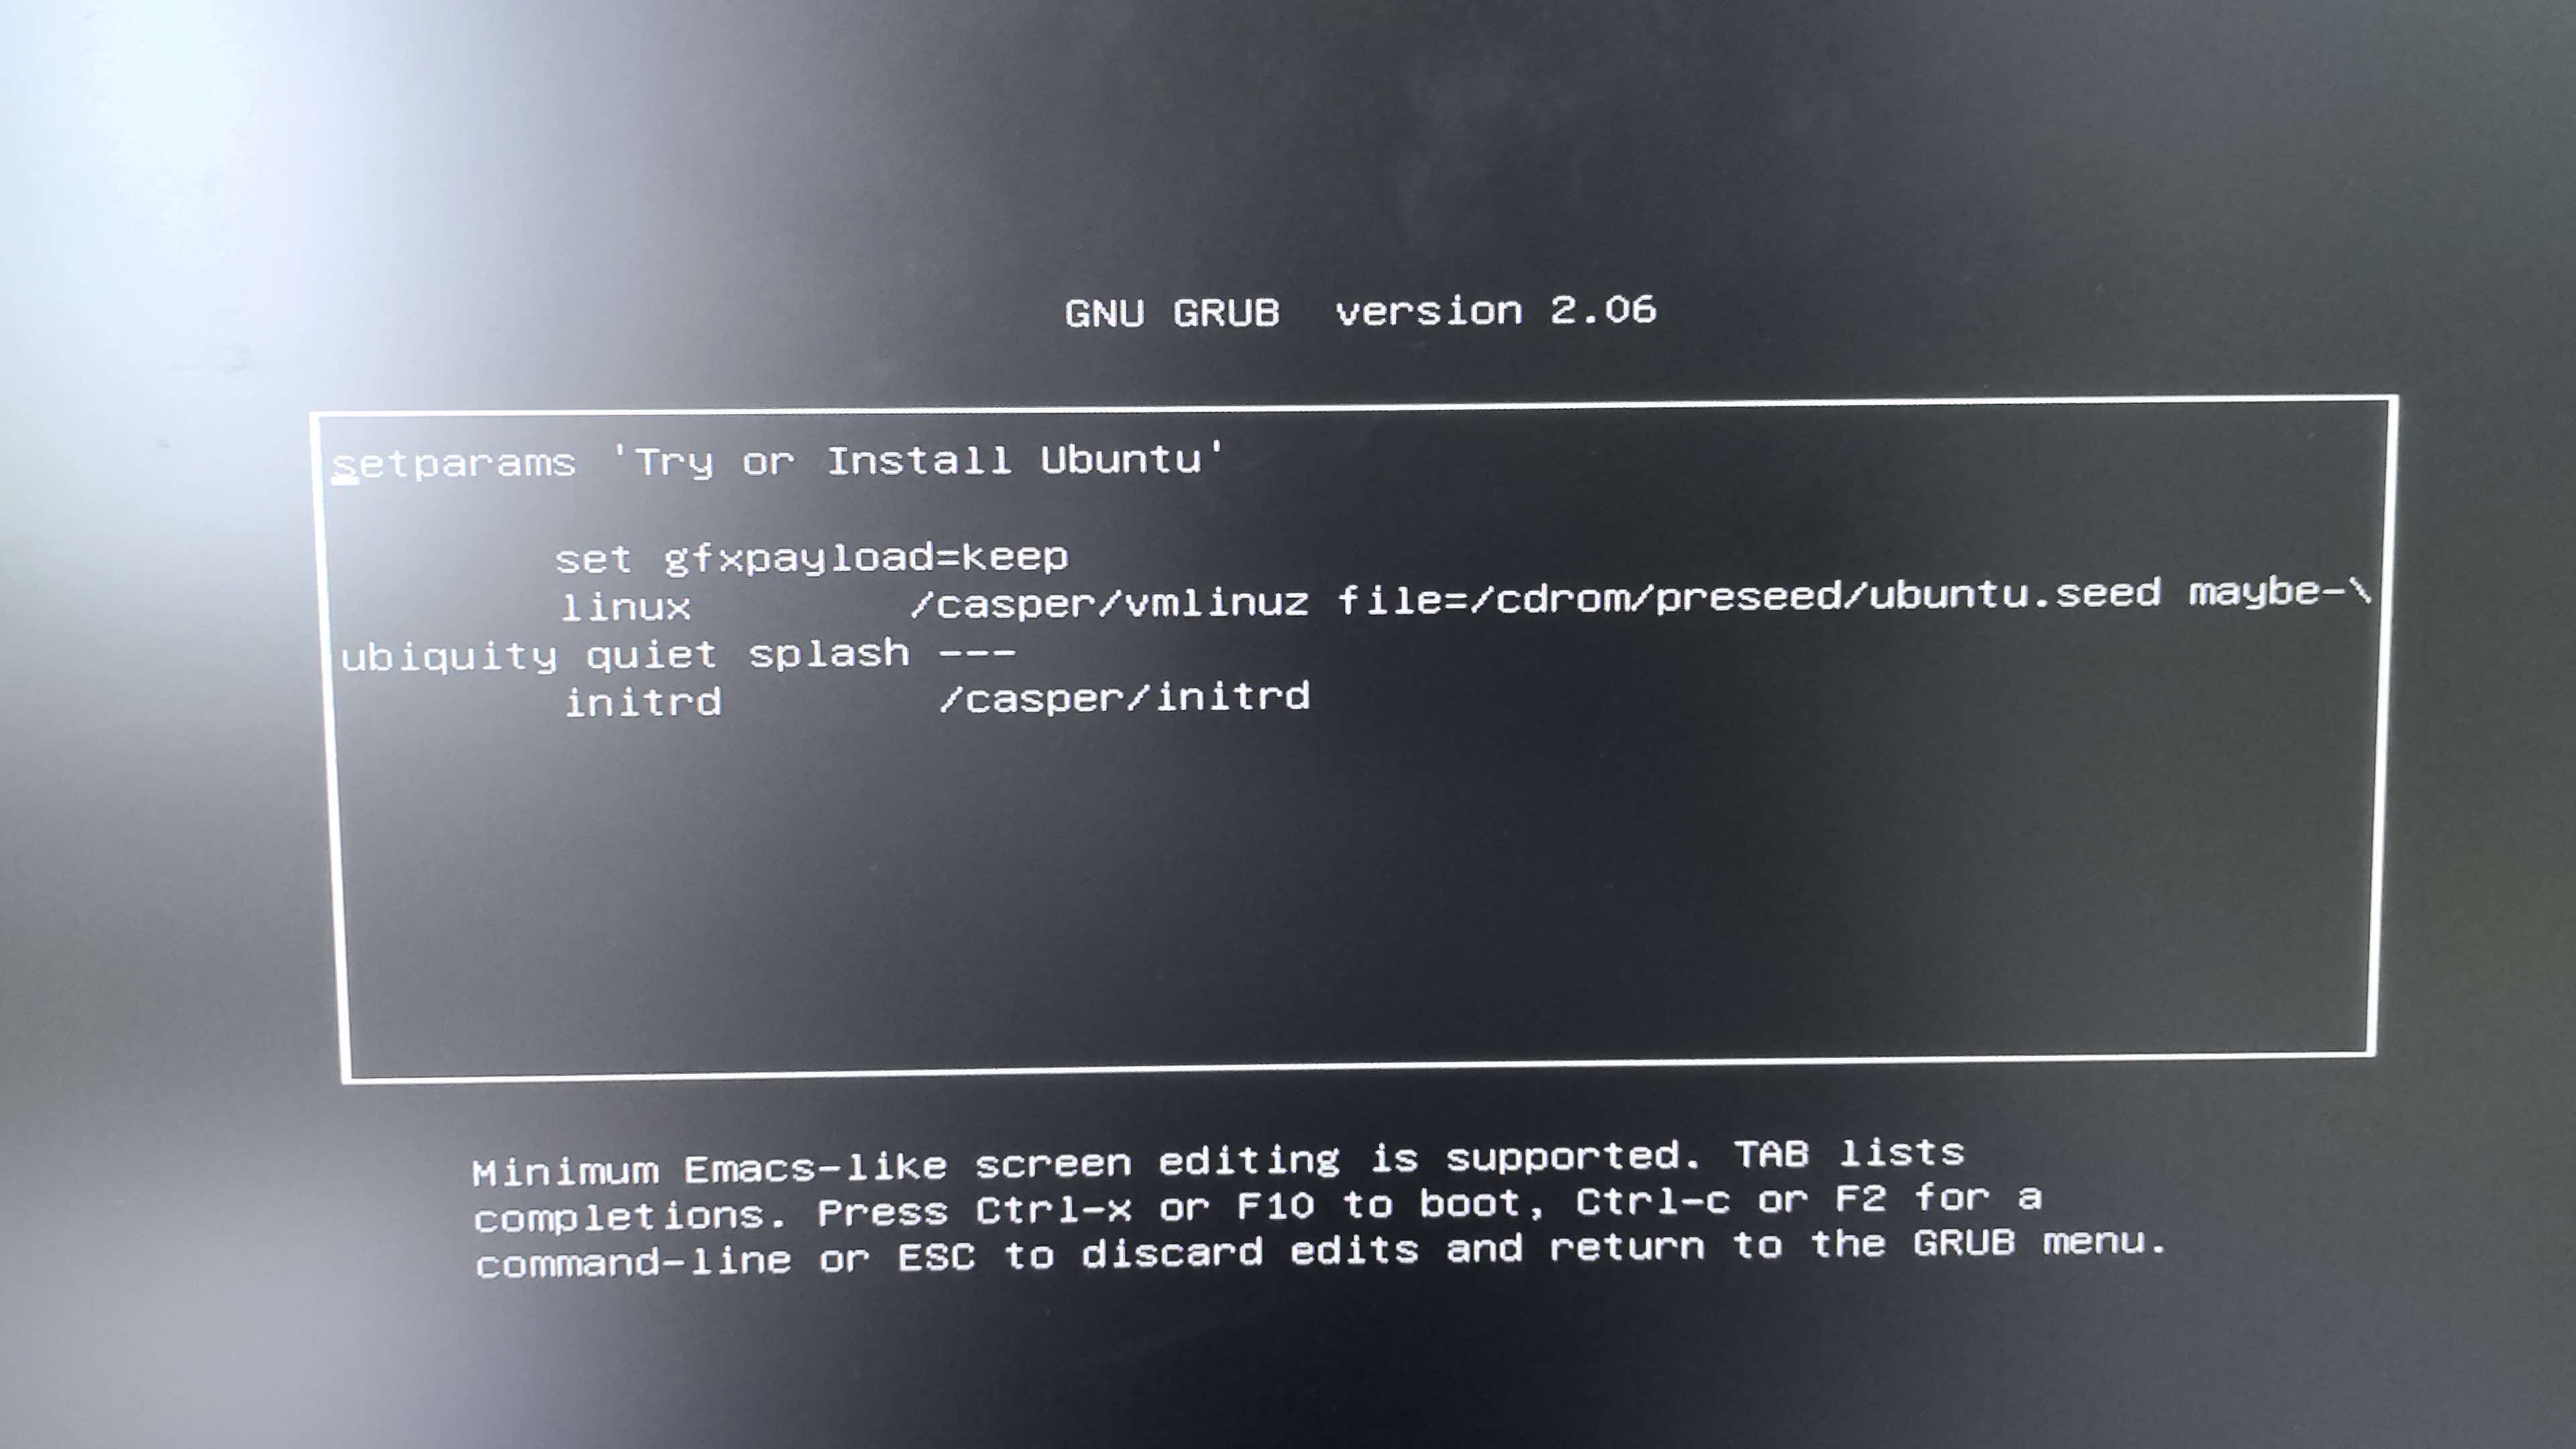
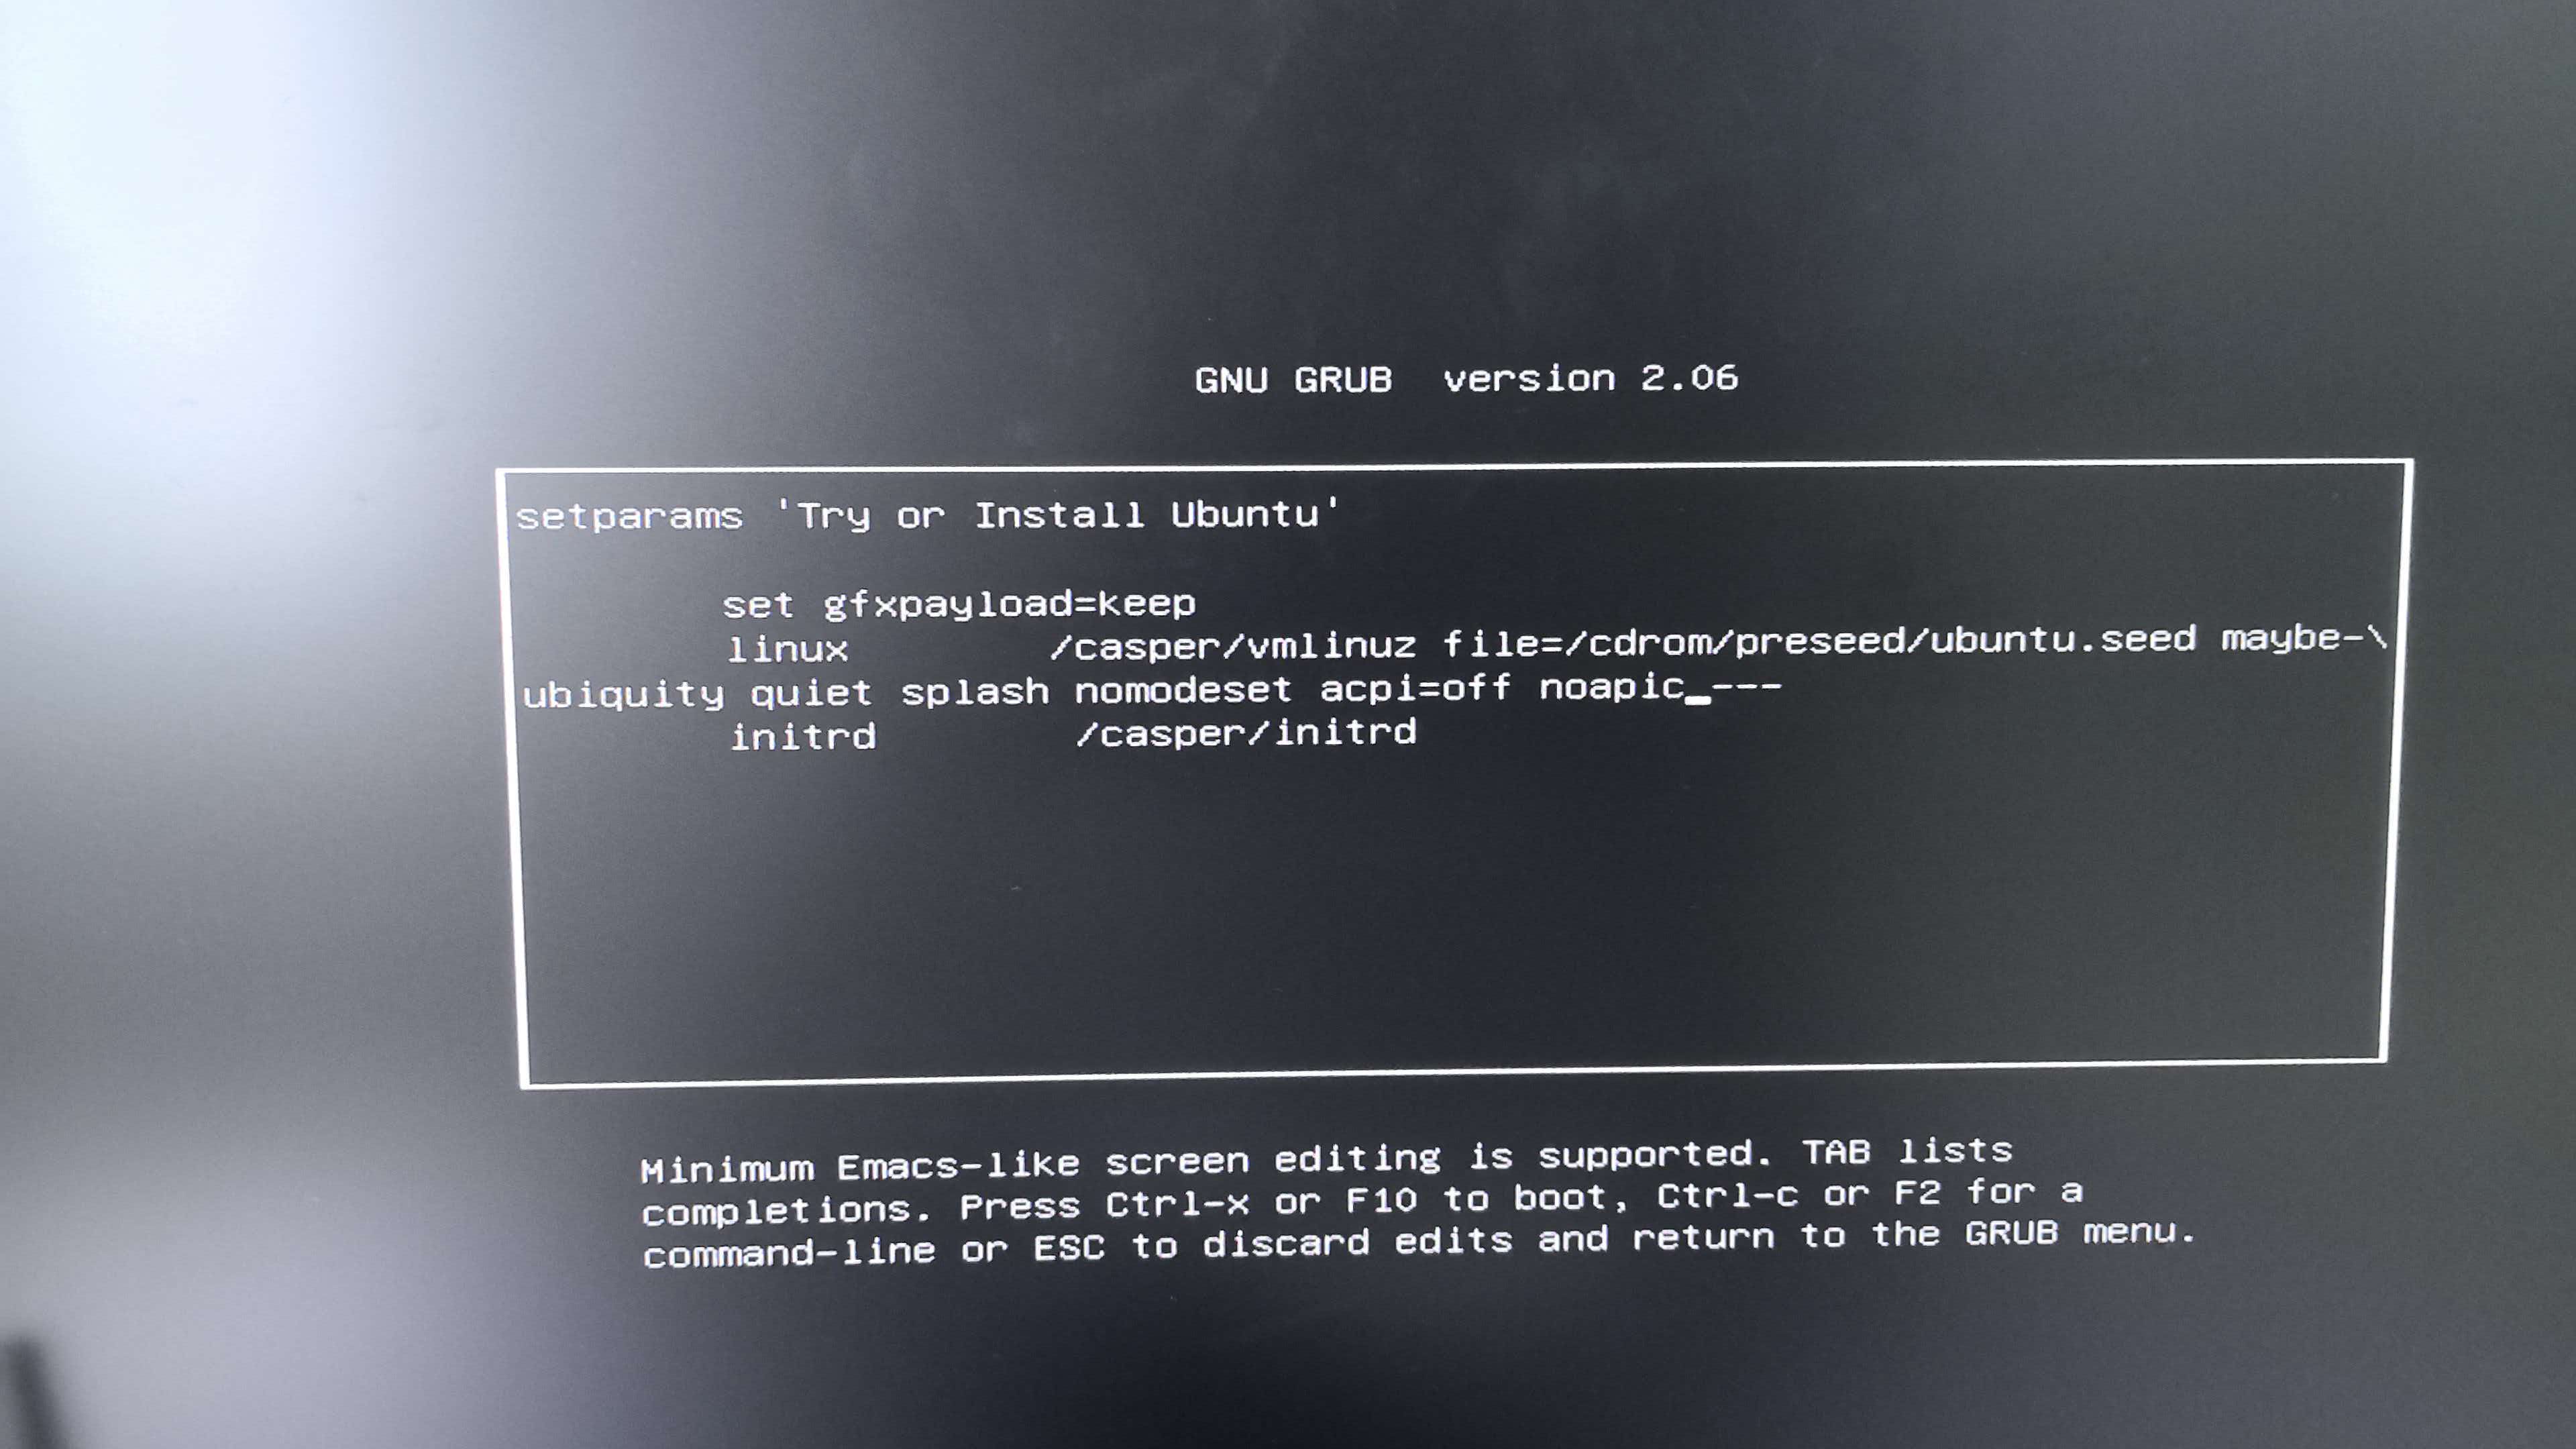
(3) 在原文"splash"后面添加 nomodeset acpi=off noapic,然后按F10。
(4)在如下界面耐心等待几秒后成功进入ubuntu22.04安装界面。
1.2 各类分区大小分配
(5)这里一定要记录下各个分区号,我的各盘分区如下图所示。
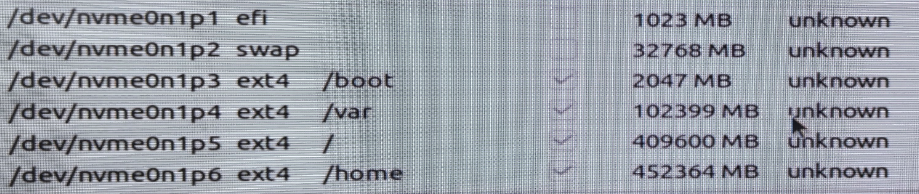
安装时不要勾选安装第三方驱动。
1.3 解决GRUB错误
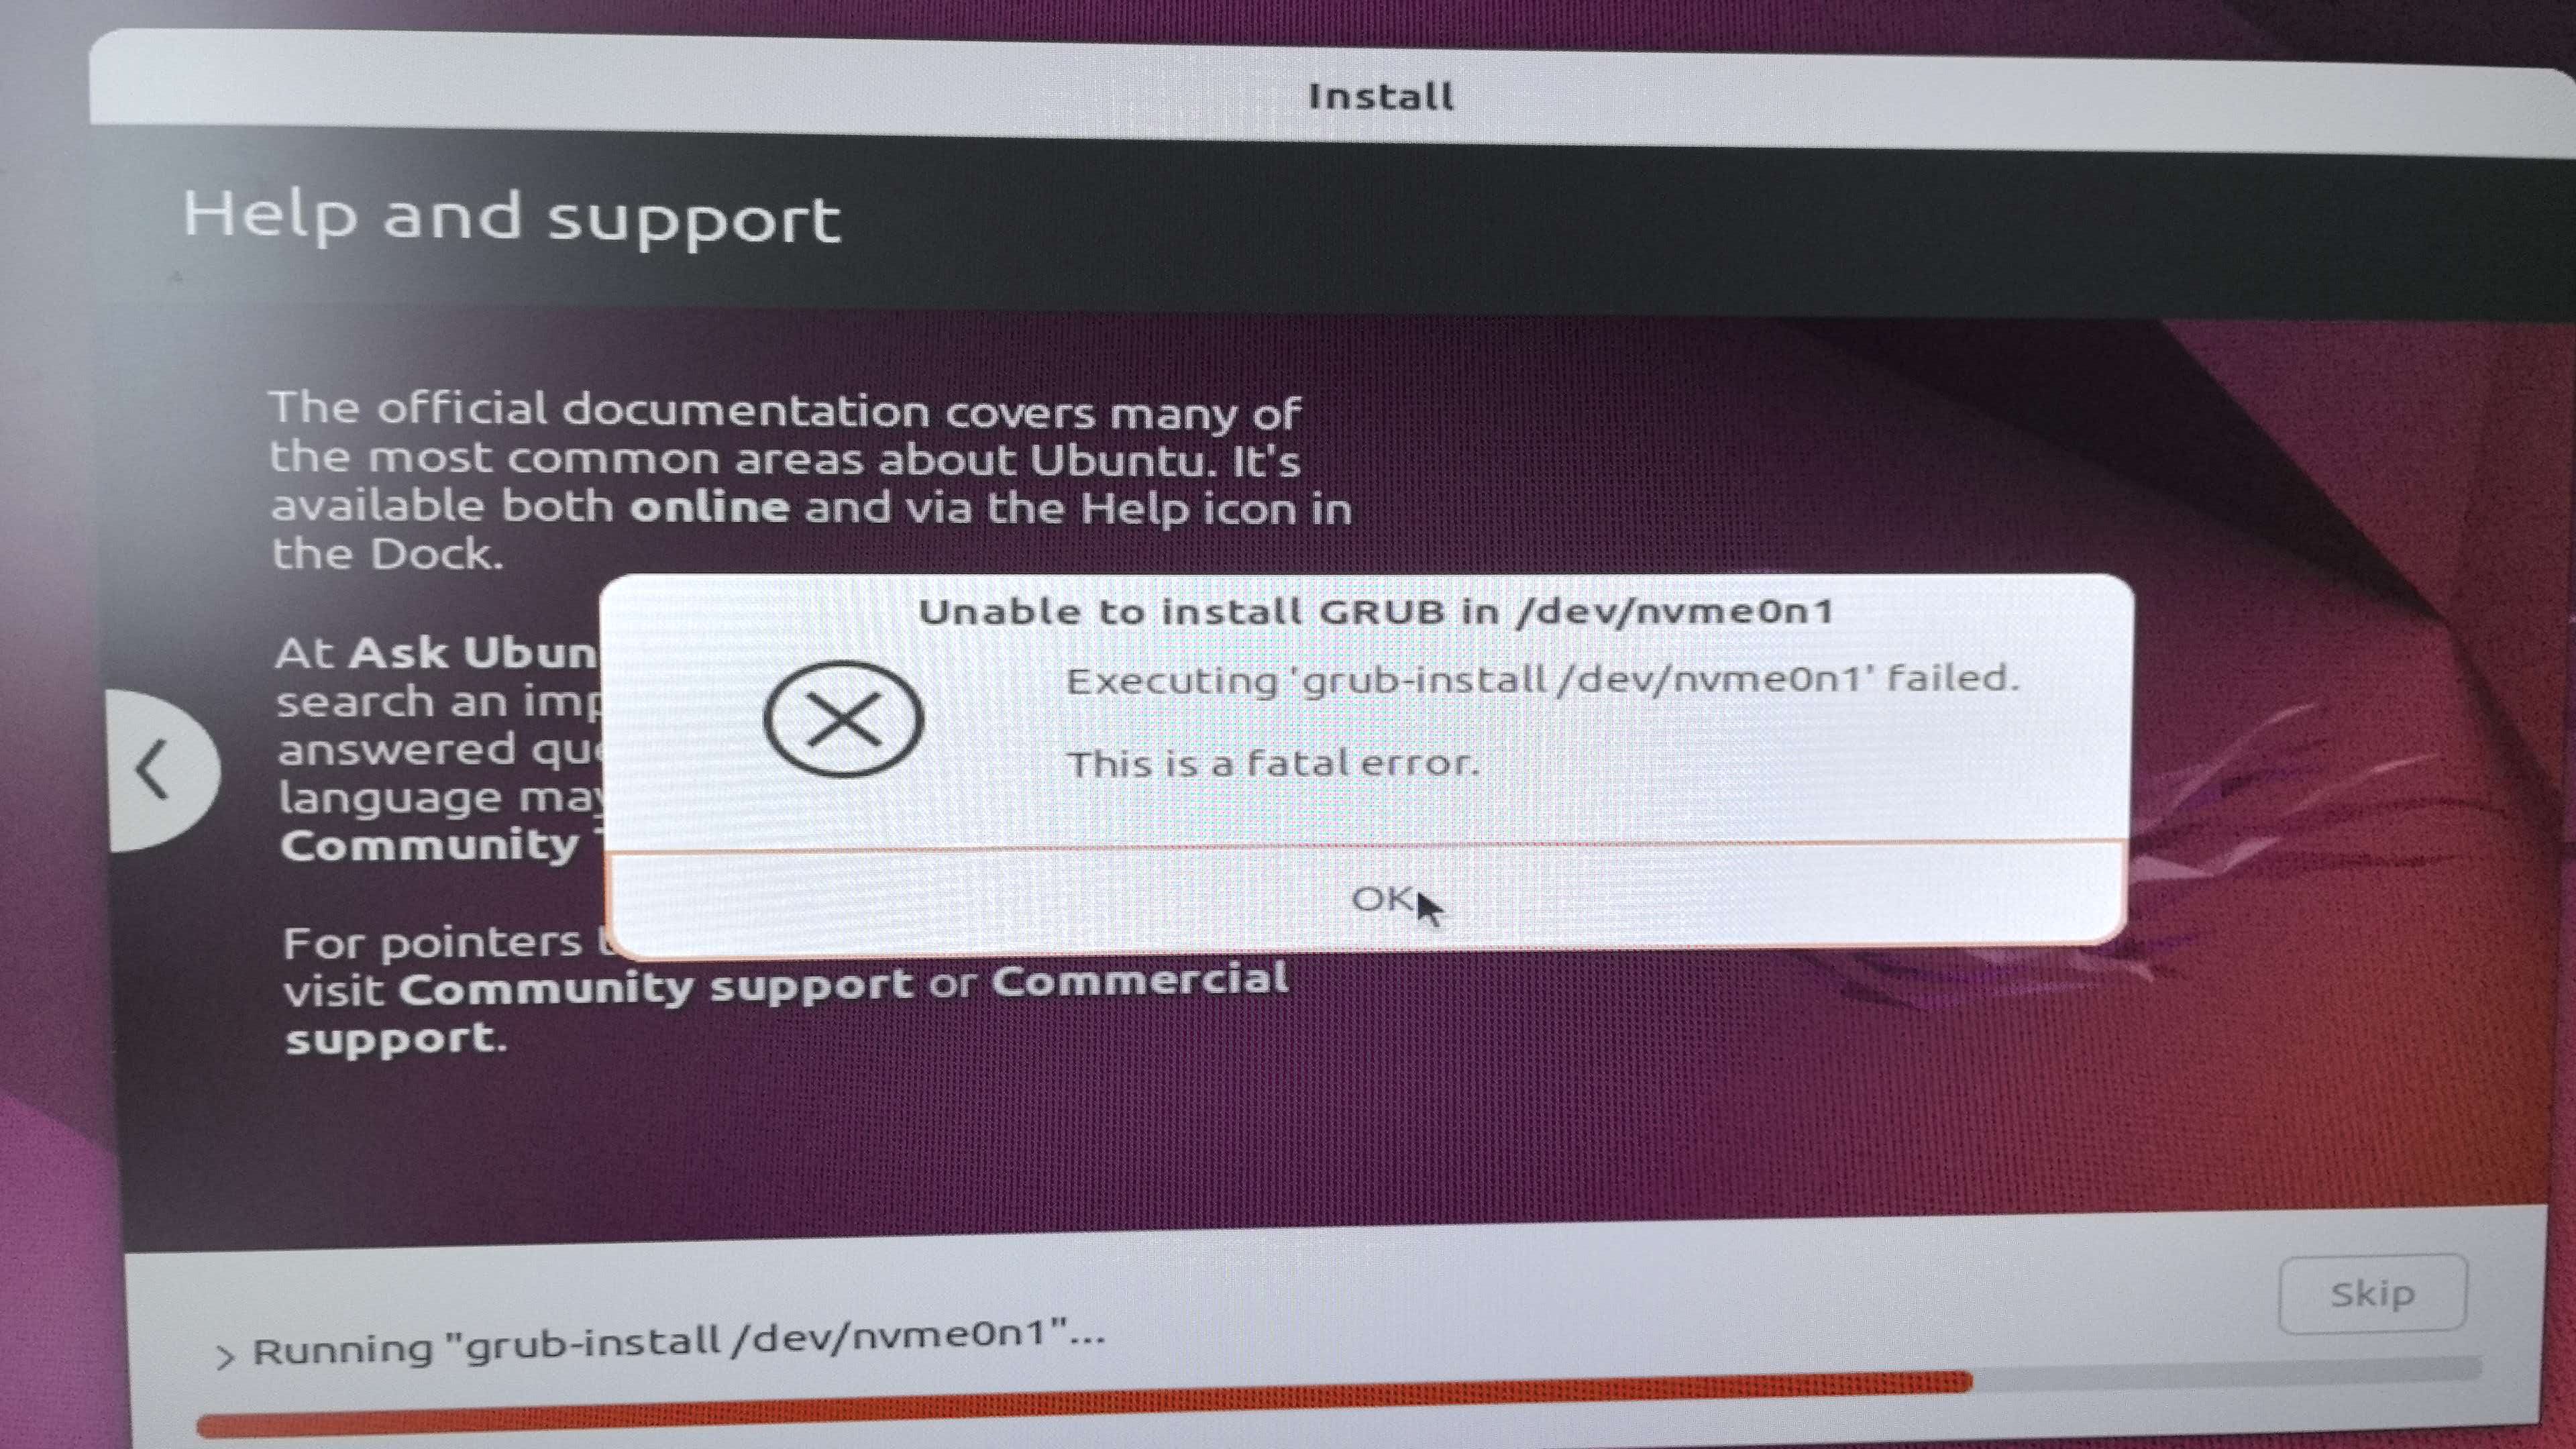
(6)遇见GRUB错误后重启,先进bios禁用"Secure Boot",从安装优盘启动重新启动,选择试用ubuntu。
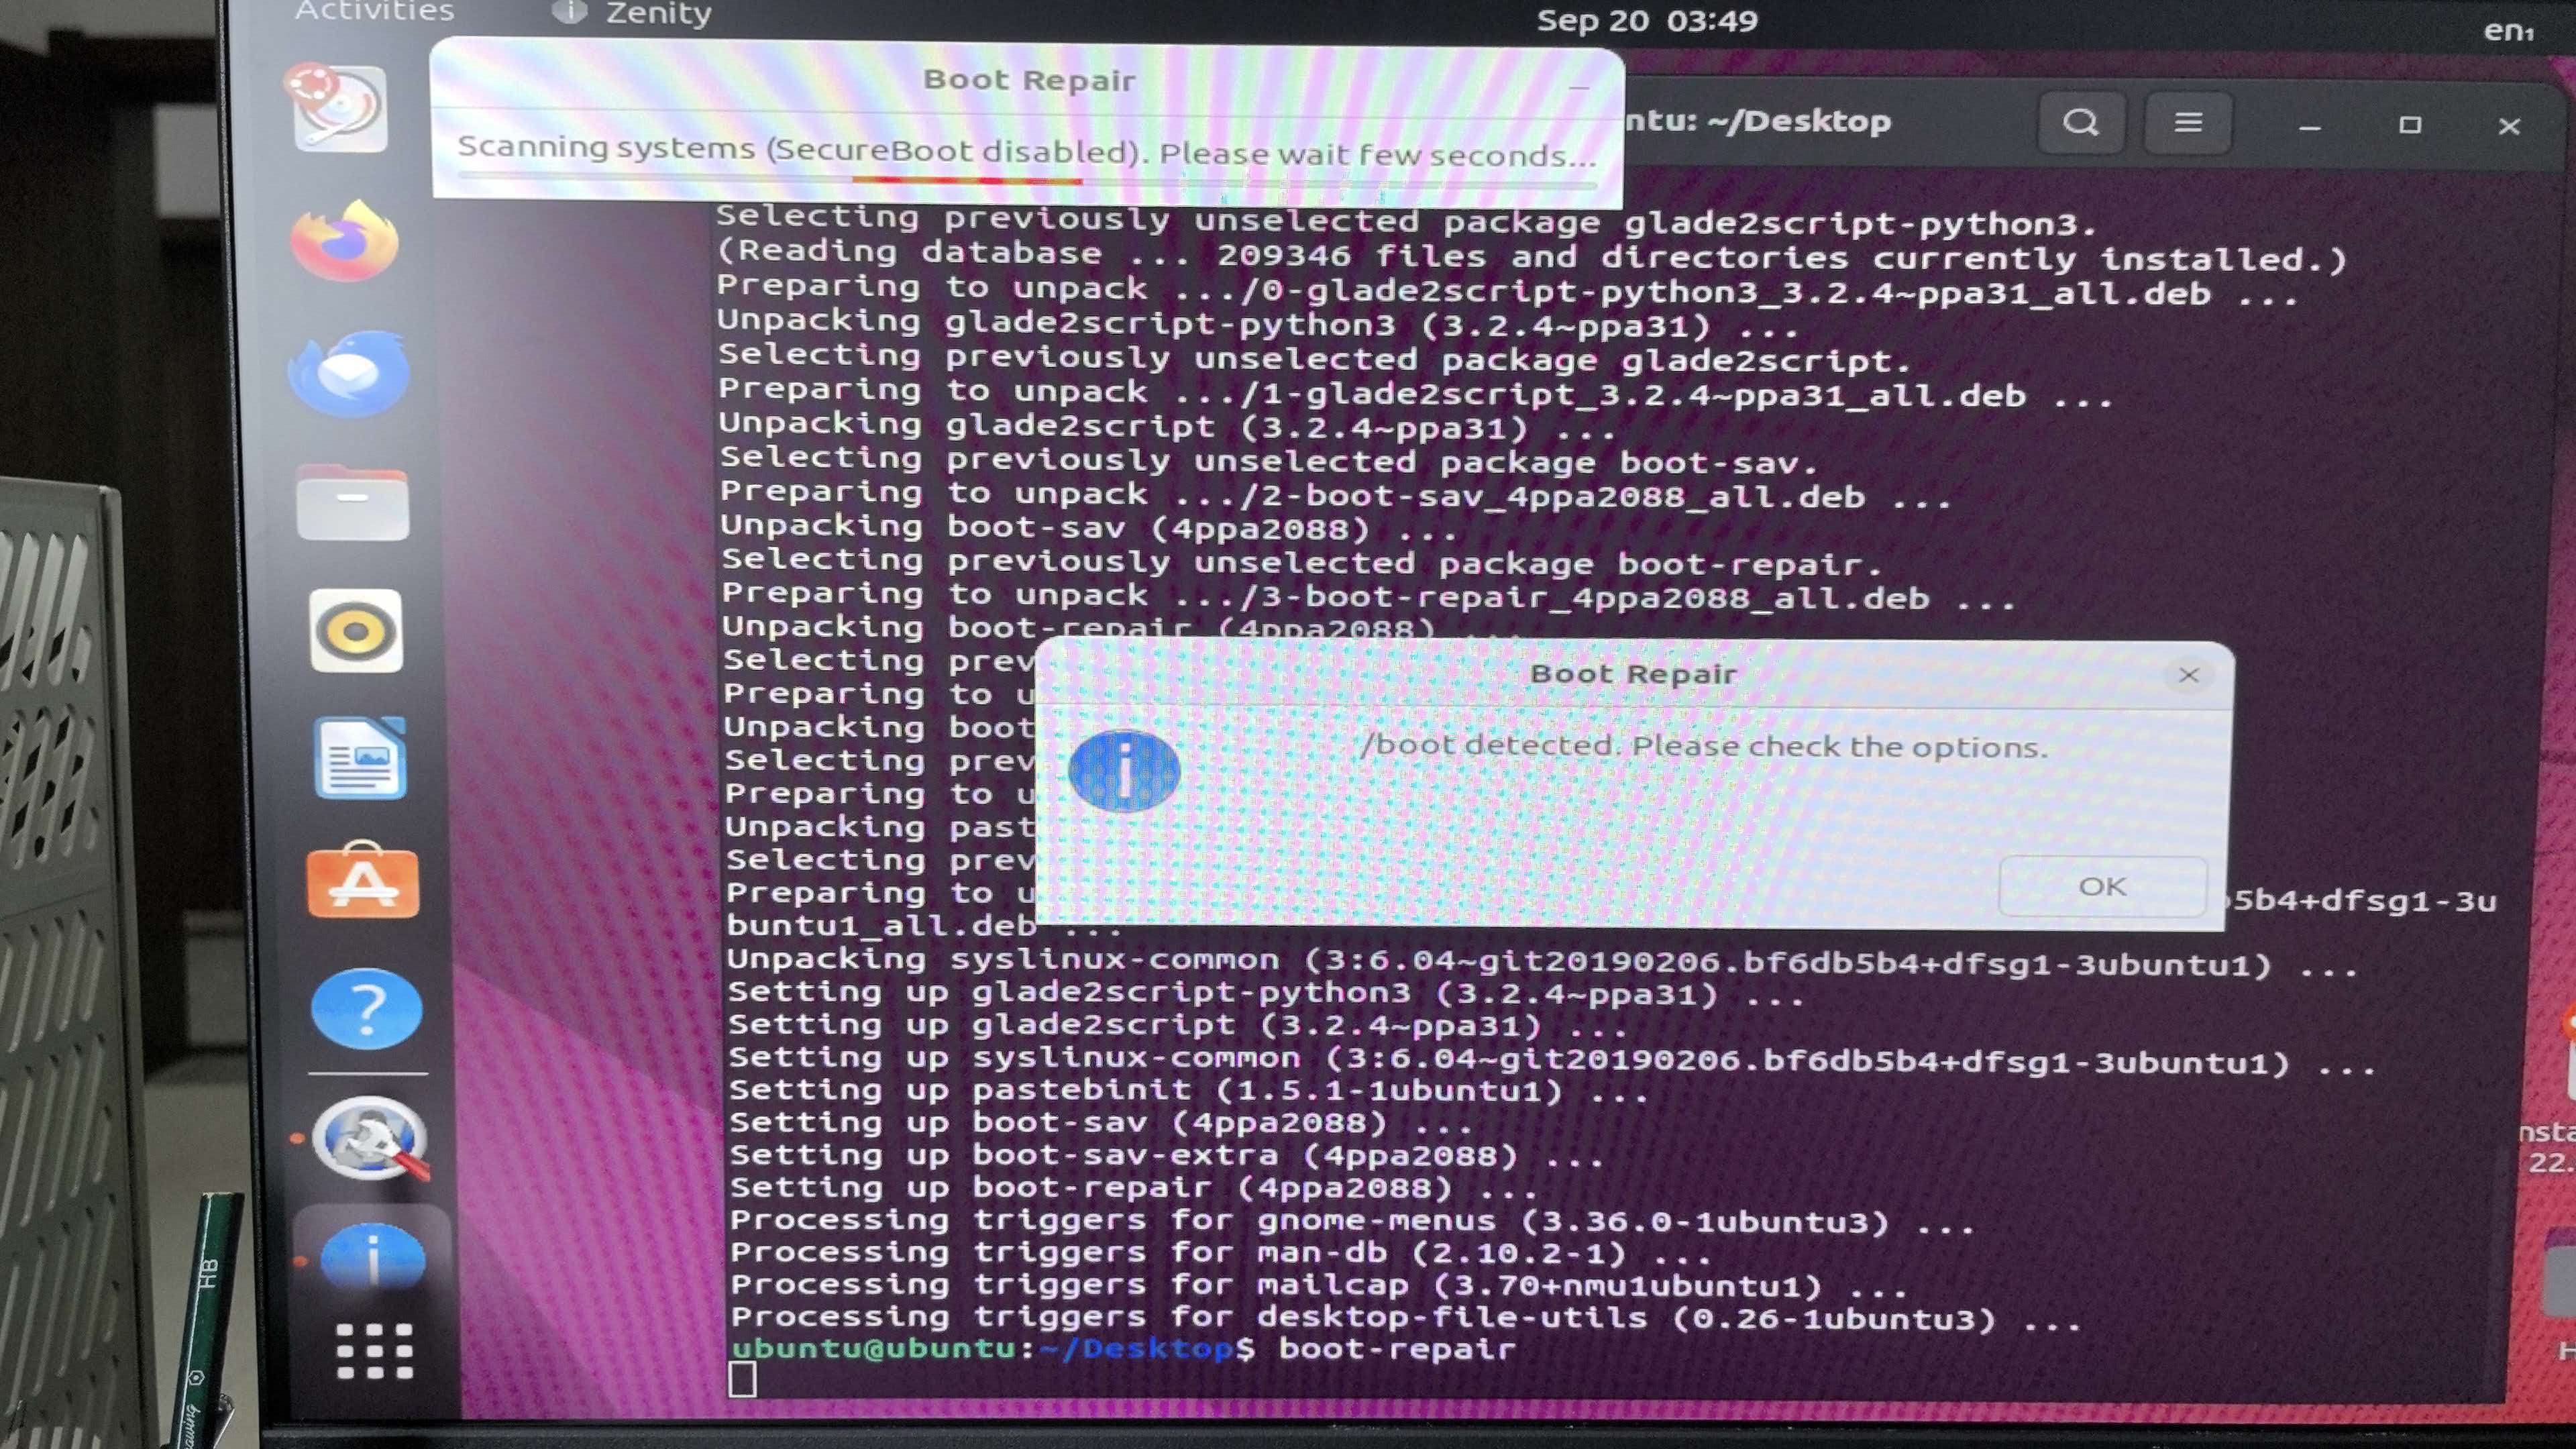
(7)联网并安装 Boot-Repair。运行修复程序。
bash
sudo apt update
sudo add-apt-repository ppa:yannubuntu/boot-repair
sudo apt update
sudo apt install boot-repair
boot-repair
如果自动修复失败,进行第八步手动修复。
(8) 收到修复引导
在试用ubuntu 界面输入以下命令:
bash
# 1. 挂载所有必要分区
sudo mount /dev/nvme0n1p5 /mnt          # 挂载根分区
sudo mount /dev/nvme0n1p3 /mnt/boot     # 挂载 /boot 分区(如果有)
sudo mount /dev/nvme0n1p1 /mnt/boot/efi # 挂载 EFI 分区

# 2. 绑定系统目录
for i in /dev /dev/pts /proc /sys /run; do sudo mount -B $i /mnt$i; done

# 3. 进入 chroot 环境
sudo chroot /mnt

# 4. 在 chroot 内重装并更新 GRUB
grub-install /dev/nvme0n1
update-grub

# 5. 退出并重启
exit
sudo umount -R /mnt
sudo reboot
(9)重启
重启时一直按shift键跳出ubuntu系统选项
按照步骤(2)-(3)修改命令进入系统
1.4 禁用 nouveau及安装显卡驱动
(10)先禁用 nouveau:
在终端中输入以下命令:
bash
# 创建一个新文件并写入禁用 Nouveau 的配置
sudo tee /etc/modprobe.d/blacklist-nouveau.conf <<EOF
blacklist nouveau
options nouveau modeset=0
EOF

# 更新 initramfs ,此时不要重启,安装完正确的显卡驱动再重启
sudo update-initramfs -u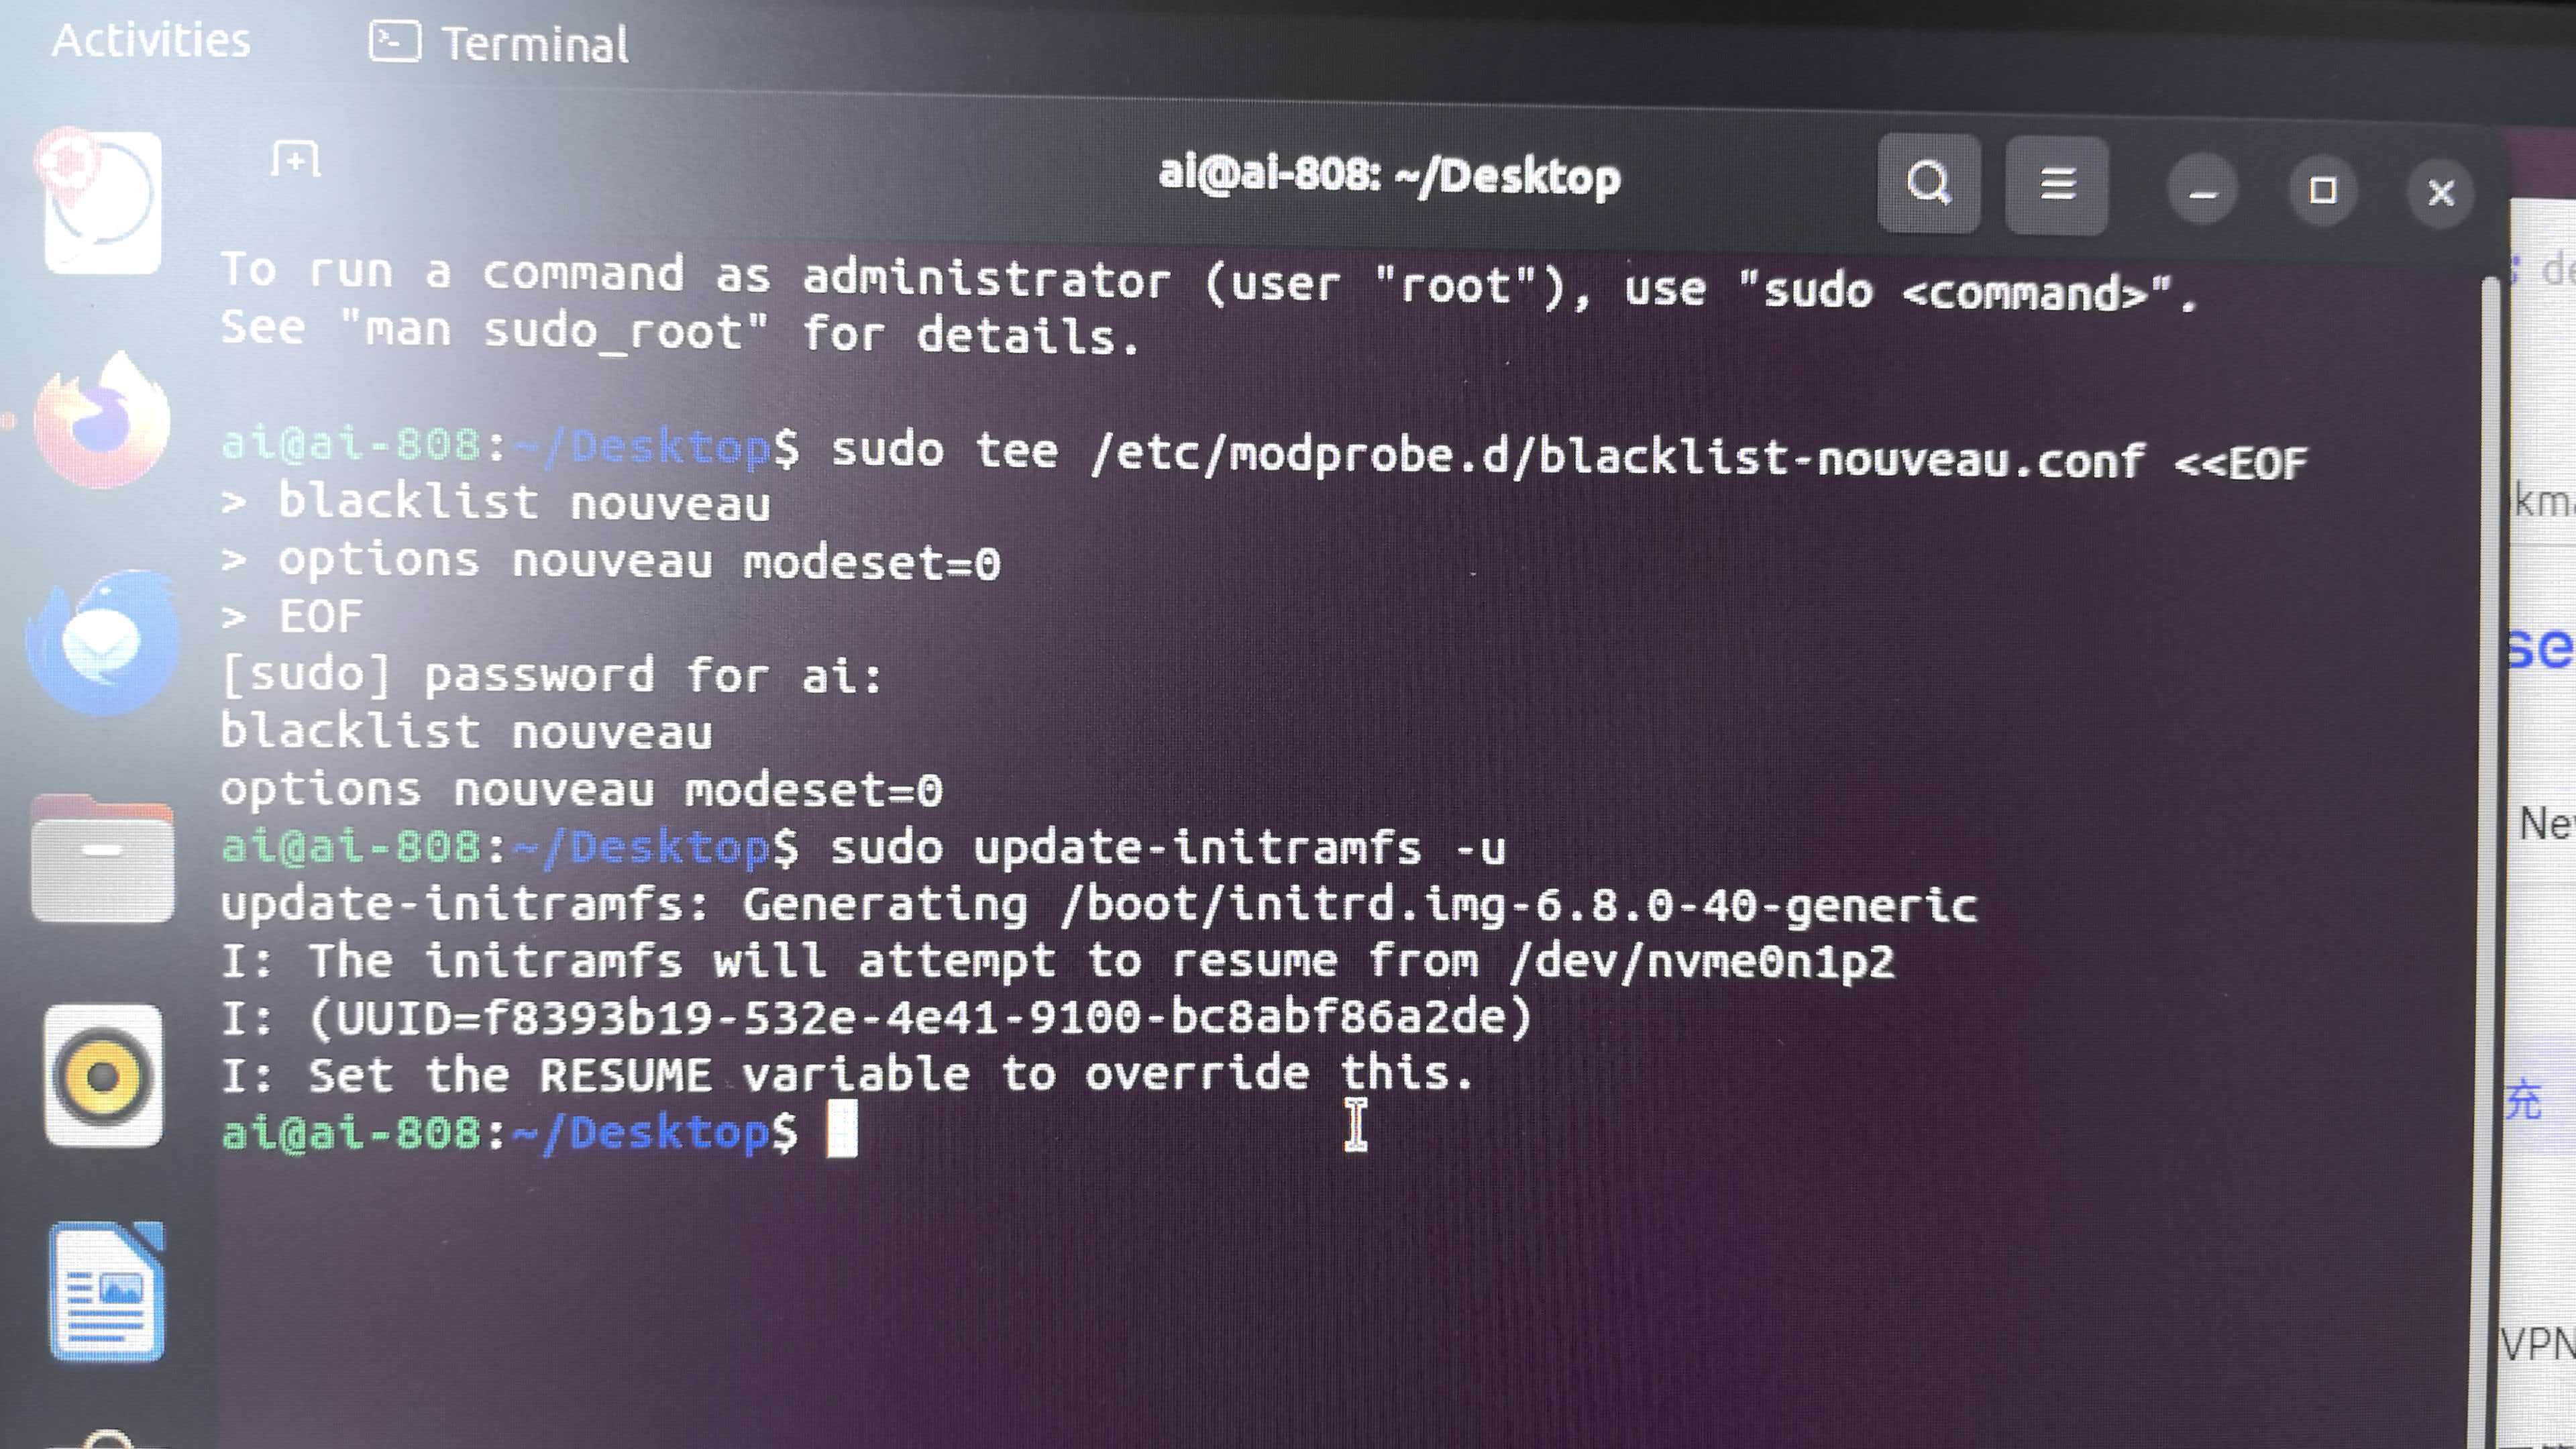
2. 安装显卡驱动
2.1 查看当前显卡驱动适合哪个版本的官方驱动
参考我的文章ubuntu24.04:降内核+显卡驱动+cuda+cudnn+pytorch+anaconda+pycharm
我的显卡是RTX5090DV2,驱动可以安装590:
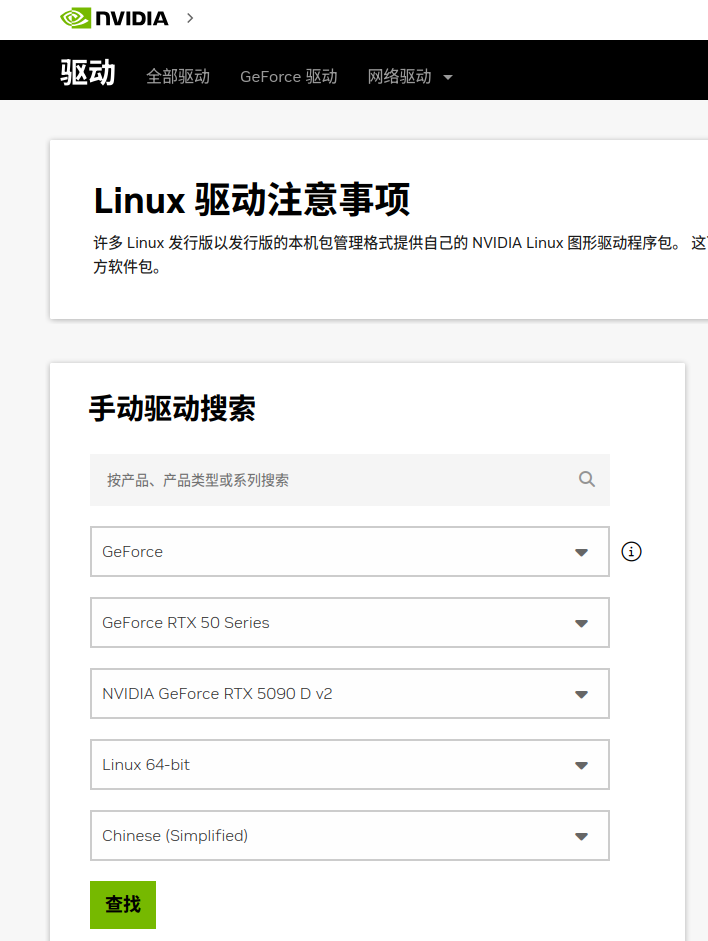
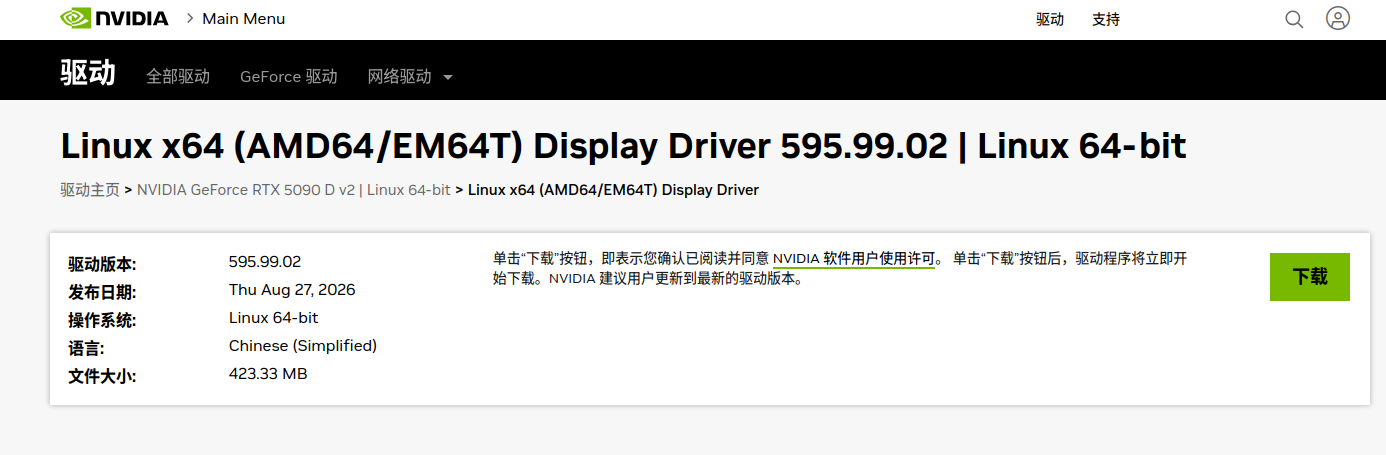
2.2 apt install 安装显卡驱动
不建议从官网下载 .run 文件安装,非常容易把图形界面搞没了。
bash
sudo apt update
sudo apt install nvidia-driver-595-open

# 过几分钟验证安装
nvidia-smi
2.3 配置 GRUB 参数(防止重启黑屏)
bash
sudo nano /etc/default/grub
# 找到 GRUB_CMDLINE_LINUX_DEFAULT,确保包含 nvidia-drm.modeset=1
GRUB_CMDLINE_LINUX_DEFAULT="quiet splash nvidia-drm.modeset=1"

sudo update-grub

# 重启,祈祷不要黑屏吧!
sudo reboot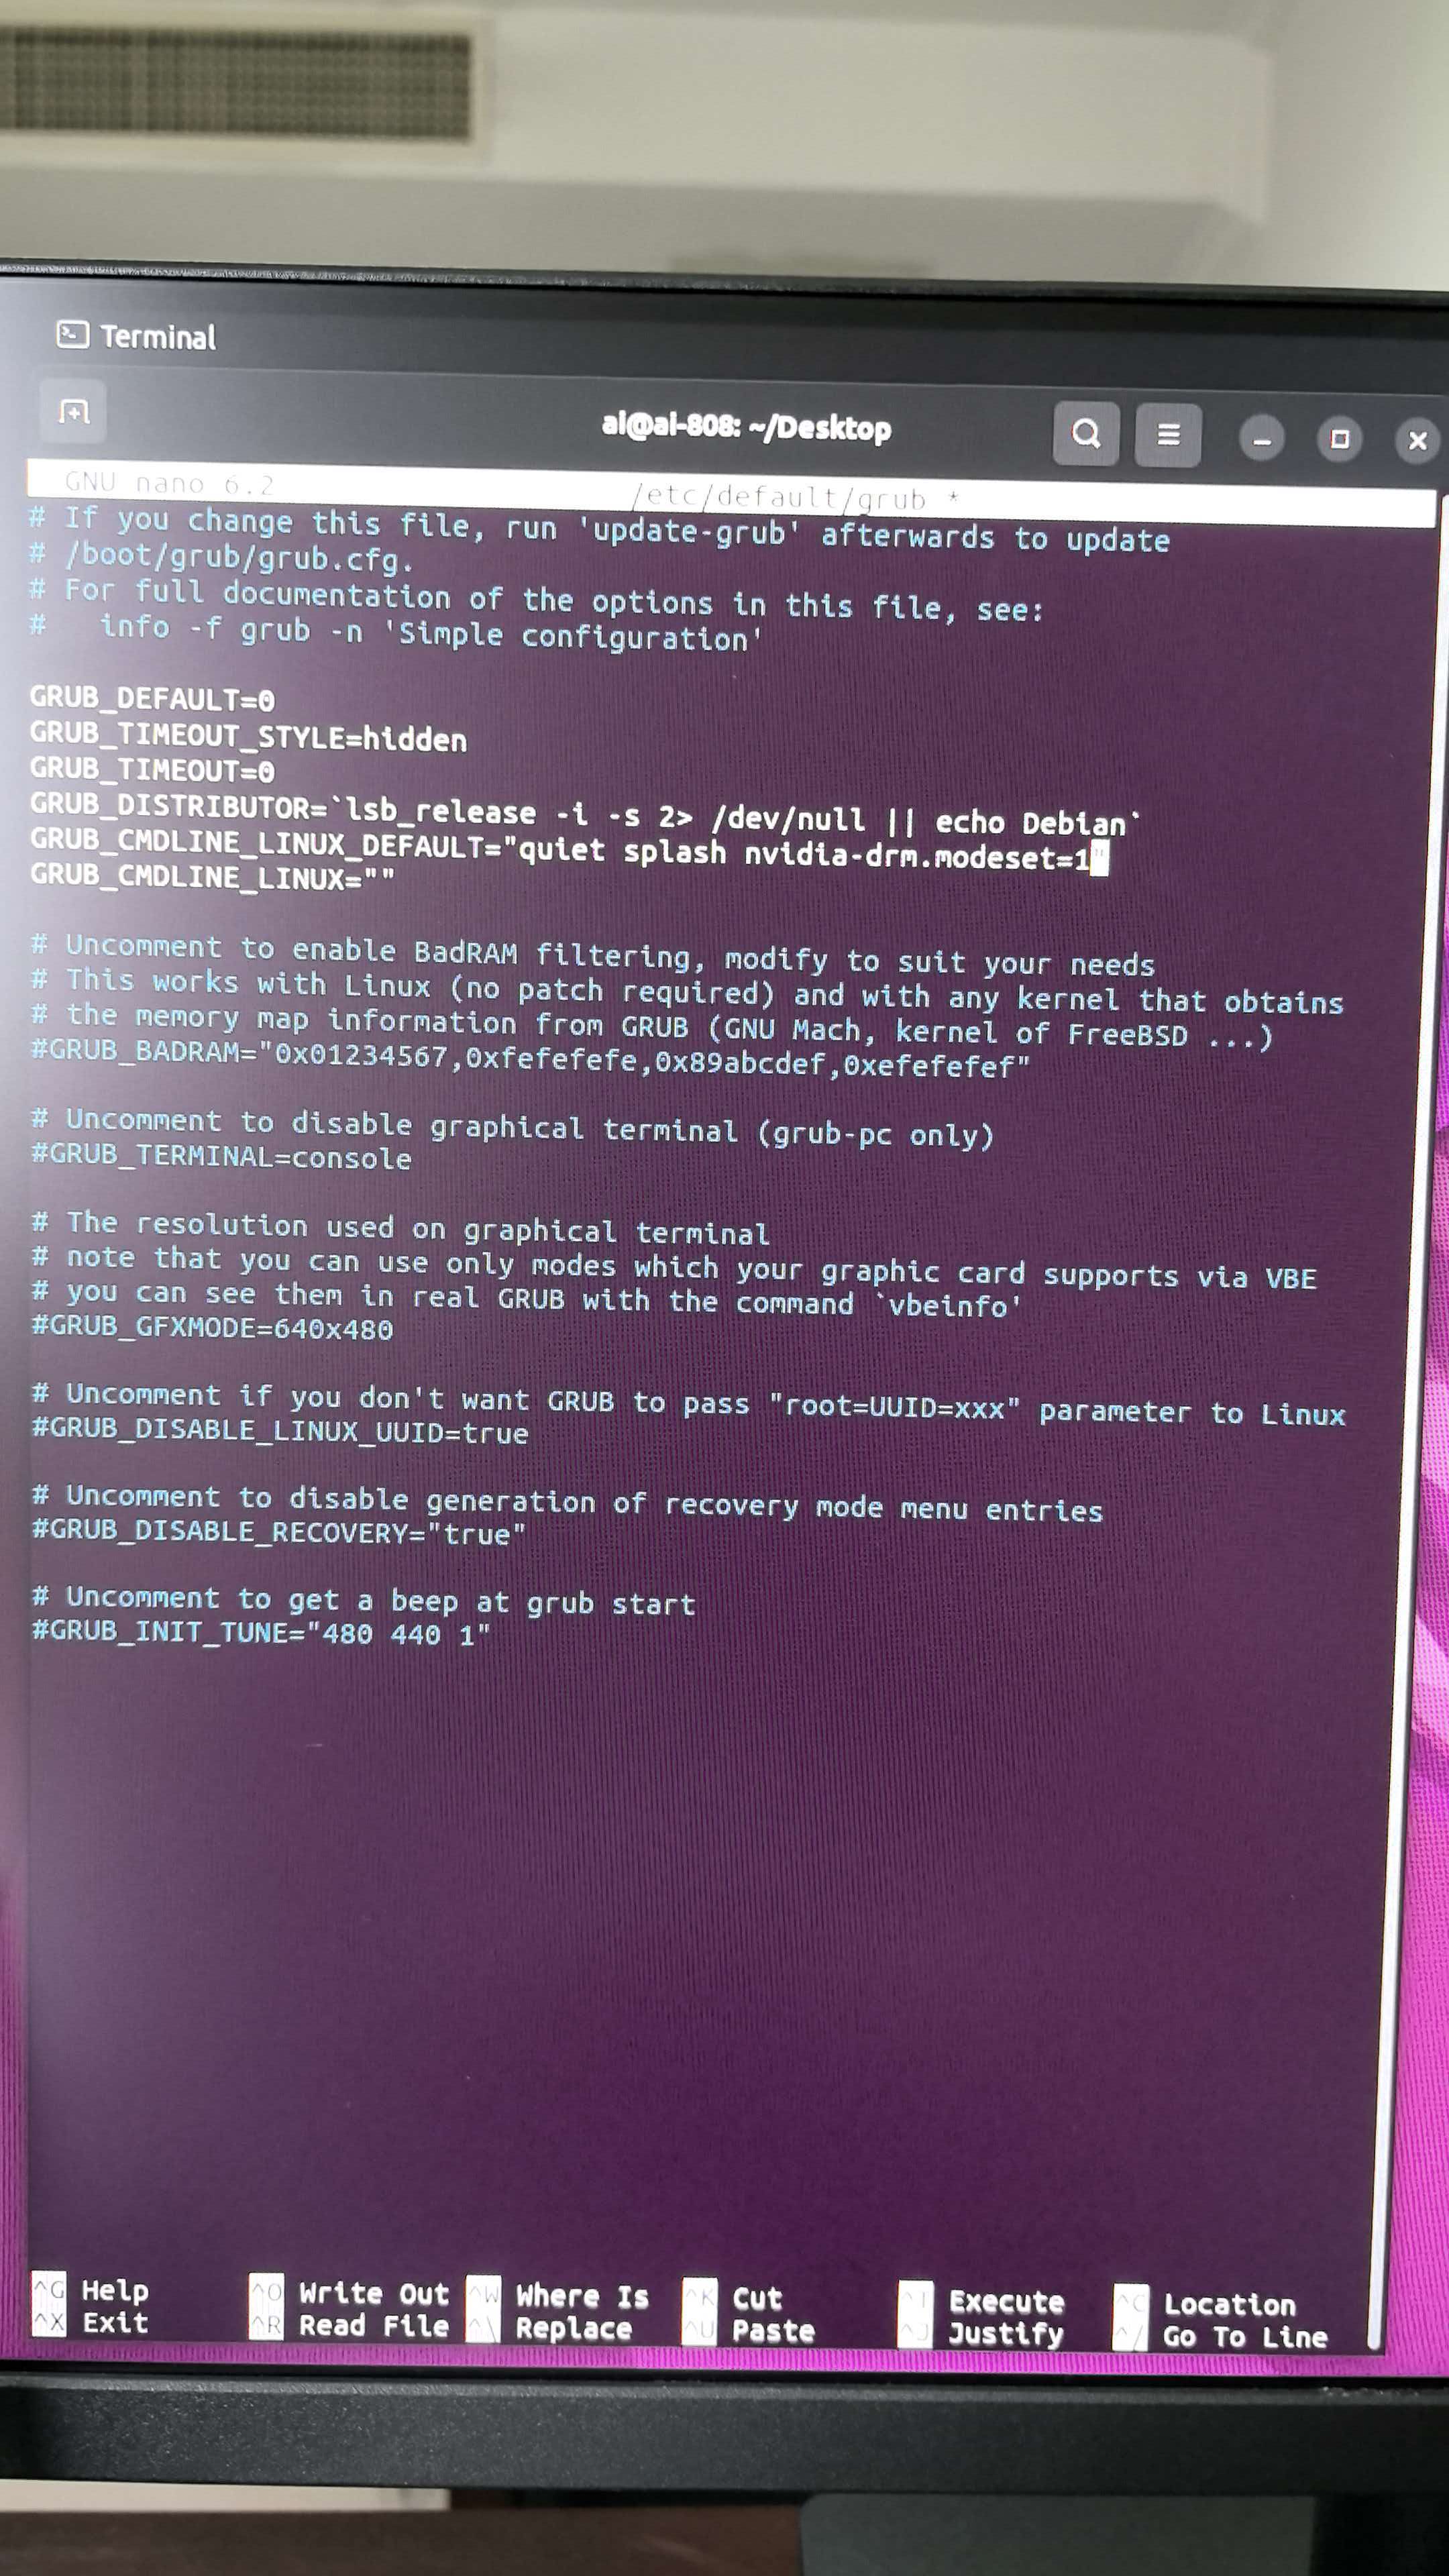
2.4 重启时再次确认BIOS 中必须关闭 Secure Boot
3. ubuntu系统设置和基础深度学习开发环境部署
参见我的文章:
ubuntu24.04:降内核+显卡驱动+cuda+cudnn+pytorch+anaconda+pycharm
利用Anaconda和Mamba创建深度学习常用四大环境(windows\ubuntu通用)
唯一的区别在于ubuntu22.04不需要降低内核版本,直接设置系统和部署深度学习研发环境。考虑到我的显卡是RTX5090,所以一些软件版本和原文中略有不同:
NVIDIA驱动版本 ≥ 580.x + CUDA = 12.8 + cudnn = 9.10 + PyTorch = 2.10.0 + Python=3.12
3.1 conda虚拟环境中的依赖库安装命令
常规的系统源更改、安装其他软件和基本组件这里就不再重复提了,只把我的conda虚拟环境中的依赖库安装命令再贴一下:
bash
mamba create -n deepseek python=3.12 -y
mamba activate guotu_deepseek
# pytorch-cuda=12.8 这个包在 Conda 的官方频道里还没有上架,用 Mamba 安装 CUDA 12.8 工具链
mamba install -c nvidia cuda-toolkit=12.8 -y
# 用 Pip 安装 PyTorch(指定 CUDA 12.8 索引)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu128 -i https://pypi.tuna.tsinghua.edu.cn/simple

pip install matplotlib ollama modelscope -i https://pypi.tuna.tsinghua.edu.cn/simple
pip install transformers accelerate peft datasets scikit-learn -i https://pypi.tuna.tsinghua.edu.cn/simple
pip install bitsandbytes -i https://pypi.tuna.tsinghua.edu.cn/simple

# ollama
modelscope download --model Lixiang/ollama-release --local_dir ~/Downloads/ollama
# ollama-linux-amd64.tar.zst下载地址 https://modelscope.cn/models/Lixiang/ollama-release/files?version=v0.34.0
# 确保上面下载的ollama-linux-amd64.tar.zst在ollama目录
cd ollama
bash ./linux-install.sh

# 验证安装
ollama --version
3.2 搜狗拼音输入法能输入中文标点但无法输入汉字
通常是由于 Fcitx 框架环境变量未正确配置,或是搜狗输入法引擎未成功加载导致的。可以按照以下步骤来排查:
(1)检查当前变量:在终端执行以下命令,检查输出结果。
bash
env | grep -E "(GTK|QT|XMODIFIERS)_IM_MODULE"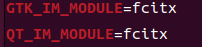
如果输出中包含 ibus 或为空,说明配置有误。修正环境变量:编辑 ~/.profile 文件,在末尾添加以下内容(如果已存在,请修改为正确值):
bash
export GTK_IM_MODULE=fcitx
export QT_IM_MODULE=fcitx
export XMODIFIERS=@im=fcitx
(2)安装必要的依赖包:运行以下命令,安装 Fcitx 框架、配置工具及 Qt 依赖库。
bash
sudo apt install fcitx fcitx-config-gtk fcitx-frontend-qt5 fcitx-modules libqt5qml5 libqt5quick5 libqt5quickwidgets5 qml-module-qtquick2 libgsettings-qt1 -y(3)确认 Fcitx 版本:搜狗输入法长期基于 Fcitx4 开发,与 Ubuntu 22.04 默认的 Fcitx5 存在兼容性问题。
bash
ps aux | grep fcitx如果看到 fcitx5 进程,需要先停用它,再启动 fcitx。
4. 模型下载与部署
4.1 DeepSeek-R1-Distill-Qwen-14模型下载
modelscope download --model deepseek-ai/DeepSeek-R1-Distill-Qwen-14B --local_dir ~/Documents/DeepSeek-R1-Distill-Qwen-14B
4.2 后台管理ollama提取模型
(1)创建Modelfile文件
不管是原生模型(文件夹形式)还是 gguf 模型,ollama都可以提取。需要在模型或模型文件夹同级目录下创建没有后缀名的Modelfile文件,用文本编辑:
bash
gedit Modelfile
#
FROM /home/ai/Documents/DeepSeek-R1-Distill-Qwen-14B
PARAMETER think false
(2)提取量化版模型
ollama命令行工具版本不能过高,否则量化参数与老版本不一致。
bash
ollama create tudideepseek -q q4_K_M -f /home/ai/Documents/Modelfile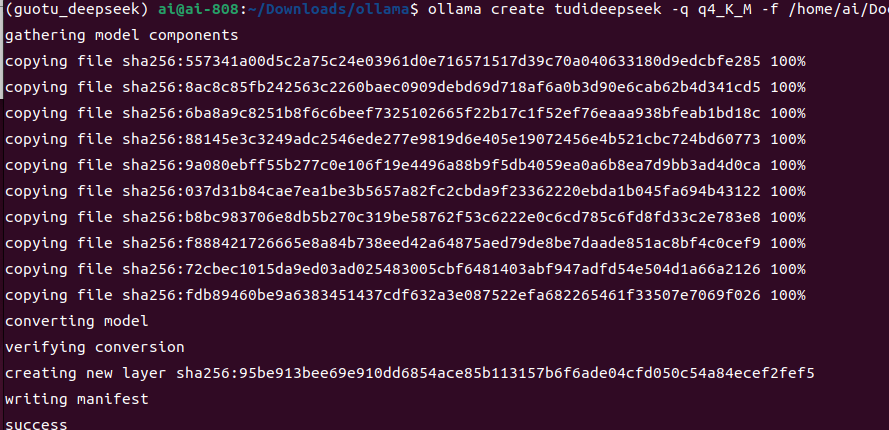
4.3 配置ollama环境变量(重要)
bash
sudo systemctl edit ollama.service
# 在 [Service] 段落中添加以下内容
[Service]
Environment="OLLAMA_NUM_PARALLEL=7"
Environment="OLLAMA_CONTEXT_LENGTH=8192"
# 重载配置并重启服务
sudo systemctl daemon-reload
sudo systemctl restart ollama
5. 前端web交互ollamawebui
5.1 安装ollamawebui
bash
pip install ollamawebui5.2 配置 Ollama 服务地址(IP)
bash
# 格式为 OLLAMA_HOST=http://<IP地址>:<端口>
# 例如,连接到本机默认端口
export OLLAMA_HOST=http://127.0.0.1:11434
# 或者,连接到局域网内的另一台服务器
export OLLAMA_HOST=http://192.168.1.100:11434

# 永久更改监听地址
sudo systemctl edit ollama
# 在打开的编辑器中添加以下内容(如果文件为空,直接复制粘贴)
[Service]
Environment="OLLAMA_HOST=0.0.0.0"
# 保存并退出(在nano中按 Ctrl+X,然后按 Y,再按 Enter)
# 重载配置并重启Ollama服务
sudo systemctl daemon-reload
sudo systemctl restart ollama
5.3 调用本地 JS/CSS 文件
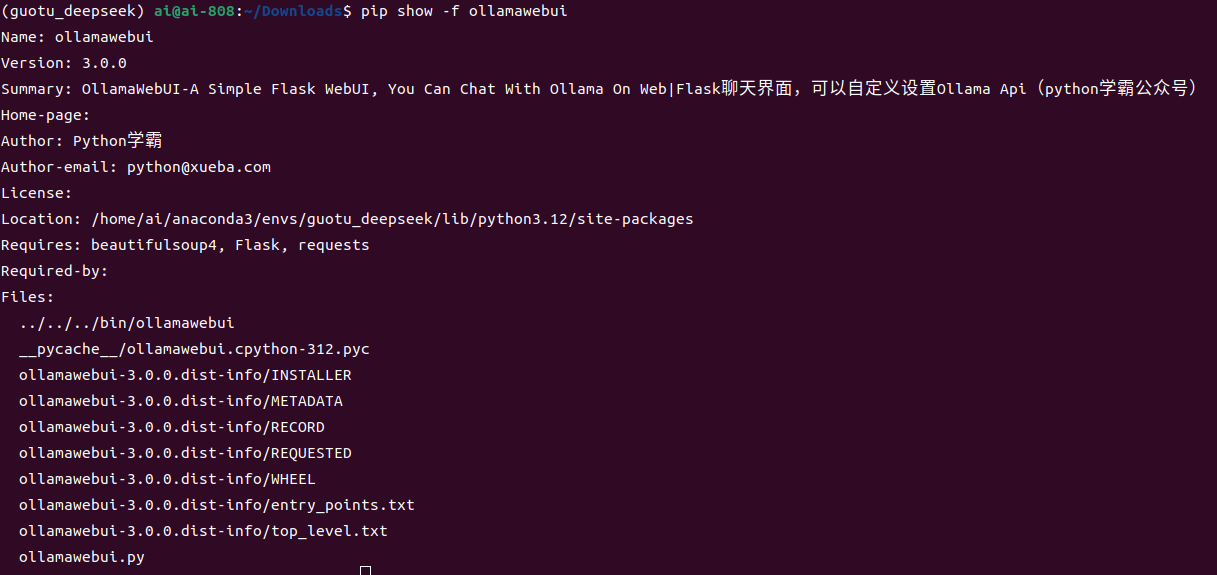
(1) 找到安装位置:使用 pip show -f ollamawebui 命令可以查看这个包的所有文件路径。
所有的web页面代码包含在了ollamawebui.py文件中。
(2) 把 JS/CSS 下载到本地
在 ollamawebui.py 所在目录下新建一个 static 文件夹,把文件下载进去,再改代码引用本地路径。
bash
# 新建目录并下载文件
mkdir -p /home/ai/anaconda3/envs/guotu_deepseek/lib/python3.12/site-packages/static
cd /home/ai/anaconda3/envs/guotu_deepseek/lib/python3.12/site-packages/static
wget https://cdn.bootcdn.net/ajax/libs/highlight.js/11.9.0/styles/github-dark.min.css
wget https://cdn.bootcdn.net/ajax/libs/marked/4.3.0/marked.min.js
wget https://cdn.bootcdn.net/ajax/libs/highlight.js/11.9.0/highlight.min.js
wget https://cdn.bootcdn.net/ajax/libs/KaTeX/0.16.9/katex.min.css
wget https://cdn.bootcdn.net/ajax/libs/KaTeX/0.16.9/katex.min.js
wget https://cdn.bootcdn.net/ajax/libs/KaTeX/0.16.9/contrib/auto-render.min.js
wget https://cdn.jsdelivr.net/npm/marked@4.3.0/lib/marked.umd.min.js
(3)编辑 ollamawebui.py,把 https://cdn.jsdelivr.net/npm/... 全部改成 /static/...(根据 Flask 默认路由调整,通常是 /static/文件名),重启服务。
5.4 启动web服务
bash
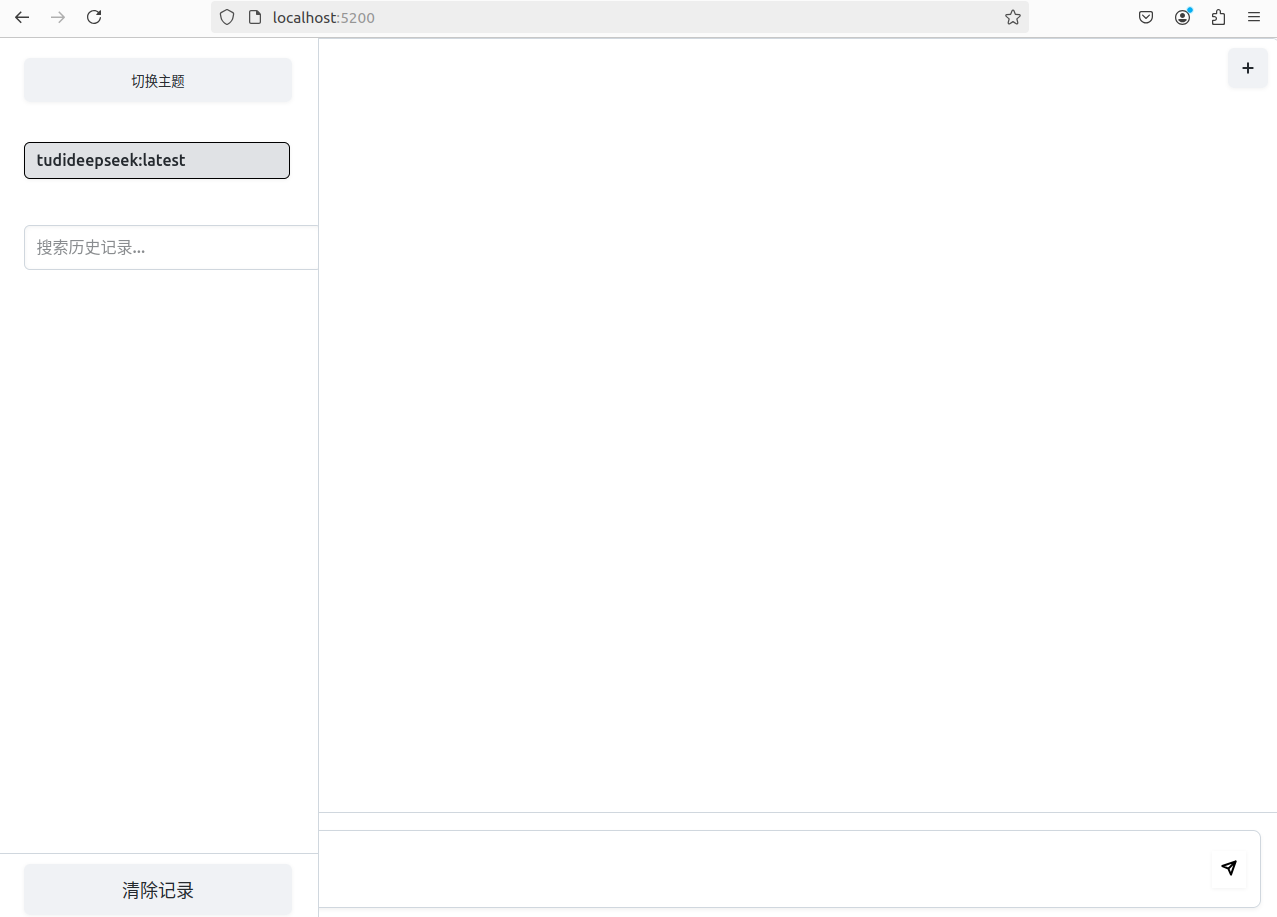
ollamawebui start看到启动成功的提示后,在浏览器中访问 http://localhost:5200 即可打开界面。其他用户输入服务器地址,比如: 192.168.8.16:5200 。
5.5 修改界面
所有的web页面代码包含在了ollamawebui.py文件中,修改完后替换掉ollamawebui.py文件。
5.6 解决前端偶发死循环和思考过程与正式回答无法区分问题
原生的ollamawebui包有两个严重问题:
问题一 :提问后,前端没有正确处理流式响应,导致它不仅重复打印了用户提问,还把模型(特别是 DeepSeek-R1)的思考过程当成了普通文本反复叠加。
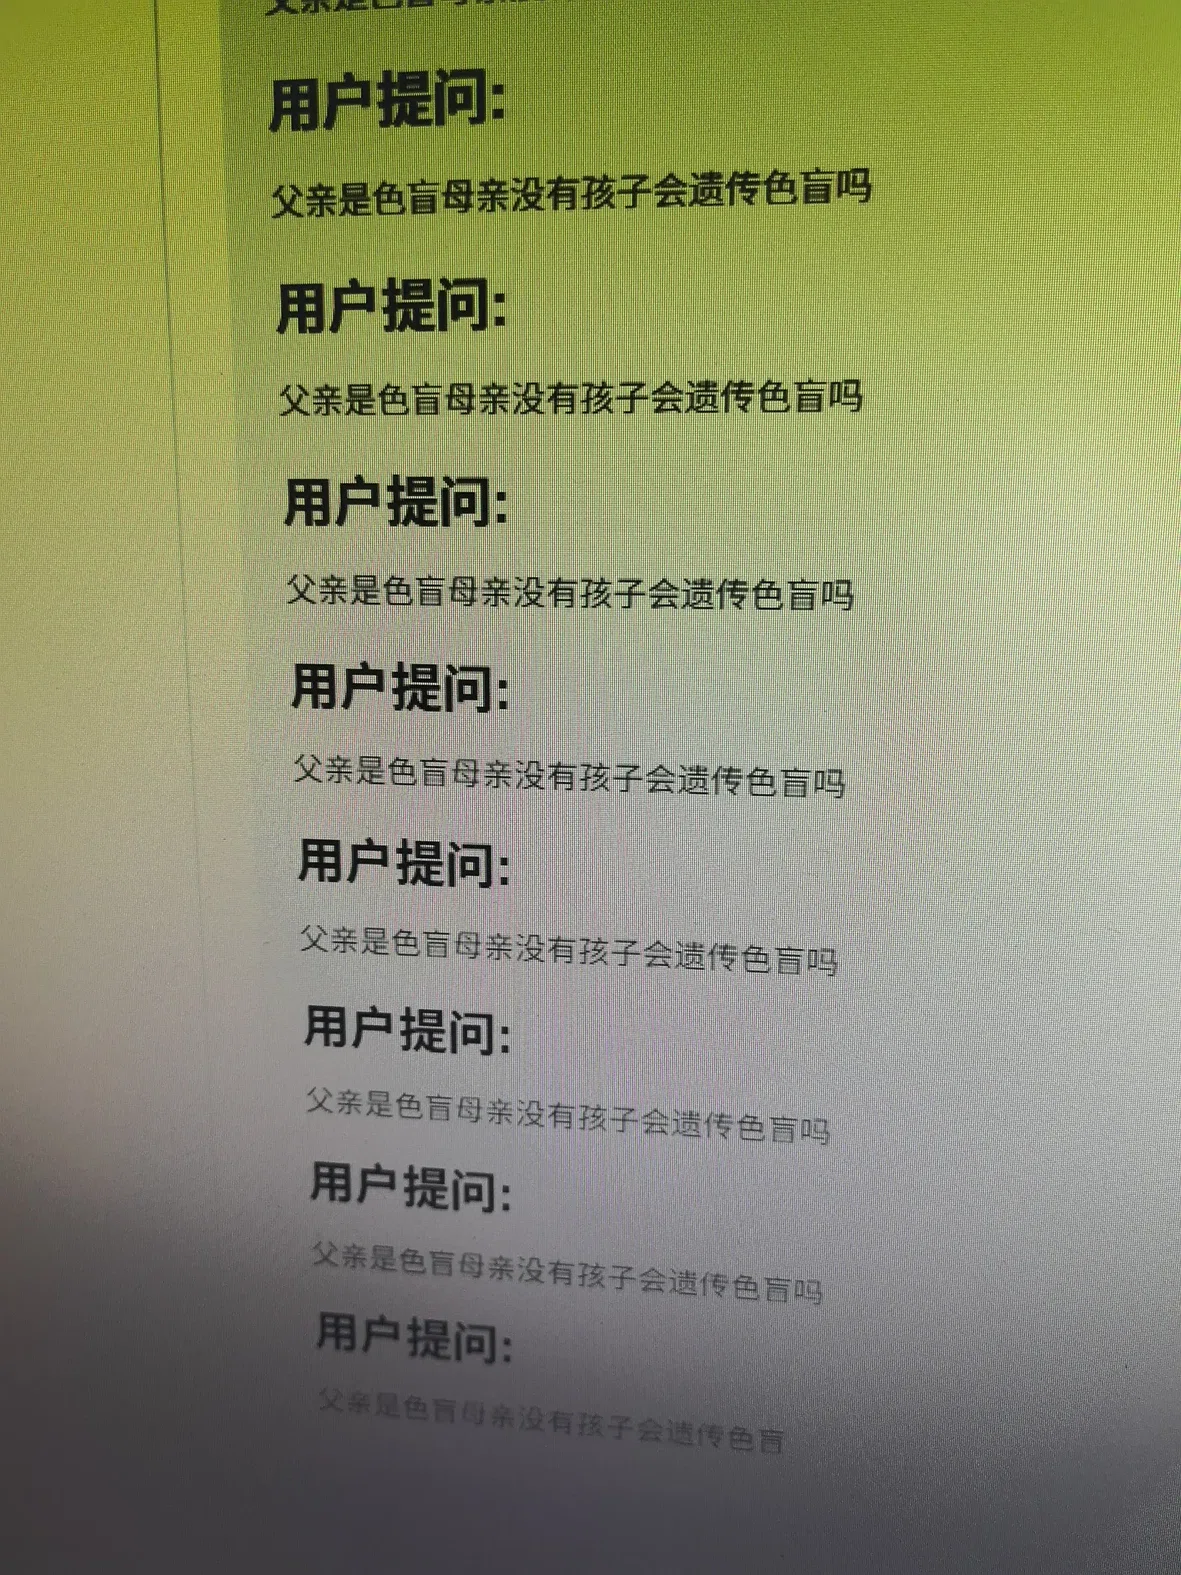 问题二:思考过程与正式回答没有区分,看上去很混杂。
优化了以上两个问题,最后修改的ollamawebui.py完整代码如下:(不包含修改样式)
python
#encoding:utf-8
"""
Python_Xueba/2025/03/03
"""
import logging
import os
from datetime import datetime
from collections import defaultdict
from typing import List, Dict, Optional
import requests
import json
from flask import Flask, Response, request, render_template_string
import uuid
import re
from bs4 import BeautifulSoup
import html
import urllib.parse
import time
from urllib.parse import unquote
DEFAULT_OLLAMA_API_URL = os.environ.get("OLLAMA_API_URL", "http://localhost:11434")
logging.basicConfig(
level=logging.INFO,
format='%(asctime)s - %(levelname)s - [%(name)s] - %(message)s',
handlers=[
logging.FileHandler('app.log', encoding='utf-8'),
logging.StreamHandler()
]
)
logger = logging.getLogger(__name__)
app = Flask(__name__)
sessions = defaultdict(dict)
generation_statuses = defaultdict(lambda: {"generating": False})
session = requests.Session()
def fetch_url_content(url: str) -> Dict[str, str]:
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',
}
try:
url = urllib.parse.unquote(url)
response = session.get(url, headers=headers, timeout=15)
response.raise_for_status()
soup = BeautifulSoup(response.text, 'html.parser')
content_selectors = ['article', '#content', '.post-content', '.entry-content', '.main-content', '[role="main"]', 'main', 'body']
content = None
for selector in content_selectors:
content = soup.select_one(selector)
if content:
break
if not content:
content = soup.body
if content:
for tag in content(['script', 'style', 'nav', 'footer', 'header', 'aside', '[class*="ad"]']):
tag.decompose()
text = content.get_text(separator=' ', strip=True)
result = {"text": text[:65536] if text else "未提取到有效内容", "images": []}
return result
return {"text": "未找到有效内容区域", "images": []}
except requests.exceptions.RequestException as e:
logger.warning(f"URL {url} 获取失败: {str(e)}", exc_info=True)
return {"text": f"链接获取失败: {str(e)}", "images": []}
except Exception as e:
logger.error(f"URL解析异常: {str(e)}", exc_info=True)
return {"text": f"URL解析异常: {str(e)}", "images": []}
def extract_urls(text: str) -> List[str]:
url_pattern = re.compile(r'(?:https?://)?(?:www\.)?(?:[a-zA-Z0-9-]+\.)+[a-zA-Z]{2,}(?:[^\s()<>]*|\([^\s()<>]+\))*(?<![\.,:;])')
urls = url_pattern.findall(text)
return [f"https://{url}" if not url.startswith(('http://', 'https://')) else url for url in urls]
def normalize_context(context: List[Dict]) -> List[Dict]:
normalized = []
for item in context:
role = item.get("role", "user")
parts = item.get("parts", [{"text": item.get("content", "")}])
message = parts[0].get("text", "") if parts and isinstance(parts, list) else ""
normalized.append({"role": role, "message": message})
return normalized
def chunk_text(text: str, chunk_size: int = 4096) -> List[str]:
return [text[i:i + chunk_size] for i in range(0, len(text), chunk_size)]
def generate_ollama_stream(prompt: str, session_id: str, history: List[Dict], url_content: str = "", model: str = "llama3", api_url: str = DEFAULT_OLLAMA_API_URL) -> Response:
headers = {"Content-Type": "application/json"}
current_time = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
system_prompt = f"你是XXX单位土地管理业务咨询AI助手,提供简洁准确的中文回复。当前时间: {current_time}"
# 构建标准 messages
messages = [{"role": "system", "content": system_prompt}]
for item in history:
role = item.get("role", "user")
# 过滤掉空消息
if item.get("message"):
messages.append({"role": "user" if role == "user" else "assistant", "content": item["message"]})
# 处理用户当前输入
effective_prompt = prompt
if url_content:
effective_prompt += f"\n\n{url_content}"
messages.append({"role": "user", "content": effective_prompt})
payload = {
"model": model,
"messages": messages,
"stream": True
}
logger.debug(f"Ollama Chat Payload: {payload}")
def stream():
generation_statuses[session_id]["generating"] = True
logger.info(f"Generation started for session {session_id} with model '{model}'")
think_started = False
think_ended = False
try:
with requests.post(f"{api_url}/api/chat", headers=headers, json=payload, stream=True, timeout=120) as response:
response.raise_for_status()
for line in response.iter_lines():
if not generation_statuses[session_id]["generating"]:
logger.info(f"Stop signal received for session {session_id}, stopping generation.")
break
if line:
try:
data = json.loads(line.decode("utf-8"))
if "message" in data:
msg = data["message"]
# 1. 处理思考过程(增量)
if "thinking" in msg and msg["thinking"]:
chunk = ""
if not think_started:
chunk += " thinking"
think_started = True
chunk += msg["thinking"]
yield f"data: {json.dumps({'text': chunk}, ensure_ascii=False)}\n\n"
# 2. 处理正文(增量)
if "content" in msg and msg["content"]:
chunk = ""
if not think_ended and think_started:
chunk += "</think>"
think_ended = True
chunk += msg["content"]
yield f"data: {json.dumps({'text': chunk}, ensure_ascii=False)}\n\n"
# 3. 结束信号
if data.get("done", False):
if think_started and not think_ended:
yield f"data: {json.dumps({'text': '</think>'}, ensure_ascii=False)}\n\n"
yield f"data: {json.dumps({'done': True}, ensure_ascii=False)}\n\n"
logger.info(f"Generation completed for session {session_id}")
break
except json.JSONDecodeError:
logger.error(f"JSON Decode Error: {line.decode('utf-8')}", exc_info=True)
continue
except requests.exceptions.RequestException as e:
logger.error(f"Ollama API request failed: {str(e)}", exc_info=True)
yield f"data: {json.dumps({'error': f'服务器响应失败: {str(e)}'}, ensure_ascii=False)}\n\n"
except Exception as e:
logger.error(f"Generation stream error: {str(e)}", exc_info=True)
yield f"data: {json.dumps({'error': f'生成出错: {str(e)}'}, ensure_ascii=False)}\n\n"
finally:
generation_statuses[session_id]["generating"] = False
return Response(stream(), mimetype="text/event-stream", headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"})
@app.route('/chat', methods=['POST'])
def chat():
try:
data = request.get_json(silent=True)
if data is None:
logger.warning("Invalid JSON request received for /chat")
return Response(f"data: {json.dumps({'error': '请求体不是有效的JSON格式'}, ensure_ascii=False)}\n\n", mimetype="text/event-stream")
if not isinstance(data, dict) or 'message' not in data:
logger.warning("Missing 'message' field in /chat request")
return Response(f"data: {json.dumps({'error': '请求体缺少message字段或格式错误'}, ensure_ascii=False)}\n\n", mimetype="text/event-stream")
message = data.get('message', '')
message = unquote(message)
session_id = data.get('session_id', str(uuid.uuid4()))
context = data.get('context', [])
model = data.get('model', 'llama3')
api_url = data.get('api_url', DEFAULT_OLLAMA_API_URL)
if not message:
logger.warning("Empty message in /chat request")
return Response(f"data: {json.dumps({'error': '消息不能为空'}, ensure_ascii=False)}\n\n", mimetype="text/event-stream")
try:
requests.get(f"{api_url}/api/tags", timeout=5)
except requests.exceptions.RequestException:
logger.error(f"Ollama service unavailable at: {api_url}", exc_info=True)
return Response(f"data: {json.dumps({'error': f'Ollama 服务不可用: {api_url},请检查地址或配置'}, ensure_ascii=False)}\n\n", mimetype="text/event-stream")
urls = extract_urls(message)
url_content_text = "".join(f"\n#### 来自 {url} 的内容:\n{fetch_url_content(url)['text']}\n" for url in urls)
normalized_context = normalize_context(context)
sessions[session_id].setdefault("messages", []).append({'role': 'user', 'parts': [{"text": message}], 'timestamp': datetime.now().isoformat()})
return generate_ollama_stream(message, session_id, normalized_context, url_content_text, model, api_url)
except ValueError as ve:
logger.error(f"JSON parsing error in /chat request: {str(ve)}", exc_info=True)
return Response(f"data: {json.dumps({'error': '请求体JSON解析失败'}, ensure_ascii=False)}\n\n", mimetype="text/event-stream")
except Exception as e:
logger.error(f"Request processing failed for /chat: {str(e)}", exc_info=True)
return Response(f"data: {json.dumps({'error': f'服务器内部错误: {str(e)}'}, ensure_ascii=False)}\n\n", mimetype="text/event-stream")
@app.route('/models', methods=['POST', 'GET'])
def get_models():
try:
if request.method == 'POST':
data = request.get_json(silent=True)
api_url = data.get('api_url', DEFAULT_OLLAMA_API_URL) if data else DEFAULT_OLLAMA_API_URL
else:
api_url = DEFAULT_OLLAMA_API_URL
response = requests.get(f"{api_url}/api/tags")
response.raise_for_status()
models_data = response.json()
models = [model["name"] for model in models_data.get("models", [])]
result = {"models": models}
return json.dumps(result, ensure_ascii=False)
except requests.exceptions.RequestException as e:
logger.error(f"Failed to fetch model list from Ollama API: {str(e)} at {api_url}", exc_info=True)
return json.dumps({"error": f"获取模型列表失败: {str(e)}"}, ensure_ascii=False)
except Exception as e:
logger.error(f"Error getting model list: {str(e)}", exc_info=True)
return json.dumps({"error": f"获取模型列表失败: {str(e)}"}, ensure_ascii=False)
@app.route('/')
def index():
return render_template_string(r'''<!DOCTYPE html>
<html lang="zh" data-theme="light">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>土地管理业务咨询AI</title>
<link rel="stylesheet" href="/static//github-dark.min.css">
<script src="/static//marked.umd.min.js"></script>
<script src="/static//highlight.min.js"></script>
<style>
:root {
--font-family: 'Arial', Arial, bold;
--light-bg: #ffffff;
--light-text: #24292e;
--light-border: #d0d7de;
--light-shadow: rgba(0, 0, 0, 0.05);
--light-hover: #f6f8fa;
--light-code-bg: #f8f9fa;
--light-code-text: #24292e;
--light-button-bg: #f0f2f5;
--light-button-hover: #e0e2e5;
--light-ai-bg: #f2f2f7;
--light-user-bg: #e0f7fa;
--light-markdown-bg: #f0f0f0;
--light-link-color: #0969da;
--light-secondary: #57606a;
--dark-bg: #1e1e1e;
--dark-text: #d4d4d4;
--dark-border: #30363d;
--dark-shadow: rgba(255, 255, 255, 0.05);
--dark-hover: #2a2d2e;
--dark-code-bg: #2d2d2d;
--dark-code-text: #d4d4d4;
--dark-button-bg: #30363d;
--dark-button-hover: #3a3f44;
--dark-ai-bg: #2a2a2d;
--dark-user-bg: #29434e;
--dark-markdown-bg: #2a2a2b;
--dark-link-color: #ffffff;
--dark-secondary: #8b949e;
}
[data-theme="light"] {
--bg: var(--light-bg);
--text: var(--light-text);
--border: var(--light-border);
--shadow: var(--light-shadow);
--hover: var(--light-hover);
--code-bg: var(--light-code-bg);
--code-text: var(--light-code-text);
--button-bg: var(--light-button-bg);
--button-hover: var(--light-button-hover);
--ai-bg: var(--light-ai-bg);
--user-bg: var(--light-user-bg);
--markdown-bg: var(--light-markdown-bg);
--link-color:#000000;
--secondary: var(--light-secondary);
}
[data-theme="dark"] {
--bg: var(--dark-bg);
--text: var(--dark-text);
--border: var(--dark-border);
--shadow: var(--dark-shadow);
--hover: var(--dark-hover);
--code-bg: var(--dark-code-bg);
--code-text: var(--dark-code-text);
--button-bg: var(--dark-button-bg);
--button-hover: var(--dark-button-hover);
--ai-bg: var(--dark-ai-bg);
--user-bg: var(--dark-user-bg);
--dark-markdown-bg: var(--dark-markdown-bg);
--link-color: var(--dark-link-color);
--secondary: var(--dark-secondary);
}
body {
font-family: var(--font-family);
background-color: var(--bg);
color: var(--text);
line-height: 1.6;
font-size: 16px;
margin: 0;
padding: 0;
min-height: 100vh;
transition: background-color 0.3s, color 0.3s;
-webkit-font-smoothing: antialiased;
}
.container {
display: flex;
width: 100%;
max-width: 1400px;
margin: 0 auto;
height: 100vh;
border: 1px solid var(--border);
background: var(--bg);
box-shadow: 0 2px 10px var(--shadow);
border-radius: 8px;
overflow: hidden;
}
.sidebar {
width: 25%;
max-width: 350px;
background: var(--light-bg);
border-right: 1px solid var(--border);
height: 100vh;
overflow-y: auto;
position: fixed;
left: -350px;
top: 0;
transition: left 0.3s ease;
z-index: 1002;
display: flex;
flex-direction: column;
}
[data-theme="dark"] .sidebar {
background: var(--dark-bg);
}
.sidebar.active { left: 0; }
.theme-toggle, .new-chat-btn, .menu-toggle, .clear-history, .history-search, .model-select, .settings-panel button, .code-actions button, #send-button, #stop-button, .settings-toggle {
transition: background-color 0.3s, transform 0.1s, color 0.3s, border-color 0.3s;
box-shadow: 0 1px 3px var(--shadow);
font-weight: 500;
}
.theme-toggle {
margin: 20px 8%;
padding: 12px;
background: var(--button-bg);
color: var(--text);
border: none;
border-radius: 6px;
cursor: pointer;
}
.theme-toggle:hover { background: var(--button-hover); transform: translateY(-1px); }
.menu-toggle {
position: fixed;
top: 10px;
left: 10px;
background: var(--button-bg);
border: none;
border-radius: 6px;
cursor: pointer;
z-index: 1003;
padding: 8px;
}
.menu-toggle:hover { background: var(--button-hover); }
.menu-toggle.hidden { display: none; }
.new-chat-btn {
position: fixed;
top: 10px;
right: 10px;
padding: 8px;
background: var(--button-bg);
color: var(--text);
border: none;
border-radius: 6px;
cursor: pointer;
display: flex;
align-items: center;
justify-content: center;
gap: 8px;
width: 40px;
height: 40px;
z-index: 1003;
}
.new-chat-btn:hover { background: var(--button-hover); transform: translateY(-1px); }
.history-search {
margin: 8% 8% 5%;
padding: 12px;
border: 1px solid var(--border);
border-radius: 6px;
width: 85%;
font-size: 16px;
background: var(--bg);
color: var(--text);
caret-color: var(--link-color);
box-shadow: inset 0 1px 3px var(--shadow);
}
.history-search:focus { border-color: var(--link-color); outline: none; }
.chat-history {
flex: 1;
overflow-y: auto;
padding: 0 5%;
scrollbar-width: thin;
scrollbar-color: var(--secondary) var(--bg);
}
.chat-history::-webkit-scrollbar { width: 8px; }
.chat-history::-webkit-scrollbar-thumb { background: var(--secondary); border-radius: 4px; }
.history-item {
padding: 12px;
border-bottom: 1px solid var(--border);
cursor: pointer;
border-radius: 6px;
margin: 5px 0;
font-size: 16px;
color: var(--text);
overflow-wrap: break-word;
}
.history-item:hover { background: var(--hover); }
.history-item.active { background: var(--ai-bg); }
.history-item .title { font-weight: 500; font-size: 18px; color: var(--link-color); }
.history-item .preview { font-size: 14px; color: var(--secondary); margin-top: 5px; }
.history-item .time { font-size: 12px; color: var(--secondary); margin-top: 5px; display: block; }
.clear-history-container {
position: sticky;
bottom: 0;
padding: 10px 8%;
background: var(--light-bg);
border-top: 1px solid var(--border);
}
[data-theme="dark"] .clear-history-container {
background: var(--dark-bg);
}
.clear-history {
padding: 12px 20px;
background: var(--button-bg);
color: var(--text);
border: none;
border-radius: 6px;
cursor: pointer;
width: 100%;
font-size: 18px;
display: flex;
justify-content: center;
}
.clear-history:hover { background: var(--button-hover); transform: translateY(-1px); }
.chat-container {
flex: 3;
display: flex;
flex-direction: column;
padding: 20px;
background: var(--bg);
width: 100%;
overflow-y: auto;
}
.chat-messages {
flex: 1;
overflow-y: auto;
padding: 0 10px;
scrollbar-width: thin;
scrollbar-color: var(--secondary) var(--bg);
display: flex;
flex-direction: column;
}
.chat-messages::-webkit-scrollbar { width: 8px; }
.chat-messages::-webkit-scrollbar-thumb { background: var(--secondary); border-radius: 4px; }
.message {
display: flex;
margin: 12px 0;
max-width: 80%;
border-radius: 8px;
animation: fadeIn 0.3s ease;
font-size: 16px;
overflow-wrap: break-word;
box-shadow: 0 1px 3px var(--shadow);
padding: 0;
}
@keyframes fadeIn { from { opacity: 0; transform: translateY(5px); } to { opacity: 1; transform: translateY(0); } }
.message.user {
margin-left: auto;
background: #000000;
color: #ffffff;
border-radius: 4px 0 4px 4px;
max-width: 70%;
}
.message.ai {
margin-right: auto;
background: var(--ai-bg);
color: var(--text);
border-radius: 0 4px 4px 4px;
max-width: 70%;
}
.message-content {
line-height: 1.6;
overflow-wrap: break-word;
word-break: break-word;
width: 100%;
padding: 12px 22px;
position: relative;
user-select: text;
}
.message-content p { margin: 12px 0; }
.message-content a { color: var(--link-color); text-decoration: none; font-weight: 600; border-bottom: 1px solid var(--link-color); padding-bottom: 2px;}
.message-content a:hover { text-decoration: underline; }
.message-content ul, .message-content ol { padding-left: 22px; margin: 12px 0; }
.message-content li { margin: 6px 0; }
.message-content details { margin: 12px 0; }
.message-content summary { cursor: pointer; font-weight: 600; padding: 6px; background-color: var(--markdown-bg); border-radius: 4px; padding: 10px; margin-bottom: 5px;}
/* 思考过程专属样式 */
.think-block {
margin: 12px 0;
border-left: 3px solid var(--secondary); /* 左侧灰色线条 */
background: var(--markdown-bg);
border-radius: 4px;
padding: 0 10px;
}
.think-block summary {
cursor: pointer;
font-weight: 500;
font-size: 14px; /* 标题也小一点 */
color: var(--secondary); /* 颜色淡一点 */
padding: 8px 0;
user-select: none;
opacity: 0.85;
}
.think-block .think-content {
font-size: 14px; /* 字号小一点 */
color: var(--secondary); /* 颜色淡一点 */
opacity: 0.8; /* 再稍微淡化一点 */
line-height: 1.5;
padding-bottom: 10px;
border-top: 1px dashed var(--border);
margin-top: 5px;
padding-top: 10px;
}
/* 调整思考内容内部的 Markdown 元素间距 */
.think-block .think-content p {
margin: 6px 0;
}
.think-block .think-content pre {
font-size: 12px;
}
.message-content details[open] summary { border-bottom: 1px solid var(--border); }
.message-content img { max-width: 100%; height: auto; margin: 12px 0; border-radius: 4px; }
.message-content blockquote {
margin: 12px 0;
padding: 12px 17px;
background: var(--markdown-bg);
border-left: 4px solid var(--link-color);
color: var(--text);
font-style: italic;
border-radius: 4px;
}
.message-content h1, .message-content h2, .message-content h3, .message-content h4, .message-content h5, .message-content h6 {
margin: 17px 0 12px;
color: var(--link-color);
font-weight: 700;
line-height: 1.3;
}
.message-content h1 { font-size: 2.2em; }
.message-content h2 { font-size: 1.8em; }
.message-content h3 { font-size: 1.6em; }
.message-content h4 { font-size: 1.4em; }
.message-content h5 { font-size: 1.2em; }
.message-content h6 { font-size: 1.1em; }
.message-content table {
width: 100%;
border-collapse: collapse;
margin: 12px 0;
background: var(--bg);
border: 1px solid var(--border);
}
.message-content th, .message-content td { padding: 9px 14px; border: 1px solid var(--border); text-align: left; }
.message-content th { background: var(--ai-bg); font-weight: 600; color: var(--link-color); }
.message-content pre {
background: var(--code-bg);
color: var(--code-text);
border-radius: 6px;
max-width: 99%;
font-size: 16px;
line-height: 1.6;
position: relative;
border: 1px solid var(--border);
padding: 10px;
overflow-x: auto;
white-space: pre-wrap;
}
.message-content code:not(pre code) {
background: #000000;
color:#ffffff;
padding: 3px 8px;
border-radius: 4px;
font-family: var(--font-family-mono);
font-size: 16px;
}
.message-content .katex {
display: inline-block;
vertical-align: middle;
max-width: 90%;
overflow-x: auto;
white-space: nowrap;
padding: 6px;
font-size: 1em;
color: var(--text);
}
.message-content .katex-display {
display: block;
max-width: 90%;
overflow-x: auto;
padding: 12px;
margin: 12px 0;
background: var(--markdown-bg);
border-radius: 4px;
color: var(--text);
text-align: center;
white-space: nowrap;
}
.code-actions {
position: absolute;
bottom: 9px;
right: 9px;
display: flex;
gap: 7px;
}
.code-actions button {
background:#f0f2f596;
color: var(--text);
border: none;
border-radius: 4px;
padding: 7px 14px;
font-size: 15px;
cursor: pointer;
}
.code-actions button:hover { background: var(--button-hover); transform: translateY(-1px); }
.loading-container {
display: flex;
justify-content: center;
align-items: center;
padding: 22px;
}
.loading-dots {
display: flex;
gap: 9px;
}
.loading-dots span {
width: 13px;
height: 13px;
background: var(--secondary);
border-radius: 50%;
animation: bounce 1.2s infinite ease-in-out both;
display: inline-block;
}
.loading-dots span:nth-child(1) { animation-delay: -0.32s; }
.loading-dots span:nth-child(2) { animation-delay: -0.16s; }
@keyframes bounce {
0%, 80%, 100% { transform: scale(0); }
40% { transform: scale(1); }
}
.input-container {
position: fixed;
bottom: 0;
left: 0;
right: 0;
padding: 17px;
border-top: 1px solid var(--border);
background: var(--bg);
z-index: 1000;
width: 100%;
max-width: 1400px;
margin: 0 auto;
display: flex;
flex-direction: column;
gap: 12px;
box-sizing: border-box;
}
.input-wrapper {
display: flex;
gap: 14px;
background: var(--bg);
border: 1px solid var(--border);
border-radius: 8px;
padding: 14px;
align-items: center;
flex: 1;
box-shadow: 0 2px 4px var(--shadow);
}
.input-wrapper:focus-within { border-color: var(--link-color); }
#message-input {
flex: 1;
border: none;
outline: none;
padding: 6px;
resize: none;
font-size: 16px;
background: transparent;
color: var(--text);
overflow-y: auto;
user-select: text;
white-space: pre-wrap;
caret-color: var(--link-color);
}
#send-button, #stop-button, .settings-toggle {
background: none;
border: none;
cursor: pointer;
padding: 9px;
color: var(--link-color);
}
#stop-button { display: none; }
.error-message {
color: #ff4444;
font-size: 16px;
margin: 12px 0;
text-align: center;
font-weight: 500;
}
.model-select-container {
margin: 20px 8%;
.model-select
width: 85%;
}
.model-select {
padding: 8px 12px;
background: var(--button-bg);
color: var(--text);
border: 1px solid var(--border);
border-radius: 6px;
font-size: 16px;
cursor: pointer;
appearance: none;
-webkit-appearance: none;
-moz-appearance: none;
width: 99%;
background-image: url("data:image/svg+xml,%3Csvg xmlns='http://www.w3.org/2000/svg' viewBox='0 0 24 24' fill='none' stroke='currentColor' stroke-width='2' stroke-linecap='round' stroke-linejoin='round'%3E%3Cpolyline points='6 9 12 15 18 9'%3E%3C/polyline%3E%3C/svg%3E");
background-repeat: no-repeat;
background-position: right 0.7rem center;
background-size: 1.5rem;
padding-right: 2.5rem;
}
.model-select:hover { background: var(--button-hover); border-color: var(--link-color); }
.settings-panel {
position: fixed;
top: 50%;
left: 50%;
transform: translate(-50%, -50%);
background: var(--bg);
border: 1px solid var(--border);
padding: 20px;
z-index: 1004;
display: none;
width: 300px;
box-shadow: 0 2px 10px var(--shadow);
border-radius: 8px;
}
.settings-panel h3 { margin: 0 0 15px; font-size: 20px; font-weight: 500; color: var(--link-color); }
.settings-panel input {
width: 100%;
padding: 10px;
margin: 10px 0;
background: var(--user-bg);
border: 1px solid var(--border);
color: var(--text);
font-size: 16px;
border-radius: 6px;
box-shadow: inset 0 1px 3px var(--shadow);
}
.settings-panel input:focus { border-color: var(--link-color); outline: none; }
.settings-panel button {
width: 100%;
padding: 12px;
background: var(--button-bg);
color: var(--text);
border: none;
cursor: pointer;
border-radius: 6px;
}
.small-text { font-size: 0.9em; color: var(--secondary); }
@media (max-width: 600px) {
.container { flex-direction: column; height: auto; border: none; border-radius: 0; }
.sidebar { width: 85%; max-width: none; height: 100vh; left: -100%; border-right: none; }
.sidebar.active { left: 0; }
.chat-container { padding: 12px; min-height: calc(100vh - 60px); margin-top: 50px; }
.chat-messages { max-height: calc(100vh - 150px); font-size: 15px; padding-bottom: 60px; padding: 20px; }
.input-container { padding: 12px; padding-bottom: env(safe-area-inset-bottom); max-width: 94%; gap: 9px; padding: 10px; }
.input-wrapper { padding: 9px; gap: 9px; width: 100%; }
.message { max-width: 100%; font-size: 15px; }
.menu-toggle { top: 6px; left: 6px; }
.new-chat-btn { top: 6px; right: 6px; width: 38px; height: 38px; }
.message-content { padding: 9px 17px; }
.message-content pre { font-size: 13px; }
.code-actions { bottom: 3px; right: 3px; }
.code-actions button { padding: 5px 10px; font-size: 13px; min-width: 50px; }
#message-input { font-size: 15px; }
.clear-history { font-size: 17px; padding: 11px 16px; }
.message-content .katex { font-size: 0.9em; padding: 4px; }
.message-content .katex-display { padding: 9px; margin: 9px 0; }
.history-item { font-size: 15px; padding: 10px; }
.history-item .title { font-size: 17px;color :#8a8a97 }
.history-item .preview { font-size: 13px; }
.history-item .time { font-size: 11px; }
.theme-toggle, .history-search, .clear-history { font-size: 17px; padding: 11px; }
.theme-toggle { margin: 15px 8%; }
.history-search { margin: 8% 8% 4%; padding: 10px; }
.clear-history-container { padding: 8px 8%; }
.settings-toggle, #send-button, #stop-button { padding: 7px; }
.settings-panel { width: 90%; }
}
</style>
<link rel="stylesheet" href="/static/katex.min.css">
<script defer src="/static/katex.min.js"></script>
<script defer src="/static/auto-render.min.js"></script>
</head>
<body>
<button class="menu-toggle">
<svg width="24" height="24" viewBox="0 0 24 24" fill="none">
<path d="M3 12h18M3 6h18M3 18h18" stroke="var(--link-color)" stroke-width="2" stroke-linecap="round"/>
</svg>
</button>
<button class="new-chat-btn" onclick="startNewChat()">
<svg width="16" height="16" viewBox="0 0 16 16" fill="none">
<path d="M8 3.33337V12.6667M3.33333 8H12.6667" stroke="var(--text)" stroke-width="2" stroke-linecap="round"/>
</svg>
</button>
<div class="container">
<div class="sidebar">
<button class="theme-toggle" onclick="toggleTheme()">切换主题</button>
<div class="model-select-container">
<select class="model-select" id="model-select" onchange="changeModel(this.value)">
<option value="llama3">加载模型...</option>
</select>
</div>
<input type="text" class="history-search" placeholder="搜索历史记录...">
<div class="chat-history"></div>
<div class="clear-history-container">
<button class="clear-history" onclick="clearHistory()">清除记录</button>
</div>
</div>
<div class="chat-container">
<div class="chat-messages"></div>
<div class="input-container">
<div class="input-wrapper">
<button class="settings-toggle" id="settings-toggle" title="设置 API" onclick="toggleSettings()">
<svg width="16" height="16" viewBox="0 0 16 16" fill="none">
<path d="M13.5 9.5a1.5 1.5 0 0 1-1.5 1.5h-1a1.5 1.5 0 0 1-1.5-1.5V6.5a1.5 1.5 0 0 1 1.5-1.5h1a1.5 1.5 0 0 1 1.5 1.5v3zM7 9.5a1.5 1.5 0 0 1-1.5 1.5h-1A1.5 1.5 0 0 1 3 9.5V6.5A1.5 1.5 0 0 1 4.5 5h1A1.5 1.5 0 0 1 7 6.5v3z" stroke="var(--link-color)" stroke-width="2"/>
</svg>
</button>
<textarea id="message-input" placeholder="输入消息..." rows="1"></textarea>
<button id="send-button">
<svg width="16" height="16" viewBox="0 0 16 16" fill="none">
<path d="M14.6667 1.33337L7.33333 8.66671M14.6667 1.33337L10 14.6667L7.33333 8.66671L1.33333 6.00004L14.6667 1.33337Z" stroke="var(--link-color)" stroke-width="2" stroke-linecap="round" stroke-linejoin="round"/>
</svg>
</button>
<button id="stop-button" onclick="stopGenerating()">
<svg width="16" height="16" viewBox="0 0 16 16" fill="none">
<path d="M4 4H12V12H4V4Z" stroke="var(--link-color)" stroke-width="2" stroke-linejoin="round"/>
</svg>
</button>
</div>
</div>
</div>
</div>
<div id="settings-panel" class="settings-panel">
<h3>API 设置</h3>
<input type="text" id="api-ip" placeholder="IP (默认: localhost)">
<input type="text" id="api-port" placeholder="端口 (默认: 11434)">
<button onclick="saveSettings()">保存并应用</button>
</div>
<div id="html-preview-modal" style="display: none; position: fixed; top: 0; left: 0; width: 100%; height: 100%; background: rgba(0, 0, 0, 0.6); z-index: 1001; overflow: auto;">
<div style="background: var(--bg); margin: 10% auto; padding: 20px; border-radius: 8px; width: 90%; max-width: 800px; position: relative; box-shadow: 0 4px 12px var(--shadow);">
<button id="close-preview" style="position: absolute; right: 5px; top: 10px; background: none; border: none; cursor: pointer; font-size: 1.5rem; color: var(--text);" onclick="htmlPreviewModal.style.display='none';">×</button>
<iframe id="html-preview-content" style="width: 100%; height: 500px; border: none;"></iframe>
</div>
</div>
<script>
function toggleTheme() {
const html = document.documentElement;
const currentTheme = html.getAttribute('data-theme');
const newTheme = currentTheme === 'light' ? 'dark' : 'light';
html.setAttribute('data-theme', newTheme);
localStorage.setItem('theme', newTheme);
updateModelSelectArrowColor();
sidebar.classList.remove('active');
menuToggle.classList.remove('hidden');
}
function updateModelSelectArrowColor() {
const modelSelect = document.getElementById('model-select');
}
function hasMath(content) {
return /\$[\s\S]+?\$|\$\$[\s\S]+?\$\$|\\\[[\s\S]+?\\\]|\\\(.*?\\\)|\\begin\{[a-z]*\*?\}\s*[^]*?\\end\{[a-z]*\*?\}/.test(content);
}
function renderMath(contentDiv) {
contentDiv.querySelectorAll('.katex').forEach(el => el.outerHTML = el.innerHTML);
renderMathInElement(contentDiv, {
delimiters: [
{ left: "\\[", right: "\\]", display: true },
{ left: "$$", right: "$$", display: true },
{ left: "[", right: "]", display: true },
{ left: "$", right: "$", display: false },
{ left: "\\(", right: "\\)", display: false },
{ left: "\\begin{equation}", right: "\\end{equation}", display: true },
{ left: "\\begin{align*}", right: "\\end{align*}", display: true },
{ left: "\\begin{matrix}", right: "\\end{matrix}", display: true }
],
throwOnError: false,
strict: "ignore",
trust: true,
macros: { "\\RR": "\\mathbb{R}", "\\NN": "\\mathbb{N}", "\\ZZ": "\\mathbb{Z}", "\\CC": "\\mathbb{C}" },
errorColor: '#ff4444'
});
}
function escapeHtml(unsafe) {
return unsafe
.replace(/&/g, "&")
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/"/g, '""')
.replace(/'/g, "'");
}
const Config = {
MAX_CONTEXT_LENGTH: 10,
MAX_MESSAGE_LENGTH: 65536,
CHUNK_SIZE: 4096,
DEFAULT_API_URL: "http://localhost:11434"
};
let conversations = JSON.parse(localStorage.getItem('conversations')) || [];
let currentConversationId = localStorage.getItem('currentConversationId') || Date.now().toString();
let generation_statuses = {};
let currentContext = [];
let eventSource = null;
let isGenerating = false;
let apiUrl = localStorage.getItem('apiUrl') || Config.DEFAULT_API_URL;
let currentModel = localStorage.getItem('currentModel') || "llama3";
const chatMessages = document.querySelector('.chat-messages');
const messageInput = document.querySelector('#message-input');
const sendButton = document.querySelector('#send-button');
const stopButton = document.querySelector('#stop-button');
const settingsToggle = document.querySelector('#settings-toggle');
const sidebar = document.querySelector('.sidebar');
const menuToggle = document.querySelector('.menu-toggle');
const newChatBtn = document.querySelector('.new-chat-btn');
const historySearch = document.querySelector('.history-search');
const htmlPreviewModal = document.querySelector('#html-preview-modal');
const htmlPreviewContent = document.querySelector('#html-preview-content');
const settingsPanel = document.querySelector('#settings-panel');
const apiIpInput = document.querySelector('#api-ip');
const apiPortInput = document.querySelector('#api-port');
const modelSelect = document.getElementById('model-select');
function initializeChat() {
conversations.forEach(conv => {
conv.messages.forEach(msg => {
if (msg.content && !msg.parts) {
msg.parts = [{"text": msg.content}];
delete msg.content;
}
if (msg.role === "assistant") msg.role = "model";
if (msg.role === "system") msg.role = "user";
});
});
loadConversation(currentConversationId);
updateChatHistory();
setupEventListeners();
adjustInputHeight();
adjustContainerHeight();
setTimeout(() => messageInput.focus(), 100);
generation_statuses[currentConversationId] = { generating: false };
loadModelsIntoSelector();
updateModelSelectArrowColor();
}
async function loadModelsIntoSelector() {
await fetchModels();
modelSelect.value = currentModel;
}
function setupEventListeners() {
menuToggle.addEventListener('click', () => { sidebar.classList.toggle('active'); menuToggle.classList.toggle('hidden'); });
document.addEventListener('click', e => {
if (!sidebar.contains(e.target) && !menuToggle.contains(e.target) && sidebar.classList.contains('active')) { sidebar.classList.remove('active'); menuToggle.classList.remove('hidden'); }
if (!settingsPanel.contains(e.target) && !settingsToggle.contains(e.target) && settingsPanel.style.display === 'block') { settingsPanel.style.display = 'none'; }
});
sendButton.addEventListener('click', () => debounce(sendMessage, 100)());
messageInput.addEventListener('keydown', e => { if (e.key === 'Enter' && !e.shiftKey) { e.preventDefault(); debounce(sendMessage, 100)(); } });
messageInput.addEventListener('input', adjustInputHeight);
historySearch.addEventListener('input', debounce(e => updateChatHistory(e.target.value.toLowerCase()), 300));
window.addEventListener('resize', adjustContainerHeight);
}
function debounce(func, wait) { let timeout; return function (...args) { clearTimeout(timeout); timeout = setTimeout(() => func.apply(this, args), wait); }; }
function adjustInputHeight() {
messageInput.style.height = 'auto';
const lines = messageInput.value.split('\n').length;
const baseHeight = 24;
const height = Math.max(1, Math.min(lines, 5)) * baseHeight + 10;
messageInput.style.height = `${Math.min(height, window.innerHeight * 0.2)}px`;
sendButton.disabled = !messageInput.value.trim();
adjustContainerHeight();
}
function adjustContainerHeight() {
const inputContainer = document.querySelector('.input-container');
const chatContainer = document.querySelector('.chat-container');
const totalHeight = window.innerHeight;
const inputHeight = inputContainer.offsetHeight;
chatContainer.style.height = `${totalHeight - inputHeight - 50}px`;
chatContainer.style.paddingBottom = `${inputHeight + 20}px`;
}
function updateChatHistory(searchTerm = '') {
const chatHistory = document.querySelector('.chat-history');
chatHistory.innerHTML = '';
const filteredConversations = conversations
.sort((a, b) => new Date(b.messages?.slice(-1)[0]?.timestamp || 0) - new Date(a.messages?.slice(-1)[0]?.timestamp || 0))
.filter(c => !searchTerm || c.messages.some(m => m.parts?.[0]?.text?.toLowerCase().includes(searchTerm)));
const initialLoad = filteredConversations.slice(0, 20);
initialLoad.forEach(c => renderHistoryItem(c, chatHistory));
let loadedCount = initialLoad.length;
const handleScroll = () => { if (chatHistory.scrollTop + chatHistory.clientHeight >= chatHistory.scrollHeight - 50 && loadedCount < filteredConversations.length) { const nextBatch = filteredConversations.slice(loadedCount, loadedCount + 10); nextBatch.forEach(c => renderHistoryItem(c, chatHistory)); loadedCount += 10; } };
chatHistory.removeEventListener('scroll', handleScroll);
chatHistory.addEventListener('scroll', handleScroll);
}
function renderHistoryItem(c, chatHistory) {
if (!c.messages?.length) return;
const firstUserMessage = c.messages.find(m => m.role === 'user');
const titleText = firstUserMessage?.parts?.[0]?.text?.slice(0, 30) + (firstUserMessage?.parts?.[0]?.text?.length > 30 ? '...' : '') || '新对话';
const div = document.createElement('div');
div.className = `history-item ${c.id === currentConversationId ? 'active' : ''}`;
div.innerHTML = `<div class="title">${escapeHtml(titleText)}</div><div class="preview">${c.messages.slice(-2).map(m => `<div>${escapeHtml(m.parts?.[0]?.text?.slice(0, 50) || '')}${m.parts?.[0]?.text?.length > 50 ? '...' : ''}</div>`).join('')}</div><div class="time">${new Date(c.messages.slice(-1)[0].timestamp).toLocaleString()}</div>`;
div.onclick = () => loadConversation(c.id);
chatHistory.appendChild(div);
}
function loadConversation(id) {
currentConversationId = id;
localStorage.setItem('currentConversationId', id);
const conversation = conversations.find(c => c.id === id);
if (!conversation) return;
chatMessages.innerHTML = '';
conversation.messages.forEach(msg => { addMessage(msg.parts.find(part => part.text)?.text || '', msg.role === 'user' ? 'user' : 'ai'); });
currentContext = conversation.messages.map(msg => ({ role: msg.role, parts: msg.parts.map(part => ({text: part.text})) }));
updateChatHistory();
sidebar.classList.remove('active');
menuToggle.classList.remove('hidden');
scrollToBottom();
if (!generation_statuses[currentConversationId]) generation_statuses[currentConversationId] = { generating: false };
}
async function addMessage(text, type = 'user') {
const messageDiv = document.createElement('div');
messageDiv.className = `message ${type}`;
const contentDiv = document.createElement('div');
contentDiv.className = 'message-content';
messageDiv.appendChild(contentDiv);
chatMessages.appendChild(messageDiv);
let content = text || '(无内容)';
if (type === 'user') {
contentDiv.innerText = content;
} else {
content = content;
// 处理历史记录中的 think 标签
let displayText = content;
let thinkText = '';
const thinkEndIndex = content.indexOf('</think>');
if (thinkEndIndex !== -1) {
thinkText = content.substring(0, thinkEndIndex + 8);
displayText = content.substring(thinkEndIndex + 8);
}
let html = '';
if (displayText) {
html += await marked.parse(displayText);
}
if (thinkText) {
html += `<details class="think-block"><summary>思考过程</summary><div class="think-content">${await marked.parse(thinkText.replace(/<\/?think>/g, ''))}</div></details>`;
}
contentDiv.innerHTML = html || '(AI 未返回内容)';
addCodeActions(contentDiv);
hljs.highlightAll();
if (hasMath(displayText)) {
renderMath(contentDiv);
}
}
scrollToBottom();
}
function addCodeActions(contentDiv) {
contentDiv.querySelectorAll('pre code').forEach(block => {
if (block.parentNode.querySelector('.code-actions')) return;
const pre = block.parentNode;
const actions = document.createElement('div');
actions.className = 'code-actions';
const isHtml = block.textContent.trim().toLowerCase().startsWith('<!doctype html') || block.textContent.trim().startsWith('<html');
actions.innerHTML = `<button onclick="copyCode(this)">复制</button>${isHtml ? '<button onclick="previewHTML(this)">预览</button>' : ''}`;
pre.style.position = 'relative';
pre.appendChild(actions);
});
}
function copyCode(button) {
const codeBlock = button.closest('pre').querySelector('code');
navigator.clipboard.writeText(codeBlock.textContent).then(() => showCopyFeedback(button, '已复制')).catch(() => showCopyFeedback(button, '复制失败'));
}
function showCopyFeedback(button, text) { const originalText = button.textContent; button.textContent = text; button.disabled = true; setTimeout(() => { button.textContent = originalText; button.disabled = false; }, 2000); }
function previewHTML(button) { const code = button.closest('pre').querySelector('code').textContent; htmlPreviewContent.srcdoc = code; htmlPreviewModal.style.display = 'block'; }
function toggleSettings() { settingsPanel.style.display = settingsPanel.style.display === 'block' ? 'none' : 'block'; apiIpInput.value = localStorage.getItem('apiIp') || ''; apiPortInput.value = localStorage.getItem('apiPort') || ''; }
function saveSettings() {
const ip = apiIpInput.value.trim();
const port = apiPortInput.value.trim();
if (ip && port) { apiUrl = `http://${ip}:${port}`; localStorage.setItem('apiUrl', apiUrl); localStorage.setItem('apiIp', ip); localStorage.setItem('apiPort', port); } else { apiUrl = Config.DEFAULT_API_URL; localStorage.removeItem('apiUrl'); localStorage.removeItem('apiIp'); localStorage.removeItem('apiPort'); }
settingsPanel.style.display = 'none';
fetchModels();
}
async function fetchModels() {
try {
const response = await fetch('/models', { method: 'POST', headers: { 'Content-Type': 'application/json' }, body: JSON.stringify({ api_url: apiUrl }) });
const data = await response.json();
modelSelect.innerHTML = '';
if (data.models) { data.models.forEach(model => { const option = document.createElement('option'); option.value = model; option.text = model; if (model === currentModel) option.selected = true; modelSelect.appendChild(option); }); } else { modelSelect.innerHTML = '<option value="llama3">llama3 (默认)</option>'; }
} catch (e) { console.error("获取模型列表失败:", e); modelSelect.innerHTML = '<option value="llama3">llama3 (默认)</option>'; addMessage(`无法连接到 Ollama 服务: ${apiUrl},请检查 API 设置`, 'ai'); }
}
function changeModel(model) { currentModel = model; localStorage.setItem('currentModel', currentModel); console.log("当前模型切换为:", currentModel); }
async function sendMessage() {
if (!messageInput.value || isGenerating) return;
startGeneratingState();
if (eventSource) {
if (eventSource.close) {
eventSource.close();
}
eventSource = null;
}
const message = messageInput.value || "";
messageInput.value = '';
adjustInputHeight();
const userParts = [{"text": message}];
currentContext.push({ role: 'user', parts: userParts });
await addMessage(message, 'user');
const loadingDiv = addLoadingMessage();
try {
const endpoint = '/chat';
const encodedMessage = encodeURIComponent(message || " ");
const payload = { message: encodedMessage, session_id: currentConversationId, context: currentContext, model: currentModel, api_url: apiUrl };
console.log("发送请求:", JSON.stringify(payload));
const response = await fetch(endpoint, { method: 'POST', headers: { 'Content-Type': 'application/json' }, body: JSON.stringify(payload) });
if (!response.ok) throw new Error(`服务器错误: ${response.status} ${response.statusText}`);
let accumulatedText = '';
const aiMessageDiv = document.createElement('div');
aiMessageDiv.className = 'message ai';
const contentDiv = document.createElement('div');
contentDiv.className = 'message-content';
aiMessageDiv.appendChild(contentDiv);
chatMessages.replaceChild(aiMessageDiv, loadingDiv);
const reader = response.body.getReader();
const decoder = new TextDecoder();
eventSource = { close: () => { stopGenerating(); if(reader && reader.cancel) reader.cancel().catch(err => console.error("取消 reader 错误:", err)); eventSource = null; } };
async function processStream() {
isGenerating = true;
let buffer = '';
while (isGenerating) {
try {
const { done, value } = await reader.read();
if (done) {
if (!accumulatedText) accumulatedText = '(无回答)';
currentContext.push({ role: 'model', parts: [{"text": accumulatedText}] });
currentContext = currentContext.slice(-Config.MAX_CONTEXT_LENGTH);
saveToHistory(message, accumulatedText);
endGeneratingState();
eventSource = null;
scrollToBottom();
return;
}
buffer += decoder.decode(value, { stream: true });
let lines = buffer.split('\n');
buffer = lines.pop(); // 保留最后不完整的一行
for (const line of lines) {
if (line.trim() === '') continue;
if (line.startsWith('data: ')) {
try {
const data = JSON.parse(line.slice(6));
if (data.text) {
accumulatedText += data.text; // 使用累加,因为 /api/chat 返回的是增量
// 处理 DeepSeek 的 think 标签
let displayText = accumulatedText;
let thinkText = '';
const thinkStartIndex = accumulatedText.indexOf(' thinking');
const thinkEndIndex = accumulatedText.indexOf('</think>');
if (thinkEndIndex !== -1) {
// 找到了结束标签
if (thinkStartIndex !== -1) {
// 有开始也有结束,正常分割
thinkText = accumulatedText.substring(thinkStartIndex, thinkEndIndex + 8);
displayText = accumulatedText.substring(thinkEndIndex + 8).trim();
} else {
// 只有结束标签(容错),前部分全是思考
thinkText = accumulatedText.substring(0, thinkEndIndex + 8);
displayText = accumulatedText.substring(thinkEndIndex + 8).trim();
}
} else if (thinkStartIndex !== -1) {
// 只有开始标签,正在思考中
thinkText = accumulatedText;
displayText = '';
} else {
// 完全没有 think 标签,直接回答
thinkText = '';
displayText = accumulatedText;
}
// 组装最终的 HTML
let html = '';
if (thinkText) {
html += `<details class="think-block"><summary>思考过程</summary><div class="think-content">${await marked.parse(thinkText.replace(/<\/?think>/g, ''))}</div></details>`;
}
if (displayText) {
html += await marked.parse(displayText);
} else if (thinkEndIndex !== -1) {
// 思考已结束,但正文还没生成出来,显示加载动画
html += '<div class="loading-container" style="padding: 10px;"><div class="loading-dots"><span></span><span></span><span></span></div></div>';
}
contentDiv.innerHTML = html;
addCodeActions(contentDiv);
hljs.highlightAll();
if (hasMath(displayText)) renderMath(contentDiv);
scrollToBottom();
}
} catch (e) {
console.error("解析 stream 错误:", e, "原始数据:", line);
}
}
}
} catch (streamError) {
console.error("Stream reading error:", streamError);
reader.cancel().catch(cancelErr => console.error("Error cancelling reader:", cancelErr));
addMessage(`发生错误: Stream reading error - ${streamError.message || 'Unknown stream error'}`, 'ai');
saveToHistory(message, `[Stream Error: ${streamError.message}]`);
endGeneratingState();
eventSource = null;
scrollToBottom();
return;
}
}
if(reader && reader.cancel) reader.cancel();
endGeneratingState();
eventSource = null;
scrollToBottom();
}
processStream();
} catch (error) { console.error("Fetch 错误:", error); chatMessages.removeChild(loadingDiv); addMessage(`发生错误: ${error.message || '未知错误'}`, 'ai'); saveToHistory(message, `[请求错误: ${error.message}]`); endGeneratingState(); eventSource = null; scrollToBottom(); }
}
function scrollToBottom() { const scrollOptions = { top: chatMessages.scrollHeight, behavior: 'smooth' }; chatMessages.scrollTop = chatMessages.scrollHeight; requestAnimationFrame(() => chatMessages.scrollTo(scrollOptions)); }
function stopGenerating() {
generation_statuses[currentConversationId]["generating"] = false;
if (eventSource) {
if (eventSource.close) {
eventSource.close();
}
eventSource = null;
}
isGenerating = false;
endGeneratingState();
}
function startGeneratingState() { isGenerating = true; sendButton.style.display = 'none'; stopButton.style.display = 'inline-block'; }
function endGeneratingState() { isGenerating = false; sendButton.style.display = 'inline-block'; stopButton.style.display = 'none'; }
function addLoadingMessage() { const div = document.createElement('div'); div.className = 'message ai'; div.innerHTML = `<div class="message-content"><div class="loading-container"><div class="loading-dots"><span></span><span></span><span></span></div></div></div>`; chatMessages.appendChild(div); scrollToBottom(); return div; }
function saveToHistory(message, response) {
let conversation = conversations.find(c => c.id === currentConversationId);
if (!conversation) { conversation = { id: currentConversationId, messages: [] }; conversations.push(conversation); }
const userParts = [{"text": message}];
conversation.messages.push( { role: 'user', parts: userParts, timestamp: new Date().toISOString() }, { role: 'model', parts: [{"text": response}], timestamp: new Date().toISOString() } );
localStorage.setItem('conversations', JSON.stringify(conversations));
updateChatHistory();
}
function startNewChat() {
if (isGenerating) stopGenerating();
currentConversationId = Date.now().toString();
localStorage.setItem('currentConversationId', currentConversationId);
chatMessages.innerHTML = '';
messageInput.placeholder = "输入消息...";
currentContext = [];
conversations.push({ id: currentConversationId, messages: [] });
localStorage.setItem('conversations', JSON.stringify(conversations));
updateChatHistory();
sidebar.classList.remove('active');
menuToggle.classList.remove('hidden');
endGeneratingState();
generation_statuses[currentConversationId] = { generating: false };
adjustContainerHeight();
}
function clearHistory() { if (confirm('确定要清除历史记录?')) { if (isGenerating) stopGenerating(); conversations = []; localStorage.setItem('conversations', JSON.stringify(conversations)); startNewChat(); } }
marked.setOptions({ gfm: true, tables: true, breaks: true, highlight: function(code, lang) { const escapedCode = escapeHtml(code); return lang && hljs.getLanguage(lang) ? hljs.highlight(escapedCode, { language: lang }).value : escapedCode; } });
document.addEventListener('DOMContentLoaded', () => {
const savedTheme = localStorage.getItem('theme');
document.documentElement.setAttribute('data-theme', savedTheme || 'light');
fetchModels();
initializeChat();
});
</script>
</body>
</html>
''')
def run_app():
app.run(host='0.0.0.0', port=5200, debug=False, threaded=True)6. deepseek训练数据集的制作
6.1 训练数据预处理
参考我的另一篇文章:自然语言大模型训练数据------高质量问答对的数据蒸馏
(1)一问一答严格按照"用户提问-ai回答"的格式组织文本,没有空行,示例如下:
xml
你好,请问今天天气怎么样?
今天天气晴朗,气温15-25℃。
明天呢?
明天多云,可能有小雨。
请问临时用地需要审批吗?
需要。根据《土地管理法》第五十七条,临时用地需经县级以上自然资源主管部门批准。
审批需要哪些材料?
通常需要申请书、项目批准文件、土地权属证明、复垦方案等。
(2)连续问答也按照"用户提问-ai回答"的格式组织文本,不同连续问答之间以空行分隔,连续问答的轮数不固定,示例如下:
xml
你好,请问今天天气怎么样?
今天天气晴朗,气温15-25℃。
明天呢?
明天多云,可能有小雨。

请问临时用地需要审批吗?
需要。根据《土地管理法》第五十七条,临时用地需经县级以上自然资源主管部门批准。
审批需要哪些材料?
通常需要申请书、项目批准文件、土地权属证明、复垦方案等。
6.2 一问一答训练数据的生成
以6.1中预处理后的文本为基础,用下列程序自动生成一问一答训练数据:
bash
import json
import random
import os


def read_segments(file_path):
    """
    读取文本文件,每行作为一个文段。
    自动过滤掉空行和只有空格的行。
    """
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"找不到文件: {file_path},请检查路径和文件名。")

    with open(file_path, 'r', encoding='utf-8') as f:
        segments = [line.strip() for line in f if line.strip()]
    return segments


def segments_to_sharegpt(segments):
    """
    将文本段列表按"一问一答"打包成独立的 ShareGPT 格式对话列表。
    严格遵循:索引偶数行是 human(提问),奇数行是 ai(回答)。
    """
    conversations = []

    # 如果总行数为奇数,提示警告并丢弃最后一行
    if len(segments) % 2 != 0:
        print(f"⚠️ 警告:文本总行数为奇数({len(segments)}行),最后一行可能缺失回答,已自动丢弃。")
        segments = segments[:-1]

    # 每次步进2,分别取提问和回答
    for i in range(0, len(segments), 2):
        question = segments[i]
        answer = segments[i + 1]

        conversation = {
            "conversations": [
                {"from": "human", "value": question},
                {"from": "ai", "value": answer}
            ]
        }
        conversations.append(conversation)

    return conversations


if __name__ == "__main__":
    # ================= 配置区 =================
    input_file = "test.txt"  # 你的输入文本文件
    output_file = "sharegpt_single.json"  # 生成的输出文件
    # ==========================================

    print(f"正在读取文件: {input_file} ...")

    try:
        # 1. 读取文段
        segments = read_segments(input_file)
        print(f"成功读取 {len(segments)} 行有效文本。")

        # 2. 转换为 ShareGPT 格式(1问1答独立会话)
        conversations = segments_to_sharegpt(segments)
        print(f"已转换为 {len(conversations)} 个独立的单轮问答会话。")

        # 3. 随机打散(核心步骤)
        random.shuffle(conversations)
        print("已完成数据随机打散,防止模型对顺序产生记忆。")

        # 4. 保存为 JSON 文件
        with open(output_file, "w", encoding="utf-8") as f:
            json.dump(conversations, f, ensure_ascii=False, indent=2)

        print(f"✅ 处理完成!已保存到 {output_file}")

    except Exception as e:
        print(f"❌ 发生错误: {e}")
6.3 连续问答训练数据的生成
以6.1中预处理后的文本为基础,用下列程序自动生成连续问答训练数据:
bash
import json
import re


def parse_conversation_blocks(file_path):
    """
    从文本文件中解析连续对话块。
    空行分隔不同的对话块,每个对话块内部行数必须为偶数,严格遵循 human-ai 交替。
    """
    with open(file_path, 'r', encoding='utf-8') as f:
        content = f.read()

    # 1. 按空行(一个或多个连续换行)切分不同的连续对话块
    blocks = re.split(r'\n\s*\n', content.strip())

    conversations = []
    roles = ["human", "ai"]

    for block_idx, block in enumerate(blocks):
        # 2. 提取块内非空行,并去除首尾空白
        lines = [line.strip() for line in block.split('\n') if line.strip()]

        if not lines:
            continue

        # 3. 校验轮数
        if len(lines) % 2 != 0:
            print(f"⚠️ 警告:第 {block_idx + 1} 个对话块行数为奇数({len(lines)}行),可能格式有误,已自动丢弃最后一行。")
            lines = lines[:-1]
            if not lines:
                continue

        # 4. 转换成 ShareGPT 格式
        current_conv = []
        for i, text in enumerate(lines):
            role = roles[i % 2]
            current_conv.append({"from": role, "value": text})

        conversations.append({"conversations": current_conv})

    return conversations


# 示例用法
if __name__ == "__main__":
    input_file = "test.txt"  # 输入文件路径
    output_file = "sharegpt_multi.json"  # 输出文件路径

    # 转换数据
    conversations = parse_conversation_blocks(input_file)

    # 保存为 JSON 文件
    with open(output_file, "w", encoding="utf-8") as f:
        json.dump(conversations, f, ensure_ascii=False, indent=2)

    print(f"✅ 成功生成 {len(conversations)} 个连续对话,已保存到 {output_file}")
6.4 合并所有训练数据
将上述一问一答问答对和连续问答问答对合并进一个训练数据文件中。每次训练数据更新,采取增量更新 和全量训练 的方式。在微调大模型时,数据 loader 通常会把每一个 conversations 对象当成一个独立的训练样本。这两种数据的区别极大:
(1)多段独立对话:它教会模型的是处理独立的、无关联的问答。即使每个对话里有2轮,这两个对话也是在完全不同的上下文里。模型会学会"根据新的提问,抛开之前的语境,重新回答"。
(2)单个连续对话:它教会模型的是上下文追踪。在这个样本里,"审批需要哪些材料"是紧接着"临时用地审批"问的,模型必须记住前面的语境来回答。
bash
import json

with open('sharegpt_single.json', 'r', encoding='utf-8') as f:
    data_multi = json.load(f)

with open('sharegpt_multi.json', 'r', encoding='utf-8') as f:
    data_test = json.load(f)

# 仅仅是把数组元素拼到一起,不修改内部结构
combined_data = data_multi + data_test

with open('sharegpt_combined.json', 'w', encoding='utf-8') as f:
    json.dump(combined_data, f, ensure_ascii=False, indent=2)
合并后的最终训练数据格式如下:
xml
[
  {
    "conversations": [
      {
        "from": "human",
        "value": "你好,请问今天天气怎么样?"
      },
      {
        "from": "ai",
        "value": "今天天气晴朗,气温15-25℃。"
      }
    ]
  },
  {
    "conversations": [
      {
        "from": "human",
        "value": "请问临时用地需要审批吗?"
      },
      {
        "from": "ai",
        "value": "需要。根据《土地管理法》第五十七条,临时用地需经县级以上自然资源主管部门批准。"
      }
    ]
  },
  {
    "conversations": [
      {
        "from": "human",
        "value": "审批需要哪些材料?"
      },
      {
        "from": "ai",
        "value": "通常需要申请书、项目批准文件、土地权属证明、复垦方案等。"
      }
    ]
  },
  {
    "conversations": [
      {
        "from": "human",
        "value": "明天呢?"
      },
      {
        "from": "ai",
        "value": "明天多云,可能有小雨。"
      }
    ]
  },
  {
    "conversations": [
      {
        "from": "human",
        "value": "你好,请问今天天气怎么样?"
      },
      {
        "from": "ai",
        "value": "今天天气晴朗,气温15-25℃。"
      },
      {
        "from": "human",
        "value": "明天呢?"
      },
      {
        "from": "ai",
        "value": "明天多云,可能有小雨。"
      }
    ]
  },
  {
    "conversations": [
      {
        "from": "human",
        "value": "请问临时用地需要审批吗?"
      },
      {
        "from": "ai",
        "value": "需要。根据《土地管理法》第五十七条,临时用地需经县级以上自然资源主管部门批准。"
      },
      {
        "from": "human",
        "value": "审批需要哪些材料?"
      },
      {
        "from": "ai",
        "value": "通常需要申请书、项目批准文件、土地权属证明、复垦方案等。"
      }
    ]
  }
]
7. 训练模型
时刻调整epoch和学习率:
(1)低学习率 + 少 Epoch = 欠拟合。比如把学习率从 2e-4 降到 1e-5,同时只跑 2 个 Epoch 时:模型参数更新的幅度极小。
(2) 低学习率 + 多 Epoch = 灾难性过拟合。如果把 Epoch 增加到 20 甚至 50 来配合低学习率:模型确实有足够的时间去学习这些数据了。但它把原本预训练的知识全忘了,变成了一个只会从训练数据中找回答的"复读机"。
python
import torch
from transformers import (
    AutoTokenizer,
    AutoModelForCausalLM,
    BitsAndBytesConfig,
    TrainingArguments,
    Trainer,
    DataCollatorForLanguageModeling,
    EarlyStoppingCallback
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from datasets import load_dataset

# ==================== 配置区 ====================
model_path = "/home/ai/Documents/DeepSeek-R1-Distill-Qwen-7B"
data_file = "./sharegpt_single.json"
output_dir = "./train_output"
Epoch = 4  # 数据量小,可以多跑几轮,但必须配合早停(Early Stopping)
TEST = 1                                                         # TEST为1调用小批量训练的参数
# =================================================

# 1. 量化配置:保持 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16  # 5090 对 BF16 支持极好
)

# 2. LoRA 配置:数据量小,需扩大 LoRA 作用范围防止过拟合
# 小数据量测试训练
if TEST == 1:
    print("采用测试训练LoRA 配置")
    lora_config = LoraConfig(
        r=16,                     # 略微增加参数量以更好地学习新知识
        lora_alpha=32,            # 通常设为 r 的 2 倍
        target_modules=[          # 全线性层注入 LoRA,比只注入注意力层效果好得多
            "q_proj", "k_proj", "v_proj", "o_proj",
            "gate_proj", "up_proj", "down_proj"
        ],
        lora_dropout=0.1,         # 增加 Dropout,防止过拟合
        bias="none",
        task_type="CAUSAL_LM"
    )
# 大数据量正式训练
else:
    print("采用正式训练LoRA 配置")
    lora_config = LoraConfig(
        r=16,
        lora_alpha=32,
        target_modules=[
            "q_proj", "k_proj", "v_proj", "o_proj",
            "gate_proj", "up_proj", "down_proj"  # 数据量大,可以全量注入,让模型深度掌握业务
        ],
        lora_dropout=0.05,  # 数据量大,Dropout 可以降低
        bias="none",
        task_type="CAUSAL_LM"
    )

# 3. 训练参数(针对 24GB 显存和极小数据集优化)
# 小数量测试训练
if TEST == 1:
    print("采用测试训练参数")
    training_args = TrainingArguments(
        output_dir=output_dir,
        per_device_train_batch_size=4,      # 24GB 显存完全够跑 batch_size=4
        per_device_eval_batch_size=4,
        gradient_accumulation_steps=2,      # 有效 batch size = 4 * 2 = 8
        num_train_epochs=Epoch,
        learning_rate=1e-4,                 # 数据少,学习率调低,防止冲撞原有知识
        bf16=True,                          # 5090 必须用 bf16,fp16 容易 NaN
        optim="paged_adamw_8bit",           # QLoRA 标准优化器,省显存且稳定
        gradient_checkpointing=True,        # 梯度检查点,防止显存溢出
        logging_steps=5,                    # 数据少,每 5 步打印一次日志
        eval_strategy="epoch",              # 每个 epoch 评估一次
        save_strategy="epoch",
        save_total_limit=2,
        load_best_model_at_end=True,        # 训练结束加载验证集最优模型
        metric_for_best_model="loss",       # 以 loss 为指标判断最优
        greater_is_better=False,
        remove_unused_columns=False,
        report_to="none",
        warmup_steps=5,                    # 学习率预热,稳定初期训练
    )
# 大数量正式训练
else:
    print("采用正式训练参数")
    training_args = TrainingArguments(
        output_dir=output_dir,
        per_device_train_batch_size=4,
        per_device_eval_batch_size=4,
        gradient_accumulation_steps=8,  # 有效 batch size = 32
        num_train_epochs=3,  # 1.8 万数据,2-3轮足够,千万别多跑
        learning_rate=2e-5,  # 数据量大,学习率保持在 2e-5 左右
        bf16=True,
        optim="paged_adamw_8bit",
        gradient_checkpointing=True,
        logging_steps=20,  # 数据量大,降低打印频率
        eval_strategy="steps",  # 改用步数评估,不用按 epoch 评估
        eval_steps=100,  # 每 100 步评估一次
        save_strategy="steps",
        save_steps=200,  # 每 200 步保存一次 checkpoint
        save_total_limit=3,  # 最多保留 3 个 checkpoint,防止撑爆硬盘
        load_best_model_at_end=True,
        metric_for_best_model="loss",
        greater_is_better=False,
        remove_unused_columns=False,
        report_to="none",
        warmup_steps=100,  # 预热步数需要加大,稳定初期大规模训练
    )

# ==================== 加载模型与分词器 ====================
print("正在加载分词器...")
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

print("正在加载模型(4-bit量化)...")
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True
)

# 开启梯度检查点时必须调用此函数,否则反向传播会报错
model = prepare_model_for_kbit_training(model)
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()

# ==================== 数据处理 ====================
print("正在加载数据集...")
dataset = load_dataset('json', data_files=data_file, split='train')

def format_sharegpt_to_conversations(example):
    messages = example['conversations']
    formatted_messages = []
    for turn in messages:
        role = "user" if turn['from'] == 'human' else "assistant"
        formatted_messages.append({"role": role, "content": turn['value']})
    text = tokenizer.apply_chat_template(
        formatted_messages,
        tokenize=False,
        add_generation_prompt=False
    )
    return {"text": text}

dataset = dataset.map(format_sharegpt_to_conversations)

# 划分验证集(104条数据,留出 15% 约 16 条作为验证集,非常重要!)
dataset = dataset.train_test_split(test_size=0.15, seed=42)
train_dataset = dataset["train"]
eval_dataset = dataset["test"]

def tokenize_function(examples):
    return tokenizer(
        examples["text"],
        truncation=True,
        max_length=512,       # 身份问答通常很短,512 足够,省显存提速
        padding=False,
        return_tensors=None
    )

print("正在Tokenize数据集...")
tokenized_train = train_dataset.map(tokenize_function, batched=True, remove_columns=train_dataset.column_names)
tokenized_eval = eval_dataset.map(tokenize_function, batched=True, remove_columns=eval_dataset.column_names)

data_collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm=False)

# ==================== 开始训练 ====================
print("开始训练...")
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_train,
    eval_dataset=tokenized_eval,            # 传入验证集
    data_collator=data_collator,
    callbacks=[EarlyStoppingCallback(early_stopping_patience=2)]  # 验证集 loss 连续 2 次不降就停止
)
trainer.train()

# ==================== 保存模型 ====================
print("训练完成,保存模型...")
model.save_pretrained(output_dir)
tokenizer.save_pretrained(output_dir)
print(f"模型已保存至 {output_dir}")
8. 在不合并模型的情况下先测试训练后的模型权重
python
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import PeftModel
import torch

# ==================== 配置区 ====================
base_model_path = "/home/ai/Documents/DeepSeek-R1-Distill-Qwen-7B"  # 基础模型路径
adapter_path = "./train_output"                                  # LoRA 适配器路径,每次调用该目录下最新一次的训练权重
MAX_HISTORY_TURNS = 10                                           # 最多保留最近 10 轮对话,防止溢出
# =================================================

# 4-bit 量化配置(省显存,适合快速测试)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.float16  # 测试生成用 fp16 更稳定
)

print("正在加载基础模型(4-bit 量化)...")
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_path,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True
)

tokenizer = AutoTokenizer.from_pretrained(base_model_path, trust_remote_code=True)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

print("正在加载 LoRA 适配器...")
model = PeftModel.from_pretrained(base_model, adapter_path)
# model = base_model  # 直接用基础模型测试
model.eval()  # 切换到推理模式

messages = []
print("\n✅ 模型加载成功!开始连续对话(输入 'exit' 结束)\n")

while True:
    user_input = input("用户: ")
    if user_input.lower() == "exit":
        print("对话结束。")
        break

    messages.append({"role": "user", "content": user_input})

    # 历史记录截断:只保留最近 MAX_HISTORY_TURNS*2 条消息(user + assistant 各算一条)
    if len(messages) > MAX_HISTORY_TURNS * 2:
        messages = messages[-(MAX_HISTORY_TURNS * 2):]

    prompt = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=512,
            do_sample=True,
            temperature=0.7,
            top_p=0.9,
            repetition_penalty=1.1,
            # no_repeat_ngram_size=4,  # 禁止4-gram重复出现,这是止住复读的关键
            eos_token_id=tokenizer.eos_token_id,
            pad_token_id=tokenizer.pad_token_id,
        )

    response = tokenizer.decode(
        outputs[0][inputs.input_ids.shape[1]:],
        skip_special_tokens=True
    )
    messages.append({"role": "assistant", "content": response})
    print(f"助手: {response}\n")
9. 合并原始模型与训练后的模型权重
python
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel
import torch

# ==================== 配置区 ====================
base_model_path = "/home/ai/Documents/DeepSeek-R1-Distill-Qwen-7B"  # 基础模型路径
adapter_path = "./train_output"                                  # LoRA 适配器路径
merged_save_path = "./merged_model"                              # 合并后模型的保存路径
# =================================================

print("正在加载基础模型...")
# 合并时用 CPU 即可,避免和训练环境抢显存;如果显存充裕也可以换成 "auto"
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_path,
    torch_dtype=torch.bfloat16,  # 5090 原生支持 bf16,合并后精度更好
    device_map="cpu",
    trust_remote_code=True
)

tokenizer = AutoTokenizer.from_pretrained(base_model_path, trust_remote_code=True)

print("正在加载 LoRA 适配器...")
model = PeftModel.from_pretrained(base_model, adapter_path)

print("正在合并权重...")
merged_model = model.merge_and_unload()

print(f"正在保存合并后的模型至: {merged_save_path}")
merged_model.save_pretrained(merged_save_path)
tokenizer.save_pretrained(merged_save_path)
print("✅ 合并完成!")
10. 合并后的模型被ollama提取
10.1 Modelfile文件添加模板等参数
合并后的模型被ollama提取时需要注意在Modelfile文件中添加以下参数:
(1) TEMPLATE:严格定义了System、User、Assistant各角色的包裹格式,与DeepSeek训练时一致,DeepSeek-R1系列使用的模板与Qwen2.5相同。
(2) PARAMETER stop:告诉模型遇到这些标记就停止生成,缺少stop参数是导致输出混乱的常见原因。
(3) PARAMETER:设置了合理的采样参数,避免因参数极端导致异常输出。
合并后的模型Modelfile文件内容示例如下:
xml
FROM /home/ai/Documents/AI_guotu/merged_model

TEMPLATE """{{- if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{- end }}{{- range .Messages }}
{{- if eq .Role "user" }}<|im_start|>user
{{ .Content }}<|im_end|>
{{- else if eq .Role "assistant" }}<|im_start|>assistant
{{ .Content }}<|im_end|>
{{- end }}{{- end }}
{{- if .Prompt }}<|im_start|>user
{{ .Prompt }}<|im_end|>
{{- end }}<|im_start|>assistant
"""

PARAMETER stop "<|im_start|>"
PARAMETER stop "<|im_end|>"
PARAMETER stop "<|endoftext|>"
PARAMETER temperature 0.7
PARAMETER top_p 0.9
10.2 强制ollama使用自定义模板
当用户自定义的 TEMPLATE 功能不如内置默认模板丰富时,Ollama 会忽略你的设置,强制使用默认模板。因此需要强制使用自定义模板。
bash
# 停止ollama服务
sudo systemctl stop ollama

# 编辑环境变量
sudo systemctl edit ollama
# 添加以下内容
[Service]
Environment="OLLAMA_GO_TEMPLATE=0"
Environment="OLLAMA_DISABLE_RENDERER=1"
# OLLAMA_GO_TEMPLATE=0 确保模板引擎使用自定义的 Go 模板,OLLAMA_DISABLE_RENDERER=1 则直接禁用默认的渲染器,强制 Ollama 使用你在 Modelfile 中定义的模板
# 在 nano 中,按 Ctrl+X,然后按 Y,最后按 Enter 确认。

# 重启服务
sudo systemctl daemon-reload
sudo systemctl restart ollama
10.3 使用原始模型的配置文件
把原始模型目录下的 tokenizer.json、tokenizer_config.json、config.json、generation_config.json 复制到 merged_model 文件夹里覆盖。
10.4 最后再用ollama提取模型
bash
# ollama提取的模型可以在交互界面中选择
ollama create jurongtudi -q q4_K_M -f /home/ai/Documents/AI_guotu/Modelfile

# 验证 ollama 使用的是否是自定义模板
ollama show tudideepseek --modelfile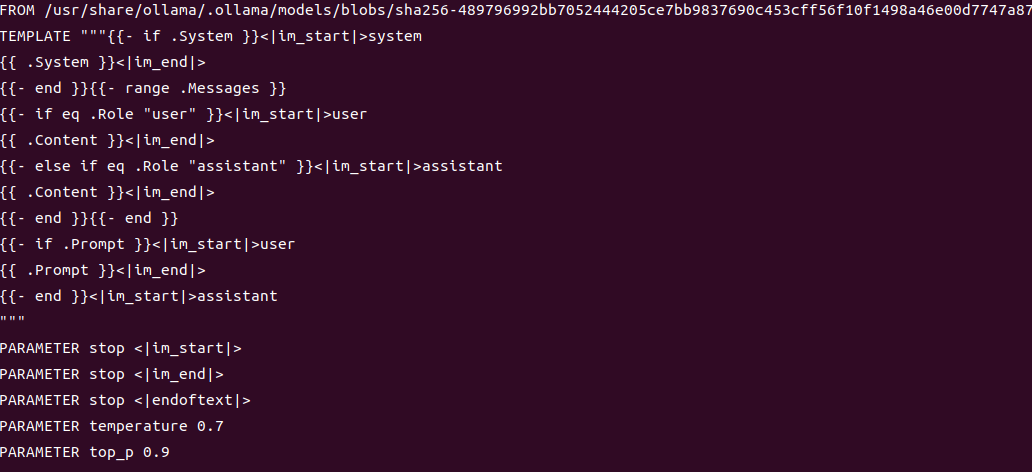
11. 其他常用命令如下
参考我的另一篇文章:
Anaconda和Mamba创建环境管理包常用命令合集(附ollama常用命令)
bash
# 激活虚拟环境
mamba activate guotu_deepseek
# 监测显卡占用
watch -n 1 nvidia-smi
# ollama 查看已经提取的模型
ollama list
# ollama 删除已经提取的模型
ollama rm (模型名称)
# ollama提取模型,ollama服务开机后运行
ollama create jurongtudi -q q4_K_M -f /home/ai/Documents/AI_guotu/Modelfile
# 开启web服务
ollamawebui start
# 其余生成训练数据、训练模型、合并模型,用"python(代码文件名称)"