不是重心也不是中点:费马---韦伯点、它的最优性条件与迭代求解
一个配送网络要选一个服务点,让服务点到六个需求点的加权距离之和最小,权重就是各点的订货量。直觉通常给出两个答案:把所有点按权重平均一下,得到「加权重心」;或者对横纵坐标分别取中位数。这两个答案都不对------不是差一点点,而是它们最小化的根本不是同一个函数。
下面用一个六点实例把这件事算清楚:三个候选点各自的目标值、迭代序列的每一步、一个会把最优解压到需求点上的权重配置,以及权重与坐标扰动下最优点会移动多远。全部数字都可以用同一段标准库代码复算。
一、把问题写成一句话:选一个点,让加权距离和最小
平面上有 n 个需求点,第 i 个点的坐标记作 p_i = (a_i, b_i),权重 w_i > 0(订货量、人口、流量都行)。要选的是一个服务点 x = (x_1, x_2),代价是它到各需求点的加权欧氏距离之和:
F(x) = Σ w_i · ‖x − p_i‖这是无约束问题:x 可以落在平面上任何位置,包括与某个需求点重合。变量只有两个,目标函数却是非光滑的------这正是后面所有麻烦的来源。这个问题在文献里叫费马---韦伯问题,它的最优解也叫几何中位数,本文两个名字混用。
先说清两个假设,它们贯穿全文:
- 权重都是正数,距离用欧氏范数,代价与距离成正比(不考虑运价分段、容量上限与建站成本);
- 需求点的位置与权重都当作已知常数,不处理位置本身有误差的情形(第十节回到这一点)。
本文的实例取六个点,其中 F 点又远又重,用来把加权重心与真正的最优解拉开距离:
| 点 | 坐标 | 权重 |
|---|---|---|
| A | (0.0, 0.0) | 1.0 |
| B | (10.0, 0.0) | 1.0 |
| C | (0.0, 8.0) | 1.0 |
| D | (10.0, 8.0) | 1.0 |
| E | (4.0, 3.0) | 2.0 |
| F | (12.0, 12.0) | 4.0 |
二、先排除两个直觉答案
加权重心是最小化加权平方距离 Σ w_i·‖x − p_i‖² 的解,可以直接写出公式:c = Σ w_i·p_i / Σ w_i。它是一阶矩,与距离的一次方没有关系。
逐坐标加权中位数是最小化加权直线距离 Σ w_i·(|x_1 − a_i| + |x_2 − b_i|) 的解。这个目标可以拆成横纵两个独立的一维问题,每个一维问题的最优解是加权中位数。它逐坐标取最优,因此也没有理由让欧氏距离和最小。
把实例的三条答案放在一起对照:
| 候选点 | 坐标 | 目标值 F |
|---|---|---|
| 加权重心 c | (7.600000, 7.000000) | 65.402201 |
| 逐坐标加权中位数 q | (10.000000, 8.000000) | 64.315292 |
| 几何中位数 m* | (9.480363, 8.165316) | 64.136355 |
三者的差距不大,但方向很清楚:重心离最优点 2.212176,坐标中位数离最优点 0.545300,而后者的目标值已经只比最优值高 0.178936。本例的坐标中位数恰好就是需求点 D------一个「看起来很像答案」的点,它却不是最优解(第五节给出判据)。
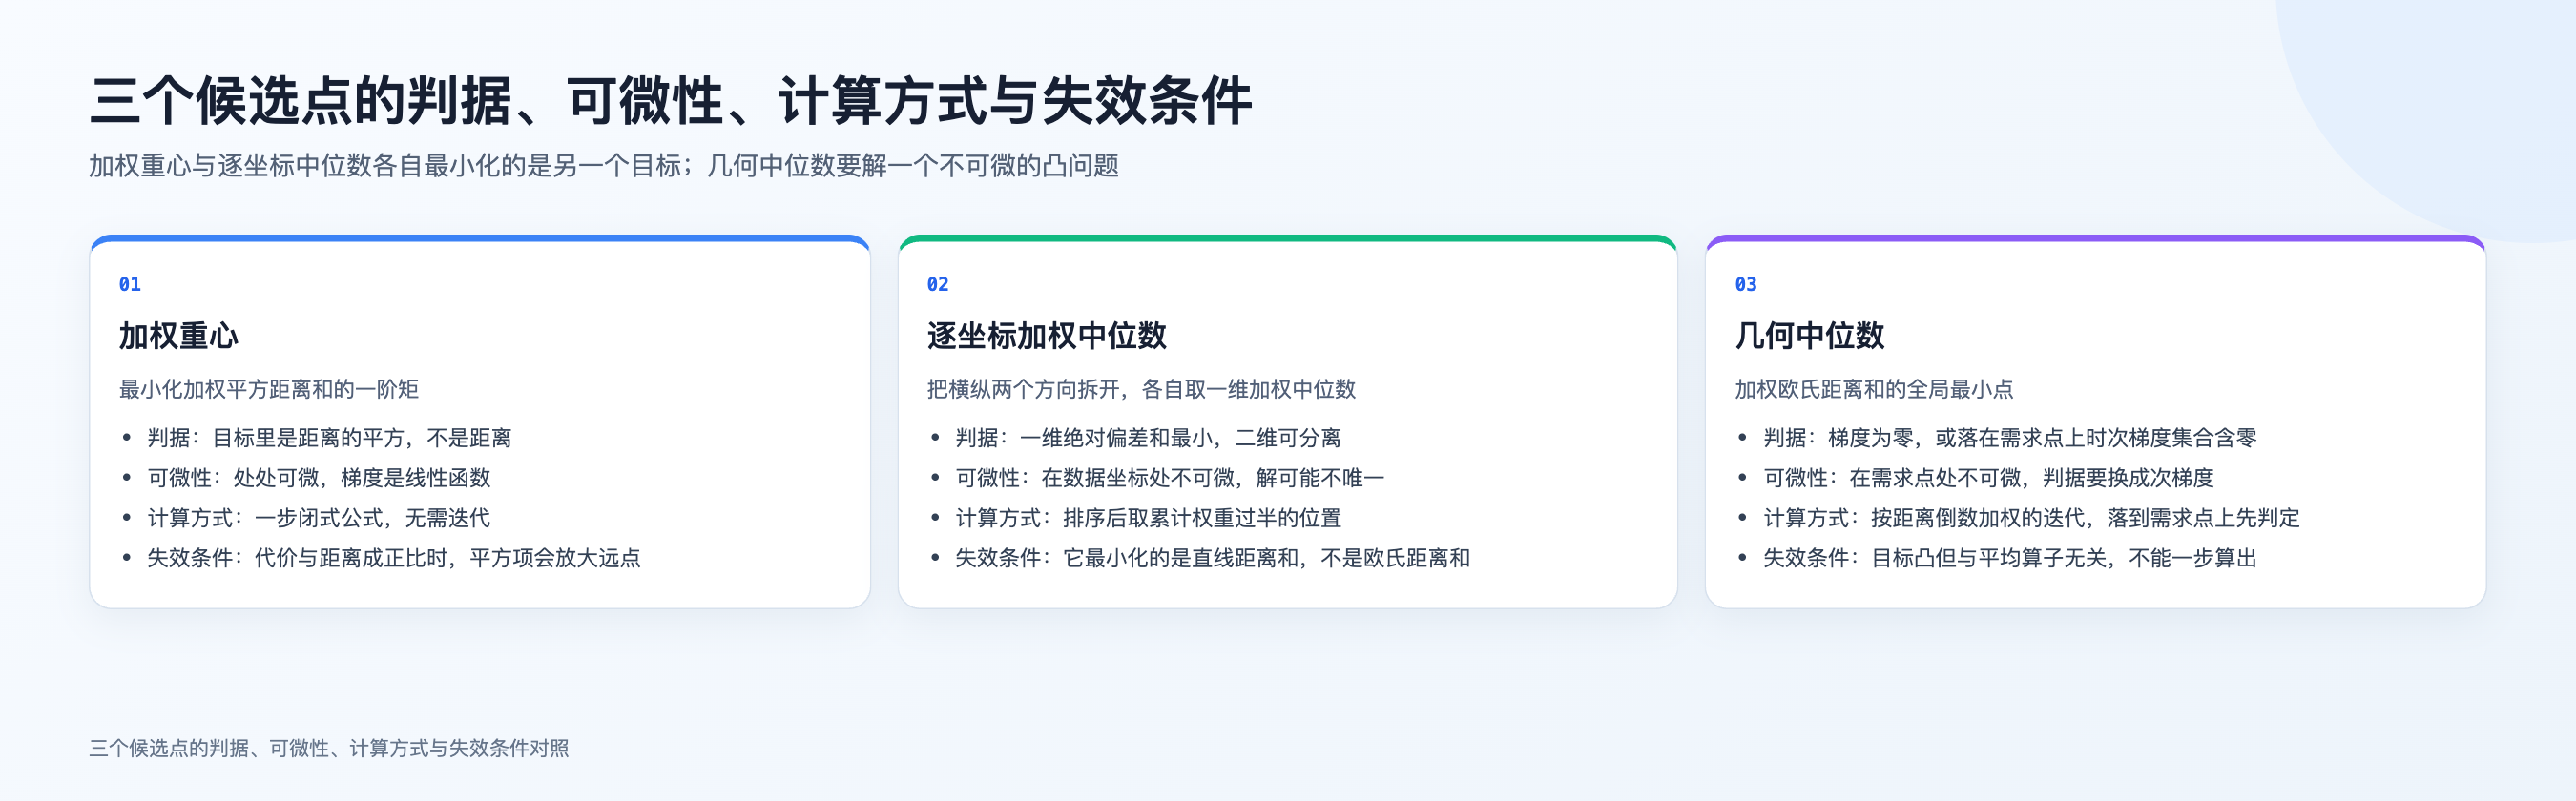
图 1 把三者的差别按判据、可微性、计算方式与失效条件四行摊开:重心有闭式解、处处可微,但它回答的是平方代价;坐标中位数把两维拆开、只对直线距离最优,而且当某个坐标上出现权重恰好对半时解可能不唯一;几何中位数要解一个不可微的凸问题,好处是任何局部最优就是全局最优。
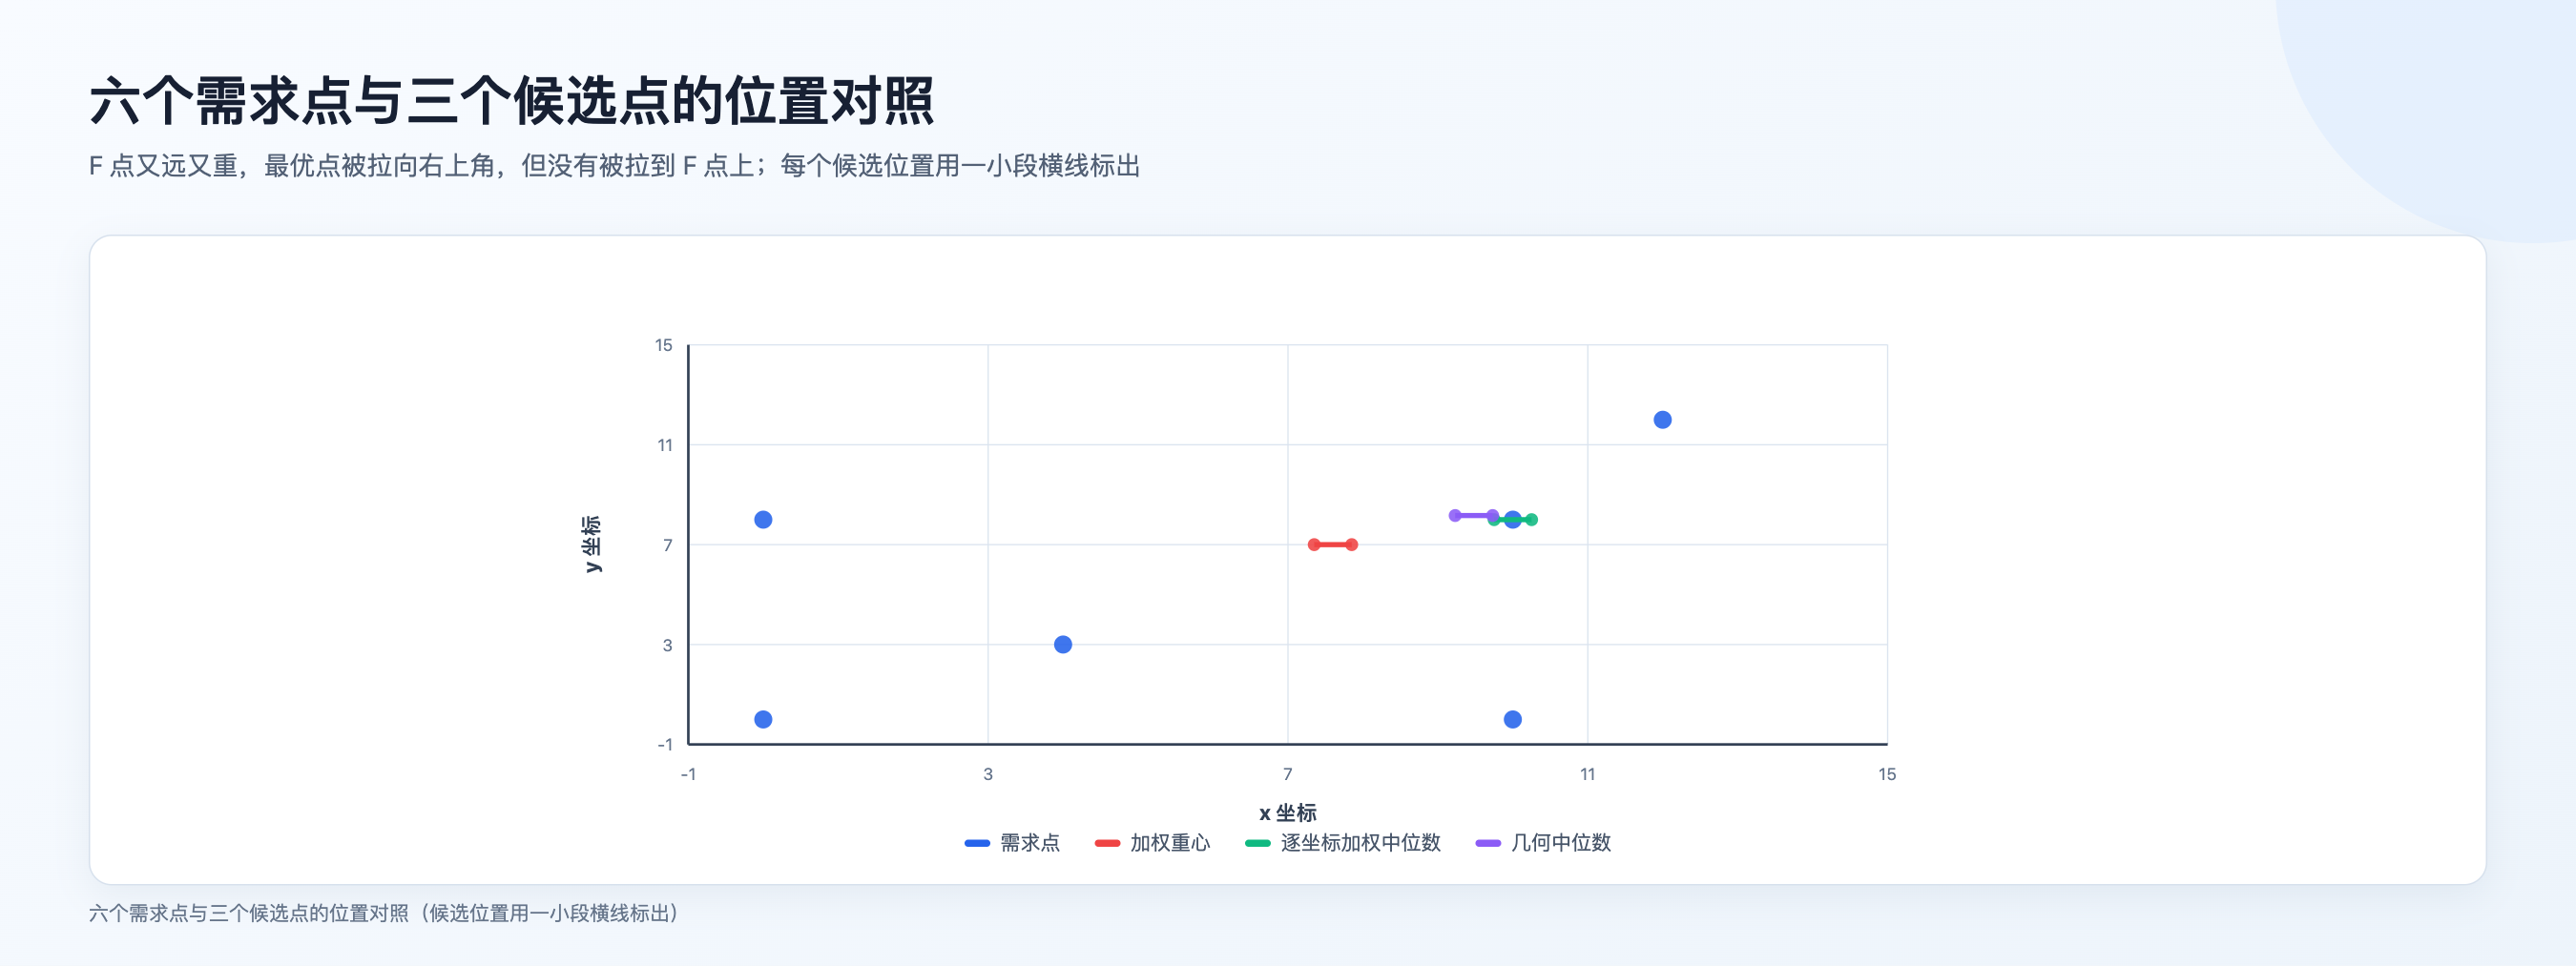
图 2 是同一组数字的几何版本:六个需求点、加权重心、坐标中位数与几何中位数。F 点权重最大,所以最优点被拉向右上角,但并没有被拉到 F 点上。
三、目标函数的形状:凸性
F 是凸函数,论证分三步:
- 欧氏范数 ‖·‖ 是凸函数;
- 每个 p_i 固定时,x ↦ ‖x − p_i‖ 是凸函数与仿射映射的复合,仍然凸;
- 非负权重下,Σ w_i·‖x − p_i‖ 是凸函数的非负组合,仍然凸。
凸性带来三个直接后果:任一局部极小点都是全局极小点;下水平集 {x : F(x) ≤ α} 是凸闭集;当 ‖x‖ 趋于无穷时 F 也趋于无穷(因为权重之和为正),所以最小值一定取到。
但 F 一般不是严格凸的:如果所有需求点共线,沿着这条线在某些区间上目标值可以持平,最优点就不唯一。实例中的六个点不共线,最优点唯一。
更要紧的是可微性。每一项 w_i·‖x − p_i‖ 在 x = p_i 处有一个尖角:从不同方向靠近 p_i 时,这一项的梯度趋向不同的单位向量。当 x 与所有需求点都不重合时,F 可微;一旦 x 落在某个需求点上,F 在该点不可微,梯度不存在。「梯度为零」这句话在那一点上直接失效------这是第五节的主题。
四、最优性条件:梯度为零等价于加权单位向量和为零
当 x 不是任何需求点时,逐项求导:
∇F(x) = Σ w_i · (x − p_i) / ‖x − p_i‖把每一项写成 w_i·u_i(x),其中 u_i(x) 是从 p_i 指向 x 的单位向量。由凸性,∇F(x) = 0 是该点全局最优的充要条件。
几何读法很直观:每个需求点沿「从自己指向 x」的方向拉,拉力大小等于它的权重;最优点就是这些拉力互相抵消的位置。权重越大、距离越近的点,方向上的话语权越大。
把上式移项,还能读出一个不动点形式:
x · Σ (w_i / d_i) = Σ (w_i / d_i) · p_i, 其中 d_i = ‖x − p_i‖也就是说,最优点必须等于「以距离倒数为权重」对全部需求点做的加权平均。第六节的迭代格式正是从这个式子抄下来的。
有一处容易误用:梯度范数是最优性的一阶残差,但它的大小不能用来比较两个候选点的目标值高低。实例里加权重心处的梯度范数是 0.920322,坐标中位数处是 1.669920------后者更大,可它的目标值更低。真正的最优点处,梯度范数降到 2.25e-14。
五、奇异情形:最优解落在需求点上
设 x 取在需求点 p_k 上。此时第 k 项的次梯度是整个闭单位球(乘以权重),其余项仍然是固定的单位向量:
∂F(p_k) = w_k · B̄ + Σ_{j≠k} w_j · u_jk其中 B̄ 是闭单位球,u_jk 是从 p_j 指向 p_k 的单位向量。由凸性,0 ∈ ∂F(p_k) 是 p_k 为全局最优的充要条件。把式子整理一下,它等价于一个只用向量长度就能检查的判据:
‖Σ_{j≠k} w_j · u_jk‖ ≤ w_k左边是其余所有需求点对 p_k 的合拉力,右边是这个点自身的权重。直觉是:如果别的点合起来也拉不动它,那么最优解就停在这个需求点上。
实例在一般权重(F 点权重 4)下的判据余量是:
| 点 | 坐标 | 权重 | 判据余量 | 该点目标值 |
|---|---|---|---|---|
| A | (0.0, 0.0) | 1.0 | 7.397211 | 108.688499 |
| B | (10.0, 0.0) | 1.0 | 6.090332 | 92.884757 |
| C | (0.0, 8.0) | 1.0 | 6.090329 | 94.208940 |
| D | (10.0, 8.0) | 1.0 | 0.669920 | 64.315292 |
| E | (4.0, 3.0) | 2.0 | 2.438059 | 74.087956 |
| F | (12.0, 12.0) | 4.0 | 1.681824 | 70.340524 |
六个余量全部为正,因此最优解严格落在需求点之外;最接近「被选中」的是 D 点,余量只有 0.669920。注意 D 点正是上一节的坐标中位数:它离最优解很近,但仍不满足判据。
现在把 F 点的权重从 4 往上提。其余五个点对 F 的合拉力范数是 5.681824,于是:
| F 点权重 | 判据余量 | 判定 |
|---|---|---|
| 4.0 | +1.681824 | 不是最优 |
| 5.0 | +0.681824 | 不是最优 |
| 6.0 | -0.318176 | F 点就是最优解,最优值 70.340524 |
阈值可以精确写出:只要 F 点权重大于 5.681824(权重乘子 1.420456),最优解就整体落到 F 点上,此时最小值等于 F 点本身的目标值。这是一个「最优解不可微」的实例:目标函数在最优点的梯度不存在,任何「跑到梯度为零」的实现都会在这一点上卡住或算错。
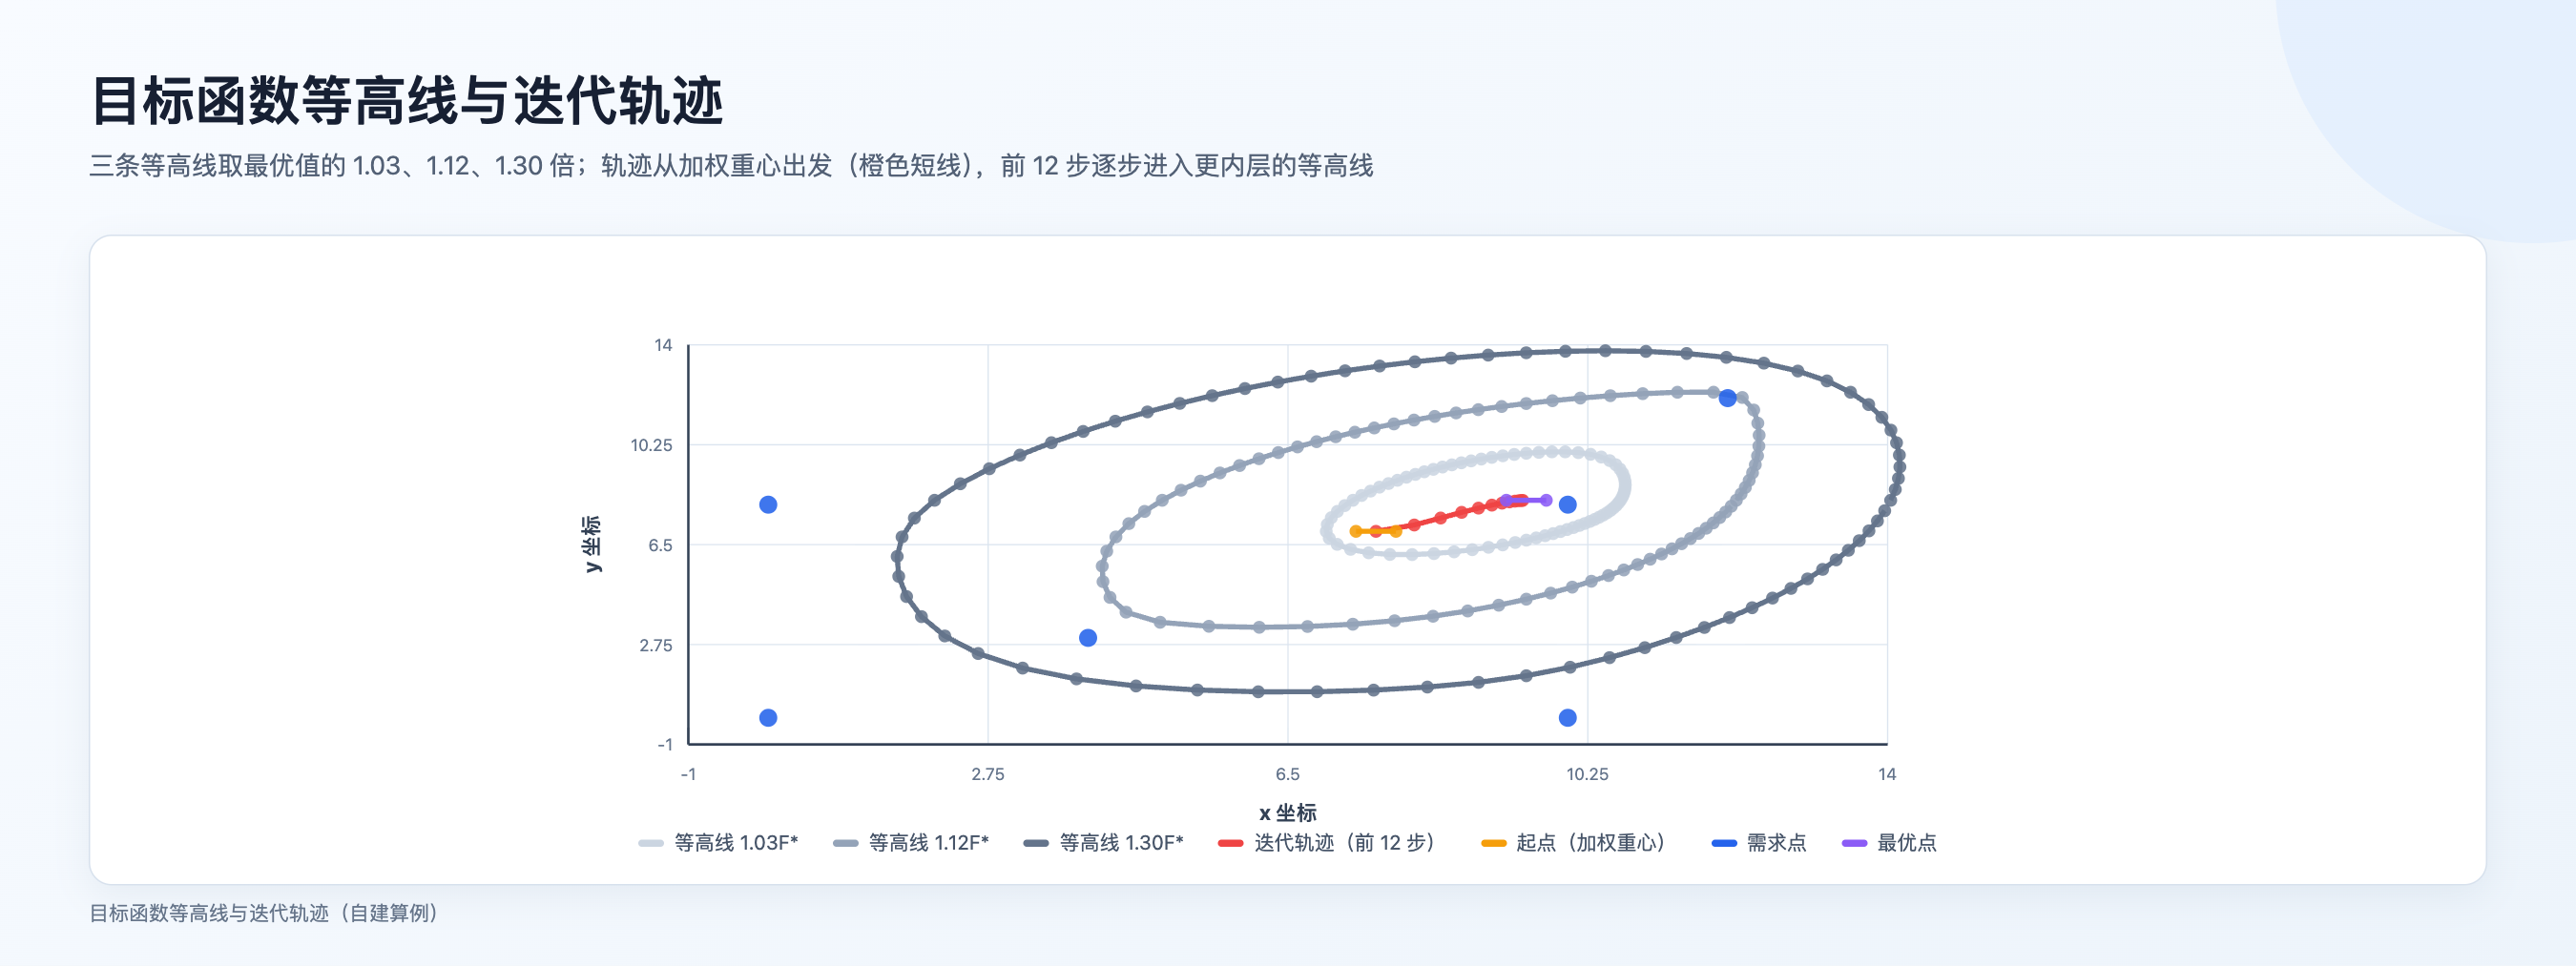
图 3 把这一族的等高线(以最优值为基准的 1.03、1.12、1.30 倍)与从加权重心出发的迭代轨迹叠在同一张坐标图上:轨迹的每一步都落在更靠内的位置上。
六、从梯度条件到不动点:Weiszfeld 迭代
把第四节的梯度条件解出来。设 d_i = ‖x − p_i‖:
Σ w_i·(x − p_i)/d_i = 0
⟺ x · Σ (w_i/d_i) = Σ (w_i/d_i)·p_i
⟺ x = [ Σ (w_i/d_i)·p_i ] / [ Σ (w_i/d_i) ]
把等号两边看成「用当前点算权重、再算新点」,就得到迭代格式:给定当前点 x_t(不是需求点),
x_(t+1) = [ Σ (w_i / ‖x_t − p_i‖)·p_i ] / [ Σ (w_i / ‖x_t − p_i‖) ]三个性质值得记住:
- 它是对全部需求点的加权平均,权重是距离的倒数------离得近的点权重大;
- 当 x_t 靠近某个需求点时,这一项的倒数权重趋于无穷,平均值被它主导,于是新点离它很近:步长自动变小;
- 反过来,这也解释了为什么迭代在最优解附近会越走越慢------减速与「安全」是同一件事的两面。
这条迭代形式在 1960 年代被独立重发现,并用于广义韦伯问题的数值求解(4)。
它为什么每一步都不增目标值。 对每个需求点用一次 a²/(2b) + b/2 ≥ a(b > 0 时成立,等号当且仅当 a = b),令 a = ‖x − p_i‖、b = d_i(x_t),得到代理函数:
G(x; x_t) = Σ w_i · ( ‖x − p_i‖² / (2·d_i(x_t)) + d_i(x_t)/2 ) ≥ F(x)并且 x = x_t 时每一项都取等号,所以 G(x_t; x_t) = F(x_t)。G 关于 x 是二次函数,二次项系数为 Σ w_i/(2·d_i(x_t)) > 0,因此有唯一最小点;对 G 求梯度并令其为零,解出来的正是上面的迭代式。于是:
F(x_(t+1)) ≤ G(x_(t+1); x_t) ≤ G(x_t; x_t) = F(x_t)只要 x_(t+1) ≠ x_t,第二个不等号就是严格的,目标值严格下降;迭代停在不动点时,梯度条件已经满足。这就是「单调下降」的证明骨架:把难解的 F 换成容易解的 G,每一步都解到底。
这个不等式可以直接用程序核对:在实例上抽样 3600 个点,F(x) − G(x; x_0) 的最大值是 -0.007363,处处不大于零;在 x_0 处该差值恰好为 0.0。
下面是一段概念性伪代码,把「先判据、再迭代」的顺序固定下来(不是任何论文算法框的复现):
text
概念性伪代码:带数据点判据的 Weiszfeld 迭代

Input : 需求点 p_1..p_n 与权重 w_1..w_n;起点 x;步长阈值 ε;步数上限 T
Output: 近似最优点 x 与停止原因

1  令 t = 0
2  重复以下步骤,直到停止:
3      若 x 与某个需求点 p_k 的距离为 0:
4          计算判据余量 g = ‖Σ_(j≠k) w_j·u_jk‖ − w_k
5          若 g ≤ 0:停止,返回「x 就是最优解」
6          否则:用剔掉第 k 项后的倒数加权平均更新 x,记下这次逃逸,进入下一轮
7      否则:
8          用全部需求点的倒数加权平均算出候选点 x'
9          若 ‖x' − x‖ ≤ ε·max(1, ‖x‖):停止,返回「步长足够小」
10         否则:令 x = x',t = t + 1
11 返回 x 与停止原因
七、倒数权重发散时怎么办
迭代式里有一项是 w_k / ‖x_t − p_k‖。只要迭代点恰好落在需求点 p_k 上,这一项就是无穷大,公式没有定义。这不是罕见情形:第五节已经构造出最优解就在需求点上的例子,而且迭代过程中也可能偶然踩上去。
正确的处理顺序只有一条:先判定,再决定去留。
- 判据余量小于等于零:这个点就是最优解,直接停。实例中把 F 点权重取 6,从 F 点出发,第 0 步就由判据终止(返回「停在需求点 F」),不需要任何迭代。
- 判据余量大于零:这个点不是最优解,必须离开。常用的做法是剔除奇异项,只用其余需求点做倒数加权平均,走出一步。
需要特别记住的是:剔除奇异项的那一步不保证下降。把 F 点权重取 5(判据余量 +0.681824,不是最优),仍从 F 点出发,第一步会跳到 (6.103542, 4.787145),目标值从 70.340524 升到 77.979062。原因是其余五个点的倒数加权平均离 F 点很远,这一步相当于把点从「偏远重的需求点」拉回需求簇中心附近。此后目标值恢复单调下降,124 次更新后到达 (9.767942, 8.763811),目标值 68.450865。
三个实现层面的结论:
- 不要用「步长是否足够小」代替数据点判据------最优解落在需求点上时,迭代可能一直在附近打转;
- 逃逸步之后要重新开始检查下降性,不能假设目标值序列处处单调;
- 判据本身很便宜:一次 O(n) 的向量求和,远比多跑几百步便宜。
八、收敛速度:一般情形与奇异情形的差别
同一套迭代在两个实例上的表现差别很大。记相对间隙为 (F(x_t) − F*)/F*(一般情形用高精度收敛值作参照,奇异情形的最优值可以精确写成 F 点的目标值):
| 相对间隙阈值 | 一般实例所需步数 | 奇异实例所需步数 |
|---|---|---|
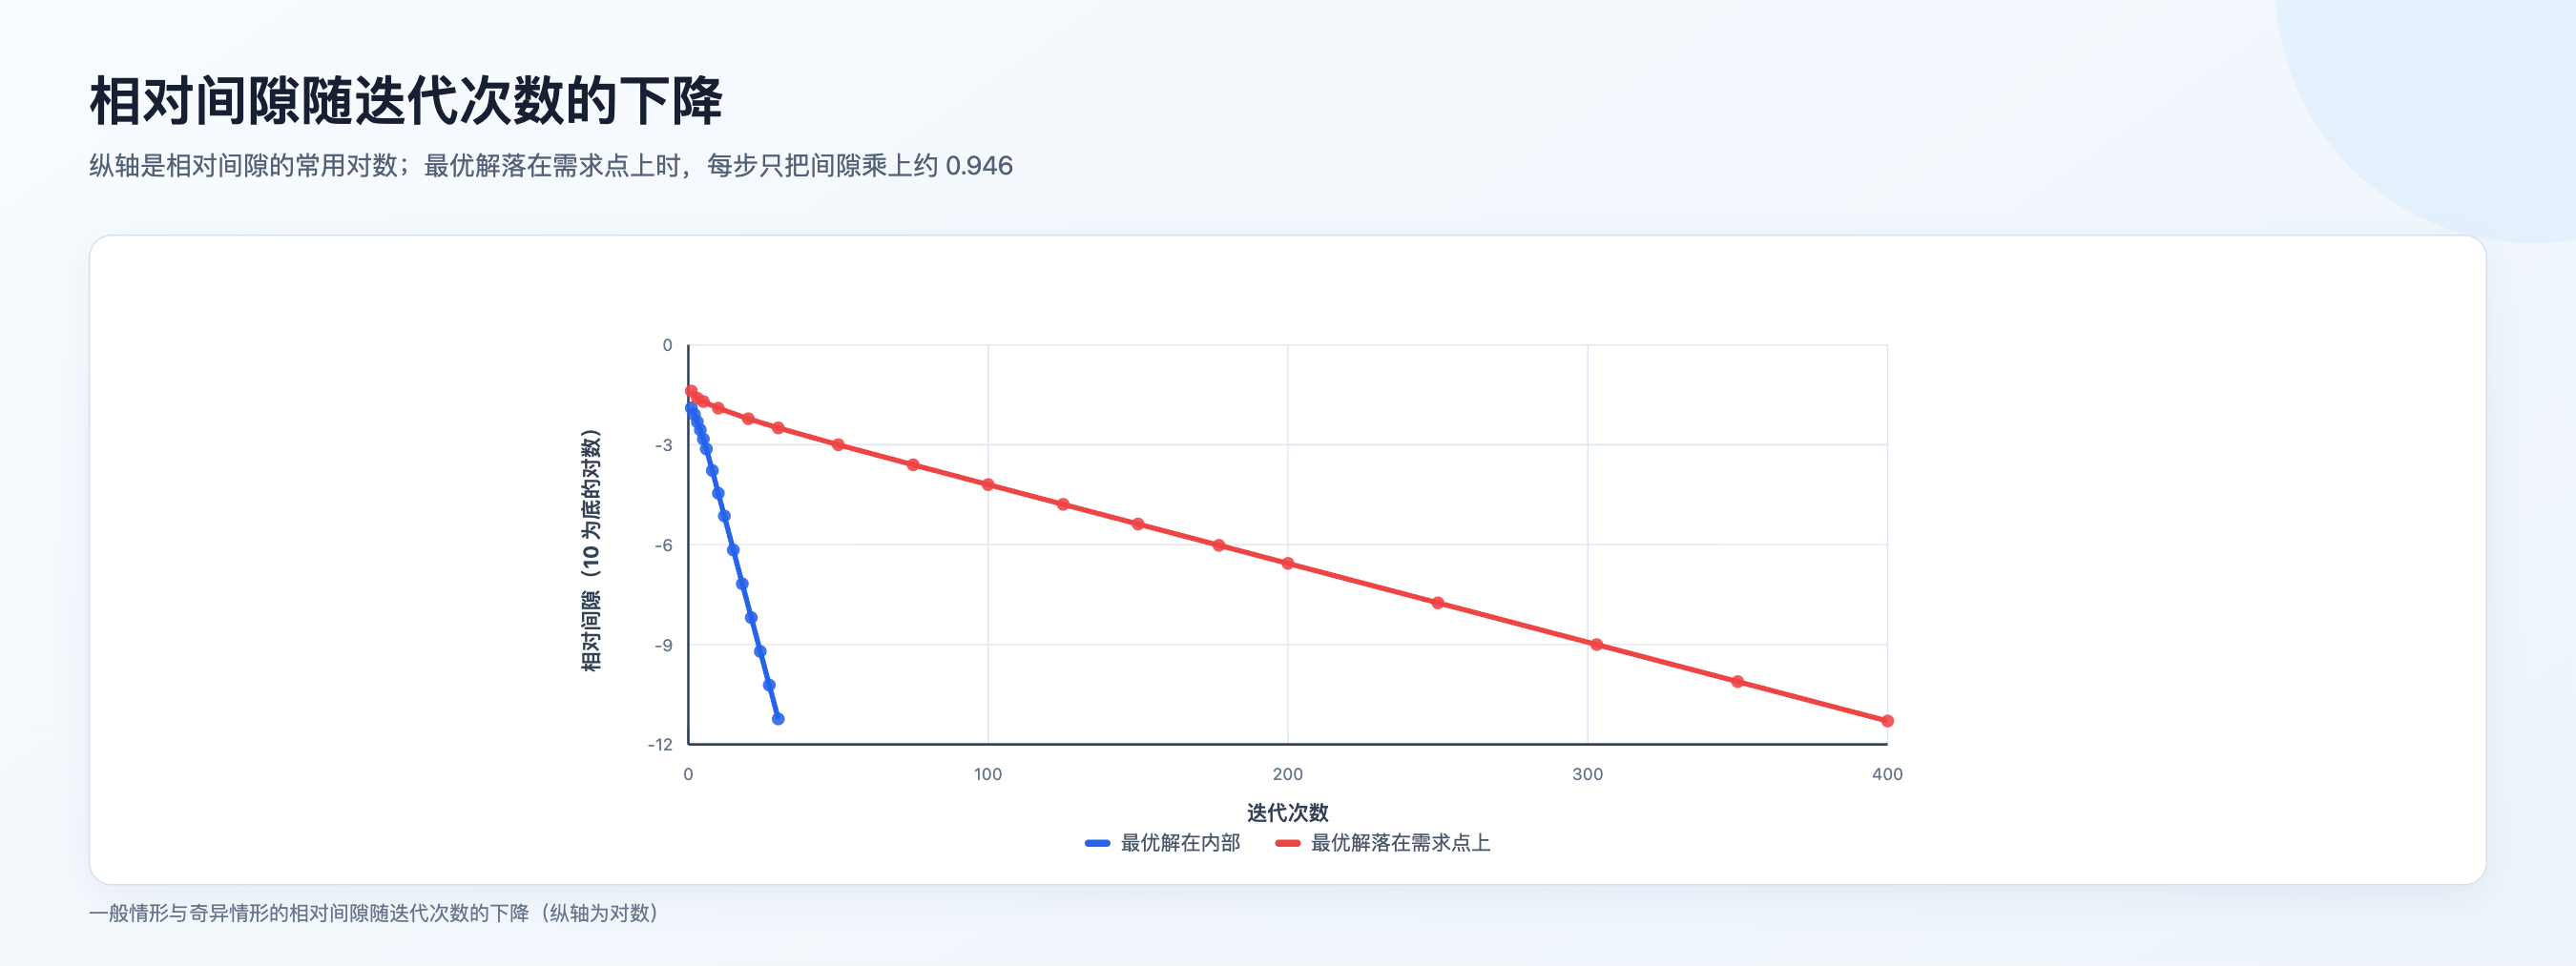
| 1e-3 | 6 | 51 |
| 1e-6 | 15 | 177 |
| 1e-9 | 24 | 303 |
实测的相邻间隙比:一般情形在第 6 步约为 0.481,在第 15 步约为 0.458,即每步把间隙乘上一个明显小于 1 的因子;奇异情形分别是 0.945 与 0.947,几乎贴着 1,于是达到同样的 1e-6 要多花一个数量级以上的步数。
机制解释与第五节直接相连:最优解落在需求点上时,目标函数在最优点不可微,迭代格式在那里没有一个「光滑的」局部模型,收敛自然退化。反过来说,本例中当最优点不在需求点上时,迭代在最优解附近表现为稳定的压缩:间隙比约 0.46。
图 4 把两条间隙曲线画在同一张对数纵轴上:一条很快折下去,另一条几乎是直线地缓慢下降。
关于收敛性的完整分析,可以回到专门讨论这个迭代的文献 2(该文是订阅内容,这里只登记题录,不转述其定理)。如果把距离换成 l_p 距离的 K 次幂,迭代仍有对应的形式,但收敛证明要在对 p 与 K 的某些限制下、针对原问题的 ε 近似给出(3 的摘要)。想要更快时,常用的两条路线是用二阶信息做牛顿型加速,或者在维数较高时改写成二阶锥规划/半定松弛求解。
九、完整算例:逐步数字与敏感性对照
一般实例的迭代轨迹(起点取加权重心 (7.600000, 7.000000)):
| 步 t | x_1 | x_2 | F(x_t) | 相对间隙 |
|---|---|---|---|---|
| 0 | 7.600000 | 7.000000 | 65.402201 | 1.974e-02 |
| 1 | 8.079864 | 7.237269 | 64.955272 | 1.277e-02 |
| 2 | 8.409364 | 7.499185 | 64.654986 | 8.086e-03 |
| 3 | 8.671656 | 7.711741 | 64.449363 | 4.880e-03 |
| 4 | 8.883096 | 7.870984 | 64.314602 | 2.779e-03 |
| 5 | 9.049905 | 7.983529 | 64.231718 | 1.487e-03 |
| 6 | 9.177205 | 8.058333 | 64.184457 | 7.500e-04 |
| 7 | 9.270841 | 8.105008 | 64.159492 | 3.607e-04 |
| 8 | 9.337430 | 8.132465 | 64.147136 | 1.681e-04 |
第一轮迭代可以手算核对:六个点的距离倒数权重分别是 0.096782, 0.135135, 0.130455, 0.384615, 0.371647, 0.600571,分母是 1.7192051697,分子是 (13.8909432525, 12.4423501593),相除得到 (8.0798635890, 7.2372689304),与表里的第 1 步逐位一致。
最小可运行示例。 下面这段纯标准库代码把上面的过程完整跑一遍:先解到步长足够小得到参照值,再打印前 9 步的坐标、目标值与相对间隙,接着打印六个需求点的判据余量、F 点权重取 5 与 6 时的判定,以及阈值下方那次逃逸之后的收敛结果。把它存成 .py 文件直接运行即可,改 P 与 W 就能换一组数据。
python
# 最小可运行示例(纯标准库):六点带权实例的迭代、判据与停止条件
import math

P = [(0.0, 0.0), (10.0, 0.0), (0.0, 8.0), (10.0, 8.0), (4.0, 3.0), (12.0, 12.0)]
W = [1.0, 1.0, 1.0, 1.0, 2.0, 4.0]
NAME = "ABCDEF"

def dist(a, b):
    return math.hypot(a[0] - b[0], a[1] - b[1])

def total(x, pts=P, w=W):
    return sum(wi * dist(x, p) for wi, p in zip(w, pts))

def centroid(pts=P, w=W):
    s = sum(w)
    return (sum(wi * p[0] for wi, p in zip(w, pts)) / s,
            sum(wi * p[1] for wi, p in zip(w, pts)) / s)

def index_at(x, pts=P, tol=1e-12):
    for i, p in enumerate(pts):
        if dist(x, p) <= tol:
            return i
    return None

def margin(k, pts=P, w=W):
    """需求点 p_k 处次梯度集合含零的余量:不大于零表示该点就是最优解。"""
    pk = pts[k]
    sx = sy = 0.0
    for j, p in enumerate(pts):
        if j == k:
            continue
        d = dist(pk, p)
        sx += w[j] * (pk[0] - p[0]) / d
        sy += w[j] * (pk[1] - p[1]) / d
    return math.hypot(sx, sy) - w[k]

def average(x, pts=P, w=W, skip=None):
    """倒数加权平均;skip 给出时要剔除的那一项(它对应的距离为零)。"""
    nx = ny = den = 0.0
    for j, p in enumerate(pts):
        if j == skip:
            continue
        wj = w[j] / dist(x, p)
        nx += wj * p[0]
        ny += wj * p[1]
        den += wj
    return (nx / den, ny / den)

def advance(x, pts=P, w=W):
    k = index_at(x, pts)
    if k is None:
        return average(x, pts, w), "step"
    if margin(k, pts, w) <= 0:
        return x, "stop_at_%s" % NAME[k]
    return average(x, pts, w, skip=k), "escape_from_%s" % NAME[k]

def solve(x, pts=P, w=W, tol=1e-15, limit=400):
    updates = 0
    for _ in range(limit):
        nxt, event = advance(x, pts, w)
        if event.startswith("stop_at"):
            return x, updates, event
        updates += 1
        if dist(nxt, x) <= tol * max(1.0, dist((0.0, 0.0), x)):
            return nxt, updates, "small_step"
        x = nxt
    return x, updates, "limit"

x0 = centroid()
xstar, used, why = solve(x0)
fstar = total(xstar)
print("加权重心 (%.6f, %.6f)   F = %.6f" % (x0[0], x0[1], total(x0)))
print("最优点   (%.6f, %.6f)   F = %.6f   %d 次更新,停止原因 %s"
      % (xstar[0], xstar[1], fstar, used, why))

x = x0
for t in range(1, 10):
    nxt = average(x)
    print("第 %d 步 (%.6f, %.6f)   F = %.6f   相对间隙 %.3e"
          % (t, nxt[0], nxt[1], total(nxt), (total(nxt) - fstar) / fstar))
    x = nxt

print("判据余量 " + "  ".join("%s=%+.6f" % (NAME[i], margin(i)) for i in range(6)))
for wf in (5.0, 6.0):
    ws = W[:5] + [wf]
    print("F 点权重 %.1f:判据余量 %+.6f;从 F 点出发 -> %s"
          % (wf, margin(5, P, ws), solve(P[5], P, ws)[2]))
w5 = W[:5] + [5.0]
xb, ub, _ = solve(P[5], P, w5)
print("权重 5 时逃逸后 %d 次更新到 (%.6f, %.6f)   F = %.6f" % (ub, xb[0], xb[1], total(xb, P, w5)))
运行后打印的前 9 步与上表逐位一致;这段示例是简化版:完整的实验脚本还会输出等高线、对数间隙曲线与敏感性对照,正文用到的每一个数字都能在它里面找到对应行。
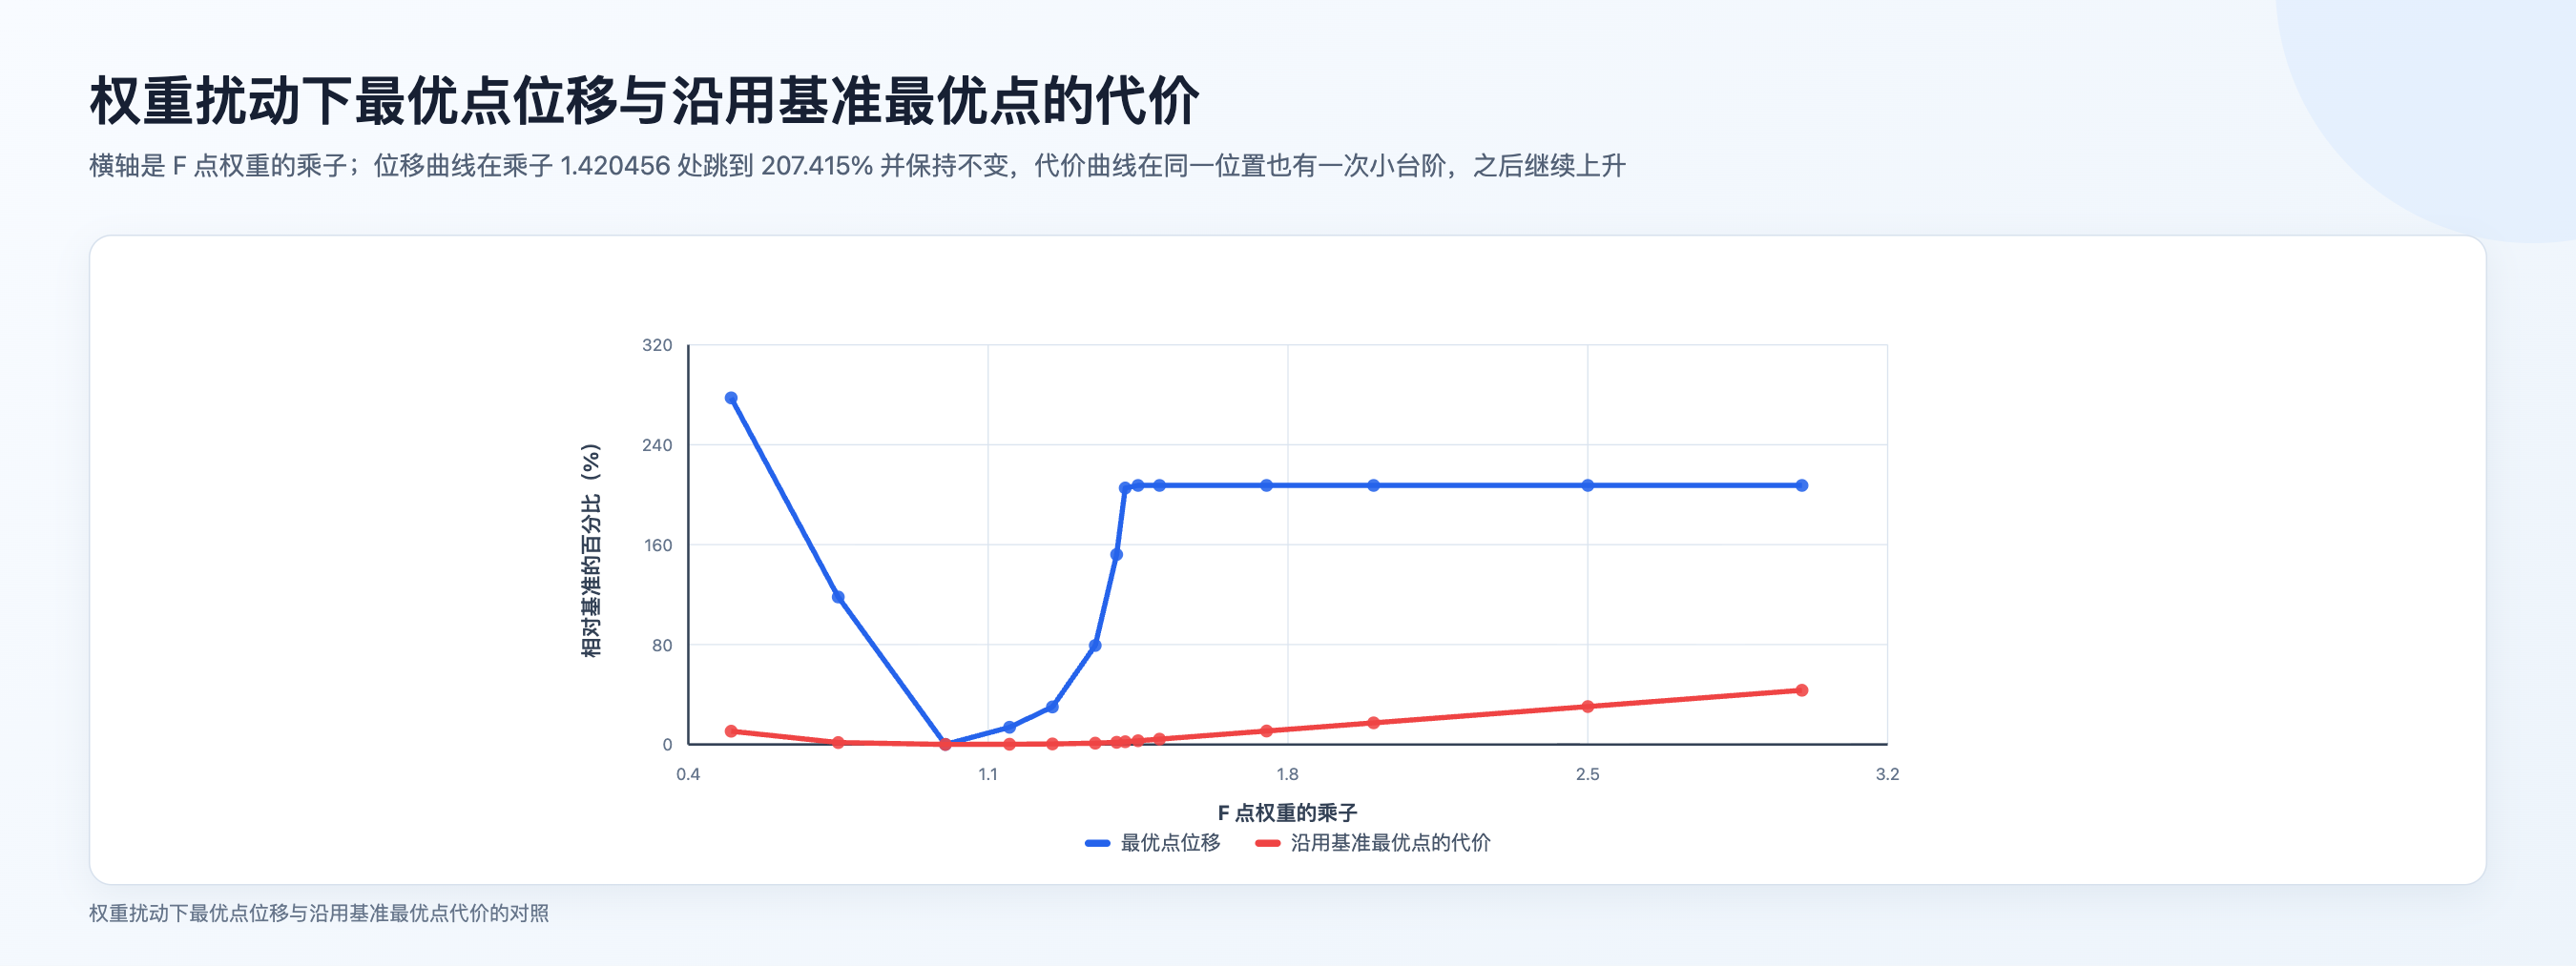
权重敏感性。 以 F 点权重 4 为基准,把它乘以不同的倍数,重新求解最优点(位移以「基准加权重心到基准最优点的距离」2.212176 为 100%,代价是沿用基准最优点时的目标值相对上升):
| 权重乘子 | F 点权重 | 新的最优点 | 位移 | 沿用基准最优点的代价 |
|---|---|---|---|---|
| 0.25 | 1.000 | 4.000000 | 3.000000 | 340.431% |
| 0.50 | 2.000 | 4.937585 | 4.035794 | 277.519% |
| 0.75 | 3.000 | 7.459879 | 6.510302 | 118.064% |
| 1.00 | 4.000 | 9.480363 | 8.165316 | 0.000% |
| 1.25 | 5.000 | 9.767942 | 8.763811 | 30.016% |
| 1.40 | 5.600 | 11.230019 | 11.039076 | 152.090% |
| 1.45 | 5.800 | 12.000000 | 12.000000 | 207.415% |
| 2.00 | 8.000 | 12.000000 | 12.000000 | 207.415% |
| 3.00 | 12.000 | 12.000000 | 12.000000 | 207.415% |
两段行为可以清楚分开:乘子在 1 附近时位移平滑增长;跨过 1.420456 之后最优解整体落到 F 点上,位移跳到 207.415% 并保持不变,而代价继续随权重上升。换句话说,位置对权重是连续的小变化加一次跳变,跳变的原因正是第五节的判据被满足。乘子小于 0.5 时最优解甚至会落到 E 点上(0.25 倍时位移 340.431%、代价 32.684%),说明权重太小的一侧同样会出现「最优点落在需求点上」。
坐标敏感性。 把 F 点沿对角线移动 δ(正数表示向外):
| δ | 新的最优点 | 位移 | 沿用基准最优点的代价 |
|---|---|---|---|
| -2.0 | 8.999496 | 8.300669 | 22.582% |
| -1.0 | 9.264802 | 8.228218 | 10.151% |
| -0.5 | 9.377892 | 8.195657 | 4.831% |
| +0.0 | 9.480363 | 8.165316 | 0.000% |
| +0.5 | 9.573634 | 8.137023 | 4.406% |
| +1.0 | 9.658882 | 8.110614 | 8.440% |
| +2.0 | 9.809105 | 8.062847 | 15.566% |
坐标扰动的效果比权重温和得多:移动两个单位,位移约 15.566%,沿用旧最优点的代价还不到 0.068%。这与权重扰动的差别来自判据:坐标变化改变的是拉力方向,权重变化直接改变判据两边的量级。
图 5 把位移与代价两条曲线画在一起,跳变出现的位置正是判据被满足的那个权重。
这两组数字只说明这个实例的行为,不外推到一般情形;换一组坐标或权重,跳变阈值会变,平滑段的斜率也会变。
十、停止判据与模型的边界
一个可计算的停止判据。 除了「步长足够小」和「判据余量」,还可以用对偶下界回答「当前值离最优值还有多远」。对偶问题把每个需求点配一个向量 y_i,要求 ‖y_i‖ ≤ w_i 且 Σ y_i = 0,此时对任意常数向量 c,Σ y_i·(c − p_i) 都是最优值的下界。用当前点构造一组可行的 y_i,就得到「当前值 − 下界」这个可计算的量:实例中最优点处下界与目标值只差 1.42e-13,第 6 步时下界与当前值相差 1.638776(相对 2.555%),第 15 步时相差 0.067738(相对 0.106%)。它给的是「还差多少」的上界估计,不能替代最优性判据。
距离函数的选择。 全文用的是欧氏距离。如果把距离换成直线距离,目标函数拆成两个一维问题,逐坐标中位数就从「近似答案」变成「准确答案」;换成 l_p 距离的 K 次幂,迭代有对应形式,但要额外的参数条件(3)。距离函数不是实现细节,它决定答案是谁。
需求点位置与权重的不确定性。 本文把坐标与权重当常数,第九节的对照说明这个假设值多少钱:权重跨过阈值时最优解会整体跳到某个需求点上,这种跳变不会出现在线性灵敏度分析里。需求点位置有误差时,通常的做法是把不确定性写进模型(鲁棒或随机版本),而不是对最优点做一次线性外推。
规模与实现。 需求点很多时,每次迭代是 O(n) 的向量运算;迭代次数在本例的良态情形下与精度要求的位数大致成正比(24 步到 1e-9),但在最优解落在需求点上的情形会明显变慢(本例 303 步)。真正需要在实现里守住的是三件事:显式检查候选数据点、用判据而不是步长判定奇异情形、以及给收敛判据留一个与数据点检查并联的分支。
参考文献
1 E. Weiszfeld, Frank Plastria. On the point for which the sum of the distances to n given points is minimum. Annals of Operations Research, 2008, 167(1): 7-41. DOI: 10.1007/s10479-008-0352-z
2 Lázaro Cánovas, Roberto Cañavate, Alfredo Marín. On the convergence of the Weiszfeld algorithm. Mathematical Programming, 2002, 93(2): 327-330. DOI: 10.1007/s101070200297
3 James G. Morris. Convergence of the Weiszfeld Algorithm for Weber Problems Using a Generalized "Distance" Function. Operations Research, 1981, 29(1): 37-48. DOI: 10.1287/opre.29.1.37
4 Harold W. Kuhn, Robert E. Kuenne. AN EFFICIENT ALGORITHM FOR THE NUMERICAL SOLUTION OF THE GENERALIZED WEBER PROBLEM IN SPATIAL ECONOMICS. Journal of Regional Science, 1962, 4(2): 21-33. DOI: 10.1111/j.1467-9787.1962.tb00902.x