👋 欢迎阅读
🎯 欢迎来到「判定字符是否唯一」题解之旅! 本文将带你从"检查一串字符里有没有重复的字母"这一直观场景出发,深入理解位图(位运算) 的巧妙运用,并掌握如何用一个整数的二进制位记录字符出现情况 来在 O(n) 时间内判断唯一性。
在开始之前,建议你先:
-
了解题目背景 :这是 LCR 191(面试题 01.01)题,给定字符串
astr,判断其中所有字符是否全部不同 ------有重复返回false,全部唯一返回true。本质上,问题转化为对每个字符做"是否出现过"的查询与标记 ,而小写字母只有 26 个,正好可以用一个 int 的 26 个比特位表示。 -
明确学习目标 :掌握位图标记与查询 技术,理解
(b >> ch) & 1判存在 与b |= (1 << ch)置位 的原理,并熟练处理空串 与字符集范围等边界情况。 -
准备好环境 :建议在本地 IDE 或 LeetCode 在线编辑器中打开代码,边看边运行,亲手验证示例(如
astr = "leetcode"输出false,astr = "abc"输出true)。
本文将从问题转化、位图原理、查重与置位、边界防护 到代码实现,层层递进。即使你对位运算 还不熟悉,我们也会从"给 26 个字母每人一个座位,来了就看看座位有没有人"这一直觉出发,让你轻松抓住核心思想 ------一位一字符,查空即坐,重坐即重。现在,让我们一起用位图点名,判断字符是否唯一吧! 🔍🎯
🔥愿旖旎 · 个人主页
📘学习专栏: 《算法专栏》《LangChain学习》《贪心算法》
🌄 钱塘江上潮信来,今日方知我是我
✨当前学习内容**:** 《位运算》
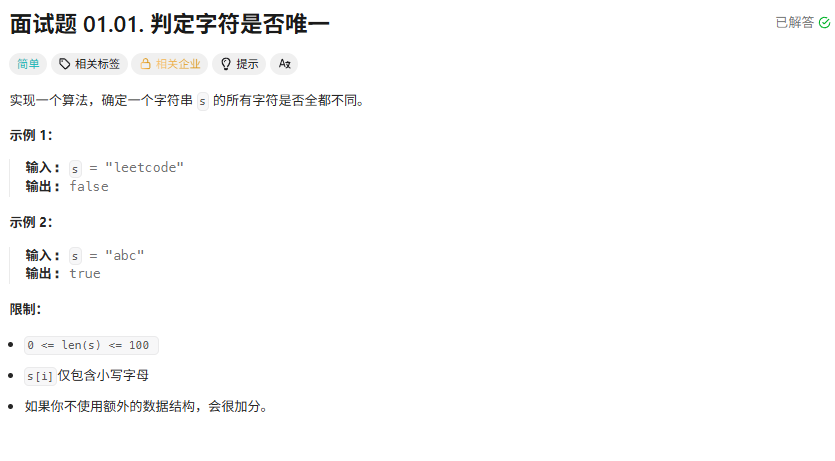
一.题目
面试题 01.01. 判定字符是否唯一 - 力扣(LeetCode)
二、算法分析
一、问题分析(前置分析)
- 题目要求:判断字符串
astr中所有字符是否唯一 (无重复),有重复返回false,否则true。 - 关键约束:字符限定为小写字母 (26 个);空串 视为唯一;不允许使用额外数据结构(面试原题常附加此条件)。
- 核心思路:暴力做法用双重循环 两两比较,总代价 O(n²);用哈希思想 只需知道"每个字符是否出现过",小写字母仅 26 种,恰好可以用一个 int 的 26 个比特位 当"极简哈希表",查询与标记都是 O(1),总复杂度 O(n)。
📌 例子:为什么可以用一个整数代替哈希表
astr = "abca":'a'、'b'、'c' 依次出现,第 4 个字符又是 'a'------只需记住"a 来过",就能判定重复。26 个小写字母的"来过与否"是 26 个布尔值 ,正好对应 int 的 26 个比特位(int 有 32 位,绰绰有余),一个整数 4 字节即可完整表示 ,比bool[26](26 字节)更省空间。
二、算法策略(位图标记 + 查重)
核心步骤:
- 初始化 :
b = 0(32 个比特全 0,表示"谁都没来过")。 - 遍历每个字符 :取字符相对 'a' 的偏移
ch = astr[i] - 'a'(范围 0~25)。 - 查询是否出现过 :
if ((b >> ch) & 1) return false;(把第 ch 位移到最低位,与 1 相与------结果为 1 说明该位已置位,字符来过)。 - 标记出现 :
b |= (1 << ch);(把第 ch 位置 1,表示"该字符来过了")。 - 返回 :遍历结束未发现重复,返回
true。
📊 示例 (astr = "abca"):
| 步骤 | 字符 | ch | b 的二进制(低位在右) | 查询 (b>>ch)&1 | 操作 | 结果 |
|---|---|---|---|---|---|---|
| 初始 | --- | --- | ...0000 |
--- | --- | --- |
| i=0 | 'a' | 0 | ...0000 |
0(未出现) | 置位 → ...0001 |
继续 |
| i=1 | 'b' | 1 | ...0001 |
0(未出现) | 置位 → ...0011 |
继续 |
| i=2 | 'c' | 2 | ...0011 |
0(未出现) | 置位 → ...0111 |
继续 |
| i=3 | 'a' | 0 | ...0111 |
1(已出现) | 返回 false | false |
i=3 时 'a' 对应的第 0 位已是 1,判定重复,返回 false ✅;若换成 "abc",三次查询全为 0,遍历结束返回 true。
三、正确性说明(简单版本)
- 位图语义精确 :
b的第ch位为 1 ⇔ 字符'a'+ch已经出现过 ;为 0 ⇔ 尚未出现。每个小写字母占据唯一且固定 的比特位,不会互相干扰(26 < 32,无位溢出)。 - 查询公式正确 :
(b >> ch) & 1把第 ch 位移到最低位后与 1 相与,恰好取出该位的值 ,为 1 即重复------与"该字符是否出现过"逐字对应,不会误判。 - 置位公式正确 :
b |= (1 << ch)用或运算 把第 ch 位强制置 1,且不影响其他位(或 1 置位、或 0 保持),标记精确。 - 覆盖全部字符 :遍历每个字符都做一次"查询 + 置位",任何重复都会在第二次出现时被立即捕获 ,不漏判;全不重复则返回
true。
📌 例子:为什么 (b >> ch) & 1 能取到第 ch 位
设
b的二进制为...0111('a'、'b'、'c' 已出现),检查 'b'(ch=1):右移 1 位得...0011,与 1 相与 →1,说明 'b' 出现过 ;检查 'd'(ch=3):右移 3 位得...0000,与 1 相与 →0,说明 'd' 没出现过 ------右移把目标位挪到最低位,与 1 相与即读出该位,这就是"取第 ch 位"的标准写法。
四、实现细节(边界防护)
- 初始化:
b = 0(所有位为 0 ,表示空集)、n = astr.size()。 - 边界防护:空串 时
n = 0,循环不进入,直接返回true(空串无重复字符,符合题意);ch = astr[i] - 'a'范围 0~25,1 << ch最大1 << 25,远小于 int 上限 ,无溢出;字符集限小写字母 ,若超出则ch可能 ≥ 32 导致位移溢出(UB),需提前扩展位图。 - 复杂度:时间 O(n) (每个字符一次查询 + 一次置位),空间 O(1)(只有一个 int,4 字节)。
- 关键操作 :
if ((b >> ch) & 1) return false;(查重)、b |= (1 << ch);(置位标记)。
📌 例子:空串与单字符的边界
astr = "":n = 0,循环一次都不执行 ,直接返回true------空串没有任何字符,唯一性成立。astr = "a":ch=0,(0 >> 0) & 1 = 0(未出现),置位后b = 1,遍历结束返回true------单字符天然唯一,两个边界都由同一套逻辑自然处理。
五、返回值(目标映射)
- 返回
false:发现重复字符 (第二次出现时立即返回);返回true:遍历完毕无重复,对应题目"字符是否唯一"的判定。
三.代码
cpp
class Solution
{
public:
    bool isUnique(string astr)
    {
        int b = 0;                  // 位图:第 ch 位为 1 表示字符 'a'+ch 已出现过
        int n = astr.size();

        // 1. 遍历每个字符:查重 -> 置位
        for (int i = 0; i < n; i++)
        {
            // 获取字符偏移:'a' 对应第 0 位,'z' 对应第 25 位
            int ch = astr[i] - 'a';

            // 2. 查重:把第 ch 位移到最低位后与 1 相与,为 1 说明该字符已出现
            if ((b >> ch) & 1)
            {
                return false;       // 出现重复字符,立即返回
            }

            // 3. 置位标记:把第 ch 位置 1,表示该字符已经来过(不影响其他位)
            b |= (1 << ch);
        }
        return true;                // 4. 遍历结束无重复,字符全部唯一
    }
};
四、易错点分析
难点1:(b >> ch) & 1 的取位逻辑
cpp
if ((b >> ch) & 1) // 取出第 ch 位
b >> ch把第 ch 位移到最低位 ,& 1只保留最低位------两步合起来就是"读出第 ch 位 "。若写成b & (1 << ch)也能判断(结果为 0 或非 0),但不能写成b & ch(那是把 ch 当掩码,语义完全错误)。理解"右移到最低位再与 1"这个标准范式,可以避免大量位运算错误。
难点2:b |= (1 << ch) 而非 b += (1 << ch)
cpp
b |= (1 << ch);    // 正确:或运算置位
// b += (1 << ch); // 危险:若该位已是 1,加法会产生进位污染其他位置位必须用或运算 :
1 << ch只有第 ch 位是 1,或其他位都能正确置位;若用+=,当该位已是 1 时相加会进位 ,把第 ch+1 位也变成 1,污染其他字符的标记 ,导致后续误判。虽然本代码在置位前已排除"该位为 1"的情况(重复会先返回),但养成用|=的习惯才是安全的。
难点3:字符集范围与位移溢出
cpp
int ch = astr[i] - 'a';    // 小写字母:0 ~ 25
b |= (1 << ch); // 1 << 25 安全;若 ch >= 32 则 UB本题限定小写字母 (26 个),
ch ∈ [0,25],1 << ch最大2^25,在 int 范围内绝对安全 。若字符集扩展到大小写 + 数字 (62 个)或 ASCII (128 个),ch可能 ≥ 32,1 << ch会位移溢出 (UB)------此时必须改用long long(64 位)或多个 int 组成位图,或退回哈希集合。
难点4:为什么位图比 bool[26] 更优
cpp
int b = 0;                // 4 字节表示 26 个状态
bool vis[26] = {false};   // 26 字节表示同样 26 个状态
bool[26]虽然简单,但每个元素占 1 字节 (共 26 字节);位图把 26 个状态压缩进 32 位 (4 字节),空间缩小到 1/8 以内 ,且查询/置位都是单条位运算指令 ,比数组寻址更快。这是"用时间换空间?不,是同时省空间又提速 "的典型------状态数少且固定用位图,状态多或用哈希。
难点5:提前判断"字符串长度 > 26 必重复"的优化
cpp
if (astr.size() > 26) return false; // 可选优化:26 个字母装不下更多唯一字符小写字母只有 26 个,若字符串长度 超过 26 ,根据鸽巢原理 必然有重复,可直接返回
false,无需遍历。
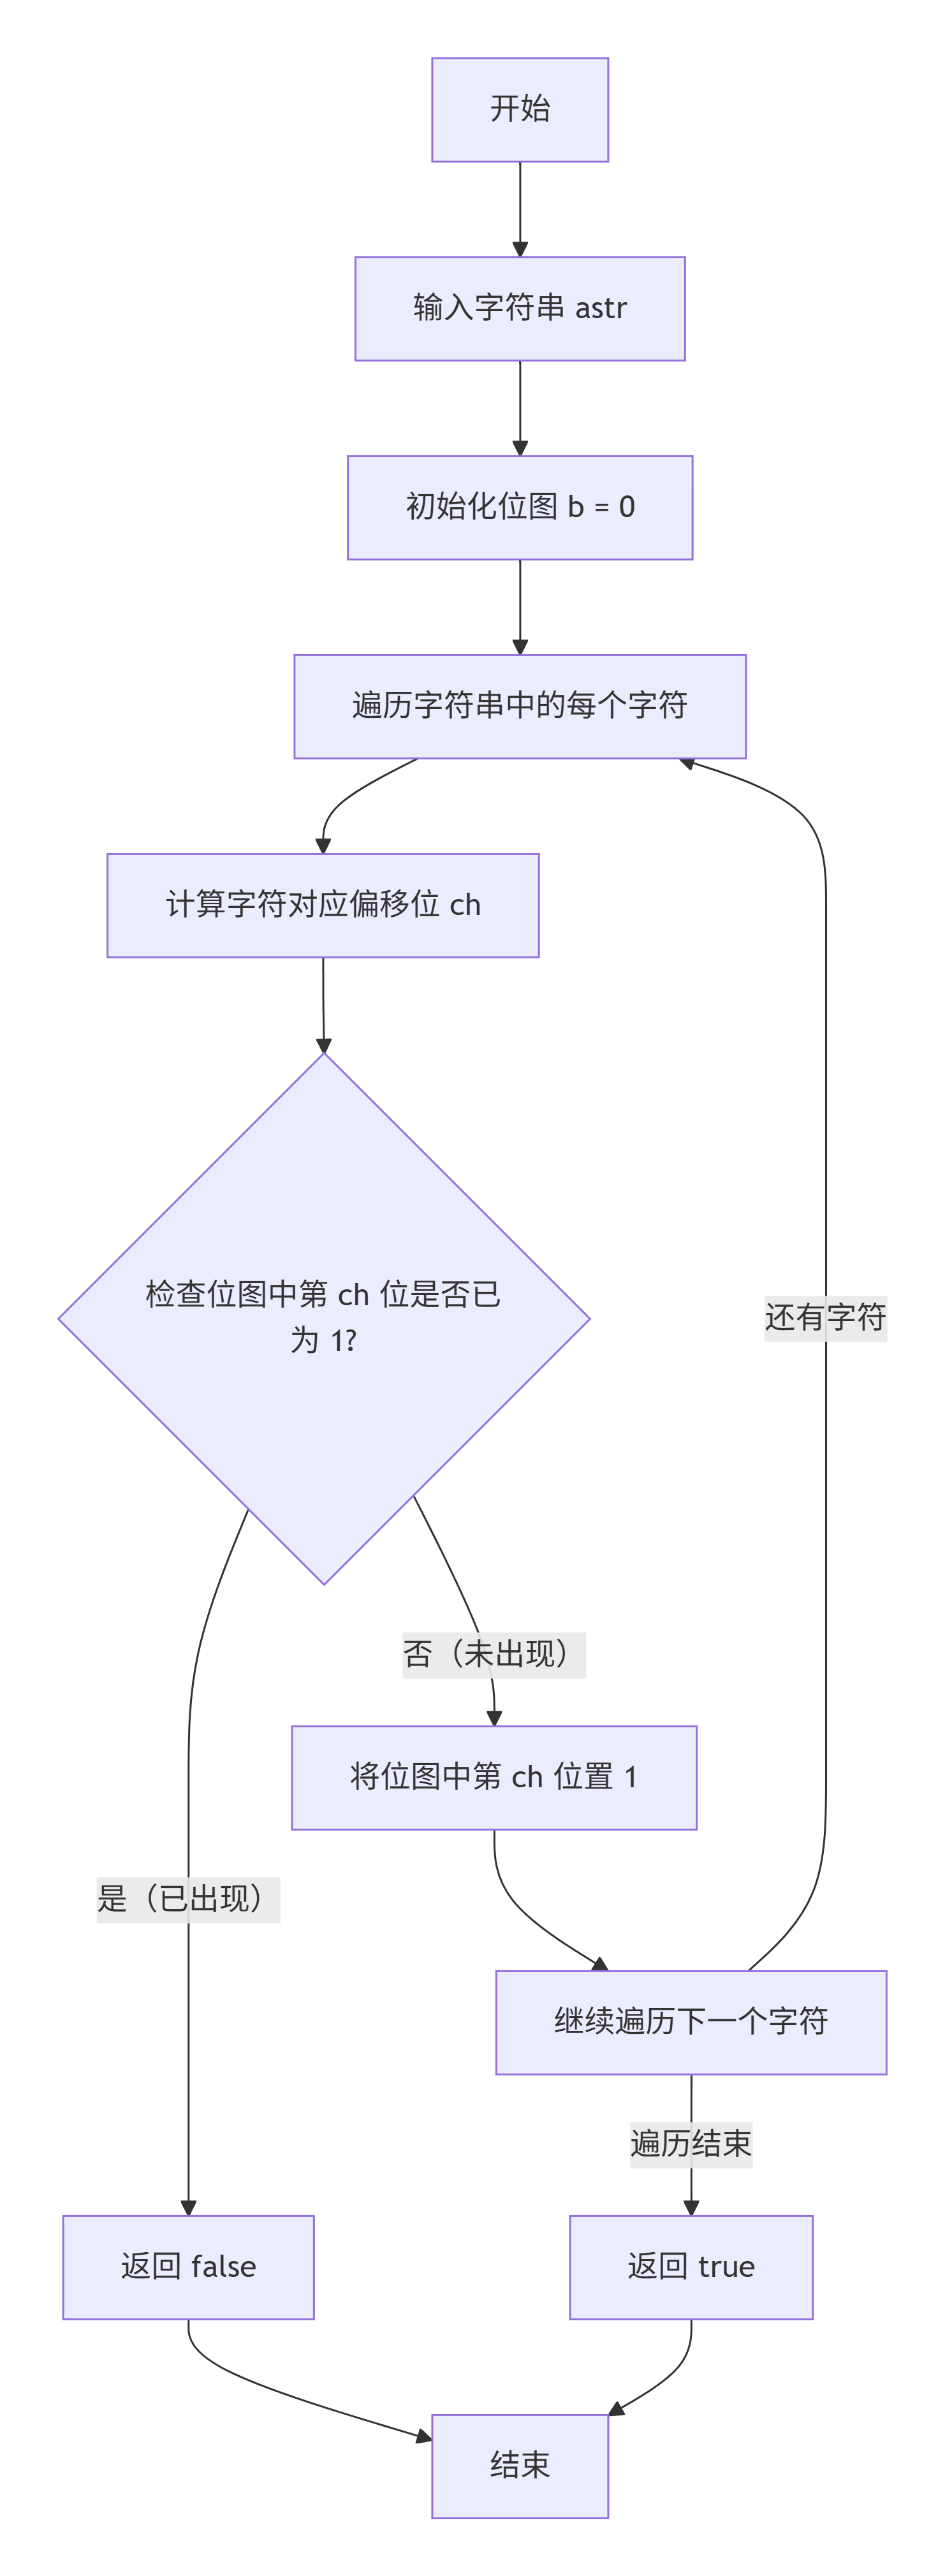
五、流程图
🎯 闭幕
🎉 恭喜你完成了「面试题 01.01. 判定字符是否唯一」问题的学习!
为了巩固知识并进一步拓展,建议你:
🚀 动手实践
在 LeetCode 上提交代码,尝试不同的测试用例。
💡 深入思考
-
本题使用一个 int 位图 来标记字符是否出现过,
'a'对应第 0 位,'z'对应第 25 位。为什么一个 int 就足够? -
查重时使用
(b >> ch) & 1,置位时使用b |= (1 << ch)。这两种位运算分别实现了什么功能? 如果换成b & (1 << ch)来判断是否出现过,是否等价? -
题目特别提示"如果不使用额外的数据结构,会很加分"。位图算不算额外的数据结构? 它的空间复杂度是多少?为什么说它比哈希表更节省空间?
-
如果字符串长度 超过 26 且只包含小写字母,是否一定存在重复字符?能否在遍历前直接根据长度返回结果? 这样做有什么好处?
如果你觉得本文对你有所帮助,欢迎:
📌 深入思考答案
-
一个 int 足够,因为小写字母只有 26 个,int 通常有 32 位,足以容纳 26 个标记位。
-
(b >> ch) & 1是 取出第 ch 位 并判断是否为 1,b |= (1 << ch)是 将第 ch 位置 1 。换成b & (1 << ch)也能判断是否出现过,结果等价,但前者更直观地展示了"取位"动作。 -
位图不算传统意义上的额外数据结构,它只是一个整型变量,空间 O(1)。相比哈希表 O(字符种类数),位图更节省空间,且位运算速度极快。
-
若字符串长度 超过 26 且只含小写字母,根据鸽巢原理 必然有重复 ,可在开头加
if (astr.size() > 26) return false;,提前剪枝,避免无谓遍历。
👍 点赞 / 收藏
👤 关注作者 ,获取更多题解
💬 留言交流你的疑问或优化思路
祝你在 算法之路 上越走越稳,早日攻克每一道难题!下次见 🚀✨