✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
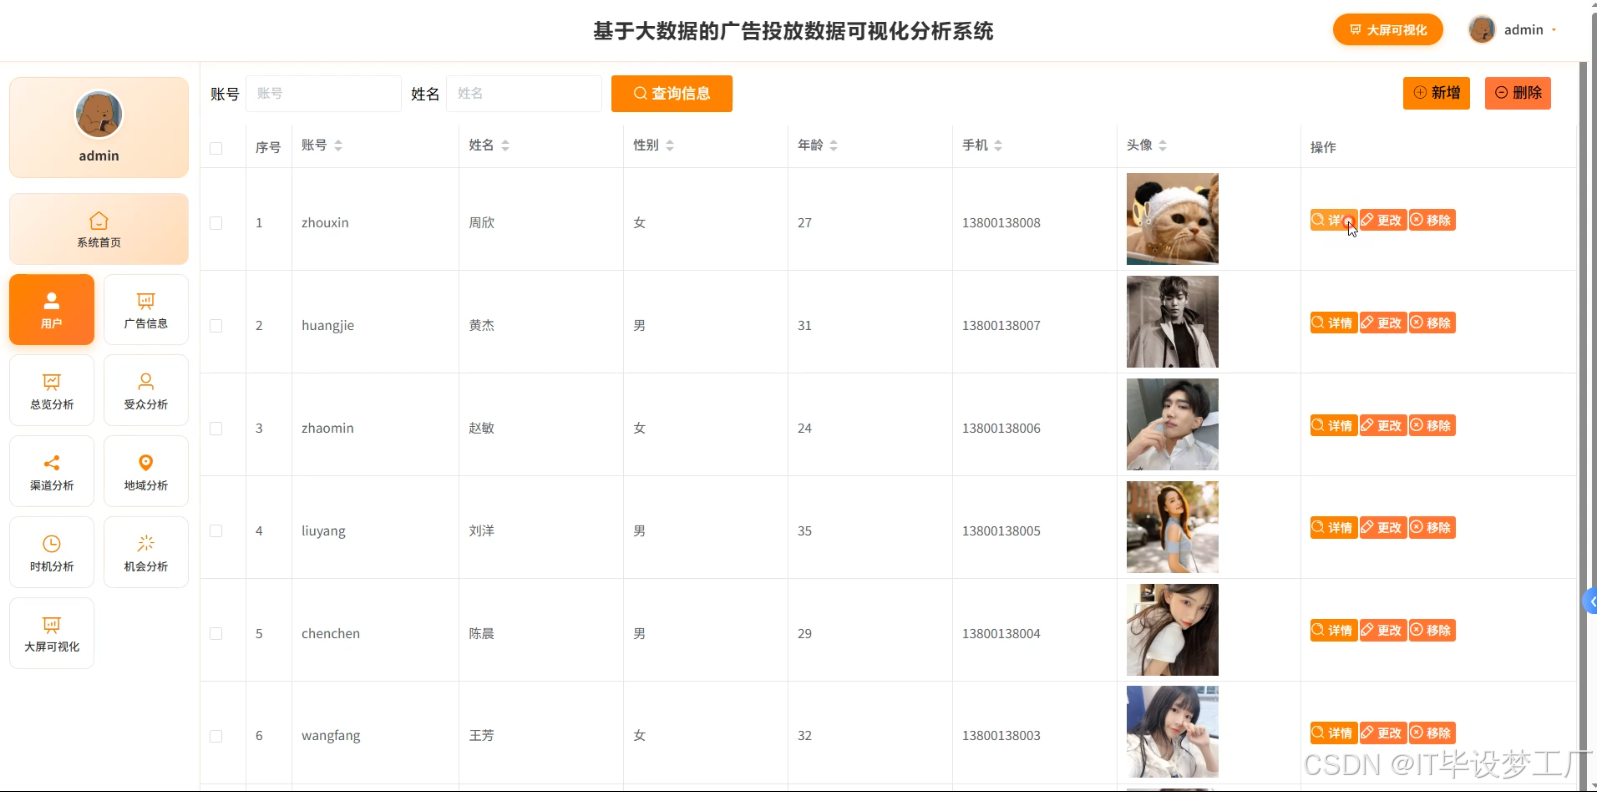
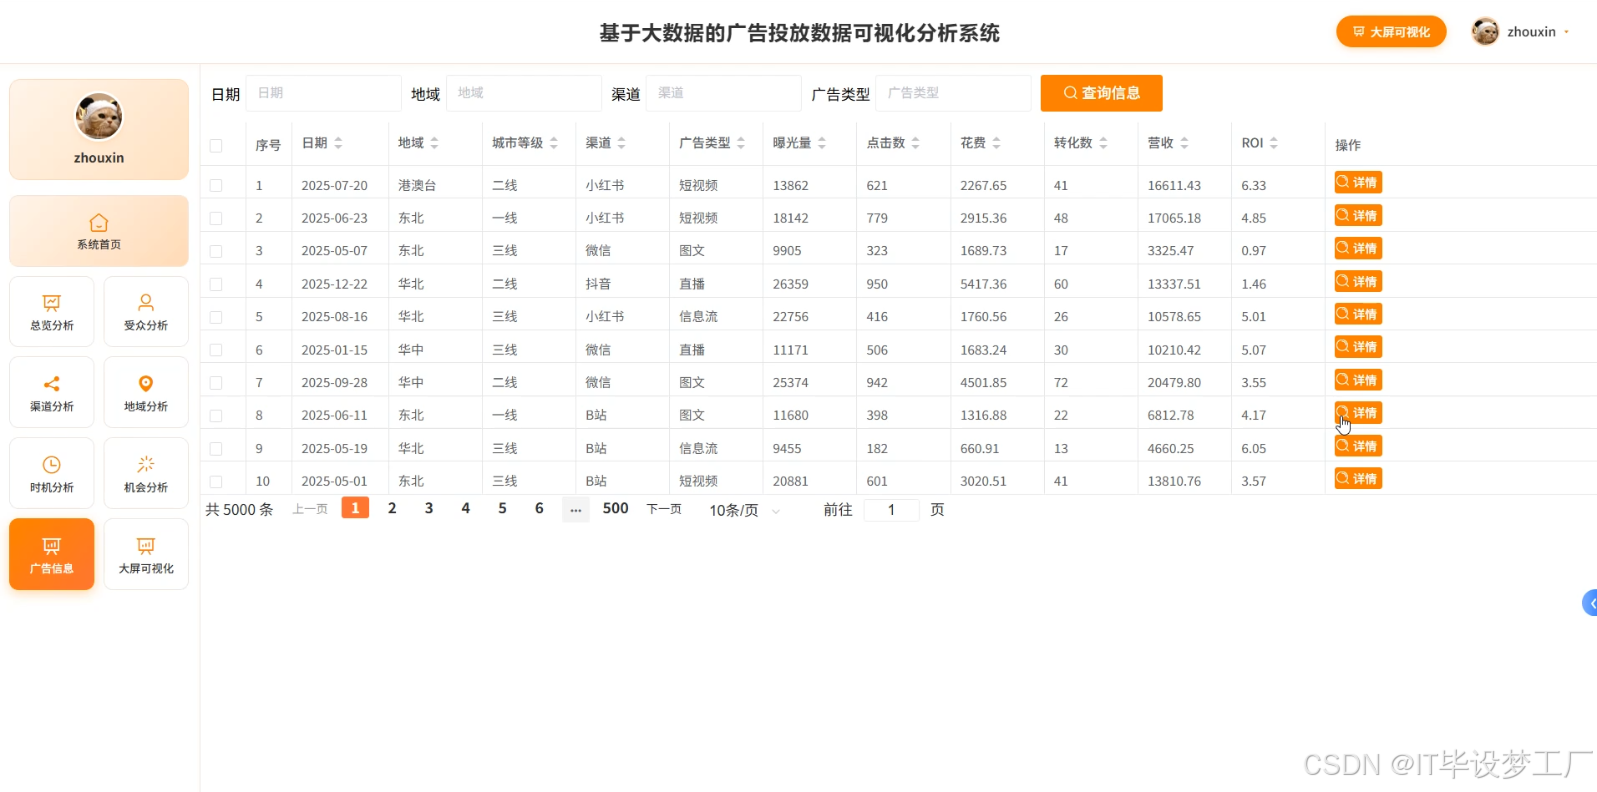
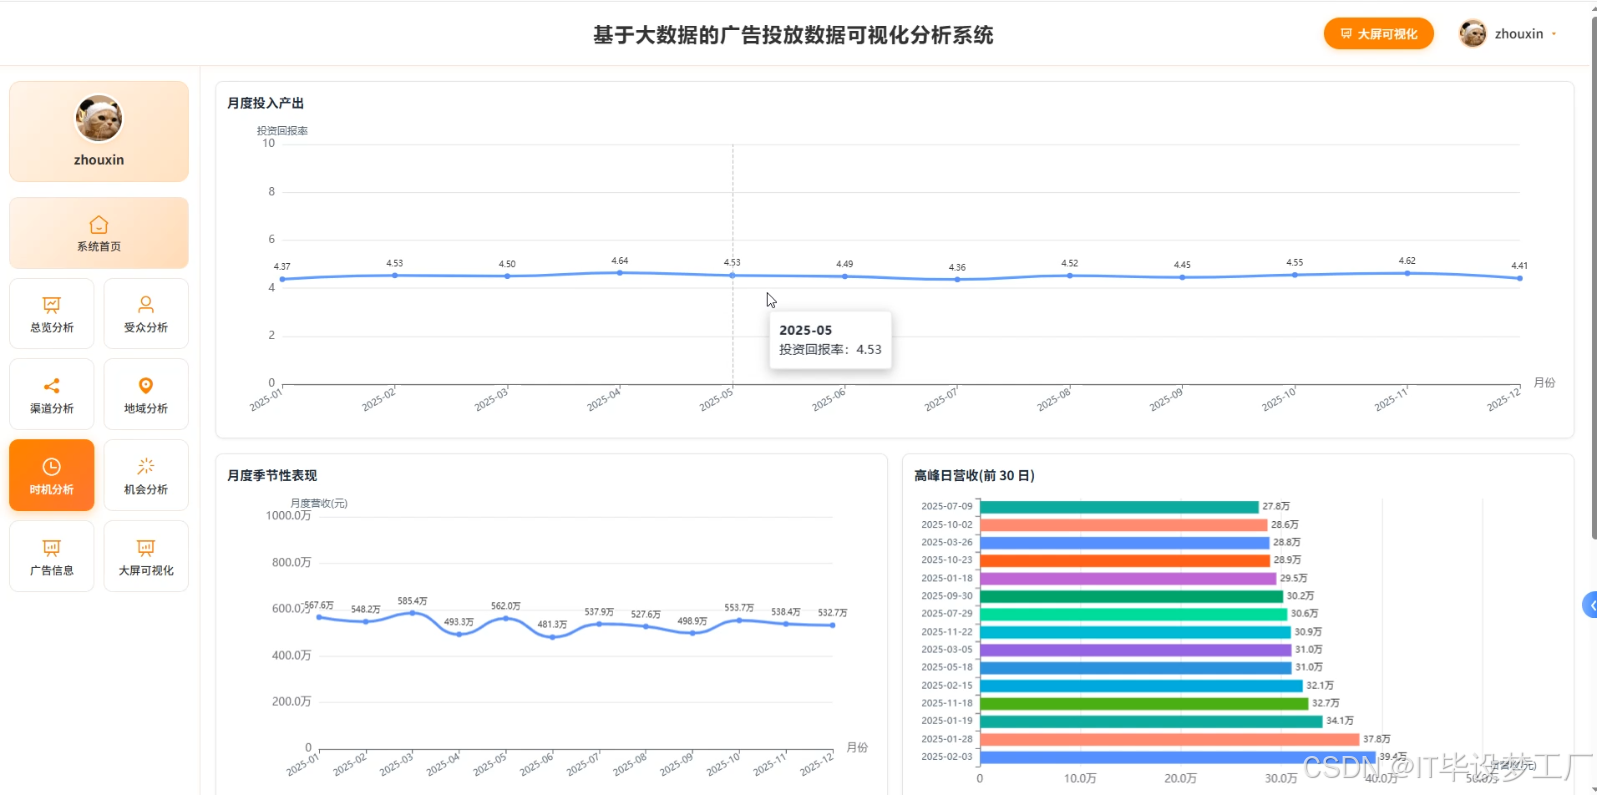
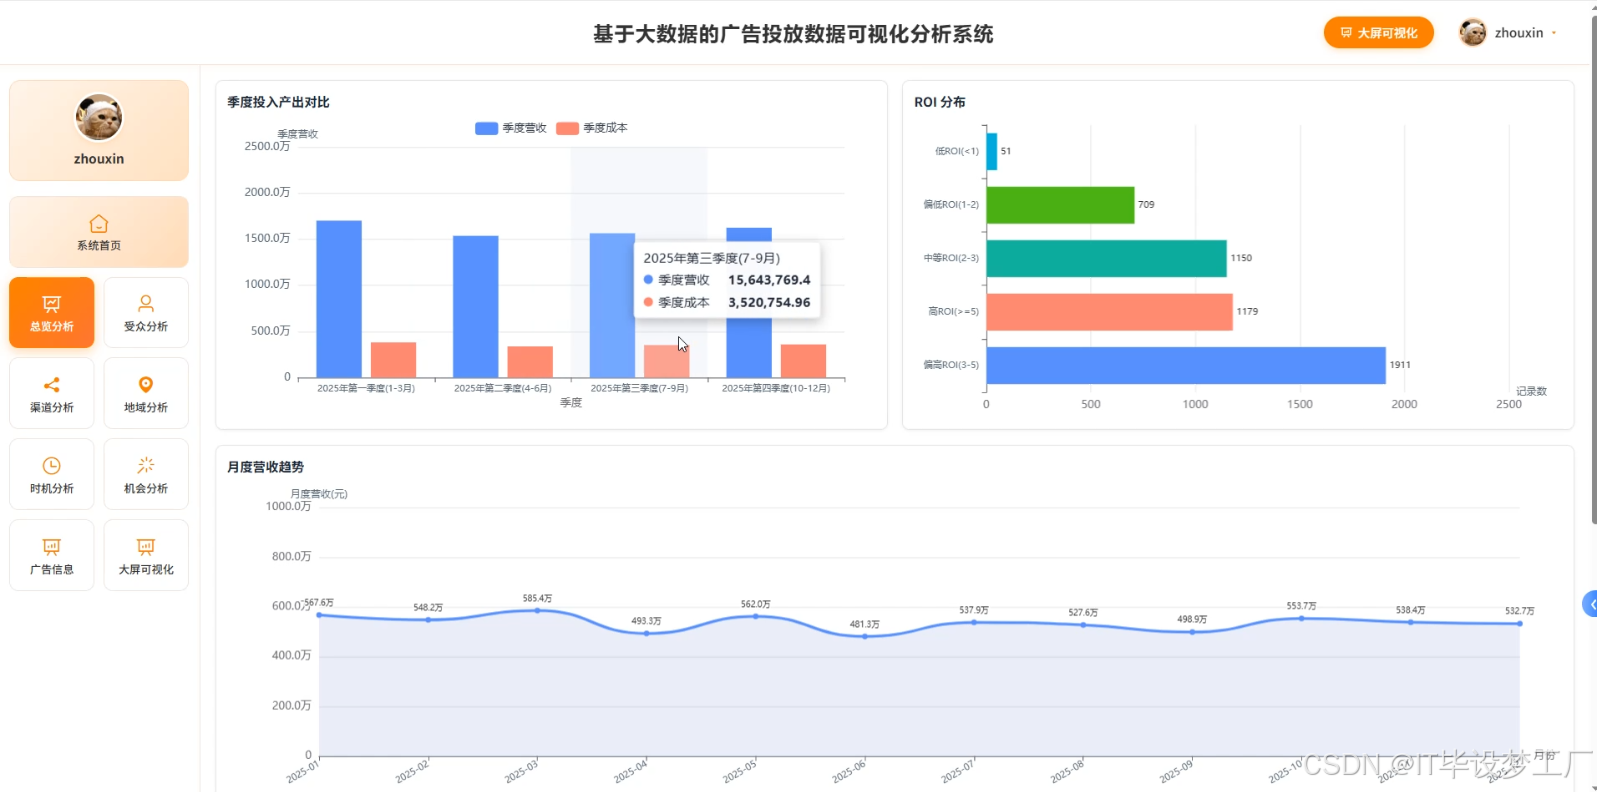
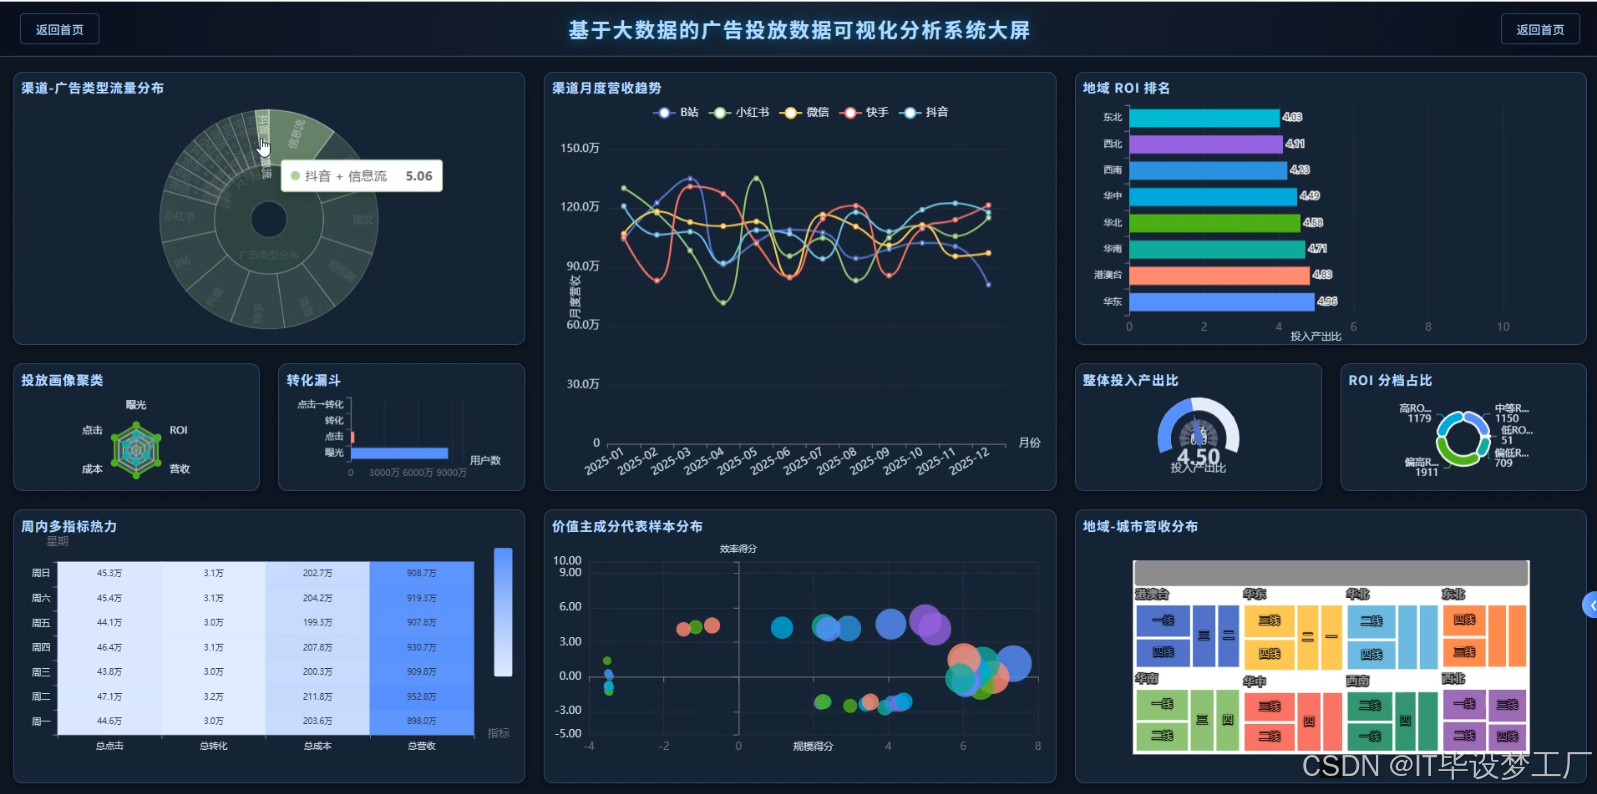
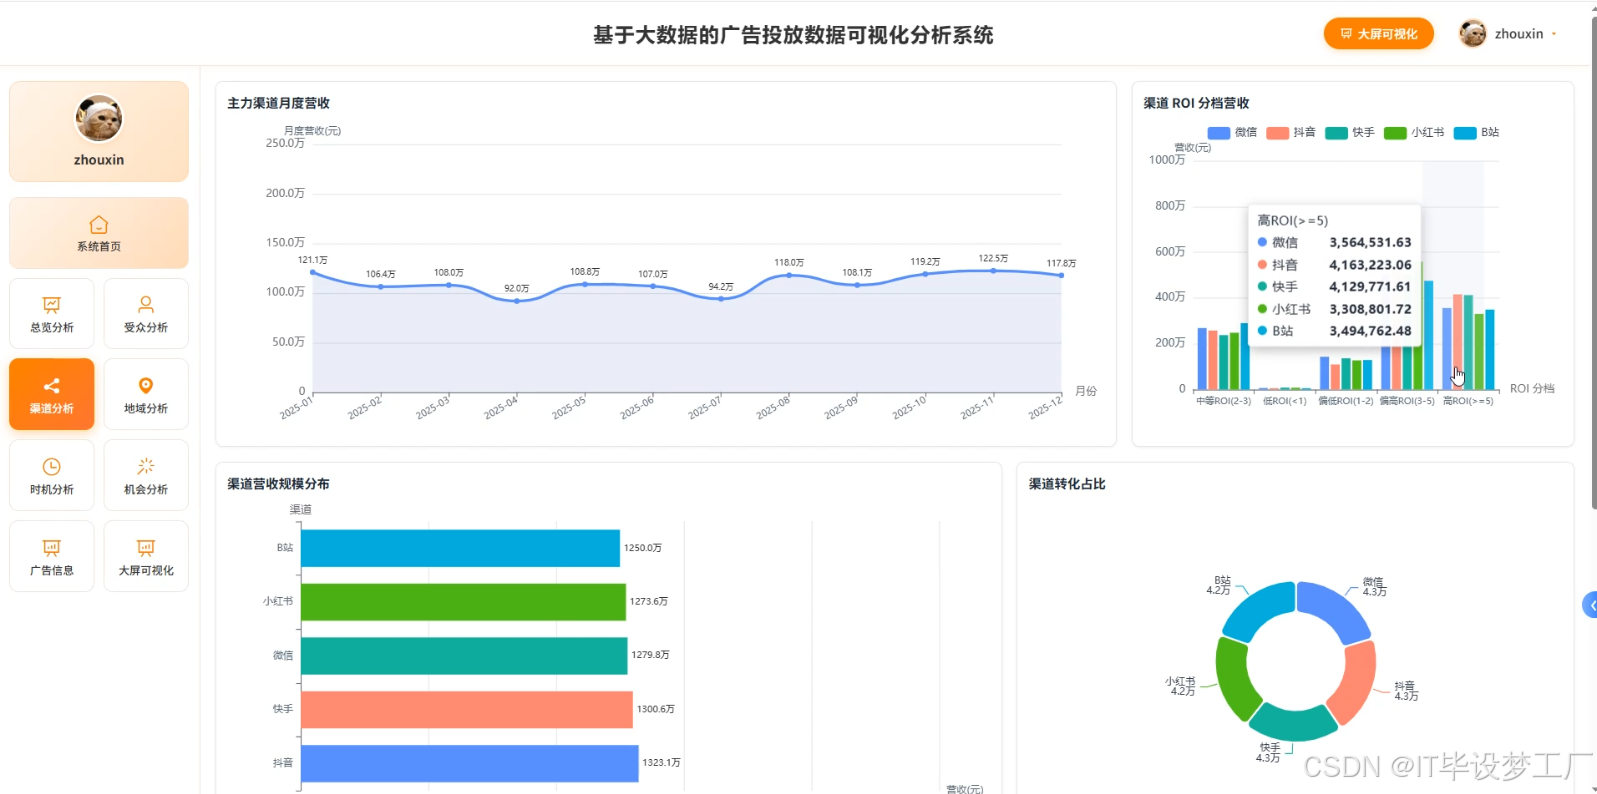
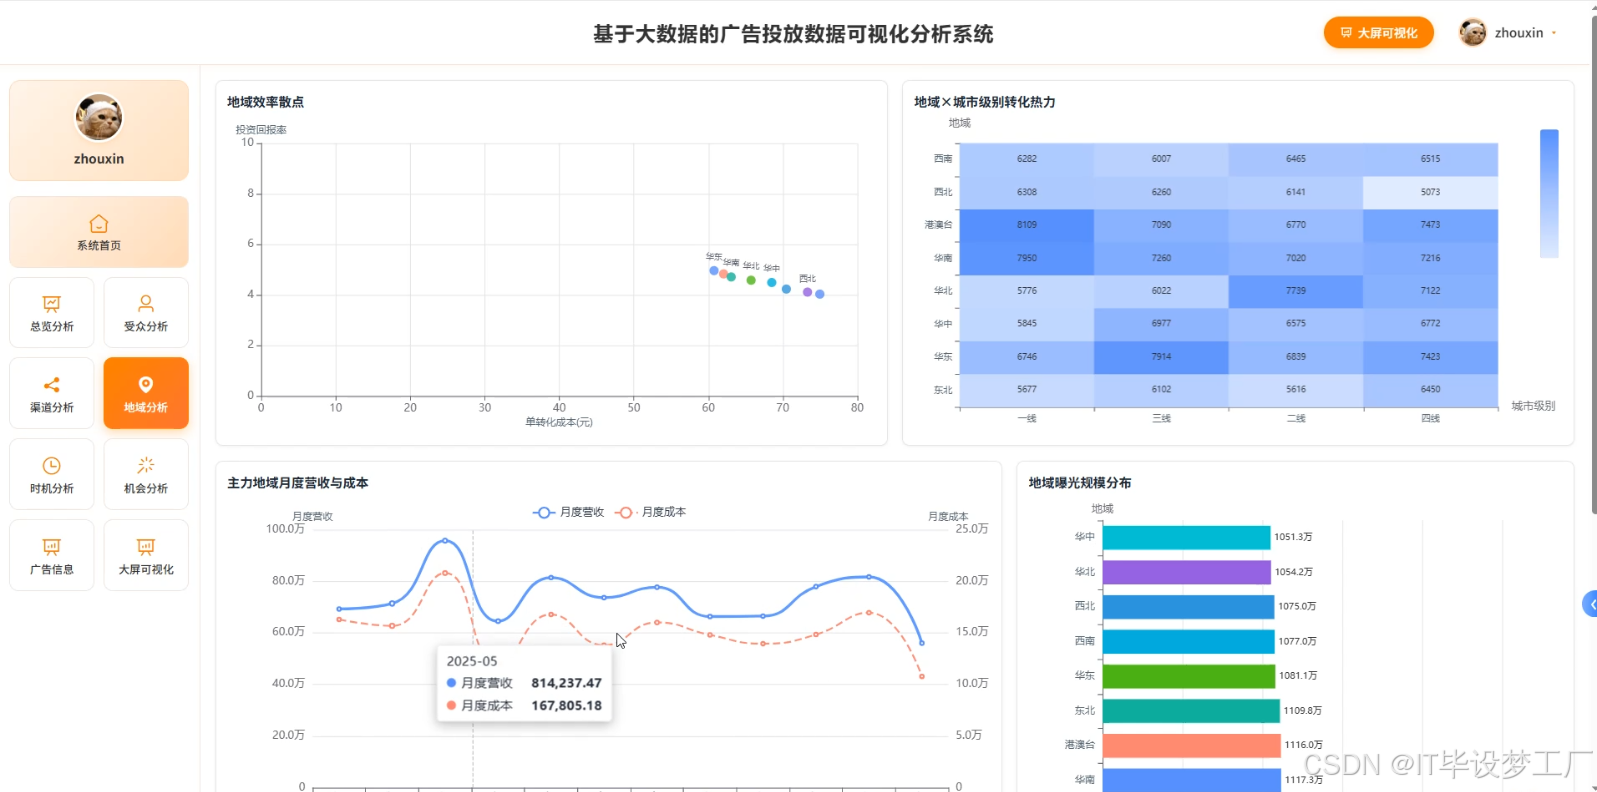
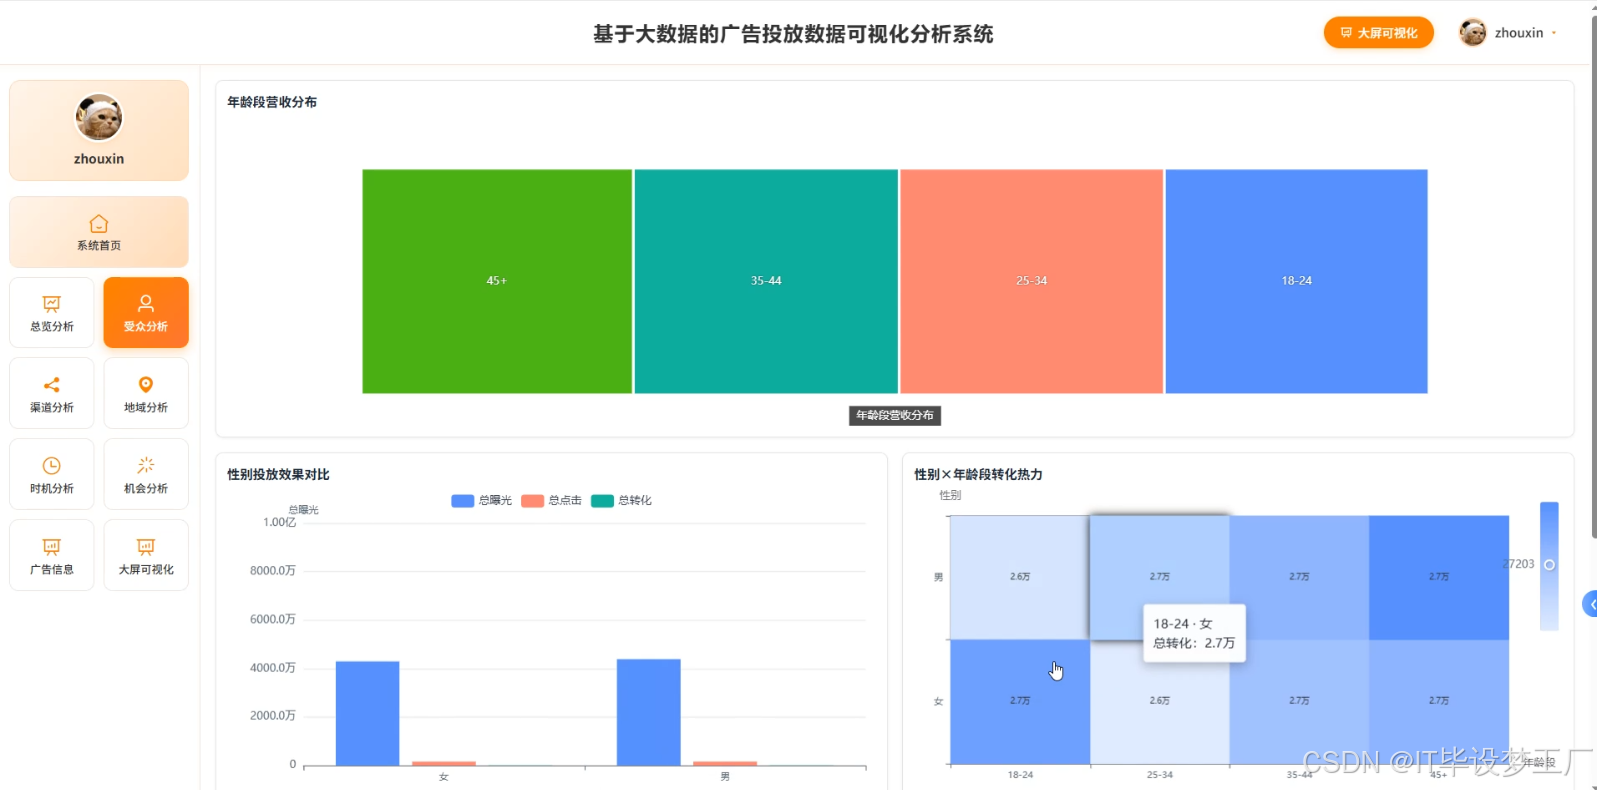
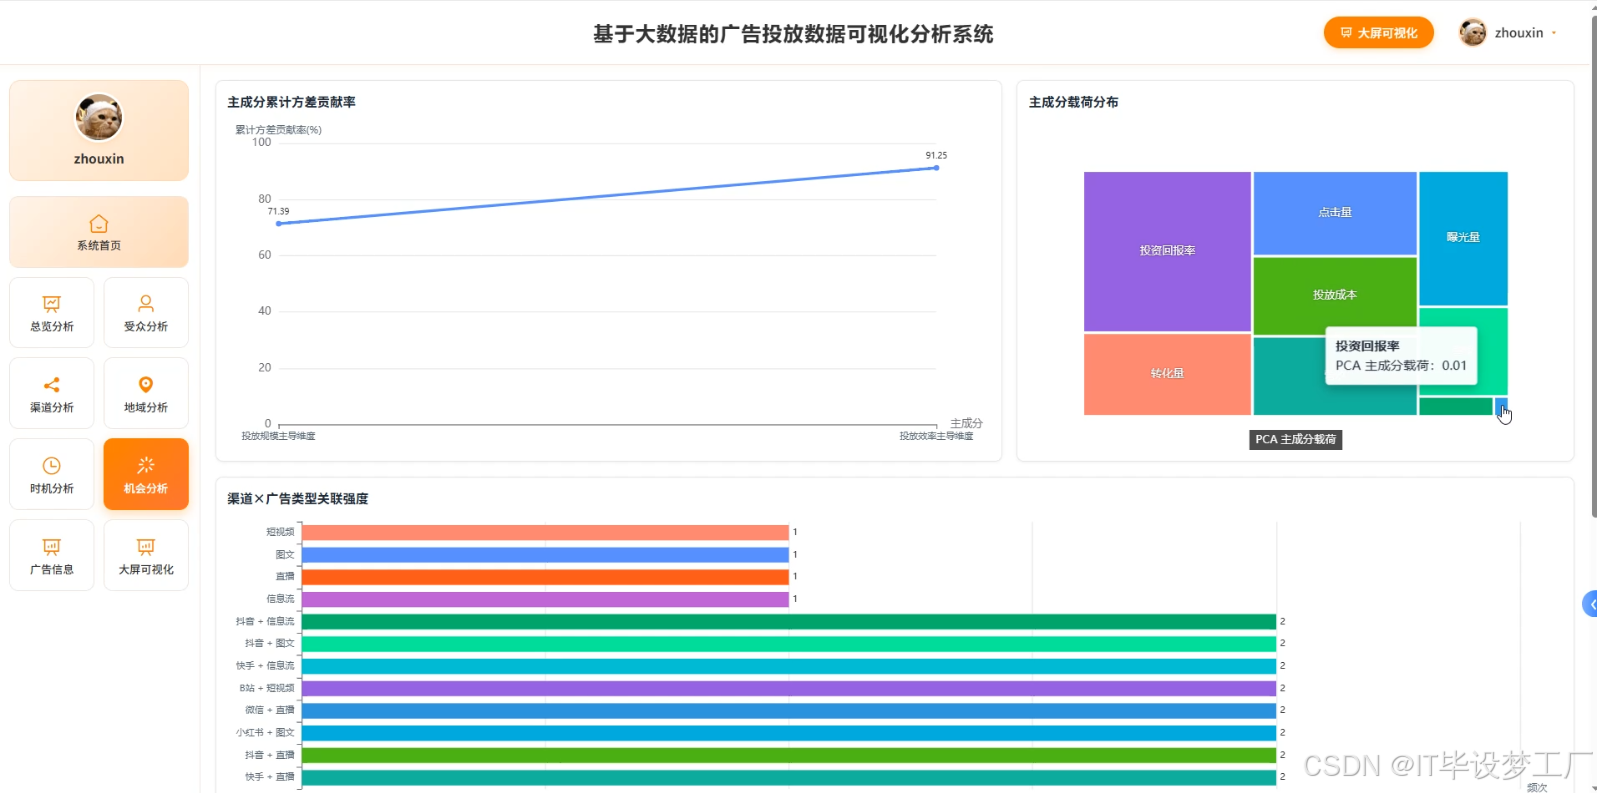
本系统名为《基于大数据的广告投放数据可视化分析系统》,主要是把广告投放过程中产生的各类数据用大数据技术跑一遍,再用图表和大屏的方式展示出来,让使用者能比较直观地看到广告投放的整体情况。技术这块用的是Hadoop加Spark这套大数据框架,底层靠HDFS做数据存储,计算和分析主要交给Spark和Spark SQL,中间也会用到Pandas和NumPy做数据处理和数值计算,后端提供Python的Django版本和Java的SpringBoot版本两套实现,前端用Vue配合ElementUI、Echarts以及HTML、CSS、JavaScript、jQuery来搭页面和画图,数据库用的是MySQL。功能上包含系统首页、大屏可视化、用户管理、广告信息管理、总览分析、渠道分析、时机分析、受众分析、地域分析、机会分析、个人信息和修改密码这些模块。用户登录进去之后,可以在首页看到整体情况,也可以切到大屏可视化页面看核心指标,广告信息模块用来维护广告基础数据,总览分析看整体投放效果,渠道分析对比不同渠道的表现,时机分析看不同时间段的投放差异,受众分析看人群特征,地域分析看不同地区的分布,机会分析则尝试从数据里找出还有提升空间的方向。整个系统说白了就是拿一个广告投放的场景,把大数据分析从存储、计算到可视化这条链路完整走一遍,适合作为计算机专业毕设来练手。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的广告投放数据可视化分析系统系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
# 总览分析核心业务处理:从HDFS读取广告投放数据,用Spark SQL做整体指标汇总
def overview_analysis(request):
    spark = SparkSession.builder.appName("AdOverviewAnalysis").master("local[*]").config("spark.sql.warehouse.dir", "/user/hive/warehouse").enableHiveSupport().getOrCreate()
    ad_df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/ad_data/ad_put.csv")
    ad_df.createOrReplaceTempView("ad_put")
    total_df = spark.sql("SELECT COUNT(*) AS total_count, SUM(impression) AS total_impression, SUM(click) AS total_click, SUM(convert) AS total_convert, SUM(cost) AS total_cost FROM ad_put")
    total_row = total_df.collect()[0]
    total_count = int(total_row["total_count"]) if total_row["total_count"] is not None else 0
    total_impression = int(total_row["total_impression"]) if total_row["total_impression"] is not None else 0
    total_click = int(total_row["total_click"]) if total_row["total_click"] is not None else 0
    total_convert = int(total_row["total_convert"]) if total_row["total_convert"] is not None else 0
    total_cost = float(total_row["total_cost"]) if total_row["total_cost"] is not None else 0.0
    ctr = round(total_click / total_impression, 4) if total_impression > 0 else 0.0
    cvr = round(total_convert / total_click, 4) if total_click > 0 else 0.0
    cpc = round(total_cost / total_click, 2) if total_click > 0 else 0.0
    cpm = round(total_cost / total_impression * 1000, 2) if total_impression > 0 else 0.0
    result = {"total_count": total_count, "total_impression": total_impression, "total_click": total_click, "total_convert": total_convert, "total_cost": total_cost, "ctr": ctr, "cvr": cvr, "cpc": cpc, "cpm": cpm}
    spark.stop()
    return JsonResponse({"code": 200, "msg": "总览分析成功", "data": result})
# 渠道分析核心业务处理:按渠道分组,用Spark SQL算出各渠道的投放效果并排序
def channel_analysis(request):
    spark = SparkSession.builder.appName("AdChannelAnalysis").master("local[*]").config("spark.sql.warehouse.dir", "/user/hive/warehouse").enableHiveSupport().getOrCreate()
    ad_df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/ad_data/ad_put.csv")
    ad_df.createOrReplaceTempView("ad_put")
    channel_df = spark.sql("SELECT channel, COUNT(*) AS ad_count, SUM(impression) AS impression, SUM(click) AS click, SUM(convert) AS convert, SUM(cost) AS cost FROM ad_put GROUP BY channel ORDER BY cost DESC")
    channel_list = []
    for row in channel_df.collect():
        impression = int(row["impression"]) if row["impression"] is not None else 0
        click = int(row["click"]) if row["click"] is not None else 0
        convert = int(row["convert"]) if row["convert"] is not None else 0
        cost = float(row["cost"]) if row["cost"] is not None else 0.0
        ctr = round(click / impression, 4) if impression > 0 else 0.0
        cvr = round(convert / click, 4) if click > 0 else 0.0
        cpc = round(cost / click, 2) if click > 0 else 0.0
        channel_list.append({"channel": row["channel"], "ad_count": int(row["ad_count"]), "impression": impression, "click": click, "convert": convert, "cost": cost, "ctr": ctr, "cvr": cvr, "cpc": cpc})
    spark.stop()
    return JsonResponse({"code": 200, "msg": "渠道分析成功", "data": channel_list})
# 地域分析核心业务处理:按地域分组,用Spark SQL统计各地域投放情况并计算转化率
def region_analysis(request):
    spark = SparkSession.builder.appName("AdRegionAnalysis").master("local[*]").config("spark.sql.warehouse.dir", "/user/hive/warehouse").enableHiveSupport().getOrCreate()
    ad_df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/ad_data/ad_put.csv")
    ad_df.createOrReplaceTempView("ad_put")
    region_df = spark.sql("SELECT region, COUNT(*) AS ad_count, SUM(impression) AS impression, SUM(click) AS click, SUM(convert) AS convert, SUM(cost) AS cost FROM ad_put GROUP BY region ORDER BY convert DESC")
    region_list = []
    for row in region_df.collect():
        impression = int(row["impression"]) if row["impression"] is not None else 0
        click = int(row["click"]) if row["click"] is not None else 0
        convert = int(row["convert"]) if row["convert"] is not None else 0
        cost = float(row["cost"]) if row["cost"] is not None else 0.0
        ctr = round(click / impression, 4) if impression > 0 else 0.0
        cvr = round(convert / click, 4) if click > 0 else 0.0
        cpc = round(cost / click, 2) if click > 0 else 0.0
        region_list.append({"region": row["region"], "ad_count": int(row["ad_count"]), "impression": impression, "click": click, "convert": convert, "cost": cost, "ctr": ctr, "cvr": cvr, "cpc": cpc})
    spark.stop()
    return JsonResponse({"code": 200, "msg": "地域分析成功", "data": region_list})
五、论文参考
- 计算机毕业设计选题推荐-基于大数据的广告投放数据可视化分析系统系统-论文参考:
六、系统视频
- 基于大数据的广告投放数据可视化分析系统系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的广告投放数据可视化分析系统|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇