✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
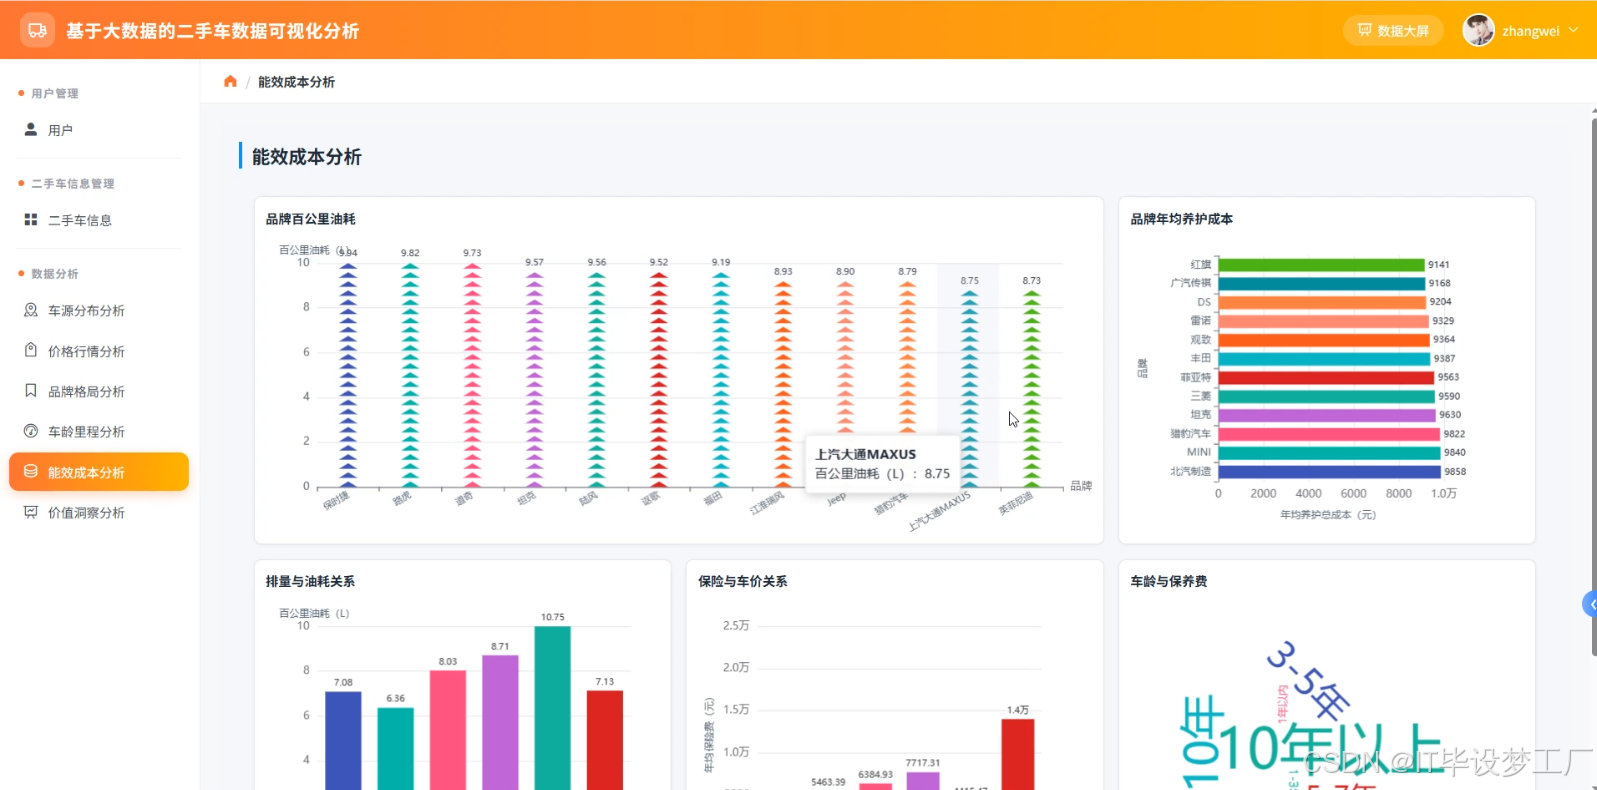
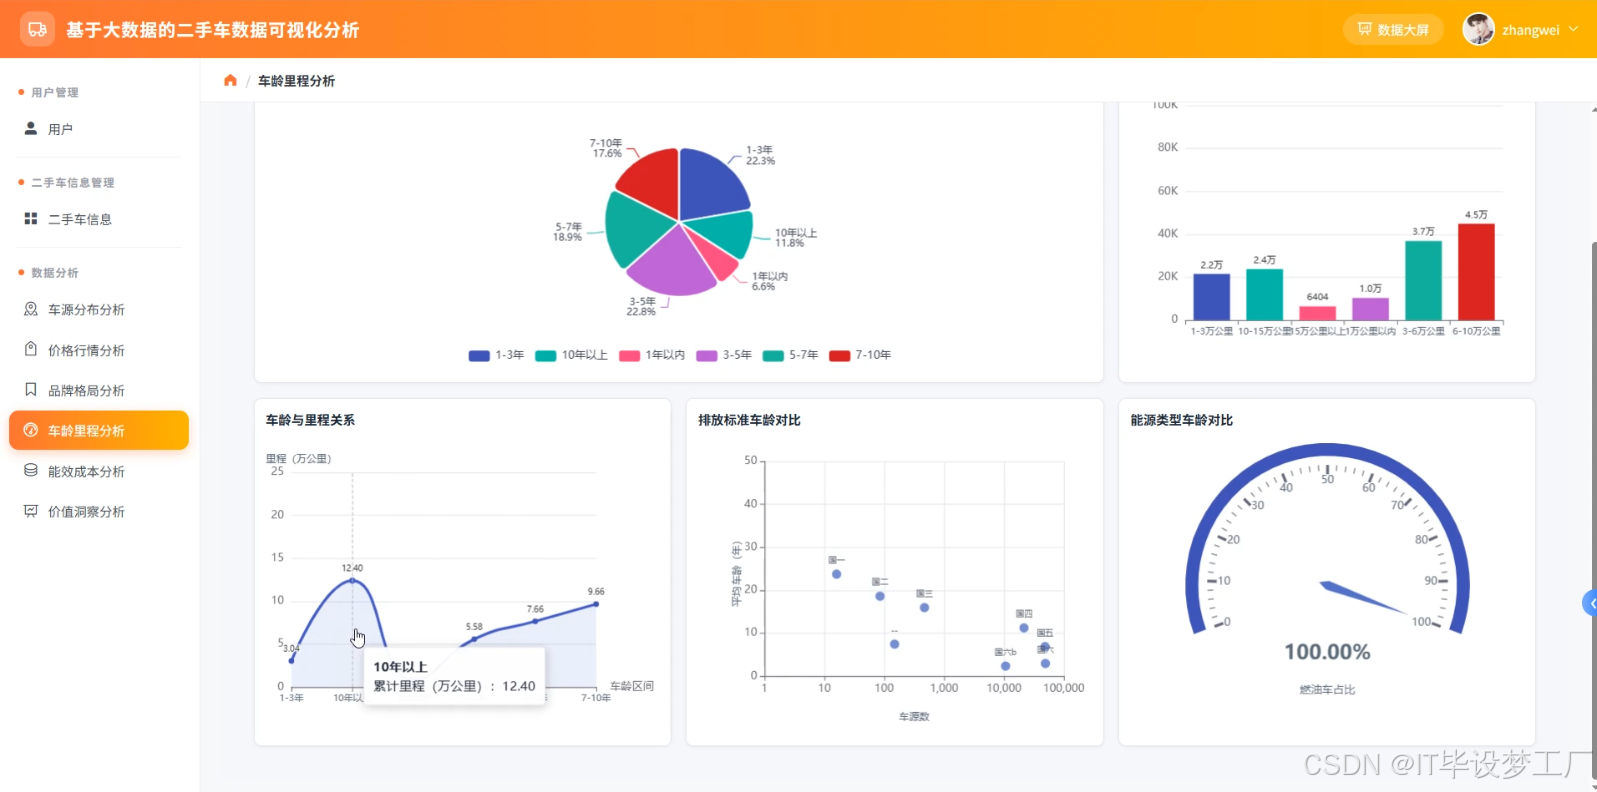
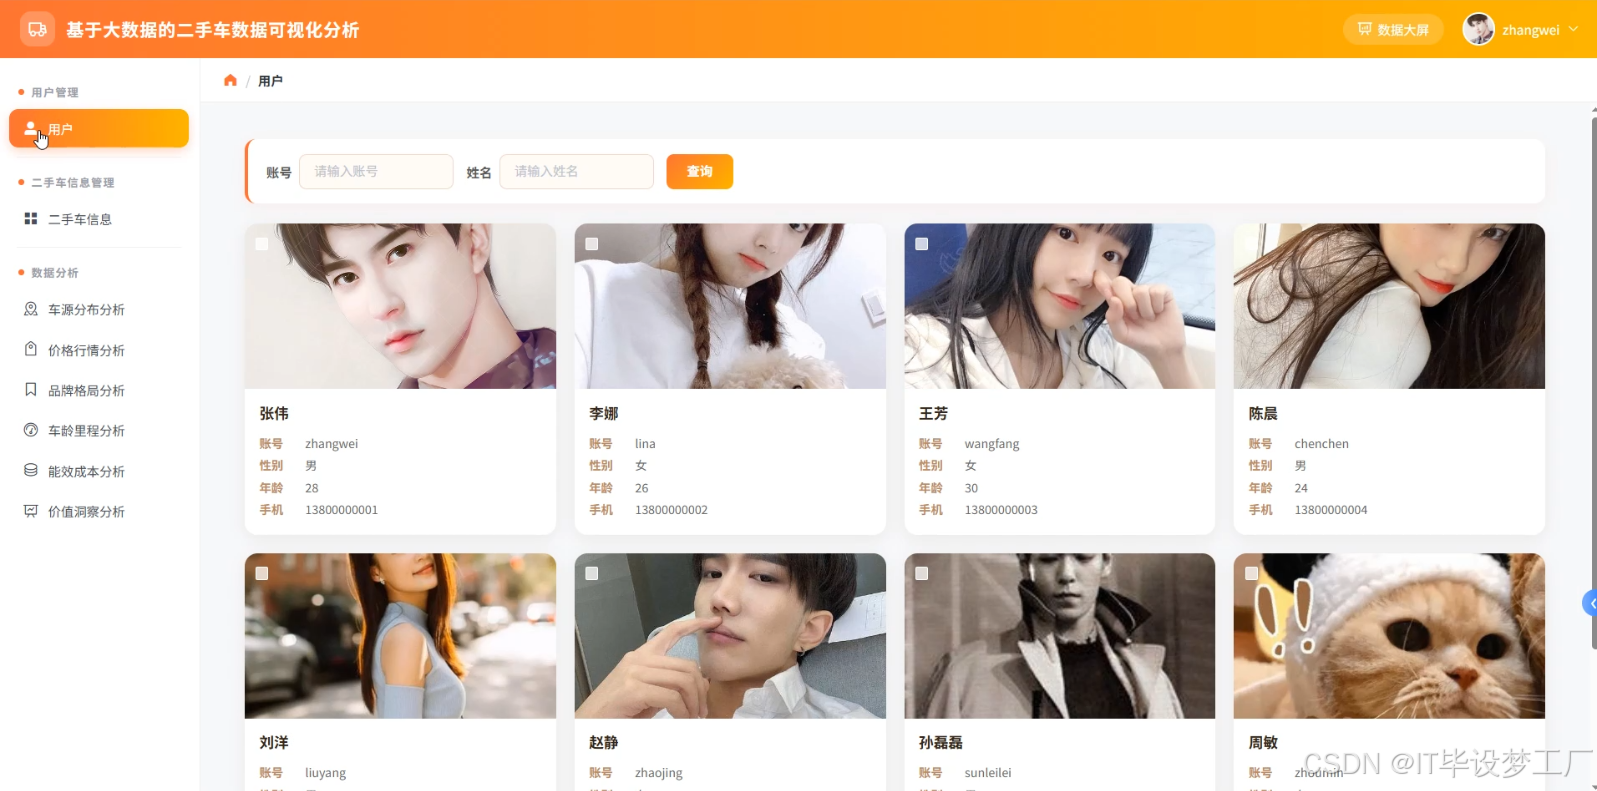
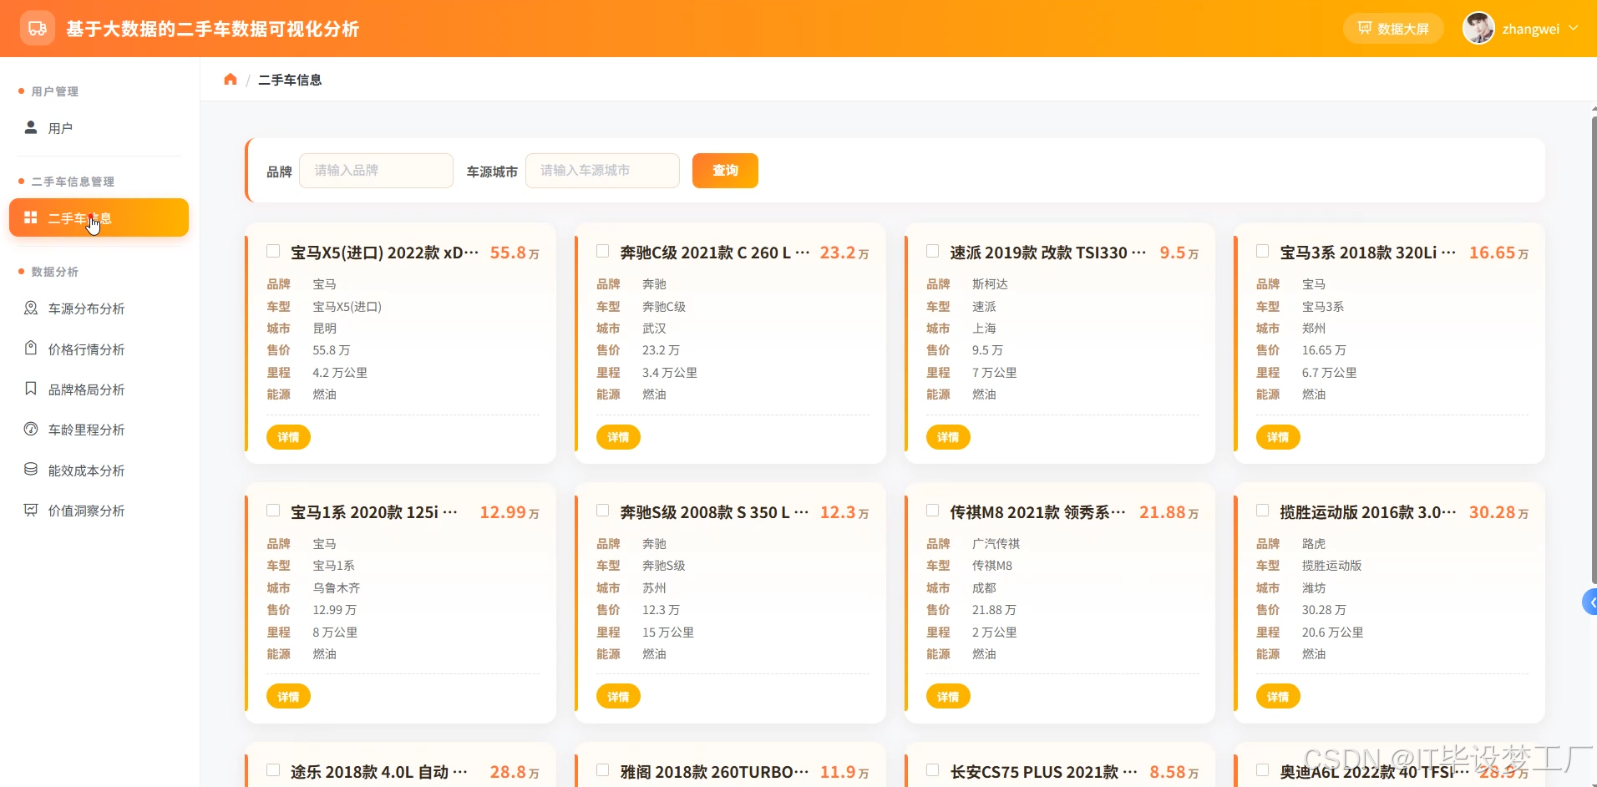
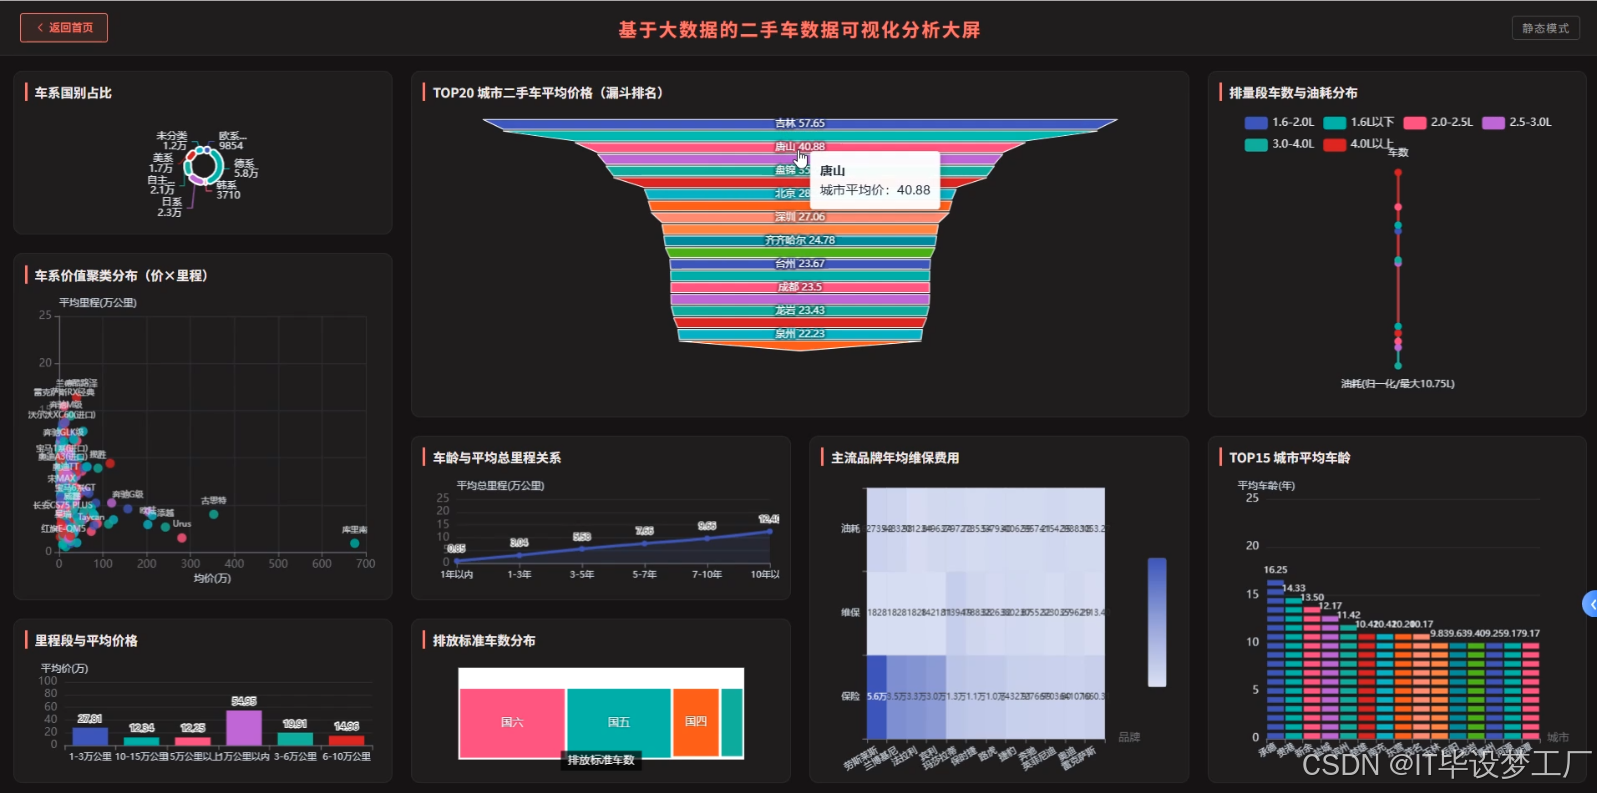
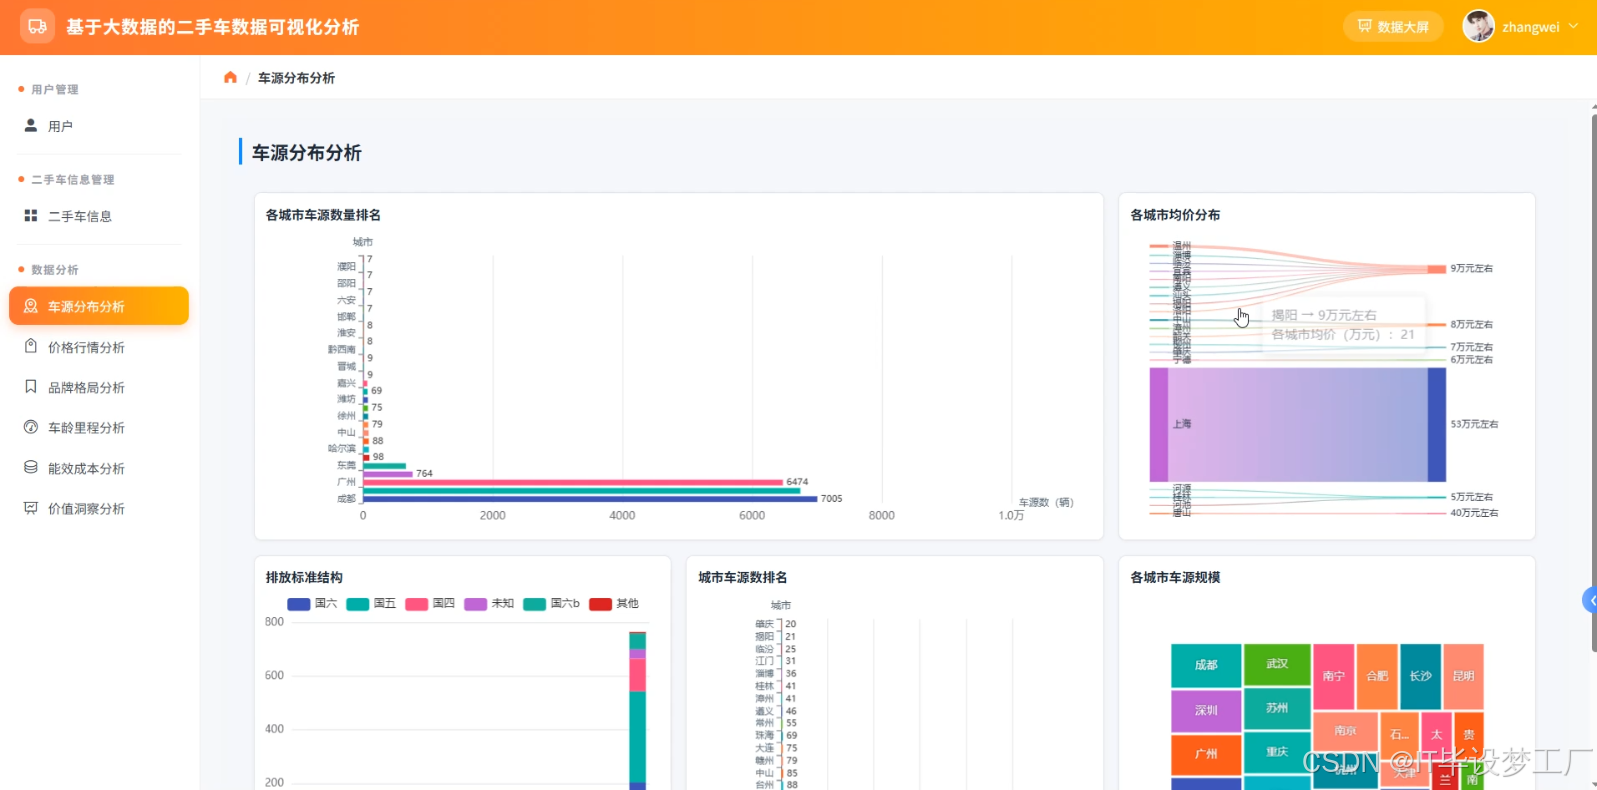
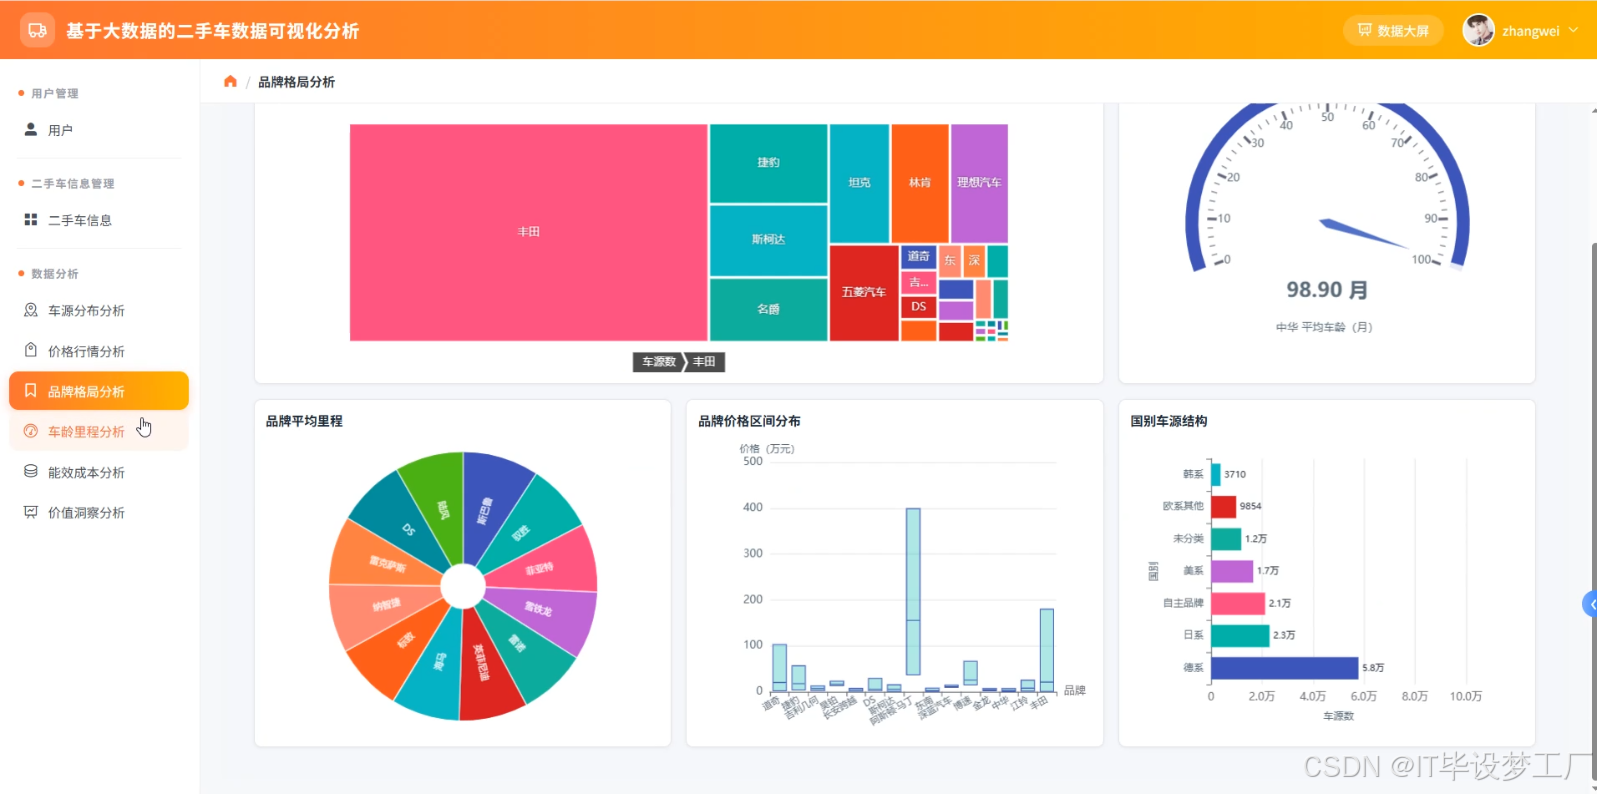
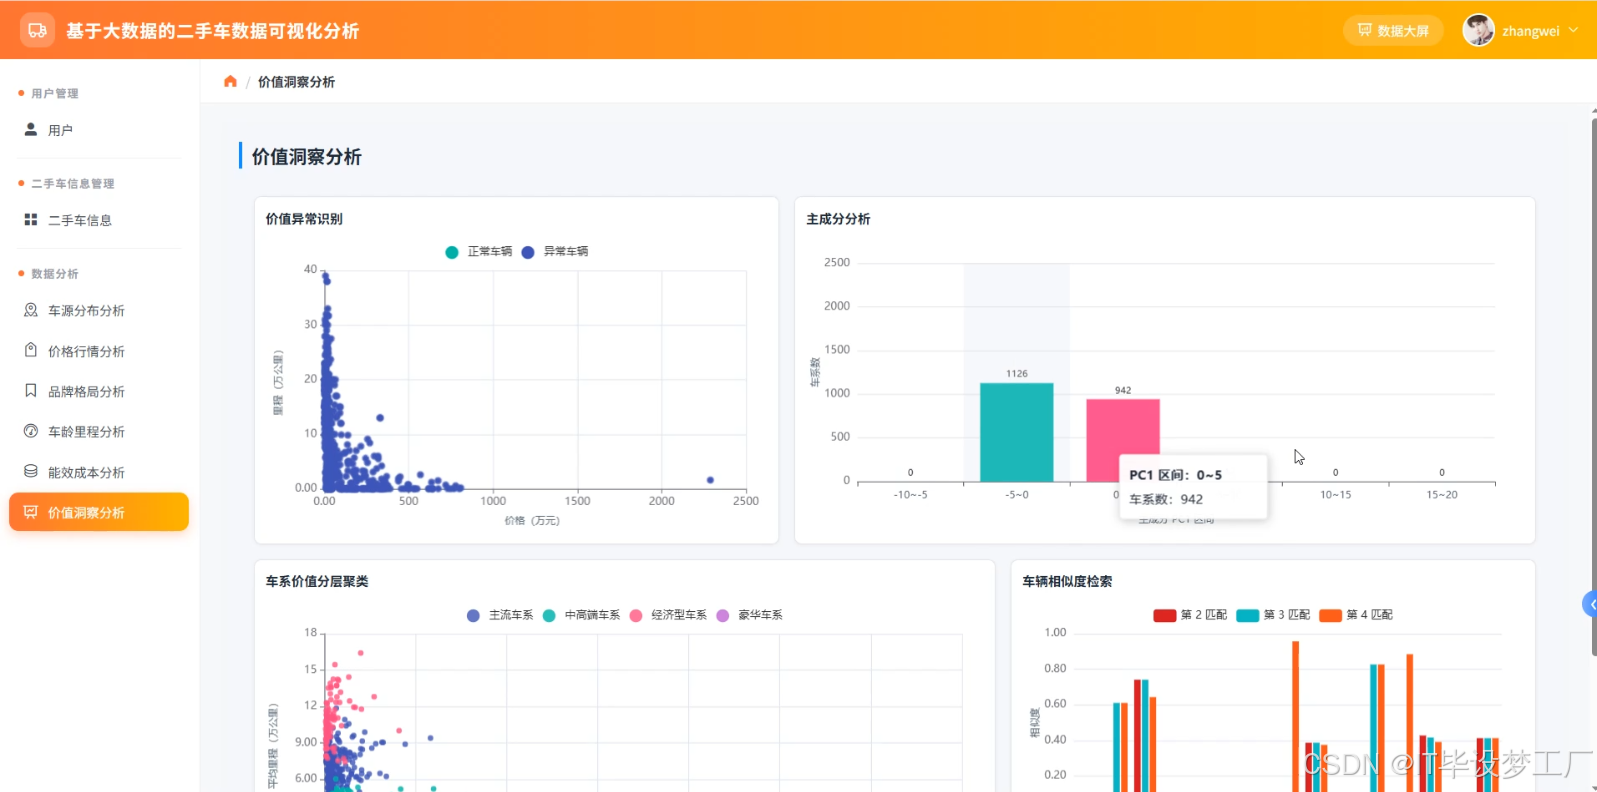
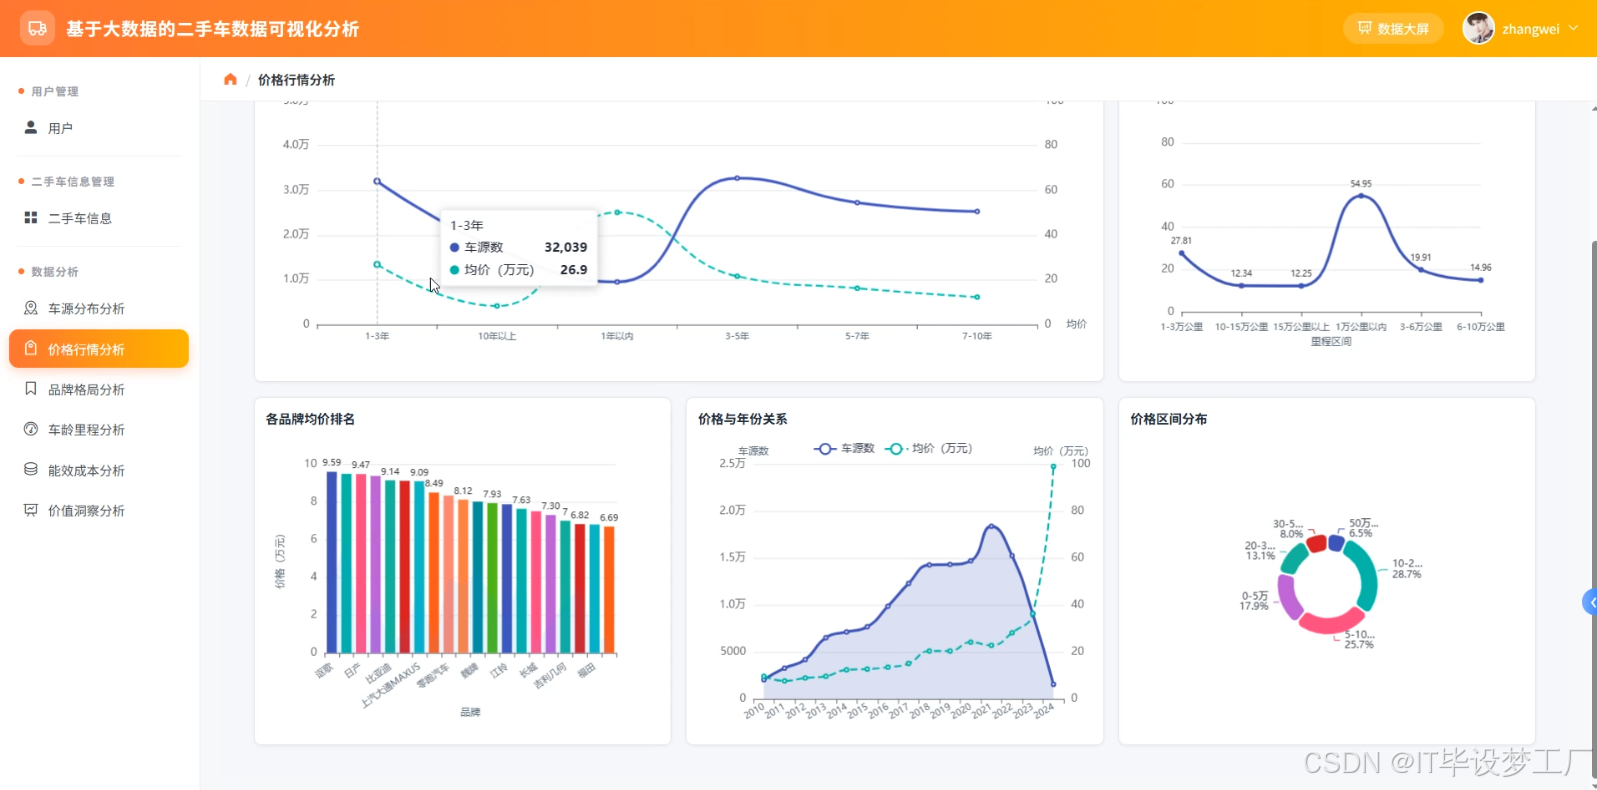
《基于大数据的二手车数据可视化分析》是一套面向计算机专业毕业设计的完整系统,主要围绕二手车业务场景,把采集到的二手车信息通过Hadoop与HDFS进行数据存储,再借助Spark和Spark SQL完成数据清洗、统计与指标计算,后端采用Django框架搭建接口服务,数据库使用MySQL保存用户信息、二手车信息以及分析结果,前端通过Vue、ElementUI、Echarts、HTML、CSS、JavaScript和jQuery实现页面展示与图表交互。系统首页提供整体入口,大屏可视化用于集中展示二手车核心指标,用户管理、二手车信息管理、个人信息和修改密码保证系统基础操作完整,数据分析模块则进一步细分为车源分布分析、价格行情分析、品牌格局分析、车龄里程分析、能效成本分析和价值洞察分析,能够从地区、价格、品牌、使用年限、行驶里程、能耗成本以及综合价值等角度对二手车数据进行可视化呈现,帮助用户更直观地了解二手车市场情况,也方便大四学生在毕设中展示大数据处理与可视化分析的完整流程。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的二手车数据可视化分析系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
spark = SparkSession.builder \
    .appName("UsedCarBigDataAnalysis") \
    .master("local[*]") \
    .config("spark.sql.warehouse.dir", "/user/hive/warehouse") \
    .enableHiveSupport() \
    .getOrCreate()
def analyze_car_source_distribution(request):
    city = request.GET.get("city", "").strip()
    start_date = request.GET.get("start_date", "").strip()
    end_date = request.GET.get("end_date", "").strip()
    car_df = spark.read.format("csv") \
        .option("header", "true") \
        .option("inferSchema", "true") \
        .load("hdfs://localhost:9000/usedcar/cleaned/car_info")
    car_df.createOrReplaceTempView("car_info")
    sql = """
        SELECT source_city, COUNT(*) AS car_count,
               ROUND(AVG(price), 2) AS avg_price,
               ROUND(AVG(mileage), 2) AS avg_mileage
        FROM car_info
        WHERE source_city IS NOT NULL
    """
    if city:
        sql += " AND source_city = '%s'" % city
    if start_date and end_date:
        sql += " AND publish_date >= '%s' AND publish_date <= '%s'" % (start_date, end_date)
    sql += " GROUP BY source_city ORDER BY car_count DESC"
    result_df = spark.sql(sql)
    total_count = result_df.agg({"car_count": "sum"}).collect()[0][0] or 0
    rows = result_df.collect()
    data_list = []
    for row in rows:
        item = {
            "source_city": row["source_city"],
            "car_count": row["car_count"],
            "avg_price": row["avg_price"],
            "avg_mileage": row["avg_mileage"],
            "ratio": round(row["car_count"] / total_count * 100, 2) if total_count else 0
        }
        data_list.append(item)
    top_city = data_list[0]["source_city"] if data_list else ""
    top_count = data_list[0]["car_count"] if data_list else 0
    return JsonResponse({
        "code": 200,
        "msg": "车源分布分析成功",
        "total": total_count,
        "top_city": top_city,
        "top_count": top_count,
        "data": data_list
    })
def analyze_price_market(request):
    brand = request.GET.get("brand", "").strip()
    price_range = request.GET.get("price_range", "").strip()
    car_df = spark.read.format("csv") \
        .option("header", "true") \
        .option("inferSchema", "true") \
        .load("hdfs://localhost:9000/usedcar/cleaned/car_info")
    car_df.createOrReplaceTempView("car_info")
    base_sql = """
        SELECT brand, price, car_age, mileage, source_city
        FROM car_info
        WHERE price IS NOT NULL AND price > 0
    """
    if brand:
        base_sql += " AND brand = '%s'" % brand
    if price_range == "low":
        base_sql += " AND price < 5"
    elif price_range == "mid":
        base_sql += " AND price >= 5 AND price < 15"
    elif price_range == "high":
        base_sql += " AND price >= 15"
    base_df = spark.sql(base_sql)
    base_df.createOrReplaceTempView("price_base")
    stat_df = spark.sql("""
        SELECT COUNT(*) AS total_count,
               ROUND(AVG(price), 2) AS avg_price,
               ROUND(MIN(price), 2) AS min_price,
               ROUND(MAX(price), 2) AS max_price,
               ROUND(PERCENTILE(price, 0.5), 2) AS median_price
        FROM price_base
    """)
    stat_row = stat_df.collect()[0]
    segment_df = spark.sql("""
        SELECT CASE
                 WHEN price < 5 THEN '5万以下'
                 WHEN price >= 5 AND price < 10 THEN '5-10万'
                 WHEN price >= 10 AND price < 15 THEN '10-15万'
                 WHEN price >= 15 AND price < 20 THEN '15-20万'
                 ELSE '20万以上'
               END AS price_segment,
               COUNT(*) AS segment_count,
               ROUND(AVG(mileage), 2) AS avg_mileage
        FROM price_base
        GROUP BY CASE
                 WHEN price < 5 THEN '5万以下'
                 WHEN price >= 5 AND price < 10 THEN '5-10万'
                 WHEN price >= 10 AND price < 15 THEN '10-15万'
                 WHEN price >= 15 AND price < 20 THEN '15-20万'
                 ELSE '20万以上'
               END
        ORDER BY segment_count DESC
    """)
    segment_list = []
    for row in segment_df.collect():
        segment_list.append({
            "price_segment": row["price_segment"],
            "segment_count": row["segment_count"],
            "avg_mileage": row["avg_mileage"]
        })
    age_price_df = spark.sql("""
        SELECT car_age, ROUND(AVG(price), 2) AS avg_price, COUNT(*) AS car_count
        FROM price_base
        WHERE car_age IS NOT NULL
        GROUP BY car_age
        ORDER BY car_age ASC
    """)
    age_price_list = []
    for row in age_price_df.collect():
        age_price_list.append({
            "car_age": row["car_age"],
            "avg_price": row["avg_price"],
            "car_count": row["car_count"]
        })
    return JsonResponse({
        "code": 200,
        "msg": "价格行情分析成功",
        "total_count": stat_row["total_count"],
        "avg_price": stat_row["avg_price"],
        "min_price": stat_row["min_price"],
        "max_price": stat_row["max_price"],
        "median_price": stat_row["median_price"],
        "segment_data": segment_list,
        "age_price_data": age_price_list
    })
def analyze_brand_pattern(request):
    city = request.GET.get("city", "").strip()
    top_n = int(request.GET.get("top_n", 10))
    car_df = spark.read.format("csv") \
        .option("header", "true") \
        .option("inferSchema", "true") \
        .load("hdfs://localhost:9000/usedcar/cleaned/car_info")
    car_df.createOrReplaceTempView("car_info")
    sql = """
        SELECT brand, COUNT(*) AS car_count,
               ROUND(AVG(price), 2) AS avg_price,
               ROUND(AVG(mileage), 2) AS avg_mileage,
               ROUND(AVG(car_age), 2) AS avg_car_age
        FROM car_info
        WHERE brand IS NOT NULL AND brand != ''
    """
    if city:
        sql += " AND source_city = '%s'" % city
    sql += " GROUP BY brand ORDER BY car_count DESC LIMIT %d" % top_n
    brand_df = spark.sql(sql)
    brand_rows = brand_df.collect()
    total_df = spark.sql("SELECT COUNT(*) AS total FROM car_info")
    total_count = total_df.collect()[0]["total"] or 0
    brand_list = []
    for row in brand_rows:
        brand_list.append({
            "brand": row["brand"],
            "car_count": row["car_count"],
            "avg_price": row["avg_price"],
            "avg_mileage": row["avg_mileage"],
            "avg_car_age": row["avg_car_age"],
            "ratio": round(row["car_count"] / total_count * 100, 2) if total_count else 0
        })
    price_rank_df = spark.sql("""
        SELECT brand, ROUND(AVG(price), 2) AS avg_price, COUNT(*) AS car_count
        FROM car_info
        WHERE brand IS NOT NULL AND brand != ''
        GROUP BY brand
        HAVING COUNT(*) >= 5
        ORDER BY avg_price DESC
        LIMIT %d
    """ % top_n)
    price_rank_list = []
    for row in price_rank_df.collect():
        price_rank_list.append({
            "brand": row["brand"],
            "avg_price": row["avg_price"],
            "car_count": row["car_count"]
        })
    return JsonResponse({
        "code": 200,
        "msg": "品牌格局分析成功",
        "total_count": total_count,
        "brand_data": brand_list,
        "price_rank_data": price_rank_list
    })
五、论文参考
- 计算机毕业设计选题推荐-基于大数据的二手车数据可视化分析系统-论文参考:
六、系统视频
- 基于大数据的二手车数据可视化分析系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的二手车数据可视化分析|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇