1.内积基础
在上一节,我们学习了范数(Norm) 。范数解决了单打独斗的问题------它是一把尺子,能告诉你单个向量有多长、有多大。
但真实世界和 AI 算法中,数据从不单打独斗。比如:
-
在推荐系统里,有一个代表"用户兴趣"的向量,和一个代表"商品特征"的向量;
-
在人脸识别中,有一张"你的自拍"的特征向量,和底库里"身份证照"的特征向量。
这时,我们最迫切想知道的不再是它们各自有多长,而是:它们俩到底合不合拍?它们是指向同一方向,还是互不相干,甚至是背道而驰?
为了给两个多维向量测量这种"方向协同度",数学家给出了另一件极其重要的武器------内积(Inner Product,也称点积 Dot Product / 数量积)。
假设在二维平面上,有两个向量:
如果我们把两个向量的所有分量融合成一个标量数值,用来评估它们的"协同程度
-
如果在第 1 个维度上,两个向量都是正数(都在往东走),这叫"同向发力",应该加分;
-
如果在第 2 个维度上,一个往北(正),一个往南(负),这叫"互相拆台",应该扣分;
-
如果某个向量在某个维度上是 0(根本不参与),既不加分也不扣分。
最简单直观的实现方式,就是把每个维度上的分量两两相乘,然后全部加起来:
-
正值:大部分分量同号,齐心协力朝一个方向使劲;
-
负值:大部分分量反号,严重内耗;
-
结果为 0:加分项和扣分项刚好完全抵消,互不相干。
上面那种"按位相乘相加"只是计算机喜欢的代数算式。在几何空间里,内积究竟在干什么?
数学家推导出了内积的第二张面孔(几何定义):
-
和
-
-
为了看透这个公式,我们不妨做一下结合律的重组:
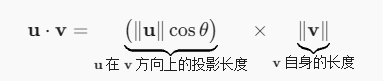
类似于这样:
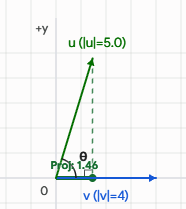
U在V上的投影就是1.46
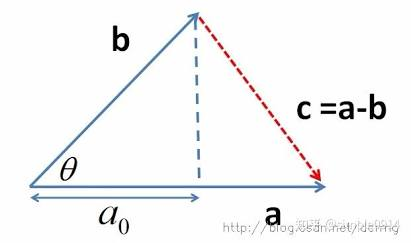
b在a上的投影就是a0,
观察上面的投影规律,夹角 决定了内积的根本性质:
1.
-
-
如果令
看,内积和范数在这里闭环了! 任何向量的长度,就是它与自己做内积后再开根号。
2. (正交 / Orthogonal)
-
-
物理含义 :这两个方向完全独立、毫无瓜葛。你在 x 轴方向上走得再快,对 y轴的位移贡献也是 0。这是现代坐标系、信号解耦最底层的数学基石。
继续思考这样一个场景:
-
用户 A 狂热喜欢科幻电影,在"科幻"标签上打了 100 分,在"喜剧"上打了 50 分;
-
用户 B 刚注册,只给"科幻"打了 2 分,在"喜剧"上打了 1 分。
两人的比例(兴趣方向)完全一致,但因为 A 评分多(向量长度极大),直接算内积数值会畸高;而 B 算出来的值很小。
怎样剥离长度的干扰,只比较两者"纯粹的偏好一致度"?
把几何公式简单移项,除以它们各自的范数(长度归一化),我们就得到了 AI 里鼎鼎大名的余弦相似度(Cosine Similarity):
-
结果被死死限定在 -1, 1 区间内;
-
越接近 1,说明两者方向越高度契合,哪怕一个向量巨大、一个向量极微小。
这也顺带引出了数学界著名的定理之一------柯西-施瓦茨不等式
(任何两个向量的内积绝对值,永远不会超过它们各自长度的乘积,当且仅当两者同向或反向共线时取等号)。
几乎所有深度学习模型的底层算力开销,80% 以上都在做高维内积(矩阵乘法):
| AI 场景 | 究竟在用内积做什么? | 形象解释 |
|---|---|---|
| Transformer (Attention 机制) | 计算注意力权重: |
Query(问题)和每个 Key(词)做高维内积。内积越大,代表注意力匹配度越高,模型就把更多权重分给那个词。 |
| 向量数据库 (RAG / 检索) | 文本 Embedding 语义检索 | 把你的提问和知识库里的上万条段落向量做余弦相似度(归一化内积),瞬间捞出语义最接近的段落。 |
| 卷积神经网络 (CNN) | 图像卷积操作 | 卷积核(权重模板)在图片上滑动相乘相加,本质是局部像素与特征模板的内积。内积得分高,说明找到了预期的边缘或纹理。 |
| 支持向量机 (SVM 核技巧) | 将低维线性不可分映射到高维 | 利用"核函数"在低维直接算高维内积,不增加额外维度的同时巧妙完成分类。 |
2.希尔伯特空间入门
函数从来不是什么神秘的曲线,它本质上就是一个拥有"无穷多个连续维度"的超级向量。
只要顺着这个视角,你不需要懂泛函分析的高深词汇,就能直观理解希尔伯特空间(Hilbert Space)的精髓。
先暂时忘掉微积分,退回到初中数学。
在三维空间中,有一个向量:
-
数字
-
现在,假设维度不再是 3 个,而是 1000 个、100 万个、1 亿个......
当维度的密度稠密到极致,相邻两个维度之间的间隔缩成了无穷小,索引不再是跳跃的整数 1, 2, 3,而是区间 a, b 上任意连续流动的实数 x。
连续函数 f(x),本质上就是一个无穷维向量
自变量 x 就是它的"维度编号",函数值 f(x) 就是它在维度 x 上的分量大小。
回想我们在有限维向量中定义的内积公式:
它的逻辑是:找到相同维度的两个分量,乘起来,全部累加。
现在我们要给两个定义在区间 上的函数
和
计算内积,该怎么做?
先做离散采样(离散化):
把区间 等分成
个微小的步长
,采样点为
。
此时, 和
变成了两个
维向量:
按位相乘并赋予"厚度":
如果直接相加,随着采样点数,总和会直接爆炸到无穷大。
为了保证度量在物理上具有稳定的意义,每一项乘积必须带上它所占据的区间微元宽度 :
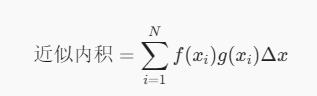
让切片趋于无穷细(取极限):
根据黎曼积分的定义,当切片数量 (即
)时,求和符号
顺理成章地变成了连续积分符号
:
这就是函数空间的内积定义。它没有施加任何魔法,只是把"每个维度的对应乘积,沿着连续的坐标轴全部积聚起来"。
一旦在函数世界里确立了内积,所有原本只属于三维几何的概念,瞬间可以平移到函数上:
1. 函数的"长度"( 范数)
向量的长度是自己与自己做内积开根号,函数也是一模一样:
-
物理含义:这个积分代表信号的总能量。
-
数学门槛 :不是随便抓个函数都能算长度。必须要求
2. 函数的"正交(垂直)"
在三维空间中,两根箭头夹角成 时内积为 0;在函数世界里:
如果
最震撼人心的例子莫过于三角函数系:
在 区间内:
-
频率不同的正弦波
-
这就是傅里叶级数的数学底气:这些正交正弦波,就像三维空间里的 x 轴、y 轴、z 轴一样,是一组的"正交坐标基底"。任何一段复杂的音频信号,都只是在这个无穷维坐标系里的投影坐标而已。
但是为什么叫"希尔伯特空间"?它究竟多了什么?
既然叫"无穷维内积空间"已经很清楚了,为什么数学家非要造一个"希尔伯特空间"的名词?
因为从"有限维"跨到"无穷维",数学面临着一场巨大的悬崖危机------"漏洞"问题。
柯西序列是否会"出圈"?
-
在有限维空间(如我们的三维世界
-
但在无穷维空间里,情况彻底失控:
你可以构造一系列极其平滑、完全合法的连续函数
如果你的空间只允许平滑函数存在,那么这个极限函数就"跌出了空间外"。你算着算着,终点居然掉进了一个原本不存在的"空洞"里。
为了解决这个漏洞,大数学家大卫·希尔伯特(David Hilbert)将这类空间进行了严格的定义封口:
内积空间:能够定义角度、投影、正交和长度;
完备性(No Holes) :给空间打好所有补丁。无论你怎么做无限次近似和级数展开,只要序列在逼近,它的极限终点百分之百安全落在这个空间之内。
著名的 空间(所有平方可积函数构成的空间),就是最经典、应用最广泛的无穷维实希尔伯特空间。
| 领域 | 希尔伯特空间在发挥什么作用? |
|---|---|
| 量子力学 | 微观粒子的状态不是一个确定的位置,而是希尔伯特空间中的一个波函数状态向量 |
| 机器学习:核方法 (SVM / RKHS) | 当数据在低维线性不可分时,核技巧通过核函数 |
| 现代信号处理与大模型声学特征 | 音频处理中的小波变换(Wavelet)与傅里叶变换,本质上都是把连续时域信号投影到希尔伯特空间的某组完备正交函数基底上。 |
3.超高维向量问题
在超高维空间中,任意随机抽取的两个向量,彼此正交(夹角接近 ,余弦相似度接近 0)的概率趋近于 100%。
但既然高维空间的大多数方向彼此垂直,为什么现代 AI(如 Transformer、向量检索、CLIP)还能在几千维的空间里算相似度?
高维空间中"几乎全正交"的数学定理,有一个至关重要的前提:向量在整个空间中是"均匀随机分布"的。
-
随机向量的世界(均匀超球体) :如果你在这个上千维的空间里闭着眼睛乱扔飞镖,任意两支飞镖的夹角确实绝大概率都卡在
-
语义向量的世界(流形假说 Manifold Hypothesis) :经过深度学习模型训练出的数据,绝不均匀分布在整个高维空间中,而是高度聚集在一个个低维弯曲的"子空间(流形)"里。
核心直觉:
真实世界的语义(猫、狗、汽车、爱情)并不是无限随机的混乱噪声。高维空间虽然有 1536 甚至 4096 个维度,但神经网络通过损失函数的约束,把有相似意义的词强行挤压到了极其狭窄的特定"锥形区域"里。
因此,两个不相干的词在千维空间里确实是正交的;但"国王"和"王后"因为语义紧密相关,被模型刻意训练到了几乎相同的方向上。
为了搞懂相似度是怎么算出来的,先看为什么随机高维向量会"正交化"。
假设有两个 维的随机单位向量
和
,每个分量都是独立同分布的随机变量:
期望值为 0 :因为分量正负完全随机,这一项相乘是正数,下一项很可能就是负数,正负抵消后的平均期望必然是 0(即夹角 )。
方差随维度剧烈收缩:根据大数定律和中心极限定理,这个内积的波动标准差大约是:
在 2 维平面上(),标准差很大,两个随机箭头很容易夹角很小;
在 1536 维空间里(),标准差缩小到了
也就是说,在 1536 维空间里,任意两个随机向量的余弦相似度,99.7% 的概率被死死压缩在 -0.075, +0.075 的狭窄缝隙里。
既然随机背景噪音全都被压到了 0 附近,AI 系统反而因祸得福,借此建立起一套极其灵敏的相似度体系:
1. 统计意义的巨变:微小的相似度,就是巨大的确定性
低维空间里的"相似度 0.3"可能只是巧合;但在千维空间里,余弦相似度只要达到 0.2,就意味着天大的关联!
-
在
-
换句话说,高维空间的"正交背景"像是一片死寂的绝对真空,任何哪怕一点点偏向正数的夹角,都是模型极度确定两事物相关的强信号。
2. 对比学习(Contrastive Learning)的人为重塑
现代大模型(如 CLIP、BERT、各类 Embedding 模型)在训练时普遍采用对比学习损失(InfoNCE):
-
算法强制要求:把"猫的照片"和"猫的文字"的余弦相似度人工拉拽到 0.8 以上;
-
同时把无关样本推回到正交区域(接近 0)。
-
这相当于模型把千维空间中的绝大部分维度留作"隔离带"(确保不同概念互不干扰),只把相关概念锁进同一个超高维子空间。
3. 温度系数(Temperature )与缩放点积
你在 Transformer 的注意力机制里一定见过这个公式:
为什么一定要除以?
-
两个高维向量相乘,其数值方差正比于维度 d。如果不除以
-
除以
更有趣的是,现代大语言模型(LLM)的真实向量空间不仅没有遭遇"大家都正交"的问题,反而患上了相反的职业病------"各向异性(Anisotropy)"。
在实际测量 BERT 或 GPT 的嵌入层时,工程师发现:几乎所有词的向量全都被挤在了一个极窄的圆锥体里,所有向量两两之间的余弦相似度都在 0.8 到 0.99 之间!
| 理论上的随机空间(正交灾难) | 未经校准的真实语言模型(各向异性) |
|---|---|
| 向量均匀布满高维球面 | 所有词汇挤在同一个狭窄的尖锥中 |
| 任意两向量相似度接近 0 | 任意两向量夹角极小(相似度都大于 0.8) |
| 缺点:容易分散,缺乏关联 | 缺点:退化严重,高频词霸占整个空间的绝对方向 |
为了解决这个问题,现代工程通常会使用 Whitening(白化变换) 、Cosine Normalization 或在对比学习中增加负样本排斥力,强行把这些挤在一起的向量重新"吹散开",让它们恰好利用好高维空间的庞大正交容量。
高维空间中"随机向量几乎全正交"不但不是缺陷,反而是大模型的天然超能力 : 正因为绝大多数空间都是正交且空的,高维空间才拥有几乎无限的存储容量,能容纳数以亿计的概念互不产生串扰;而真正有关系的实体,则在损失函数的雕刻下,紧紧依偎在属于它们的低维流形上。