【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
5、【数学】【基础】归一化的几何意义:球面、超平面与信息去哪了
背景
上篇 blog
4、【数学】【基础】归一化的数学原理:LayerNorm、RMSNorm 与 BatchNorm
把归一化统一成 x ^ = x − c s \hat{x}=\frac{x-c}{s} x^=sx−c,并留下一句:几何视角下一篇单独展开。本篇就补上这块------球面与超平面到底指什么、"压到球面"是怎么压的、长度被统一之后数据的差异又体现在哪里。
把球面、超平面读成"集合"
在 n n n 维空间里,先记住两个集合的定义:
- 半径 R R R 的球面 :所有长度等于 R R R 的向量, { v : ∥ v ∥ 2 = R } \{v:\lVert v\rVert_2=R\} {v:∥v∥2=R}。二维是圆,三维是球壳;
- 零均值超平面 :所有均值为 0 0 0 的向量, { v : ∑ i v i = 0 } \{v:\sum_{i}v_i=0\} {v:∑ivi=0}。它是一张过原点、维数为 n − 1 n-1 n−1 的平直子空间(二维就是一条过原点的直线)。
"超平面"只是"平面"在高维的推广。把它们当成"点的集合"来看,后面的推导就很直接了。
径向投影:沿射线压到球面
归一化在几何上就是一次径向投影 :从原点朝 x x x 画一条射线,把箭头缩短或拉长,让它恰好停在这条射线与目标球面的交点上:
x ⟶ x ∥ x ∥ 2 x\longrightarrow\frac{x}{\lVert x\rVert_2} x⟶∥x∥2x
方向一点没变,只改了长度。
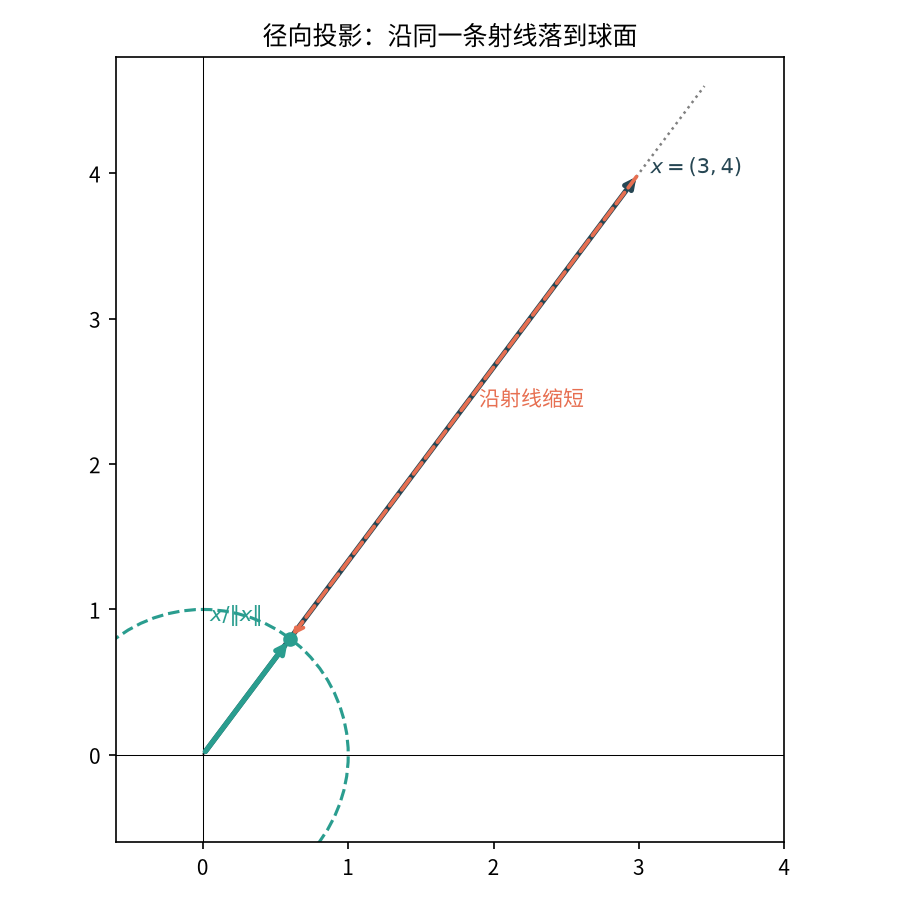
以二维 x = ( 3 , 4 ) x=(3,4) x=(3,4) 为例,长度 ∥ x ∥ 2 = 5 \lVert x\rVert_2=5 ∥x∥2=5,投影到单位圆上就是 ( 3 , 4 ) / 5 = ( 0.6 , 0.8 ) (3,4)/5=(0.6,0.8) (3,4)/5=(0.6,0.8)。
L2 为什么落在单位球面
L2 归一化就是除以自己的长度:
x ^ = x ∥ x ∥ 2 \hat{x}=\frac{x}{\lVert x\rVert_2} x^=∥x∥2x
它的长度必然是
∥ x ^ ∥ 2 = ∥ x ∥ 2 ∥ x ∥ 2 = 1 \lVert\hat{x}\rVert_2=\frac{\lVert x\rVert_2}{\lVert x\rVert_2}=1 ∥x^∥2=∥x∥2∥x∥2=1
所以无论原来多长,输出长度恒为 1 1 1------所有输出都落在"长度 = 1 =1 =1"的集合里,这个集合就叫单位球面。
RMSNorm 为什么落在半径 n \sqrt{n} n 的球面
RMSNorm 的条件是输出 R M S ( x ^ ) = 1 \mathrm{RMS}(\hat{x})=1 RMS(x^)=1。把均方根展开:
R M S ( x ^ ) = 1 n ∑ i = 1 n x ^ i 2 = 1 \mathrm{RMS}(\hat{x})=\sqrt{\frac{1}{n}\sum_{i=1}^{n}\hat{x}_i^2}=1 RMS(x^)=n1i=1∑nx^i2 =1
两边平方得 1 n ∑ x ^ i 2 = 1 \frac{1}{n}\sum\hat{x}_i^2=1 n1∑x^i2=1,即 ∑ x ^ i 2 = n \sum\hat{x}_i^2=n ∑x^i2=n。而 ∑ x ^ i 2 = ∥ x ^ ∥ 2 2 \sum\hat{x}_i^2=\lVert\hat{x}\rVert_2^2 ∑x^i2=∥x^∥22,所以
∥ x ^ ∥ 2 = n \lVert\hat{x}\rVert_2=\sqrt{n} ∥x^∥2=n
RMSNorm 不是把长度压成 1 1 1,而是压成 n \sqrt{n} n ( n n n 是维数,二维就是 2 \sqrt{2} 2 )。
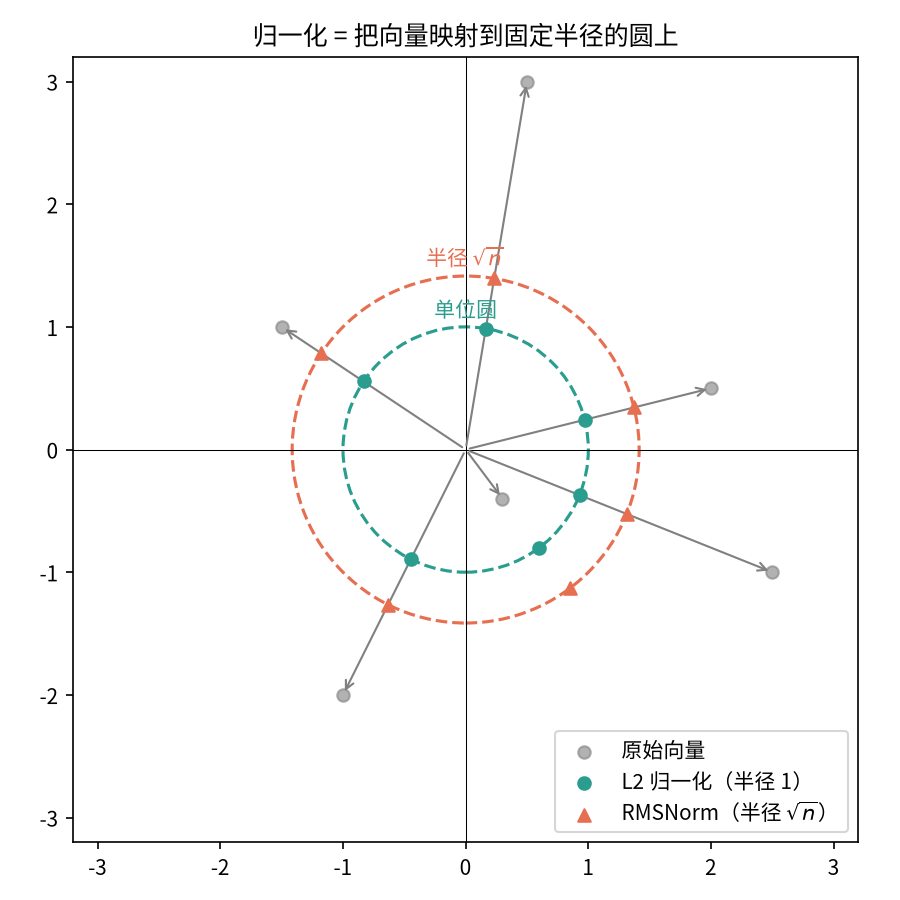
图中原始向量长短不一、方向各异:L2 归一化把它们全压到单位圆上,RMSNorm 则压到半径 2 \sqrt{2} 2 的圆上。
LayerNorm 为什么是"超平面 ∩ \cap ∩ 球面"
LayerNorm 比前两者多了一步减均值,用正交分解看得最清楚:
x = μ 1 ⏟ 公共部分 + ( x − μ 1 ) ⏟ 零均值部分 x=\underbrace{\mu\mathbf{1}}{\text{公共部分}}+\underbrace{(x-\mu\mathbf{1})}{\text{零均值部分}} x=公共部分 μ1+零均值部分 (x−μ1)
其中 1 = ( 1 , ... , 1 ) \mathbf{1}=(1,\dots,1) 1=(1,...,1),零均值部分与 1 \mathbf{1} 1 正交(内积为 0)。
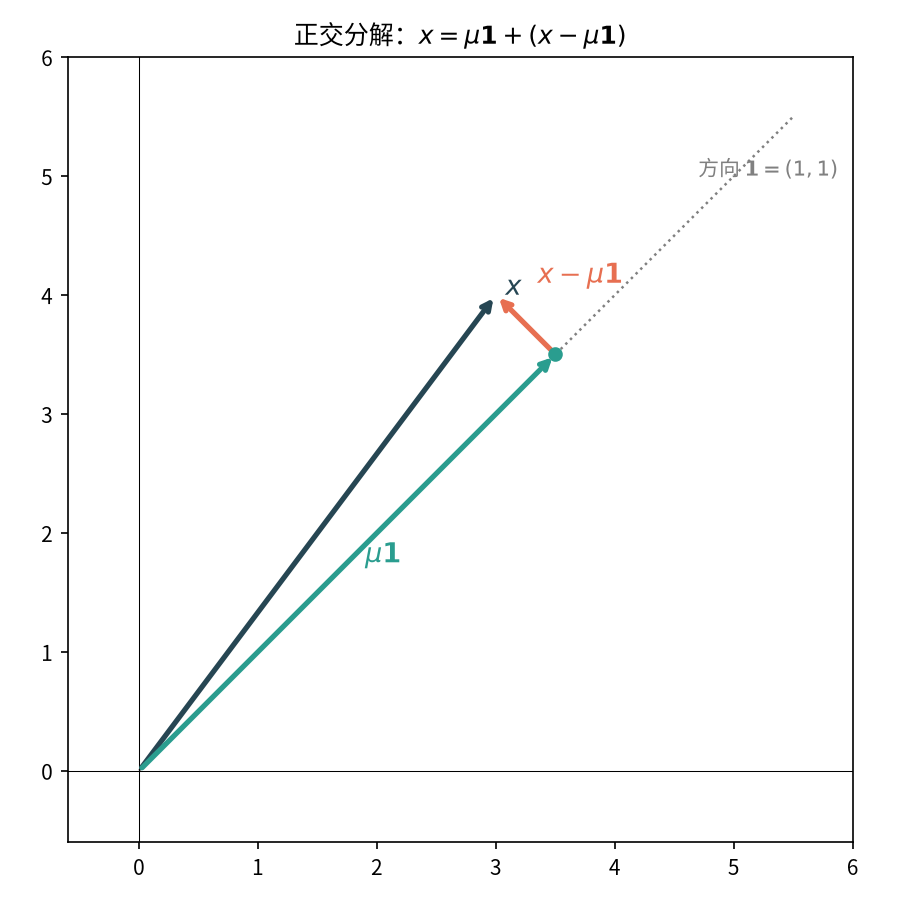
- 减去 μ 1 \mu\mathbf{1} μ1 后,输出的均值为 0 0 0,落在零均值超平面上;
- 再除以 σ \sigma σ 后,输出方差为 1 1 1,等价于长度 ∥ x ^ ∥ 2 = n \lVert\hat{x}\rVert_2=\sqrt{n} ∥x^∥2=n ,落在半径 n \sqrt{n} n 的球面上。
两个条件同时满足,就落在超平面与球面的交线 上。二维时这条"交线"只剩两个点, ( ± 1 , ∓ 1 ) (\pm1,\mp1) (±1,∓1)。
信息去哪了:差异在方向,不在长度
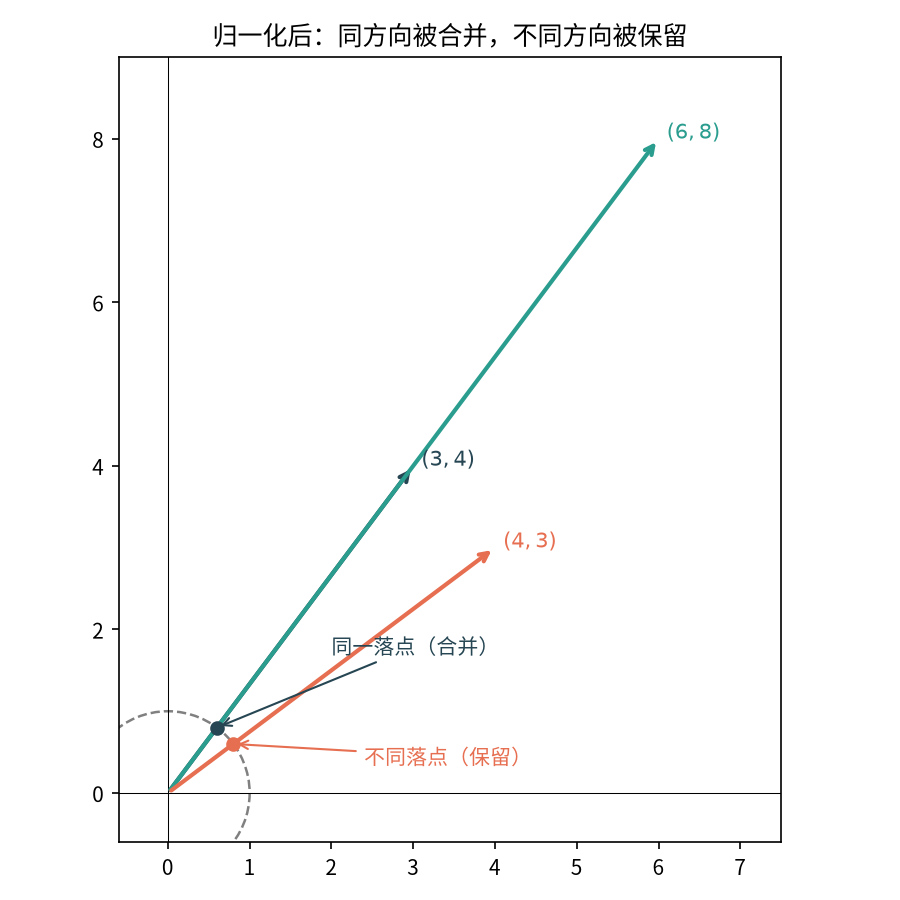
长度被统一后,数据差异全部体现在方向上。用二维例子看得很清楚:
- x = ( 3 , 4 ) x=(3,4) x=(3,4) 与 y = ( 6 , 8 ) y=(6,8) y=(6,8):方向相同、长度不同,L2 后都变成 ( 0.6 , 0.8 ) (0.6,0.8) (0.6,0.8),被合并------长度信息被故意丢掉;
- x = ( 3 , 4 ) x=(3,4) x=(3,4) 与 z = ( 4 , 3 ) z=(4,3) z=(4,3):方向不同,L2 后是 ( 0.6 , 0.8 ) (0.6,0.8) (0.6,0.8) 与 ( 0.8 , 0.6 ) (0.8,0.6) (0.8,0.6),差异保留。
用自由度来数一数还剩多少信息:
| 状态 | 约束 | 剩余自由度 |
|---|---|---|
| 原始向量 | 无 | n n n(长度 + 方向) |
| L2 / RMSNorm | 长度固定 | n − 1 n-1 n−1(只剩方向) |
| LayerNorm | 长度固定 + 均值为 0 | n − 2 n-2 n−2 |
丢掉的正是"长度"这 1 1 1 个自由度(LayerNorm 再多丢"整体偏移")。Qwen2 的隐藏维 n = 896 n=896 n=896,剩 895 895 895 个自由度,信息量几乎没少------被丢掉的恰恰是那个会逐层漂移、需要抹掉的尺度。若网络确实需要不同尺度,由归一化之后的可学习权重 γ \gamma γ 逐维缩放回来。
二维为什么会"看起来全丢"
n = 2 n=2 n=2 时 LayerNorm 剩 n − 2 = 0 n-2=0 n−2=0 个自由度:零均值且长度固定,平面上只剩两个方向,所以看起来"什么都没了"。
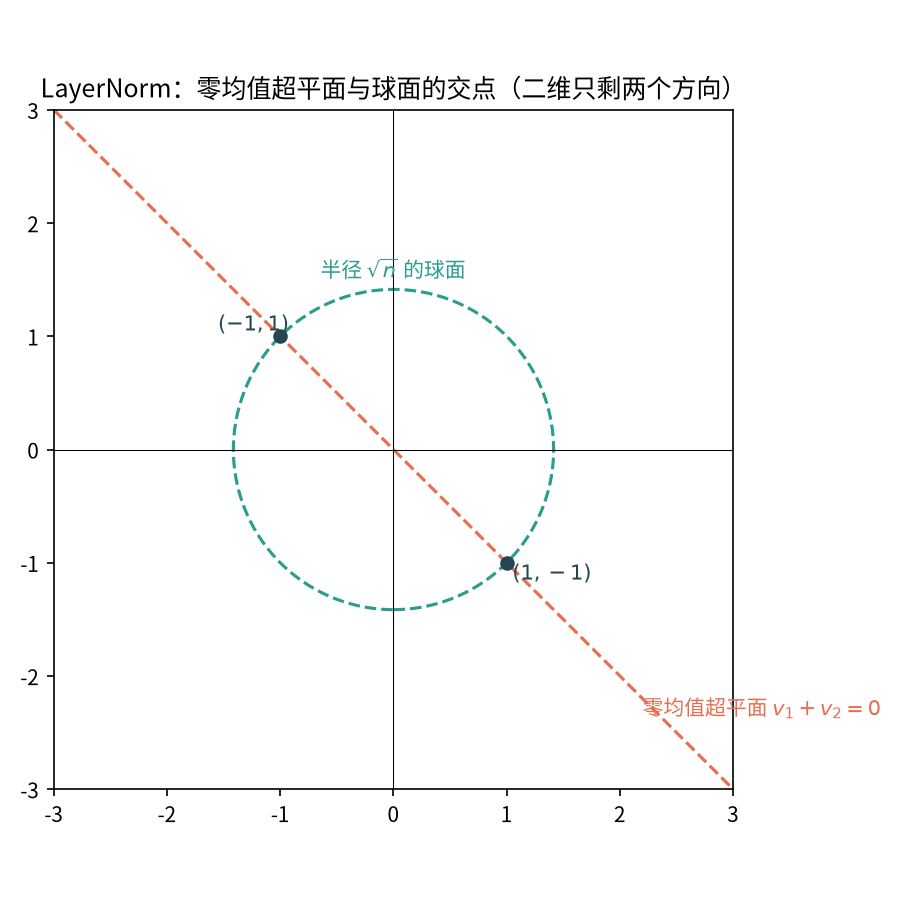
这是二维的极端情况。高维空间里球面和超平面都很大, 896 896 896 维时仍有 894 894 894 维的自由方向,不用担心"信息被压没"。
小结
归一化的几何动作是径向投影 :沿原点射线把向量压到固定半径的球面上。L2 压到单位球面( ∥ x ^ ∥ 2 = 1 \lVert\hat{x}\rVert_2=1 ∥x^∥2=1),RMSNorm 压到半径 n \sqrt{n} n 的球面,LayerNorm 先减均值落到零均值超平面、再压到半径 n \sqrt{n} n 的球面,即落在两者的交线上。长度被统一后,差异体现在方向上;从自由度看, n n n 维只丢 1 ∼ 2 1\sim2 1∼2 个自由度,高维下信息几乎无损,而丢掉的正是需要被抹掉的尺度。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!