面试官问:穿透、击穿和雪崩有什么区别?
我回答:先看请求的数据是否存在,再看失效的是一个热点 key、很多 key,还是整个缓存服务。
| 问题 | 请求对象 | 典型现象 | 主要处理 |
|---|---|---|---|
| 缓存穿透 | 数据库中不存在的数据 | 未设置保护时,每次请求都可能查询数据库 | 空值缓存、布隆过滤器、参数校验 |
| 缓存击穿 | 一个访问量很高的热点 key | 单个 key 失效后,大量请求同时回源 | 互斥锁、逻辑过期 |
| 缓存雪崩 | 大量 key,或整个 Redis 服务 | 大量缓存同时失效,或缓存故障导致集中回源 | 随机 TTL、高可用、限流降级、多级缓存 |
三者也可能叠加:一批热门店铺同时过期形成雪崩,其中某个店铺又因并发重建表现出击穿;持续请求不存在的 ID 则会形成穿透流量。回答时先指出压力从哪里来,再说明对应方案控制哪一段请求。
面试官问:什么是缓存穿透?你怎么解决?
我回答:缓存穿透是请求的数据在 Redis 和数据库中都不存在。普通缓存旁路流程只会回填查到的记录;数据库没有记录时,Redis 中仍没有这个 key,相同的请求下次又会查询数据库。
解决方案:我会先校验明显非法的参数,再把数据库的"无记录"结果用短 TTL 缓存起来。相同无效 ID 的后续请求命中空值标记,直接结束。若无效 ID 分布很散,可以在查询前加布隆过滤器,提前筛掉一部分确定未加入的 ID,并做好新增数据的同步维护。
空值缓存只能减少同一个无效 ID 的重复查询。攻击者每次换一个新 ID 时,每个 ID 仍可能造成一次数据库回源,所以入口限流仍然有价值。
代码实现:用空字符串缓存无记录结果
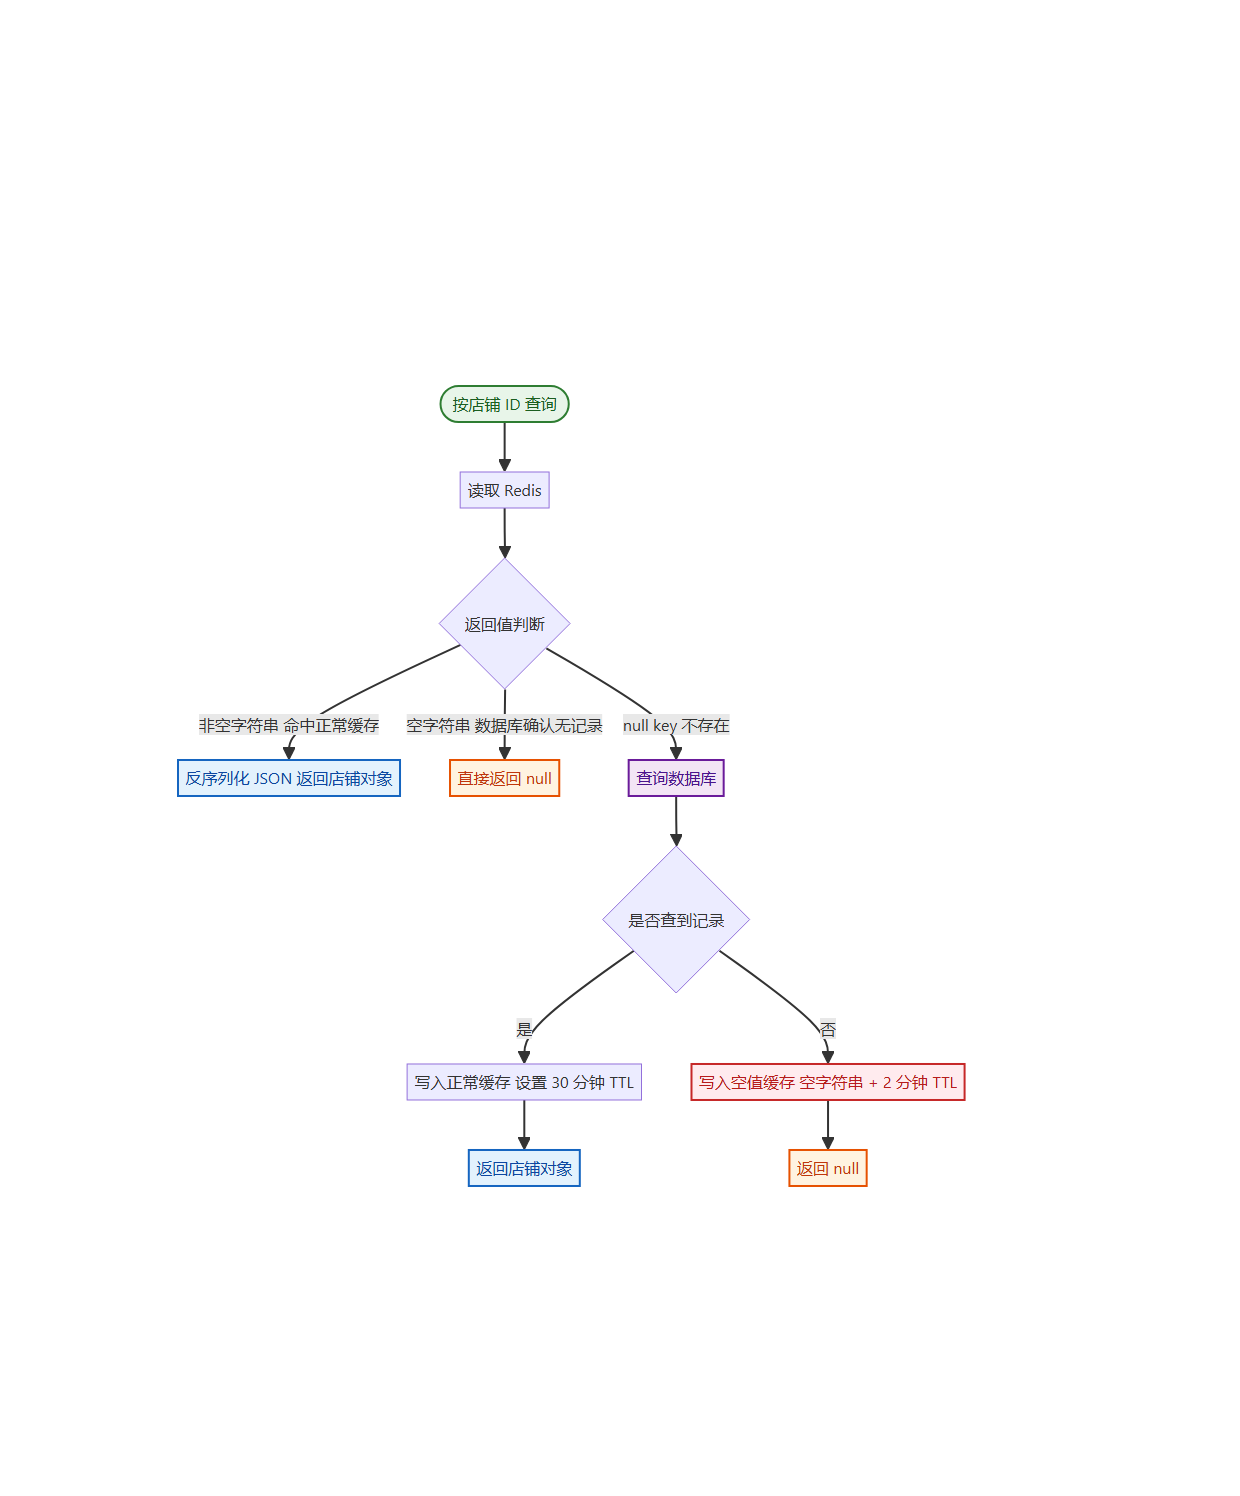
查询一个不存在的店铺时,Redis 不能只留下"查不到"这件事。当前实现把空字符串写回 Redis,并给它设置 2 分钟 TTL;正常店铺数据的 TTL 是 30 分钟。这样,下一次请求还能区分三种状态:
null:key 不存在,说明还没有缓存过,需要查询数据库。- 空字符串:key 存在,但之前已经确认数据库没有记录,直接返回
null。 - 非空字符串:命中店铺 JSON,反序列化后返回。
java
public Shop querywithpassthrough(Long id) {
    String key = CACHE_SHOP_KEY + id;
    String shopJson = stringRedisTemplate.opsForValue().get(key);

    // 命中正常缓存
    if (StringUtils.isNotBlank(shopJson)) {
        return JSONUtil.toBean(shopJson, Shop.class);
    }

    // key 存在但值为空,表示数据库确认无记录
    if (shopJson != null) {
        return null;
    }

    // 只有 key 不存在时才回源数据库
    Shop shop = getById(id);
    if (shop == null) {
        stringRedisTemplate.opsForValue().set(
                key, "", CACHE_NULL_TTL, TimeUnit.MINUTES);
        return null;
    }

    stringRedisTemplate.opsForValue().set(
            key,
            JSONUtil.toJsonStr(shop),
            CACHE_SHOP_TTL,
            TimeUnit.MINUTES
    );
    return shop;
}
空值只表示"这一次查询没有找到记录",所以有效期要短于正常数据。店铺在这段时间内新增,旧的空值仍可能挡住新数据;无效 ID 很多时,空值 key 留存太久也会增加 Redis 的存储压力。
这套处理能挡住同一个无效 ID 的重复回源。请求每次换一个从未出现过的 ID 时,Redis 没有可复用的空值,仍可能触发一次数据库查询,入口还需要配合参数校验和访问频率限制。
追问:布隆过滤器能完全替代空值缓存吗?
我回答:布隆过滤器只能判断"确定未加入"或"可能存在"。只要对应位置有一个为 0,就可以拦截;所有位置为 1 时仍需继续查询,因为可能发生误判。它放行后查不到数据库的 ID,还可以交给空值缓存处理重复请求。
布隆过滤器需要提前装载并持续同步。新增店铺没有及时加入时,业务层可能把真实存在的记录误拦截。
面试官问:一个热点 key 过期,大量请求同时查数据库怎么办?
我回答:这属于缓存击穿。数据在数据库中存在,但一个高访问量 key 失效后,多个请求同时发现未命中,可能重复查询同一条记录。
解决方案:如果请求需要尽量新的数据,我会用互斥锁,让一个请求负责重建,其他请求等待后重试。如果业务允许短时间旧数据,我会预热逻辑过期缓存:过期后先返回旧值,只让一个后台任务刷新。两种方案的取舍点是等待时间与数据时效。
代码实现一:互斥锁控制重建
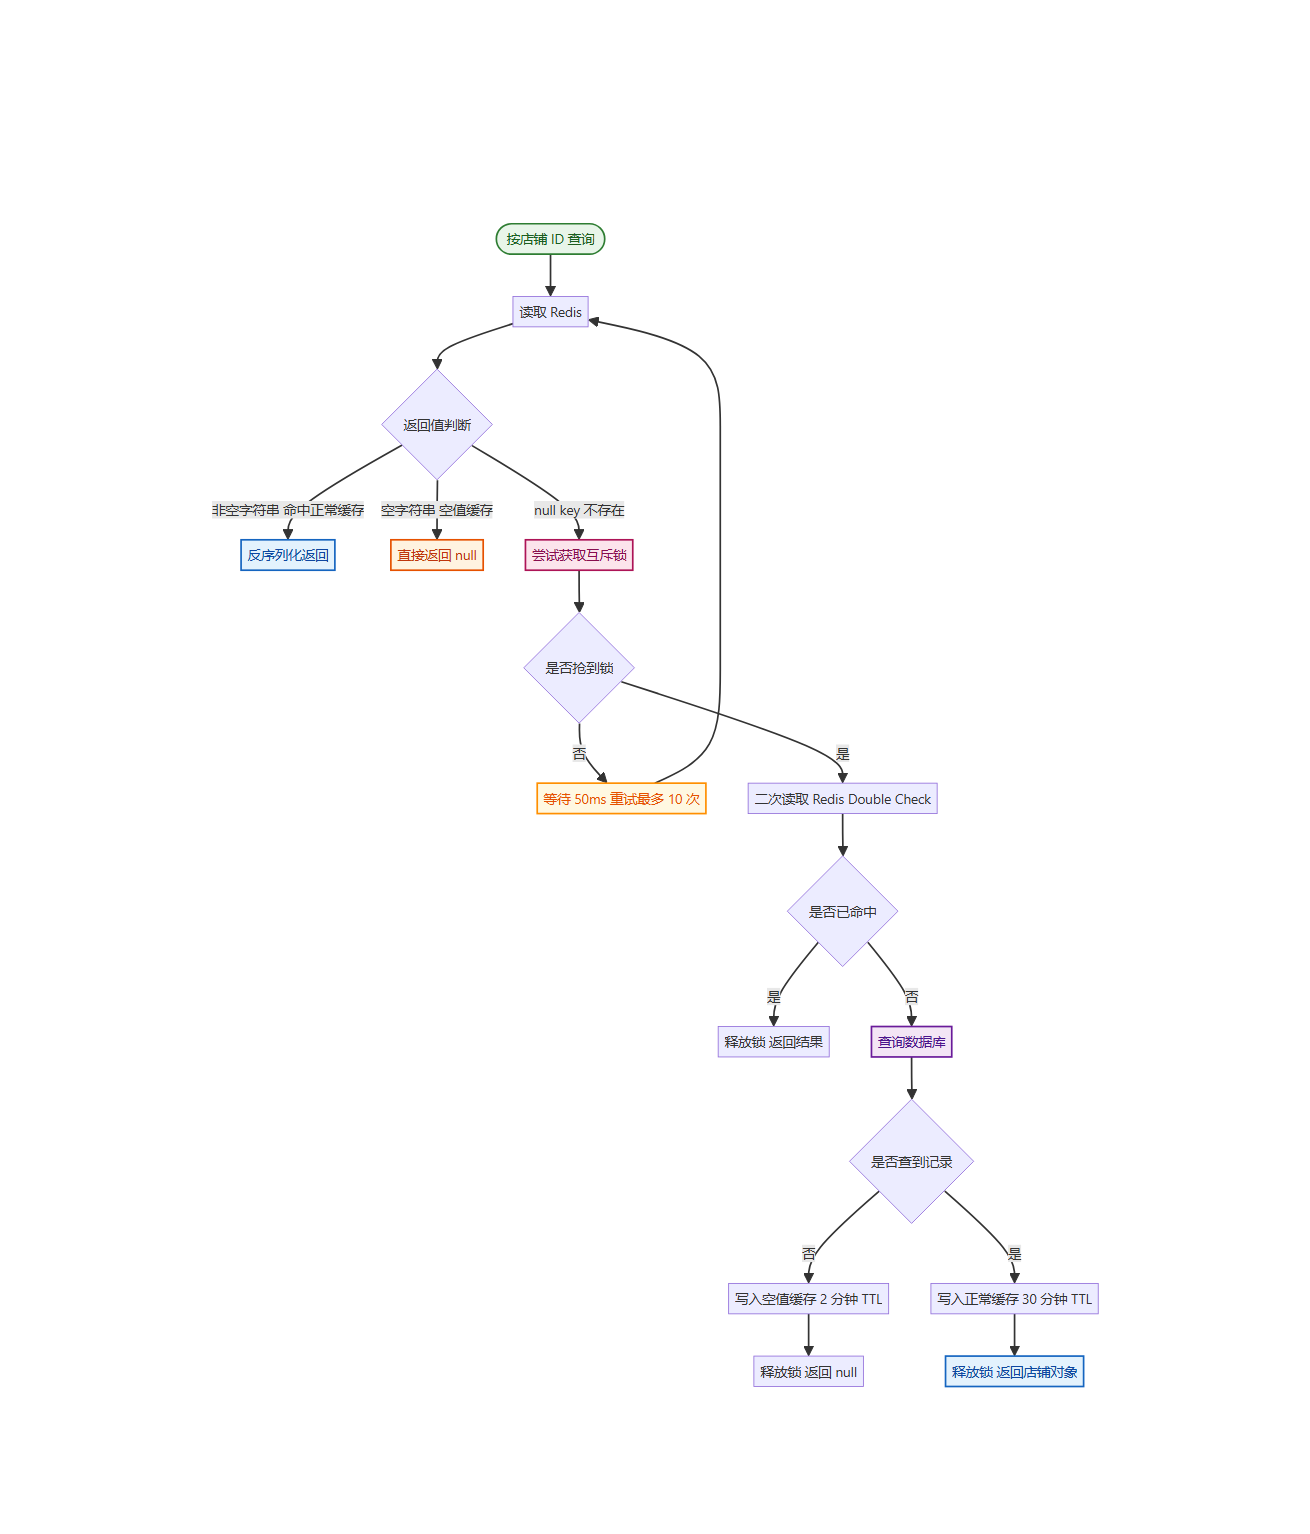
缓存未命中后尝试抢锁。拿到锁的请求二次检查缓存,再回源和回填;没拿到锁的请求等待后重试。锁要有过期时间,并且只能由持有者释放。
java
public Shop querywithmutex(Long id) {
    String key = CACHE_SHOP_KEY + id;
    String shopJson = stringRedisTemplate.opsForValue().get(key);

    if (StringUtils.isNotBlank(shopJson)) {
        return JSONUtil.toBean(shopJson, Shop.class);
    }
    if (shopJson != null) {
        return null;
    }

    try {
        for (int attempt = 0; attempt < 10; attempt++) {
            String lockKey = LOCK_SHOP_KEY + id;
            String lockToken = UUID.randomUUID().toString();
            boolean locked = false;
            try {
                locked = trylock(lockKey, lockToken);
                if (!locked) {
                    Thread.sleep(50);
                    continue;
                }

                // 拿锁后再次读取,避免重复回源
                shopJson = stringRedisTemplate.opsForValue().get(key);
                if (StringUtils.isNotBlank(shopJson)) {
                    return JSONUtil.toBean(shopJson, Shop.class);
                }
                if (shopJson != null) {
                    return null;
                }

                Shop shop = getById(id);
                if (shop == null) {
                    stringRedisTemplate.opsForValue()
                            .set(key, "", CACHE_NULL_TTL, TimeUnit.MINUTES);
                    return null;
                }

                stringRedisTemplate.opsForValue().set(
                        key,
                        JSONUtil.toJsonStr(shop),
                        CACHE_SHOP_TTL,
                        TimeUnit.MINUTES
                );
                return shop;
            } finally {
                if (locked) {
                    unlock(lockKey, lockToken);
                }
            }
        }
        throw new IllegalStateException("缓存重建等待超时");
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
        throw new IllegalStateException("缓存重建被中断", e);
    }
}

private boolean trylock(String key, String token) {
    Boolean result = stringRedisTemplate.opsForValue()
            .setIfAbsent(key, token, LOCK_SHOP_TTL, TimeUnit.SECONDS);
    return BooleanUtil.isTrue(result);
}

private static final DefaultRedisScript<Long> UNLOCK_SCRIPT =
        new DefaultRedisScript<>(
                "if redis.call('get', KEYS[1]) == ARGV[1] " +
                "then return redis.call('del', KEYS[1]) " +
                "else return 0 end",
                Long.class
        );

private void unlock(String key, String token) {
    stringRedisTemplate.execute(
            UNLOCK_SCRIPT, Collections.singletonList(key), token);
}
拿到锁时,请求会用 UUID 生成自己的锁值。释放锁前,Lua 脚本先核对 Redis 中的锁值;确认锁仍属于当前请求,才执行删除。即使旧锁在处理期间到期、又被其他请求拿到,先前的请求也删不掉新锁。DefaultRedisScript 保存这段脚本,RedisTemplate.execute 将锁 key 和锁值传给 Redis 执行,Collections.singletonList 用来组装 key 列表。
没有拿到锁的请求每隔 50 毫秒重试一次,最多尝试 10 次,仍未成功就抛出等待超时异常。锁的有效期要覆盖正常的数据库查询与缓存回填;等待次数也要结合接口的超时时间调整。
需要新数据、又能接受短暂等待时,可以用互斥锁控制热点重建。它按店铺 ID 分锁,正常持锁期间,同一家店只由一个请求负责回源。如果大量不同店铺同时失效,各自的锁仍会放行一次数据库查询,还需要限制整体回源量。
代码实现二:逻辑过期与异步刷新
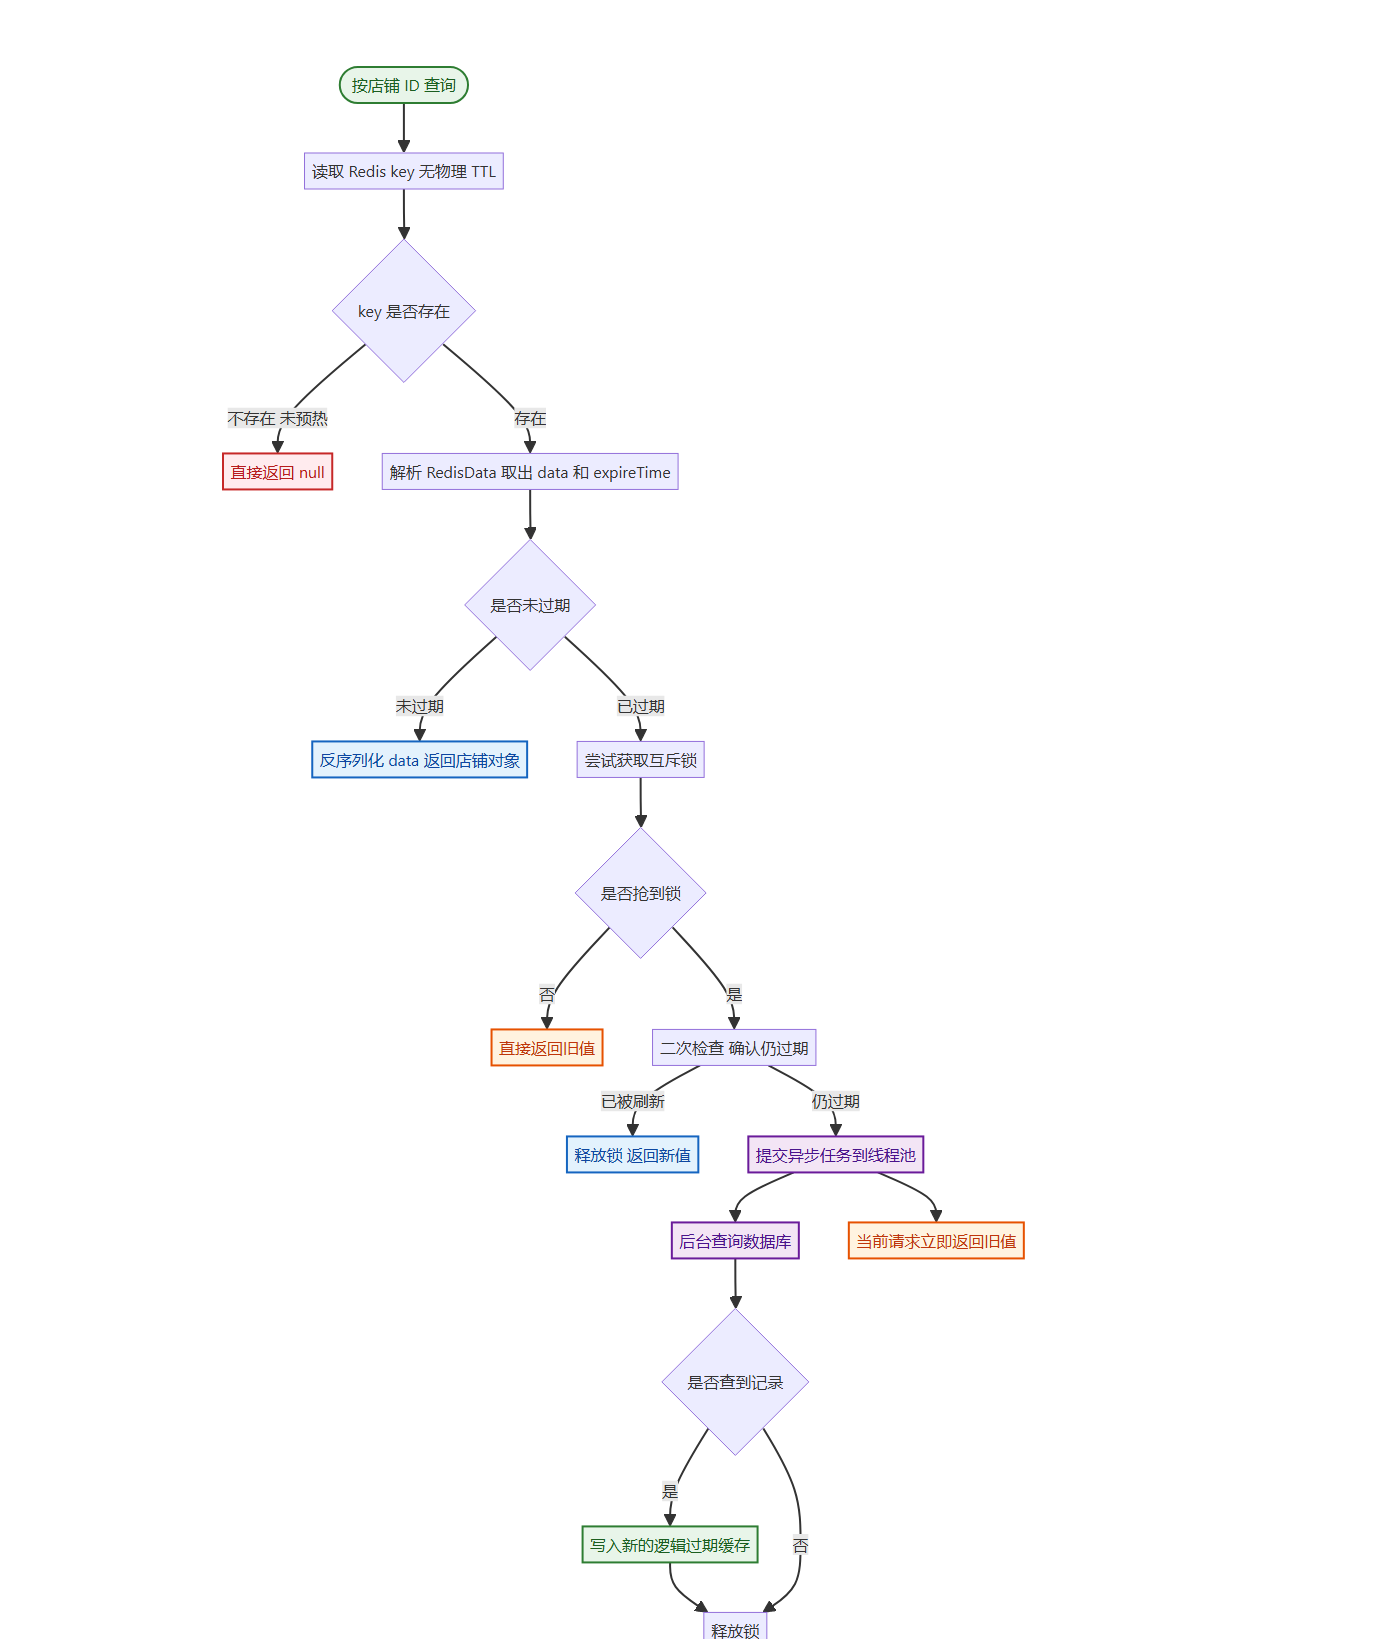
逻辑过期把业务过期时间放进 value,Redis key 本身不设置物理 TTL。请求读到过期数据后,先尝试抢锁;抢到锁的请求提交异步重建任务,当前请求仍返回旧值。
java
@Data
public class RedisData {
    private LocalDateTime expireTime;
    private Object data;
}
写入逻辑过期缓存时,项目使用 set 保存 JSON,不传入 Redis TTL:
java
public void setwithLogicalExpire(
        String key, Object value, Long time, TimeUnit unit) {
    RedisData data = new RedisData();
    data.setExpireTime(
            LocalDateTime.now().plusSeconds(unit.toSeconds(time)));
    data.setData(value);

    // Redis key 不设置物理 TTL
    stringRedisTemplate.opsForValue()
            .set(key, JSONUtil.toJsonStr(data));
}
读取逻辑过期缓存时,项目的 CacheClient 使用固定大小线程池异步刷新。以下示例沿用上方带 token 的 trylock 和 unlock 辅助方法;放入 CacheClient 时需一并使用这两个方法:
java
private static final ExecutorService CACHE_REBUILD_POOL =
        Executors.newFixedThreadPool(10);

public <R, ID> R querywithlogicalexpire(
        String keyPrefix,
        ID id,
        Class<R> type,
        Function<ID, R> dbFallback,
        Long time,
        TimeUnit unit) {
    String key = keyPrefix + id;
    String json = stringRedisTemplate.opsForValue().get(key);
    if (StringUtils.isBlank(json)) {
        return null;
    }

    RedisData data = JSONUtil.toBean(json, RedisData.class);
    R value = JSONUtil.toBean((JSONObject) data.getData(), type);
    if (data.getExpireTime().isAfter(LocalDateTime.now())) {
        return value;
    }

    String lockKey = LOCK_SHOP_KEY + id;
    String lockToken = UUID.randomUUID().toString();
    if (trylock(lockKey, lockToken)) {
        boolean submitted = false;
        try {
            // 抢锁后重新读取,确认其他请求尚未完成刷新
            String latestJson = stringRedisTemplate.opsForValue().get(key);
            RedisData latest = StringUtils.isBlank(latestJson)
                    ? null
                    : JSONUtil.toBean(latestJson, RedisData.class);
            if (latest != null
                    && !latest.getExpireTime().isAfter(LocalDateTime.now())) {
                CACHE_REBUILD_POOL.submit(() -> {
                    try {
                        R freshValue = dbFallback.apply(id);
                        if (freshValue != null) {
                            setwithLogicalExpire(key, freshValue, time, unit);
                        }
                    } catch (Exception e) {
                        log.error("缓存重建失败,key={}", key, e);
                    } finally {
                        unlock(lockKey, lockToken);
                    }
                });
                submitted = true;
            }
        } finally {
            // 未提交任务时,锁仍由当前请求持有
            if (!submitted) {
                unlock(lockKey, lockToken);
            }
        }
    }

    // 无论是否抢到锁,都先返回旧值
    return value;
}
逻辑过期缓存要先把热点数据写入 Redis。预热时先从数据库查出店铺,再把店铺信息和过期时间一起保存。查询方法只读取已经写入的逻辑过期数据;如果 key 不存在,它会直接返回空结果,不会在这个分支里再次查询数据库。
逻辑过期时间到了,后台线程会尝试刷新缓存。刷新失败时,原有数据仍可能留在 Redis 中,因此要给旧值设定最长可接受时限。超过这个时限后,系统应进入受控回源或业务降级路径,避免刷新持续失败时长期返回旧数据。
物理 TTL 由 Redis 管理。时间到了,Redis 可以删除对应的 key;逻辑过期把过期时间放在 value 中,key 仍然存在,由应用读取过期时间并决定是否刷新。逻辑过期依赖 Redis 能够正常读取,仍然需要配合复制、Sentinel 或 Cluster 等高可用方案。
面试官问:很多缓存同时失效,或者 Redis 宕机,你怎么保护数据库?
我回答:这属于缓存雪崩,需要先分清故障来源。大量 key 在相近时间写入并采用相同 TTL,会集中到期;Redis 节点或网络故障,会让应用无法读取缓存。两种情况都可能造成大量回源。
解决方案:批量过期时,对允许的缓存时长增加随机偏移,必要时分批预热。Redis 故障时,用复制、Sentinel 或 Cluster 降低节点故障影响,并在应用侧限制数据库回源总量,为超限请求准备明确的降级结果。业务允许旧数据时,可以再用本地缓存提供一条独立读取路径。
这些措施保护的范围不同:随机 TTL 分散到期时间,高可用处理节点故障,回源限流保护数据库。本地缓存还要处理各实例的数据失效和允许多旧的问题。
Redis 故障时的处理:主从复制保存数据副本,Sentinel 监控主从节点并执行自动故障转移,Cluster 通过分片和副本支持扩展与故障转移。节点切换期间仍可能短暂失败,应用客户端需要能够发现新主节点并恢复连接。
缓存未命中或 Redis 读取异常时,回源入口要限制数据库承受的总请求量。单 key 互斥锁只约束同一条数据的重建;大量不同 key 同时失效时,仍需业务级限流。超过限额的请求应返回符合业务语义的降级结果,不能把 Redis 连接失败伪装成"店铺不存在"。多实例部署时,各实例限额会叠加,应按数据库总容量设置。
本地缓存可以在 Redis 短暂不可用时提供独立的旧值读取路径,但需要管理实例间更新、容量和最大允许旧值时间。
代码实现:给正常数据设置随机 TTL
如果店铺缓存基础 TTL 为 30 分钟,可以在允许的范围内加入随机偏移:
java
long baseSeconds = TimeUnit.MINUTES.toSeconds(CACHE_SHOP_TTL);
long randomSeconds = ThreadLocalRandom.current().nextLong(301);
long ttlSeconds = baseSeconds + randomSeconds;

stringRedisTemplate.opsForValue().set(
        key,
        JSONUtil.toJsonStr(shop),
        ttlSeconds,
        TimeUnit.SECONDS
);
这个例子把 TTL 分布在 1800 到 2100 秒之间。随机范围必须服从业务的数据时效上限。业务数据最长只允许缓存 30 分钟时,随机 TTL 可设置在 25 到 30 分钟之间。
随机 TTL 只能分散物理过期时间。它不能防止单个热点并发重建,也不能在 Redis 故障时继续读取缓存。
逻辑过期也可以加入随机的业务过期时间,以分散后台刷新任务,但大量 key 仍然可能同时触发刷新,所以还要配合互斥重建和回源限流。
面试官追问:这几种方案如何选择?
我回答:先确认业务允许的数据旧值时长,以及数据库能够承受的总回源量。
| 条件 | 优先考虑 |
|---|---|
| 数据必须尽量新,可以接受短暂等待 | 互斥锁 |
| 读多写少,允许返回短时间旧值 | 逻辑过期 |
| 无效 ID 重复请求较多 | 空值缓存 |
| 无效 ID 分布很散,数据规模大 | 布隆过滤器加空值缓存 |
| 大批缓存集中写入 | 随机 TTL、分批预热 |
| Redis 节点可能故障 | 复制、Sentinel 或 Cluster,加限流降级 |
面试官追问:怎么证明这些方案生效了?
我回答:在开发或隔离测试环境分别制造无效 ID、热点 key 失效和批量过期,观察数据库查询量、Redis 状态和请求结果。
穿透验证
准备一条确认存在的店铺 ID 和一条确认不存在的 ID。无效 ID 第一次访问应查询数据库并写入空字符串;空值 TTL 内再次访问时,应直接结束且不再触发该方法的数据库查询。Redis 中可以使用 GET、EXISTS 和 TTL 区分空字符串 key 与不存在的 key。
击穿验证
先删除一个热点 key,再用并发请求访问同一个 ID。互斥锁方案应看到一次缓存重建,其余请求等待后命中;逻辑过期方案应立即返回旧值,并观察只有一个请求提交异步刷新任务。检查锁 TTL、锁释放和重建失败分支。
雪崩验证
批量写入测试 key 后查看 TTL 分布,确认随机偏移确实产生不同到期时间。对比固定 TTL 与随机 TTL 下的数据库查询量、接口耗时、错误率和连接池等待情况。模拟 Redis 连接失败时,确认请求不会无条件把全部流量转给数据库;使用 Sentinel 或 Cluster 时,还要观察故障发现、切换和客户端重连过程。
Redis TTL 命令返回剩余秒数;返回 -1 表示 key 存在但没有物理过期时间,返回 -2 表示 key 不存在。逻辑过期缓存通常会得到 -1,此时应读取 JSON 中的 expireTime,不能把 -1 当作业务数据永不过期。
面试时先判断故障形状,再说明方案的作用范围,最后用代码交代请求在哪里停止、由谁回源、缓存如何重建。排查线上问题也遵循同一顺序:先看 Redis 返回空值、缺失 key,还是连接异常;再看受影响的是一个热点、很多 key,还是整个缓存服务。