近年来,视频生成模型逐渐从内容生成走向具身智能。对于机器人而言,视频生成的意义并不只是生成一段视觉上合理的未来视频,更重要的是利用视觉预测去理解当前动作可能带来的后续变化。基于这一思路,World Action Models(WAMs)开始将视频生成模型引入机器人策略,使机器人能够在执行动作之前,对未来的视觉状态进行预测。
但这类方法也带来了一个实际问题:未来视频的生成通常需要经过多步迭代去噪。 对于强调实时闭环控制的机器人而言,每增加一次去噪,都意味着额外的推理开销。因此,如何在保留未来动态信息的同时降低生成成本,成为 WAM 进一步走向实际应用需要面对的问题。
Fast-WAM 等工作已经探索了通过减少去噪步骤来降低推理延迟。但这里存在一个容易被忽略的问题:少做几步去噪,究竟会损失什么?
对于普通的视频生成任务而言,去噪步数减少可能主要意味着视觉细节有所下降;但对于机器人操作来说,真正重要的并不是背景、桌面等静态结构,而是机械臂、夹爪、被操作物体,以及它们之间正在发生的交互动态。
DIDO 关注的正是这一问题:如果最终只进行一步去噪,这一步究竟缺失了哪些信息?又能否让一次前向传播直接获得原本需要多步去噪才能形成的交互动态?
01|从第一步到完整未来:去噪过程中究竟发生了什么?
要回答这个问题,一个关键切入点是观察视频扩散模型完整的去噪轨迹。
DIDO 对多步去噪过程进行了分析。结果显示,不同类型的视觉信息并不是同时形成的:场景中的静态结构往往在较早阶段就已经建立,而与机器人操作直接相关的动态信息,则会随着去噪过程进一步显现。
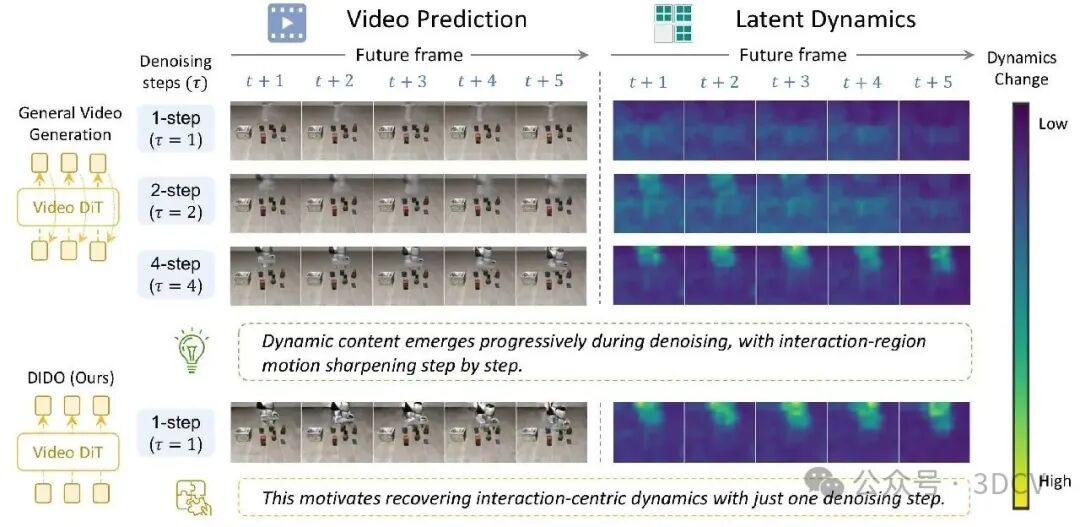
这意味着,直接把多步去噪截断到第一步,并不只是"少生成了一些细节"。更重要的是,一些真正决定机器人后续动作的交互动态,本身可能尚未充分形成。
这也解释了为什么简单的 one-step truncation 虽然能够带来明显的速度提升,却可能在下游控制性能上出现损失。对于 WAM 而言,问题并不是如何尽可能快地生成一段完整视频,而是如何在有限计算预算下保留那些真正影响机器人决策的未来信息。
DIDO 因此没有直接沿着"继续减少去噪步骤"的思路推进,而是尝试重新利用完整的多步生成过程:如果最终的多步结果包含了机器人需要的动态信息,那么能否让一个单步模型直接学习这个最终结果?
项目主页: https://loveju1y.github.io/DIDO/
代码仓库: https://github.com/LoveJu1y/DIDO-WAM/
论文: https://arxiv.org/abs/2609.15570
02|DIDO:把多步动态压缩到一次前向传播
多步动态蒸馏:学习完整去噪后的未来
DIDO 首先从时间维度压缩 WAM 的生成过程。
在 Teacher 端,模型仍然执行完整的 4-step denoising,从噪声逐步生成最终的未来视频 latent;而 Student 则只进行一次前向传播,并直接预测 Teacher 完整去噪之后的最终结果。
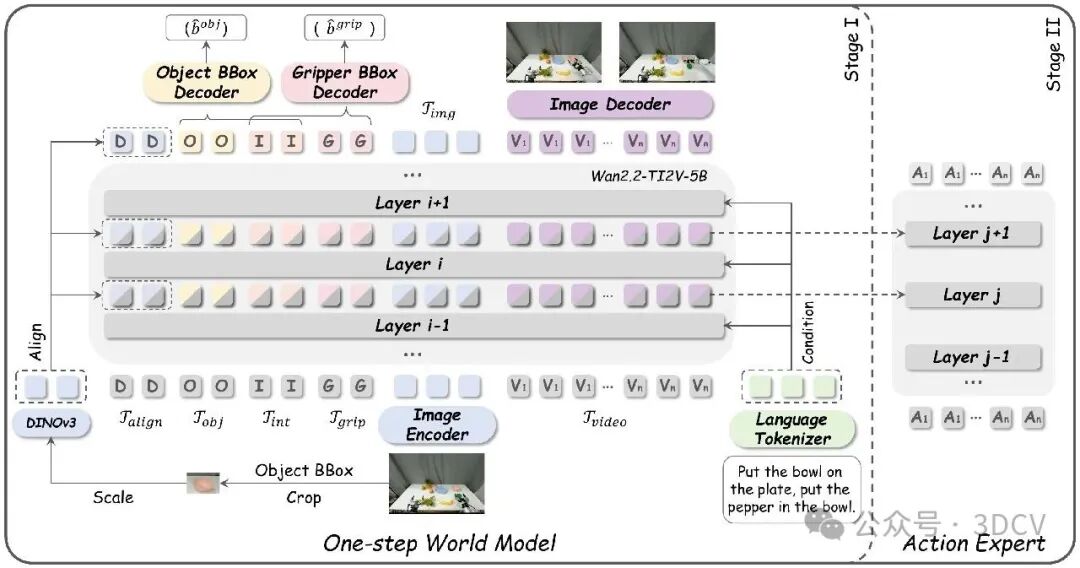
这里最关键的区别在于,Student 并不是在模仿 Teacher 的第一步输出。如果直接将第一步结果作为训练目标,本质上仍然是在学习一个尚未形成完整交互动态的中间状态。DIDO 使用DMD作为蒸馏机制,学习teacher最终输出的分布,使单步模型直接学习整个去噪轨迹最终形成的动态信息。
换句话说,原本分散在多个 denoising steps 中逐渐形成的信息,被压缩到了单次前向传播中。这样做的目标并不是让模型"猜一个更快的第一步",而是让模型在一步之内直接获得原本需要多步计算才能得到的未来表示。
交互感知表示:把计算集中到真正重要的区域
完成时间维度上的压缩后,DIDO 进一步考虑空间维度上的计算效率。
未来视频中并不是所有区域都同样重要。对于机器人操作而言,夹爪和被操作物体附近的变化往往直接关系到下一步动作,而背景和其他低动态区域则很少影响当前交互。
因此,DIDO 在模型中引入了面向交互的表示,包括 object token、gripper token 和 interaction token,分别建模被操作物体、机器人末端执行器以及二者之间的交互关系。其中,interaction token 同时参与物体和夹爪轨迹的预测,使模型能够显式捕获两者之间的关联;align token 则利用 DINOv3 的多层视觉特征进行语义对齐,进一步增强物体相关表示。
在此基础上,模型还根据当前与未来表示之间的变化程度,对不同空间区域进行动态划分。对于区域 (r),其动态分数可以写作:
这里的 (V) 来自模型内部的 value 表示,动态分数用于衡量当前区域在预测未来中的变化程度。需要注意的是,这并不是简单地对每一帧图像进行独立的 VAE 编码后再做差分,而是利用模型自身的 latent representation 来衡量不同区域的动态变化。
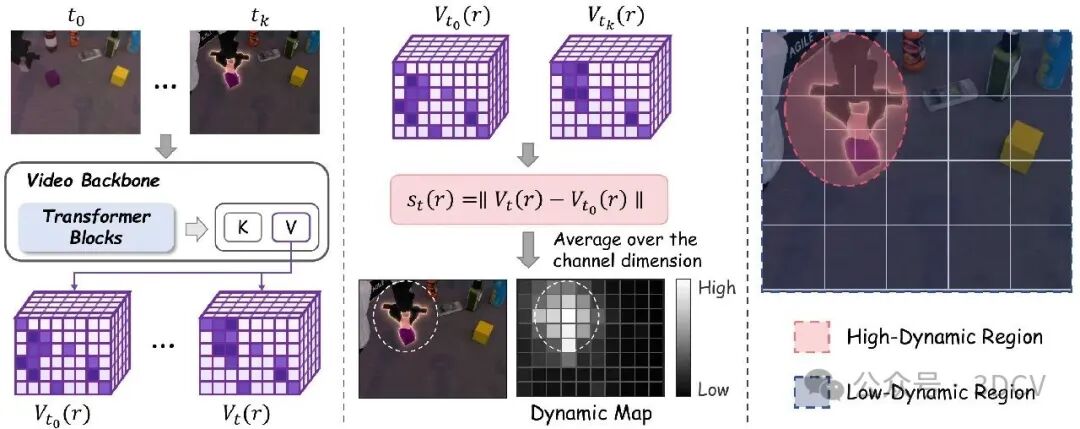
动态分数较高的区域通常对应夹爪、被操作物体及其附近的交互区域,因此保留更细粒度的 token;动态较低的区域则通过平均池化进行压缩。
由此,DIDO 实际上形成了两个层面的压缩:在时间上,将原本需要多次迭代才能形成的未来动态蒸馏到一次前向传播;在空间上,则根据动态程度重新分配 token 计算资源。
最终保留下来的,并不是完整场景中所有区域的同等细节,而是与机器人当前操作最相关的交互信息。
03|一步预测之后,性能还剩多少?
DIDO 首先在 LIBERO 和 RoboTwin 上进行了评估。与已有的 WAM 加速方法相比,一步蒸馏并没有带来明显的性能损失,反而在完整的交互建模之后取得了较高的下游成功率。
| Method | LIBERO | RoboTwin |
|---|---|---|
| LingBot-VA | 98.5 | 92.2 |
| Fast-WAM | 97.6 | 91.8 |
| Faster-WAM | 98.5 | 89.2 |
| Flash-WAM | 95.7 | 85.5 |
| DIDO | 99.0 | 92.0 |
在更强调泛化能力的 LIBERO-Plus 上,DIDO 达到 76.61% 的成功率,而 Fast-WAM 为 51.5%。进一步进行物体位置随机化后,DIDO 的成功率达到 83.34%,相比 Fast-WAM 的 37.7% 仍保持明显优势。
这些结果与前面的设计形成了对应:当场景中的物体位置发生变化时,模型需要的不只是对固定场景结构的记忆,而是能够识别新的物体位置以及夹爪与物体之间的动态关系。交互感知表示和动态区域建模因此成为一步预测能够保持下游性能的重要组成部分。
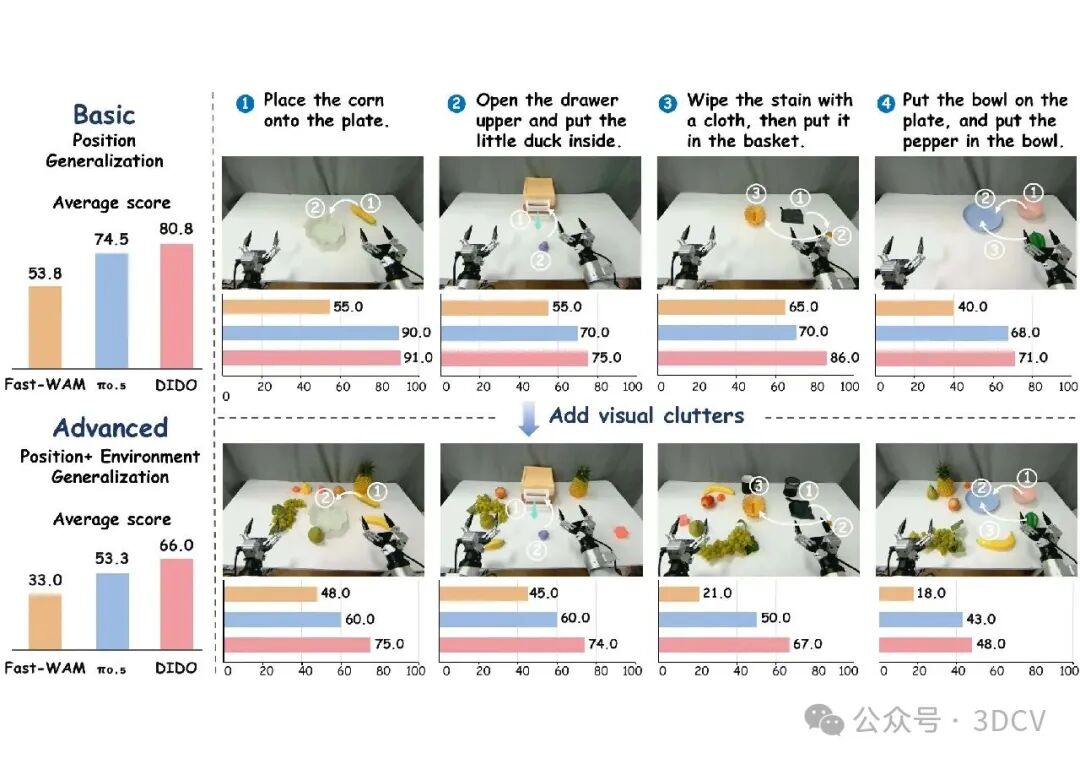
在真实机器人实验中,DIDO 也进行了进一步验证。基于 Galbot G1 平台,在 Basic 任务设置下,DIDO 达到 80.8% 的成功率,π₀.₅ 为 74.5% ,Fast-WAM 为 53.8% ;在更具挑战性的 Advanced 设置下,DIDO 达到 66.0% ,Fast-WAM 则为 33.0% 。
消融实验进一步展示了不同设计的作用:
| Setting | LIBERO | LIBERO-Plus |
|---|---|---|
| Naive 1-step truncation | 97.7 | 71.43 |
| + One-step distillation | 98.3 | 72.31 |
| + Interaction-centric tokens | 98.9 | 75.87 |
| + Dynamic-based pooling | 99.0 | 76.61 |
单纯将去噪过程截断到一步时,LIBERO 和 LIBERO-Plus 分别达到 97.7% 和 71.43%。加入 one-step distillation 后,性能提升至 98.3% 和 72.31%;进一步加入 interaction-centric tokens 后,LIBERO-Plus 提升至 75.87%;最终结合 dynamic-based pooling,达到 76.61%。
这组消融结果说明,DIDO 所解决的问题并不仅仅是"如何让视频模型少跑几步"。如果只是减少计算步骤,模型仍然可能丢失后续去噪阶段逐渐形成的交互信息;而将多步动态蒸馏到单步,再结合交互区域建模和动态感知的 token 压缩,才构成了完整的方法。
在效率方面,DIDO 同样体现出了单步推理的优势。在 H100、batch size 为 1 的设置下,原本 4-step Teacher 的推理时间约为 562 ms ,DIDO 将其降低至 384 ms ,整体降低约 **32%**。相比 Fast-WAM 约 356 ms 的推理时间,DIDO 额外增加约 28 ms,但换来了更加完整的多步动态信息。
04|从"加速生成"到"压缩动态"
如果把 DIDO 放回 WAM 的发展脉络中来看,它所讨论的问题其实并不局限于推理速度。
视频生成模型天然倾向于描述一个完整场景如何随时间演化,但对于机器人而言,未来视频中的每一个像素并不具有相同价值。机器人真正需要预测的,往往是与当前动作直接相关的局部变化:物体是否会被抓住,抓住之后如何移动,目标物与夹爪之间的相对关系如何变化,以及这些变化最终如何影响下一步动作。
DIDO 的核心思路因此可以理解为一种从"完整未来生成"向"任务相关动态预测"的转变。它并没有试图让单步模型重新复现多步生成过程中的所有视觉细节,而是利用完整去噪结果作为监督,将最终真正影响下游控制的信息压缩进一次前向传播,再通过 interaction-centric representation 将有限的计算进一步集中到交互区域。
这一点也让 one-step denoising 有了不同于单纯工程加速的意义。过去,减少去噪步数更多意味着在效率和生成质量之间进行权衡;而 DIDO 的结果表明,去噪轨迹本身可能具有一定的结构性:不同阶段逐渐形成不同类型的信息,而这些信息中只有一部分对于机器人决策真正关键。
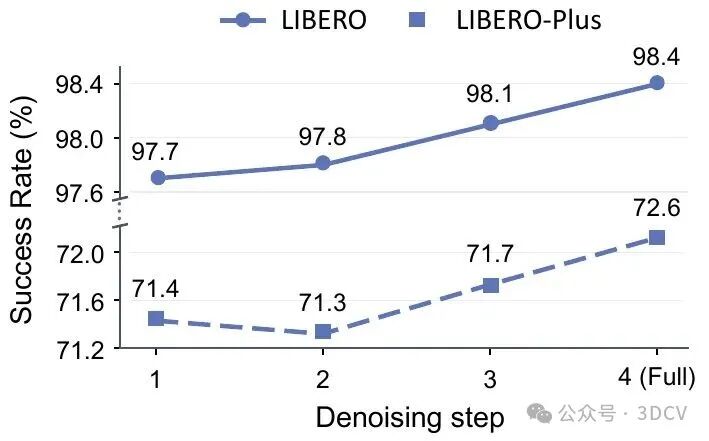
从实验结果来看,在 LIBERO 上,第一步去噪已经能够达到 97.7%,完整 4-step 则达到 98.4%;在 LIBERO-Plus 上,这一数字分别为 71.4% 和 72.6%。多步去噪确实能够带来额外信息,但这些信息并不一定需要以"多次推理"的形式保留下来。
这也提出了一个值得继续讨论的问题:对于以动作决策为最终目标的世界模型,究竟什么样的"未来"才是最有价值的?
如果世界模型的目标最终是帮助机器人行动,那么一个视觉上并不完全、但高度聚焦于交互动态的未来表示,可能比一段更加完整的未来视频更有决策价值。DIDO 所提供的探索路径,是通过蒸馏和表示压缩,将多步世界模型中的交互动态直接提取出来,并进一步压缩到机器人可以实时使用的预测过程中。
从这个角度看,一步去噪并不只是少算几次,而是在反过来追问:一个机器人真正需要的未来,究竟应该包含什么?