Visibility Buffer Rendering with Material Graphs -- Filmic Worlds
可见性渲染探索
第一部分:可见性缓冲渲染与材质图
第二部分:解耦可见性多重采样
第三部分:可见性缓冲渲染的软件VRS
第四部分:利用子采样历史的可见性TAA与上采样
引言
过去的一年多对每个人来说都很不寻常。我们每个人都在以自己的方式应对新冠疫情隔离,而对我来说,我一直在编码。如您所知,由于多种原因(包括低四边形利用率),小三角形在GPU上效率低下。由于可见性缓冲在理论上比延迟渲染更能抵抗四边形利用率差的情况,我一直有个直觉,即可见性缓冲渲染器能够比传统的延迟渲染器获得更好的性能。借着一些空闲时间,我构建了一个Dx12小引擎来测试这个理论。
概述与先前工作
可见性缓冲的想法相当简单。在第一次渲染过程中,您渲染一个"可见性缓冲",它将对象和三角形ID存储在一个单一值中,通常是一个打包的U32。然后,这个三角形/对象ID就是获取您需要的任何参数所需的全部信息。
最初的重大论文来自Intel的Christopher Burns和Warren Hunt 3。除了创造"可见性缓冲"这个术语外,它们是我能找到的关于存储三角形ID并重建插值顶点数据的第一个参考文献。为了处理多种材质,他们将屏幕分成块(tiles),并对块内的像素进行分类。然后,他们为每种材质只渲染覆盖所需像素块的一次绘制调用。可见性缓冲也被用于以其他方式优化渲染,例如Christoph Schied和Carsten Dachsbacher 12,他们将此问题视为一种多重采样压缩算法。来自ConfettiFX的Wolfgang Engel演示了一种可见性缓冲 5,放弃了任意材质图,但使用了无绑定纹理。他们的方法将材质视为具有任意纹理访问的统一着色器。他们还在宽松许可证下提供了源代码,所以如果您感兴趣,我强烈建议您去看看 4。
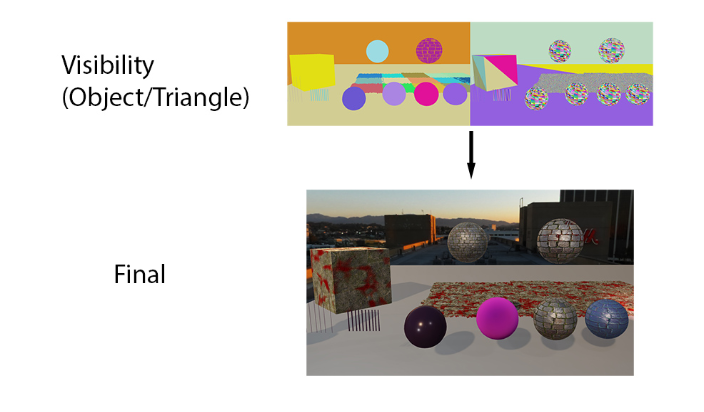
当然,最近的工作是Epic Games在虚幻引擎5中的Nanite。他们处理问题的方式与过去不同。虽然我没有任何秘密可以透露,但其高级方法是公开的。他们不是使用可见性缓冲作为GBuffer的替代品,而是将其用作一种优化手段,以更高效地创建GBuffer。特别是,GPU光栅化器在处理小三角形时存在性能低效问题,因此Nanite使用自定义光栅化器来绕过这些瓶颈,您可以在他们的概述视频中看到 7。请注意,您可以跳到1:00:45查看关于三角形大小的快速讨论。UE5的可见性光栅化器是仅限Nanite的光栅化器,因此其他对象通过标准的延迟渲染路径。
理论上,使用可见性渲染不需要GBuffer。如果您需要法线,您总是可以直接从顶点参数中获取它。如果您再次需要它,您可以再次获取。但在实践中,材质图已经相当长,并且每年都在变长。如果我们只需要直接光照,那么我们可以不需要GBuffer。但由于我们在每帧中多次需要像法线这样的值(直接光照、屏幕空间反射、环境探针等),将材质输出存储在GBuffer中似乎是可行的方法。
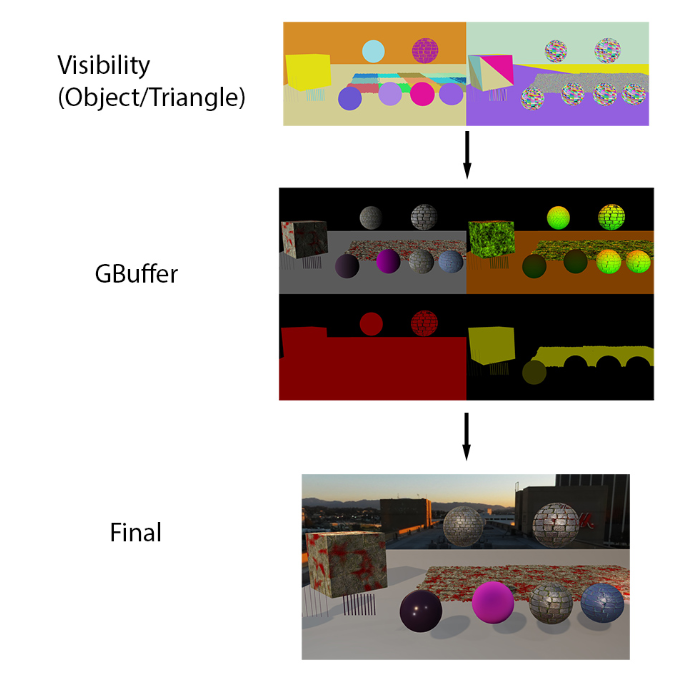
在此处提出的变体中,可见性缓冲将用于生成GBuffer,并且我们将对所有三角形使用它。我们还将使用任意材质图来实现这一点,这意味着计算我们自己的解析偏导数。在进行这些测试时,我试图找到以下几个问题的答案:
-
我们能否高效地计算材质图的解析偏导数?
换句话说,这种方法到底可不可行?如果我们无法计算解析偏导数,这种方法就毫无意义。
-
对于非常高的三角形数量(每个像素一个三角形),可见性方法更快吗?
这种方法对未来工作负载更快吗?如果我们想要达到电影级质量,最终我们需要所有三角形都小到1个像素大小。背景、角色、草地、道具,一切。
-
对于更典型的三角形大小(每个像素5-10个三角形),可见性方法在那里也更快吗?
这种方法对当前的AAA游戏工作负载更快吗?
结果表明,在下面的测试中,以上三个问题的答案都是:是的!但需要注意的是,这是一个小引擎,而不是真正的AAA引擎。
前向/延迟/可见性概述
首先,我们应该快速概述前向、延迟和可见性渲染。
在前向渲染中,您在一个像素着色器中计算所有内容,看起来像这样:
cpp
struct Interpolators; // 位置、法线、UV等
struct BrdfData; // 法线贴图后的法线、反照率颜色、粗糙度、金属度等
struct LightData; // 输出的光照数据,通常只是一个float3

// Pass 0: 渲染所有网格,输出最终光照颜色
LightData MainPS(Interpolators interp)
{
  BrdfData  brdfData  = MaterialEval(interp);
  LightData lightData = LightingEval(brdfData);
  return lightData;
}从根本上说,每个基于物理的前向着色器都从代码中没有显示的隐藏步骤开始:插值顶点。硬件插值顶点数据,并神奇地将插值后的顶点数据传递给您。当然,硬件并不神奇,但这一步确实在像素着色器代码开始执行之前发生。在下一步中,MaterialEval()函数将获取插值后的值(如UV、法线和切线)来执行数学运算和纹理查找,以计算表面材质参数。这些通常包括法线贴图后的法线、基础颜色等。在最后一步,它针对这些参数评估每个光源,并输出最终颜色。
然而,如今游戏中更常见的渲染方法是延迟渲染,它使用GBuffer,分两个阶段渲染:
cpp
// Pass 0: 渲染所有网格,输出材质数据
BrdfData MaterialPS(Interpolators interp)
{
  BrdfData  brdfData  = MaterialEval(interp);
  return brdfData;
}

// Pass 1: 计算着色器(或大四边形)来计算光照
LightData LightingCS(float2 screenPos)
{
  BrdfData  brdfData  = FetchMaterial(screenPos);
  LightData lightData = LightingEval(brdfData);
  return lightData;
}
延迟方法使用与前向相同的基本步骤。然而,光照数据在一个单独的阶段中评估,要么是全屏四边形,要么是计算着色器。其好处是:
-
最大的优势是保证光照函数每个像素只运行一次。当光栅化几何图形时,
MaterialPS()可能每个像素运行多次,但LightingCS()保证只运行一次。 -
当
MaterialEval()和LightingEval()函数在同一个着色器中时,它们会按照两者中最坏情况的寄存器分配进行编译,而当它们分开时,一个阶段可以使用比另一个更少的寄存器(并获得更好的占用率)。 -
使用延迟方法,我们有一个GBuffer,可以用于其他效果,如屏幕空间反射、SSGI、SSAO和次表面散射。
明显的缺点是延迟方法增加了带宽使用量。通常,您可以进行的屏幕空间效果以及改善的着色器性能大大超过了带宽和内存成本。当然,如果您绝对需要MSAA,这一切都不成立,但那完全是另一回事了。
可见性渲染采用了一种非常不同的方法。它不是光栅化光照颜色(如前向)或GBuffer数据(如延迟),而是仅光栅化三角形和绘制调用的ID。我们也可以存储重心坐标或导数,但我们将使用单个三角形ID。
cpp
// Pass 0: 光栅化所有网格,仅输出瘦可见性数据
U32 VisibilityPS(U32 drawCallId, U32 triangleId)
{
  return (drawCallId << NUM_TRIANGLE_BITS) | triangleId;
}

// Pass 1: 在CS中从三角形ID转换为BRDF数据
BrdfData MaterialCS(float2 screenPos)
{
  U32 drawCallId = FetchVisibility() >> NUM_TRIANGLE_BITS;
  U32 triangleId = FetchVisibility() &      TRIANGLE_MASK;

  Interpolators interp    = FetchInterpolators(drawCallId, triangleId);
  BrdfData      brdfData  = MaterialEval(interp);
  return brdfData;
}

// Pass 2: 在CS中,获取BRDF数据并计算光照
LightData LightingCS(float2 screenPos)
{
  BrdfData      brdfData  = FetchMaterial(screenPos);
  LightData     lightData = LightingEval(brdfData);
  return lightData;
}请注意,我们为材质和光照步骤设置了单独的通道,这与大多数先前的工作 3, 13 不同。大多数先前的论文为了减少GBuffer带宽,将这两个步骤一起执行。但鉴于材质着色器的复杂性,我的观点是我们需要一个GBuffer。材质着色器可能非常长,但它们因合理的技术美术原因而变长。美术人员制作的材质着色器可能效率低下(也许说得有点轻了)。但即使它们完全是一团糟,通常也有一个好的、合理的原因来解释材质试图达到的效果,即使这个效果不是以最高性能的方式实现的。我个人的观点是,长的材质图将继续存在,它们会很昂贵,我们需要找出最高效的处理方式。
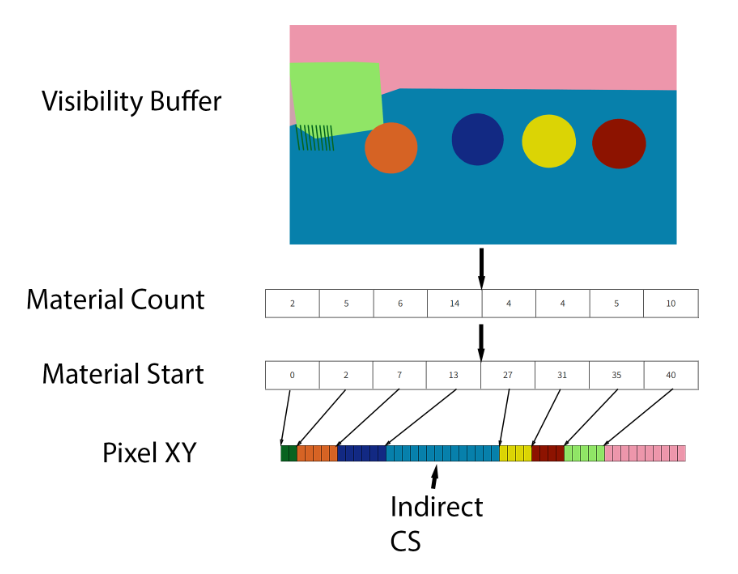
那么在这种情况下,我们如何处理多种材质,特别是材质图呢?我们将使用下面流程图所示的方法。
-
作为第一步,我们渲染全屏可见性缓冲。
-
遍历每个像素,计算每种材质使用的像素数量。将结果存储在材质计数缓冲中。
-
执行前缀和以计算材质起始位置。
-
再次遍历可见性缓冲,将每个像素的XY位置存储到像素XY缓冲中的适当位置。注意,像素XY缓冲的元素数量与可见性缓冲相同。
-
对于每种材质,运行一个间接计算着色器来计算GBuffer数据。
这就是阶段的顺序,它允许我们渲染具有不同生成HLSL代码的多种材质图。然而,在计算GBuffer数据时,还有一个问题需要解决:偏导数。
硬件偏导数
如果您写过像素着色器,那么在某个时候您肯定写过一行从纹理读取的代码。类似这样:
cpp
Sampler2D sampler;
Texture2D texture;
...
float2 uv = SomeUv();
float4 value = texture.Sample(sampler, uv);当您运行这段代码时,GPU会计算出要读取的最佳mipmap级别,并为您过滤数据。但它是如何计算出正确的mipmap级别的呢?
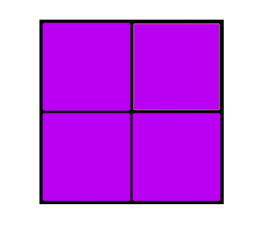
关键在于像素着色器不是处理单个像素。相反,它们在2x2的像素组上运行,这称为一个四边形(quad)。在下面的紫色示例中,三角形覆盖了所有4个像素,所有4个像素都同步运行相同的着色器,在纹理读取期间,GPU会比较4个uv值以确定mipmap级别。GPU可以通过从左像素减去右像素来估计关于x的偏导数,并通过从上像素减去下像素来估计关于y的偏导数。然后,它可以根据该差值的log2确定适当的级别。这种方法称为有限差分法。
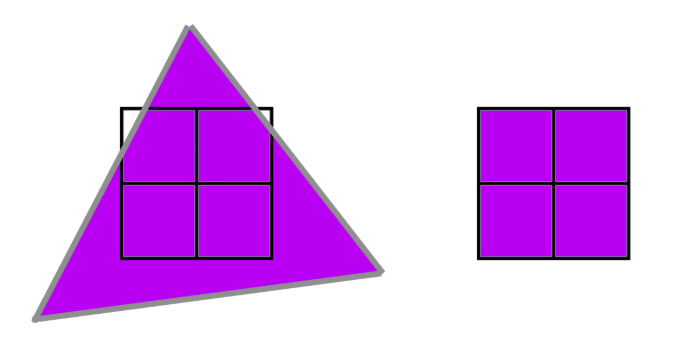
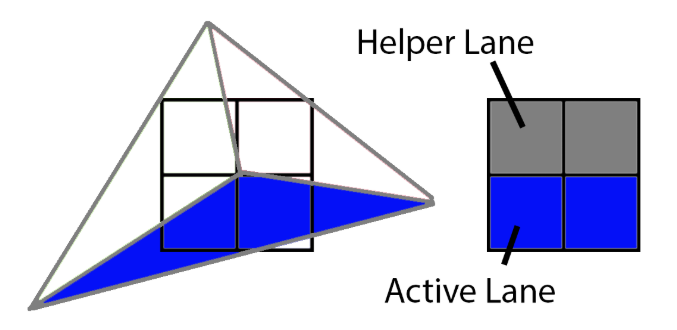
然而,如果一个三角形没有覆盖所有4个像素,比如下面这个只覆盖了3个像素的三角形呢?在这种情况下,GPU会将三角形外推到那个缺失的像素上,并像正常一样运行它。实际运行的3个像素称为"活动通道",而仅为了向其他三个提供导数而运行的1个像素称为"辅助通道"。
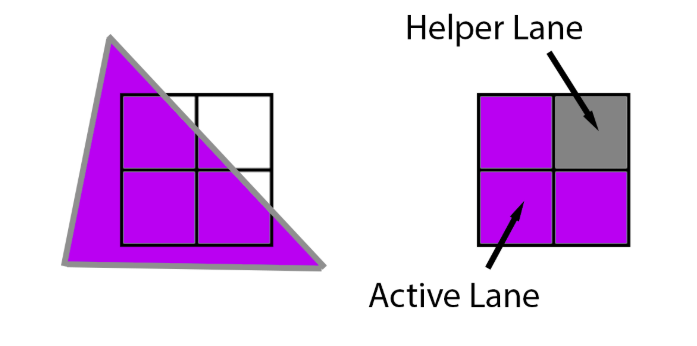
有关更多信息,请参阅HLSL着色器模型6.0波内联函数文档 9。实际上,有一些内联函数可以在同一个2x2四边形中的其他像素之间传递数据。但是,如果多个三角形重叠在同一个2x2四边形上会怎么样呢?
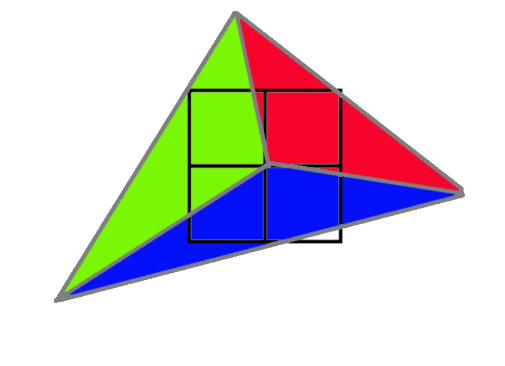
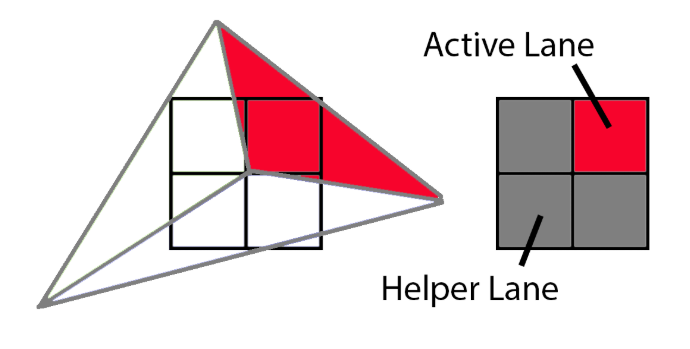
在这个示例中,3个不同的三角形覆盖了2x2网格中的采样中心。首先,绿色三角形覆盖了左上角。为了渲染它,GPU会将左上角像素作为活动通道进行渲染,其他三个则作为辅助通道进行着色,为这一个活动通道提供纹理导数。
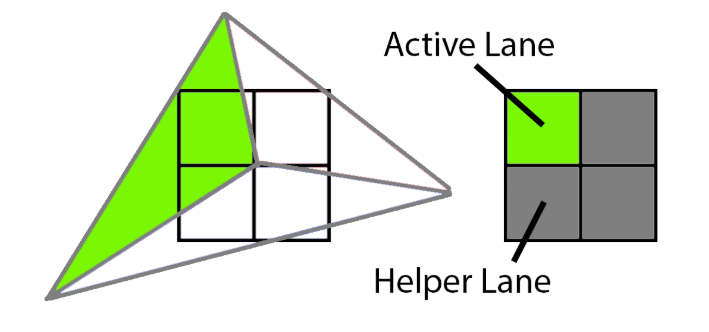
接下来,蓝色三角形将有2个活动通道和2个辅助通道。
最后,红色三角形将有1个活动通道和3个辅助通道。
当我们有1个覆盖四边形中所有4个像素的三角形时,像素着色器的工作负载如下所示:
但是当我们有3个三角形覆盖四边形中的4个像素时,像素着色器的工作负载如下所示:
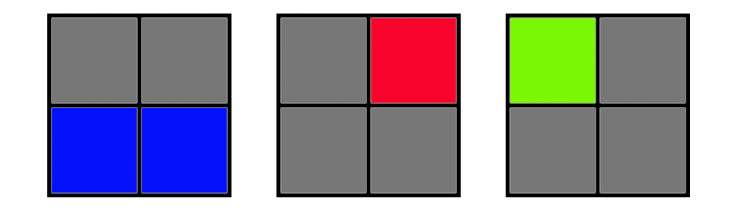
如果我们有3个三角形覆盖同一个2x2四边形,那么相对于一个覆盖所有4个像素的单个三角形,我们实际上有3倍的像素着色器工作要做。活动通道与总通道的比率就是四边形利用率 。紫色四边形具有100%的四边形利用率,但这三个三角形的工作负载只有33%的四边形利用率。影响四边形利用率的主要因素是什么?三角形大小。
四边形利用率效率
鉴于此,假设我们只渲染1像素大小的三角形。即使没有过度绘制,每个2x2四边形也会有1个活动通道和3个辅助通道。
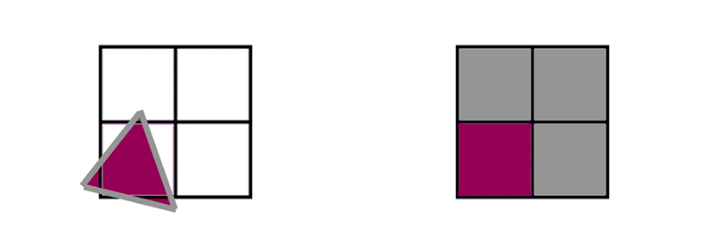
如果我们用1像素大小的三角形渲染整个场景,每个像素我们需要执行每个像素着色器4次,而不是1次。前向和延迟材质着色器将在每个像素运行4次,而延迟光照和可见性材质及光照通道将只在每个像素运行1次。
对于1像素大小的三角形,每像素着色器函数调用次数:
| 渲染方法 | 材质 | 光照 |
|---|---|---|
| 前向 | 4x | 4x |
| 延迟 | 4x | 1x |
| 可见性 | 1x | 1x |
转向另一个极端,如果我们有大三角形呢?在这种情况下就简单多了。辅助通道的数量将占总渲染像素的一小部分,为了本文的目的,我们可以称之为附带性的。像素着色器大约每个像素运行一次。
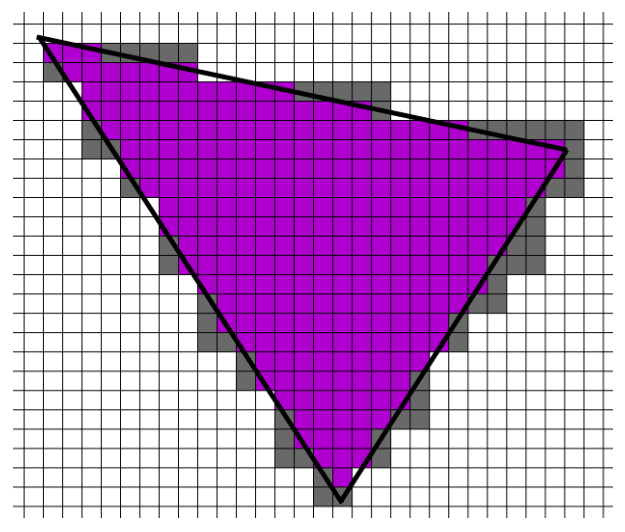
对于大三角形,近似的每像素着色器函数调用次数:
| 渲染方法 | 材质 | 光照 |
|---|---|---|
| 前向 | 1x | 1x |
| 延迟 | 1x | 1x |
| 可见性 | 1x | 1x |
这些是极端情况,但中间情况呢?中间情况更复杂。传统观点认为目标是每个三角形大约10个像素。一个10像素三角形的四边形利用率是多少?这会因形状而异,但让我们尝试几种并找出答案。我们从最简单的10像素三角形开始。
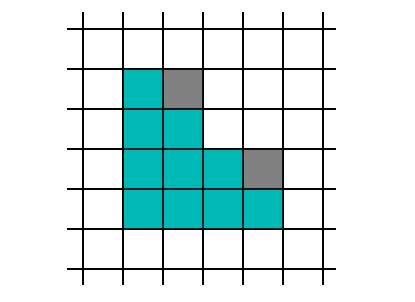
乍一看,它看起来非常好,因为有10个活动通道,只有2个辅助通道。然而,这个三角形与2x2网格对齐有4种可能的方式。
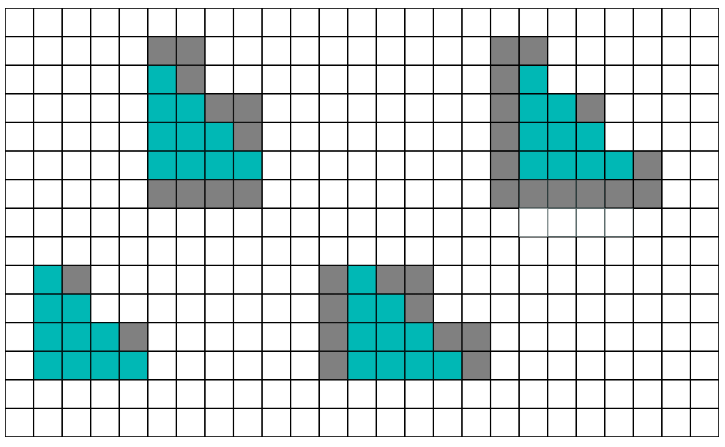
如果您数一数,平均下来会有9个辅助通道对应10个活动通道。接下来,让我们尝试一个更长更窄的三角形。
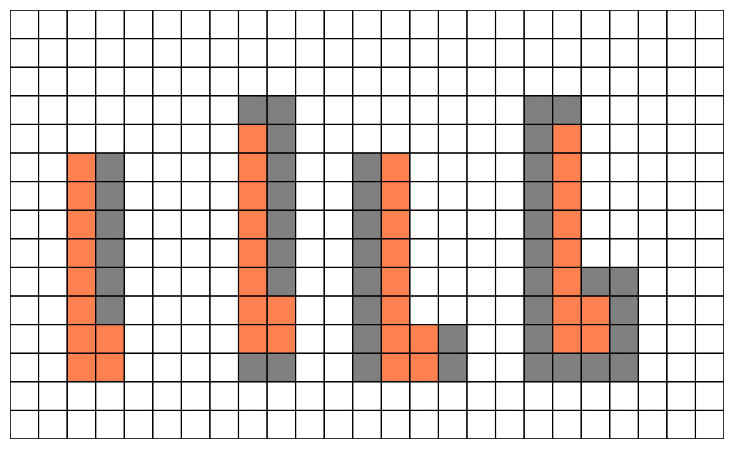
对于这种形状,我们平均有11个辅助通道对应10个活动通道。这是最坏情况的形状:
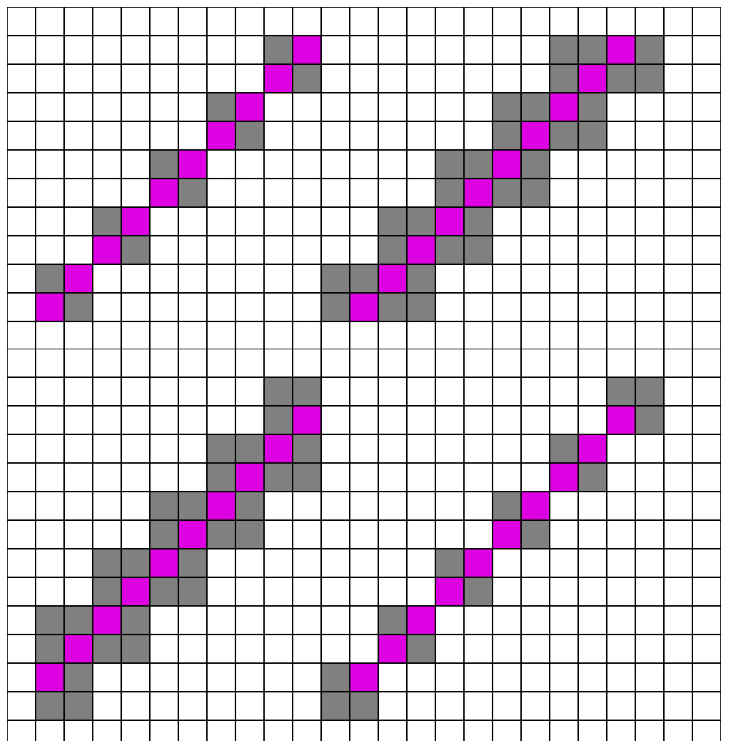
如果我数得没错,对应10个活动通道有21个辅助通道(哎)。现在,这是一个极端情况,因为三角形必须完美对齐才能导致这种形状。作为合理估计,如果我们说第一种(青色)和第二种(橙色)三角形同样频繁发生,而第三种(紫色)从不发生,我们将达到50%的四边形利用率。换句话说,前向和延迟材质通道将大约每个像素运行2次。再一次,延迟光照和可见性材质及光照将每个像素运行一次。
对于10像素三角形,近似的每像素着色器函数调用次数:
| 渲染方法 | 材质 | 光照 |
|---|---|---|
| 前向 | 2x | 2x |
| 延迟 | 2x | 1x |
| 可见性 | 1x | 1x |
乍一看,可见性渲染与延迟相比突然显得非常有吸引力。对于10像素大小的三角形,延迟材质通道需要运行的次数是可见性材质通道的2倍,如果三角形为1像素,则变为4倍。然而,可见性通道有额外的工作要做。
插值与解析偏导数
延迟方法依赖硬件将插值器传递给像素着色器,而我们必须自己获取并插值这些数据。第一步是获取数据,这相对简单。请注意,您可以通过积极打包数据来获得显著收益,但在此测试中,为了简单起见,数据存储为32位浮点数。g_dcElemData是绘制调用元素数据,它是一个StructuredBuffer,包含重要的每个实例数据,例如顶点缓冲区的起始位置。
cpp
uint3 FetchTriangleIndices(uint dcElemIndex, uint primId)
{
  TriangleIndices ret = (TriangleIndices)0;
  uint startIndex = g_dcElemData[dcElemIndex].m_visStart_index_pos_geo_materialId.x;
  return g_visIndexBuffer.Load3(startIndex + 3 * 4 * primId);
}

TrianglePos FetchTrianglePos(uint dcElemIndex, TriangleIndices triIndices)
{
  uint startPos = g_dcElemData[dcElemIndex].m_visStart_index_pos_geo_materialId.y;

  TrianglePos triPos = (TrianglePos)0;
  triPos.m_pos0.xyz = asfloat(g_visPosBuffer.Load3(startPos + 12 * triIndices.m_idx0));
  triPos.m_pos1.xyz = asfloat(g_visPosBuffer.Load3(startPos + 12 * triIndices.m_idx1));
  triPos.m_pos2.xyz = asfloat(g_visPosBuffer.Load3(startPos + 12 * triIndices.m_idx2));
  return triPos;
}
指令不多,但影响性能的是等待数据时的停顿。获取UV和法线数据大致相同,因此我们在此略过。下一步是计算重心坐标。DAIS论文 12 在附录A中有一个非常方便的公式,ConfettiFX代码也是一个非常有用的参考 4。
cpp
struct BarycentricDeriv
{
  float3 m_lambda;
  float3 m_ddx;
  float3 m_ddy;
};

BarycentricDeriv CalcFullBary(float4 pt0, float4 pt1, float4 pt2, float2 pixelNdc, float2 winSize)
{
  BarycentricDeriv ret = (BarycentricDeriv)0;

  float3 invW = rcp(float3(pt0.w, pt1.w, pt2.w));

  float2 ndc0 = pt0.xy * invW.x;
  float2 ndc1 = pt1.xy * invW.y;
  float2 ndc2 = pt2.xy * invW.z;

  float invDet = rcp(determinant(float2x2(ndc2 - ndc1, ndc0 - ndc1)));
  ret.m_ddx = float3(ndc1.y - ndc2.y, ndc2.y - ndc0.y, ndc0.y - ndc1.y) * invDet * invW;
  ret.m_ddy = float3(ndc2.x - ndc1.x, ndc0.x - ndc2.x, ndc1.x - ndc0.x) * invDet * invW;
  float ddxSum = dot(ret.m_ddx, float3(1,1,1));
  float ddySum = dot(ret.m_ddy, float3(1,1,1));

  float2 deltaVec = pixelNdc - ndc0;
  float interpInvW = invW.x + deltaVec.x*ddxSum + deltaVec.y*ddySum;
  float interpW = rcp(interpInvW);

  ret.m_lambda.x = interpW * (invW[0] + deltaVec.x*ret.m_ddx.x + deltaVec.y*ret.m_ddy.x);
  ret.m_lambda.y = interpW * (0.0f    + deltaVec.x*ret.m_ddx.y + deltaVec.y*ret.m_ddy.y);
  ret.m_lambda.z = interpW * (0.0f    + deltaVec.x*ret.m_ddx.z + deltaVec.y*ret.m_ddy.z);

  ret.m_ddx *= (2.0f/winSize.x);
  ret.m_ddy *= (2.0f/winSize.y);
  ddxSum    *= (2.0f/winSize.x);
  ddySum    *= (2.0f/winSize.y);

  ret.m_ddy *= -1.0f;
  ddySum    *= -1.0f;

  float interpW_ddx = 1.0f / (interpInvW + ddxSum);
  float interpW_ddy = 1.0f / (interpInvW + ddySum);

  ret.m_ddx = interpW_ddx*(ret.m_lambda*interpInvW + ret.m_ddx) - ret.m_lambda;
  ret.m_ddy = interpW_ddy*(ret.m_lambda*interpInvW + ret.m_ddy) - ret.m_lambda;

  return ret;
}输入点是齐次裁剪空间(刚进行MVP变换之后)中的点。请注意,我们计算了重心坐标关于x和y的导数。重心坐标(m_lambda)由透视校正插值确定。最后,重心坐标的导数乘以2/winSize,以将单位从NDC坐标(-1到1)更改为像素单位。最后,m_ddy被翻转,因为NDC是从下到上,而窗口坐标是从上到下。
一旦找到了重心坐标和重心坐标的偏导数,从顶点插值任何属性就很容易了。给定三个浮点数,此函数返回插值、关于x的导数和关于y的导数的三元组。
cpp
float3 InterpolateWithDeriv(BarycentricDeriv deriv, float v0, float v1, float v2)
{
  float3 mergedV = float3(v0, v1, v2);
  float3 ret;
  ret.x = dot(mergedV, deriv.m_lambda);
  ret.y = dot(mergedV, deriv.m_ddx);
  ret.z = dot(mergedV, deriv.m_ddy);
  return ret;
}最后,对于从插值器到材质图中纹理采样路径上的任何值,我们都应用链式法则。使用SampleGrad()对纹理进行采样,并显式传递uv导数。
另外,请注意这不是一个新概念。有使用C++模板以这种方式生成导数的实现 11,Arnold也采用了这种方法 8。但不是使用模板来生成导数代码,这个小引擎是根据材质图在hlsl中生成导数计算。Arnold使用术语"导数汇"来表示那些实际需要导数的节点,任何在通向汇点路径上的节点都需要沿途计算导数。然而,他们估计只有5%-10%的节点位于此路径上。其余的节点可以忽略导数。
在实践中,现实世界中绝大多数着色器都使用插值UV,只进行微不足道的调整(如缩放和旋转)。材质的大部分复杂性来自于UV查找之后复杂的数学运算和混合纹理。因此,在大多数情况下,我们只需要对少数几个节点执行额外的导数计算。
尽管如此,这仍然是相当多的额外工作。这些额外指令是否会让可见性材质函数比GBuffer材质函数慢,即使当三角形密度增加时,GBuffer材质需要2倍或4倍的调用次数?还是这些额外计算足够轻量,使得可见性材质函数更快?让我们找出答案。
性能测试
为了测试,我使用了一个带高度图的模型,并将其复制到一个5x3的网格中。摄像机下方还有一些网格投射阴影。阴影深度通道效率非常低,因为它暴力渲染了大量三角形的深度,但所有三种渲染类型的成本相同,因此数字仍然有效。此外,所有命令(包括拷贝)都在图形队列上运行,以最小化重叠并获得一致的数值。对于所有这些截图,时间捕获来自我的带有NVIDIA RTX 3070的机器上的PIX,分辨率为1080p(嗯,技术上来说是1088,因为帧缓冲区大小向上舍入到16的倍数...原因多种多样)。
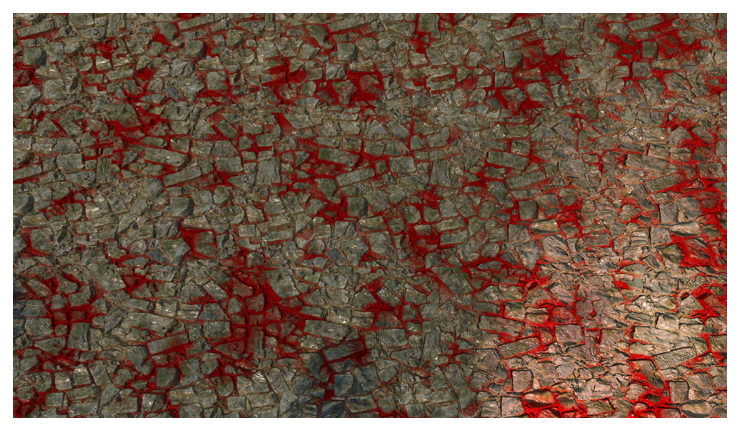
主要地面是一个5x3的高度图网格。它们不是细分后的高度图。相反,有一个预处理步骤生成网格点,然后像普通网格一样处理。想法是我想要控制三角形的近似密度,但我也想要一点过度绘制,以使其与真实用例有些相似。从那个角度看的绘制调用如下所示:
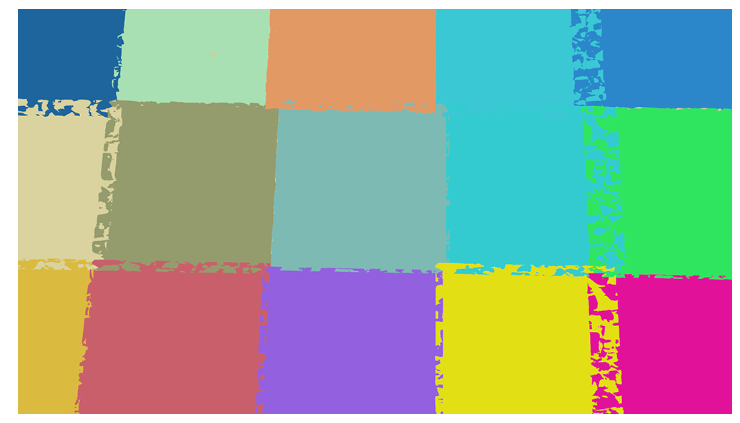
通过这种设置,我们可以保持相机固定,改变这些网格的分辨率,这让我们大致了解随着三角形数量增加,前向、延迟和可见性之间的权衡。
对于材质着色器,我想要一些大致类似于游戏实际使用的东西。在测试模型中,非常常见的是使用简单的PBR纹理,快速查找反照率、法线、高光并直接输出。但现实世界中的材质图往往像一盘意大利面。我用来自AmbientCg.com 2 的两组纹理制作了这个着色器,顺便说一下,如果您需要免费的、高质量且许可证宽松的纹理,强烈推荐这个网站。
-
PavingStones054
-
Ground037
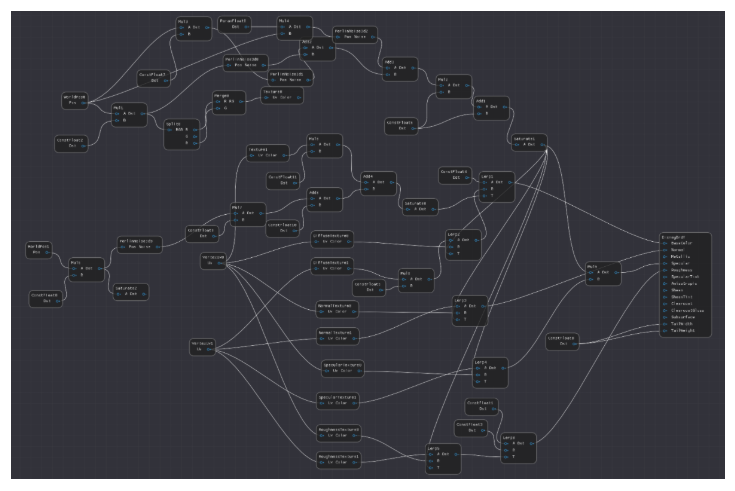
对于混合,我使用了3层Perlin噪声。我还做了第三层,我最初计划它是一个湿度层。但我的第一次测试是平坦的红色,看起来有一种不错的干粉质感,所以我就用了这个。它通过一层Perlin噪声结合高度图混合进来,使得红色层偏向于石头之间的裂缝。
以下是材质图的截图。它有点乱,因为这个材质编辑器缺乏一个成熟的商业引擎的大多数(所有?)UI特性。有很多额外的节点,因为我从来没有抽出时间给节点添加常量(比如加0.5需要一个加法节点和一个0.5常量节点)。但对于这个测试来说已经足够好了。
低三角形数量
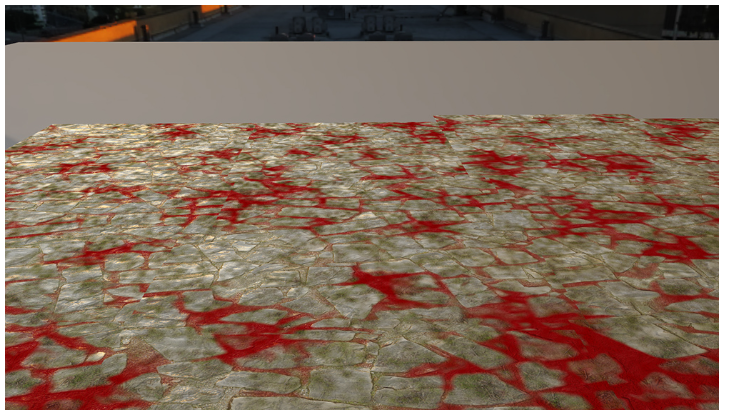
在第一个测试中,我们将观察大三角形,所以每个网格只是一个由两个三角形组成的四边形。这是一个低角度视图,你可以看到它有多平坦。
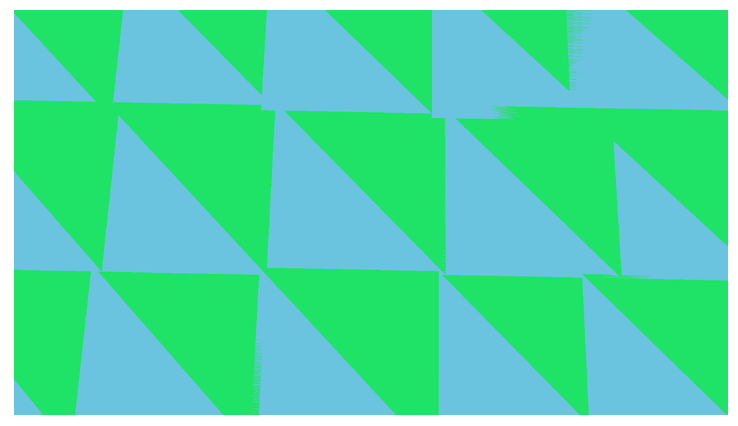
这是三角形ID视图。如您所见,每次绘制调用只是两个三角形。
以及最终图像。
让我们捕捉一些数据。以下是对各阶段的解释。
-
PrePass(预处理通道):对于前向和延迟通道,PrePass只写入深度。然而,对于可见性通道,它也写入包括drawCallId和triangleId的可见性U32。
-
Material(材质):对于延迟通道,此通道指的是材质光栅化通道。对于可见性,它指的是计算通道的时间。当然,对于前向通道,这与光照通道合并为一个数值。
-
Lighting(光照):在延迟情况下,此通道是一个计算着色器,读取纹理并写入光照。可见性对缓冲区执行类似操作,而不是纹理。
-
VisUtil(可见性工具):此类别指的是可见性渲染器中的其他通道。这包括计算每种材质像素数量的计算着色器、重新排序可见性缓冲区,以及在像素着色完成后将其重新排序回线性缓冲区的计算着色器。
-
Other(其他):此类别指所有其他内容。这里的主要通道是阴影通道、TAA、运动矢量、色调映射、GUI(未出现在这些截图中)以及各种屏障。我实际计算这个的方法是取GPU总时间减去所有其他类别。
"其他"类别有点棘手,因为光栅化/计算重叠是组织渲染通道的关键设计决策之一。但此测试的目标是确定不同算法之间的相对成本,而不是最小化最终渲染时间。对于所有三种渲染类型,成本大致相似,因此将它们分开分组是合理的。前向/延迟/可见性的选择对这些项目(如TAA和阴影)的成本影响最小。
低密度三角形视图性能。
| PrePass | Material | Lighting | VisUtil | Other | Total | |
|---|---|---|---|---|---|---|
| 前向 | 0.020 | 1.61 | 1.61 | 0.749 | 2.379 | |
| 延迟 | 0.020 | 1.06 | 0.730 | 0.759 | 2.569 | |
| 可见性 | 0.043 | 1.06 | 0.762 | 0.322 | 0.832 | 3.01 |
嗯,这个结果很有趣。在延迟情况下,材质着色器成本为1.06毫秒,而可见性着色器成本居然完全相同,也是1.06毫秒。此外,光照着色器成本略高0.032毫秒,并且在管理可见性通道方面还有额外的0.322毫秒开销。最后,前向通道计算材质和光照的速度略快,这可能是因为它节省了带宽。
首先,作为免责声明,5x3的四边形几乎是平坦的,并且存在一些z-fighting,因此GBuffer通道中的某些像素可能没有得到正确的早期z剔除,导致少量过度绘制。但更可能的原因是,该通道主要受带宽限制,因此插值顶点和计算导数的额外ALU成本被带宽成本所掩盖。
但是,从数字来看,获取顶点属性和计算偏导数的额外成本是...没有?可见性光照通道略高,额外的管理通道也增加了一些,但总的来说,这对下一个测试来说是一个非常令人鼓舞的结果。此外,VisUtil通道的成本可能还可以降低一些。当前的实现使用缓冲区而不是纹理来渲染光照,并在之后对数据进行排序。但显然,将可见性数据的输出直接作为UAV存储到GBuffer中会更快。
中等三角形数量
接下来,让我们尝试中等分辨率的视图。对于高分辨率图像,我们设定为500x500。为了得到像素密度降低10倍的图像,我们可以将分辨率设为500/sqrt(10)≈158。因此,此中等分辨率设置的网格为158x158。它们有细节,但肯定偏向块状。
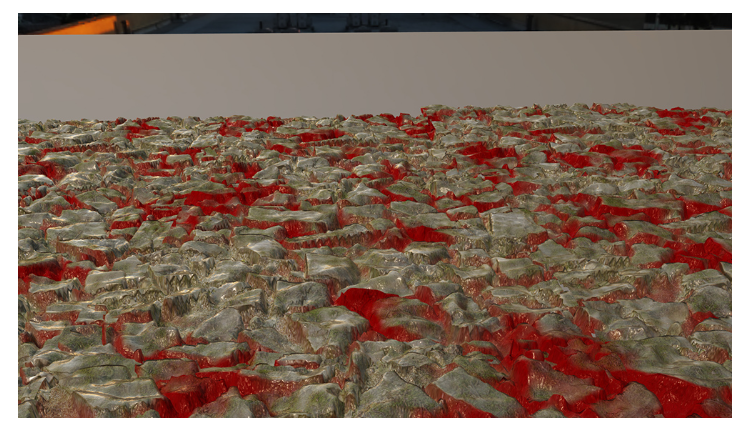
这是我们相机角度看到的最终视图:
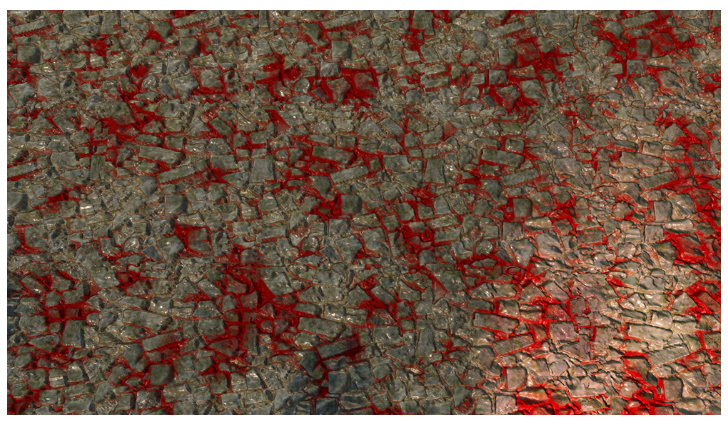
当然,还有所有三角形的视图。在调整相机角度时,我试图让每个三角形大约10个像素,但乍一看似乎更接近8个。目标是捕捉趋势,而不是任何特定大小,所以这已经足够好了。
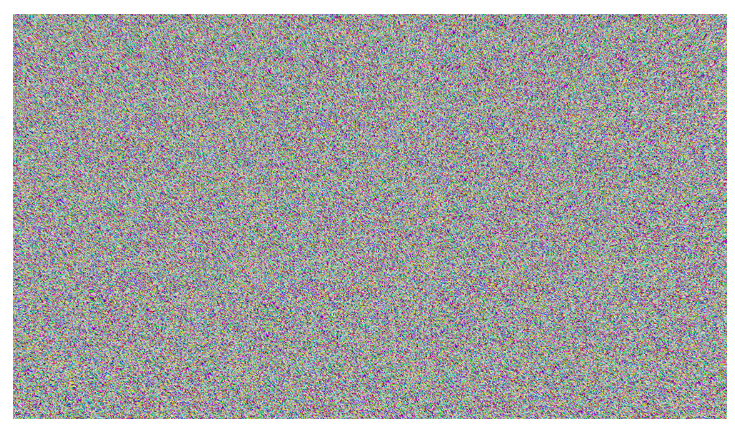
鉴于三角形大约为8-10个像素,我们预计任何光栅化通道的成本大约是原来的2倍。那么数据如何呢?
| PrePass | Material | Lighting | VisUtil | Other | Total | |
|---|---|---|---|---|---|---|
| 前向 | 0.132 | 3.92 | 3.92 | 1.099 | 5.151 | |
| 延迟 | 0.132 | 2.95 | 0.764 | 1.122 | 4.968 | |
| 可见性 | 0.158 | 1.65 | 0.818 | 0.336 | 1.188 | 4.15 |
作为免责声明,"其他"项的变化并不显著,因为其变化是由阴影深度通道驱动的。阴影通道相当简单,只是将所有几何体渲染到级联阴影和点光源阴影通道中。由于几何体复杂度跳跃,阴影通道的复杂度也随之跳跃。然而,这种成本变化对于所有三种渲染类型来说实际上是相同的。让我们只检查三种不同算法的相关通道:PrePass、Material、Lighting和VisUtil。
PrePass + Material + Lighting + VisUtil
| 渲染方法 | 总计 (毫秒) |
|---|---|
| 前向 (M) | 4.05 |
| 延迟 (M) | 3.85 |
| 可见性 (M) | 2.96 |
从数据来看,很明显随着三角形变小,可见性渲染开始领先。而且数据差距比我预想的要大。我首先注意到的实际上是PrePass。我原本预计同时渲染可见性ID和深度(相对于仅渲染深度)会有更大的性能影响,但成本差异相当小(0.033毫秒)。最大的跳跃是前向和延迟材质通道,它们分别变为了之前第一张图像时长的2.43倍和2.78倍。可见性材质通道是原始通道时长的1.56倍。
但为什么可见性材质通道比大三角形情况下花费的时间更长呢?毕竟,它是在相同数量的像素上运行相同的着色器。问题是缓存一致性。让我们看两个场景。在左边,我们有一个8x8的像素块被两个三角形分割,而在右边,8x8块中的每个像素指向不同的三角形。
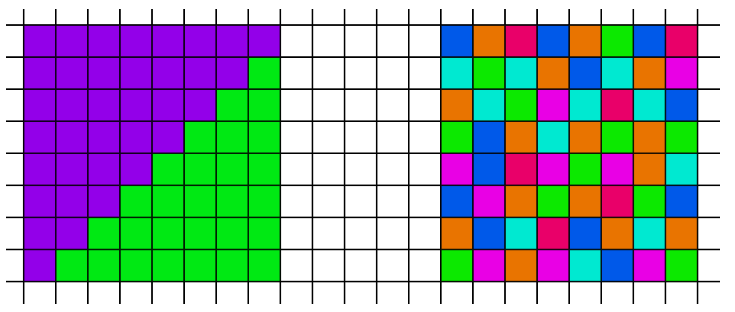
在计算着色器中,所有64个线程都获取第一个顶点的数据。但在左边的情况下,GPU只需要为整个8x8块获取2个唯一的顶点位置。然而在右边的情况下,GPU需要从内存中64个不同的位置获取数据。除了更差的一致性外,它还需要获取更多的原始带宽,因为它需要从内存中获取的总字节数更高。因此,虽然这些额外的获取在第一个大三角形测试用例中成本微不足道,但在这个场景中它们具有相关的成本。然而,这个成本远小于延迟路径由于四边形利用率差而付出的代价。因此,可见性方法整体上更快。
高三角形数量
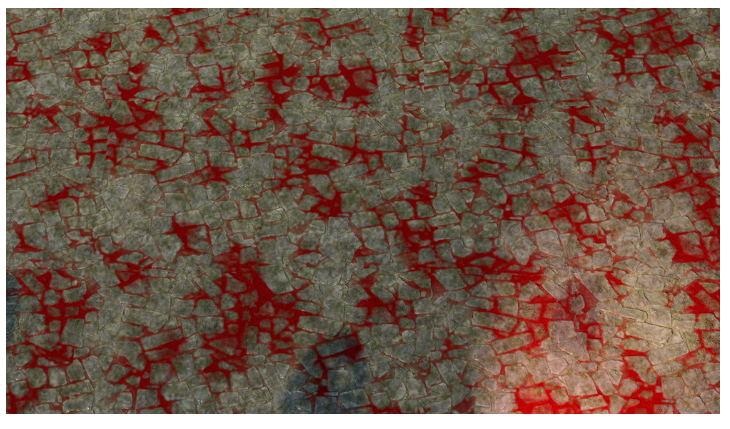
最后,让我们进行第三个高三角形数量的截图。每个模型是500x500,我们已经进入了每像素一个三角形的阶段。这是一块岩石的特写。
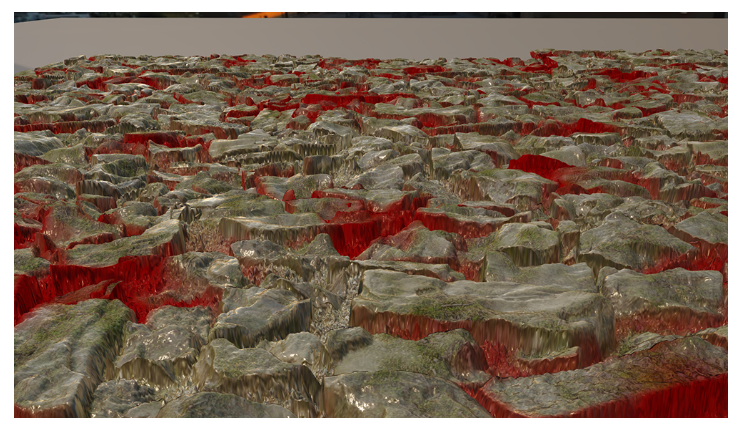
最终图像:
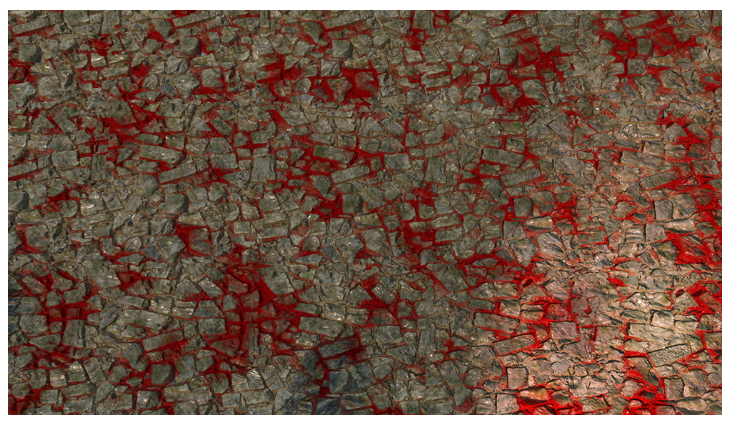
以及三角形ID:
那么数据看起来如何呢?
| PrePass | Material | Lighting | VisUtil | Other | Total | |
|---|---|---|---|---|---|---|
| 前向 | 1.00 | 9.27 | 9.27 | 4.726 | 14.996 | |
| 延迟 | 1.00 | 4.64 | 0.792 | 4.729 | 11.161 | |
| 可见性 | 1.15 | 2.01 | 0.836 | 0.341 | 4.516 | 8.853 |
从时间线上看,PrePass成本上升但仍保持在合理范围内,写入可见性U32的成本只增加了15%。"其他"通道成本也显著上升,但这主要是由阴影深度通道驱动的。可见性通道在"其他"类别中少了0.21毫秒,这有点奇怪。查看PIX运行,阴影深度通道确实与PrePass有一些重叠,因此PrePass额外的0.15毫秒成本可能隐藏了阴影通道的0.15毫秒,另外0.06毫秒则被与VisUtil的其他重叠所隐藏。
但主要区别在于材质和光照成本。这些数据基本上不言自明。前向成本缩放为第一帧的5.76倍,延迟材质成本增加为第一帧的4.38倍。然而,可见性材质成本缩放为第一帧的1.90倍。
再次,让我们隔离出与渲染算法差异相关的通道。
PrePass + Material + Lighting + VisUtil
| 渲染方法 | 总计 (毫秒) |
|---|---|
| 前向 (H) | 10.27 |
| 延迟 (H) | 6.43 |
| 可见性 (H) | 4.34 |
数据很清晰。在这个测试用例中,一旦三角形密度降低到单个像素,可见性渲染更好的四边形利用率带来的优势大大超过了插值顶点属性和解析计算偏导数的额外成本。
结论
回到最初的问题:
1. 我们能否高效地计算材质图的解析偏导数?
在这个测试用例中,答案是"是的"。但在一般情况下,更好的答案是"可能"。在简单的UV缩放和偏移情况下,生成偏导数所需的额外计算是微不足道的。我还做了一些其他的粗略测试(没有进行完整的PIX运行集),乍一看,没有哪些关键用例会造成足够的性能损失,从而从根本上改变这些数据。
最常见的情况是一个纹理输出成为另一个纹理的UV。如果我们有一个包含4次纹理读取的标准材质,然后我们添加一次UV偏移纹理读取,前向/延迟材质通道将增加1次纹理读取,而可见性材质通道将增加3次。但是,5次和7次纹理采样之间的差异不会导致足以大幅改变数据的性能悬崖。并且我预计这两个额外的采样成本极小,因为它们将与第一个采样高度缓存一致。
一个更有问题的情况是视差遮挡映射。理论上,每一步我们需要3次纹理读取而不是1次。但是导数会在每一步实际变化多少呢?对所有这些步骤使用相同的导数/mipmap级别是否可以接受?乍一看似乎合理,但我没有验证。
当然,我们还有真正糟糕的情况。一个折射眼睛着色器需要传递视图向量在通过角膜几何法线折射时的偏导数。我可以想象,那个着色器比有限差分版本慢3倍,因为我们需要考虑视图向量关于x和y的导数,以及角膜高度和法线关于x和y的偏导数。但我也可以想到能降低成本近似方法。例如,我怀疑我们可以假设角膜的曲率太小而无关紧要,可以在计算中将该导数设为零。
最后,使用有限差分的标准导数也不是完美的。我们有像分支和丢弃(discard)这样的问题情况,通过切换到解析导数可以优雅地解决。当使用超出三角形边缘的辅助通道时,这一点尤其正确。
所以,是的,它在当前情况下有效。但对于AAA游戏中偏导数的普遍问题,我的答案是"可能,倾向于肯定"。我的结论是解析偏导数可能是可行的,但该方法需要更多测试才能确定更复杂的用例。
2. 对于非常高的三角形数量(每个像素一个三角形),可见性方法更快吗?
对于非常高的三角形数量,每个像素运行4次的情况下,可见性渲染是明显的赢家。延迟成本为6.43毫秒,而可见性为4.34毫秒。相关通道总体GPU成本降低32.5%是不可忽视的。
3. 对于更典型的三角形大小(每个像素5-10个三角形),可见性方法在那里也更快吗?
在中等数量下,在这些测试中,可见性方法也同样更快。利润空间更接近,为3.85毫秒对比2.96毫秒。尽管如此,23.1%的降低也是不可忽视的。此外,我预计可见性方法在具有大量几何体和过度绘制的糟糕视角下会不那么波动,但这只是推测。
其他考虑因素
鉴于可见性渲染在高三角形数量下比延迟渲染扩展性更好,并且三角形数量每年都在增加,每个游戏引擎是否应该放弃一切并切换到它?当然不是。在任何主要的架构渲染决策中,还有几个其他因素。
代码复杂性:
可能是反对可见性渲染的最佳论点是其涉及的复杂性。可见性渲染需要工程时间来管理顶点缓冲区和偏导数。工程时间不是无限的。
内存:
为了使用可见性渲染,您所有的动态几何体都需要放在一个巨大的缓冲区(或多个缓冲区)中,以便着色器可以访问。如果您的屏幕被草叶覆盖,那么每一个变形后的顶点都需要在某处的缓冲区中。也就是说,内存并不一定像听起来那么糟糕。您可能可以将位置XYZ打包为每个16位,因此每个顶点为6字节。如果您需要变形后的切空间,您可以将其存储在一个4字节的四元数中,总共每个像素10字节。假设您在1080p(200万像素)下渲染,并且每个像素有一个顶点。这将占用20MB的RAM,或者如果您需要存储前一帧,则为40MB。40MB的RAM并非微不足道,但也不离谱。而且,如果您想将网格包含在光线追踪中,您无论如何都需要变形后的顶点。
PSO切换:
可见性渲染的一个微妙优势是光栅化过程中的PSO切换更少。在前向或延迟光栅化通道中,当像素着色器在早期阶段缺乏工作时,可能会形成气泡(bubbles),特别是如果PSO不断切换的话。但不透明几何体可以共享相同的可见性像素着色器,尽管它们有完全不同的材质。虽然有一些例外(背面剔除、Alpha测试等),但我们可以将几乎所有可见几何体分组到仅有的几个PSO中,用于三角形ID写入通道。我们还可以在材质通道中更积极地分组PSO。例如,一个渲染不透明材质的变体和一个带有Alpha测试的变体可以在同一个可见性间接CS调度中评估材质数据,而在延迟材质通道中,它们将需要单独的PSO。可见性管线应该会有显著更少的气泡,但测试这种工作负载超出了小型玩具引擎的范围。
材质成本:
如果您使用巨大而复杂的材质进行渲染,那么可见性更有吸引力。这是因为获取和插值顶点数据的成本被材质评估的成本所掩盖。如果您使用短的材质着色器,那么插值成本以及固定成本开销将更加突出。
最低规格:
这些测试是在NVIDIA GTX 3070上进行的,这高于未来几年任何AAA游戏的最低规格。特别是,此测试用例具有约0.34毫秒的固定成本。然而,对于5年前的低端笔记本GPU来说,同样的成本会相当高昂。可见性对于未来的更强大的GPU扩展性良好,但同样地,对于将在最低规格中保留很长时间的旧GPU,其扩展性较差。
分辨率上采样:
次要的考虑是上采样算法的作用,例如NVIDIA的DLSS 10、AMD的Super Resolution 1 和Unreal的Temporal Super Resolution 6。观点当然各不相同,但如果我可以选择原生4K分辨率但着色效果打折扣,与一个真正好的1080p图像、高质量着色并上采样到4K相比,我会选择上采样的1080p。但是假设您针对的是4K图像,每个三角形10个像素,然后您决定切换到1080p。那么,突然您的10像素三角形变成了2.5像素三角形。换句话说,如果我们从PS4/XB1时代提升三角形数量,但保持分辨率目标为1080p帧缓冲区,那么我们在PS5/XSX上将会有大量非常小的三角形。
四边形利用率很重要:
真的,这里的大结论是四边形利用率很重要。它实际上与过度绘制的成本相同!我们都知道1像素三角形不好,但10像素三角形也不理想。4倍比2倍差,但2倍也比1倍差。四边形利用率不是未来的遥远问题。它是当今游戏实际发布的工作负载中真实存在的问题。但是,如果我们确实解决了四边形利用率问题,我们实际上有很大的空间来优化我们的渲染器,并将那些GPU周期用于有趣的效果,而不是用于辅助通道。
参考文献:
1 AMD FidelityFX, Super Resolution. AMD Inc. (AMD FSR™ Technologies)
2 AmbientCG, (https://www.ambientcg.com)
3 The Visibility Buffer: A Cache-Friendly Approach to Deferred Shading. Christopher Burns and Warren Hunt. (http://jcgt.org/published/0002/02/04/)
4 ConfettiFX/The-Forge. ConfettiFX. (GitHub - ConfettiFX/The-Forge: The Forge Cross-Platform Framework PC Windows, Steamdeck (native), Ray Tracing, macOS / iOS, Android, XBOX, PS4, PS5, Switch, Quest 2 · GitHub)
5 4K Rendering Breakthrough: The Filtered and Culled Visibility Buffer. Wolfgang Engel. (GDC Vault - 4K Rendering Breakthrough: The Filtered and Culled Visibility Buffer)
6 Unreal Engine 5 Early Access Release Notes. Epic Games, Inc. (https://docs.unrealengine.com/5.0/en-US/ReleaseNotes/)
7 Nanite, Inside Unreal. Brian Karis, Chance Ivey, Galen Davis, and Victor Brodin. (https://www.youtube.com/watch?v=TMorJX3Nj6U)
8 Sony Pictures Imageworks Arnold. Christopher Kulla, Alejandro Conty, Clifford Stein, and Larry Gritz. (https://dl.acm.org/doi/10.1145/3180495)
9 HLSL Shader Model 6.0, Microsoft Inc. (HLSL Shader Model 6.0 - Win32 apps | Microsoft Learn)
10 NVIDIA DLSS. NVIDIA Inc. (DLSS Technology | NVIDIA)
11 Automatic Differentiation, C++ Template and Photogrammetry. Dan Piponi. (http://citeseerx.ist.psu.edu/viewdoc/download?doi=10.1.1.89.7749&rep=rep1&type=pdf)
12 Deferred Attribute Interpolation for Memory-Efficient Deferred Shading. Christoph Schied and Carsten Dachsbacher. (http://cg.ivd.kit.edu/publications/2015/dais/DAIS.pdf)
1 AMD FidelityFX, Super Resolution. AMD Inc. (AMD FSR™ Technologies)
解决的问题:
高分辨率渲染对 GPU 算力要求极高,尤其是在低端硬件或需要高帧率的场景下,原生分辨率渲染难以兼顾画质与性能。
提出的重要思想/方法:
AMD FSR(FidelityFX Super Resolution)是一种空间域超分辨率技术。它通过低分辨率渲染 + 高质量上采样,在不依赖专用硬件(如 Tensor Core)的前提下,输出接近原生高分辨率的画质。核心思路是用边缘感知的空间滤波算法,从低分辨率图像重建高分辨率细节。
具体实现方式:
FSR 1.0 使用经典的 Lanczos 重采样 + 锐化 组合,通过分析每个像素周围的局部对比度,自适应地重建边缘。FSR 2.0 则引入时域信息(运动矢量、深度、历史帧),结合时域抗锯齿(TAA)思路,进一步提升画质。它提供多种质量档位(Ultra Quality、Quality、Balanced、Performance),在不同平台上均可运行,无需机器学习硬件。
2 AmbientCG, (https://www.ambientcg.com)
解决的问题:
3D 艺术家和开发者需要高质量、免费、可商用的 PBR 材质、HDRI 和环境贴图资源,但获取渠道分散、授权不清。
提出的重要思想/方法:
AmbientCG 是一个免费 PBR 材质与 HDRI 资源库。所有资源采用 CC0 许可,可自由用于个人和商业项目。资源以标准化格式提供,包含反照率、法线、粗糙度、金属度、置换等贴图通道。
具体实现方式:
网站按类别(材质、HDRI、模型等)组织资源,支持分辨率选择(1K/2K/4K/8K 等)和格式下载。资源可直接导入主流渲染引擎(Blender、Unreal、Unity 等)。对于渲染研究,它常被用作测试场景的标准化材质来源。
3 The Visibility Buffer: A Cache-Friendly Approach to Deferred Shading. Christopher Burns and Warren Hunt.
解决的问题:
传统延迟着色存在两个缺陷:G-buffer 带宽开销大(每样本 20+ 字节),且在移动/集成 GPU 上成为瓶颈;可见性与着色分离不彻底,前向 Pass 仍对被遮挡片元急切计算表面属性,浪费带宽和算力。
提出的重要思想/方法:
用可见性缓冲区(Visibility Buffer) 替代 G-buffer。每个样本仅存储三角形索引和实例 ID,最少 4 字节。生成可见性缓冲区比生成 G-buffer 更廉价,无需纹理读取或材质相关计算。延迟着色 Pass 通过索引访问三角形数据,计算重心坐标并插值顶点属性。
具体实现方式:
-
前向 Pass 仅做可见性判定,写入三角形索引和实例 ID。
-
延迟着色 Pass 利用索引取三角形数据,计算重心坐标,插值出法线、UV 等属性,再执行光照。
-
通过最小化可见性方案的内存占用,缩小延迟渲染管线的工作集,在带宽受限平台(尤其高分辨率)获得性能提升。
4 ConfettiFX/The-Forge. ConfettiFX. (GitHub - ConfettiFX/The-Forge)
解决的问题:
跨平台图形开发需要一套统一、高性能、支持多种图形 API 和平台的渲染框架,避免为每个平台重复造轮子。
提出的重要思想/方法:
The Forge 是一个跨平台渲染框架,支持 PC Windows、Steamdeck(原生)、macOS/iOS、Android、XBOX、PS4、PS5、Switch、Quest 2 等平台,并支持光线追踪。它提供统一的抽象层,封装不同图形 API(DirectX、Vulkan、Metal 等)。
具体实现方式:
框架包含渲染器抽象、资源管理、着色器编译、场景图、动画、物理等模块。提供大量示例(如延迟渲染、前向渲染、光线追踪、GPU 驱动等),开发者可基于此快速构建跨平台渲染应用。它是开源项目,常用于研究和教学。
5 4K Rendering Breakthrough: The Filtered and Culled Visibility Buffer. Wolfgang Engel.
解决的问题:
可见性缓冲区(Visibility Buffer)虽然降低了带宽,但在 4K 高分辨率下,可见性缓冲区的解析(resolve)和着色仍可能成为瓶颈,尤其是当大量三角形重叠时。
提出的重要思想/方法:
提出过滤与剔除可见性缓冲区(Filtered and Culled Visibility Buffer) 。核心是在可见性缓冲区解析阶段,引入过滤(Filtering) 和**剔除(Culling)**机制,减少需要着色的样本数量。过滤指利用深度或材质信息合并相似样本;剔除指跳过对最终图像无贡献的样本。
具体实现方式:
在生成可见性缓冲区后,增加一个解析 Pass,对缓冲区进行统计和分类。对于被完全遮挡或对最终颜色无影响的样本,直接跳过着色。对于材质相同且深度接近的相邻样本,可合并处理。这样在 4K 下显著减少着色开销,实现性能突破。
6 Unreal Engine 5 Early Access Release Notes. Epic Games, Inc.
解决的问题:
游戏和实时渲染需要更高几何细节、更真实光照和更高效的内容创作流程,但传统管线在几何复杂度和光照质量上存在瓶颈。
提出的重要思想/方法:
UE5 早期访问版引入了 Nanite 虚拟化微多边形几何 和 Lumen 全动态全局光照 两大核心技术,以及 Virtual Shadow Maps 、Temporal Super Resolution 等。目标是让开发者能直接使用影视级资产,无需手动 LOD 和光照烘焙。
具体实现方式:
Nanite 通过虚拟化几何 和簇层次结构(Cluster Hierarchy) ,按屏幕像素需求流式加载和渲染微多边形,实现像素级几何细节。Lumen 使用屏幕空间 + 世界空间的混合追踪,结合距离场和表面缓存,实现动态 GI 和反射。TSR 是时域超分辨率,替代 TAA,提供更清晰的高分辨率输出。
7 Nanite, Inside Unreal. Brian Karis, Chance Ivey, Galen Davis, and Victor Brodin.
解决的问题:
传统渲染管线难以高效处理数十亿三角形的影视级几何资产,LOD 生成和绘制调用成为瓶颈。
提出的重要思想/方法:
Nanite 的核心是虚拟化微多边形几何(Virtualized Micropolygon Geometry) 。它将几何数据组织成簇(Cluster) 和层次结构,按屏幕空间误差动态选择细节级别。只有可见的簇才会被加载和光栅化,实现"像素级几何"。
具体实现方式:
-
离线将高模切分为簇,构建 BVH 层次。
-
运行时根据相机距离和屏幕误差,遍历层次结构,选择需要渲染的簇。
-
使用软件光栅化(Compute Shader)处理微小三角形,避免硬件光栅化开销。
-
结合 Virtual Shadow Maps 和 Lumen,实现全动态光照。Nanite 支持流式加载,内存占用与屏幕分辨率相关,而非场景复杂度。
8 Sony Pictures Imageworks Arnold. Christopher Kulla, Alejandro Conty, Clifford Stein, and Larry Gritz.
解决的问题:
影视级离线渲染需要高质量、物理正确的全局光照、材质和相机模型,同时要支持大规模场景和复杂着色网络。
提出的重要思想/方法:
Arnold 是一个物理基渲染器(Physically Based Renderer) ,采用蒙特卡洛路径追踪 。它强调无偏、物理正确 的光照模拟,支持任意着色网络、体积渲染、次表面散射等。核心设计是延迟着色 + 按需加载,以适应超大场景。
具体实现方式:
Arnold 使用 BVH 加速结构 进行光线求交,支持实例化 和程序化几何 。着色系统基于 OSL(Open Shading Language) ,允许自定义材质。渲染时采用自适应采样 和重要性采样,在保证质量的同时控制噪声。它支持多线程和分布式渲染,是影视行业标准渲染器之一。
9 HLSL Shader Model 6.0, Microsoft Inc.
解决的问题:
早期 HLSL Shader Model 在功能上受限,无法充分利用现代 GPU 的可编程能力和新硬件特性(如波前操作、64 位整数、动态资源等)。
提出的重要思想/方法:
Shader Model 6.0 引入了波前操作(Wave Operations) 、64 位整数 、动态资源索引 、根签名等特性,显著提升了着色器的表达能力和性能。它是 DirectX 12 的重要组成部分。
具体实现方式:
SM 6.0 支持 WaveReadLaneAt、WaveActiveSum 等波前内在函数,允许着色器在 SIMD 组内高效通信。支持 int64_t 和 uint64_t,便于大范围索引和计算。动态资源索引允许在运行时选择纹理和缓冲区,减少分支。根签名优化了资源绑定模型。后续 SM 6.1~6.8 持续增加新特性(如光线追踪、网格着色器、可变速率着色等)。
10 NVIDIA DLSS. NVIDIA Inc.
解决的问题:
高分辨率渲染对 GPU 算力要求极高,传统超分辨率方法难以在低分辨率输入下重建高质量高分辨率图像,且容易产生闪烁和伪影。
提出的重要思想/方法:
DLSS(Deep Learning Super Sampling)使用深度学习神经网络 进行超分辨率。它利用时域信息 (历史帧、运动矢量、深度)和低分辨率输入 ,通过训练好的神经网络重建高分辨率图像。DLSS 2.0 后采用通用网络,不再为每个游戏单独训练。
具体实现方式:
DLSS 在 GPU 的 Tensor Core 上运行推理。输入包括低分辨率颜色、运动矢量、深度、曝光等。网络输出高分辨率图像,并配合时域抗锯齿 和锐化 。DLSS 3.0 引入帧生成,通过光流和神经网络插帧,进一步提升帧率。它需要 NVIDIA RTX 系列 GPU 支持。
11 Automatic Differentiation, C++ Template and Photogrammetry. Dan Piponi.
解决的问题:
摄影测量(Photogrammetry)和渲染中常需要对复杂函数求导,手动推导和实现容易出错,且难以维护。
提出的重要思想/方法:
利用 C++ 模板元编程 实现自动微分(Automatic Differentiation)。通过模板类封装数值及其导数,运算符重载自动传播导数。这样可以在编译期生成高效的求导代码,无需手动推导。
具体实现方式:
定义 Dual 或 Jet 类型,包含值和导数部分。重载 +、-、*、/、sin、cos 等运算符和函数,按链式法则更新导数。在摄影测量中,用于优化相机参数、三维点坐标等。模板展开后,生成的代码与手写求导性能相当,但开发效率大幅提升。
12 Deferred Attribute Interpolation for Memory-Efficient Deferred Shading. Christoph Schied and Carsten Dachsbacher.
解决的问题:
传统延迟着色需要存储完整的 G-buffer(法线、UV、材质等),内存和带宽开销大。可见性缓冲区虽然降低了存储,但在着色阶段需要重新插值顶点属性,可能带来额外计算。
提出的重要思想/方法:
提出延迟属性插值(Deferred Attribute Interpolation, DAIS) 。核心是在可见性缓冲区中仅存储三角形索引和重心坐标,在着色阶段按需插值顶点属性。这样既避免了存储完整 G-buffer,又避免了在可见性 Pass 中急切插值。
具体实现方式:
-
前向 Pass 生成可见性缓冲区,存储三角形索引和重心坐标(可压缩)。
-
延迟着色 Pass 根据索引读取顶点属性,用重心坐标插值出法线、UV 等。
-
通过共享内存 和缓存优化,减少重复顶点读取。DAIS 在保持低内存占用的同时,提供了与 G-buffer 相当的着色灵活性,尤其适合高分辨率和移动平台。