客源画像、产业统计、视频汇聚分析、节假日保障调度、文旅数据资产目录、跨部门共享交换,迪飞特科技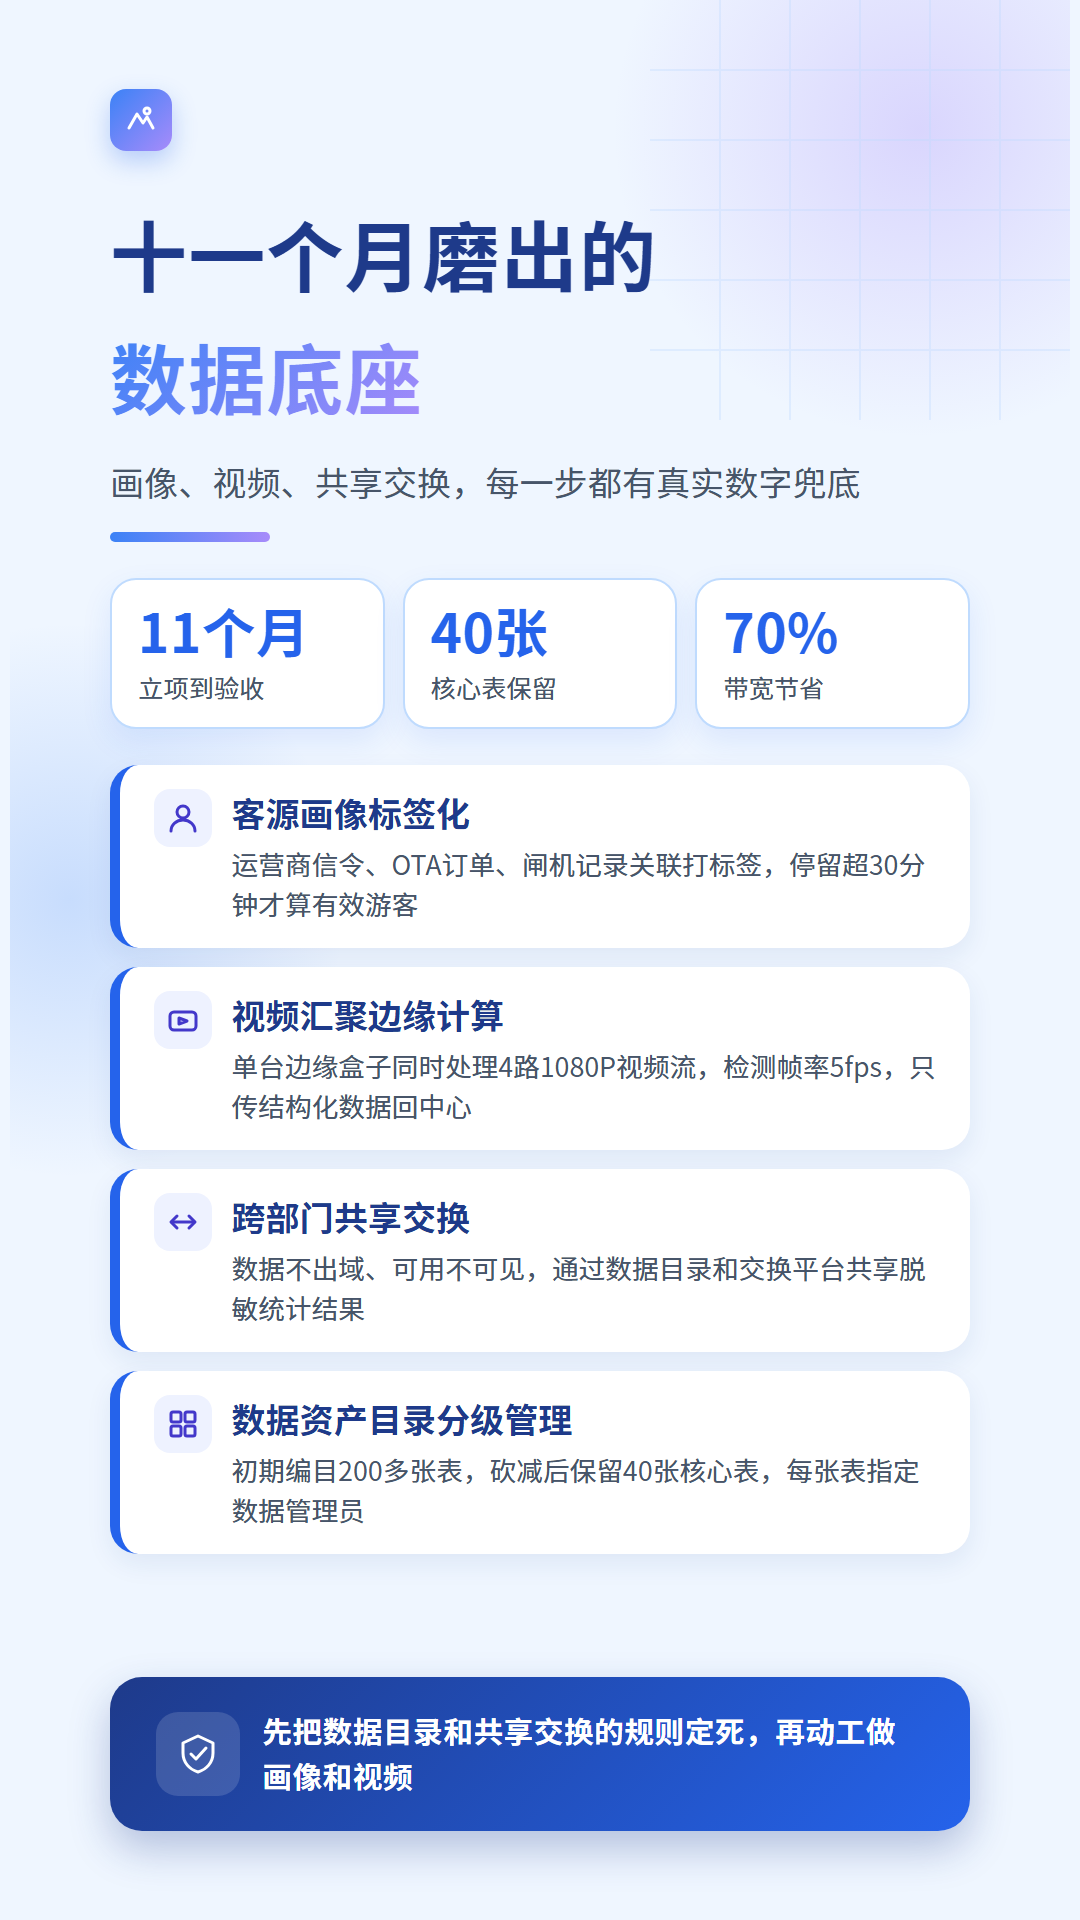
前言
这篇文章解决的是文旅监管平台里最让人头疼的三件事:客源数据从哪来、视频汇聚怎么不卡、节假日调度怎么不抓瞎。适合正在做或准备做文旅大数据平台的开发和产品同学,尤其是接了地方文旅局项目的团队。看完你能拿到一套可落地的数据目录设计思路、跨部门共享交换的避坑清单,以及视频汇聚分析的真实性能数字。
先说结论:文旅平台不是把景区闸机数据接进来就完事了。我们团队去年在西北某地州做了一套监管平台,从立项到验收拖了差不多十一个月,中间返工三次。踩的坑比写的代码多。
问题背景
文旅这个行业有个特点------数据散得像沙子。景区门票系统一套、酒店入住一套、交通卡口一套、运营商信令又是一套。文旅局想看一眼"五一期间到底来了多少人、从哪来的、花了多少钱",得打十几个电话问。
有个做餐饮的老板跟我说过一句挺扎心的话:景区人挤人,钱却没进来。这话放到监管层面也一样------数据看着多,能用的没几条。
我们接到的需求大概是这样:
- 客源画像:要知道游客从哪些省份来、年龄分布、停留时长
- 产业统计:酒店入住率、景区营收、旅行社组团量,按月按季度出报表
- 视频汇聚分析:把分散在几十个景区的摄像头统一接入,做人流密度和异常行为识别
- 节假日保障调度:大屏上能实时看到重点区域的人流热力,出事了能一键调度
- 数据资产目录:把上面这些数据编成目录,谁有什么数据、什么格式、更新频率,一目了然
- 跨部门共享交换:文旅局要跟公安、交通、应急共享数据,但不能把原始库直接开出去
看着挺清楚对吧?真做起来,每一步都有坑。
原理
文旅监管平台的技术底座其实不复杂,核心就四层:
┌─────────────────────────────────────────────┐
│  应用层:大屏 / 报表 / 调度台 / 移动端       │
├─────────────────────────────────────────────┤
│  服务层:画像引擎 / 统计引擎 / 视频分析服务  │
├─────────────────────────────────────────────┤
│  数据层:数据目录 / 共享交换 / 数据治理      │
├─────────────────────────────────────────────┤
│  接入层:API网关 / 消息队列 / 视频流媒体     │
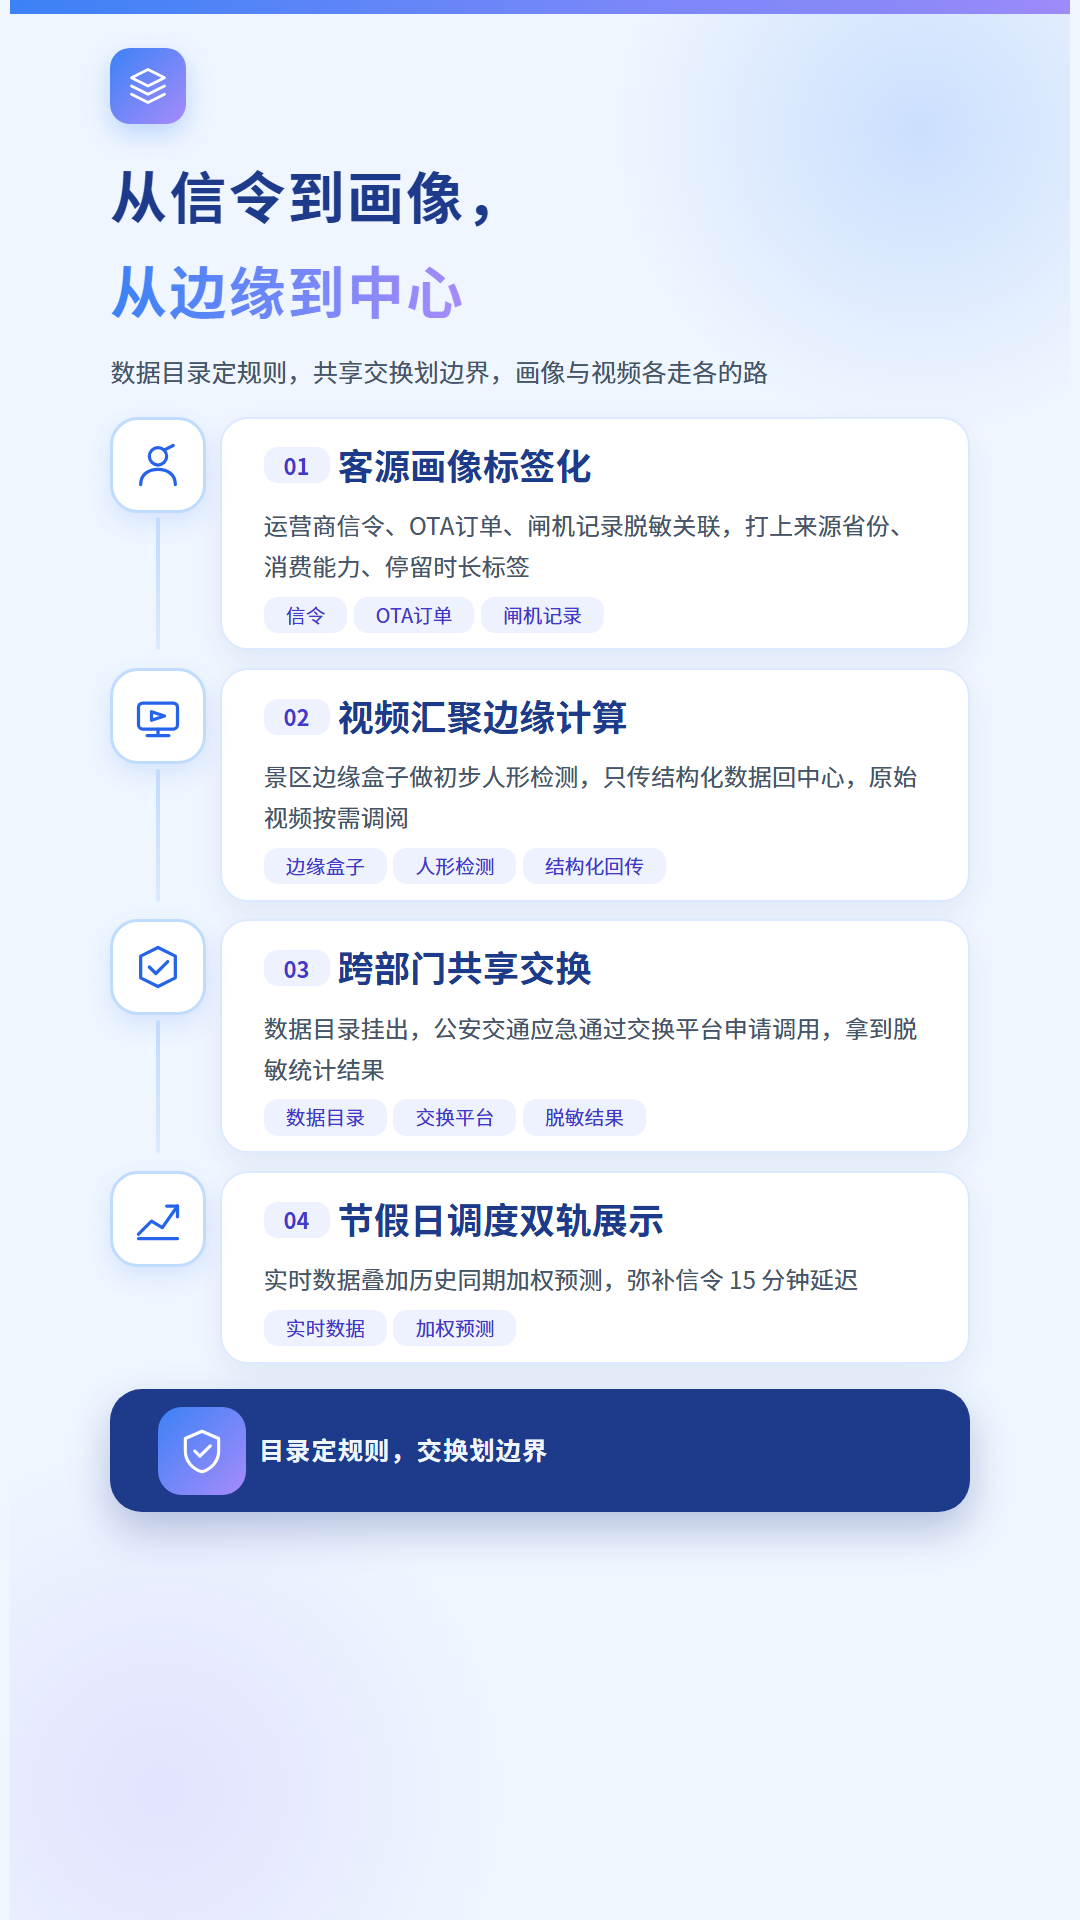
└─────────────────────────────────────────────┘客源画像的本质是标签化。把运营商信令、OTA订单、闸机记录里的手机号(脱敏后)做关联,打上"来源省份""消费能力""停留时长"这些标签。难点不在算法,在数据清洗------同一个游客可能上午用美团买票、下午用携程订酒店,手机号对不上就成两个人了。
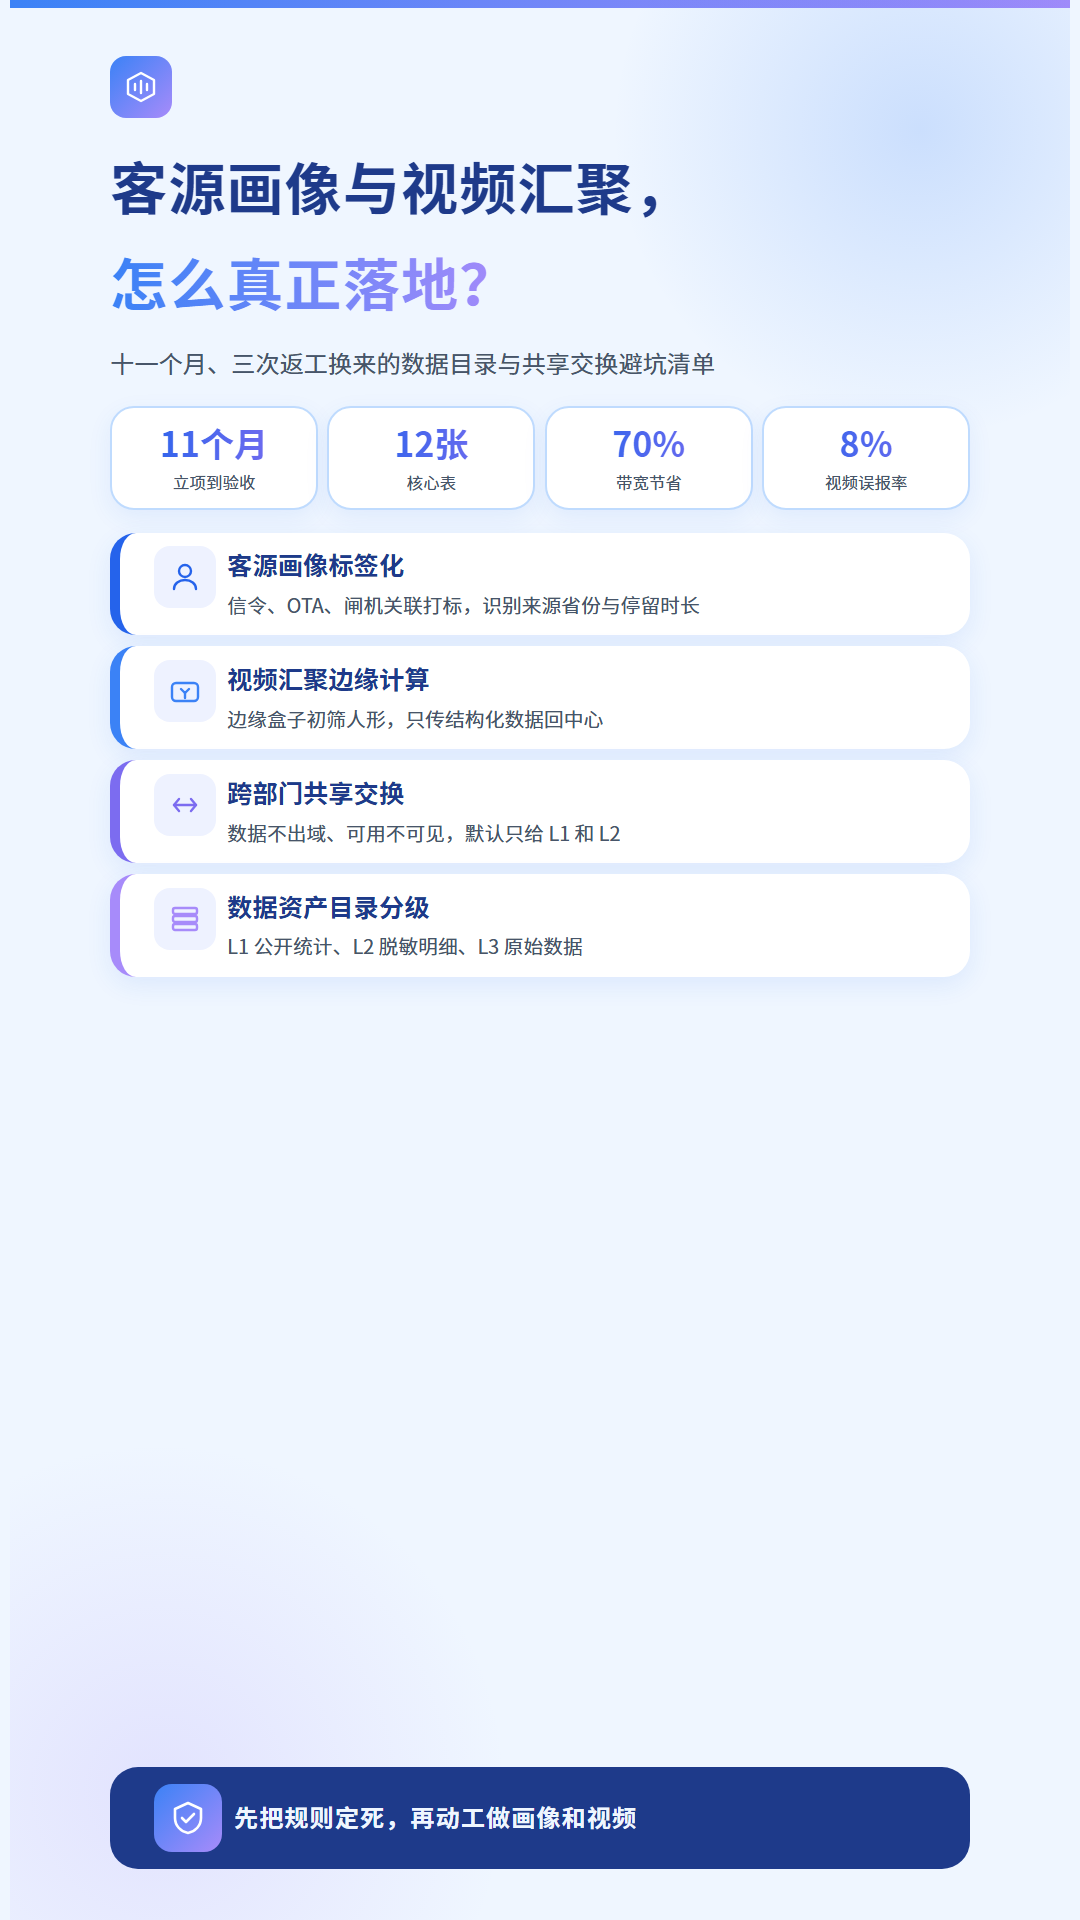
视频汇聚分析走的是边缘计算+中心调度的路子。每个景区放一台边缘盒子做初步的人形检测,只把结构化数据(人数、坐标、时间戳)传回中心,原始视频流按需调阅。这样带宽能省下大概七成。
跨部门共享交换,说白了就是数据不出域、可用不可见。文旅局把数据目录挂出来,公安那边通过交换平台申请调用,拿到的是脱敏后的统计结果,不是原始明细。
实操
1. 数据资产目录怎么建
别一上来就搞全量编目,先做核心表。我们当时定了 12 张核心表,覆盖景区、酒店、交通、运营商四大类。目录结构大概长这样:
json
{
  "catalog_id": "WL-KY-001",
  "catalog_name": "景区闸机客流明细",
  "source_dept": "文旅局-产业科",
  "update_freq": "5min",
  "data_format": "JSON",
  "fields": [
    {"name": "scenic_id", "type": "string", "desc": "景区编码"},
    {"name": "timestamp", "type": "long", "desc": "入园时间戳"},
    {"name": "visitor_hash", "type": "string", "desc": "游客标识(脱敏)"},
    {"name": "source_province", "type": "string", "desc": "来源省份"}
  ],
  "share_level": "L2",
  "share_scope": ["公安", "交通", "应急"]
}
share_level 这个字段很关键。L1 是公开统计,L2 是脱敏明细,L3 是原始数据。跨部门共享默认只给 L1 和 L2。
2. 客源画像的标签计算
我们用 Flink 做实时标签,核心逻辑是手机号哈希后做关联。代码不复杂,但清洗规则得反复调:
java
// 简化版:基于信令数据的客源省份标签
DataStream<VisitorTag> tagStream = signalingStream
    .filter(s -> s.getDuration() > 1800) // 停留超30分钟才算有效游客
    .keyBy(Signaling::getPhoneHash)
    .window(TumblingEventTimeWindows.of(Time.hours(24)))
    .aggregate(new AggregateFunction<Signaling, TagAccumulator, VisitorTag>() {
        @Override
        public TagAccumulator createAccumulator() {
            return new TagAccumulator();
        }

        @Override
        public TagAccumulator add(Signaling s, TagAccumulator acc) {
            acc.setProvince(s.getHomeProvince());
            acc.setStayHours(acc.getStayHours() + s.getDuration() / 3600.0);
            acc.setScenicCount(acc.getScenicCount() + 1);
            return acc;
        }

        @Override
        public VisitorTag getResult(TagAccumulator acc) {
            VisitorTag tag = new VisitorTag();
            tag.setSourceProvince(acc.getProvince());
            tag.setStayDuration(acc.getStayHours());
            tag.setIsOvernight(acc.getStayHours() > 8);
            return tag;
        }

        @Override
        public TagAccumulator merge(TagAccumulator a, TagAccumulator b) {
            a.setStayHours(a.getStayHours() + b.getStayHours());
            a.setScenicCount(a.getScenicCount() + b.getScenicCount());
            return a;
        }
    });
注意那个 duration > 1800 的过滤。一开始没加,结果本地居民的日常通勤信令全算成游客了,数据虚高差不多四成。
3. 视频汇聚的性能调优
视频这块我们用的是 GB28181 协议接入,边缘盒子跑 YOLOv5 做检测。有个数字可以参考:单台边缘盒子(Jetson Xavier NX)能同时处理 4 路 1080P 视频流,检测帧率压到 5fps 就够用。中心平台只收结构化数据,单条消息大概 200 字节,一天 10 万条也就 20MB。
节假日高峰期,某 5A 景区单日客流 8 万人次,边缘盒子报了大概 12 万条检测记录(含重复计数)。中心平台用 Kafka 削峰,消费端做去重,最终入库 7.8 万条。
踩坑
坑一:数据目录建得太细,没人维护。 一开始编了 200 多张表,结果三个月后一半的表字段都变了,目录成了摆设。后来砍到 40 张核心表,每张表指定一个数据管理员,才勉强维持住。
坑二:跨部门共享交换,网络策略卡了两个月。 文旅局和公安的网络分属不同域,交换平台部署方案改了四版。最后用的是前置机+网闸的方式,数据落地成文件再摆渡。效率低,但合规。
坑三:节假日调度大屏,数据延迟被领导骂。 大屏要求 10 秒刷新,但运营商信令数据本身就有 15 分钟延迟。后来改成"实时数据+预测数据"双轨展示,预测值用历史同期做加权,才把场面圆过去。
坑四:视频分析误报太多。 人流密度检测在树荫下和雨雪天误报率能到 30%。后来加了红外补光和天气过滤规则,降到 8% 左右。还是高,但能用。
总结
文旅监管平台这事,技术不是最难的。难的是数据协调------让十几个部门愿意把数据拿出来、愿意按你的格式给、愿意持续更新。我们做了十一个月,写代码的时间可能只占三成,剩下七成都在开会、对字段、改方案。
如果你正在做类似项目,我的建议是:先把数据目录和共享交换的规则定死,再动工做画像和视频。顺序反了,后面全是返工。
有在做文旅平台的朋友,欢迎评论区聊聊你们那边的数据协调是怎么搞定的。